
Corso
Introduzione al Deep Learning con PyTorch
4 ore
92.8K
Pratica and corso your progress.
Continua Con GoogleIl transfer learning è una tecnica che permette alle macchine di sfruttare la conoscenza acquisita in un compito precedente per migliorare la generalizzazione su un altro. È un concetto fondamentale alla base dello sviluppo di modelli come ChatGPT e Google Gemini, e aiuta in molti compiti importanti e utili, come riassumere documenti lunghi, redigere saggi complessi, organizzare viaggi o persino scrivere poesie e canzoni.
In questa guida esploreremo in profondità il transfer learning. Vedremo cos'è, perché è rilevante per il deep learning e i moderni modelli generativi di IA, e le sfide e i limiti di questa tecnica. Ti suggeriremo anche risorse per continuare a imparare. Pronto? Iniziamo.
Il transfer learning è una tecnica in cui un modello sviluppato per un determinato compito viene riutilizzato come punto di partenza per un modello su un secondo compito. In altre parole, riapplichi i componenti di un modello di machine learning pre-addestrato a nuovi modelli pensati per qualcosa di diverso ma correlato.
Il concetto è simile a come gli esseri umani imparano nuove abilità. Facciamo un esempio: immagina di essere un chitarrista esperto e di decidere di imparare l'ukulele. La tua esperienza precedente con la chitarra accelererà il processo di apprendimento. Questo perché molte delle abilità e delle conoscenze necessarie per suonare la chitarra—come le posizioni delle dita, i pattern di strumming, la comprensione della tastiera, la teoria musicale e il ritmo—sono applicabili anche all'ukulele.
Nell'IA, il transfer learning ti consente di sfruttare l'addestramento precedente per risolvere nuovi problemi correlati in modo più efficiente, riducendo così tempo e risorse computazionali.
Ci sono diverse ragioni convincenti per adottare tecniche di transfer learning nello sviluppo di reti neurali, tra cui:
Esploriamo tre concetti correlati al transfer learning: apprendimento multi-task, estrazione di caratteristiche e fine-tuning.
Nell'apprendimento multi-task, un singolo modello viene addestrato a svolgere più compiti contemporaneamente. Il modello ha un insieme condiviso di strati iniziali che elaborano i dati in modo comune, seguiti da strati separati per ciascun compito specifico. Questo consente al modello di apprendere caratteristiche generali utili a tutti i compiti, e al contempo caratteristiche specifiche più peculiari di ciascun compito.
Questo paradigma è ampiamente usato negli LLM moderni. Dai un'occhiata al nostro corso Introduction to LLMs per scoprire tutti i dettagli.
L'estrazione di caratteristiche consiste nell'usare un modello pre-addestrato per estrarre feature o rappresentazioni significative dai dati. Queste feature vengono poi usate come input per un nuovo modello focalizzato su qualcosa di specifico.
Il transfer learning basato su feature sfrutta le capacità uniche delle reti neurali di estrarre caratteristiche dai dati. Con l'estrazione di caratteristiche, il modello "capisce", per così dire, quale parte dell'input è importante per, ad esempio, classificare un'immagine. In termini pratici, significa che, quando un modello viene applicato a un nuovo compito, si utilizzano solo gli strati iniziali e intermedi pre-addestrati che contengono la conoscenza più generalizzabile.
Il fine-tuning va oltre l'estrazione di caratteristiche ed è comunemente usato quando i due compiti non sono strettamente correlati. Consiste nel prendere un modello pre-addestrato e addestrarlo ulteriormente su un dataset specifico del dominio.
La maggior parte degli LLM oggi ha ottime prestazioni generali ma spesso fallisce in problemi specifici orientati al compito. Il fine-tuning adatta il modello per ottenere risultati migliori su compiti specifici, rendendolo più efficace e versatile nelle applicazioni reali. Se vuoi sapere di più sul fine-tuning, consulta la nostra Guida introduttiva al fine-tuning degli LLM.
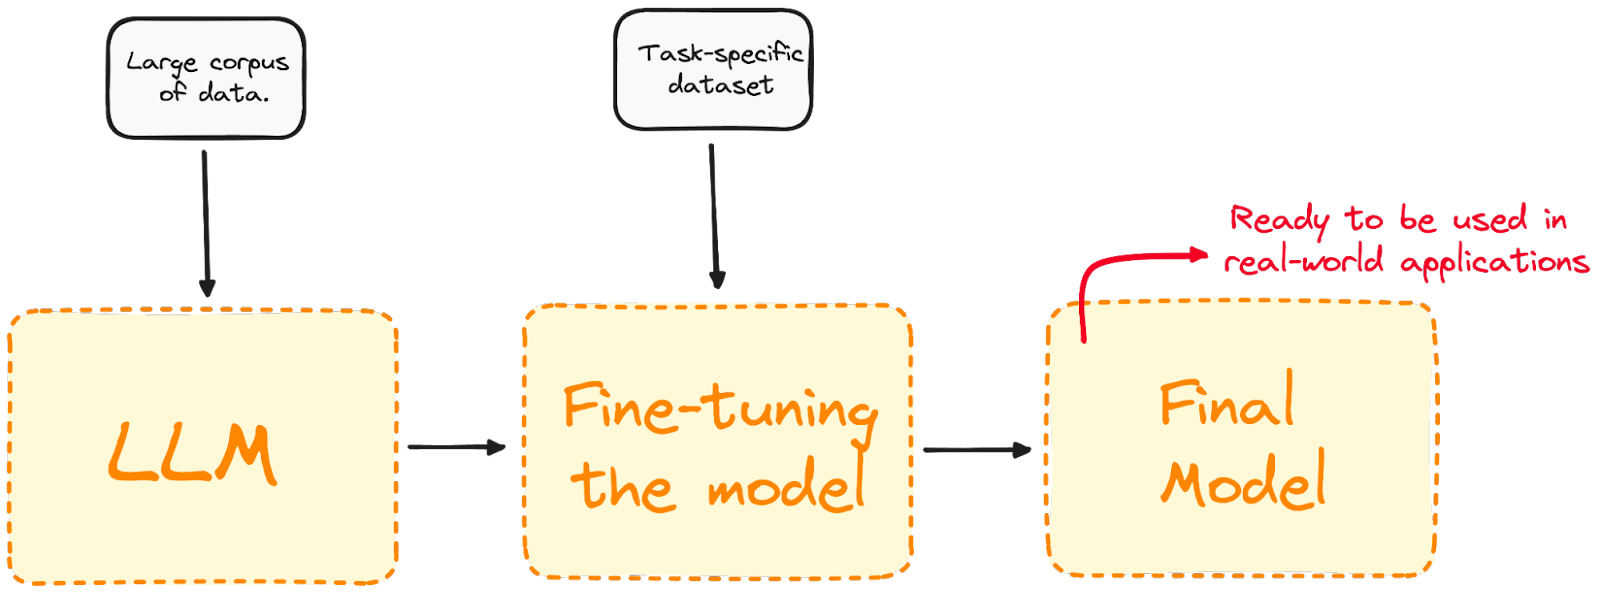 Visualizzazione del processo di fine-tuning. [DataCamp]
Il transfer learning è una tecnica comune per affrontare molteplici compiti di data science, inclusi quelli di computer vision e elaborazione del linguaggio naturale.
La computer vision è uno dei campi in cui il transfer learning si è rivelato particolarmente fruttuoso. Le reti neurali sviluppate in questo ambito richiedono enormi quantità di dati per affrontare compiti come il rilevamento di oggetti e la classificazione di immagini.
Nella computer vision, gli strati iniziali delle reti neurali rilevano i bordi nelle immagini, mentre quelli intermedi identificano forme e sagome. Gli strati finali sono adattati a compiti specifici. Il transfer learning ci permette di creare nuovi modelli riaddestrando solo gli strati finali, mantenendo invariati pesi e bias degli strati iniziali e intermedi. Grazie al transfer learning, è possibile creare nuovi modelli che riaddestrano soltanto gli ultimi strati della rete, conservando pesi e bias dei primi e intermedi.
Oggi esistono numerose reti neurali pre-addestrate e pubbliche in ambito computer vision, ad esempio:
L'NLP è un ramo dell'IA che si concentra sull'interazione tra computer e umani attraverso il linguaggio naturale. L'obiettivo è programmare i computer per elaborare e analizzare grandi quantità di dati in linguaggio naturale, in forma testuale o audio.
Il transfer learning svolge un ruolo cruciale nello sviluppo dei modelli di NLP. Consente di utilizzare modelli linguistici pre-addestrati, impiegati per la comprensione generale del linguaggio o la traduzione, per poi eseguirne il fine-tuning su problemi di NLP specifici, come l'analisi del sentiment o la traduzione automatica. Le applicazioni dell'NLP sono praticamente infinite e includono assistenti vocali e riconoscimento vocale.
Il transfer learning è alla base di alcuni dei modelli NLP più popolari, tra cui:
Alla base, il transfer learning è essenzialmente un approccio progettuale per aumentare l'efficienza. Invece di addestrare modelli da zero—il che richiede enormi risorse, denaro e tempo nel caso dei modelli generativi di IA più avanzati—il transfer learning permette ai modelli di imparare più rapidamente ed efficacemente in nuovi compiti sfruttando la conoscenza acquisita in passato.
Il transfer learning dà il meglio quando sono disponibili pochi dati per addestrare un modello su un secondo compito. Usando la conoscenza di un modello pre-addestrato, può aiutare a prevenire l'overfitting e aumentare l'accuratezza complessiva. Tuttavia, non è infallibile e presenta limiti e potenziali insidie da affrontare con attenzione. Alcune delle sfide più comuni nel transfer learning sono:
Il transfer learning è un approccio progettuale cruciale per aumentare efficienza e potenziale delle reti neurali. Si può dire che l'attuale rivoluzione dell'IA non sarebbe stata possibile senza le numerose tecniche di transfer learning disponibili.
Se vuoi approfondire gli aspetti specifici del transfer learning, DataCamp è qui per aiutarti. Scopri i nostri materiali dedicati a LLM e reti neurali per iniziare oggi stesso.
Impara con DataCamp
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



