Il campo, in continua espansione, della data science vive di dati, ma acquisire grandi dataset etichettati può diventare un collo di bottiglia significativo nello sviluppo dei modelli. Qui entra in gioco il few-shot learning, che offre un approccio rivoluzionario per ricavare insight di valore a partire da pochi esempi.
A differenza dei tradizionali metodi di apprendimento supervisionato che richiedono enormi quantità di dati, il few-shot learning permette ai modelli di apprendere e adattarsi rapidamente, risultando estremamente rilevante in contesti in cui i dati sono scarsi, costosi da raccogliere o sensibili per natura.
Questo articolo offre una panoramica completa del few-shot learning, analizzandone l'importanza, i meccanismi e le molteplici applicazioni in diversi settori.
Che cos'è il Few-Shot Learning?
Il few-shot learning (FSL) è un sottoinsieme del machine learning in cui i modelli imparano a riconoscere pattern e a fare previsioni sulla base di un numero molto ridotto di esempi di addestramento. Ciò contrasta con l'apprendimento supervisionato tradizionale, che spesso richiede grandi quantità di dati etichettati per un training efficace.
L'FSL privilegia la generalizzazione rispetto alla memorizzazione. Uno dei lavori pionieristici è il paper “Language Models are Few Shot Learners” di Tom B. Brown et al., che mette in discussione la necessità di un esteso fine-tuning.
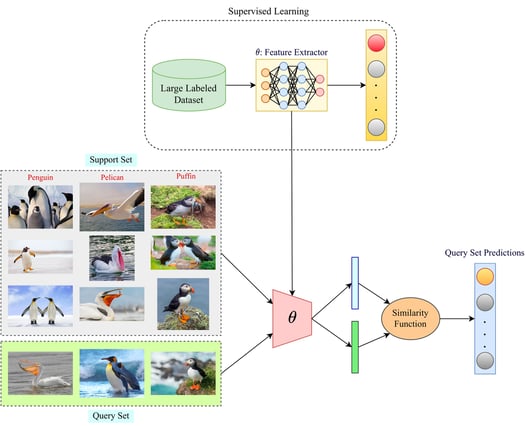
Un diagramma che illustra la differenza tra approcci di apprendimento supervisionato e few-shot learning. La sezione sull'apprendimento supervisionato mostra un grande dataset etichettato usato per addestrare un modello estrattore di feature, mentre la sezione sul few-shot learning mostra l'uso di un piccolo support set di esempi e di una funzione di similarità per effettuare previsioni su un query set. Fonte: Paperspace
Pensa a un bambino che impara a riconoscere animali diversi. Con pochi esempi di cani, gatti e uccelli, riesce rapidamente a riconoscere e distinguere queste creature in futuro, anche se incontra razze o specie mai viste prima.
Questa capacità di generalizzare da dati limitati è un tratto distintivo dell'intelligenza umana, ed è proprio ciò che il few-shot learning mira a raggiungere.
La chiave sta nella capacità di cogliere la struttura e le caratteristiche di fondo che definiscono una categoria.
Gli esseri umani hanno un'innata capacità di estrarre informazioni essenziali da esperienze limitate e applicarle a nuove situazioni. I modelli di few-shot learning tentano di emulare questo comportamento imparando una comprensione generale della struttura sottostante dei dati a partire da esperienze pregresse.
Questa conoscenza viene poi sfruttata per adattarsi rapidamente a nuovi compiti con un minimo di informazioni aggiuntive, proprio come il bambino che riconosce una nuova razza di cane basandosi sulla conoscenza pregressa dei cani.
Perché il Few-Shot Learning è importante?
L'FSL aiuta lo sviluppatore a concentrarsi sullo sviluppo del modello piuttosto che sull'acquisizione dei dati. La capacità di apprendere da dati limitati offre diversi vantaggi:
- Riduzione degli sforzi di raccolta dati. L'FSL attenua la necessità di dataset massivi, facendo risparmiare tempo e risorse nella raccolta e nell'etichettatura.
- Risparmio di potenza computazionale poiché il modello non deve essere addestrato da zero, ma esteso a una nuova categoria di dati
- Affrontare la scarsità di dati. In ambiti in cui i dati sono intrinsecamente scarsi o costosi da acquisire (ad es. malattie rare, specie in via d'estinzione), l'FSL consente lo sviluppo di modelli e l'estrazione di conoscenza.
- Migliore adattabilità. I modelli FSL possono adattarsi rapidamente a nuovi compiti e situazioni, rendendoli versatili e robusti in ambienti dinamici.
N-Shot Learning e le sue varianti
Il few-shot learning rientra nel più ampio ombrello dell'n-shot learning, che comprende varie tecniche in base al numero di esempi forniti:
- Zero-shot learning: Non vengono forniti esempi; il modello si basa esclusivamente su conoscenze pregresse o descrizioni.
- One-shot learning: Viene fornito un solo esempio per classe.
- Two-shot learning: Si usano due esempi per classe per l'addestramento.
- Few-shot learning: È disponibile un piccolo numero di esempi (tipicamente tra 3 e 10) per ciascuna classe.
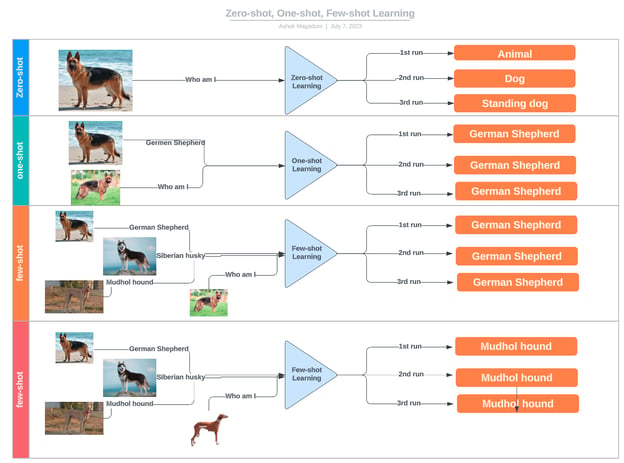
Un diagramma che illustra le differenze tra zero-shot, one-shot e few-shot learning usando esempi di classificazione di razze canine. Fonte: LinkedIn
Come funziona il Few-Shot Learning?
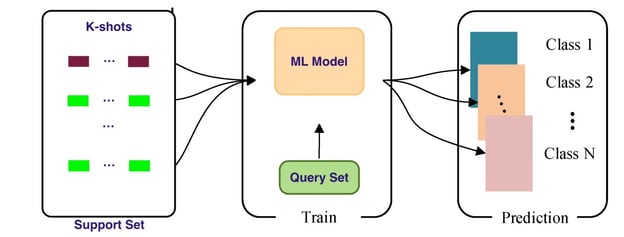
Un diagramma che illustra il processo di few-shot learning. Mostra un support set contenente esempi k-shot per più classi, un modello di machine learning addestrato su un query set e il modello che poi effettua predizioni per nuove istanze di dati su classi diverse. Fonte: LinkedIn
A differenza dell'apprendimento supervisionato tradizionale, che fa affidamento su dataset di training estesi, i modelli di few-shot learning sfruttano conoscenze pregresse ed esperienze di apprendimento per adattarsi rapidamente a nuovi compiti con un minimo di dati aggiuntivi. Cogliendo la struttura sottostante e le caratteristiche salienti che definiscono un concetto, questi modelli riescono a generalizzare efficacemente, effettuando predizioni accurate su istanze nuove a partire da pochi esempi.
Questa conoscenza viene poi applicata per adattarsi rapidamente a nuovi compiti tramite una funzione di similarità che può mettere in corrispondenza le classi nei query e support set con un minimo di informazioni aggiuntive.
Per contesto, il query set qui si riferisce ai campioni sia di vecchie sia di nuove categorie, su cui il modello generalizza e che usa per valutare le prestazioni. Al contrario, il support set è costituito dai pochi campioni etichettati di ogni nuova categoria di dati, usati per aggiornare i parametri del modello:
- Support set (S): Un piccolo insieme di esempi etichettati, S={(x1,y1),…,(xk,yk)}S = \{(x₁, y₁), \ldots, (xₖ, yₖ)\}S={(x1,y1),…,(xk,yk)}, dove ogni esempio consiste in un punto dati xixᵢxi e nella sua etichetta corrispondente yiyᵢyi.
- Query set (Q): Un insieme di punti dati non etichettati, Q={x1′,…,xm′}Q = \{x'₁, \ldots, x'ₘ\}Q={x1′,…,xm′}, per i quali il modello deve predire le etichette.
Diversi approcci al Few-Shot Learning
MAML apprende un'inizializzazione generale del modello che può essere ottimizzata per compiti specifici con pochi passi di gradiente. È un approccio di meta-learning versatile e potente, che consente ai modelli di adattarsi a nuovi compiti con notevole efficienza.
La sua forza risiede nella capacità di apprendere un'inizializzazione che faciliti un apprendimento rapido attraverso pochi passi di discesa del gradiente su un nuovo compito.
Questa caratteristica rende di fatto il modello "facile da ottimizzare", permettendogli di cogliere rapidamente le sottigliezze di compiti inediti con dati minimi.
MAML si basa sul principio di apprendere un insieme di parametri iniziali θ altamente sensibili ai cambiamenti del compito. Questa sensibilità garantisce che piccoli aggiustamenti dei parametri possano migliorare sensibilmente la funzione di perdita di qualsiasi compito estratto dalla distribuzione p(T) quando aggiornati nella direzione del gradiente di tale perdita.
Ecco una scomposizione dell'algoritmo MAML:
- Inizializzazione: Il modello parte da un insieme iniziale di parametri θ.
- Adattamento specifico del compito: Per ciascun compito Tᵢ campionato da p(T), il modello viene addestrato su un support set Sᵢ contenente K esempi usando la discesa del gradiente. Ciò produce parametri specifici del compito θ'ᵢ: dove α rappresenta il learning rate per gli aggiornamenti dell'anello interno (specifici del compito).
- Valutazione: Le prestazioni del modello vengono valutate su un query set Qᵢ usando i parametri adattati θ'ᵢ.
- Meta-aggiornamento: I gradienti dal query set vengono poi usati per aggiornare i parametri iniziali θ. Questo aggiornamento mira a ottimizzare θ affinché un piccolo numero di passi di gradiente su un nuovo compito produca prestazioni ottimali: dove β rappresenta il learning rate per l'aggiornamento dell'anello esterno (meta).
Metric learning
La metric learning si concentra sull'apprendere una funzione di distanza che misuri la similarità tra punti dati. Si focalizza sull'apprendere una funzione di distanza, indicata come d(x, x'), che misura la similarità tra i punti dati x e x'. Questo permette ai modelli di classificare nuovi punti dati confrontandoli con pochi esempi noti.
- Reti siamesi: Usano una coppia di reti identiche per apprendere la similarità tra input.
- Matching networks: Utilizzano meccanismi di attenzione per confrontare un'immagine di query con un support set di esempi etichettati.
- Prototypical networks: Apprendono una rappresentazione prototipica per ciascuna classe e classificano i nuovi punti in base alla distanza da questi prototipi.
Transfer learning
Il transfer learning sfrutta la conoscenza acquisita in un compito sorgente per migliorare le prestazioni in un compito target correlato.
- Modelli preaddestrati: Utilizzano modelli pre-addestrati su grandi dataset e li ottimizzano sul compito di few-shot.
Applicazioni del Few-Shot Learning
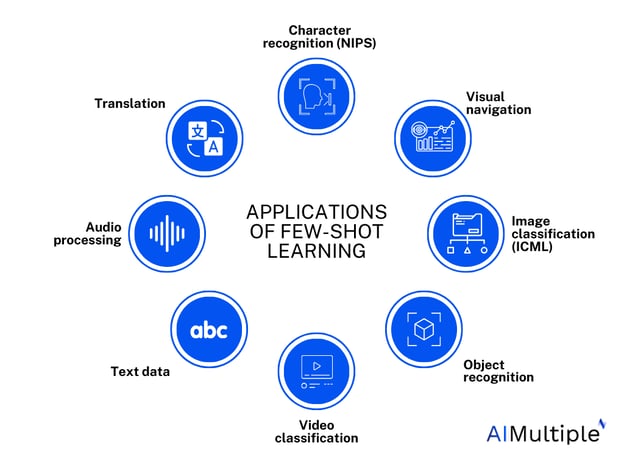
Un riepilogo delle applicazioni dell'FSL in vari domini. Fonte: AI Multiple Research
Le applicazioni del few-shot learning sono vaste e di ampia portata, spaziando dalla computer vision all'elaborazione del linguaggio naturale, dalla robotica all'healthcare. Nel campo della computer vision, per esempio, il few-shot learning può consentire ai sistemi di riconoscere oggetti rari o identificare pattern poco comuni nelle immagini mediche con solo una manciata di esempi di training.
Nel natural language processing, il few-shot learning potrebbe aprire la strada a modelli linguistici personalizzati in grado di imitare lo stile di scrittura o il dialetto di un individuo, rivoluzionando la creazione di contenuti e la comunicazione. Inoltre, ha un enorme potenziale per preservare e tradurre lingue con poche risorse, favorendo una maggiore comprensione culturale e inclusività.
Forse una delle applicazioni più trasformative riguarda la scoperta di farmaci e la sanità. Addestrando modelli su dati limitati provenienti da trial clinici o casi di malattie rare, il few-shot learning potrebbe accelerare lo sviluppo di terapie salvavita e consentire diagnosi più accurate, migliorando in ultima analisi gli esiti per i pazienti.
Sfide e direzioni future
Nonostante l'enorme potenziale, il few-shot learning non è privo di sfide. Uno degli ostacoli principali è il rischio di overfitting, in cui i modelli diventano troppo specializzati sui pochi dati di training e non riescono a generalizzare efficacemente a nuove istanze. Inoltre, la scelta della misura di similarità o della funzione di distanza appropriata è cruciale per ottenere buone prestazioni, e l'ambiguità del compito o i dati rumorosi possono ostacolare ulteriormente l'efficacia del modello.
Tuttavia, queste sfide hanno alimentato un'ondata di ricerca e innovazione nel campo. Approcci come meta-learning, metric learning e transfer learning sono emersi come strategie promettenti per potenziare le capacità del few-shot learning. Tecniche come il Model-Agnostic Meta-Learning (MAML) e le Prototypical Networks hanno dimostrato un successo notevole nell'adattarsi rapidamente a nuovi compiti con dati minimi.
Con l'evolversi del campo, possiamo aspettarci metodi di few-shot learning sempre più sofisticati e robusti, capaci di spingere i confini di ciò che è possibile con dati limitati. In definitiva, il vero potere del few-shot learning risiede nella sua capacità di democratizzare l'AI, rendendola accessibile a domini e applicazioni finora ostacolati dalla scarsità di dati, inaugurando una nuova era di intelligenza artificiale efficiente nei dati, adattabile e inclusiva.
Conclusione
Il few-shot learning rappresenta un passo avanti significativo nel machine learning, permettendoci di estrarre insight da dati limitati. Comprendendo i diversi approcci e le applicazioni, i junior data practitioner possono sfruttare questo potente strumento per affrontare problemi reali in svariati domini.
Con il progredire della ricerca, possiamo aspettarci tecniche di few-shot learning ancora più innovative ed efficienti, in grado di spingere ulteriormente i confini della data science.
Se vuoi padroneggiare altri concetti di machine learning, dai un'occhiata al career track Machine Learning Scientist with Python.





Il campo, in continua espansione, della data science vive di dati, ma acquisire grandi dataset etichettati può diventare un collo di bottiglia significativo nello sviluppo dei modelli. Qui entra in gioco il few-shot learning, che offre un approccio rivoluzionario per ricavare insight di valore a partire da pochi esempi.
A differenza dei tradizionali metodi di apprendimento supervisionato che richiedono enormi quantità di dati, il few-shot learning permette ai modelli di apprendere e adattarsi rapidamente, risultando estremamente rilevante in contesti in cui i dati sono scarsi, costosi da raccogliere o sensibili per natura.
Questo articolo offre una panoramica completa del few-shot learning, analizzandone l'importanza, i meccanismi e le molteplici applicazioni in diversi settori.
Che cos'è il Few-Shot Learning?
Il few-shot learning (FSL) è un sottoinsieme del machine learning in cui i modelli imparano a riconoscere pattern e a fare previsioni sulla base di un numero molto ridotto di esempi di addestramento. Ciò contrasta con l'apprendimento supervisionato tradizionale, che spesso richiede grandi quantità di dati etichettati per un training efficace.
L'FSL privilegia la generalizzazione rispetto alla memorizzazione. Uno dei lavori pionieristici è il paper “Language Models are Few Shot Learners” di Tom B. Brown et al., che mette in discussione la necessità di un esteso fine-tuning.
Un diagramma che illustra la differenza tra approcci di apprendimento supervisionato e few-shot learning. La sezione sull'apprendimento supervisionato mostra un grande dataset etichettato usato per addestrare un modello estrattore di feature, mentre la sezione sul few-shot learning mostra l'uso di un piccolo support set di esempi e di una funzione di similarità per effettuare previsioni su un query set. Fonte: Paperspace
Pensa a un bambino che impara a riconoscere animali diversi. Con pochi esempi di cani, gatti e uccelli, riesce rapidamente a riconoscere e distinguere queste creature in futuro, anche se incontra razze o specie mai viste prima.
Questa capacità di generalizzare da dati limitati è un tratto distintivo dell'intelligenza umana, ed è proprio ciò che il few-shot learning mira a raggiungere.
La chiave sta nella capacità di cogliere la struttura e le caratteristiche di fondo che definiscono una categoria.
Gli esseri umani hanno un'innata capacità di estrarre informazioni essenziali da esperienze limitate e applicarle a nuove situazioni. I modelli di few-shot learning tentano di emulare questo comportamento imparando una comprensione generale della struttura sottostante dei dati a partire da esperienze pregresse.
Questa conoscenza viene poi sfruttata per adattarsi rapidamente a nuovi compiti con un minimo di informazioni aggiuntive, proprio come il bambino che riconosce una nuova razza di cane basandosi sulla conoscenza pregressa dei cani.
Perché il Few-Shot Learning è importante?
L'FSL aiuta lo sviluppatore a concentrarsi sullo sviluppo del modello piuttosto che sull'acquisizione dei dati. La capacità di apprendere da dati limitati offre diversi vantaggi:
N-Shot Learning e le sue varianti
Il few-shot learning rientra nel più ampio ombrello dell'n-shot learning, che comprende varie tecniche in base al numero di esempi forniti:
Un diagramma che illustra le differenze tra zero-shot, one-shot e few-shot learning usando esempi di classificazione di razze canine. Fonte: LinkedIn
Come funziona il Few-Shot Learning?
Un diagramma che illustra il processo di few-shot learning. Mostra un support set contenente esempi k-shot per più classi, un modello di machine learning addestrato su un query set e il modello che poi effettua predizioni per nuove istanze di dati su classi diverse. Fonte: LinkedIn
A differenza dell'apprendimento supervisionato tradizionale, che fa affidamento su dataset di training estesi, i modelli di few-shot learning sfruttano conoscenze pregresse ed esperienze di apprendimento per adattarsi rapidamente a nuovi compiti con un minimo di dati aggiuntivi. Cogliendo la struttura sottostante e le caratteristiche salienti che definiscono un concetto, questi modelli riescono a generalizzare efficacemente, effettuando predizioni accurate su istanze nuove a partire da pochi esempi.
Questa conoscenza viene poi applicata per adattarsi rapidamente a nuovi compiti tramite una funzione di similarità che può mettere in corrispondenza le classi nei query e support set con un minimo di informazioni aggiuntive.
Per contesto, il query set qui si riferisce ai campioni sia di vecchie sia di nuove categorie, su cui il modello generalizza e che usa per valutare le prestazioni. Al contrario, il support set è costituito dai pochi campioni etichettati di ogni nuova categoria di dati, usati per aggiornare i parametri del modello:
Diversi approcci al Few-Shot Learning
Model-Agnostic Meta-Learning (MAML)
MAML apprende un'inizializzazione generale del modello che può essere ottimizzata per compiti specifici con pochi passi di gradiente. È un approccio di meta-learning versatile e potente, che consente ai modelli di adattarsi a nuovi compiti con notevole efficienza.
La sua forza risiede nella capacità di apprendere un'inizializzazione che faciliti un apprendimento rapido attraverso pochi passi di discesa del gradiente su un nuovo compito.
Questa caratteristica rende di fatto il modello "facile da ottimizzare", permettendogli di cogliere rapidamente le sottigliezze di compiti inediti con dati minimi.
MAML si basa sul principio di apprendere un insieme di parametri iniziali θ altamente sensibili ai cambiamenti del compito. Questa sensibilità garantisce che piccoli aggiustamenti dei parametri possano migliorare sensibilmente la funzione di perdita di qualsiasi compito estratto dalla distribuzione p(T) quando aggiornati nella direzione del gradiente di tale perdita.
Ecco una scomposizione dell'algoritmo MAML:
Metric learning
La metric learning si concentra sull'apprendere una funzione di distanza che misuri la similarità tra punti dati. Si focalizza sull'apprendere una funzione di distanza, indicata come d(x, x'), che misura la similarità tra i punti dati x e x'. Questo permette ai modelli di classificare nuovi punti dati confrontandoli con pochi esempi noti.
Transfer learning
Il transfer learning sfrutta la conoscenza acquisita in un compito sorgente per migliorare le prestazioni in un compito target correlato.
Applicazioni del Few-Shot Learning
Un riepilogo delle applicazioni dell'FSL in vari domini. Fonte: AI Multiple Research
Le applicazioni del few-shot learning sono vaste e di ampia portata, spaziando dalla computer vision all'elaborazione del linguaggio naturale, dalla robotica all'healthcare. Nel campo della computer vision, per esempio, il few-shot learning può consentire ai sistemi di riconoscere oggetti rari o identificare pattern poco comuni nelle immagini mediche con solo una manciata di esempi di training.
Nel natural language processing, il few-shot learning potrebbe aprire la strada a modelli linguistici personalizzati in grado di imitare lo stile di scrittura o il dialetto di un individuo, rivoluzionando la creazione di contenuti e la comunicazione. Inoltre, ha un enorme potenziale per preservare e tradurre lingue con poche risorse, favorendo una maggiore comprensione culturale e inclusività.
Forse una delle applicazioni più trasformative riguarda la scoperta di farmaci e la sanità. Addestrando modelli su dati limitati provenienti da trial clinici o casi di malattie rare, il few-shot learning potrebbe accelerare lo sviluppo di terapie salvavita e consentire diagnosi più accurate, migliorando in ultima analisi gli esiti per i pazienti.
Sfide e direzioni future
Nonostante l'enorme potenziale, il few-shot learning non è privo di sfide. Uno degli ostacoli principali è il rischio di overfitting, in cui i modelli diventano troppo specializzati sui pochi dati di training e non riescono a generalizzare efficacemente a nuove istanze. Inoltre, la scelta della misura di similarità o della funzione di distanza appropriata è cruciale per ottenere buone prestazioni, e l'ambiguità del compito o i dati rumorosi possono ostacolare ulteriormente l'efficacia del modello.
Tuttavia, queste sfide hanno alimentato un'ondata di ricerca e innovazione nel campo. Approcci come meta-learning, metric learning e transfer learning sono emersi come strategie promettenti per potenziare le capacità del few-shot learning. Tecniche come il Model-Agnostic Meta-Learning (MAML) e le Prototypical Networks hanno dimostrato un successo notevole nell'adattarsi rapidamente a nuovi compiti con dati minimi.
Con l'evolversi del campo, possiamo aspettarci metodi di few-shot learning sempre più sofisticati e robusti, capaci di spingere i confini di ciò che è possibile con dati limitati. In definitiva, il vero potere del few-shot learning risiede nella sua capacità di democratizzare l'AI, rendendola accessibile a domini e applicazioni finora ostacolati dalla scarsità di dati, inaugurando una nuova era di intelligenza artificiale efficiente nei dati, adattabile e inclusiva.
Conclusione
Il few-shot learning rappresenta un passo avanti significativo nel machine learning, permettendoci di estrarre insight da dati limitati. Comprendendo i diversi approcci e le applicazioni, i junior data practitioner possono sfruttare questo potente strumento per affrontare problemi reali in svariati domini.
Con il progredire della ricerca, possiamo aspettarci tecniche di few-shot learning ancora più innovative ed efficienti, in grado di spingere ulteriormente i confini della data science.
Se vuoi padroneggiare altri concetti di machine learning, dai un'occhiata al career track Machine Learning Scientist with Python.