

Configurare Amazon Polly
Ora passiamo alla pratica e configuriamo Amazon Polly! In questa sezione trovi una panoramica dei passaggi necessari.
Passaggio 1: Creare un account AWS
Per usare Amazon Polly, ti serve innanzitutto un account AWS. Se non ne hai già uno, vai alla pagina di registrazione ad AWS e segui i passaggi per crearlo. Assicurati di fornire informazioni di fatturazione valide, perché i servizi AWS, incluso Polly, sono fatturati in base all’uso.
Configurazione IAM per i permessi
Ti consiglio di configurare un utente IAM (Identity and Access Management) con i permessi necessari per gestire le risorse di Amazon Polly. Assegna la policy AmazonPollyFullAccess per garantire all’utente l’accesso a tutte le funzionalità di Polly.
Passaggio 2: Accedere ad Amazon Polly
Dopo aver effettuato l’accesso alla AWS Management Console, cerca Polly nella barra di ricerca in alto.
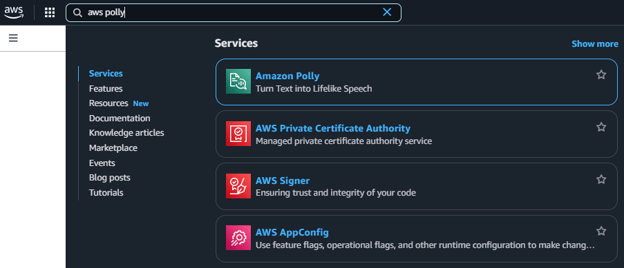
Il menu di ricerca nella console AWS.
Clicca sul servizio Amazon Polly per accedere all’interfaccia di Polly.
Usare Amazon Polly per il Text-to-Speech
Di solito, gli sviluppatori usano le API di Amazon Polly per integrare il text-to-speech direttamente nelle loro applicazioni. Tuttavia, puoi anche usare l’interfaccia AWS Polly per provare rapidamente diverse voci e impostazioni senza scrivere codice. Per farlo, clicca sul pulsante Try Polly nell’interfaccia di Polly. Questo pulsante ti permette di sperimentare con vari testi, tipi di voce e formati di output dalla Console AWS, rendendo facile esplorare le funzionalità di Polly prima di implementarle via codice.
Conversione base da testo a voce
Per eseguire una conversione base testo-voce, inserisci una frase come "Hello, welcome to Amazon Polly!" nella casella di input. Puoi anche scegliere il tipo di motore (ad esempio generative, long-form, neural o standard), la lingua e la voce. Clicca su Listen per ascoltare subito l’output oppure su Download per scaricarlo come file .mp3.
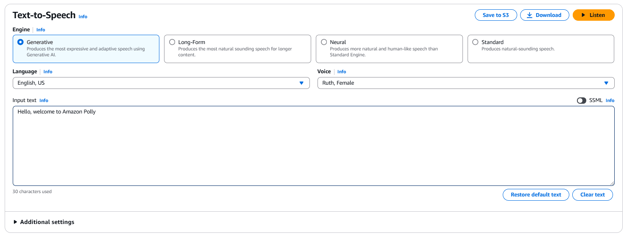
L’interfaccia di Amazon Polly nella console AWS.
Configurare l’AWS SDK per il text-to-speech
Per integrare Amazon Polly nel tuo codice, devi configurare l’AWS SDK. In questo modo puoi interagire con Amazon Polly direttamente dall’applicazione, abilitando funzionalità di sintesi vocale più dinamiche e personalizzabili.
In questo tutorial useremo il Python SDK (boto3). Installa boto3 tramite pip:
pip install boto3Poi configura le credenziali AWS usando la AWS CLI:
aws configure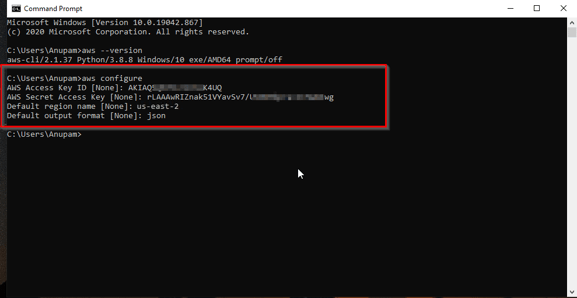
Il comando aws configure sulla CLI.
Generare voce tramite SDK
Ecco un semplice script Python per convertire il testo in voce usando Amazon Polly:
import boto3
polly = boto3.client('polly')
response = polly.synthesize_speech(
Text='Hello, this is a test of Amazon Polly.',
OutputFormat='mp3',
VoiceId='Joanna'
)
with open('speech.mp3', 'wb') as file:
file.write(response['AudioStream'].read())Questo script genera voce a partire dal testo e la salva in un file mp3.
Funzionalità avanzate di Amazon Polly
Sebbene Amazon Polly sia noto soprattutto per la sintesi vocale di base, offre anche diverse funzionalità avanzate che consentono agli sviluppatori di creare esperienze vocali più sofisticate e interattive.
Uso di SSML (Speech Synthesis Markup Language)
SSML (Speech Synthesis Markup Language) permette di controllare vari aspetti del parlato, come intonazione, velocità, volume ed enfasi, rendendo l’output audio più espressivo e naturale.
Con i tag SSML puoi aggiungere pause, regolare gli stili di parlato e persino sillabare le sigle lettera per lettera. Questa flessibilità è particolarmente utile in contesti come la narrazione, le piattaforme di e-learning e le applicazioni di customer service, dove tono e modalità di erogazione influiscono significativamente sul coinvolgimento.
Per esempio, puoi enfatizzare alcune parole per sottolinearne l’importanza o modificare la velocità per contenuti didattici al fine di garantire chiarezza.
Ecco come usare SSML con l’SDK di Polly:
response = polly.synthesize_speech(
Text="<speak><emphasis level='strong'>Important</emphasis> message!</speak>",
TextType='ssml',
OutputFormat='mp3',
VoiceId='Matthew'
)
# Save the audio file
with open('speech_ssml.mp3', 'wb') as file:
file.write(response['AudioStream'].read())Questo esempio enfatizza la parola "Important" per farla risaltare nel messaggio parlato, aumentando l’impatto emotivo su chi ascolta. SSML supporta anche funzionalità avanzate come la pronuncia dei fonemi, il sussurro e l’aggiunta di effetti sonori, offrendo un controllo completo sull’esperienza vocale.
Speech marks per la sincronizzazione labiale
Gli speech marks forniscono metadati allineati temporalmente, permettendo di sincronizzare la voce con animazioni, evidenziazione del testo o movimenti delle labbra dei personaggi.
Questa funzione è particolarmente utile per applicazioni interattive come personaggi virtuali, giochi educativi o evidenziazione del testo in stile karaoke.
Richiedendo gli speech marks insieme alla sintesi vocale, ottieni informazioni temporali dettagliate per ogni parola o frase, permettendoti di creare esperienze multimediali dinamiche e sincronizzate.
Per esempio, puoi animare i movimenti della bocca di un personaggio in sincronia con le parole pronunciate o evidenziare il testo in tempo reale mentre viene narrato. Ecco come richiedere gli speech marks:
response = polly.synthesize_speech(
Text='Hello, world!',
OutputFormat='json',
VoiceId='Emma',
SpeechMarkTypes=['word']
)
# Save the speech marks to a JSON file
with open('speech_marks.json', 'wb') as file:
file.write(response['AudioStream'].read())Output JSON:
{"time":6,"type":"word","start":0,"end":5,"value":"Hello"}
{"time":714,"type":"word","start":7,"end":12,"value":"world"}Nell’esempio sopra si richiedono gli speech marks per ogni parola, ottenendo oggetti JSON con timestamp e testo. Gli sviluppatori possono usare queste informazioni per sincronizzare le animazioni frame-by-frame, rendendo l’esperienza audio-visiva più coinvolgente e realistica.
Streaming in tempo reale con Amazon Polly
Per applicazioni in tempo reale come assistenti vocali, commenti live o chatbot interattivi, Amazon Polly supporta lo streaming tramite protocollo WebSocket o lettori multimediali compatibili con HLS (HTTP Live Streaming).
Questo consente alle applicazioni di iniziare a riprodurre l’audio mentre viene sintetizzato, riducendo la latenza e offrendo un’esperienza più reattiva. Lo streaming in tempo reale è ideale quando l’immediatezza è critica, come nel supporto clienti live o nell’IA conversazionale.
Gli sviluppatori possono sfruttare questa funzione per creare dispositivi attivati dalla voce, lettori di notizie o applicazioni di storytelling interattive che rispondono al volo agli input dell’utente.
Gestione delle risorse di Amazon Polly
Una gestione efficace delle risorse di Amazon Polly è fondamentale per ottimizzare prestazioni, costi e scalabilità. Conservando strategicamente i file audio e monitorando l’utilizzo, puoi garantire un uso efficiente delle risorse mantenendo alta la qualità dell’esperienza utente.
Amazon Polly si integra perfettamente con altri servizi AWS, come Amazon S3 per l’archiviazione e l’AWS Billing Dashboard per il monitoraggio dei costi, semplificando la gestione delle risorse.
Creare e gestire i file audio
Amazon Polly ti permette di archiviare la voce sintetizzata in Amazon S3 per uno storage scalabile e un facile recupero. Questo approccio è particolarmente utile per applicazioni con necessità audio ricorrenti, come piattaforme di e-learning, audiolibri o bot di supporto clienti, dove puoi riutilizzare i file audio invece di sintetizzare ogni volta.
Archiviando in S3 gli output vocali usati di frequente, puoi ridurre i costi e migliorare le prestazioni servendo direttamente file audio in cache dal cloud.
s3 = boto3.client('s3')
s3.upload_file('speech.mp3', 'your-bucket-name', 'speech.mp3')Monitorare utilizzo e costi
Sfrutta l’AWS Billing and Cost Management Dashboard per monitorare in modo efficiente utilizzo e costi. La dashboard offre dettagli sui costi, report di utilizzo e la possibilità di impostare budget e avvisi per evitare addebiti imprevisti.
Il monitoraggio dei costi è particolarmente importante quando utilizzi voci neurali, più costose rispetto a quelle standard. Puoi anche tracciare metriche come il numero di caratteri sintetizzati e la frequenza delle chiamate API, utili per ottimizzare l’uso delle risorse.
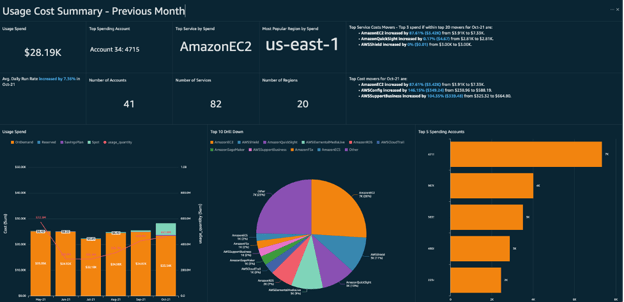
Esempio di dashboard dei costi AWS.
Best practice per usare Amazon Polly
Quando usi Amazon Polly, adottare le best practice garantisce prestazioni ottimali, efficienza dei costi e una buona esperienza utente. Ecco alcune linee guida chiave:
Scegliere la voce giusta
La scelta della voce dipende dallo scopo dell’applicazione e dal pubblico di riferimento. Amazon Polly offre una varietà di voci, tra cui standard e neurali, ciascuna con tono e caratteristiche proprie.
- Le voci neurali offrono un suono più naturale ed espressivo ma costano di più. Sono quindi ideali per applicazioni che richiedono un alto coinvolgimento emotivo, come audiolibri o narrazione.
- Le voci standard sono una soluzione conveniente per applicazioni orientate all’utilità, come i chatbot di supporto clienti. Testare diverse voci con feedback degli utenti aiuta a selezionare quella più adatta alle esigenze della tua applicazione.
Ottimizzare l’output vocale
Sfrutta SSML (Speech Synthesis Markup Language) per migliorare la qualità della voce regolando intonazione, velocità e volume. Affinando queste impostazioni puoi creare un’esperienza audio più dinamica e coinvolgente.
Per esempio, rallentare la velocità migliora la chiarezza nei contenuti didattici, mentre enfatizzare le frasi chiave valorizza la narrazione. Sperimentare con i diversi tag SSML ti aiuta a ottenere una voce il più naturale possibile.
Ridurre i costi
Per ottimizzare i costi con Amazon Polly, valuta strategie come gestire la frequenza di generazione della voce e archiviare in S3 i file audio usati di frequente per riutilizzarli. Questo approccio riduce le chiamate API ripetute e i costi di sintesi.
Inoltre, usare in modo strategico un mix di voci standard e neurali può bilanciare costo e qualità.
Per esempio, utilizza le voci neurali solo nei touchpoint critici come i messaggi di benvenuto, lasciando alle voci standard i contenuti informativi. Impostare limiti di utilizzo e avvisi di costo nella AWS Billing Dashboard aiuta a mantenere il controllo del budget ed evitare spese inattese.
Conclusione
Amazon Polly è un potente servizio di text-to-speech che sfrutta tecnologie avanzate di deep learning per convertire il testo in una voce realistica, migliorando l’esperienza utente e l’accessibilità.
In questo tutorial abbiamo esplorato le funzionalità fondamentali di Amazon Polly, dalla configurazione dell’AWS SDK alla generazione programmata della voce. Abbiamo inoltre visto capacità avanzate come l’uso di SSML per personalizzare l’output, gli Speech Marks per la sincronizzazione e le animazioni, e lo streaming in tempo reale per applicazioni vocali dinamiche.
Integrando Amazon Polly nelle tue applicazioni, puoi creare esperienze vocali altamente interattive e personalizzate per un pubblico globale. Che tu stia sviluppando assistenti virtuali, audiolibri, piattaforme educative o strumenti di accessibilità, Amazon Polly offre flessibilità, scalabilità e funzionalità avanzate per dare vita alle tue idee.
Se sei alle prime armi con AWS e vuoi rafforzare le tue competenze cloud, dai un’occhiata a questi corsi correlati:
- AWS Concepts – Impara i concetti fondamentali del cloud computing AWS.
- AWS Cloud Technology and Services – Esercitati con i principali servizi AWS e le loro applicazioni pratiche.
- AWS Security and Cost Management – Scopri le best practice per mettere in sicurezza le risorse AWS e ottimizzare i costi.
- AWS Cloud Practitioner Certification Track – Preparati all’esame AWS Cloud Practitioner CLF-C02 con un percorso strutturato.
FAQ
In che modo Amazon Polly si confronta con altri servizi TTS?
Amazon Polly si distingue per la sua tecnologia NTTS (neural text-to-speech) avanzata, che produce una voce più naturale ed espressiva rispetto ai sistemi TTS tradizionali. Supporta inoltre SSML per la personalizzazione della voce, Speech Marks per la sincronizzazione labiale e lo streaming in tempo reale, risultando più flessibile e potente di molte altre soluzioni TTS.
Amazon Polly supporta la creazione di voci personalizzate?
No, al momento Amazon Polly non supporta la creazione di voci personalizzate. Tuttavia, offre un’ampia gamma di voci neurali e standard in più lingue, insieme a SSML (Speech Synthesis Markup Language) per regolare intonazione, velocità, volume e stile di parlato. Se ti serve una voce altamente personalizzata, potresti valutare altre soluzioni TTS come Google Cloud Text-to-Speech o fornitori specializzati in voci custom.
Amazon Polly è adatto a generare contenuti long-form, come audiolibri o podcast?
Sì, Amazon Polly offre la sintesi long-form per generare contenuti audio estesi, come audiolibri o podcast. Supporta l’uso del motore NTTS (Neural Text-to-Speech), che fornisce una voce più naturale adatta alla narrazione e alle applicazioni orientate al racconto. Puoi anche suddividere script lunghi in segmenti gestibili per mantenere prestazioni e qualità.
Si può usare Amazon Polly offline?
No, Amazon Polly è un servizio basato sul cloud e richiede una connessione Internet attiva per elaborare le richieste di text-to-speech. Tuttavia, puoi generare e scaricare i file audio per l’uso offline dopo la sintesi. Questo è comodo per applicazioni che necessitano di contenuti vocali preregistrati, come audiolibri, annunci o video didattici.
Esistono limiti o quote di utilizzo per Amazon Polly?
Sì, Amazon Polly prevede quote e limiti di utilizzo, come il numero di caratteri sintetizzabili per richiesta e per account. I limiti specifici variano a seconda che tu stia usando il Free Tier o un piano a pagamento. Per evitare interruzioni, puoi monitorare l’utilizzo e impostare avvisi tramite l’AWS Billing and Cost Management Dashboard. Per applicazioni ad alto volume, puoi richiedere un aumento delle quote tramite l’AWS Support Center.





Nell’era post-GPT, l’interazione vocale sta diventando sempre più essenziale, dagli assistenti virtuali alle funzionalità di accessibilità che aiutano le persone con disabilità visive a navigare nei contenuti digitali. Amazon Polly non solo semplifica l’aggiunta del text-to-speech, ma consente anche un’esperienza utente altamente personalizzata e immersiva grazie al supporto per più lingue e a un’ampia gamma di voci.
Questo tutorial ha l’obiettivo di mostrarti come configurare Amazon Polly e integrarlo nelle applicazioni, sbloccando il potenziale dell’interazione vocale e aprendo la strada a esperienze digitali più dinamiche e accessibili.
Che cos’è Amazon Polly?
Amazon Polly è un servizio di sintesi vocale (Text-to-Speech, TTS) che utilizza tecnologie avanzate di deep learning per generare una voce naturale. Si distingue come uno dei servizi TTS più sofisticati disponibili, permettendo agli sviluppatori di creare applicazioni che possono “parlare” in modo sorprendentemente umano. Il servizio supporta oltre 60 voci in più di 30 lingue, soddisfacendo un pubblico globale con esigenze linguistiche diversificate.
Una delle caratteristiche chiave di Amazon Polly è l’uso della tecnologia NTTS (neural text-to-speech), che offre voci più espressive e naturali rispetto ai tradizionali sistemi di sintesi vocale. Ciò include la regolazione di attributi come intonazione, volume e velocità di parlato, dando agli sviluppatori un controllo preciso sull’output audio. Per esempio, è possibile rendere il parlato più allegro, entusiasta o empatico, migliorando la connessione emotiva con l’utente.
Amazon Polly supporta anche funzionalità come gli speech marks, che permettono di sincronizzare la voce con elementi visivi, come l’evidenziazione del testo durante la lettura o l’animazione di personaggi per la sincronizzazione labiale con l’audio. Questo lo rende una soluzione ideale per narrazioni interattive, contenuti educativi e strumenti di accessibilità.
Che tu stia creando un assistente virtuale attivato dalla voce, una piattaforma di audiolibri o un dispositivo IoT con funzionalità vocali, Amazon Polly offre la flessibilità e la scalabilità necessarie per dare vita alle tue idee.