

Thiết lập Amazon Polly
Giờ hãy bắt tay vào thiết lập Amazon Polly! Phần này cung cấp tổng quan cách thực hiện.
Bước 1: Tạo tài khoản AWS
Để sử dụng Amazon Polly, trước tiên bạn cần một tài khoản AWS. Nếu chưa có, hãy truy cập trang đăng ký AWS và làm theo các bước để tạo tài khoản. Hãy đảm bảo cung cấp thông tin thanh toán hợp lệ, vì các dịch vụ AWS, bao gồm Polly, được tính phí theo mức sử dụng.
Thiết lập IAM cho quyền truy cập
Tôi khuyến nghị thiết lập người dùng IAM (Identity and Access Management) với các quyền cần thiết để quản lý tài nguyên Amazon Polly. Gán chính sách AmazonPollyFullAccess để đảm bảo người dùng có thể truy cập toàn bộ tính năng của Polly.
Bước 2: Điều hướng đến Amazon Polly
Sau khi đăng nhập AWS Management Console, hãy tìm Polly trên thanh tìm kiếm ở phía trên.
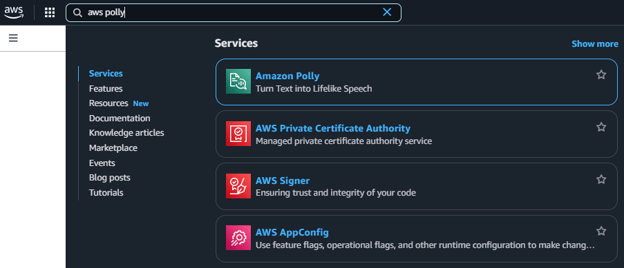
Menu tìm kiếm trong bảng điều khiển AWS.
Nhấp vào dịch vụ Amazon Polly để vào giao diện Polly.
Sử dụng Amazon Polly cho Text-to-Speech
Thông thường, nhà phát triển sử dụng API của Amazon Polly để tích hợp chức năng chuyển văn bản thành giọng nói trực tiếp vào ứng dụng. Tuy nhiên, bạn cũng có thể dùng giao diện AWS Polly để nhanh chóng thử các giọng đọc và thiết lập khác nhau mà không cần viết mã. Để làm điều đó, nhấp vào nút Try Polly trong giao diện Polly. Nút này cho phép bạn thử nghiệm nhiều đầu vào văn bản, kiểu giọng và định dạng đầu ra ngay từ AWS Console, giúp bạn dễ dàng khám phá khả năng của Polly trước khi triển khai bằng mã.
Chuyển văn bản thành giọng nói cơ bản
Để thực hiện chuyển đổi cơ bản, hãy nhập một câu như "Hello, welcome to Amazon Polly!" vào ô nhập. Bạn cũng có thể chọn loại engine (ví dụ: Generative, long-form, neural hoặc standard), ngôn ngữ và giọng đọc. Nhấp Listen để nghe ngay lập tức hoặc nhấp Download để tải xuống dưới dạng tệp .mp3.
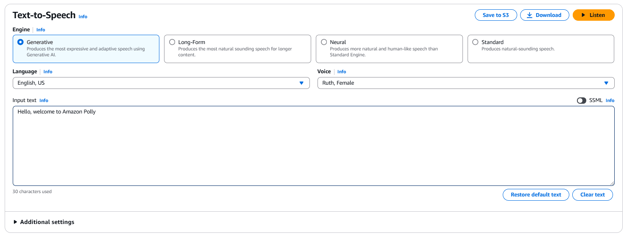
Giao diện Amazon Polly trong bảng điều khiển AWS.
Thiết lập AWS SDK cho chuyển văn bản thành giọng nói
Bạn cần thiết lập AWS SDK để tích hợp Amazon Polly vào ứng dụng bằng lập trình. Điều này cho phép bạn tương tác với Amazon Polly trực tiếp từ mã nguồn, kích hoạt các chức năng chuyển văn bản thành giọng nói động và tùy biến hơn.
Trong hướng dẫn này, chúng ta sẽ sử dụng Python SDK (boto3). Cài đặt boto3 qua pip:
pip install boto3Sau đó, cấu hình thông tin xác thực AWS của bạn bằng AWS CLI:
aws configure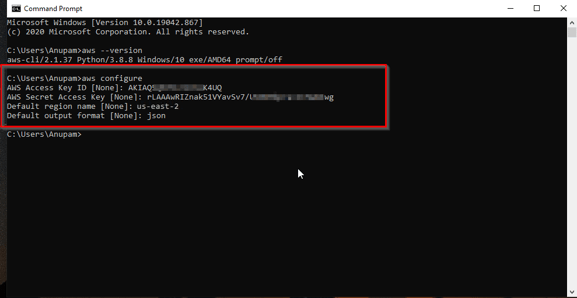
Lệnh aws configure trên CLI.
Tạo giọng nói qua SDK
Dưới đây là một đoạn script Python đơn giản để chuyển văn bản thành giọng nói bằng Amazon Polly:
import boto3
polly = boto3.client('polly')
response = polly.synthesize_speech(
Text='Hello, this is a test of Amazon Polly.',
OutputFormat='mp3',
VoiceId='Joanna'
)
with open('speech.mp3', 'wb') as file:
file.write(response['AudioStream'].read())Đoạn script này tạo giọng nói từ văn bản và lưu dưới dạng tệp mp3.
Các tính năng nâng cao của Amazon Polly
Bên cạnh chức năng chuyển văn bản thành giọng nói cơ bản, Amazon Polly còn cung cấp nhiều tính năng nâng cao giúp nhà phát triển tạo trải nghiệm giọng nói tinh vi và tương tác hơn.
Sử dụng SSML (Speech Synthesis Markup Language)
SSML (Speech Synthesis Markup Language) cho phép kiểm soát nhiều khía cạnh lời nói như cao độ, tốc độ, âm lượng và nhấn giọng, giúp đầu ra âm thanh biểu cảm và tự nhiên hơn.
Bằng cách sử dụng thẻ SSML, bạn có thể chèn ngắt nghỉ, điều chỉnh phong cách nói, thậm chí đánh vần từng chữ cái của từ viết tắt. Tính linh hoạt này đặc biệt hữu ích cho các tình huống như kể chuyện, nền tảng e-learning và ứng dụng chăm sóc khách hàng, nơi giọng điệu và cách truyền đạt ảnh hưởng lớn đến mức độ tương tác.
Ví dụ, bạn có thể nhấn mạnh một số từ để thể hiện tầm quan trọng hoặc thay đổi tốc độ nói cho nội dung hướng dẫn để đảm bảo rõ ràng.
Cách dùng SSML với Polly SDK:
response = polly.synthesize_speech(
Text="<speak><emphasis level='strong'>Important</emphasis> message!</speak>",
TextType='ssml',
OutputFormat='mp3',
VoiceId='Matthew'
)
# Save the audio file
with open('speech_ssml.mp3', 'wb') as file:
file.write(response['AudioStream'].read())Ví dụ này nhấn mạnh từ "Important" để làm nổi bật trong thông điệp được đọc, tăng tác động cảm xúc với người nghe. SSML cũng hỗ trợ các tính năng nâng cao như phiên âm theo âm vị, thì thầm và thêm hiệu ứng âm thanh, giúp nhà phát triển kiểm soát hoàn toàn trải nghiệm giọng nói.
Speech marks để khớp môi
Speech marks cung cấp siêu dữ liệu căn thời gian, cho phép đồng bộ giọng nói với hoạt ảnh, tô sáng văn bản hoặc cử động môi của nhân vật.
Tính năng này đặc biệt giá trị cho các ứng dụng tương tác như nhân vật ảo, trò chơi giáo dục hoặc tô sáng văn bản kiểu karaoke.
Bằng cách yêu cầu speech marks cùng với tổng hợp giọng nói, bạn nhận được thông tin thời gian chi tiết cho từng từ hoặc câu, cho phép tạo trải nghiệm đa phương tiện đồng bộ và sinh động.
Ví dụ, bạn có thể tạo hoạt ảnh cử động miệng của nhân vật khớp với từ được đọc hoặc tô sáng văn bản theo thời gian thực khi được thuyết minh. Cách yêu cầu speech marks:
response = polly.synthesize_speech(
Text='Hello, world!',
OutputFormat='json',
VoiceId='Emma',
SpeechMarkTypes=['word']
)
# Save the speech marks to a JSON file
with open('speech_marks.json', 'wb') as file:
file.write(response['AudioStream'].read())JSON đầu ra:
{"time":6,"type":"word","start":0,"end":5,"value":"Hello"}
{"time":714,"type":"word","start":7,"end":12,"value":"world"}Ví dụ trên yêu cầu speech marks cho từng từ, trả về đối tượng JSON chứa dấu thời gian và dữ liệu văn bản. Nhà phát triển có thể dùng thông tin này để đồng bộ hoạt ảnh theo từng khung hình, giúp trải nghiệm nghe nhìn hấp dẫn và chân thực hơn.
Phát trực tuyến thời gian thực với Amazon Polly
Đối với các ứng dụng thời gian thực như trợ lý giọng nói, bình luận trực tiếp hoặc chatbot tương tác, Amazon Polly hỗ trợ phát trực tuyến bằng giao thức WebSocket hoặc qua trình phát hỗ trợ HLS (HTTP Live Streaming).
Điều này cho phép ứng dụng bắt đầu phát âm thanh trong khi đang tổng hợp, giảm độ trễ và mang đến trải nghiệm phản hồi tốt hơn. Phát trực tuyến thời gian thực lý tưởng cho các tình huống đòi hỏi tính tức thì, như hỗ trợ khách hàng trực tuyến hoặc AI hội thoại.
Nhà phát triển có thể tận dụng tính năng này để xây dựng thiết bị kích hoạt bằng giọng nói, trình đọc tin tức hoặc ứng dụng kể chuyện tương tác phản hồi theo đầu vào của người dùng ngay lập tức.
Quản lý tài nguyên Amazon Polly
Quản lý hiệu quả tài nguyên Amazon Polly rất quan trọng để tối ưu hiệu năng, chi phí và khả năng mở rộng. Bằng cách lưu trữ tệp giọng nói hợp lý và theo dõi mức sử dụng, bạn có thể đảm bảo khai thác tài nguyên hiệu quả đồng thời duy trì trải nghiệm người dùng chất lượng cao.
Amazon Polly tích hợp liền mạch với các dịch vụ AWS khác như Amazon S3 để lưu trữ và AWS Billing Dashboard để theo dõi chi phí, giúp việc quản lý tài nguyên dễ dàng hơn.
Tạo và quản lý tệp giọng nói
Amazon Polly cho phép bạn lưu trữ giọng nói đã tổng hợp trên Amazon S3 để có khả năng lưu trữ mở rộng và truy xuất dễ dàng. Cách tiếp cận này đặc biệt hữu ích cho các ứng dụng có nhu cầu âm thanh lặp lại, như nền tảng e-learning, sách nói hoặc bot hỗ trợ khách hàng, nơi bạn có thể tái sử dụng tệp âm thanh thay vì tổng hợp lại mỗi lần.
Bằng cách lưu trữ các đầu ra giọng nói dùng thường xuyên trên S3, bạn có thể giảm chi phí và cải thiện hiệu năng bằng cách phục vụ tệp âm thanh được lưu sẵn trực tiếp từ đám mây.
s3 = boto3.client('s3')
s3.upload_file('speech.mp3', 'your-bucket-name', 'speech.mp3')Theo dõi mức sử dụng và chi phí
Tận dụng AWS Billing and Cost Management Dashboard để theo dõi hiệu quả mức sử dụng và chi phí. Bảng điều khiển này cung cấp phân tích chi phí chi tiết, báo cáo sử dụng và khả năng thiết lập ngân sách và cảnh báo để tránh phát sinh chi phí ngoài ý muốn.
Theo dõi chi phí đặc biệt quan trọng khi sử dụng giọng neural, vốn đắt hơn giọng standard. Bạn cũng có thể theo dõi các số liệu như số ký tự đã tổng hợp và tần suất gọi API, giúp tối ưu việc sử dụng tài nguyên.
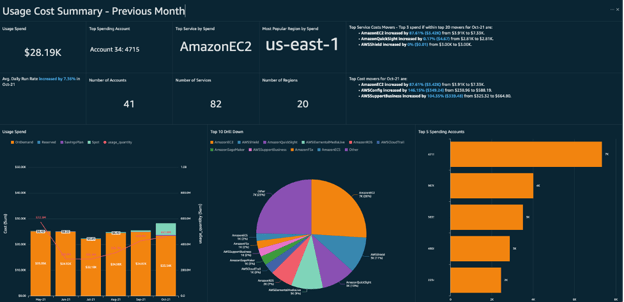
Ví dụ bảng điều khiển chi phí AWS.
Thực hành tốt nhất khi dùng Amazon Polly
Khi sử dụng Amazon Polly, áp dụng các thực hành tốt nhất sẽ đảm bảo hiệu năng, chi phí và trải nghiệm người dùng tối ưu. Dưới đây là một số hướng dẫn chính:
Chọn giọng đọc phù hợp
Việc chọn giọng phù hợp phụ thuộc vào mục đích ứng dụng và đối tượng người dùng. Amazon Polly cung cấp đa dạng giọng đọc, bao gồm giọng standard và giọng neural, mỗi loại có sắc thái và đặc điểm riêng.
- Giọng neural mang lại âm thanh tự nhiên và biểu cảm hơn nhưng chi phí cao hơn. Do đó, phù hợp cho các ứng dụng cần mức độ tương tác cảm xúc cao như sách nói hoặc kể chuyện.
- Giọng standard là giải pháp tiết kiệm chi phí cho các ứng dụng thiên về tiện ích như chatbot hỗ trợ khách hàng. Thử nghiệm các giọng khác nhau kèm phản hồi người dùng sẽ giúp chọn ra giọng phù hợp nhất với nhu cầu ứng dụng.
Tối ưu đầu ra giọng nói
Tận dụng SSML (Speech Synthesis Markup Language) để nâng cao chất lượng giọng nói bằng cách điều chỉnh các tham số cao độ, tốc độ và âm lượng. Bằng cách tinh chỉnh các thiết lập này, bạn có thể tạo trải nghiệm âm thanh sinh động và hấp dẫn hơn.
Chẳng hạn, giảm tốc độ nói giúp cải thiện độ rõ ràng cho nội dung hướng dẫn, trong khi nhấn mạnh các cụm từ quan trọng sẽ tăng hiệu quả kể chuyện. Thử nghiệm các thẻ SSML khác nhau giúp bạn đạt được giọng đọc tự nhiên nhất.
Giảm chi phí
Hãy cân nhắc các chiến lược như quản lý tần suất tạo giọng nói và lưu trữ các tệp âm thanh dùng thường xuyên trên S3 để tái sử dụng nhằm tối ưu chi phí khi dùng Amazon Polly. Cách này giúp giảm số lần gọi API lặp lại và chi phí tổng hợp.
Ngoài ra, sử dụng kết hợp chiến lược giữa giọng standard và neural có thể cân bằng giữa chi phí và chất lượng.
Ví dụ, chỉ dùng giọng neural cho các điểm chạm quan trọng như thông điệp chào mừng, trong khi giọng standard xử lý nội dung thông tin. Thiết lập giới hạn sử dụng và cảnh báo chi phí trong AWS Billing Dashboard giúp kiểm soát ngân sách và tránh chi phí bất ngờ.
Kết luận
Amazon Polly là dịch vụ chuyển văn bản thành giọng nói mạnh mẽ, tận dụng công nghệ học sâu tiên tiến để biến văn bản thành giọng nói sống động, nâng cao trải nghiệm người dùng và khả năng tiếp cận.
Xuyên suốt hướng dẫn này, chúng ta đã khám phá các tính năng nền tảng của Amazon Polly, từ thiết lập AWS SDK đến tạo giọng nói bằng lập trình. Chúng ta cũng đã đề cập các khả năng nâng cao như dùng SSML để tùy chỉnh đầu ra, tận dụng Speech Marks để khớp môi và hoạt ảnh, cũng như triển khai phát trực tuyến thời gian thực cho các ứng dụng giọng nói động.
Tích hợp Amazon Polly vào ứng dụng giúp bạn tạo trải nghiệm giọng nói tương tác cao và cá nhân hóa cho khán giả toàn cầu. Dù bạn đang xây dựng trợ lý ảo, sách nói, nền tảng giáo dục hay công cụ hỗ trợ tiếp cận, Amazon Polly mang đến sự linh hoạt, khả năng mở rộng và các tính năng nâng cao cần thiết để hiện thực hóa ý tưởng.
Nếu bạn mới làm quen với AWS và muốn củng cố kỹ năng đám mây, hãy tham khảo các khóa học liên quan sau:
- AWS Concepts – Tìm hiểu các khái niệm nền tảng của điện toán đám mây AWS.
- AWS Cloud Technology and Services – Thực hành với các dịch vụ AWS chủ chốt và ứng dụng thực tiễn.
- AWS Security and Cost Management – Hiểu các thực hành tốt nhất để bảo mật tài nguyên AWS và tối ưu chi phí.
- AWS Cloud Practitioner Certification Track – Chuẩn bị cho kỳ thi AWS Cloud Practitioner CLF-C02 với lộ trình học tập có cấu trúc.
FAQs
Amazon Polly khác gì so với các dịch vụ TTS khác?
Amazon Polly nổi bật nhờ công nghệ neural text-to-speech (NTTS) tiên tiến, tạo ra giọng nói tự nhiên và biểu cảm hơn so với các hệ thống TTS truyền thống. Dịch vụ cũng hỗ trợ SSML để tùy chỉnh giọng nói, Speech Marks để khớp môi, và phát trực tuyến thời gian thực, giúp linh hoạt và mạnh mẽ hơn nhiều giải pháp TTS khác.
Amazon Polly có hỗ trợ tạo giọng tùy chỉnh không?
Hiện tại, Amazon Polly không hỗ trợ tạo giọng tùy chỉnh. Tuy nhiên, dịch vụ cung cấp nhiều giọng neural và standard bằng nhiều ngôn ngữ, cùng với SSML (Speech Synthesis Markup Language) để điều chỉnh cao độ, tốc độ, âm lượng và phong cách nói. Nếu bạn cần giọng tùy biến cao, có thể cân nhắc các giải pháp TTS khác như Google Cloud Text-to-Speech hoặc các nhà cung cấp giọng tùy chỉnh.
Amazon Polly có phù hợp để tạo nội dung dài, như sách nói hoặc podcast không?
Có, Amazon Polly cung cấp tổng hợp dạng dài (long-form) để tạo nội dung âm thanh kéo dài như sách nói hoặc podcast. Dịch vụ hỗ trợ engine NTTS (Neural Text-to-Speech), mang lại giọng nói tự nhiên phù hợp cho kể chuyện và nội dung thiên về tường thuật. Bạn cũng có thể chia nhỏ kịch bản dài thành các phân đoạn dễ quản lý để duy trì hiệu năng và chất lượng.
Có thể dùng Amazon Polly ngoại tuyến không?
Không, Amazon Polly là dịch vụ dựa trên đám mây và yêu cầu kết nối Internet hoạt động để xử lý yêu cầu chuyển văn bản thành giọng nói. Tuy nhiên, bạn có thể tạo và tải xuống tệp âm thanh để sử dụng ngoại tuyến sau khi tổng hợp. Điều này rất tiện cho các ứng dụng cần nội dung giọng nói ghi sẵn, như sách nói, thông báo hoặc video hướng dẫn.
Amazon Polly có giới hạn sử dụng hoặc hạn ngạch không?
Có, Amazon Polly có hạn ngạch và giới hạn sử dụng, chẳng hạn số ký tự bạn có thể tổng hợp mỗi yêu cầu và mỗi tài khoản. Giới hạn cụ thể thay đổi tùy theo bạn dùng Free Tier hay gói trả phí. Để tránh gián đoạn, bạn có thể theo dõi mức sử dụng và thiết lập cảnh báo bằng AWS Billing and Cost Management Dashboard. Với ứng dụng lưu lượng lớn, bạn có thể yêu cầu tăng hạn ngạch qua AWS Support Center.


Trong kỷ nguyên hậu GPT, tương tác bằng giọng nói ngày càng trở nên thiết yếu, từ trợ lý ảo đến các tính năng hỗ trợ tiếp cận giúp người khiếm thị điều hướng nội dung số. Amazon Polly không chỉ giúp bổ sung chức năng chuyển văn bản thành giọng nói dễ dàng hơn mà còn cho phép cá nhân hóa sâu và trải nghiệm đắm chìm nhờ hỗ trợ nhiều ngôn ngữ và dải giọng đọc phong phú.
Hướng dẫn này nhằm giúp bạn thiết lập Amazon Polly và tích hợp vào ứng dụng, mở khóa tiềm năng của tương tác bằng giọng nói và tạo tiền đề cho những trải nghiệm số năng động, dễ tiếp cận hơn.
Amazon Polly là gì?
Amazon Polly là dịch vụ Text-to-Speech (TTS) sử dụng công nghệ học sâu tiên tiến để tổng hợp giọng nói tự nhiên. Đây là một trong những dịch vụ TTS tinh vi nhất hiện có, cho phép nhà phát triển tạo ra các ứng dụng có thể “nói” với chất giọng gần giống con người một cách đáng kinh ngạc. Dịch vụ hỗ trợ hơn 60 giọng đọc bằng hơn 30 ngôn ngữ, đáp ứng khán giả toàn cầu với nhu cầu ngôn ngữ đa dạng.
Một trong những tính năng then chốt của Amazon Polly là việc sử dụng công nghệ chuyển văn bản thành giọng nói dạng neural (NTTS), mang đến các giọng đọc biểu cảm và tự nhiên hơn so với hệ thống tổng hợp giọng nói truyền thống. Điều này bao gồm điều chỉnh các thuộc tính như cao độ, âm lượng và tốc độ nói, cho phép nhà phát triển kiểm soát chính xác đầu ra âm thanh. Ví dụ, bạn có thể làm cho giọng nói vui tươi, hào hứng hoặc đồng cảm hơn, tăng cường kết nối cảm xúc với người dùng.
Amazon Polly cũng hỗ trợ các tính năng như speech marks, cho phép đồng bộ giọng nói với các yếu tố hình ảnh, như tô sáng văn bản khi được đọc hoặc tạo hoạt ảnh nhân vật khớp môi với âm thanh. Điều này khiến Polly trở thành giải pháp lý tưởng cho kể chuyện tương tác, nội dung giáo dục và công cụ hỗ trợ tiếp cận.
Dù bạn đang xây dựng trợ lý ảo điều khiển bằng giọng nói, nền tảng sách nói hay thiết bị IoT có khả năng thoại, Amazon Polly cung cấp tính linh hoạt và khả năng mở rộng cần thiết để hiện thực hóa ý tưởng.