courses
머신 러닝 이해하기
2
308K
레이블이 없는 데이터로 모델을 학습시키는 일은 불가능해 보이지만, 바로 그것이 대조 학습의 핵심 아이디어입니다.
아시다시피 데이터 라벨링은 느리고 비용이 많이 듭니다. 단일 이미지 분류 데이터셋만 해도 사람이 주석을 다는 데 수천 시간이 필요하고, 오류와 불일치를 고려하기 전의 이야기입니다.
대조 학습은 모델에게 ‘비교’를 가르쳐 라벨링 문제를 우회합니다. 무언가가 무엇인지 알려주는 대신, 무엇이 비슷하고 무엇이 다른지를 보여주고 나머지는 모델이 스스로 알아내도록 합니다.
이 글에서는 대조 학습의 직관, 내부 작동 방식, 실제 활용 분야(이미지 인식부터 NLP 임베딩까지), 그리고 PyTorch로 구현하는 방법을 순서대로 살펴보겠습니다.
컴퓨터 비전이 정확히 무엇인지 궁금하신가요? 이미지 분석 입문 가이드를 읽어보세요.
대조 학습은 분류 대신 비교로 학습하는 훈련 방식입니다.
모델에게 "이건 고양이" 또는 "이건 개"라고 말하는 대신, 예시 쌍을 보여주고 무엇이 함께 묶여야 하고 무엇이 아닌지를 스스로 파악하게 합니다. 모델은 두 대상이 유사한지 아닌지를 통해 학습합니다.
다시 말해, 모델에 한 번에 두 데이터 포인트를 입력합니다. 서로 관련이 있다면—예를 들어 같은 개를 다른 각도에서 찍은 두 사진—이는 양의 쌍(positive pair)입니다. 관련이 없다면—개의 사진과 자동차의 사진—이는 음의 쌍(negative pair)입니다.
모델의 임무는 이런 구조를 따르는 표현(수치 벡터)을 생성하는 것입니다. 양의 쌍은 벡터 공간에서 서로 가깝게, 음의 쌍은 멀어지게 위치해야 합니다.
대조 학습을 가장 쉽게 이해하는 방법은 이미지를 통해서입니다.
개의 사진을 하나 가져옵니다. 이제 두 가지 버전을 만듭니다—하나는 크롭하고, 하나는 밝기를 조정합니다. 보이는 내용은 같지만 픽셀은 다릅니다. 대조 학습 모델은 이 두 버전을 양의 쌍으로 보고 벡터 공간에서 비슷한 위치로 매핑하도록 학습합니다.
그 개 사진과 함께 자동차 사진을 보여주면 음의 쌍이 됩니다. 모델은 두 표현을 멀어지게 학습합니다.
"이건 개"나 "이건 자동차"라고 수동으로 지정할 필요가 없습니다. 모델은 유사성과 차이의 구조에서 이해를 구축합니다.
이 점이 대조 학습을 강력하게 만듭니다.
신호는 비교에서 나옵니다. 충분한 쌍을 학습하면, 모델은 무엇이 비슷하게 만드는지와 무엇이 다르게 만드는지를 파악하는 표현을 발전시킵니다.
그런 표현은 실제로 매우 유용합니다. 이렇게 이미지를 학습한 모델은 분류, 탐지, 검색 작업에 대해 라벨이 거의 없어도 미세 조정만으로 좋은 성능을 냅니다. 이미 시각 세계에 대한 의미 있는 것을 학습했기 때문입니다.
대조 학습은 여러 도메인에 걸쳐 등장합니다. 다음 분야에서 특히 많이 볼 수 있습니다.
대조 학습이 처음으로 성능을 입증한 분야입니다.
이 방식으로 이미지를 학습한 모델은 라벨을 전혀 보지 않고도 시각적 유사성을 파악하는 표현을 생성합니다. 같은 장면을 다른 각도나 다른 조명에서 촬영한 두 사진은 벡터 공간에서 가까운 지점으로 매핑되어야 합니다. 서로 관련 없는 장면은 멀리 매핑되어야 합니다.
대조적으로 사전 학습된 모델을 사용하면, 원래 필요했던 라벨의 일부만으로도 분류나 객체 탐지에 미세 조정할 수 있습니다.
NLP에서는 문장 임베딩—문장의 전체 의미를 파악하는 벡터 표현—을 학습하는 데 대조 학습을 사용합니다.
의미가 비슷한 문장은 벡터 공간에서 서로 가깝게, 관련 없는 문장은 떨어지게 배치되어야 합니다. 이렇게 학습한 모델은 대규모 라벨 문장 쌍이 없어도 의미 검색이나 문장 유사도와 같은 작업을 수행할 수 있습니다.
추천 시스템은 사용자-아이템 유사성을 모델링하기 위해 대조 학습을 사용합니다.
사용자와 그가 상호작용한 아이템은 양의 쌍을 이룹니다. 사용자와 한 번도 본 적 없는 임의의 아이템은 음의 쌍을 이룹니다. 이러한 예시를 충분히 학습하면, 모델은 관련 사용자와 아이템이 함께 모이는 공유 공간을 학습합니다.
대조 학습이 특히 흥미로워지는 영역입니다.
CLIP 같은 모델은 텍스트와 이미지를 공유 벡터 공간에 정렬하는 데 이를 사용합니다. 개의 사진과 "공원에서 노는 개"라는 문장은 서로 가깝게 위치해야 합니다. 개의 사진과 "빨간 스포츠카"라는 문장은 그렇지 않아야 합니다. 이를 통해 멀티모달 모델은 이미지와 텍스트 설명을 매칭하고 캡션을 생성할 수 있습니다.
이미지, 텍스트, 오디오 중 무엇을 다루든 대조 학습은 항상 같은 네 단계를 따릅니다.
모든 학습 예시는 쌍으로 시작합니다. 두 데이터 포인트를 샘플링하고, 관계를 유사(양의) 또는 비유사(음의)로 라벨링합니다. 실제로는 같은 입력을 두 가지 방식으로 증강해 양의 쌍을 만들고, 관련 없는 예시를 샘플링해 음의 쌍을 만듭니다.
두 데이터 포인트 모두 임베딩으로 변환하는 인코더를 거칩니다. 임베딩은 공유 벡터 공간에 존재하는 수치 표현입니다. 목표는 그 공간이 원시 픽셀이나 토큰 값이 아니라 의미(semantic)를 반영하도록 하는 것입니다.
두 임베딩을 얻으면, 얼마나 가까운지 측정합니다. 여기서 가장 흔한 선택은 코사인 유사도입니다. -1과 1 사이의 점수를 반환하며, 1은 벡터가 같은 방향, -1은 완전히 반대 방향을 의미합니다.
모델은 자신이 계산한 유사도 점수를 기대값과 비교합니다. 양의 쌍은 점수가 높아야 하고, 음의 쌍은 낮아야 합니다. 손실 함수가 모델의 오차를 측정하고, 역전파를 통해 인코더 가중치를 조정해 다음 번에는 더 잘하도록 합니다.
이 과정을 충분한 쌍에 걸쳐 반복하면, 인코더는 유사한 것은 모으고 다른 것은 떨어뜨리는 임베딩을 생성하도록 학습합니다.
대조 모델의 품질은 쌍을 어떻게 생성하느냐에 달려 있습니다.
양의 쌍은 유사하게 간주되어야 하는 두 데이터 포인트입니다. 컴퓨터 비전에서는 보통 같은 이미지의 두 증강 버전을 의미합니다. NLP에서는 같은 문장의 두 패러프레이즈나 문장과 그 번역일 수 있습니다. 모델은 그들 사이에서 변하는 것은 중요하지 않다고 학습합니다. 중요한 것은 공유되는 부분뿐입니다.
음의 쌍은 다르게 간주되어야 하는 두 데이터 포인트입니다. 대부분의 구현은 나머지 데이터셋에서 음의 샘플을 무작위로 샘플링합니다. 이미지 학습에서는 서로 다른 객체의 아무 두 이미지나 유효한 음의 쌍이 됩니다.
여기서부터가 까다롭습니다.
모든 음의 샘플이 똑같이 유용한 것은 아닙니다. 원본과 명백히 다른 무작위 음성—예를 들어 개 사진과 비행기 사진—은 모델이 크게 노력하지 않게 만듭니다. 이를 쉬운 음성(easy negatives)이라고 하며, 이런 샘플이 너무 많으면 학습이 느려집니다.
반대로, 어려운 음성(hard negatives)은 원본과 비슷해 보이지만 다른 클래스로 속하는 데이터 포인트입니다—예를 들어 두 개 품종의 개, 혹은 비슷한 문구지만 의미가 다른 두 문장. 모델은 이를 구분하기 위해 더 미세한 표현을 개발해야 하므로, 전반적으로 더 나은 임베딩을 만들어냅니다.
같은 논리가 양성에도 적용됩니다. 증강이 너무 미묘하면 모델은 배울 것이 많지 않습니다. 너무 과격하면, 더 이상 의미 있게 유사한 쌍이 아닙니다.
손실 함수는 쌍 비교를 학습 신호로 바꿉니다.
각 손실 함수는 작동 방식이 다르지만, 공통 목표는 같습니다. 유사한 것이 벡터 공간에서 가깝게 위치하면 보상하고, 그렇지 않으면 패널티를 주는 것입니다.
대조 손실은 초기 대조 학습 연구와 함께 소개되었습니다.
이는 쌍 단위로 작동합니다. 양의 쌍이 주어지면 임베딩이 멀리 떨어져 있을수록 패널티를 줍니다. 음의 쌍이 주어지면 임베딩이 너무 가까울 때—구체적으로 정해진 마진 내에 있을 때—패널티를 줍니다. 이미 충분히 멀리 떨어진 음성은 손실에 기여하지 않습니다.
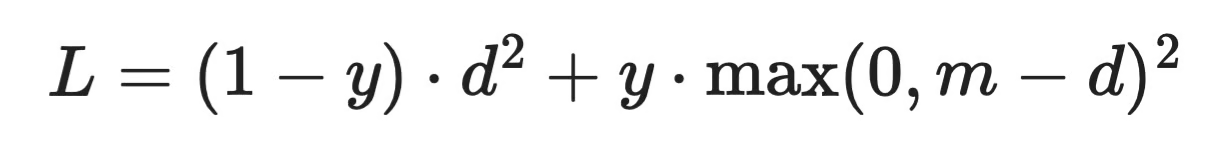
대조 손실 공식
여기서 d는 두 임베딩 사이의 거리, y는 음의 쌍에 1, 양의 쌍에 0, m은 마진입니다. 마진은 수동으로 설정하는 하이퍼파라미터이므로 이 손실은 튜닝에 민감합니다.
트리플릿 손실은 앵커, 양성, 음성 세 데이터 포인트를 한 번에 사용합니다.
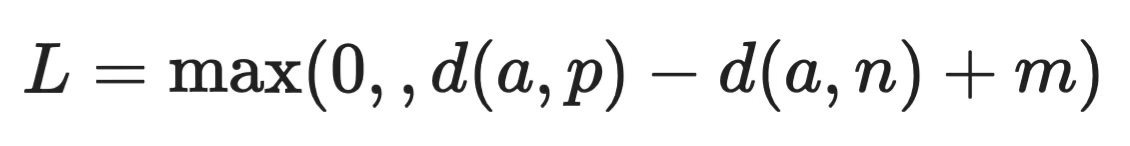
트리플릿 손실 공식
앵커-양성 거리 d(a, p)가 앵커-음성 거리 d(a, n)보다 마진 m만큼 충분히 작지 않을 때 모델은 패널티를 받습니다. 그 조건이 이미 충족되면 손실은 0입니다.
이 정식화는 한 번에 하나의 관계만 비교하는 대조 손실보다, 업데이트당 더 많은 문맥을 제공합니다.
InfoNCE는 SimCLR과 CLIP을 포함한 대부분의 현대 대조 학습 방법의 기반이 되는 손실입니다.
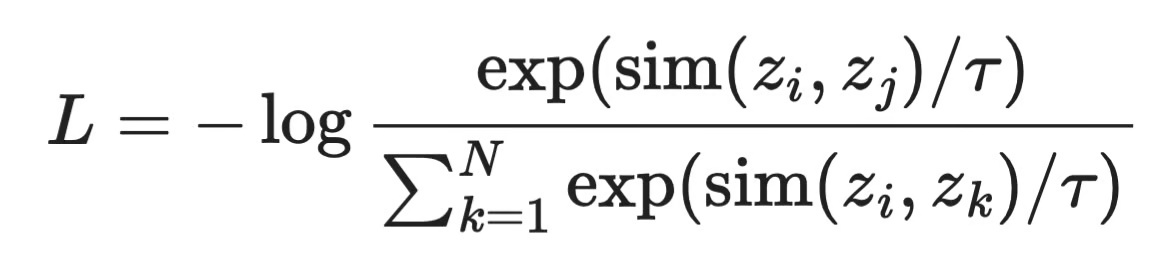
InfoNCE 손실 공식
각 앵커 z_i에 대해, 모델은 배치의 다른 N개 예시 중에서 자신의 양성 z_j를 식별해야 합니다. 온도 매개변수 τ는 분포의 예리함을 제어합니다—값이 낮을수록 모델은 더 확신을 가지며, 값이 높을수록 쌍 간 대비가 완화됩니다.
업데이트당 더 많은 음성을 얻게 되어, 모델은 더 풍부한 학습 신호를 받습니다. 또한 배치가 클수록 더 어려운 음성을 접하게 되어 일반적으로 더 나은 표현을 만듭니다.
대조 학습과 자기 지도 학습은 궁합이 좋습니다. 그 이유를 이해하면 현대 ML이 어디로 가는지 보일 것입니다.
자기 지도 학습은 사람의 주석 없이 데이터로부터 모델이 스스로 라벨을 생성하는 학습 방식입니다. 즉, 누군가 수천 장의 이미지를 "고양이"나 "개"로 라벨링하는 대신, 데이터 자체가 감독 신호를 제공합니다.
대조 학습은 바로 그 일을 합니다. 이미지를 가져와 두 가지 증강 버전을 만들고, 모델에게 그것이 양의 쌍이라고 알려주는 순간, 라벨을 만든 것입니다.
이는 대부분의 ML 파이프라인에서 라벨 데이터가 병목이기 때문입니다. 수집은 느리고, 주석은 비싸며, 의료 영상 같은 일부 도메인에서는 데이터 자체가 충분치 않습니다.
지금까지의 결과는 고무적입니다. 대규모 미라벨 데이터셋에서 대조적 자기 지도 목표로 사전 학습된 모델은, 소량의 라벨 데이터로만 미세 조정해도 다양한 다운스트림 작업에서 감독 학습 기준선에 맞먹거나 근접한 성능을 보였습니다.
전반적 경향은 작업별 감독 학습에서 벗어나, 원시 데이터로부터 대규모로 학습한 범용 표현으로 이동하는 것입니다. SimCLR, MoCo, BYOL 같은 방법은 모두 이 흐름을 따르며, 이어서 자세히 다루겠습니다.
2026년에 대조 학습을 이끈 가장 영향력 있는 프레임워크 세 가지를 소개합니다.
Google Research가 소개한 SimCLR은 대조 학습 아이디어를 가장 명확히 구현한 방법 중 하나입니다.
배치의 각 이미지에 대해 두 개의 증강 뷰를 만들고 이를 양의 쌍으로 처리합니다. 배치의 나머지 이미지는 모두 음성이 됩니다. CNN에 작은 프로젝션 헤드를 잇는 모델은 InfoNCE 손실을 사용해 양의 쌍을 가깝게 매핑하도록 학습합니다.
SimCLR이 두드러졌던 점은 배치 크기의 영향이 컸다는 것입니다. 배치가 클수록 업데이트당 음성이 많아져 더 나은 표현으로 이어졌습니다. 대가로 메모리가 듭니다. SimCLR은 좋은 성능을 내려면 큰 배치를 요구하므로, 성능을 끌어내려면 하드웨어가 받쳐줘야 합니다.
Meta AI Research의 MoCo(Momentum Contrast)는 바로 그 문제를 해결하도록 설계되었습니다.
큰 배치의 음성에 의존하는 대신, MoCo는 큐—이전 배치에서 인코딩된 표현의 순환 버퍼—를 유지합니다. 이렇게 하면 음성의 수가 배치 크기와 분리되어, 메모리를 훨씬 적게 쓰면서도 모델에 많은 음성을 노출할 수 있습니다.
또한 모멘텀 인코더(주 인코더를 서서히 업데이트한 사본)를 사용해, 큐에 있는 표현의 일관성을 시간에 걸쳐 유지합니다.
BYOL(Bootstrap Your Own Latent)은 음의 쌍을 전혀 사용하지 않음에도 여기서 언급할 가치가 있습니다.
음성을 멀어지게 밀어내는 대신, BYOL은 하나의 네트워크가 다른(서서히 업데이트되는 타깃 네트워크)의 표현을 예측하도록 학습합니다. 음성도, 대조 손실도 없습니다. 놀랍게도 잘 작동하며, 대조 스타일 학습에 음성 쌍이 필수라는 가정을 흔들었습니다.
BYOL은 대조 학습의 경계에 있지만, 핵심 방법을 이해한 다음 단계로 살펴보기 좋습니다.
두 접근법은 같은 문제를 풀지만, 출발 가정이 다르다는 점을 이해해야 합니다.
감독 학습은 라벨이 있는 데이터를 필요로 합니다. 모든 학습 예시에 사람이 지정한 라벨이 있어야 하며, 모델은 입력을 그 라벨에 매핑하면서 학습합니다. 직관적인 접근이며, 충분한 라벨 예시가 있을 때 잘 작동합니다. 모델은 입력이 무엇이고 정답이 무엇인지 압니다.
대조 학습은 데이터의 구조—유사성과 차이—에서 감독 신호를 스스로 생성하며, 라벨을 전혀 보지 않고 표현을 학습합니다.
두 방식을 비교하는 더 시각적인 표현은 다음과 같습니다:
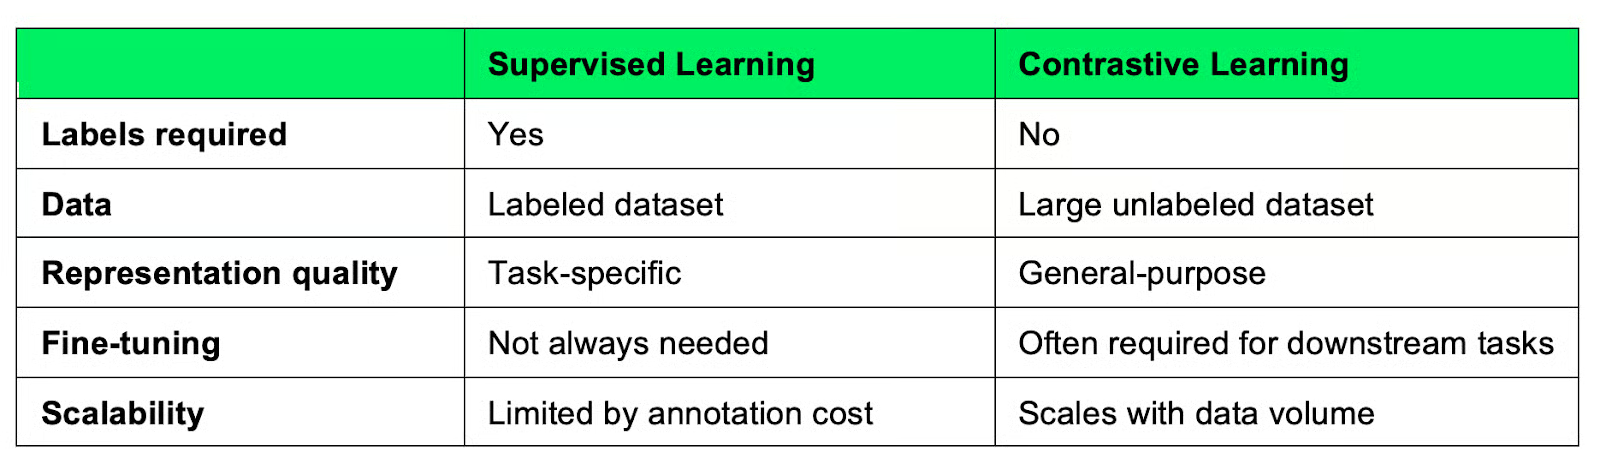
대조 학습과 감독 학습 비교
대부분의 차이는 규모에서 드러납니다. 감독 학습은 라벨 데이터에 의존하며, 라벨을 더 만드는 데 비용이 듭니다. 대조 학습은 보통 풍부한 미라벨 데이터를 더 많이 투입할수록 성능을 높일 수 있습니다.
하지만 대조 학습 모델이 학습하는 표현은 일반적이며 작업 특화가 아니라는 점을 유의해야 합니다. 따라서 특정 작업에서 좋은 성능을 내려면 보통 미세 조정 단계가 필요합니다. 감독 모델은 목표 목표식으로 학습되므로 그 단계가 필요 없습니다.
선택은 데이터 상황에 달려 있습니다. 라벨 데이터와 명확한 작업이 있다면 감독 학습이 더 빠른 경우가 많습니다. 대량의 미라벨 데이터를 다루거나 작업 간 전이 가능한 표현이 필요하다면, 대조 학습은 추가 설정을 들일 가치가 있습니다.
이제 최소한의 PyTorch 구현을 만들어 보겠습니다. 아래 예시는 앞서 논의한 세 가지 핵심 아이디어—임베딩 모델, 코사인 유사도, NT-Xent 손실(InfoNCE 기반, SimCLR에서 사용)—을 다룹니다.
인코더는 입력 벡터를 더 낮은 차원의 임베딩 공간으로 매핑하는 간단한 피드포워드 네트워크입니다.
import torch
import torch.nn as nn
import torch.nn.functional as F

class Encoder(nn.Module):
    def __init__(self, input_dim, embedding_dim):
        super().__init__()
        self.network = nn.Sequential(
            nn.Linear(input_dim, 128),
            nn.ReLU(),
            nn.Linear(128, embedding_dim)
        )

    def forward(self, x):
        return self.network(x)
실제로는 이미지를 위해 CNN, 텍스트를 위해 트랜스포머로 교체합니다. 아키텍처 자체보다 이후 단계가 더 중요합니다.
두 임베딩을 얻으면 코사인 유사도로 얼마나 가까운지 측정합니다. 먼저 벡터를 정규화하면 유사도 점수가 -1과 1 사이에 머뭅니다.
def cosine_similarity(z1, z2):
    z1 = F.normalize(z1, dim=-1)
    z2 = F.normalize(z2, dim=-1)
    return torch.matmul(z1, z2.T)
결과는 각 항목 [i, j]가 배치에서 임베딩 i와 임베딩 j의 유사도를 나타내는 행렬입니다.
NT-Xent(Normalized Temperature-scaled Cross Entropy)는 InfoNCE 기반 손실입니다. 각 앵커에 대해, 짝이 되는 뷰를 양성으로, 배치의 다른 모든 예시를 음성으로 간주합니다.
def nt_xent_loss(z1, z2, temperature=0.5):
    batch_size = z1.shape[0]

    z = torch.cat([z1, z2], dim=0)
    z = F.normalize(z, dim=-1)
    sim_matrix = torch.matmul(z, z.T) / temperature

    mask = torch.eye(2 * batch_size, dtype=torch.bool)
    sim_matrix = sim_matrix.masked_fill(mask, float("-inf"))

    labels = torch.arange(batch_size)
    labels = torch.cat([labels + batch_size, labels])

    return F.cross_entropy(sim_matrix, labels)
temperature 매개변수는 분포의 예리함을 제어합니다. 값이 낮을수록 모델이 어느 쌍이 양성인지 더 확신하고, 값이 높을수록 대비가 완화됩니다.
encoder = Encoder(input_dim=64, embedding_dim=32)
optimizer = torch.optim.Adam(encoder.parameters(), lr=1e-3)

# Simulate a batch of positive pairs
x1 = torch.randn(32, 64)
x2 = torch.randn(32, 64)

# Training
optimizer.zero_grad()
z1, z2 = encoder(x1), encoder(x2)
loss = nt_xent_loss(z1, z2)
loss.backward()
optimizer.step()

print(f"Loss: {loss.item():.4f}")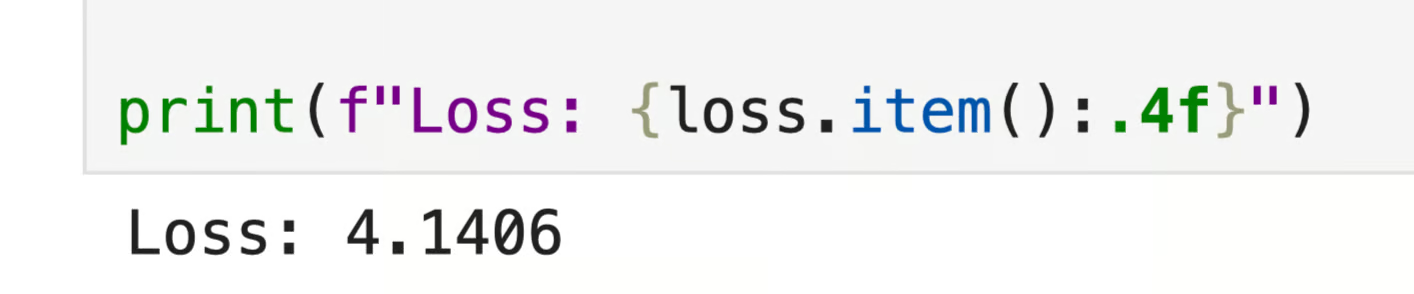
대조 루프 출력
이것이 가장 단순한 형태의 전체 대조 루프입니다. 실제 구현에서는 x1과 x2가 무작위 노이즈가 아니라 같은 입력의 두 증강 뷰가 되겠지만, 구조는 정확히 동일합니다.
대조 학습은 단순하지만 범용성이 큰 아이디어입니다.
라벨에 의존하지 않고 비교를 통해 구조를 이해하도록 모델을 가르칩니다. 비슷한 것은 모으고 다른 것은 벌린다—이것이 전부입니다. 이 원리만으로도 다양한 작업에 잘 전이되는 표현을 학습하기에 충분합니다.
분야는 주석에 크게 의존하는 파이프라인에서 벗어나는 중이며, 대조 학습이 그 이유 중 큰 부분을 차지합니다. SimCLR, MoCo, CLIP 같은 알고리즘이 실제 제품에 채택되었다는 사실은 이 접근이 실제로 얼마나 잘 작동하는지를 보여줍니다.
더 깊이 들어가고 싶다면 실제 구현을 직접 다뤄보는 것이 좋습니다. 이 글의 PyTorch 예시는 출발점에 불과하며, 실제 이미지 데이터셋—작은 것이라도—에서 SimCLR을 실행해보면 어떤 설명보다 많은 것을 배우게 됩니다.
고급 머신 러닝 주제에 대한 궁극의 학습 자료가 필요하다면, Machine Learning Scientist in Python 트랙에 등록해 보세요.
DataCamp로 학습하세요
courses
courses
courses