course
Wprowadzenie do uczenia maszynowego
2 godz.
308K
Sprawienie, by model uczył się bez danych z etykietami, brzmi jak coś niemożliwego — a jednak na tym polega uczenie kontrastowe.
Jak wiesz, etykietowanie danych jest wolne i kosztowne. Sam tylko zbiór do klasyfikacji obrazów zwykle wymaga tysięcy godzin pracy ludzkich anotatorów — i to zanim uwzględnisz błędy i niespójności.
Uczenie kontrastowe omija ten problem z etykietami, ucząc modele porównywania. Zamiast mówić modelowi, czym coś jest, pokazujesz mu, co jest do siebie podobne, a co się różni — a on sam dopracowuje resztę.
W tym artykule przeprowadzę cię przez intuicję stojącą za uczeniem kontrastowym, wyjaśnię, jak działa „pod maską”, gdzie znajduje zastosowanie w praktyce — od rozpoznawania obrazów po osadzenia w NLP — oraz jak zaimplementować je w PyTorchu.
Czym dokładnie jest komputerowe rozpoznawanie obrazu? Przeczytaj nasz przewodnik dla początkujących po analizie obrazów.
Uczenie kontrastowe to podejście do trenowania, w którym model uczy się przez porównywanie, a nie klasyfikację.
Zamiast mówić modelowi „to jest kot” albo „to jest pies”, pokazujesz mu pary przykładów i pozwalasz ustalić, co do siebie pasuje, a co nie. Model uczy się, rozstrzygając, czy dwie rzeczy są podobne, czy nie.
Innymi słowy — podajesz modelowi po dwa punkty danych na raz. Jeśli są powiązane — na przykład dwa zdjęcia tego samego psa zrobione pod różnymi kątami — to jest to para pozytywna. Jeśli są niepowiązane — zdjęcie psa i zdjęcie samochodu — to jest to para negatywna.
Zadaniem modelu jest tworzenie reprezentacji (wektorów liczbowych), które odzwierciedlają tę strukturę. Pary pozytywne powinny lądować blisko siebie w przestrzeni wektorowej. Pary negatywne — daleko od siebie.
Najłatwiej zrozumieć uczenie kontrastowe na przykładzie obrazów.
Weź zdjęcie psa. Stwórz dwie wersje — jedną przyciętą, drugą z inną jasnością. To, co widać, jest to samo, ale piksele są inne. Model uczący się kontrastowo widzi te dwie wersje jako parę pozytywną i uczy się mapować je na podobne pozycje w przestrzeni wektorowej.
Jeśli pokażesz modelowi zdjęcie samochodu obok tego zdjęcia psa, dostaniesz parę negatywną. Model uczy się odsuwać ich reprezentacje od siebie.
Nie musisz ręcznie wskazywać „to jest pies” ani „to jest samochód”. Model buduje rozumienie na podstawie struktury podobieństw i różnic.
To właśnie czyni uczenie kontrastowe tak mocnym podejściem.
Sygnał pochodzi z porównań. Przy wystarczającej liczbie par model potrafi wykształcić reprezentacje, które rozumieją, co sprawia, że rzeczy są do siebie podobne, a co je od siebie odróżnia.
Te reprezentacje okazują się naprawdę użyteczne. Model wytrenowany w ten sposób na obrazach można dostroić do zadań klasyfikacji, detekcji lub wyszukiwania przy bardzo małej liczbie danych z etykietami, bo już nauczył się czegoś istotnego o świecie wizualnym.
Uczenie kontrastowe pojawia się w wielu dziedzinach — oto gdzie zobaczysz je najczęściej.
To tutaj uczenie kontrastowe po raz pierwszy pokazało, na co je stać.
Modele trenowane w ten sposób na obrazach uczą się tworzyć reprezentacje, które rozumieją podobieństwo wizualne, mimo że nigdy nie widziały etykiet. Dwa zdjęcia tej samej sceny, zrobione pod różnymi kątami czy w innym oświetleniu, powinny mapować się na bliskie punkty w przestrzeni wektorowej. Dwie niepowiązane sceny — daleko od siebie.
Możesz wziąć wstępnie wytrenowany kontrastowo model i dostroić go do klasyfikacji lub detekcji obiektów, używając ułamka liczby etykietowanych danych, których normalnie byś potrzebował.
W NLP uczenie kontrastowe służy do trenowania osadzeń zdań — wektorowych reprezentacji, które rozumieją znaczenie zdania jako całości.
Zdania o podobnym znaczeniu powinny znajdować się blisko siebie w przestrzeni wektorowej, a niepowiązane — być od siebie oddalone. Modele trenowane w ten sposób potrafią wykonywać zadania takie jak wyszukiwanie semantyczne i podobieństwo zdań bez dużych ilości sparowanych, etykietowanych zdań.
Systemy rekomendacyjne wykorzystują uczenie kontrastowe do modelowania podobieństwa użytkownik–element.
Użytkownik i element, z którym wchodził w interakcję, tworzą parę pozytywną. Użytkownik i losowy element, którego nigdy nie widział, tworzą parę negatywną. Jeśli wytrenujesz na wystarczającej liczbie takich przykładów, model uczy się wspólnej przestrzeni, w której powiązani użytkownicy i elementy grupują się razem.
Tutaj uczenie kontrastowe robi się szczególnie ciekawe.
Modele takie jak CLIP wykorzystują je do wyrównywania tekstu i obrazów we wspólnej przestrzeni wektorowej. Zdjęcie psa i zdanie „a dog playing in the park” powinny trafić blisko siebie. Zdjęcie psa i zdanie „a red sports car” — nie. Dzięki temu modele multimodalne potrafią dopasowywać obrazy do opisów tekstowych i generować podpisy.
Uczenie kontrastowe zawsze podąża tymi samymi czterema krokami — niezależnie od tego, czy pracujesz z obrazami, tekstem, czy dźwiękiem.
Każdy przykład treningowy zaczyna się od pary. Losujesz dwa punkty danych i oznaczasz relację jako podobną (pozytywną) lub niepodobną (negatywną). W praktyce pary pozytywne często pochodzą z dwóch różnych augmentacji tego samego wejścia, a pary negatywne — z losowania niepowiązanych przykładów.
Oba punkty danych przechodzą przez enkoder, który zamienia je w wektory. Te wektory, zwane osadzeniami, są numerycznymi reprezentacjami we wspólnej przestrzeni wektorowej. Celem jest, by ta przestrzeń odzwierciedlała znaczenie semantyczne, a nie surowe piksele czy tokeny.
Gdy masz dwa osadzenia, mierzysz, jak blisko siebie są. Najczęściej używa się tu podobieństwa cosinusowego. Daje ono wynik między -1 a 1, gdzie 1 oznacza, że wektory wskazują w tym samym kierunku, a -1 — że są zupełnie przeciwne.
Model porównuje swoje wyniki podobieństwa z tym, jakie powinny być. Dla par pozytywnych wynik powinien być wysoki. Dla negatywnych — niski. Funkcja straty mierzy odchylenie od ideału, a propagacja wsteczna dostraja wagi enkodera, by następnym razem było lepiej.
Jeśli powtórzysz te kroki dla wystarczającej liczby par, enkoder nauczy się tworzyć osadzenia, które grupują podobne rzeczy i odsuwają od siebie różne.
Jakość twojego modelu kontrastowego zależy od tego, jak tworzysz pary.
Pary pozytywne to dwa punkty danych, które należy uznać za podobne. W wizji komputerowej zwykle oznacza to dwie zaugmentowane wersje tego samego obrazu. W NLP mogą to być dwa parafrazy tego samego zdania albo zdanie i jego tłumaczenie. Model uczy się, że to, co się między nimi różni, nie ma znaczenia. Liczy się tylko to, co wspólne.
Pary negatywne to dwa punkty danych, które należy uznać za różne. Większość implementacji dobiera negatywy losowo z reszty zbioru. Jeśli trenujesz na obrazach, dowolne dwa obrazy różnych obiektów tworzą poprawną parę negatywną.
I tu zaczynają się schody.
Nie wszystkie negatywy są równie użyteczne. Losowy negatyw, który jest ewidentnie inny od źródła — np. zdjęcie psa sparowane ze zdjęciem samolotu — nie wymaga od modelu zbyt wiele wysiłku. To tzw. łatwe negatywy i trenowanie na zbyt wielu z nich spowalnia naukę.
Z drugiej strony trudne negatywy to punkty danych, które wyglądają podobnie do źródła, ale należą do innej klasy — na przykład dwie rasy psów albo dwa zdania o podobnym brzmieniu, lecz innym znaczeniu. Model musi rozwinąć bardziej finezyjne reprezentacje, by je odróżnić, co w efekcie daje lepsze osadzenia.
Ta sama logika dotyczy pozytywów. Jeśli twoje augmentacje są zbyt subtelne, model niewiele się nauczy. Jeśli są zbyt agresywne, para przestaje być sensownie podobna.
Funkcja straty zamienia porównania par na sygnał uczący.
Każda działa nieco inaczej, ale wszystkie mają ten sam cel: nagradzać model, gdy podobne rzeczy są blisko w przestrzeni wektorowej, i karać, gdy nie są.
Contrastive loss została wprowadzona wraz z wczesnymi pracami nad uczeniem kontrastowym.
Działa na parach. Dla pary pozytywnej karze model, jeśli ich osadzenia są od siebie daleko. Dla pary negatywnej karze model, jeśli ich osadzenia są zbyt blisko — konkretnie, jeśli mieszczą się w zdefiniowanym marginesie. Negatywy, które są już dostatecznie daleko, nie wnoszą nic do straty.
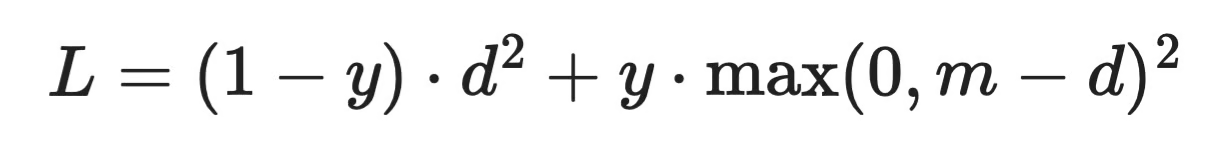
Wzór na contrastive loss
Gdzie d to odległość między dwoma osadzeniami, y to 1 dla par negatywnych i 0 dla pozytywnych, a m to margines. Margines jest hiperparametrem ustawianym ręcznie, co sprawia, że ta strata jest wrażliwa na strojenie.
Triplet loss działa jednocześnie na trzech punktach danych: kotwicy (anchor), pozytywie i negatywie.
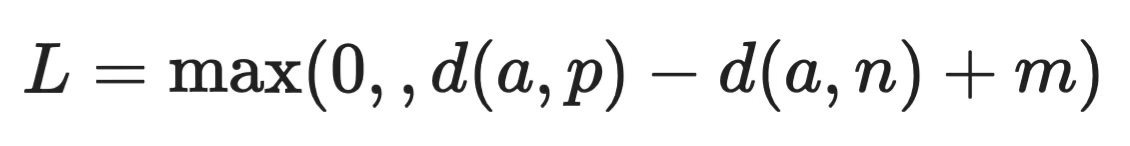
Wzór na triplet loss
Model jest karany za każdym razem, gdy odległość kotwica–pozytyw d(a, p) nie jest mniejsza od odległości kotwica–negatyw d(a, n) co najmniej o margines m. Jeśli warunek jest spełniony, strata wynosi zero.
Ta formulacja daje modelowi więcej kontekstu na aktualizację niż contrastive loss, ponieważ porównuje oba związki naraz, a nie po kolei.
InfoNCE to strata stojąca za większością nowoczesnych metod uczenia kontrastowego, w tym SimCLR i CLIP.
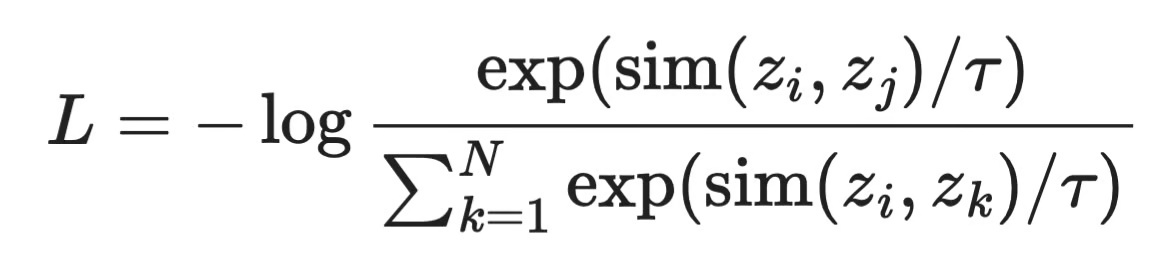
Wzór na InfoNCE
Dla każdej kotwicy z_i model musi zidentyfikować jej pozytyw z_j spośród wszystkich pozostałych N przykładów w batchu. Parametr temperatury τ kontroluje ostrość rozkładu — niższe wartości czynią model bardziej pewnym, wyższe łagodzą kontrast między parami.
Dostajesz więcej negatywów na aktualizację, co daje modelowi silniejszy sygnał uczący. Oznacza to też, że większe batchy wystawiają model na trudniejsze negatywy i zazwyczaj prowadzą do lepszych reprezentacji.
Uczenie kontrastowe i samonadzorowane dobrze ze sobą współgrają — a rozumiejąc dlaczego, zrozumiesz, dokąd zmierza nowoczesne ML.
Uczenie samonadzorowane to podejście, w którym model generuje własne etykiety z danych, bez ludzkiej anotacji. Zamiast tego, by ktoś oznaczał tysiące obrazów jako „kot” czy „pies”, to same dane dostarczają sygnału nadzorującego.
Uczenie kontrastowe robi dokładnie to. Gdy bierzesz obraz, tworzysz dwie jego zaugmentowane wersje i mówisz modelowi, że to para pozytywna, właśnie stworzyłeś etykietę.
To ma znaczenie, bo dane z etykietami są wąskim gardłem w większości potoków ML. Ich zbieranie jest wolne, anotacja kosztowna, a niektóre dziedziny — jak obrazowanie medyczne — nie mają ich wystarczająco dużo.
Dotychczasowe wyniki są obiecujące. Modele wstępnie trenowane kontrastowo-samonadzorowanymi celami na dużych, nieetykietowanych zbiorach dorównywały lub zbliżały się do nadzorowanych baseline’ów w wielu zadaniach downstream po dostrojeniu na niewielkiej liczbie danych z etykietami.
Ogólny trend to odchodzenie od treningu ściśle zadaniowego na rzecz uniwersalnych reprezentacji uczonych na surowych danych w skali. Metody takie jak SimCLR, MoCo i BYOL wpisują się w ten trend — i o nich opowiem za chwilę.
Oto trzy najbardziej wpływowe frameworki stojące za uczeniem kontrastowym w 2026 roku.
SimCLR, zaprezentowany przez Google Research, to jedno z najczystszych wcieleń idei uczenia kontrastowego.
Dla każdego obrazu w batchu tworzy dwa zaugmentowane widoki i traktuje je jako parę pozytywną. Każdy inny obraz w batchu staje się negatywem. Model — CNN z niewielką głowicą projekcyjną — uczy się zbliżać pary pozytywne, używając straty InfoNCE.
To, co wyróżniło SimCLR, to znaczenie rozmiaru batcha. Większe batchy oznaczały więcej negatywów na aktualizację, co przekładało się na lepsze reprezentacje. Minusem jest pamięć. Ponieważ SimCLR potrzebuje dużych batchy, by działać dobrze, potrzebujesz dobrego sprzętu, aby w pełni go wykorzystać.
MoCo (Momentum Contrast) od Meta AI Research został zaprojektowany dokładnie po to, by rozwiązać ten problem.
Zamiast polegać na dużym batchu dla negatywów, MoCo utrzymuje kolejkę — bufor bieżących reprezentacji zakodowanych w poprzednich batchach. To rozsprzęga liczbę negatywów od rozmiaru batcha, więc możesz trenować przy znacznie mniejszym zużyciu pamięci, a mimo to wystawiać model na dużą pulę negatywów.
Wykorzystuje też enkoder z momentum — wolniej aktualizowaną kopię głównego enkodera — aby utrzymać spójność reprezentacji w kolejce w czasie.
BYOL (Bootstrap Your Own Latent) warto tu wspomnieć, choć w ogóle nie używa par negatywnych.
Zamiast odpychać negatywy, BYOL trenuje jedną sieć, by przewidywała reprezentacje drugiej — wolniej aktualizowanej sieci docelowej. Nie ma negatywów ani straty kontrastowej. Działa zaskakująco dobrze, a jego sukces podważył założenie, że pary negatywne są konieczne w uczeniu w stylu kontrastowym.
BYOL znajduje się gdzieś na granicy uczenia kontrastowego, ale to dobry kolejny krok, gdy zrozumiesz, jak działają metody podstawowe.
Te dwa podejścia rozwiązują ten sam problem, ale wychodzą od innych założeń, które warto zrozumieć.
Uczenie nadzorowane wymaga danych z etykietami. Każdy przykład treningowy potrzebuje ludzkiej kategorii lub wartości, a model uczy się mapować wejścia na te etykiety. To bezpośrednie podejście i działa dobrze, gdy masz dość etykietowanych przykładów. Model wie, czym jest wejście i jaka jest poprawna odpowiedź.
Uczenie kontrastowe generuje własny nadzór ze struktury danych — podobieństw i różnic — i uczy się reprezentacji bez oglądania etykiet.
Oto bardziej wizualne przedstawienie porównania:
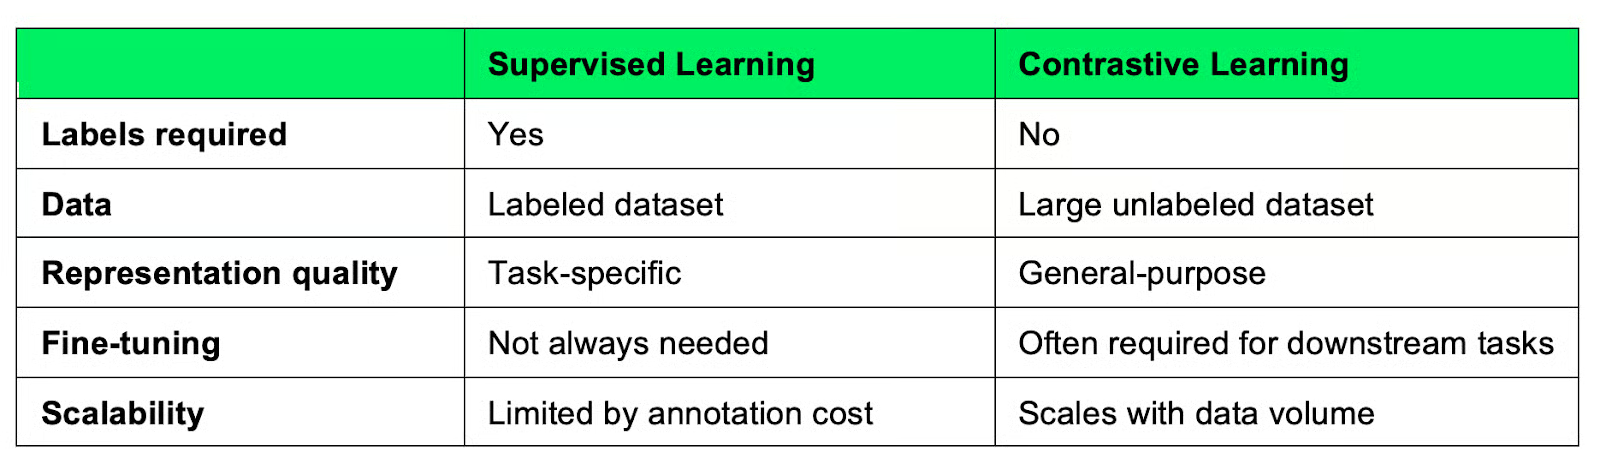
Uczenie kontrastowe w porównaniu z uczeniem nadzorowanym
Największa różnica pojawia się w skali. Uczenie nadzorowane zależy od danych z etykietami — a ich tworzenie jest kosztowne. Uczenie kontrastowe może się dalej poprawiać, gdy karmisz je większą ilością nieetykietowanych danych, które zwykle są w nadmiarze.
Warto jednak zaznaczyć, że reprezentacje, których uczy się model kontrastowy, są ogólne, a nie zadaniowe, co zwykle oznacza potrzebę etapu dostrajania, by uzyskać wysoką skuteczność w konkretnym zadaniu. Modele nadzorowane tego nie potrzebują, bo są trenowane bezpośrednio na celu docelowym.
Wybór sprowadza się do sytuacji danych. Jeśli masz dane z etykietami i konkretne zadanie, uczenie nadzorowane jest często szybsze. Jeśli pracujesz z dużą ilością nieetykietowanych danych lub potrzebujesz reprezentacji przenoszalnych między zadaniami, uczenie kontrastowe może być warte dodatkowej konfiguracji.
Przejdźmy teraz do minimalnej implementacji w PyTorchu. Poniższy przykład obejmuje trzy kluczowe idee omawiane wcześniej: model osadzeń, podobieństwo cosinusowe i stratę NT-Xent — funkcję straty używaną w SimCLR, opartą na InfoNCE.
Enkoder to prosty sieciowy model feedforward, który mapuje wektory wejściowe do niżej wymiarowej przestrzeni osadzeń.
import torch
import torch.nn as nn
import torch.nn.functional as F

class Encoder(nn.Module):
    def __init__(self, input_dim, embedding_dim):
        super().__init__()
        self.network = nn.Sequential(
            nn.Linear(input_dim, 128),
            nn.ReLU(),
            nn.Linear(128, embedding_dim)
        )

    def forward(self, x):
        return self.network(x)
W praktyce zastąpiłbyś to CNN-em dla obrazów lub transformatorem dla tekstu. Architektura ma mniejsze znaczenie niż to, co dzieje się później.
Gdy masz dwa osadzenia, mierzysz ich bliskość za pomocą podobieństwa cosinusowego. Wcześniejsze znormalizowanie wektorów utrzymuje wyniki podobieństwa w przedziale od -1 do 1.
def cosine_similarity(z1, z2):
    z1 = F.normalize(z1, dim=-1)
    z2 = F.normalize(z2, dim=-1)
    return torch.matmul(z1, z2.T)
Wynik to macierz, w której każdy element [i, j] reprezentuje podobieństwo między osadzeniem i a osadzeniem j w całym batchu.
NT-Xent (Normalized Temperature-scaled Cross Entropy) to strata oparta na InfoNCE. Dla każdej kotwicy traktuje sparowany widok jako pozytyw, a wszystkie inne przykłady w batchu jako negatywy.
def nt_xent_loss(z1, z2, temperature=0.5):
    batch_size = z1.shape[0]

    z = torch.cat([z1, z2], dim=0)
    z = F.normalize(z, dim=-1)
    sim_matrix = torch.matmul(z, z.T) / temperature

    mask = torch.eye(2 * batch_size, dtype=torch.bool)
    sim_matrix = sim_matrix.masked_fill(mask, float("-inf"))

    labels = torch.arange(batch_size)
    labels = torch.cat([labels + batch_size, labels])

    return F.cross_entropy(sim_matrix, labels)
Parametr temperature kontroluje ostrość rozkładu. Niższe wartości sprawiają, że model jest bardziej pewny, która para jest pozytywna; wyższe łagodzą kontrast.
encoder = Encoder(input_dim=64, embedding_dim=32)
optimizer = torch.optim.Adam(encoder.parameters(), lr=1e-3)

# Simulate a batch of positive pairs
x1 = torch.randn(32, 64)
x2 = torch.randn(32, 64)

# Training
optimizer.zero_grad()
z1, z2 = encoder(x1), encoder(x2)
loss = nt_xent_loss(z1, z2)
loss.backward()
optimizer.step()

print(f"Loss: {loss.item():.4f}")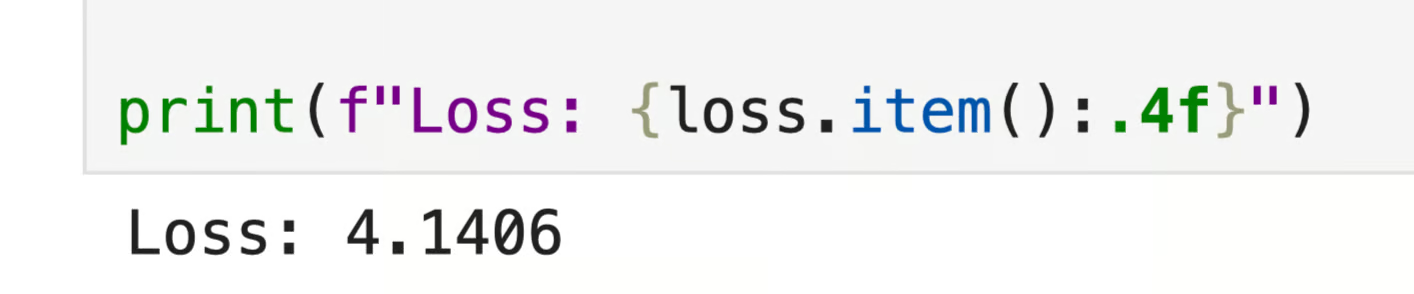
Wynik pętli kontrastowej
To pełna pętla kontrastowa w najprostszej postaci. W rzeczywistej implementacji x1 i x2 byłyby dwiema zaugmentowanymi wersjami tego samego wejścia, a nie losowym szumem — ale struktura pozostaje dokładnie taka sama.
Uczenie kontrastowe to prosta idea o szerokim zasięgu.
Uczy modele rozumienia struktury przez porównanie, zamiast polegać na danych z etykietami. Zbliżaj podobne rzeczy, oddalaj różne — to cały zamysł. Okazuje się, że to wystarcza, by nauczyć się reprezentacji dobrze przenoszących się między zadaniami.
Dziedzina odchodzi od potoków wymagających ciężkiej anotacji, a uczenie kontrastowe jest jednym z głównych powodów. Algorytmy takie jak SimCLR, MoCo i CLIP trafiły do prawdziwych produktów, co mówi wiele o skuteczności podejścia.
Jeśli chcesz wejść głębiej, kolejnym krokiem jest praca z prawdziwą implementacją. Przykład w PyTorchu z tego artykułu to punkt startowy, ale uruchomienie SimCLR na rzeczywistym zbiorze obrazów — nawet małym — nauczy cię więcej niż jakiekolwiek wyjaśnienia.
A jeśli potrzebujesz kompletnego źródła wiedzy o zaawansowanych tematach ML, zapisz się na naszą ścieżkę Machine Learning Scientist in Python.
Ucz się z DataCamp
course
course
course