Curso
Comprender el machine learning
2 h
308K
Que un modelo aprenda sin datos etiquetados suena imposible, pero esa es justo la idea detrás del aprendizaje contrastivo.
Como sabes, etiquetar datos es lento y caro. Un único dataset de clasificación de imágenes suele requerir miles de horas de anotación humana, y eso sin contar errores e inconsistencias.
El aprendizaje contrastivo sortea este problema enseñando a los modelos a comparar. En vez de decirle al modelo qué es cada cosa, le muestras qué ejemplos son parecidos y cuáles son distintos, y dejas que deduzca el resto.
En este artículo te explico la intuición detrás del aprendizaje contrastivo, cómo funciona por dentro, dónde se usa en la práctica —desde el reconocimiento de imágenes hasta embeddings en PLN— y cómo implementarlo en PyTorch.
¿Qué es exactamente la visión por computador? Lee nuestra guía para principiantes sobre análisis de imágenes.
El aprendizaje contrastivo es un enfoque de entrenamiento en el que un modelo aprende comparando en lugar de clasificando.
En vez de decirle al modelo "esto es un gato" o "esto es un perro", le muestras pares de ejemplos y dejas que descubra qué va junto y qué no. El modelo aprende determinando si dos cosas son similares o no.
Dicho de otro modo: alimentas al modelo con dos datos a la vez. Si están relacionados —por ejemplo, dos fotos del mismo perro desde ángulos distintos— tienes un par positivo. Si no están relacionados —una foto de un perro y otra de un coche— es un par negativo.
La tarea del modelo es producir representaciones (vectores numéricos) que respeten esta estructura. Los pares positivos deben quedar cerca en el espacio vectorial. Los negativos, lejos.
La forma más sencilla de entenderlo es con imágenes.
Toma una foto de un perro. Crea dos versiones: una recortada y otra con el brillo modificado. El contenido es el mismo, pero los píxeles cambian. Un modelo contrastivo ve estas dos versiones como un par positivo y aprende a ubicarlas en posiciones próximas en el espacio vectorial.
Si junto a esa foto del perro le muestras una de un coche, obtendrás un par negativo. El modelo aprende a separar sus representaciones.
No necesitas intervenir manualmente diciendo "esto es un perro" o "esto es un coche". El modelo construye su comprensión a partir de la estructura de similitudes y diferencias.
Ahí reside la fuerza del aprendizaje contrastivo.
La señal viene de la comparación. Con suficientes pares, el modelo desarrolla representaciones que captan qué hace que las cosas se parezcan y qué las diferencia.
Y esas representaciones resultan muy útiles. Un modelo entrenado así con imágenes puede ajustarse (fine-tuning) para clasificación, detección o búsqueda con muy pocos datos etiquetados, porque ya ha aprendido algo relevante sobre el mundo visual.
El aprendizaje contrastivo aparece en muchos ámbitos. Aquí es donde más lo verás.
Aquí fue donde primero demostró su potencial.
Los modelos entrenados así con imágenes aprenden a producir representaciones que captan la similitud visual sin ver ni una sola etiqueta. Dos fotos de la misma escena, tomadas desde ángulos o con iluminaciones distintos, deben mapearse a puntos cercanos. Dos escenas no relacionadas, lejos.
Puedes tomar un modelo preentrenado de forma contrastiva y ajustarlo para clasificación o detección de objetos con una fracción de los datos etiquetados que necesitarías de otro modo.
En PLN, el aprendizaje contrastivo se usa para entrenar embeddings de frases: representaciones vectoriales que captan el significado de una oración en su conjunto.
Las frases con significados similares deben quedar cerca en el espacio vectorial, y las no relacionadas, separadas. Los modelos entrenados así pueden hacer búsqueda semántica o medir similitud entre oraciones sin grandes volúmenes de pares etiquetados.
Los sistemas de recomendación emplean aprendizaje contrastivo para modelar la similitud usuario–ítem.
Un usuario y un ítem con el que ha interactuado forman un par positivo. Un usuario y un ítem aleatorio que nunca ha visto forman un par negativo. Con suficientes ejemplos, el modelo aprende un espacio compartido donde usuarios e ítems relevantes se agrupan.
Aquí es donde el aprendizaje contrastivo se pone interesante.
Modelos como CLIP lo usan para alinear texto e imágenes en un espacio vectorial compartido. Una foto de un perro y la frase "a dog playing in the park" deben quedar cerca. Una foto de un perro y la frase "a red sports car" no. Esto permite emparejar imágenes con descripciones de texto y generar leyendas.
El aprendizaje contrastivo siempre sigue los mismos cuatro pasos, trabajes con imágenes, texto o audio.
Cada ejemplo de entrenamiento empieza como un par. Muestras dos datos y etiquetas su relación como similar (positivo) o distinta (negativo). En la práctica, los pares positivos suelen venir de aumentar el mismo input de dos formas distintas, y los negativos de muestrear ejemplos no relacionados.
Ambos puntos pasan por un codificador que los convierte en vectores. Estos vectores, llamados embeddings, son representaciones numéricas que viven en un espacio vectorial compartido. El objetivo es que ese espacio refleje el significado semántico, no los píxeles o tokens en bruto.
Una vez tienes dos embeddings, mides lo cerca que están. La similitud del coseno es la opción más común. Da una puntuación entre -1 y 1, donde 1 significa que los vectores apuntan en la misma dirección y -1 que son opuestos.
El modelo compara sus puntuaciones de similitud con lo que deberían ser. Para pares positivos, alta; para negativos, baja. Una función de pérdida mide el error y la retropropagación ajusta los pesos del codificador para mejorar en la siguiente iteración.
Si repites estos pasos con suficientes pares, el codificador aprenderá a producir embeddings que agrupen lo similar y separen lo distinto.
La calidad de tu modelo contrastivo depende de cómo crees los pares.
Los pares positivos son dos datos que deberían considerarse similares. En visión por computador, suelen ser dos versiones aumentadas de la misma imagen. En PLN, pueden ser dos paráfrasis de una misma frase, o una oración y su traducción. El modelo aprende que lo que varía entre ellas no importa. Lo único relevante es lo compartido.
Los pares negativos son dos datos que deberían considerarse distintos. La mayoría de implementaciones muestrean negativos al azar del resto del dataset. Si entrenas con imágenes, dos imágenes de objetos diferentes forman un par negativo válido.
Aquí viene lo complicado.
No todos los negativos son igual de útiles. Un negativo aleatorio que es obviamente distinto —por ejemplo, una foto de un perro con una de un avión— no obliga al modelo a esforzarse. Son los llamados negativos fáciles, y entrenar con demasiados de ellos ralentiza el aprendizaje.
En el otro extremo, los negativos difíciles son datos que se parecen al origen pero pertenecen a otra clase: dos razas de perro, por ejemplo, o dos oraciones con redacción similar pero distinto significado. El modelo debe aprender representaciones más finas para distinguirlos, lo que produce mejores embeddings en general.
La misma lógica aplica a los positivos. Si tus aumentos son demasiado sutiles, el modelo aprende poco. Si son demasiado agresivos, el par deja de ser realmente similar.
La función de pérdida convierte las comparaciones de pares en señal de aprendizaje.
Cada función de pérdida opera de forma distinta, pero todas comparten el mismo objetivo: premiar al modelo cuando las cosas similares quedan cerca en el espacio vectorial y penalizarlo cuando no.
La pérdida contrastiva se introdujo junto con los primeros trabajos en aprendizaje contrastivo.
Opera con pares. Dado un par positivo, penaliza al modelo si sus embeddings están muy separados. Dado un par negativo, lo penaliza si están demasiado cerca, en concreto si caen dentro de un margen definido. Los negativos que ya están lo bastante lejos no contribuyen a la pérdida.
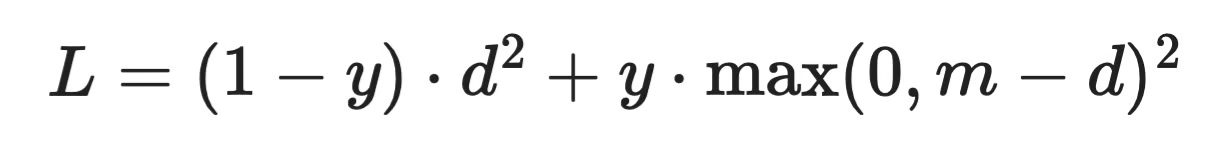
Fórmula de la pérdida contrastiva
Donde d es la distancia entre dos embeddings, y vale 1 para pares negativos y 0 para pares positivos, y m es el margen. El margen es un hiperparámetro que estableces manualmente, lo que hace que esta pérdida sea sensible al ajuste fino.
La pérdida tripleta trabaja con tres datos a la vez: un ancla, un positivo y un negativo.
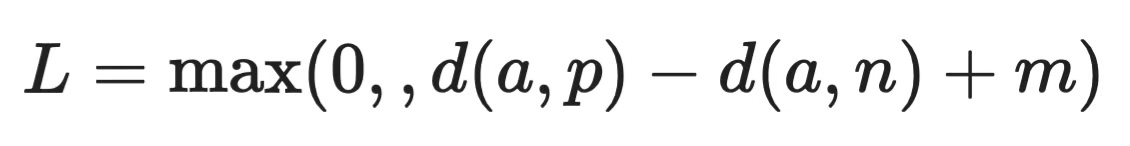
Fórmula de la pérdida tripleta
El modelo es penalizado cuando la distancia ancla–positivo d(a, p) no es menor que la distancia ancla–negativo d(a, n) en al menos el margen m. Si ya se cumple, la pérdida es cero.
Esta formulación da más contexto por actualización que la pérdida contrastiva, porque compara ambas relaciones a la vez en lugar de una por una.
InfoNCE es la pérdida detrás de la mayoría de métodos modernos de aprendizaje contrastivo, como SimCLR y CLIP.
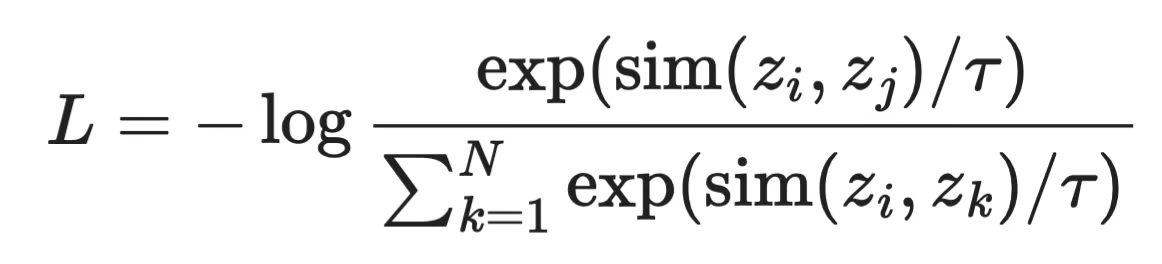
Fórmula de la pérdida InfoNCE
Para cada ancla z_i, el modelo debe identificar su positivo z_j entre los otros N ejemplos del batch. El parámetro de temperatura τ controla lo afilada que es la distribución: valores bajos hacen el modelo más confiado; valores altos suavizan el contraste entre pares.
Obtienes más negativos por actualización, lo que aporta más señal de aprendizaje. También implica que batches grandes exponen al modelo a negativos más difíciles y, por lo general, producen mejores representaciones.
El aprendizaje contrastivo y el auto-supervisado encajan bien, y al entender por qué, entenderás hacia dónde va el ML moderno.
El aprendizaje auto-supervisado es un enfoque en el que el propio modelo genera etiquetas a partir de los datos, sin anotación humana. En vez de que alguien etiquete miles de imágenes como "gato" o "perro", es el propio dato el que aporta la señal de supervisión.
El aprendizaje contrastivo hace exactamente eso. Cuando tomas una imagen, creas dos versiones aumentadas y le dices al modelo que forman un par positivo, acabas de crear una etiqueta.
Esto importa porque los datos etiquetados son el cuello de botella en la mayoría de pipelines de ML. Recolectarlos es lento, anotar es caro y, en algunos dominios como la imagen médica, apenas hay suficientes.
Los resultados son prometedores. Modelos preentrenados con objetivos contrastivos auto-supervisados sobre grandes datasets no etiquetados han igualado o rozado los baselines supervisados en múltiples tareas downstream, tras un ajuste con solo una pequeña cantidad de datos etiquetados.
La tendencia general es alejarse de entrenamientos supervisados específicos de tarea y avanzar hacia representaciones de propósito general aprendidas a escala a partir de datos en bruto. Métodos como SimCLR, MoCo y BYOL siguen esta línea, y los veremos a continuación.
Estos son los tres frameworks más influyentes detrás del aprendizaje contrastivo en 2026.
SimCLR, presentado por Google Research, es una de las implementaciones más claras de la idea contrastiva.
Para cada imagen del batch, crea dos vistas aumentadas y las trata como par positivo. Todas las demás imágenes del batch se convierten en negativas. El modelo, una CNN seguida de una pequeña cabeza de proyección, aprende a acercar los pares positivos usando la pérdida InfoNCE.
Lo que hizo destacar a SimCLR fue lo mucho que importaba el tamaño del batch. Batches más grandes implican más negativos por actualización y mejores representaciones. La contrapartida es la memoria. Como SimCLR requiere batches grandes para rendir bien, necesitas buen hardware para sacarle partido.
MoCo (Momentum Contrast), de Meta AI Research, se diseñó para resolver justo ese problema.
En lugar de depender de un batch grande para obtener negativos, MoCo mantiene una cola: un buffer de representaciones codificadas de batches previos. Así desacopla el número de negativos del tamaño del batch, de modo que puedes entrenar con mucha menos memoria y aun así exponer al modelo a un gran conjunto de negativos.
También usa un codificador de momentum, una copia del codificador principal que se actualiza lentamente, para mantener coherentes en el tiempo las representaciones de la cola.
BYOL (Bootstrap Your Own Latent) merece mención aunque no usa pares negativos en absoluto.
En vez de alejar negativos, BYOL entrena una red para predecir las representaciones de otra —una red objetivo que se actualiza lentamente. No hay negativos ni pérdida contrastiva. Funciona sorprendentemente bien, y su éxito cuestionó la idea de que los pares negativos son imprescindibles para este estilo de aprendizaje.
BYOL está en el límite de lo contrastivo, pero es un buen siguiente paso una vez entiendes los métodos base.
Ambos enfoques resuelven el mismo problema, pero parten de supuestos distintos que conviene entender.
El aprendizaje supervisado requiere datos etiquetados. Cada ejemplo necesita una etiqueta asignada por humanos, y el modelo aprende mapeando inputs a esas etiquetas. Es un enfoque directo y funciona bien cuando tienes suficientes ejemplos etiquetados. El modelo sabe qué es el input y cuál es la respuesta correcta.
El aprendizaje contrastivo genera su propia supervisión a partir de la estructura del dato —similitudes y diferencias— y aprende representaciones sin ver etiquetas.
Aquí tienes una comparación más visual de ambos enfoques:
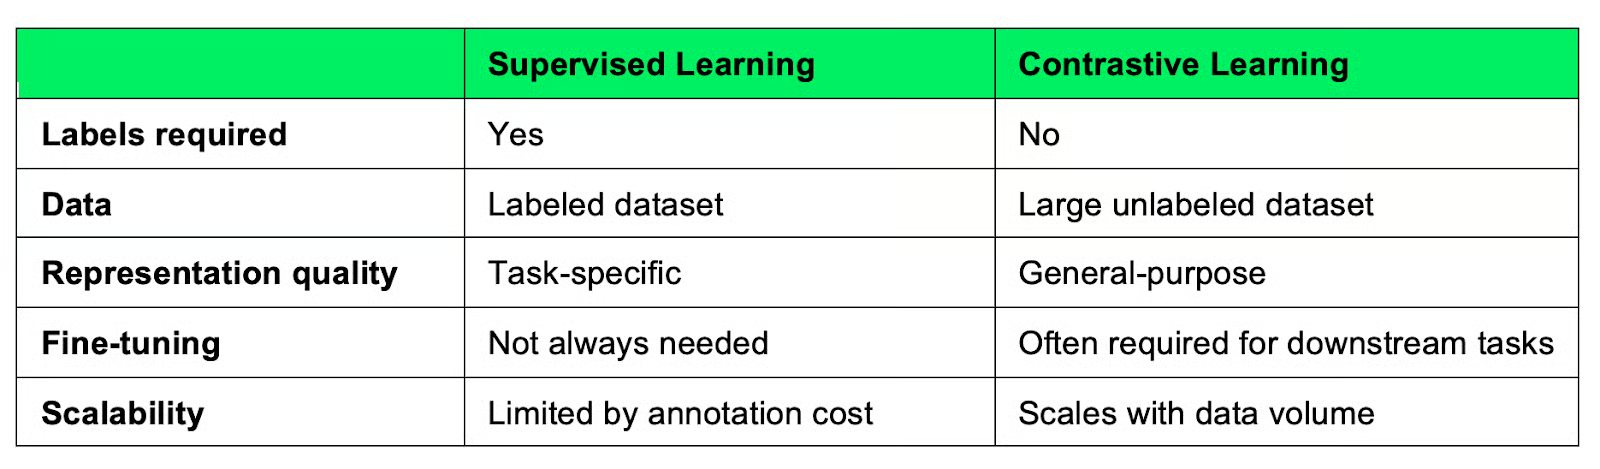
Aprendizaje contrastivo frente a supervisado
La mayor diferencia se ve a escala. El supervisado depende de datos etiquetados —y etiquetar más es caro—. El contrastivo puede seguir mejorando a medida que le das más datos sin etiquetar, que suelen abundar.
Ahora bien, las representaciones que aprende un modelo contrastivo son generales, no específicas de una tarea; por eso normalmente necesitarás una fase de fine-tuning para rendir bien en una tarea concreta. Los modelos supervisados no requieren ese paso porque se entrenan directamente con el objetivo final.
La elección depende de tu situación de datos. Si tienes datos etiquetados y una tarea concreta, el supervisado suele ser más rápido. Si trabajas con grandes volúmenes sin etiquetar o necesitas representaciones transferibles entre tareas, el contrastivo puede compensar la mayor preparación inicial.
Vamos a crear una implementación mínima en PyTorch. El ejemplo cubre las tres ideas clave ya comentadas: un modelo de embeddings, la similitud del coseno y la pérdida NT-Xent —la usada en SimCLR, basada en InfoNCE.
El codificador es una red feedforward sencilla que mapea vectores de entrada a un espacio de embedding de menor dimensión.
import torch
import torch.nn as nn
import torch.nn.functional as F

class Encoder(nn.Module):
    def __init__(self, input_dim, embedding_dim):
        super().__init__()
        self.network = nn.Sequential(
            nn.Linear(input_dim, 128),
            nn.ReLU(),
            nn.Linear(128, embedding_dim)
        )

    def forward(self, x):
        return self.network(x)
En la práctica, lo sustituirías por una CNN para imágenes o un transformer para texto. La arquitectura importa menos que lo que viene después.
Una vez tienes dos embeddings, mides su cercanía con la similitud del coseno. Normalizar primero los vectores mantiene las puntuaciones acotadas entre -1 y 1.
def cosine_similarity(z1, z2):
    z1 = F.normalize(z1, dim=-1)
    z2 = F.normalize(z2, dim=-1)
    return torch.matmul(z1, z2.T)
El resultado es una matriz donde cada entrada [i, j] representa la similitud entre el embedding i y el embedding j dentro del batch.
NT-Xent (Normalized Temperature-scaled Cross Entropy) es la pérdida basada en InfoNCE. Para cada ancla, trata su vista emparejada como positivo y todos los demás ejemplos del batch como negativos.
def nt_xent_loss(z1, z2, temperature=0.5):
    batch_size = z1.shape[0]

    z = torch.cat([z1, z2], dim=0)
    z = F.normalize(z, dim=-1)
    sim_matrix = torch.matmul(z, z.T) / temperature

    mask = torch.eye(2 * batch_size, dtype=torch.bool)
    sim_matrix = sim_matrix.masked_fill(mask, float("-inf"))

    labels = torch.arange(batch_size)
    labels = torch.cat([labels + batch_size, labels])

    return F.cross_entropy(sim_matrix, labels)
El parámetro temperature controla lo afilada que es la distribución. Valores bajos hacen que el modelo esté más seguro de qué par es positivo; valores altos suavizan el contraste.
encoder = Encoder(input_dim=64, embedding_dim=32)
optimizer = torch.optim.Adam(encoder.parameters(), lr=1e-3)

# Simular un batch de pares positivos
x1 = torch.randn(32, 64)
x2 = torch.randn(32, 64)

# Entrenamiento
optimizer.zero_grad()
z1, z2 = encoder(x1), encoder(x2)
loss = nt_xent_loss(z1, z2)
loss.backward()
optimizer.step()

print(f"Loss: {loss.item():.4f}")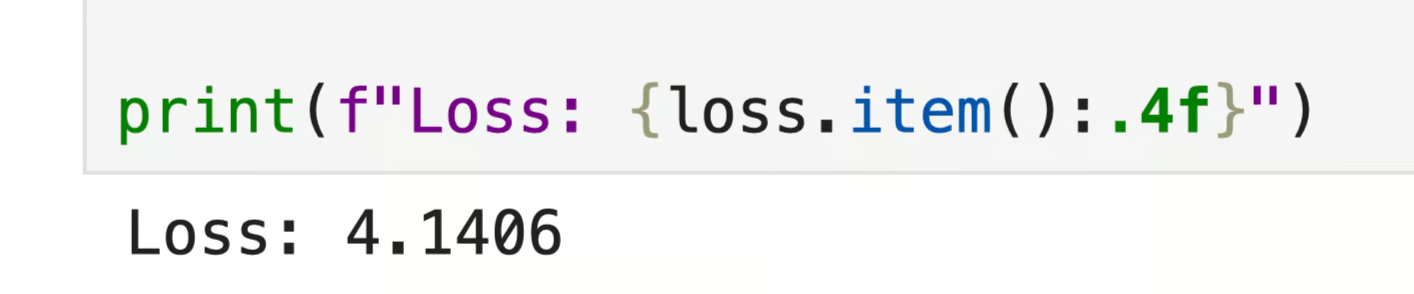
Salida del bucle contrastivo
Este es el bucle contrastivo completo en su forma más simple. En una implementación real, x1 y x2 serían dos vistas aumentadas del mismo input en lugar de ruido aleatorio, pero la estructura es exactamente la misma.
El aprendizaje contrastivo es una idea sencilla con mucho alcance.
Enseña a los modelos a entender la estructura comparando, en lugar de depender de datos etiquetados. Acerca lo similar y separa lo diferente: esa es la premisa. Y resulta suficiente para aprender representaciones que se transfieren bien entre tareas.
El campo se está alejando de pipelines cargados de anotación, y el aprendizaje contrastivo es una gran parte del motivo. Algoritmos como SimCLR, MoCo y CLIP ya han llegado a productos reales, lo que dice mucho de lo bien que funciona este enfoque.
Si quieres profundizar, el siguiente paso ideal es trastear con una implementación real. El ejemplo en PyTorch de este artículo es un punto de partida, pero ejecutar SimCLR sobre un dataset de imágenes —aunque sea pequeño— te enseñará más que cualquier explicación.
Y si buscas el recurso definitivo para temas avanzados de machine learning, apúntate a nuestro itinerario Machine Learning Scientist in Python.
Aprende con DataCamp
Curso
Curso
Curso
blog
Arun Nanda
15 min
blog
Zoumana Keita
14 min
blog
Natassha Selvaraj
15 min
Tutorial
Kurtis Pykes
14 min
Tutorial
Richmond Alake
12 min
Tutorial
Arjun Sarkar
15 min



