Cours
Comprendre le Machine Learning
2 h
308K
Faire apprendre un modèle sans données étiquetées semble impossible, et pourtant c’est précisément le principe de l’apprentissage contrastif.
Comme vous le savez, l’étiquetage des données est lent et coûteux. Un simple jeu de données de classification d’images nécessite souvent des milliers d’heures d’annotation humaine, sans même compter les erreurs et incohérences.
L’apprentissage contrastif contourne ce problème d’étiquetage en apprenant aux modèles à comparer. Au lieu de dire à un modèle ce qu’est une chose, vous lui montrez ce qui se ressemble et ce qui diffère — et vous le laissez déduire le reste.
Dans cet article, je vous présente l’intuition derrière l’apprentissage contrastif, son fonctionnement en coulisses, ses usages concrets — de la reconnaissance d’images aux embeddings en NLP — et comment l’implémenter avec PyTorch.
Qu’est-ce que la vision par ordinateur, au juste ? Lisez notre guide d’initiation à l’analyse d’images.
L’apprentissage contrastif est une approche d’entraînement où un modèle apprend par comparaison plutôt que par classification.
Au lieu de lui dire « c’est un chat » ou « c’est un chien », vous lui montrez des paires d’exemples et vous le laissez déterminer ce qui va ensemble et ce qui n’y va pas. Le modèle apprend en décidant si deux éléments sont similaires ou non.
Autrement dit, vous fournissez au modèle deux points de données à la fois. S’ils sont liés — par exemple, deux photos du même chien prises sous des angles différents — c’est une paire positive. S’ils sont sans lien — une photo de chien et une photo de voiture — c’est une paire négative.
Le rôle du modèle est de produire des représentations (vecteurs numériques) qui respectent cette structure. Les paires positives doivent se retrouver proches dans l’espace vectoriel. Les paires négatives doivent être éloignées.
Le moyen le plus simple de comprendre l’apprentissage contrastif est via les images.
Prenez une photo d’un chien. Créez ensuite deux versions — l’une recadrée, l’autre avec une luminosité modifiée. Le contenu perçu est le même, mais les pixels diffèrent. Un modèle contrastif voit ces deux versions comme une paire positive et apprend à les projeter à des positions proches dans l’espace vectoriel.
Si vous montrez au modèle une photo de voiture en parallèle de la photo du chien, vous obtenez une paire négative. Le modèle apprend à éloigner leurs représentations.
Vous n’avez pas besoin d’indiquer manuellement « c’est un chien » ou « c’est une voiture ». Le modèle construit sa compréhension à partir des structures de similarité et de différence.
C’est ce qui rend l’apprentissage contrastif puissant.
Le signal vient de la comparaison. Avec suffisamment de paires, le modèle apprend des représentations qui capturent ce qui rapproche les choses et ce qui les différencie.
Ces représentations sont réellement utiles. Un modèle entraîné de cette façon sur des images peut être affiné pour des tâches de classification, de détection ou de recherche avec très peu de données étiquetées, car il a déjà acquis une compréhension pertinente du monde visuel.
L’apprentissage contrastif s’invite dans de nombreux domaines — voici ceux où vous le verrez le plus souvent.
C’est là qu’il a d’abord fait ses preuves.
Des modèles entraînés ainsi sur des images apprennent à produire des représentations sensibles à la similarité visuelle sans avoir vu le moindre label. Deux photos d’une même scène, prises sous des angles ou éclairages différents, doivent se projeter en des points proches. Deux scènes sans lien doivent être éloignées.
Vous pouvez prendre un modèle pré-entraîné de manière contrastive et le peaufiner pour la classification ou la détection d’objets avec une fraction des données étiquetées normalement nécessaires.
En NLP, l’apprentissage contrastif sert à entraîner des embeddings de phrases — des représentations vectorielles qui captent le sens global d’une phrase.
Des phrases de sens proche doivent être voisines dans l’espace vectoriel, tandis que des phrases sans rapport doivent être éloignées. Des modèles ainsi entraînés peuvent réaliser des tâches comme la recherche sémantique et la similarité de phrases, sans disposer de grandes quantités de paires étiquetées.
Les systèmes de recommandation utilisent l’apprentissage contrastif pour modéliser la similarité utilisateur-produit.
Un utilisateur et un article avec lequel il a interagi forment une paire positive. Un utilisateur et un article aléatoire qu’il n’a jamais vu forment une paire négative. En entraînant sur suffisamment de cas, le modèle apprend un espace partagé où utilisateurs et articles pertinents se regroupent.
C’est ici que l’apprentissage contrastif devient particulièrement intéressant.
Des modèles comme CLIP l’utilisent pour aligner textes et images dans un espace vectoriel commun. Une photo de chien et la phrase « a dog playing in the park » doivent finir proches. Une photo de chien et la phrase « a red sports car » ne doivent pas. Cela permet aux modèles multimodaux d’associer des images à des descriptions textuelles et de générer des légendes.
L’apprentissage contrastif suit toujours les mêmes quatre étapes, que vous travailliez sur des images, du texte ou de l’audio.
Chaque exemple d’entraînement commence par une paire. Vous échantillonnez deux points de données et étiquetez leur relation comme similaire (positive) ou dissemblable (négative). En pratique, les paires positives proviennent souvent de deux augmentations d’une même entrée, et les paires négatives d’exemples sans lien.
Les deux points de données traversent un encodeur qui les convertit en vecteurs. Ces vecteurs, appelés embeddings, sont des représentations numériques dans un espace vectoriel commun. L’objectif est que cet espace reflète le sens sémantique, et non les valeurs brutes de pixels ou de tokens.
Une fois les deux embeddings obtenus, vous mesurez leur proximité. La similarité cosinus est le choix le plus courant. Elle renvoie un score entre -1 et 1 : 1 signifie que les vecteurs pointent dans la même direction, -1 qu’ils sont opposés.
Le modèle compare ses scores de similarité à ceux attendus. Pour les paires positives, le score doit être élevé. Pour les paires négatives, il doit être bas. Une fonction de perte mesure l’écart et la rétropropagation ajuste les poids de l’encodeur pour faire mieux au prochain passage.
En répétant ces étapes sur suffisamment de paires, l’encodeur apprend à produire des embeddings qui regroupent les éléments similaires et éloignent les différents.
La qualité de votre modèle contrastif dépend de la façon dont vous créez vos paires.
Les paires positives sont deux points de données qui doivent être considérés comme similaires. En vision, cela correspond généralement à deux versions augmentées de la même image. En NLP, il peut s’agir de deux paraphrases d’une même phrase, ou d’une phrase et de sa traduction. Le modèle apprend que ce qui varie entre elles n’a pas d’importance. Seul compte ce qui est partagé.
Les paires négatives sont deux points de données qui doivent être considérés comme différents. La plupart des implémentations échantillonnent des négatifs aléatoirement dans le reste du jeu de données. Si vous entraînez sur des images, n’importe quelles images d’objets différents forment une paire négative valable.
C’est là que ça se complique.
Tous les négatifs ne se valent pas. Un négatif aléatoire, manifestement différent de la source — par exemple, une photo de chien appariée à un avion — ne sollicite pas beaucoup le modèle. On parle de négatifs faciles, et en entraîner trop ralentit l’apprentissage.
À l’inverse, les négatifs difficiles ressemblent à la source mais appartiennent à une autre classe — deux races de chiens, par exemple, ou deux phrases au phrasé proche mais de sens différent. Le modèle doit développer des représentations plus fines pour les distinguer, ce qui améliore globalement les embeddings.
La même logique s’applique aux positives. Si vos augmentations sont trop subtiles, le modèle n’apprend pas grand-chose. Si elles sont trop agressives, la paire n’est plus réellement similaire.
La fonction de perte transforme les comparaisons de paires en signaux d’apprentissage.
Chaque fonction de perte opère différemment, mais elles partagent toutes le même objectif : récompenser le modèle quand les éléments similaires sont proches dans l’espace vectoriel, et le pénaliser lorsqu’ils ne le sont pas.
La contrastive loss a été introduite avec les premiers travaux sur l’apprentissage contrastif.
Elle opère sur des paires. Pour une paire positive, elle pénalise le modèle si leurs embeddings sont éloignés. Pour une paire négative, elle le pénalise s’ils sont trop proches — en particulier s’ils tombent dans une marge définie. Les négatifs déjà suffisamment éloignés ne contribuent pas à la perte.
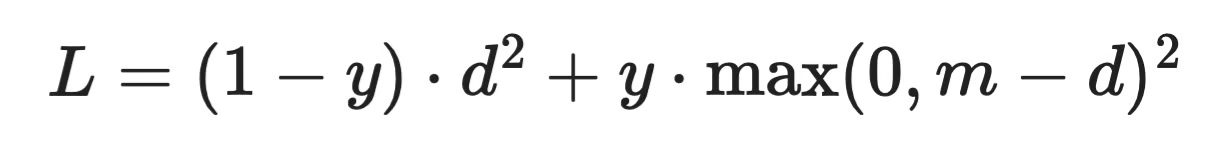
Formule de la contrastive loss
Où d est la distance entre deux embeddings, y vaut 1 pour les paires négatives et 0 pour les positives, et m est la marge. La marge est un hyperparamètre que vous définissez manuellement, ce qui rend cette perte sensible au réglage.
La triplet loss utilise trois points de données à la fois : une ancre, un positif et un négatif.
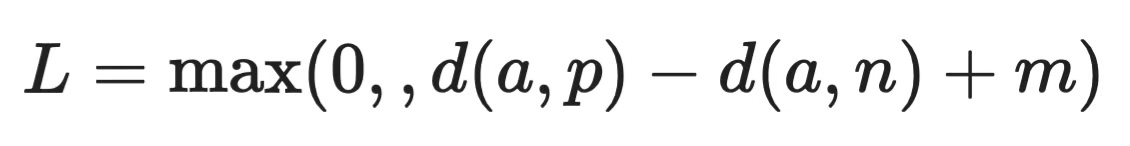
Formule de la triplet loss
Le modèle est pénalisé lorsque la distance ancre-positif d(a, p) n’est pas inférieure à la distance ancre-négatif d(a, n) d’au moins la marge m. Si cette condition est déjà satisfaite, la perte est nulle.
Cette formulation fournit plus de contexte par mise à jour que la contrastive loss, car elle compare simultanément les deux relations plutôt qu’une à la fois.
InfoNCE est la perte au cœur de la plupart des méthodes modernes d’apprentissage contrastif, dont SimCLR et CLIP.
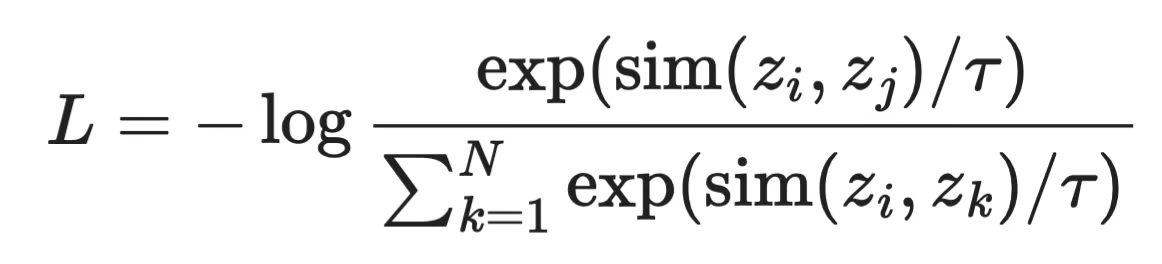
Formule de la perte InfoNCE
Pour chaque ancre z_i, le modèle doit identifier son positif z_j parmi tous les autres exemples N du lot. Le paramètre de température τ contrôle l’acuité de la distribution : des valeurs plus basses rendent le modèle plus confiant, des valeurs plus élevées adoucissent le contraste entre les paires.
On obtient davantage de négatifs par mise à jour, ce qui fournit plus de signal d’apprentissage. Cela signifie aussi que des lots plus grands exposent le modèle à des négatifs plus difficiles et produisent en général de meilleures représentations.
L’apprentissage contrastif et l’auto-supervision fonctionnent très bien ensemble, et comprendre pourquoi éclaire la trajectoire actuelle du ML.
L’auto-supervision est une approche d’entraînement où le modèle génère ses propres labels à partir des données, sans annotation humaine. Au lieu que quelqu’un étiquette des milliers d’images « chat » ou « chien », c’est la donnée elle-même qui fournit le signal de supervision.
L’apprentissage contrastif fait exactement cela. Lorsque vous prenez une image, créez deux versions augmentées et indiquez au modèle qu’il s’agit d’une paire positive, vous venez de créer un label.
C’est crucial car les données étiquetées constituent le goulet d’étranglement de la plupart des pipelines ML. Les collecter est lent, l’annotation coûteuse, et certains domaines, comme l’imagerie médicale, en manquent cruellement.
Les résultats sont prometteurs. Des modèles pré-entraînés avec des objectifs contrastifs auto-supervisés sur de grands jeux non étiquetés égalent ou approchent les références supervisées sur de nombreuses tâches aval, après un fin réglage sur une petite quantité de données étiquetées.
La tendance générale est de s’éloigner d’entraînements supervisés spécifiques à une tâche pour aller vers des représentations généralistes apprises à grande échelle à partir de données brutes. Des méthodes comme SimCLR, MoCo et BYOL s’inscrivent dans cette voie — je les présente ci-dessous.
Voici les trois cadres qui ont le plus influencé l’apprentissage contrastif en 2026.
SimCLR, présenté par Google Research, est l’une des implémentations les plus limpides de l’idée contrastive.
Pour chaque image d’un lot, il crée deux vues augmentées et les considère comme une paire positive. Toutes les autres images du lot deviennent des négatives. Le modèle, une CNN suivie d’une petite tête de projection, apprend à rapprocher les paires positives en utilisant la perte InfoNCE.
Ce qui a distingué SimCLR, c’est l’importance de la taille de lot. Des lots plus grands signifient plus de négatifs par mise à jour, donc de meilleures représentations. Le compromis, c’est la mémoire. Comme SimCLR exige de grands lots pour bien fonctionner, il faut du matériel solide pour en tirer le meilleur.
MoCo (Momentum Contrast), développé par Meta AI Research, a été conçu précisément pour résoudre ce problème.
Au lieu de dépendre d’un grand lot pour les négatifs, MoCo maintient une file — un tampon évolutif de représentations encodées issues des lots précédents. Cela découple le nombre de négatifs de la taille du lot : on peut donc entraîner avec bien moins de mémoire tout en exposant le modèle à un grand réservoir de négatifs.
Il utilise aussi un encodeur à momentum, copie mise à jour lentement de l’encodeur principal, afin de garder cohérentes dans le temps les représentations en file.
BYOL (Bootstrap Your Own Latent) mérite d’être cité même s’il n’utilise aucun négatif.
Plutôt que d’éloigner des négatifs, BYOL entraîne un réseau à prédire les représentations d’un autre — un réseau cible mis à jour lentement. Il n’y a ni négatifs ni perte contrastive. Et pourtant, cela fonctionne remarquablement bien, remettant en cause l’idée que les paires négatives sont indispensables à l’apprentissage de type contrastif.
BYOL se situe à la frontière de l’apprentissage contrastif, mais c’est une bonne étape suivante une fois les méthodes cœur assimilées.
Ces deux approches visent le même objectif, mais reposent sur des postulats différents qu’il faut comprendre.
L’apprentissage supervisé exige des données étiquetées. Chaque exemple d’entraînement a besoin d’un label attribué par un humain, et le modèle apprend à associer entrées et labels. C’est direct et efficace quand on dispose de suffisamment d’exemples étiquetés. Le modèle sait ce qu’est l’entrée et quelle est la bonne réponse.
L’apprentissage contrastif génère sa propre supervision à partir de la structure des données — similarités et différences — et apprend des représentations sans jamais voir de label.
Voici une représentation plus visuelle de la comparaison :
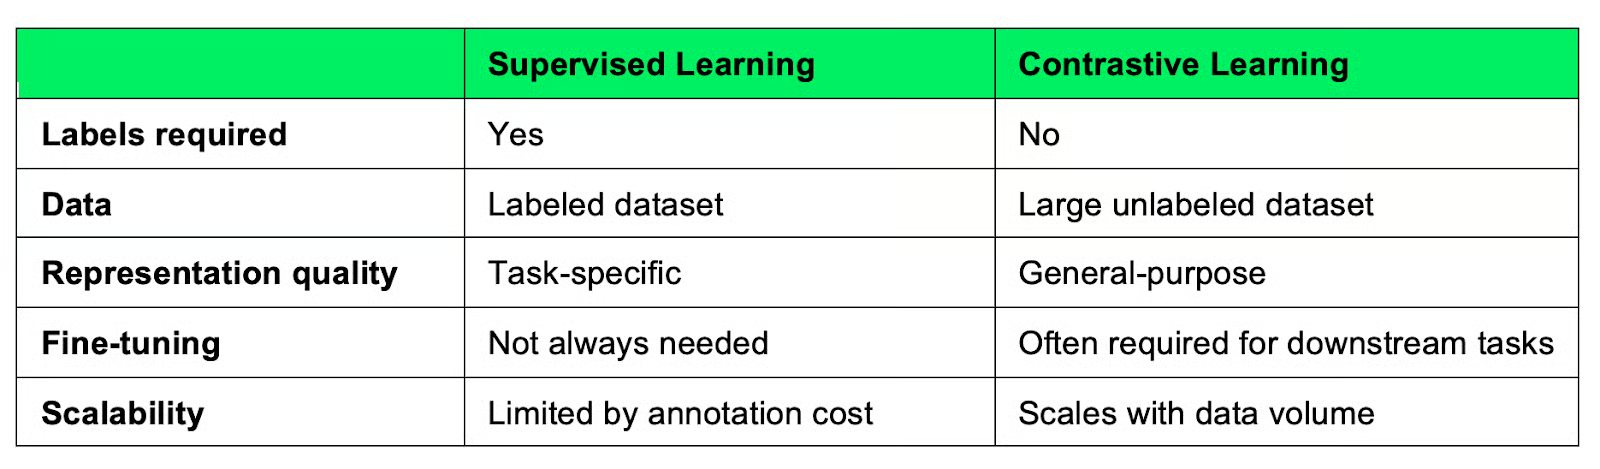
Apprentissage contrastif comparé à l’apprentissage supervisé
La différence se voit surtout à l’échelle. L’apprentissage supervisé dépend des données étiquetées — et en produire davantage coûte cher. L’apprentissage contrastif peut continuer à s’améliorer à mesure qu’on lui fournit plus de données non étiquetées, généralement abondantes.
Mais il est important de noter que les représentations apprises en contrastif sont générales, non spécifiques à une tâche, ce qui impose en général une étape de fine-tuning pour de bonnes performances sur une tâche précise. Les modèles supervisés n’en ont pas besoin car ils sont entraînés directement sur l’objectif cible.
Le choix dépend de votre contexte de données. Si vous avez des labels et une tâche précise, l’apprentissage supervisé est souvent plus rapide. Si vous travaillez avec de grands volumes de données non étiquetées ou si vous avez besoin de représentations transférables entre tâches, l’apprentissage contrastif peut valoir l’effort supplémentaire de mise en place.
Passons à une implémentation PyTorch minimale. L’exemple ci-dessous couvre trois idées clés vues plus haut : un modèle d’embedding, la similarité cosinus et la perte NT-Xent — la fonction de perte de SimCLR, fondée sur InfoNCE.
L’encodeur est un simple réseau feedforward qui projette des vecteurs d’entrée dans un espace d’embedding de plus faible dimension.
import torch
import torch.nn as nn
import torch.nn.functional as F

class Encoder(nn.Module):
    def __init__(self, input_dim, embedding_dim):
        super().__init__()
        self.network = nn.Sequential(
            nn.Linear(input_dim, 128),
            nn.ReLU(),
            nn.Linear(128, embedding_dim)
        )

    def forward(self, x):
        return self.network(x)
En pratique, vous remplacerez ceci par une CNN pour les images ou un transformeur pour le texte. L’architecture compte moins que ce qui vient après.
Une fois que vous avez deux embeddings, vous mesurez leur proximité avec la similarité cosinus. Normaliser d’abord les vecteurs borne les scores entre -1 et 1.
def cosine_similarity(z1, z2):
    z1 = F.normalize(z1, dim=-1)
    z2 = F.normalize(z2, dim=-1)
    return torch.matmul(z1, z2.T)
Le résultat est une matrice où chaque entrée [i, j] représente la similarité entre l’embedding i et l’embedding j au sein du lot.
NT-Xent (Normalized Temperature-scaled Cross Entropy) est la perte basée sur InfoNCE. Pour chaque ancre, elle considère sa vue appariée comme positif et toutes les autres observations du lot comme négatifs.
def nt_xent_loss(z1, z2, temperature=0.5):
    batch_size = z1.shape[0]

    z = torch.cat([z1, z2], dim=0)
    z = F.normalize(z, dim=-1)
    sim_matrix = torch.matmul(z, z.T) / temperature

    mask = torch.eye(2 * batch_size, dtype=torch.bool)
    sim_matrix = sim_matrix.masked_fill(mask, float("-inf"))

    labels = torch.arange(batch_size)
    labels = torch.cat([labels + batch_size, labels])

    return F.cross_entropy(sim_matrix, labels)
Le paramètre de temperature contrôle l’acuité de la distribution. Des valeurs plus faibles rendent le modèle plus confiant sur la paire positive ; des valeurs plus élevées atténuent le contraste.
encoder = Encoder(input_dim=64, embedding_dim=32)
optimizer = torch.optim.Adam(encoder.parameters(), lr=1e-3)

# Simulate a batch of positive pairs
x1 = torch.randn(32, 64)
x2 = torch.randn(32, 64)

# Training
optimizer.zero_grad()
z1, z2 = encoder(x1), encoder(x2)
loss = nt_xent_loss(z1, z2)
loss.backward()
optimizer.step()

print(f("Loss: {loss.item():.4f}"))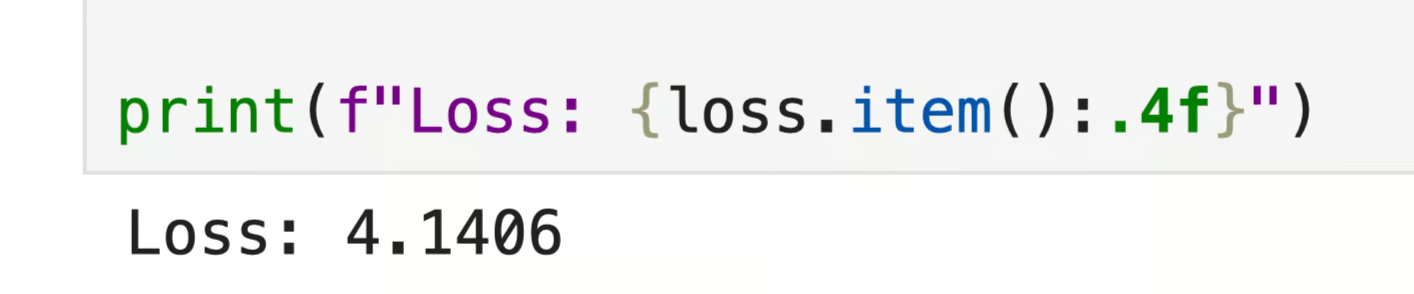
Sortie de la boucle contrastive
Voici la boucle contrastive complète dans sa forme la plus simple. Dans une implémentation réelle, x1 et x2 seraient deux vues augmentées d’une même entrée plutôt que du bruit aléatoire — mais la structure reste exactement la même.
L’apprentissage contrastif est une idée simple au champ d’application vaste.
Il apprend aux modèles à saisir la structure par la comparaison plutôt que de s’appuyer sur des labels. Rapprocher ce qui se ressemble, éloigner ce qui diffère — c’est tout le principe. Et cela suffit pour apprendre des représentations qui se transfèrent bien d’une tâche à l’autre.
Le domaine s’éloigne des pipelines saturés d’annotation, et l’apprentissage contrastif y contribue largement. Des algorithmes comme SimCLR, MoCo et CLIP sont passés en production, preuve de l’efficacité de l’approche.
Pour aller plus loin, mettez la main à la pâte. L’exemple PyTorch de cet article est un point de départ, mais faire tourner SimCLR sur un vrai jeu d’images — même petit — vous apprendra plus que n’importe quelle explication.
Et si vous cherchez la ressource ultime sur les sujets avancés en apprentissage automatique, inscrivez-vous à notre parcours Machine Learning Scientist in Python.
Apprenez avec DataCamp
Cours
Cours
Cours
blog
Tutoriel
Samuel Shaibu
9 min
Tutoriel
Allan Ouko
11 min
Tutoriel
Mark Pedigo
10 min
Tutoriel
Abid Ali Awan
7 min
Tutoriel
DataCamp Team
5 min