
Courses
Tìm hiểu Machine Learning
2 giờ
308K
Để một mô hình học mà không cần dữ liệu gán nhãn nghe có vẻ bất khả thi, nhưng đó chính là ý tưởng đằng sau học tương phản.
Như bạn biết, gán nhãn dữ liệu vừa chậm vừa tốn kém. Một bộ dữ liệu phân loại ảnh thường cần hàng nghìn giờ gắn nhãn thủ công, chưa kể lỗi và thiếu nhất quán.
Học tương phản vượt qua vấn đề gán nhãn bằng cách dạy mô hình biết so sánh. Thay vì nói cho mô hình biết một thứ là gì, bạn cho nó thấy những thứ nào giống nhau và khác nhau — và để nó tự suy ra phần còn lại.
Trong bài viết này, tôi sẽ dẫn bạn qua trực giác đằng sau học tương phản, cách nó hoạt động bên dưới, nơi nó được dùng trong thực tế — từ nhận dạng ảnh đến embedding NLP — và cách triển khai trong PyTorch.
Chính xác thì thị giác máy tính là gì? Hãy đọc hướng dẫn nhập môn về phân tích ảnh của chúng tôi.
Học tương phản là cách huấn luyện trong đó mô hình học bằng so sánh thay vì phân loại.
Thay vì nói với mô hình "đây là mèo" hay "đây là chó", bạn đưa cho nó các cặp ví dụ và để nó tự tìm xem cái gì thuộc về cùng nhóm và cái gì thì không. Mô hình học bằng cách xác định liệu hai thứ có giống nhau hay không.
Nói cách khác — bạn đưa vào mô hình hai điểm dữ liệu mỗi lần. Nếu chúng có liên quan — ví dụ, hai bức ảnh của cùng một con chó chụp ở các góc khác nhau — đó là cặp dương. Nếu chúng không liên quan — một ảnh con chó và một ảnh ô tô — đó là cặp âm.
Nhiệm vụ của mô hình là tạo ra các biểu diễn (vector số) tuân theo cấu trúc này. Các cặp dương phải nằm gần nhau trong không gian vector. Các cặp âm phải ở xa nhau.
Cách dễ nhất để hiểu học tương phản là qua hình ảnh.
Lấy một bức ảnh con chó. Giờ tạo hai phiên bản của nó — một bản cắt cúp, một bản điều chỉnh độ sáng. Nội dung bạn thấy là như nhau, nhưng các điểm ảnh khác nhau. Mô hình học tương phản xem hai phiên bản này là một cặp dương và học cách ánh xạ chúng tới các vị trí gần nhau trong không gian vector.
Nếu bạn cho mô hình xem một ảnh ô tô bên cạnh ảnh con chó đó, bạn sẽ có một cặp âm. Mô hình học cách đẩy các biểu diễn của chúng ra xa nhau.
Bạn không cần can thiệp thủ công để chỉ rõ "đây là chó" hay "đây là ô tô." Mô hình xây dựng hiểu biết từ cấu trúc của sự giống và khác.
Đó là điều làm cho học tương phản trở nên mạnh mẽ.
Tín hiệu đến từ so sánh. Với đủ các cặp, mô hình có thể phát triển các biểu diễn hiểu điều gì làm cho các sự vật giống nhau và điều gì tạo nên sự khác biệt.
Những biểu diễn đó hóa ra rất hữu ích. Một mô hình được huấn luyện theo cách này trên ảnh có thể được fine-tune cho các tác vụ phân loại, phát hiện, hoặc truy hồi chỉ với rất ít dữ liệu gán nhãn, vì nó đã học được điều gì đó có ý nghĩa về thế giới thị giác.
Học tương phản xuất hiện trong nhiều lĩnh vực — dưới đây là nơi bạn sẽ gặp nó nhiều nhất.
Đây là nơi học tương phản lần đầu chứng minh được khả năng của mình.
Các mô hình được huấn luyện theo cách này trên ảnh học cách tạo ra các biểu diễn hiểu về sự tương đồng thị giác mà không cần thấy nhãn. Hai bức ảnh của cùng một cảnh, chụp từ các góc khác nhau hoặc dưới điều kiện ánh sáng khác nhau, nên được ánh xạ tới các điểm gần nhau trong không gian vector. Hai cảnh không liên quan nên được ánh xạ xa nhau.
Bạn có thể lấy một mô hình được tiền huấn luyện tương phản và fine-tune nó cho phân loại hoặc phát hiện vật thể với chỉ một phần nhỏ dữ liệu gán nhãn so với mức bạn thường cần.
Trong NLP, học tương phản được dùng để huấn luyện embedding câu — các biểu diễn vector hiểu nghĩa của cả câu.
Các câu có nghĩa tương tự nên ở gần nhau trong không gian vector, và các câu không liên quan nên đặt xa nhau. Các mô hình được huấn luyện theo cách này có thể thực hiện các tác vụ như tìm kiếm ngữ nghĩa và đo độ tương đồng câu, mà không cần lượng lớn cặp câu gán nhãn.
Hệ thống gợi ý dùng học tương phản để mô hình hóa độ tương đồng người dùng — mục mục (user-item).
Một người dùng và một mục họ đã tương tác tạo thành cặp dương. Một người dùng và một mục ngẫu nhiên họ chưa từng thấy tạo thành cặp âm. Nếu bạn huấn luyện đủ nhiều như vậy, mô hình sẽ học một không gian chung nơi những người dùng và mục liên quan tụ lại gần nhau.
Đây là nơi học tương phản trở nên thú vị.
Các mô hình như CLIP dùng nó để căn chỉnh văn bản và hình ảnh trong một không gian vector chung. Một ảnh con chó và câu "a dog playing in the park" nên nằm gần nhau. Một ảnh con chó và câu "a red sports car" thì không. Điều này cho phép các mô hình đa phương thức ghép ảnh với mô tả văn bản và tạo chú thích.
Học tương phản luôn theo bốn bước giống nhau, bất kể bạn làm việc với ảnh, văn bản, hay âm thanh.
Mỗi ví dụ huấn luyện bắt đầu từ một cặp. Bạn lấy mẫu hai điểm dữ liệu và gán nhãn mối quan hệ là tương tự (dương) hoặc không tương tự (âm). Trong thực tế, các cặp dương thường đến từ việc tăng cường cùng một đầu vào theo hai cách khác nhau, và các cặp âm đến từ việc lấy mẫu những ví dụ không liên quan.
Cả hai điểm dữ liệu đi qua một bộ mã hóa để chuyển thành vector. Các vector này, gọi là embedding, là các biểu diễn số cùng sống trong một không gian vector chung. Mục tiêu là không gian đó phản ánh ý nghĩa ngữ nghĩa, chứ không phải giá trị điểm ảnh hay token thô.
Khi bạn có hai embedding, bạn đo xem chúng gần nhau đến mức nào. Cosine similarity là lựa chọn phổ biến nhất. Nó cho điểm từ -1 đến 1, trong đó 1 nghĩa là hai vector cùng hướng và -1 nghĩa là hoàn toàn đối ngược.
Mô hình so sánh các điểm tương đồng nó tính được với giá trị mong muốn. Với cặp dương, điểm phải cao. Với cặp âm, điểm phải thấp. Một hàm mất mát đo độ sai lệch của mô hình, và lan truyền ngược điều chỉnh trọng số bộ mã hóa để làm tốt hơn ở lần sau.
Nếu bạn lặp lại các bước này trên đủ nhiều cặp, bộ mã hóa sẽ học cách tạo embedding gom nhóm các thứ giống nhau và đẩy các thứ khác nhau ra xa.
Chất lượng mô hình tương phản của bạn phụ thuộc vào cách bạn tạo các cặp.
Các cặp dương là hai điểm dữ liệu nên được coi là giống nhau. Trong thị giác máy tính, điều đó thường có nghĩa là hai phiên bản tăng cường của cùng một ảnh. Trong NLP, có thể là hai cách diễn đạt cùng câu, hoặc một câu và bản dịch của nó. Mô hình học rằng những gì khác nhau giữa chúng không quan trọng. Điều duy nhất quan trọng là phần chung.
Các cặp âm là hai điểm dữ liệu nên được coi là khác nhau. Hầu hết các triển khai chọn ngẫu nhiên cặp âm từ phần còn lại của bộ dữ liệu. Nếu bạn huấn luyện trên ảnh, bất kỳ hai ảnh của các đối tượng khác nhau đều là cặp âm hợp lệ.
Đây là chỗ trở nên phức tạp.
Không phải mọi mẫu âm đều hữu ích như nhau. Một mẫu âm ngẫu nhiên mà rõ ràng khác với nguồn — ví dụ, ảnh con chó ghép với ảnh máy bay — không bắt mô hình phải nỗ lực nhiều. Đây được gọi là mẫu âm dễ, và huấn luyện quá nhiều với chúng sẽ làm chậm quá trình học.
Ở phía bên kia, mẫu âm khó là các điểm dữ liệu trông giống nguồn nhưng thuộc lớp khác — ví dụ hai giống chó, hoặc hai câu có cách diễn đạt tương tự nhưng nghĩa khác nhau. Mô hình phải phát triển các biểu diễn tinh vi hơn để phân biệt chúng, từ đó tạo ra embedding tốt hơn nói chung.
Lập luận tương tự áp dụng cho cặp dương. Nếu các phép tăng cường quá nhẹ, mô hình không học được nhiều. Nếu chúng quá mạnh tay, cặp đó không còn thực sự tương tự nữa.
Hàm mất mát biến các so sánh cặp thành tín hiệu học.
Mỗi hàm mất mát hoạt động khác nhau, nhưng tất cả đều có cùng mục tiêu là thưởng cho mô hình khi những thứ tương tự ở gần nhau trong không gian vector, và phạt khi chúng không như vậy.
Contrastive loss được giới thiệu cùng với các nghiên cứu học tương phản giai đoạn đầu.
Nó hoạt động trên các cặp. Với một cặp dương, nó phạt mô hình nếu embedding của chúng ở quá xa nhau. Với một cặp âm, nó phạt mô hình nếu embedding của chúng quá gần — cụ thể là nếu chúng nằm trong một ngưỡng biên được xác định. Những cặp âm đã đủ xa sẽ không đóng góp vào mất mát.
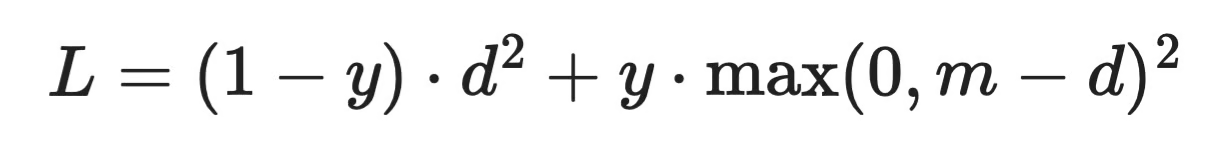
Công thức contrastive loss
Trong đó d là khoảng cách giữa hai embedding, y bằng 1 cho cặp âm và 0 cho cặp dương, và m là ngưỡng biên. Ngưỡng biên là siêu tham số bạn đặt thủ công, khiến hàm mất mát này nhạy với việc tinh chỉnh.
Triplet loss làm việc với ba điểm dữ liệu cùng lúc: một mốc (anchor), một dương, và một âm.
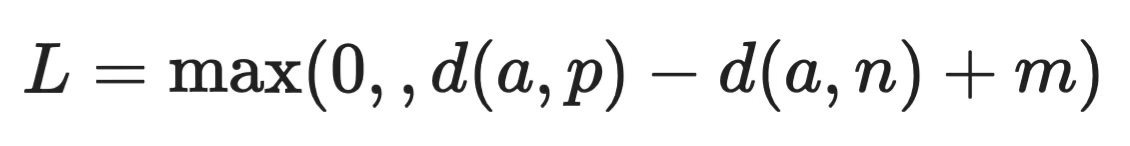
Công thức triplet loss
Mô hình bị phạt bất cứ khi nào khoảng cách anchor-điểm dương d(a, p) không nhỏ hơn khoảng cách anchor-điểm âm d(a, n) ít nhất là một ngưỡng biên m. Nếu điều kiện đó đã được thỏa, mất mát bằng 0.
Cách đặt bài toán này cho mô hình nhiều ngữ cảnh hơn mỗi lần cập nhật so với contrastive loss, vì nó so sánh cả hai mối quan hệ cùng lúc thay vì từng cái một.
InfoNCE là hàm mất mát đứng sau hầu hết các phương pháp học tương phản hiện đại, bao gồm SimCLR và CLIP.
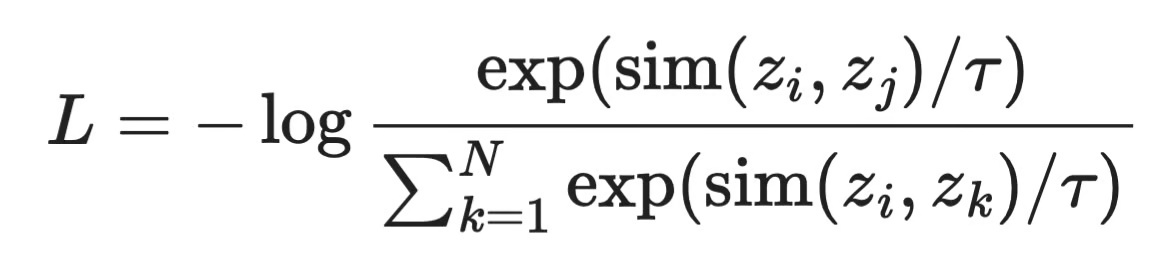
Công thức InfoNCE loss
Với mỗi mốc z_i, mô hình phải xác định điểm dương z_j của nó từ tất cả các ví dụ N còn lại trong batch. Tham số nhiệt độ τ điều khiển độ sắc của phân phối — giá trị thấp làm mô hình tự tin hơn, giá trị cao làm mềm độ tương phản giữa các cặp.
Bạn nhận được nhiều mẫu âm hơn mỗi lần cập nhật, cung cấp cho mô hình nhiều tín hiệu học hơn. Nó cũng có nghĩa là các batch lớn hơn phơi bày mô hình với nhiều mẫu âm khó hơn và thường tạo ra các biểu diễn tốt hơn.
Học tương phản và học tự giám sát kết hợp rất hiệu quả, và hiểu vì sao sẽ giúp bạn hiểu hướng đi của ML hiện đại.
Học tự giám sát là cách huấn luyện trong đó mô hình tự tạo nhãn từ dữ liệu, không cần gán nhãn thủ công. Vậy nên thay vì ai đó gán nhãn hàng nghìn ảnh là "mèo" hay "chó", chính dữ liệu cung cấp tín hiệu giám sát.
Học tương phản làm đúng như vậy. Khi bạn lấy một ảnh, tạo hai phiên bản tăng cường của nó, và nói với mô hình rằng chúng là một cặp dương, bạn vừa tạo ra một nhãn.
Điều này quan trọng vì dữ liệu gán nhãn là nút thắt trong hầu hết các pipeline ML. Thu thập thì chậm, gán nhãn thì đắt, và một số lĩnh vực như ảnh y khoa thì không có đủ dữ liệu.
Kết quả cho đến nay rất hứa hẹn. Các mô hình được tiền huấn luyện bằng mục tiêu tự giám sát tương phản trên các bộ dữ liệu không gán nhãn lớn đã đạt hoặc tiệm cận các chuẩn có giám sát trên nhiều tác vụ hạ nguồn, sau khi fine-tune chỉ với một lượng nhỏ dữ liệu gán nhãn.
Xu hướng chung là rời xa huấn luyện có giám sát theo tác vụ cụ thể và tiến tới các biểu diễn mục đích chung học từ dữ liệu thô ở quy mô lớn. Các phương pháp như SimCLR, MoCo, và BYOL đều theo xu hướng này, và tôi sẽ bàn đến chúng tiếp theo.
Dưới đây là ba khuôn khổ có ảnh hưởng nhất đứng sau học tương phản vào năm 2026.
SimCLR, do Google Research giới thiệu, là một trong những triển khai rõ ràng nhất của ý tưởng học tương phản.
Với mỗi ảnh trong một batch, nó tạo hai góc nhìn tăng cường và xem chúng là cặp dương. Mọi ảnh khác trong batch trở thành âm. Mô hình, là một CNN theo sau bởi một đầu chiếu nhỏ, học cách ánh xạ các cặp dương lại gần nhau bằng InfoNCE loss.
Điều làm SimCLR nổi bật là kích thước batch quan trọng đến mức nào. Batch lớn hơn nghĩa là nhiều mẫu âm hơn mỗi lần cập nhật, chuyển hóa thành các biểu diễn tốt hơn. Đổi lại là bộ nhớ. Vì SimCLR cần batch lớn để hoạt động tốt, bạn cần phần cứng mạnh để tận dụng tối đa.
MoCo (Momentum Contrast), từ Meta AI Research, được thiết kế để giải quyết đúng vấn đề đó.
Thay vì phụ thuộc vào batch lớn cho các mẫu âm, MoCo duy trì một hàng đợi — bộ đệm liên tục của các biểu diễn đã mã hóa từ những batch trước. Điều này tách số lượng mẫu âm khỏi kích thước batch, vì vậy bạn có thể huấn luyện với ít bộ nhớ hơn nhiều mà vẫn cho mô hình tiếp xúc với một kho mẫu âm lớn.
Nó cũng dùng một bộ mã hóa momentum, là bản sao cập nhật chậm của bộ mã hóa chính, để giữ cho các biểu diễn trong hàng đợi nhất quán theo thời gian.
BYOL (Bootstrap Your Own Latent) đáng được nhắc đến ở đây dù nó hoàn toàn không dùng cặp âm.
Thay vì đẩy các âm ra xa, BYOL huấn luyện một mạng dự đoán các biểu diễn của một mạng khác — một mạng mục tiêu được cập nhật chậm. Không có mẫu âm và không có contrastive loss. Nó hoạt động đáng ngạc nhiên, và thành công của nó thách thức giả định rằng cặp âm là cần thiết cho học kiểu tương phản.
BYOL ở rìa của học tương phản, nhưng là bước tiếp theo tốt khi bạn đã hiểu cách các phương pháp cốt lõi hoạt động.
Hai cách tiếp cận này giải quyết cùng một vấn đề, nhưng bắt đầu từ những giả định khác nhau mà bạn cần hiểu.
Học có giám sát cần dữ liệu gán nhãn. Mỗi ví dụ huấn luyện cần một nhãn do con người gán, và mô hình học bằng cách ánh xạ đầu vào tới các nhãn đó. Đây là cách trực tiếp và hiệu quả khi bạn có đủ ví dụ gán nhãn. Mô hình biết đầu vào là gì và đáp án đúng là gì.
Học tương phản tự tạo tín hiệu giám sát từ cấu trúc dữ liệu — sự tương đồng và khác biệt — và học biểu diễn mà không cần thấy nhãn.
Dưới đây là cách so sánh trực quan hơn:
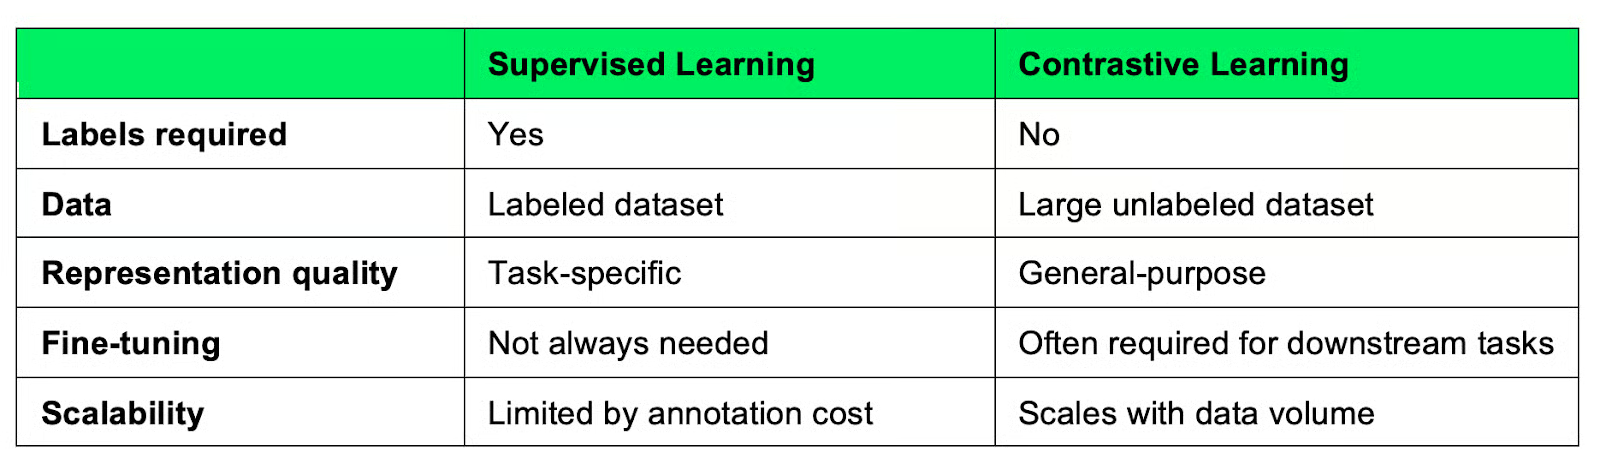
So sánh học tương phản với học có giám sát
Khác biệt lớn nhất thể hiện ở quy mô. Học có giám sát phụ thuộc vào dữ liệu gán nhãn — và việc gán nhãn thêm rất tốn kém. Học tương phản có thể tiếp tục cải thiện khi bạn cấp thêm dữ liệu không gán nhãn, vốn thường dồi dào.
Nhưng cần lưu ý các biểu diễn mà mô hình học tương phản học được là tổng quát, không đặc thù tác vụ, nghĩa là bạn thường cần một bước fine-tune để đạt hiệu năng tốt trên một tác vụ cụ thể. Mô hình có giám sát không cần bước đó vì chúng được huấn luyện trực tiếp theo mục tiêu đích.
Lựa chọn phụ thuộc vào tình huống dữ liệu của bạn. Nếu bạn có dữ liệu gán nhãn và một tác vụ cụ thể, học có giám sát thường nhanh hơn. Nếu bạn làm việc với lượng lớn dữ liệu không gán nhãn hoặc cần các biểu diễn có thể chuyển giao giữa các tác vụ, học tương phản có thể đáng công thiết lập thêm.
Giờ tôi sẽ đưa ra một triển khai PyTorch tối giản. Ví dụ dưới đây bao quát ba ý chính đã thảo luận: một mô hình embedding, cosine similarity, và NT-Xent loss — hàm mất mát dùng trong SimCLR, xây dựng trên InfoNCE.
Bộ mã hóa là một mạng feedforward đơn giản ánh xạ vector đầu vào sang không gian embedding có số chiều thấp hơn.
import torch
import torch.nn as nn
import torch.nn.functional as F

class Encoder(nn.Module):
    def __init__(self, input_dim, embedding_dim):
        super().__init__()
        self.network = nn.Sequential(
            nn.Linear(input_dim, 128),
            nn.ReLU(),
            nn.Linear(128, embedding_dim)
        )

    def forward(self, x):
        return self.network(x)
Trong thực tế, bạn sẽ thay thế bằng một CNN cho ảnh hoặc một transformer cho văn bản. Kiến trúc quan trọng ít hơn so với những gì diễn ra sau đó.
Khi đã có hai embedding, bạn đo độ gần của chúng bằng cosine similarity. Chuẩn hóa các vector trước giúp giữ điểm tương đồng trong khoảng từ -1 đến 1.
def cosine_similarity(z1, z2):
    z1 = F.normalize(z1, dim=-1)
    z2 = F.normalize(z2, dim=-1)
    return torch.matmul(z1, z2.T)
Kết quả là một ma trận trong đó mỗi phần tử [i, j] biểu diễn độ tương đồng giữa embedding i và embedding j trong toàn batch.
NT-Xent (Normalized Temperature-scaled Cross Entropy) là loss dựa trên InfoNCE. Với mỗi mốc, nó xem góc nhìn ghép cặp là dương và mọi ví dụ khác trong batch là âm.
def nt_xent_loss(z1, z2, temperature=0.5):
    batch_size = z1.shape[0]

    z = torch.cat([z1, z2], dim=0)
    z = F.normalize(z, dim=-1)
    sim_matrix = torch.matmul(z, z.T) / temperature

    mask = torch.eye(2 * batch_size, dtype=torch.bool)
    sim_matrix = sim_matrix.masked_fill(mask, float("-inf"))

    labels = torch.arange(batch_size)
    labels = torch.cat([labels + batch_size, labels])

    return F.cross_entropy(sim_matrix, labels)
Tham số temperature điều khiển độ sắc của phân phối. Giá trị thấp khiến mô hình tự tin hơn về cặp dương; giá trị cao làm mềm độ tương phản.
encoder = Encoder(input_dim=64, embedding_dim=32)
optimizer = torch.optim.Adam(encoder.parameters(), lr=1e-3)

# Simulate a batch of positive pairs
x1 = torch.randn(32, 64)
x2 = torch.randn(32, 64)

# Training
optimizer.zero_grad()
z1, z2 = encoder(x1), encoder(x2)
loss = nt_xent_loss(z1, z2)
loss.backward()
optimizer.step()

print(f("Loss: {loss.item():.4f}"))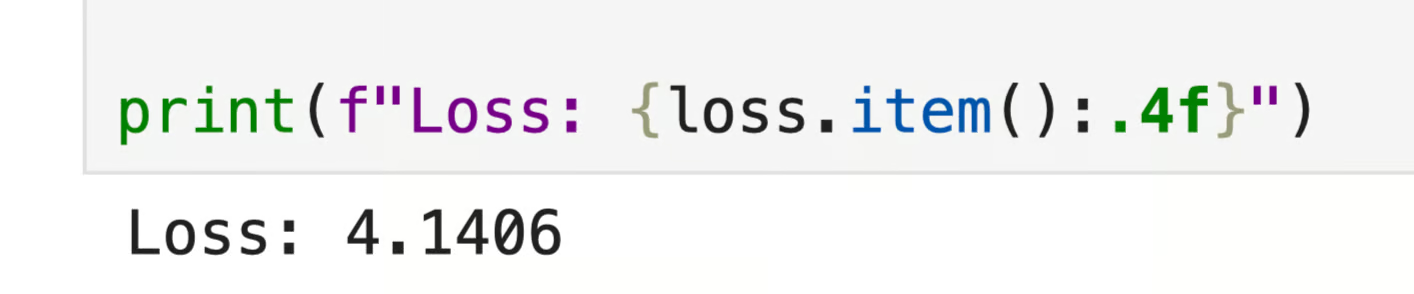
Kết quả vòng lặp tương phản
Đây là vòng lặp tương phản đầy đủ ở dạng đơn giản nhất. Trong triển khai thực tế, x1 và x2 sẽ là hai góc nhìn tăng cường của cùng một đầu vào thay vì nhiễu ngẫu nhiên — nhưng cấu trúc thì giữ nguyên y hệt.
Học tương phản là một ý tưởng đơn giản nhưng có sức lan tỏa lớn.
Nó dạy mô hình hiểu cấu trúc thông qua so sánh thay vì dựa vào dữ liệu gán nhãn. Kéo các thứ giống nhau lại gần, đẩy các thứ khác nhau ra xa — đó là toàn bộ tiền đề. Hóa ra, chừng đó là đủ để học các biểu diễn chuyển giao tốt giữa các tác vụ.
Lĩnh vực này đang rời xa các pipeline nặng gán nhãn, và học tương phản là một lý do lớn. Các thuật toán như SimCLR, MoCo, và CLIP đã đi vào sản phẩm thực tế, điều đó nói lên mức độ hiệu quả của phương pháp này.
Nếu bạn muốn đi sâu hơn, bước tiếp theo tốt là tự tay chạy một triển khai thực. Ví dụ PyTorch trong bài là điểm khởi đầu, nhưng chạy SimCLR trên một bộ dữ liệu ảnh thực — dù nhỏ — sẽ dạy bạn nhiều hơn mọi lời giải thích.
Và nếu bạn cần nguồn tài nguyên tối ưu cho các chủ đề học máy nâng cao, hãy đăng ký lộ trình Machine Learning Scientist in Python của chúng tôi.
Học cùng DataCamp
Courses
Courses
Courses