Corso
Capire il Machine Learning
2 h
308K
Far imparare un modello senza dati etichettati sembra impossibile, ma è proprio l'idea alla base del contrastive learning.
Come sai, etichettare i dati è lento e costoso. Un singolo dataset per la classificazione di immagini richiede di solito migliaia di ore di annotazione umana, e questo prima ancora di considerare errori e incoerenze.
Il contrastive learning aggira il problema dell'etichettatura insegnando ai modelli a confrontare. Quindi, invece di dire a un modello cos'è qualcosa, gli mostri cosa è simile e cosa è diverso — e lasci che capisca il resto da solo.
In questo articolo ti guiderò nell'intuizione dietro il contrastive learning, come funziona sotto il cofano, dove viene usato nella pratica — dal riconoscimento di immagini agli embedding NLP — e come implementarlo in PyTorch.
Cos'è esattamente la computer vision? Leggi la nostra guida introduttiva all'analisi delle immagini.
Il contrastive learning è un approccio di training in cui un modello impara per confronto invece che per classificazione.
Invece di dire al modello "questo è un gatto" o "questo è un cane", gli mostri coppie di esempi e lo lasci capire cosa appartiene insieme e cosa no. Il modello impara capendo se due cose sono simili oppure no.
In altre parole: dai in pasto al modello due punti dati alla volta. Se sono correlati — ad esempio, due foto dello stesso cane scattate da angolazioni diverse — quella è una coppia positiva. Se non sono correlati — una foto di un cane e una foto di un'auto — quella è una coppia negativa.
Il compito del modello è produrre rappresentazioni (vettori numerici) che rispettino questa struttura. Le coppie positive dovrebbero finire vicine nello spazio vettoriale. Le coppie negative dovrebbero finire lontane.
Il modo più semplice per capire il contrastive learning è attraverso le immagini.
Prendi una foto di un cane. Ora creane due versioni — una ritagliata, una con luminosità regolata. Il contenuto che vedi è lo stesso, ma i pixel sono diversi. Un modello di contrastive learning vede queste due versioni come una coppia positiva e impara a mappare entrambe in posizioni simili nello spazio vettoriale.
Se mostri al modello una foto di un'auto insieme a quella foto del cane, ottieni una coppia negativa. Il modello impara a spingere lontane le loro rappresentazioni.
Non serve intervenire manualmente e specificare "questo è un cane" o "questa è un'auto". Il modello costruisce la sua comprensione dalla struttura di somiglianze e differenze.
È questo che rende potente il contrastive learning.
Il segnale arriva dal confronto. Con abbastanza coppie, il modello può sviluppare rappresentazioni che capiscono cosa rende le cose simili e cosa le distingue.
Queste rappresentazioni si rivelano davvero utili. Un modello addestrato così sulle immagini può essere fine-tuned per compiti di classificazione, detection o retrieval con pochissimi dati etichettati, perché ha già imparato qualcosa di significativo sul mondo visivo.
Il contrastive learning compare in molti domini — ecco dove lo vedrai più spesso.
È qui che il contrastive learning ha dimostrato per primo di cosa è capace.
I modelli addestrati in questo modo sulle immagini imparano a produrre rappresentazioni che colgono la somiglianza visiva senza mai vedere un'etichetta. Due foto della stessa scena, scattate da angolazioni diverse o con illuminazioni differenti, dovrebbero mappare a punti vicini nello spazio vettoriale. Due scene non correlate dovrebbero mappare lontano.
Puoi prendere un modello pre-addestrato in modo contrastivo e fare fine-tuning per classificazione o object detection con una frazione dei dati etichettati che altrimenti servirebbero.
Nell'NLP, il contrastive learning viene usato per addestrare sentence embedding — rappresentazioni vettoriali che colgono il significato di una frase nel suo insieme.
Frasi con significati simili dovrebbero essere vicine nello spazio vettoriale, e frasi non correlate dovrebbero essere distanziate. I modelli addestrati così possono svolgere compiti come ricerca semantica e similarità tra frasi, senza grandi quantità di coppie di frasi etichettate.
I sistemi di raccomandazione usano il contrastive learning per modellare la somiglianza utente–item.
Un utente e un item con cui ha interagito formano una coppia positiva. Un utente e un item casuale che non ha mai visto formano una coppia negativa. Se ne alleni abbastanza, il modello impara uno spazio condiviso in cui utenti e item rilevanti si raggruppano.
Qui il contrastive learning diventa interessante.
Modelli come CLIP lo usano per allineare testo e immagini in uno spazio vettoriale condiviso. Una foto di un cane e la frase "un cane che gioca al parco" dovrebbero finire vicine. Una foto di un cane e la frase "un'auto sportiva rossa" no. Questo permette ai modelli multimodali di abbinare immagini a descrizioni testuali e generare didascalie.
Il contrastive learning segue sempre gli stessi quattro passaggi, che tu stia lavorando con immagini, testo o audio.
Ogni esempio di training parte come una coppia. Campioni due punti dati e ne etichetti la relazione come simile (positiva) o dissimile (negativa). In pratica, le coppie positive spesso derivano da due diverse augmentations dello stesso input, e le coppie negative da esempi non correlati campionati a caso.
Entrambi i punti dati passano attraverso un encoder che li converte in vettori. Questi vettori, chiamati embedding, sono rappresentazioni numeriche che vivono in uno spazio vettoriale condiviso. L'obiettivo è che quello spazio rifletta il significato semantico, e non i valori grezzi di pixel o token.
Una volta ottenuti due embedding, misuri quanto sono vicini. La cosine similarity è la scelta più comune. Ti dà un punteggio tra -1 e 1, dove 1 significa che i vettori puntano nella stessa direzione e -1 che sono completamente opposti.
Il modello confronta i suoi punteggi di somiglianza con quelli attesi. Per le coppie positive, il punteggio dovrebbe essere alto. Per le negative, dovrebbe essere basso. Una funzione di loss misura quanto il modello è fuori bersaglio, e la backpropagation aggiusta i pesi dell'encoder per fare meglio al prossimo giro.
Se ripeti questi passaggi su abbastanza coppie, l'encoder imparerà a produrre embedding che raggruppano le cose simili e allontanano quelle diverse.
La qualità del tuo modello contrastivo dipende da come crei le coppie.
Le coppie positive sono due punti dati che dovrebbero essere considerati simili. In computer vision, di solito significa due versioni augmentate della stessa immagine. Nell'NLP, potrebbero essere due parafrasi della stessa frase, o una frase e la sua traduzione. Il modello impara che qualunque cosa vari tra le due non conta. Conta solo ciò che è condiviso.
Le coppie negative sono due punti dati che dovrebbero essere considerati diversi. La maggior parte delle implementazioni campiona i negativi casualmente dal resto del dataset. Se stai addestrando su immagini, due immagini di oggetti diversi costituiscono una valida coppia negativa.
Ed è qui che si fa complicato.
Non tutti i negativi sono ugualmente utili. Un negativo casuale che è palesemente diverso dalla sorgente — ad esempio, una foto di un cane abbinata a una di un aereo — non mette molto alla prova il modello. Questi si chiamano negativi facili, e addestrarsi su troppi di essi rallenta l'apprendimento.
Dall'altro lato, i negativi difficili sono punti dati che sembrano simili alla sorgente ma appartengono a una classe diversa — due razze di cane, per esempio, o due frasi con parole simili ma significati diversi. Il modello deve sviluppare rappresentazioni più fini per distinguerli, il che produce embedding complessivamente migliori.
La stessa logica vale per le positive. Se le tue augmentations sono troppo lievi, il modello non impara molto. Se sono troppo aggressive, la coppia non è più significativamente simile.
La funzione di loss trasforma i confronti tra coppie in segnali di apprendimento.
Ogni funzione di loss lavora in modo diverso, ma condividono tutte lo stesso obiettivo: premiare il modello quando le cose simili sono vicine nello spazio vettoriale e penalizzarlo quando non lo sono.
La contrastive loss è stata introdotta insieme ai primi lavori sul contrastive learning.
Opera su coppie. Data una coppia positiva, penalizza il modello se i loro embedding sono troppo lontani. Data una coppia negativa, penalizza il modello se i loro embedding sono troppo vicini — in particolare, se cadono entro un margine definito. I negativi già abbastanza lontani non contribuiscono alla loss.
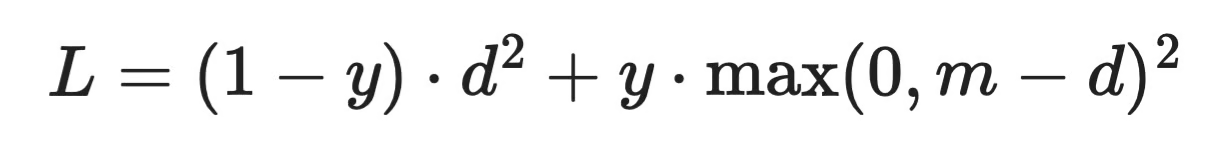
Formula della contrastive loss
Dove d è la distanza tra due embedding, y vale 1 per le coppie negative e 0 per le coppie positive, e m è il margine. Il margine è un iperparametro impostato manualmente, il che rende questa loss sensibile al tuning.
La triplet loss lavora con tre punti dati alla volta: un anchor, un positivo e un negativo.
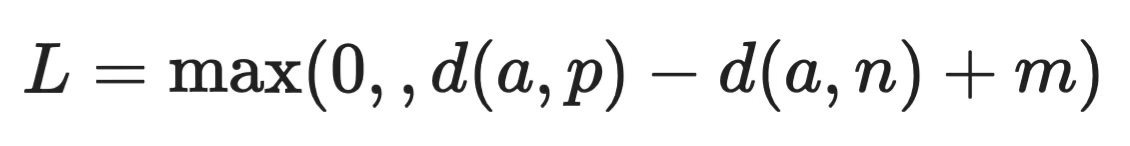
Formula della triplet loss
Il modello viene penalizzato ogni volta che la distanza anchor–positivo d(a, p) non è più piccola della distanza anchor–negativo d(a, n) di almeno il margine m. Se quella condizione è già soddisfatta, la loss è zero.
Questa formulazione dà al modello più contesto per aggiornamento rispetto alla contrastive loss, perché confronta entrambe le relazioni contemporaneamente invece che una alla volta.
InfoNCE è la loss dietro la maggior parte dei metodi moderni di contrastive learning, tra cui SimCLR e CLIP.
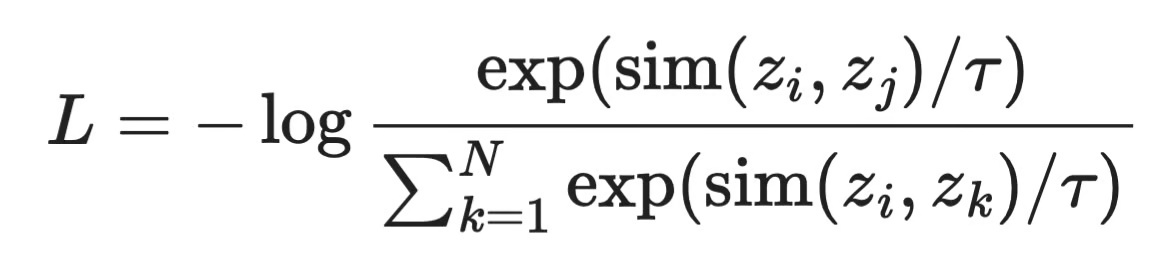
Formula della InfoNCE loss
Per ogni anchor z_i, il modello deve identificare il suo positivo z_j tra tutti gli altri esempi N nel batch. Il parametro di temperatura τ controlla quanto è netta la distribuzione — valori più bassi rendono il modello più sicuro, valori più alti attenuano il contrasto tra le coppie.
Ottieni più negativi per aggiornamento, il che dà al modello più segnale di apprendimento. Significa anche che batch più grandi espongono il modello a negativi più difficili e in genere producono rappresentazioni migliori.
Contrastive learning e self-supervised learning funzionano bene insieme, e capendo perché, capirai dove sta andando il ML moderno.
Il self-supervised learning è un approccio di training in cui il modello genera le proprie etichette dai dati, senza annotazione umana. Quindi, invece che qualcuno etichetti migliaia di immagini come "gatto" o "cane", è il dato stesso a fornire il segnale di supervisione.
Il contrastive learning fa esattamente questo. Quando prendi un'immagine, ne crei due versioni augmentate e dici al modello che sono una coppia positiva, hai appena creato un'etichetta.
Questo conta perché i dati etichettati sono il collo di bottiglia nella maggior parte delle pipeline di ML. Raccoglierli è lento, l'annotazione è costosa e in alcuni domini, come l'imaging medico, non ce n'è abbastanza.
I risultati finora sono stati promettenti. Modelli pre-addestrati con obiettivi contrastivi self-supervised su grandi dataset non etichettati hanno eguagliato o si sono avvicinati alle baseline supervisionate su una gamma di task downstream, dopo il fine-tuning su solo una piccola quantità di dati etichettati.
La tendenza generale è allontanarsi da training supervisionati specifici per il task e dirigersi verso rappresentazioni generali apprese da dati grezzi su larga scala. Metodi come SimCLR, MoCo e BYOL seguono tutti questa tendenza, e li discuterò a breve.
Ecco i tre framework più influenti dietro il contrastive learning nel 2026.
SimCLR, introdotto da Google Research, è una delle implementazioni più chiare dell'idea di contrastive learning.
Per ogni immagine in un batch, crea due viste augmentate e le tratta come coppia positiva. Ogni altra immagine nel batch diventa un negativo. Il modello, che è una CNN seguita da una piccola testa di proiezione, impara a mappare le coppie positive vicine usando la InfoNCE loss.
Ciò che ha reso SimCLR degno di nota è quanto contasse la dimensione del batch. Batch più grandi significavano più negativi per aggiornamento, il che si traduceva in rappresentazioni migliori. Il compromesso è la memoria. Poiché SimCLR richiede batch grandi per funzionare bene, ti serve buon hardware per sfruttarlo al massimo.
MoCo (Momentum Contrast), di Meta AI Research, è stato progettato per risolvere proprio quel problema.
Invece di fare affidamento su un batch grande per i negativi, MoCo mantiene una coda — un buffer in scorrimento di rappresentazioni codificate dai batch precedenti. Questo disaccoppia il numero di negativi dalla dimensione del batch, così puoi addestrare con molta meno memoria ed esporre comunque il modello a un ampio pool di negativi.
Usa anche un momentum encoder, una copia aggiornata lentamente dell'encoder principale, per mantenere coerenti nel tempo le rappresentazioni in coda.
BYOL (Bootstrap Your Own Latent) merita di essere citato qui anche se non usa affatto coppie negative.
Invece di spingere i negativi lontano, BYOL allena una rete a predire le rappresentazioni di un'altra — una rete target aggiornata lentamente. Non ci sono negativi e non c'è una loss contrastiva. Funziona sorprendentemente bene, e il suo successo ha messo in discussione l'assunzione che le coppie negative siano necessarie per l'apprendimento in stile contrastivo.
BYOL è un po' al confine del contrastive learning, ma è un buon passo successivo una volta che hai capito come funzionano i metodi core.
Questi due approcci risolvono lo stesso problema, ma partono da assunzioni diverse che devi capire.
Il supervised learning richiede dati etichettati. Ogni esempio di training ha bisogno di un'etichetta assegnata da un umano, e il modello impara mappando gli input a quelle etichette. È un approccio diretto e funziona bene quando hai abbastanza esempi etichettati. Il modello sa cos'è l'input e qual è la risposta corretta.
Il contrastive learning genera la propria supervisione dalla struttura dei dati — somiglianza e differenza — e impara rappresentazioni senza vedere mai un'etichetta.
Ecco una rappresentazione più visiva di come si confrontano:
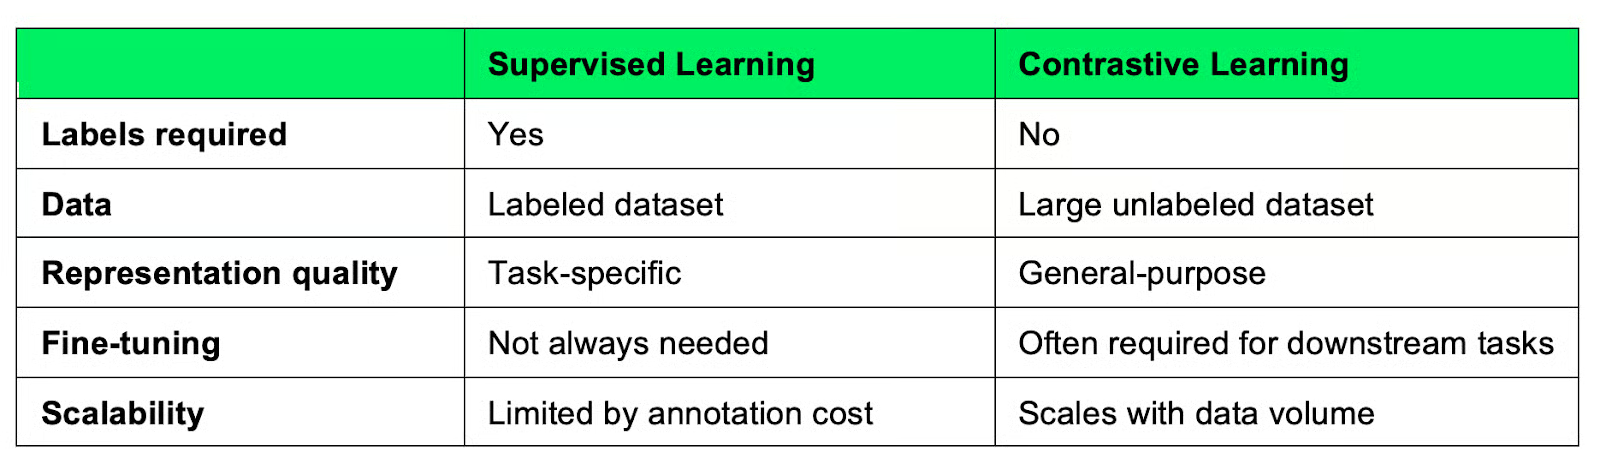
Contrastive learning rispetto al supervised learning
La maggior parte della differenza emerge in scala. Il supervised learning dipende dai dati etichettati — e etichettarli di più è costoso. Il contrastive learning può continuare a migliorare man mano che gli dai in pasto più dati non etichettati, che di solito abbondano.
Ma è importante notare che le rappresentazioni apprese da un modello di contrastive learning sono generali, non specifiche per il task, il che significa che di solito servirà un passaggio di fine-tuning per ottenere buone prestazioni su un compito specifico. I modelli supervisionati non hanno bisogno di quel passaggio perché sono addestrati direttamente sull'obiettivo target.
La scelta dipende dalla tua situazione dati. Se hai dati etichettati e un compito specifico, spesso il supervised learning è più rapido. Se lavori con grandi quantità di dati non etichettati o ti servono rappresentazioni trasferibili tra compiti, il contrastive learning può valere l'extra setup.
Passiamo ora a un'implementazione minima in PyTorch. L'esempio seguente copre le tre idee chiave discusse prima: un modello di embedding, la cosine similarity e la NT-Xent loss — la funzione di loss usata in SimCLR, costruita su InfoNCE.
L'encoder è una semplice rete feedforward che mappa vettori di input in uno spazio di embedding a dimensionalità inferiore.
import torch
import torch.nn as nn
import torch.nn.functional as F

class Encoder(nn.Module):
    def __init__(self, input_dim, embedding_dim):
        super().__init__()
        self.network = nn.Sequential(
            nn.Linear(input_dim, 128),
            nn.ReLU(),
            nn.Linear(128, embedding_dim)
        )

    def forward(self, x):
        return self.network(x)
In pratica, lo sostituiresti con una CNN per le immagini o un transformer per il testo. L'architettura conta meno di ciò che viene dopo.
Una volta che hai due embedding, misuri quanto sono vicini usando la cosine similarity. Normalizzare prima i vettori mantiene i punteggi di somiglianza compresi tra -1 e 1.
def cosine_similarity(z1, z2):
    z1 = F.normalize(z1, dim=-1)
    z2 = F.normalize(z2, dim=-1)
    return torch.matmul(z1, z2.T)
Il risultato è una matrice in cui ogni voce [i, j] rappresenta la somiglianza tra l'embedding i e l'embedding j all'interno del batch.
NT-Xent (Normalized Temperature-scaled Cross Entropy) è la loss basata su InfoNCE. Per ogni anchor, tratta la sua vista accoppiata come positiva e tutti gli altri esempi nel batch come negativi.
def nt_xent_loss(z1, z2, temperature=0.5):
    batch_size = z1.shape[0]

    z = torch.cat([z1, z2], dim=0)
    z = F.normalize(z, dim=-1)
    sim_matrix = torch.matmul(z, z.T) / temperature

    mask = torch.eye(2 * batch_size, dtype=torch.bool)
    sim_matrix = sim_matrix.masked_fill(mask, float("-inf"))

    labels = torch.arange(batch_size)
    labels = torch.cat([labels + batch_size, labels])

    return F.cross_entropy(sim_matrix, labels)
Il parametro temperature controlla quanto è netta la distribuzione. Valori più bassi rendono il modello più sicuro su quale coppia sia positiva; valori più alti attenuano il contrasto.
encoder = Encoder(input_dim=64, embedding_dim=32)
optimizer = torch.optim.Adam(encoder.parameters(), lr=1e-3)

# Simulate a batch of positive pairs
x1 = torch.randn(32, 64)
x2 = torch.randn(32, 64)

# Training
optimizer.zero_grad()
z1, z2 = encoder(x1), encoder(x2)
loss = nt_xent_loss(z1, z2)
loss.backward()
optimizer.step()

print(f"Loss: {loss.item():.4f}")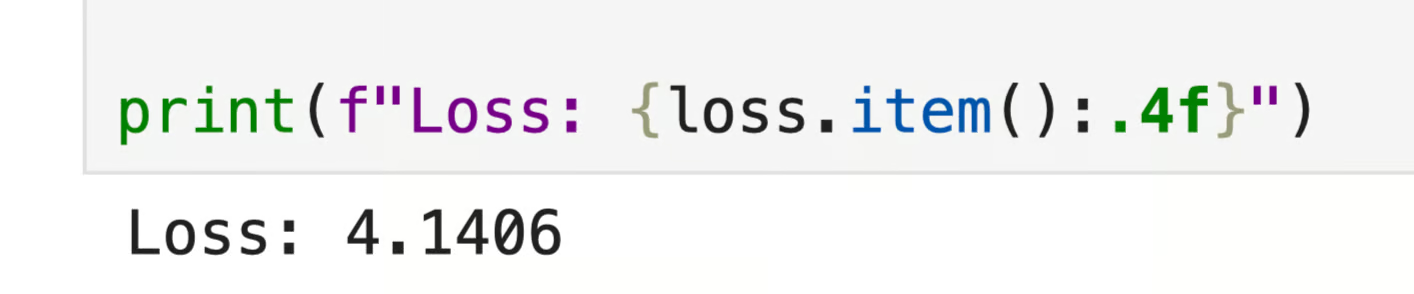
Output del loop contrastivo
Questo è il loop contrastivo completo nella sua forma più semplice. In un'implementazione reale, x1 e x2 sarebbero due viste augmentate dello stesso input invece di rumore casuale — ma la struttura resta esattamente la stessa.
Il contrastive learning è un'idea semplice con una grande portata.
Insegna ai modelli a comprendere la struttura attraverso il confronto invece di affidarsi a dati etichettati. Spingi insieme le cose simili, allontana quelle diverse — è tutta qui la premessa. Si scopre che basta per apprendere rappresentazioni che trasferiscono bene tra i task.
Il settore si sta allontanando da pipeline piene di annotazioni, e il contrastive learning è una grande ragione. Algoritmi come SimCLR, MoCo e CLIP sono arrivati in prodotti reali, il che dice molto su quanto l'approccio funzioni davvero.
Se vuoi andare più a fondo, un buon prossimo passo è mettere mano a un'implementazione reale. L'esempio PyTorch in questo articolo è un punto di partenza, ma far girare SimCLR su un vero dataset di immagini — anche piccolo — ti insegnerà più di qualsiasi spiegazione.
E se ti serve la risorsa definitiva per argomenti avanzati di machine learning, iscriviti al percorso Machine Learning Scientist in Python.
Impara con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min