Courses
機械学習を理解する
2時間
308K
ラベル付きデータなしでモデルに学習させるなんて不可能に聞こえますが、まさにそれがコントラスト学習の発想です。
ご存じのとおり、データのラベリングは時間がかかり高コストです。画像分類用のデータセットひとつでも、通常は人手によるアノテーションに数千時間を要し、しかもその前にエラーや不整合を考慮しなければなりません。
コントラスト学習は、モデルに「比較」を教えることで、このラベリングの問題を回避します。つまり、何であるかを教える代わりに、何が似ていて何が異なるかを見せて、残りはモデルに推論させるのです。
この記事では、コントラスト学習の直感的な考え方、その内部動作、実際の利用例(画像認識からNLPの埋め込みまで)、そしてPyTorchでの実装方法を順に解説します。
コンピュータビジョンとは何か?当社の画像解析入門ガイドをお読みください。
コントラスト学習は、分類ではなく比較によってモデルを学習させる手法です。
モデルに「これは猫」「これは犬」と教える代わりに、例をペアで見せ、何が同類で何がそうでないかを自ら見つけさせます。モデルは、この2つが似ているかどうかを判断することで学習します。
言い換えると、モデルに一度に2つのデータポイントを与えます。もし関係がある(たとえば、同じ犬を別角度から撮った2枚の写真)なら、これはポジティブ・ペアです。無関係(犬の写真と車の写真)なら、ネガティブ・ペアです。
モデルの役割は、この構造に従う表現(数値ベクトル)を出力することです。ポジティブ・ペアはベクトル空間で互いに近くに位置し、ネガティブ・ペアは遠くに位置するべきです。
コントラスト学習を最も簡単に理解する方法は、画像を通じてです。
犬の写真を1枚用意し、2つのバージョンを作ります——1つはトリミング、もう1つは明るさを調整。見えている内容は同じですが、ピクセルは異なります。コントラスト学習のモデルはこれら2つをポジティブ・ペアとみなし、ベクトル空間で近い位置に写像することを学びます。
その犬の写真と並べて車の写真を見せると、今度はネガティブ・ペアになります。モデルは両者の表現を引き離すように学習します。
「これは犬」「これは車」と手動で指定する必要はありません。モデルは、類似と相違の構造から理解を構築します。
これがコントラスト学習を強力にする理由です。
学習の信号は比較から生まれます。十分な数のペアがあれば、モデルは何が似ていて何が異なるのかを理解する表現を獲得できます。
そして、その表現は実際に役に立ちます。画像でこの方法で学習したモデルは、すでに視覚世界について意味のあることを学んでいるため、少量のラベル付きデータで分類・検出・検索などに微調整できます。
コントラスト学習は多くの領域で見られます。とくによく目にするのは次の分野です。
ここが、コントラスト学習がその実力を最初に示した分野です。
この方法で画像を学習したモデルは、ラベルを一切見なくても視覚的な類似性を理解する表現を生成できるようになります。同じシーンを別角度や異なる光条件で撮影した2枚は、ベクトル空間で近接するべきです。無関係なシーン同士は遠くに配置されるべきです。
コントラストで事前学習したモデルを使えば、通常必要なラベル付きデータのごく一部で分類や物体検出に微調整できます。
NLPでは、コントラスト学習は文埋め込みの学習に使われます。文全体の意味をとらえるベクトル表現のことです。
意味が似た文はベクトル空間で近くに、無関係な文は離れた位置に配置されます。こうして学習したモデルは、大量のラベル付き文ペアがなくても、セマンティック検索や文類似度のようなタスクを実行できます。
レコメンデーションでは、ユーザーとアイテムの類似性をモデリングするためにコントラスト学習が使われます。
ユーザーと、そのユーザーが相互作用したアイテムはポジティブ・ペアになります。ユーザーと、そのユーザーが一度も見たことのないランダムなアイテムはネガティブ・ペアです。これを十分に学習すると、関連するユーザーとアイテムが集まる共有空間をモデルが学習します。
ここからがコントラスト学習の面白いところです。
CLIPのようなモデルは、テキストと画像を共有ベクトル空間で整合させるために用います。犬の写真と「公園で遊ぶ犬」という文は近くに位置すべきで、「赤いスポーツカー」という文とはそうではありません。これにより、マルチモーダルモデルは画像とテキスト記述の対応付けやキャプション生成が可能になります。
コントラスト学習は、画像・テキスト・音声のいずれでも、常に同じ4つの手順に従います。
あらゆる学習例はペアから始まります。2つのデータポイントをサンプリングし、その関係が類似(ポジティブ)か非類似(ネガティブ)かをラベル付けします。実務では、ポジティブ・ペアは同じ入力に2種類の拡張をかけて作ることが多く、ネガティブ・ペアは無関係な例をサンプリングして作ります。
両方のデータポイントをエンコーダに通し、ベクトルに変換します。これらのベクトル(埋め込み)は、共有のベクトル空間に存在する数値表現です。目標は、その空間が生のピクセルやトークン値ではなく、意味的な内容を反映することです。
2つの埋め込みが得られたら、その近さを測ります。ここで最も一般的なのがコサイン類似度です。スコアは-1から1の範囲で、1は同じ方向、-1は正反対を意味します。
モデルは自分の類似度スコアをあるべき値と比較します。ポジティブ・ペアは高く、ネガティブ・ペアは低くあるべきです。損失関数が乖離を測り、誤差逆伝播で次回より良くなるようエンコーダの重みを調整します。
この手順を十分な数のペアで繰り返すと、エンコーダは似たものを集め、異なるものを引き離す埋め込みを出力するようになります。
コントラストモデルの品質は、ペアの作り方に大きく依存します。
ポジティブ・ペアは、類似とみなすべき2つのデータポイントです。コンピュータビジョンでは、同じ画像に対する2種類の拡張であることが多いです。NLPでは、同じ文のパラフレーズや、文とその翻訳などが該当します。モデルは、それらの間で変化している部分は重要ではなく、共有される部分こそが重要だと学びます。
ネガティブ・ペアは、異なるとみなすべき2つのデータポイントです。多くの実装では、ネガティブはデータセットの他の例からランダムにサンプリングします。画像で学習している場合、異なる物体の任意の2画像は有効なネガティブ・ペアになります。
ここからが難しいところです。
すべてのネガティブが同じように有用とは限りません。ソースと明らかに異なるランダムなネガティブ——たとえば、犬の写真と飛行機の写真——では、モデルにほとんど負荷がかかりません。これはイージー・ネガティブと呼ばれ、こればかりで学習すると進みが遅くなります。
一方で、ハード・ネガティブは、見た目はソースに似ているが異なるクラスに属するデータポイントです——たとえば犬種違いの2枚、あるいは表現は似ているが意味が異なる2つの文など。これらを見分けるには、モデルがより細やかな表現を発達させる必要があり、結果としてより良い埋め込みが得られます。
同じ論理はポジティブにも当てはまります。拡張が控えめすぎると学習は進まず、攻撃的すぎると、もはや有意味な類似とは言えなくなります。
損失関数は、ペアの比較を学習信号へと変換します。
各損失関数の働きは異なりますが、どれも共通の目標——類似するものがベクトル空間で近く、そうでないものが離れるようにモデルを報酬・罰則する——を持っています。
コントラスト損失は、初期のコントラスト学習の研究とともに提案されました。
これはペアに対して作用します。ポジティブ・ペアでは、埋め込みが離れすぎていると罰則を与えます。ネガティブ・ペアでは、埋め込みが近すぎる(特に、定義したマージン内に収まる)場合に罰則を与えます。十分に離れているネガティブは損失に寄与しません。
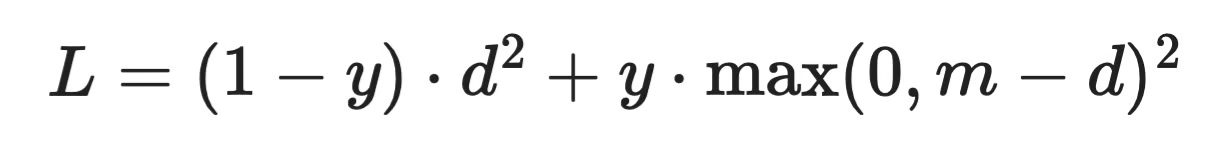
コントラスト損失の式
ここで、dは2つの埋め込み間の距離、yはネガティブ・ペアで1、ポジティブ・ペアで0、mはマージンです。マージンは手動で設定するハイパーパラメータであり、この損失はチューニングに敏感です。
トリプレット損失は、アンカー・ポジティブ・ネガティブの3つを同時に扱います。
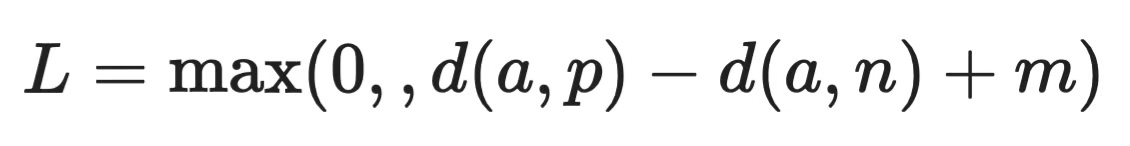
トリプレット損失の式
アンカーからポジティブへの距離d(a, p)が、アンカーからネガティブへの距離d(a, n)よりも少なくともマージンmだけ小さくない場合、モデルに罰則を与えます。この条件が満たされていれば、損失は0です。
この定式化は、1回の更新で両方の関係を同時に比較するため、コントラスト損失よりも多くの文脈をモデルに与えます。
InfoNCEは、SimCLRやCLIPを含む多くの最新コントラスト学習手法の根幹にある損失です。
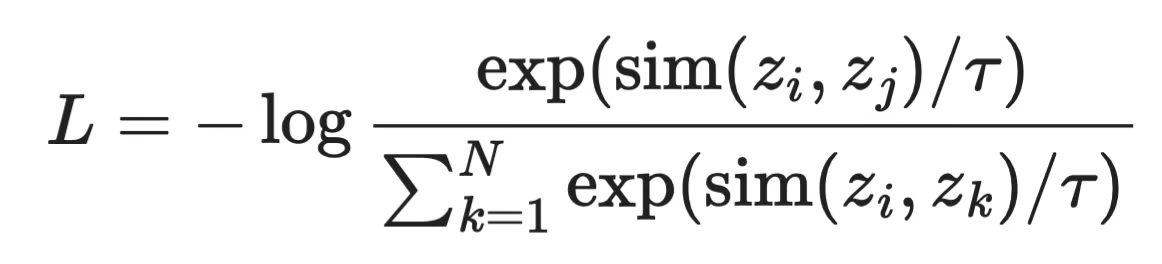
InfoNCE損失の式
各アンカーz_iに対して、モデルはバッチ内の他のN例の中から、そのポジティブz_jを特定しなければなりません。温度パラメータτは分布の鋭さを制御し、値を下げるとモデルはより確信的になり、値を上げるとペア間のコントラストが和らぎます。
1回の更新でより多くのネガティブに触れられるため、モデルはより豊富な学習信号を得ます。さらに、バッチを大きくすると、より難しいネガティブに曝露でき、一般により良い表現が得られます。
コントラスト学習と自己教師あり学習は相性が良く、その理由を理解することで、現代MLの進む方向も見えてきます。
自己教師あり学習は、人手のアノテーションなしで、データからモデル自身がラベルを生成する学習手法です。つまり、誰かが何千枚もの画像に「猫」「犬」とラベルを付ける代わりに、データ自体が監督信号を提供します。
コントラスト学習はまさにそれを行います。画像を取り、2つの拡張バージョンを作って、それをポジティブ・ペアだとモデルに伝える——これでラベルを作ったことになります。
これは重要です。なぜなら、ラベル付きデータこそが多くのMLパイプラインのボトルネックだからです。収集は遅く、アノテーションは高価で、医用画像のような領域ではそもそも十分なデータがないこともあります。
これまでの結果は有望です。大規模なラベルなしデータセットでコントラストな自己教師あり目的で事前学習したモデルは、わずかなラベル付きデータで微調整した後、さまざまな下流タスクで教師ありのベースラインに匹敵、あるいは近い性能を示しています。
全体的な傾向は、タスク特化の教師あり学習から、スケールする生データから汎用表現を学ぶ方向への移行です。SimCLR、MoCo、BYOLといった手法はいずれもこの流れに沿っており、次で取り上げます。
2026年時点でコントラスト学習を支える影響力の大きいフレームワークを3つ紹介します。
Google Researchが提案したSimCLRは、コントラスト学習の考えを最も明快に実装したものの1つです。
各バッチの各画像に対して2つの拡張ビューを作り、それらをポジティブ・ペアとして扱います。バッチ内の他のすべての画像はネガティブになります。CNNに小さな射影ヘッドをつないだモデルが、InfoNCE損失を用いてポジティブ・ペアを近づけるよう学習します。
SimCLRを際立たせたのは、バッチサイズの重要性です。バッチが大きいほど、1回の更新でのネガティブ数が増え、より良い表現につながりました。そのトレードオフはメモリです。SimCLRは大きなバッチを必要とするため、最大限に活用するには高性能なハードウェアが求められます。
Meta AI ResearchのMoCo(Momentum Contrast)は、まさにその問題を解決するために設計されました。
MoCoは大きなバッチに頼らず、キュー——直前のバッチからのエンコード済み表現の循環バッファ——を維持します。これにより、ネガティブの数をバッチサイズから切り離せるため、メモリを大幅に抑えつつ、多数のネガティブにモデルを曝露できます。
さらに、モメンタムエンコーダ(メインのエンコーダをゆっくり更新したコピー)を使い、キュー内の表現の一貫性を時間的に保ちます。
BYOL(Bootstrap Your Own Latent)は、ネガティブ・ペアを全く使わないにもかかわらず有用なため、ここで触れておく価値があります。
BYOLは、1つのネットワークが、ゆっくり更新されるターゲットネットワークの表現を予測するように学習します。ネガティブもコントラスト損失もありません。驚くほど良く機能し、コントラスト風の学習にネガティブ・ペアが必須だという前提に疑問を投げかけました。
BYOLはコントラスト学習の周縁に位置づけられますが、核となる手法を理解した後の次の一歩として良い選択です。
これら2つのアプローチは同じ問題を解きますが、出発点となる前提が異なることを理解しておく必要があります。
教師あり学習はラベル付きデータを必要とします。すべての学習例には人手によるカテゴリーや値の付与が必要で、モデルは入力からそのラベルへの写像を学びます。十分なラベル付き例があるときに有効な、直接的なアプローチです。モデルは入力が何で、正解が何かを知っています。
コントラスト学習は、データの構造——類似と相違——から自ら監督信号を生成し、ラベルを一切見ずに表現を学びます。
より視覚的な比較は次のとおりです:
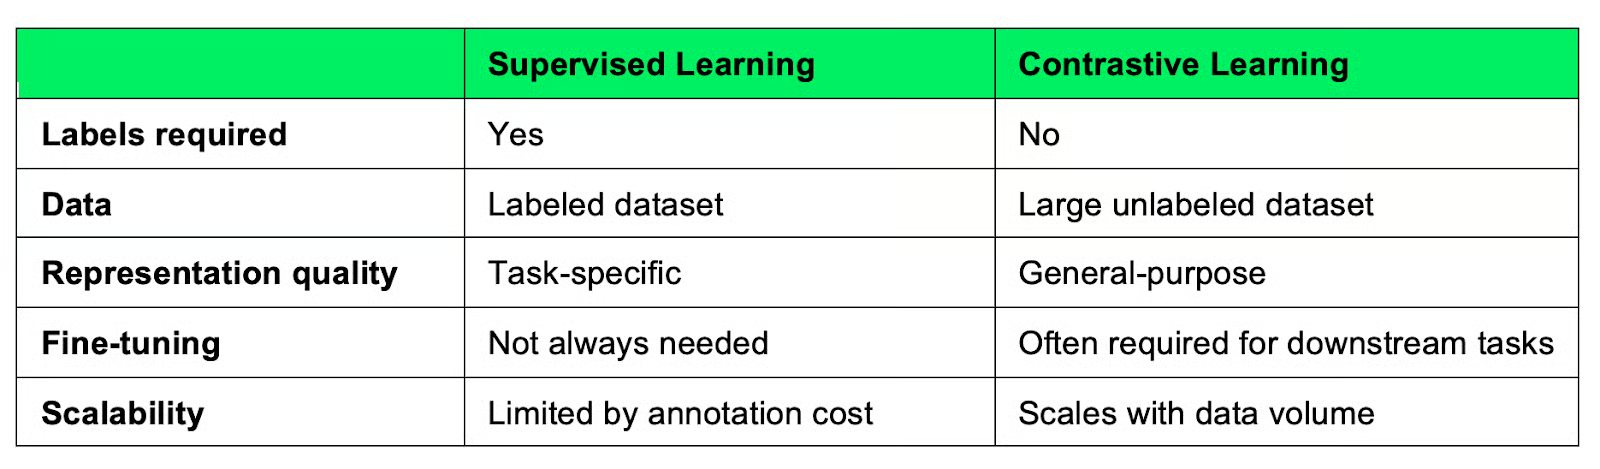
コントラスト学習と教師あり学習の比較
違いはスケールで顕著になります。教師あり学習はラベル付きデータに依存し、ラベル付けの追加は高コストです。コントラスト学習は、豊富に存在することが多いラベルなしデータを増やすほど改善を続けられます。
ただし重要なのは、コントラスト学習モデルが学ぶ表現は汎用的であり、タスク特化ではない点です。そのため、特定のタスクで高い性能を出すには、通常は微調整ステップが必要になります。教師ありモデルはターゲット目的で学習しているため、そのステップを必要としません。
選択はデータ状況に依存します。ラベル付きデータがあり、特定のタスクが決まっているなら、教師あり学習の方がしばしば速いです。大量のラベルなしデータを扱う、またはタスクを越えて転移する表現が必要なら、追加のセットアップに見合う価値がコントラスト学習にあります。
ここでは最小限のPyTorch実装を示します。以下の例は、先ほど説明した3つの中核概念——埋め込みモデル、コサイン類似度、そしてSimCLRで使われるInfoNCEベースのNT-Xent損失——をカバーします。
エンコーダは、入力ベクトルを低次元の埋め込み空間へ写像するシンプルなフィードフォワードネットワークです。
import torch
import torch.nn as nn
import torch.nn.functional as F

class Encoder(nn.Module):
    def __init__(self, input_dim, embedding_dim):
        super().__init__()
        self.network = nn.Sequential(
            nn.Linear(input_dim, 128),
            nn.ReLU(),
            nn.Linear(128, embedding_dim)
        )

    def forward(self, x):
        return self.network(x)
実務では、画像にはCNN、テキストにはトランスフォーマーに置き換えるでしょう。重要なのは、その後段で何をするかです。
2つの埋め込みが得られたら、コサイン類似度で近さを測ります。先にベクトルを正規化しておくと、類似度スコアは-1から1の範囲に収まります。
def cosine_similarity(z1, z2):
    z1 = F.normalize(z1, dim=-1)
    z2 = F.normalize(z2, dim=-1)
return torch.matmul(z1, z2.T)結果は行列で、各要素[i, j]が、バッチ内で埋め込みiと埋め込みjの類似度を表します。
NT-Xent(Normalized Temperature-scaled Cross Entropy)はInfoNCEに基づく損失です。各アンカーに対して、その対となるビューをポジティブとし、バッチ内の他のすべての例をネガティブとして扱います。
def nt_xent_loss(z1, z2, temperature=0.5):
    batch_size = z1.shape[0]

    z = torch.cat([z1, z2], dim=0)
    z = F.normalize(z, dim=-1)
    sim_matrix = torch.matmul(z, z.T) / temperature

    mask = torch.eye(2 * batch_size, dtype=torch.bool)
    sim_matrix = sim_matrix.masked_fill(mask, float("-inf"))

    labels = torch.arange(batch_size)
    labels = torch.cat([labels + batch_size, labels])

return F.cross_entropy(sim_matrix, labels)temperatureパラメータは分布の鋭さを制御します。値を下げると、どのペアがポジティブかについてモデルの確信が強まり、値を上げるとコントラストが和らぎます。
encoder = Encoder(input_dim=64, embedding_dim=32)
optimizer = torch.optim.Adam(encoder.parameters(), lr=1e-3)

# Simulate a batch of positive pairs
x1 = torch.randn(32, 64)
x2 = torch.randn(32, 64)

# Training
optimizer.zero_grad()
z1, z2 = encoder(x1), encoder(x2)
loss = nt_xent_loss(z1, z2)
loss.backward()
optimizer.step()

print(f"Loss: {loss.item():.4f}")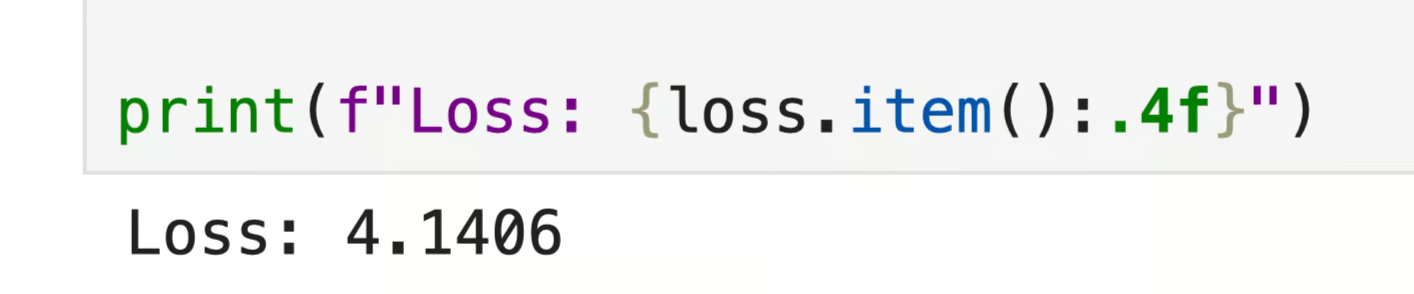
コントラスト学習ループの出力
これは最も単純な形でのコントラスト学習ループの全体です。実際の実装では、x1とx2はランダムノイズではなく同一入力の2つの拡張ビューになります——しかし構造自体はまったく同じです。
コントラスト学習は、シンプルながら適用範囲の広いアイデアです。
ラベル付きデータに頼るのではなく、比較によって構造を理解するようモデルに教えます。似たものを引き寄せ、異なるものを引き離す——それがすべての前提です。これだけで、タスク間でよく転移する表現を学習するには十分であることが分かっています。
分野はアノテーション依存のパイプラインから離れつつあり、コントラスト学習はその大きな要因です。SimCLR、MoCo、CLIPのようなアルゴリズムが実際の製品に組み込まれていることは、この手法の有効性を物語っています。
さらに深く学ぶなら、実装に触れるのが近道です。本記事のPyTorch例は出発点にすぎませんが、実際の画像データセット——小規模でも——でSimCLRを動かしてみると、どんな説明よりも多くを学べます。
高度な機械学習トピックの決定版リソースが必要であれば、当社のMachine Learning Scientist in Pythonトラックにご登録ください。