Courses
理解机器学习
2小时
307.9K
让模型在没有标注数据的情况下学习,听起来似乎不可能,但这正是对比学习背后的理念。
众所周知,数据标注既缓慢又昂贵。单是一个图像分类数据集,通常就需要数千小时的人力标注,更不用说其中的错误与不一致了。
对比学习通过教模型进行比较来绕过这一标注难题。也就是说,您不告诉模型“这是什么”,而是展示哪些东西相似、哪些不同——其余的交给模型自己去领会。
在本文中,我将带您理解对比学习背后的直觉、它的底层工作方式、它在实践中的用法——从图像识别到 NLP 向量表征——以及如何在 PyTorch 中实现它。
计算机视觉究竟是什么?阅读我们的图像分析入门指南。
对比学习是一种训练方法,模型通过比较而非分类来学习。
您不对模型说“这是猫”或“这是狗”,而是给它看成对的样本,让它自己找出哪些归为一类、哪些不归为一类。模型通过判断两样东西是否相似来学习。
换句话说——您一次向模型输入两个数据点。如果它们相关——比如同一只狗从不同角度拍的两张照片——这就是正样本对。如果它们无关——一张狗的照片和一张汽车的照片——这就是负样本对。
模型的任务是生成遵循这种结构的表征(数值向量)。正样本对应在向量空间中彼此靠近,负样本对应彼此远离。
理解对比学习最简单的方式是通过图像。
取一张狗的照片。再生成两个版本——一个裁剪过,一个调整了亮度。您看到的内容相同,但像素不同。对比学习模型会将这两个版本视为正样本对,并学习将它们映射到向量空间中的相近位置。
如果您把那张狗的照片和一张汽车的照片一起给模型看,就得到一个负样本对。模型会学习将它们的表征推远。
您无需手动介入、指定“这是狗”或“这是车”。模型从相似与差异的结构中建立理解。
这正是对比学习强大的原因。
信号来自比较。只要有足够多的样本对,模型就能学到既理解相似之处又能分辨差异的表征。
这些表征事实证明非常有用。这样训练过的图像模型,可以在很少的标注数据下,就为分类、检测或检索任务进行微调,因为它已对视觉世界学到了有意义的东西。
对比学习出现在许多领域——以下是您最常见到的地方。
这是对比学习最先证明实力的领域。
以这种方式在图像上训练的模型,能学会生成无需标签也能理解视觉相似性的表征。同一场景在不同角度或不同光照下拍摄的两张照片,应映射到向量空间中的相邻点。两个不相关的场景则应相距甚远。
您可以拿一个对比预训练的模型来做分类或目标检测微调,只需用到原本所需标注数据的一小部分。
在 NLP 中,对比学习用于训练句子嵌入——能理解整句意义的向量表征。
语义相近的句子应在向量空间中彼此靠近,无关的句子应被拉开。以这种方式训练的模型可以执行语义搜索与句子相似度等任务,而无需大量标注的句子对。
推荐系统使用对比学习来建模用户-物品的相似性。
用户与其互动过的物品构成正样本对。用户与其未见过的随机物品构成负样本对。只要训练了足够多这样的样本,模型就会学到一个共享空间,让相关用户与物品聚在一起。
这是对比学习变得更有趣的地方。
像 CLIP 这样的模型使用它来在共享向量空间中对齐文本与图像。一张狗的照片与句子“a dog playing in the park”应彼此靠近;一张狗的照片与句子“a red sports car”则不应靠近。这让多模态模型能够将图像与文本描述进行匹配,并生成字幕。
无论您处理的是图像、文本还是音频,对比学习始终遵循同样的四个步骤。
每个训练样本都以一对开始。您采样两个数据点,并将它们的关系标为相似(正样本)或不相似(负样本)。在实践中,正样本对通常来自对同一输入进行两种不同的增强;负样本对通常来自采样无关的例子。
两个数据点都通过一个编码器被转换为向量。这些向量称为嵌入,是处于共享向量空间中的数值表征。目标是让这个空间反映语义意义,而非原始像素或词元的取值。
得到两个嵌入后,您需要衡量它们的接近程度。这里最常用的是余弦相似度。它给出介于 -1 与 1 之间的分数,1 表示两个向量方向一致,-1 表示完全相反。
模型将自己的相似度分数与期望值进行比较。正样本分数应高,负样本分数应低。损失函数衡量模型的偏差程度,反向传播则调整编码器权重,以便下次做得更好。
如果在足够多的样本对上重复这些步骤,编码器就会学会生成让相似事物聚集、不同事物分离的嵌入。
您的对比模型质量,很大程度取决于您如何构造样本对。
正样本对是应被视为相似的两个数据点。在计算机视觉中,这通常意味着同一张图像的两个增强版本。在 NLP 中,可能是同一句子的两个意译,或一句话及其翻译。模型会学到:两者之间变化的部分并不重要,唯一重要的是它们的共性。
负样本对是应被视为不同的两个数据点。大多数实现会从数据集的其余部分随机采样负样本。如果您在图像上训练,任何两张不同物体的图像都可以构成有效的负样本对。
难点在这里开始体现。
并非所有负样本都同等有用。明显不同于源样本的随机负样本——比如把一张狗的照片与一张飞机的照片配对——并不会让模型费太多劲。这些称为易负样本,训练中过多这类样本会降低学习速度。
另一边,难负样本指与源样本看起来相似但属于不同类别的数据点——例如两种狗的品种,或两句措辞相似但含义不同的句子。模型必须学习更细粒度的表征来区分它们,从而整体上得到更好的嵌入。
同样的逻辑也适用于正样本。如果您的增强过于细微,模型学不到太多;如果过于激进,这一对就不再有意义地相似了。
损失函数将样本对的比较转化为学习信号。
各类损失函数工作机制不同,但都以同一目标为导向:当相似样本在向量空间中更靠近时奖励模型,当它们不够接近时惩罚模型。
对比损失与早期的对比学习研究一同被提出。
它在成对样本上工作。对于正样本对,如果它们的嵌入距离过远,则惩罚模型;对于负样本对,如果它们的嵌入距离过近——具体来说落在设定的间隔之内——则惩罚模型。已足够分开的负样本不再贡献损失。
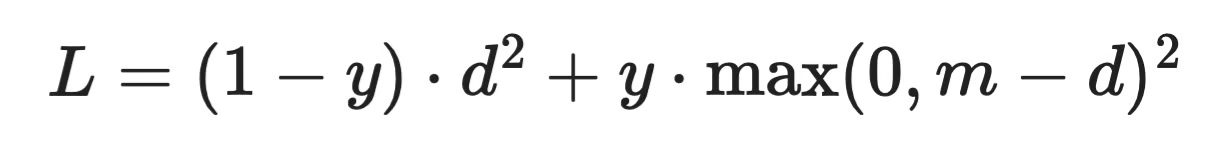
对比损失公式
其中 d 为两个嵌入之间的距离,y 对负样本对为 1、对正样本对为 0,m 为间隔。间隔是您手动设定的超参数,因此该损失对调参较为敏感。
三元组损失一次处理三个数据点:一个锚点、一个正样本和一个负样本。
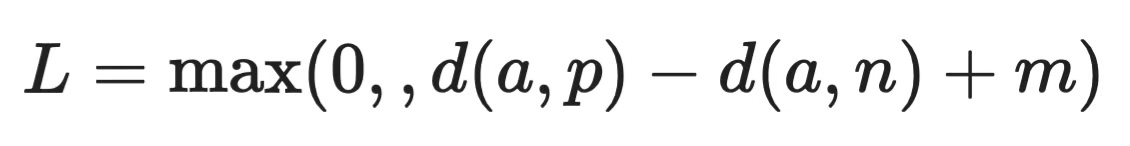
三元组损失公式
当锚点到正样本的距离 d(a, p) 未能比锚点到负样本的距离 d(a, n) 至少小 m 时,模型会被惩罚。如果该条件已满足,则损失为 0。
这种形式比对比损失在每次更新中给模型更多上下文,因为它在同时比较两种关系,而非一次只比较一种。
InfoNCE 是大多数现代对比学习方法背后的损失,包括 SimCLR 和 CLIP。
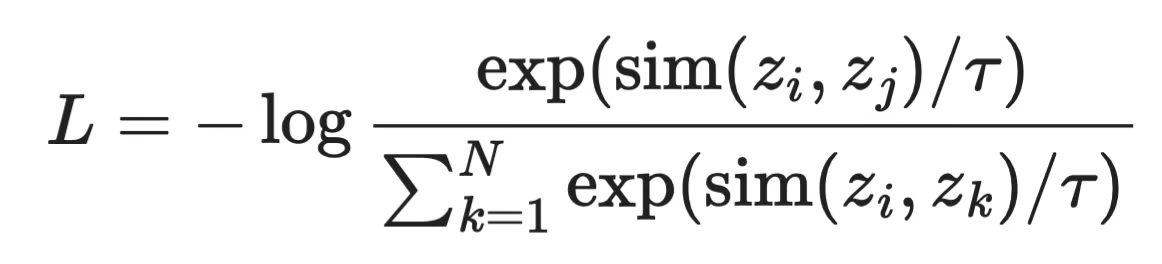
InfoNCE 损失公式
对于每个锚点 z_i,模型需要从批中的所有其他 N 个样本中识别出其正样本 z_j。温度参数 τ 控制分布的尖锐程度——值越低模型越自信,值越高则弱化样本对之间的对比。
每次更新您会得到更多负样本,从而提供更丰富的学习信号。这也意味着更大的批次会让模型接触到更难的负样本,通常能产生更好的表征。
对比学习与自监督学习相得益彰。理解二者为何契合,便能理解现代机器学习的发展方向。
自监督学习是一种训练方法,模型无需人工标注即可从数据中生成自身的标签。也就是说,与其让人把上千张图片标为“猫”或“狗”,不如由数据本身提供监督信号。
对比学习正是这样做的。当您拿一张图像,生成两个增强版本,并告诉模型它们是一对正样本时,您其实已经创建了一个标签。
这之所以重要,是因为标注数据是多数机器学习流程的瓶颈。采集缓慢、标注昂贵,且在一些领域(如医学影像)中,数据量本就不足。
迄今为止结果令人鼓舞。用对比式自监督目标在大型无标注数据集上进行预训练的模型,在只用少量标注数据微调后,已在多项下游任务上与监督基线相匹配或接近。
总体趋势是从面向任务的监督训练,转向从大规模原始数据中学习通用表征。SimCLR、MoCo 和 BYOL 等方法都遵循这一趋势,接下来我会讨论它们。
以下是 2026 年最具影响力的三大对比学习框架。
SimCLR 由 Google Research 提出,是对比学习理念最清晰的实现之一。
对一个批次中的每张图像,它会创建两个增强视图并将其视为正样本对。批次中的其他所有图像都成为负样本。模型由一个 CNN 和一个小型投影头组成,使用 InfoNCE 损失学习将正样本对映射得更接近。
SimCLR 脱颖而出的原因在于批大小的重要性。批次越大,每次更新中的负样本越多,表征也就越好。取舍在于内存。由于 SimCLR 需要较大的批次才能效果理想,您需要足够的硬件来发挥其优势。
MoCo(Momentum Contrast,动量对比)来自 Meta AI Research,正是为解决上述问题而设计。
MoCo 不依赖大批次来获取负样本,而是维护一个队列——一个保存前几个批次编码表征的动态缓冲区。这样将负样本数量与批大小解耦,您可以用更少内存训练,同时仍让模型接触到大量负样本池。
它还使用动量编码器,即主编码器的一个缓慢更新的副本,以保持队列表征随时间的一致性。
尽管 BYOL(Bootstrap Your Own Latent)完全不使用负样本,它仍值得一提。
BYOL 不通过推远负样本来训练,而是训练一个网络去预测另一个——一个缓慢更新的目标网络——的表征。没有负样本,也没有对比损失。它的效果出人意料地好,并挑战了“对比式学习必须需要负样本”的假设。
BYOL 处在对比学习的边缘地带,但在您理解核心方法之后,它是很好的下一步。
这两种方法解决的是同一类问题,但出发假设不同,您需要理解这些差异。
监督学习需要标注数据。每个训练样本都要有人赋予标签,模型通过将输入映射到这些标签来学习。这是一种直接的方法,当您有足够的标注样本时效果很好。模型知道输入是什么以及正确答案是什么。
对比学习则从数据的结构——相似与差异——中自行生成监督信号,在没有任何标签的情况下学习表征。
下面是一个更直观的比较方式:
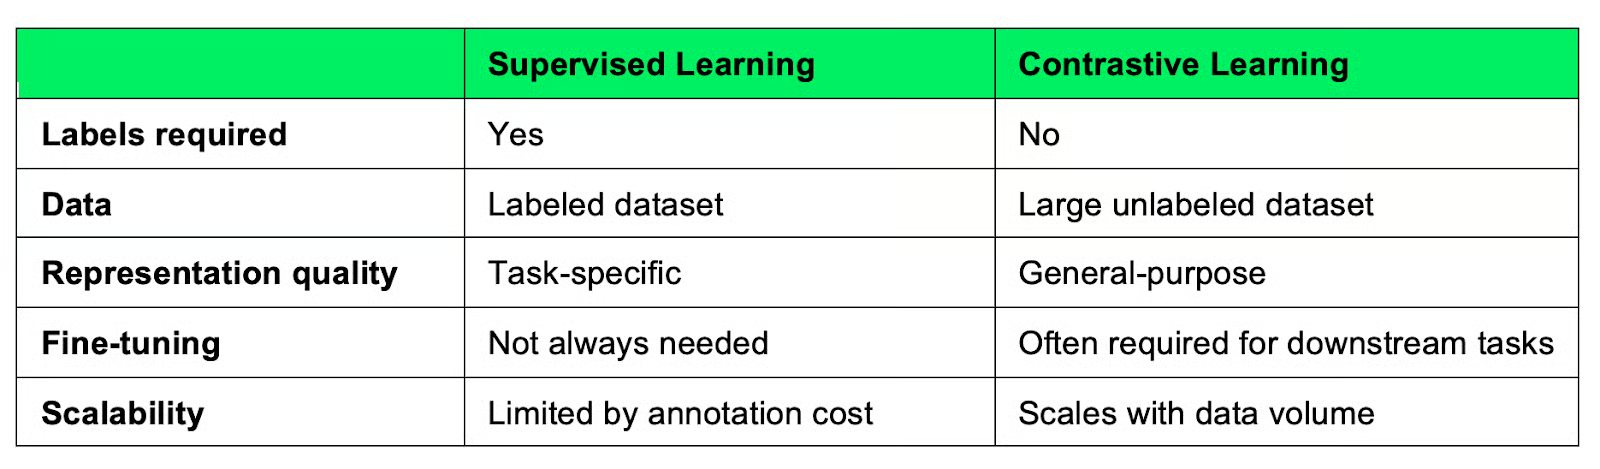
对比学习与监督学习对比
主要差异体现在规模化上。监督学习依赖标注数据——而增加标注很昂贵。对比学习则能在您不断喂入更多无标注数据时持续提升,而无标注数据通常很充足。
但需要注意的是,对比学习模型学到的是通用表征,而非任务特定表征,这意味着通常需要一个微调步骤才能在特定任务上取得良好表现。监督模型则不需要这一步,因为它们直接在目标任务上训练。
选择取决于您的数据情况。如果您有标注数据且目标明确,监督学习往往更快。如果您拥有大量无标注数据,或需要能跨任务迁移的表征,对比学习则值得投入额外的搭建成本。
下面给出一个最小化的 PyTorch 实现。以下示例涵盖了先前讨论的三个核心思想:嵌入模型、余弦相似度,以及 NT-Xent 损失——SimCLR 所用、基于 InfoNCE 的损失函数。
编码器是一个简单的前馈网络,将输入向量映射到更低维的嵌入空间。
import torch
import torch.nn as nn
import torch.nn.functional as F

class Encoder(nn.Module):
    def __init__(self, input_dim, embedding_dim):
        super().__init__()
        self.network = nn.Sequential(
            nn.Linear(input_dim, 128),
            nn.ReLU(),
            nn.Linear(128, embedding_dim)
        )

    def forward(self, x):
        return self.network(x)
在实践中,您会将其替换为用于图像的 CNN 或用于文本的 Transformer。与它之后的内容相比,架构本身并不那么关键。
得到两个嵌入后,您使用余弦相似度来衡量它们的接近程度。先对向量进行归一化可让相似度分数限定在 -1 到 1 之间。
def cosine_similarity(z1, z2):
    z1 = F.normalize(z1, dim=-1)
    z2 = F.normalize(z2, dim=-1)
    return torch.matmul(z1, z2.T)
结果是一个矩阵,其中每个条目 [i, j] 表示批内嵌入 i 与嵌入 j 之间的相似度。
NT-Xent(Normalized Temperature-scaled Cross Entropy)是基于 InfoNCE 的损失。对每个锚点,它将其配对视图作为正样本,将批中其他所有样本作为负样本。
def nt_xent_loss(z1, z2, temperature=0.5):
    batch_size = z1.shape[0]

    z = torch.cat([z1, z2], dim=0)
    z = F.normalize(z, dim=-1)
    sim_matrix = torch.matmul(z, z.T) / temperature

    mask = torch.eye(2 * batch_size, dtype=torch.bool)
    sim_matrix = sim_matrix.masked_fill(mask, float("-inf"))

    labels = torch.arange(batch_size)
    labels = torch.cat([labels + batch_size, labels])

    return F.cross_entropy(sim_matrix, labels)
temperature 参数控制分布的尖锐程度。值越低,模型对哪个配对为正越自信;值越高,对比会更柔和。
encoder = Encoder(input_dim=64, embedding_dim=32)
optimizer = torch.optim.Adam(encoder.parameters(), lr=1e-3)

# Simulate a batch of positive pairs
x1 = torch.randn(32, 64)
x2 = torch.randn(32, 64)

# Training
optimizer.zero_grad()
z1, z2 = encoder(x1), encoder(x2)
loss = nt_xent_loss(z1, z2)
loss.backward()
optimizer.step()

print(f"Loss: {loss.item():.4f}")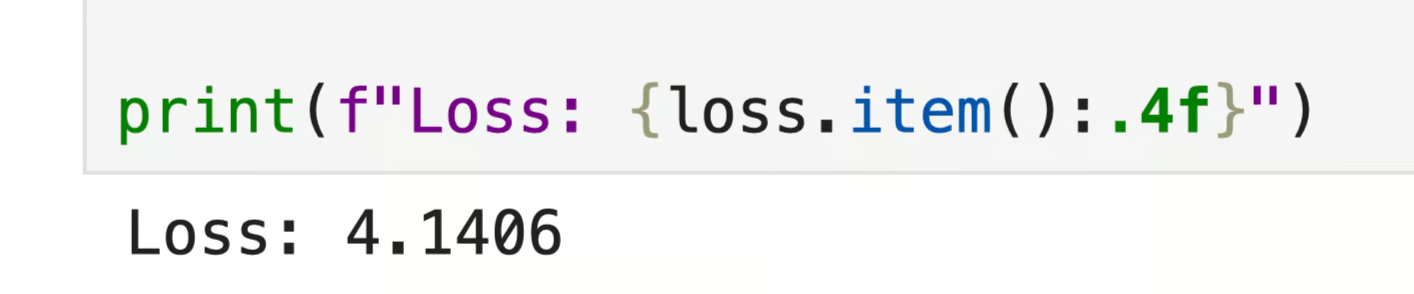
对比循环输出
这就是最简单形式的完整对比循环。在真实实现中,x1 与 x2 会是同一输入的两种增强视图,而非随机噪声——但结构完全相同。
对比学习是一个简单却影响深远的理念。
它教会模型通过比较来理解结构,而不是依赖标注数据。将相似的事物拉近、将不同的事物推远——这就是全部前提。事实证明,这足以学习到能够在各类任务间良好迁移的表征。
整个领域正在远离高度依赖标注的流程,而对比学习正是重要原因之一。像 SimCLR、MoCo 和 CLIP 这样的算法已经进入了真实产品,这从侧面说明了这种方法的有效性。
如果您想更深入,下一步的好方法是亲手上手一个真实实现。本文的 PyTorch 示例是一个起点,但在实际图像数据集上运行 SimCLR——哪怕是小数据集——所带来的收获,胜过任何文字解释。
若您需要进阶机器学习主题的系统资源,欢迎报名我们的Python 机器学习科学家学习路径。