course
Introduktion till maskininlärning
2 timmar
308K
Att få en modell att lära sig utan märkta data låter omöjligt, men det är idén bakom kontrastiv inlärning.
Som du vet är annotering av data långsamt och dyrt. Ett enda bildklassificeringsdataset kräver ofta tusentals timmar av manuell annotering, och det är innan du tar hänsyn till fel och inkonsekvenser.
Kontrastiv inlärning kringgår problemet med märkning genom att lära modeller att jämföra. Så i stället för att tala om för en modell vad något är, visar du vad som är likt och vad som är olika – och låter den lista ut resten.
I den här artikeln går jag igenom intuitionen bakom kontrastiv inlärning, hur det fungerar under huven, var det används i praktiken – från bildigenkänning till NLP-inbäddningar – och hur du implementerar det i PyTorch.
Vad är datorseende egentligen? Läs vår nybörjarguide till bildanalys.
Kontrastiv inlärning är ett träningsupplägg där en modell lär sig genom jämförelse i stället för klassificering.
I stället för att säga till modellen ”det här är en katt” eller ”det här är en hund” visar du den par av exempel och låter den lista ut vad som hör ihop och vad som inte gör det. Modellen lär sig genom att avgöra om två saker är lika eller inte.
Med andra ord – du matar modellen med två datapunkter åt gången. Om de är relaterade – säg två foton av samma hund tagna ur olika vinklar – är det ett positivt par. Om de är orelaterade – ett foto av en hund och ett foto av en bil – är det ett negativt par.
Modellens uppgift är att producera representationer (numeriska vektorer) som följer den här strukturen. Positiva par ska hamna nära varandra i vektorrummet. Negativa par ska hamna långt ifrån varandra.
Det enklaste sättet att förstå kontrastiv inlärning är via bilder.
Ta ett foto av en hund. Skapa sedan två versioner – en beskuren, en med justerad ljusstyrka. Innehållet du ser är detsamma, men pixlarna skiljer sig. En modell för kontrastiv inlärning ser dessa två versioner som ett positivt par och lär sig att placera dem på liknande positioner i vektorrummet.
Visar du modellen ett foto av en bil tillsammans med hundfotot får du ett negativt par. Modellen lär sig att trycka isär deras representationer.
Du behöver inte manuellt gå in och specificera ”det här är en hund” eller ”det här är en bil”. Modellen bygger sin förståelse utifrån strukturen av likhet och olikhet.
Det är detta som gör kontrastiv inlärning kraftfull.
Signalen kommer från jämförelsen. Med tillräckligt många par kan modellen utveckla representationer som förstår vad som gör saker lika och vad som skiljer dem åt.
De representationerna visar sig vara verkligt användbara. En modell som tränats på detta sätt på bilder kan finjusteras för klassificering, detektion eller återhämtning med mycket lite märkt data, eftersom den redan har lärt sig något meningsfullt om den visuella världen.
Kontrastiv inlärning dyker upp i många domäner – här ser du den oftast.
Det var här kontrastiv inlärning först visade vad den kan åstadkomma.
Modeller som tränas på detta sätt på bilder lär sig att producera representationer som förstår visuell likhet utan att någonsin se en etikett. Två foton av samma scen, tagna ur olika vinklar eller under olika ljusförhållanden, ska kartläggas till närliggande punkter i vektorrummet. Två orelaterade scener ska hamna långt ifrån varandra.
Du kan ta en kontrastivt förtränad modell och finjustera den för klassificering eller objektigenkänning med en bråkdel av den märkta data du annars skulle behöva.
Inom NLP används kontrastiv inlärning för att träna meningsembeddningar – vektorrepresentationer som fångar betydelsen av en mening som helhet.
Meningar med liknande innebörd ska ligga nära varandra i vektorrummet, och orelaterade meningar ska placeras isär. Modeller som tränas så här kan utföra uppgifter som semantisk sökning och meningslikhet utan stora mängder märkta meningspar.
Rekommendationssystem använder kontrastiv inlärning för att modellera likhet mellan användare och objekt.
En användare och ett objekt som hen har interagerat med bildar ett positivt par. En användare och ett slumpmässigt objekt som hen aldrig har sett bildar ett negativt par. Tränar du på tillräckligt många sådana lär sig modellen ett gemensamt rum där relevanta användare och objekt klustrar tillsammans.
Det är här kontrastiv inlärning blir extra intressant.
Modeller som CLIP använder den för att linjera text och bilder i ett gemensamt vektorrum. Ett foto av en hund och meningen ”a dog playing in the park” ska hamna nära varandra. Ett foto av en hund och meningen ”a red sports car” ska inte det. Detta gör att multimodala modeller kan matcha bilder mot textbeskrivningar och generera bildtexter.
Kontrastiv inlärning följer alltid samma fyra steg, oavsett om du arbetar med bilder, text eller ljud.
Varje tränings exempel börjar som ett par. Du samplar två datapunkter och märker relationen som lik (positiv) eller olik (negativ). I praktiken kommer positiva par ofta från att augmentera samma indata på två olika sätt, och negativa par från att samp la orelaterade exempel.
Båda datapunkterna passerar genom en encoder som omvandlar dem till vektorer. Dessa vektorer, kallade inbäddningar, är numeriska representationer i ett gemensamt vektorrum. Målet är att detta rum ska återspegla semantisk mening, inte råa pixel- eller tokenvärden.
När du har två inbäddningar mäter du hur nära de är. Cosinuslikhet är det vanligaste valet här. Den ger ett betyg mellan -1 och 1, där 1 betyder att vektorerna pekar i samma riktning och -1 att de är helt motsatta.
Modellen jämför sina likhetsbetyg mot vad de borde vara. För positiva par ska betyget vara högt. För negativa par ska det vara lågt. En förlustfunktion mäter hur långt ifrån modellen är, och backpropagation justerar encoder-vikterna för att bli bättre till nästa gång.
Upprepar du dessa steg över tillräckligt många par lär sig encodern att producera inbäddningar som klustrar liknande saker och trycker isär olika saker.
Kvaliteten på din kontrastiva modell beror på hur du skapar dina par.
Positiva par är två datapunkter som bör betraktas som lika. Inom datorseende betyder det oftast två augmenterade versioner av samma bild. Inom NLP kan det vara två parafraser av samma mening, eller en mening och dess översättning. Modellen lär sig att det som varierar mellan dem inte spelar någon roll. Det enda som spelar roll är det de har gemensamt.
Negativa par är två datapunkter som bör betraktas som olika. De flesta implementationer samplar negativa exempel slumpmässigt från resten av datasetet. Om du tränar på bilder utgör vilka två bilder som helst av olika objekt ett giltigt negativt par.
Här blir det knepigt.
Alla negativa är inte lika användbara. Ett slumpmässigt negativt som uppenbart skiljer sig från källan – säg ett foto av en hund ihop med ett foto av ett flygplan – tvingar inte modellen att arbeta särskilt hårt. Dessa kallas enkla negativa, och att träna på för många sådana saktar ned inlärningen.
På andra sidan är svåra negativa datapunkter som ser lika ut som källan men tillhör en annan klass – två hundraser till exempel, eller två meningar med liknande formulering men olika betydelser. Modellen måste utveckla mer finmaskiga representationer för att skilja dem åt, vilket ger bättre inbäddningar överlag.
Samma logik gäller för positiva. Om dina augmentationer är för subtila lär sig modellen inte mycket. Om de är för aggressiva är paret inte meningsfullt likt längre.
Förlustfunktionen gör om jämförelser mellan par till inlärningssignaler.
Varje förlust fungerar olika, men de har samma mål: att belöna modellen när liknande saker ligger nära i vektorrummet och straffa den när de inte gör det.
Kontrastiv förlust introducerades tillsammans med de tidiga arbetena inom kontrastiv inlärning.
Den verkar på par. Givet ett positivt par straffar den modellen om deras inbäddningar ligger långt ifrån varandra. Givet ett negativt par straffar den modellen om deras inbäddningar ligger för nära – specifikt, om de faller inom en definierad marginal. Negativa som redan ligger tillräckligt långt isär bidrar inte till förlusten.
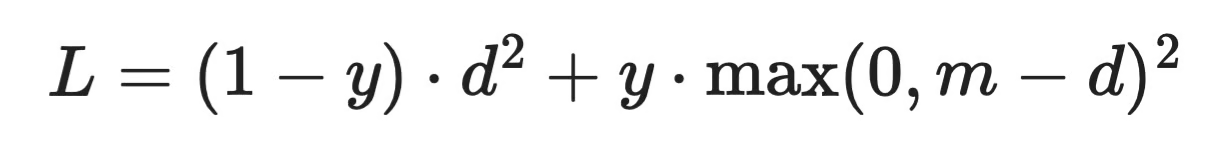
Formel för kontrastiv förlust
Där d är avståndet mellan två inbäddningar, y är 1 för negativa par och 0 för positiva par, och m är marginalen. Marginalen är en hyperparameter du sätter manuellt, vilket gör denna förlust känslig för justering.
Triplet-förlust arbetar med tre datapunkter samtidigt: ett ankare, en positiv och en negativ.
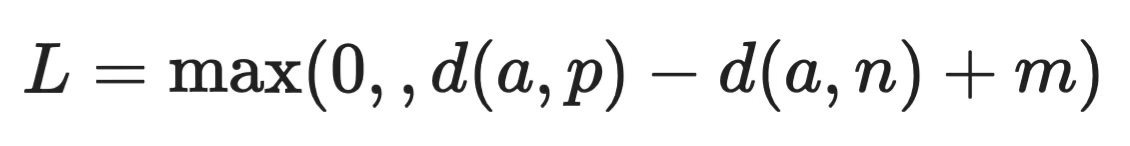
Formel för triplet-förlust
Modellen straffas när avståndet mellan ankare och positiv d(a, p) inte är mindre än avståndet mellan ankare och negativ d(a, n) med åtminstone marginalen m. Om villkoret redan är uppfyllt är förlusten noll.
Denna formulering ger modellen mer kontext per uppdatering än kontrastiv förlust, eftersom den jämför båda relationerna samtidigt i stället för en i taget.
InfoNCE är förlusten bakom de flesta moderna metoderna för kontrastiv inlärning, inklusive SimCLR och CLIP.
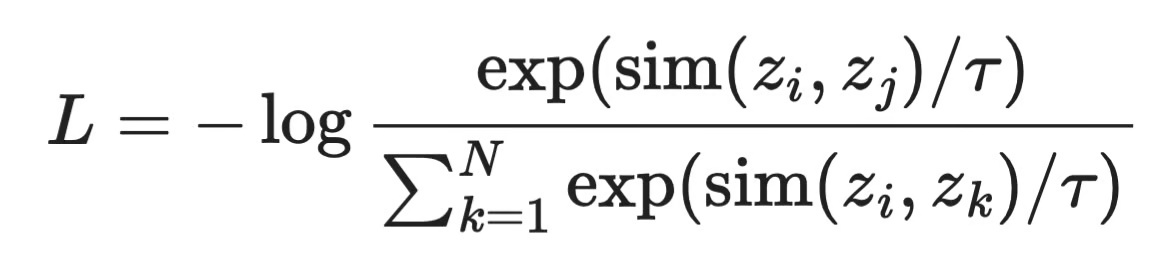
Formel för InfoNCE-förlust
För varje ankare z_i måste modellen identifiera dess positiva z_j bland alla andra N exempel i batchen. Temperaturparametern τ styr hur skarp fördelningen är – lägre värden gör modellen mer självsäker, högre värden mjukar upp kontrasten mellan par.
Du får fler negativa per uppdatering, vilket ger modellen mer inlärningssignal. Det innebär också att större batcher exponerar modellen för svårare negativa och i allmänhet ger bättre representationer.
Kontrastiv inlärning och självövervakad inlärning fungerar väl tillsammans, och genom att förstå varför förstår du vart modern ML är på väg.
Självövervakad inlärning är ett träningssätt där modellen skapar sina egna etiketter från datan, utan mänsklig annotering. Så i stället för att någon märker tusentals bilder som ”katt” eller ”hund”, ger datan själv övervakningssignalen.
Kontrastiv inlärning gör precis det. När du tar en bild, skapar två augmenterade versioner av den och talar om för modellen att de är ett positivt par, har du just skapat en etikett.
Detta spelar roll eftersom märkta data är flaskhalsen i de flesta ML-pipelines. Insamling går långsamt, annotering är dyrt och vissa områden, såsom medicinsk bildbehandling, har inte tillräckligt av det.
Resultaten hittills har varit lovande. Modeller som förtränats med kontrastiva självövervakade mål på stora omärkta dataset har matchat eller närmat sig övervakade baslinjer på en rad nedströmsuppgifter efter finjustering på endast en liten mängd märkta data.
Den allmänna trenden är att gå bort från uppgiftsspecifik övervakad träning och mot allmänna representationer lärda från rådata i stor skala. Metoder som SimCLR, MoCo och BYOL följer alla denna trend, och jag tar upp dem härnäst.
Här är de tre mest inflytelserika ramverken bakom kontrastiv inlärning 2026.
SimCLR, introducerat av Google Research, är en av de tydligaste implementationerna av idén om kontrastiv inlärning.
För varje bild i en batch skapar den två augmenterade vyer och behandlar dem som ett positivt par. Varje annan bild i batchen blir ett negativt. Modellen, som är en CNN följd av ett litet projek tionshuvud, lär sig att placera positiva par nära varandra med InfoNCE-förlust.
Det som fick SimCLR att sticka ut var hur mycket batchstorleken spelade roll. Större batcher innebar fler negativa per uppdatering, vilket gav bättre representationer. Baksidan är minne. Eftersom SimCLR kräver stora batcher för att fungera väl behöver du bra hårdvara för att få ut det mesta.
MoCo (Momentum Contrast), från Meta AI Research, utformades för att lösa just det problemet.
I stället för att förlita sig på en stor batch för negativa behåller MoCo en kö – en rullande buffert av kodade representationer från tidigare batcher. Detta kopplar loss antalet negativa från batchstorleken, så du kan träna med betydligt mindre minne och ändå exponera modellen för en stor pool av negativa.
Den använder också en momentum-encoder, som är en långsamt uppdaterad kopia av huvudencodern, för att hålla representationerna i kön konsistenta över tid.
BYOL (Bootstrap Your Own Latent) är värt att nämna här även om den inte använder negativa par alls.
I stället för att trycka negativa isär tränar BYOL ett nätverk att förutsäga representationerna hos ett annat – ett långsamt uppdaterat målnätverk. Det finns inga negativa och ingen kontrastiv förlust. Det fungerar förvånansvärt bra, och dess framgång utmanade antagandet att negativa par är nödvändiga för kontrastiv-liknande inlärning.
BYOL ligger någonstans i utkanten av kontrastiv inlärning, men det är ett bra nästa steg när du förstår hur kärnmetoderna fungerar.
Dessa två angreppssätt löser samma problem, men de utgår från olika antaganden som du behöver förstå.
Övervakad inlärning kräver märkta data. Varje tränings exempel behöver en mänskligt tilldelad etikett, och modellen lär sig genom att kartlägga indata till dessa etiketter. Det är ett direkt angreppssätt och fungerar bra när du har tillräckligt många märkta exempel. Modellen vet vad indata är och vad det korrekta svaret är.
Kontrastiv inlärning skapar sin egen övervakning från datans struktur – likhet och olikhet – och lär sig representationer utan att någonsin se en etikett.
Här är en mer visuell representation av hur de jämförs:
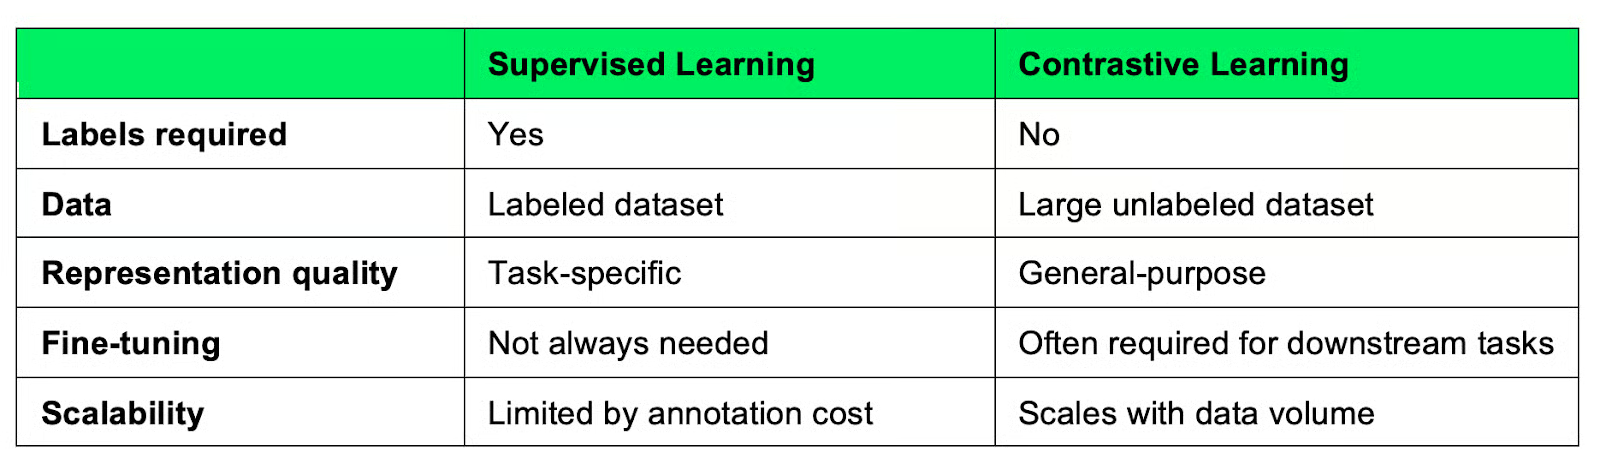
Kontrastiv inlärning jämfört med övervakad inlärning
Största skillnaden visar sig i skala. Övervakad inlärning är beroende av märkta data – och att märka mer är dyrt. Kontrastiv inlärning kan fortsätta att förbättras när du matar den med mer omärkt data, vilket oftast finns i överflöd.
Men det är viktigt att notera att representationerna som en kontrastiv modell lär sig är generella, inte uppgiftsspecifika, vilket innebär att du oftast behöver en finjusteringsfas för att få bra prestanda på en specifik uppgift. Övervakade modeller behöver inte det steget eftersom de tränas på målobjektivet.
Valet beror på din datasituation. Har du märkta data och en specifik uppgift är övervakad inlärning ofta snabbare. Arbetar du med stora mängder omärkt data eller behöver representationer som överförs mellan uppgifter kan kontrastiv inlärning vara värd den extra uppsättningen.
Låt mig nu göra en minimal PyTorch-implementation. Exemplet nedan täcker de tre kärnidéer som diskuterades tidigare: en inbäddningsmodell, cosinuslikhet och NT-Xent-förlust – förlustfunktionen som används i SimCLR, byggd ovanpå InfoNCE.
Encodern är ett enkelt feedforward-nätverk som mappar indata-vektorer till ett inbäddningsutrymme med lägre dimension.
import torch
import torch.nn as nn
import torch.nn.functional as F

class Encoder(nn.Module):
    def __init__(self, input_dim, embedding_dim):
        super().__init__()
        self.network = nn.Sequential(
            nn.Linear(input_dim, 128),
            nn.ReLU(),
            nn.Linear(128, embedding_dim)
        )

    def forward(self, x):
        return self.network(x)
I praktiken skulle du ersätta detta med en CNN för bilder eller en transformer för text. Arkitekturen spelar mindre roll än vad som kommer efter.
När du har två inbäddningar mäter du hur nära de är med cosinuslikhet. Att normalisera vektorerna först håller likhetsbetygen inom intervallet -1 till 1.
def cosine_similarity(z1, z2):
    z1 = F.normalize(z1, dim=-1)
    z2 = F.normalize(z2, dim=-1)
    return torch.matmul(z1, z2.T)
Resultatet är en matris där varje element [i, j] representerar likheten mellan inbäddning i och inbäddning j över batchen.
NT-Xent (Normalized Temperature-scaled Cross Entropy) är InfoNCE-baserad förlust. För varje ankare behandlar den dess parade vy som positiv och alla andra exempel i batchen som negativa.
def nt_xent_loss(z1, z2, temperature=0.5):
    batch_size = z1.shape[0]

    z = torch.cat([z1, z2], dim=0)
    z = F.normalize(z, dim=-1)
    sim_matrix = torch.matmul(z, z.T) / temperature

    mask = torch.eye(2 * batch_size, dtype=torch.bool)
    sim_matrix = sim_matrix.masked_fill(mask, float("-inf"))

    labels = torch.arange(batch_size)
    labels = torch.cat([labels + batch_size, labels])

    return F.cross_entropy(sim_matrix, labels)
Parametern temperature styr hur skarp fördelningen är. Lägre värden gör modellen mer självsäker på vilket par som är positivt; högre värden mjukar upp kontrasten.
encoder = Encoder(input_dim=64, embedding_dim=32)
optimizer = torch.optim.Adam(encoder.parameters(), lr=1e-3)

# Simulate a batch of positive pairs
x1 = torch.randn(32, 64)
x2 = torch.randn(32, 64)

# Training
optimizer.zero_grad()
z1, z2 = encoder(x1), encoder(x2)
loss = nt_xent_loss(z1, z2)
loss.backward()
optimizer.step()

print(f"Loss: {loss.item():.4f}")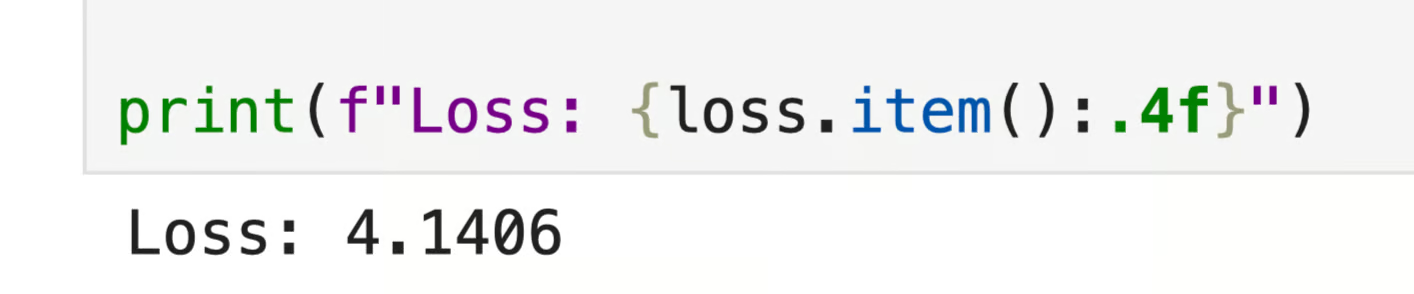
Utdata från kontrastiv loop
Detta är hela kontrastiva loopen i sin enklaste form. I en verklig implementation skulle x1 och x2 vara två augmenterade vyer av samma indata i stället för slumpmässigt brus – men strukturen förblir exakt densamma.
Kontrastiv inlärning är en enkel idé med stor räckvidd.
Den lär modeller att förstå struktur genom jämförelse i stället för att förlita sig på märkta data. För ihop liknande saker, dra isär olika saker – det är hela premissen. Det visar sig räcka för att lära representationer som överför väl mellan uppgifter.
Fältet rör sig bort från annoteringstunga pipelines, och kontrastiv inlärning är en stor anledning. Algoritmer som SimCLR, MoCo och CLIP har tagit sig in i riktiga produkter, vilket säger en del om hur väl tillvägagångssättet faktiskt fungerar.
Vill du gå djupare är ett bra nästa steg att sätta händerna i en riktig implementation. PyTorch-exemplet i den här artikeln är en startpunkt, men att köra SimCLR på ett faktiskt bilddataset – även ett litet – lär dig mer än någon förklaring kan.
Och om du behöver den ultimata resursen för avancerade maskininlärningsämnen, anmäl dig till vår Machine Learning Scientist in Python-track.
Lär dig med DataCamp
course
course
course