course
Înțelegerea Machine Learning-ului
2 oră
308.1K
Să faci un model să învețe fără date etichetate sună imposibil, dar asta e ideea din spatele învățării contrastive.
După cum știi, etichetarea datelor e lentă și costisitoare. Un singur set de date pentru clasificarea imaginilor necesită de obicei mii de ore de adnotare umană, și asta înainte să iei în calcul erorile și inconsistențele.
Învățarea contrastivă ocolește problema etichetării învățând modelele să compare. În loc să îi spui modelului ce este ceva, îi arăți ce lucruri sunt similare și ce lucruri sunt diferite - și îl lași să deducă restul.
În acest articol, îți explic intuiția din spatele învățării contrastive, cum funcționează în profunzime, unde este folosită în practică - de la recunoașterea imaginilor la embeddinguri NLP - și cum să o implementezi în PyTorch.
Ce este, mai exact, viziunea computerizată? Citește ghidul pentru începători despre analiza imaginilor.
Învățarea contrastivă este o abordare de antrenare în care un model învață prin comparație, nu prin clasificare.
În loc să îi spui modelului „asta e o pisică” sau „asta e un câine”, îi arăți perechi de exemple și îl lași să deducă ce aparține împreună și ce nu. Modelul învață stabilind dacă cele două lucruri sunt similare sau nu.
Cu alte cuvinte, alimentezi modelul cu două puncte de date odată. Dacă sunt înrudite - de exemplu, două poze ale aceluiași câine făcute din unghiuri diferite - aceea este o pereche pozitivă. Dacă sunt fără legătură - o poză cu un câine și una cu o mașină - aceea este o pereche negativă.
Sarcina modelului este să producă reprezentări (vectori numerici) care respectă această structură. Perechile pozitive ar trebui să ajungă apropiate în spațiul vectorial. Perechile negative ar trebui să fie depărtate.
Cel mai ușor mod de a înțelege învățarea contrastivă este prin imagini.
Ia o fotografie cu un câine. Creează acum două versiuni ale ei - una decupată, alta cu luminozitatea ajustată. Conținutul pe care îl vezi e același, dar pixelii diferă. Un model de învățare contrastivă vede aceste două versiuni ca o pereche pozitivă și învață să le mapeze în poziții similare în spațiul vectorial.
Dacă îi arăți modelului o fotografie cu o mașină alături de acea fotografie cu câinele, obții o pereche negativă. Modelul învață să îndepărteze reprezentările lor.
Nu trebuie să intervii manual și să specifici „asta e un câine” sau „asta e o mașină”. Modelul își construiește înțelegerea din structura de similaritate și diferență.
Asta face ca învățarea contrastivă să fie puternică.
Semnalul vine din comparație. Cu suficiente perechi, modelul poate dezvolta reprezentări care înțeleg ce face lucrurile asemănătoare și ce le deosebește.
Aceste reprezentări se dovedesc a fi cu adevărat utile. Un model antrenat astfel pe imagini poate fi ajustat pentru sarcini de clasificare, detecție sau regăsire cu foarte puține date etichetate, deoarece a învățat deja ceva semnificativ despre lumea vizuală.
Învățarea contrastivă apare în multe domenii - iată unde o vei întâlni cel mai des.
Aici și-a demonstrat pentru prima dată potențialul.
Modelele antrenate astfel pe imagini învață să producă reprezentări care înțeleg similaritatea vizuală fără a vedea vreodată o etichetă. Două fotografii ale aceleiași scene, făcute din unghiuri diferite sau sub iluminări diferite, ar trebui să se mapeze în puncte apropiate în spațiul vectorial. Două scene fără legătură ar trebui să fie departe una de alta.
Poți lua un model preantrenat contrastiv și să îl ajustezi pentru clasificare sau detecție de obiecte cu o fracțiune din datele etichetate de care altfel ai avea nevoie.
În NLP, învățarea contrastivă este folosită pentru a antrena embeddinguri de propoziție - reprezentări vectoriale care înțeleg sensul unei propoziții ca întreg.
Propozițiile cu sensuri similare ar trebui să fie apropiate în spațiul vectorial, iar propozițiile fără legătură ar trebui plasate departe. Modelele antrenate astfel pot realiza sarcini precum căutare semantică și similaritate între propoziții, fără cantități mari de perechi de propoziții etichetate.
Sistemele de recomandare folosesc învățarea contrastivă pentru a modela similaritatea utilizator-articol.
Un utilizator și un articol cu care a interacționat formează o pereche pozitivă. Un utilizator și un articol aleator pe care nu l-a văzut formează o pereche negativă. Dacă antrenezi pe suficiente astfel de exemple, modelul învață un spațiu comun în care utilizatorii și articolele relevante se grupează.
Aici învățarea contrastivă devine interesantă.
Modele precum CLIP o folosesc pentru a alinia textul și imaginile într-un spațiu vectorial comun. O fotografie cu un câine și propoziția „un câine care se joacă în parc” ar trebui să ajungă aproape una de alta. O fotografie cu un câine și propoziția „o mașină sport roșie” nu ar trebui. Asta permite modelelor multimodale să potrivească imagini cu descrieri text și să genereze subtitrări.
Învățarea contrastivă urmează mereu aceiași patru pași, indiferent dacă lucrezi cu imagini, text sau audio.
Fiecare exemplu de antrenare pornește ca o pereche. Eșantionezi două puncte de date și etichetezi relația ca similară (pozitivă) sau disimilară (negativă). În practică, perechile pozitive provin adesea din augmentarea aceluiași input în două moduri diferite, iar perechile negative din eșantionarea de exemple fără legătură.
Ambele puncte de date trec printr-un encoder care le convertește în vectori. Acești vectori, numiți embeddinguri, sunt reprezentări numerice într-un spațiu vectorial comun. Scopul este ca acel spațiu să reflecte semnificația semantică, nu valorile brute ale pixelilor sau tokenilor.
După ce ai două embeddinguri, măsori cât de apropiate sunt. Similaritatea cosinus este cea mai frecventă alegere aici. Îți dă un scor între -1 și 1, unde 1 înseamnă că vectorii indică în aceeași direcție, iar -1 că sunt complet opuși.
Modelul își compară scorurile de similaritate cu ceea ce ar trebui să fie. Pentru perechile pozitive, scorul ar trebui să fie mare. Pentru perechile negative, ar trebui să fie mic. O funcție de pierdere măsoară cât de departe este modelul și backpropagation ajustează greutățile encoderului pentru a performa mai bine data viitoare.
Dacă repeți acești pași pe suficiente perechi, encoderul va învăța să producă embeddinguri care grupează lucrurile similare și să îndepărteze lucrurile diferite.
Calitatea modelului tău contrastiv depinde de modul în care creezi perechile.
Perechile pozitive sunt două puncte de date care ar trebui considerate similare. În viziune computerizată, asta înseamnă de obicei două versiuni augmentate ale aceleiași imagini. În NLP, ar putea fi două parafraze ale aceleiași propoziții sau o propoziție și traducerea ei. Modelul învață că orice variază între ele nu contează. Singurul lucru care contează este ceea ce au în comun.
Perechile negative sunt două puncte de date care ar trebui considerate diferite. Majoritatea implementărilor eșantionează negative aleator din restul setului de date. Dacă antrenezi pe imagini, orice două imagini ale unor obiecte diferite formează o pereche negativă validă.
Aici devine complicat.
Nu toate negativele sunt la fel de utile. O negativă aleatoare care este în mod evident diferită de sursă - de exemplu, o fotografie cu un câine împerecheată cu o fotografie cu un avion - nu pune modelul la mare lucru. Acestea se numesc negative ușoare, iar antrenarea pe prea multe dintre ele încetinește învățarea.
Pe de altă parte, negativele dificile sunt puncte de date care seamănă cu sursa, dar aparțin unei alte clase - de exemplu, două rase de câini sau două propoziții cu formulări similare dar sensuri diferite. Modelul trebuie să dezvolte reprezentări mai fine pentru a le distinge, ceea ce produce embeddinguri mai bune per ansamblu.
Aceeași logică se aplică și la pozitive. Dacă augmentările sunt prea subtile, modelul nu învață mare lucru. Dacă sunt prea agresive, perechea nu mai este cu adevărat similară.
Funcția de pierdere transformă comparațiile dintre perechi în semnale de învățare.
Fiecare funcție de pierdere funcționează diferit, dar toate au același scop: să răsplătească modelul când lucrurile similare sunt apropiate în spațiul vectorial și să îl penalizeze când nu sunt.
Contrastive loss a fost introdusă odată cu primele lucrări de învățare contrastivă.
Funcționează pe perechi. Dată o pereche pozitivă, penalizează modelul dacă embeddingurile lor sunt departe. Dată o pereche negativă, penalizează modelul dacă embeddingurile sunt prea apropiate - în special, dacă se încadrează într-un prag (margină) definit. Negativele care sunt deja suficient de departe nu contribuie la pierdere.
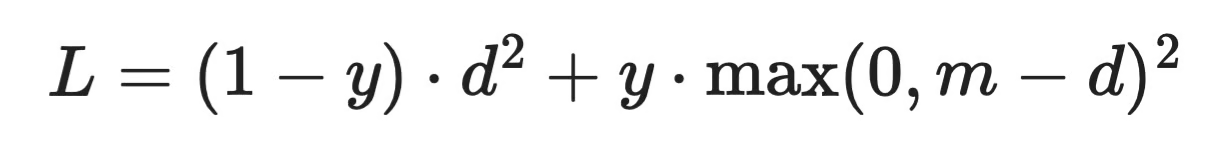
Formula contrastive loss
Unde d este distanța dintre două embeddinguri, y este 1 pentru perechi negative și 0 pentru perechi pozitive, iar m este marginea. Marginea este un hiperparametru setat manual, ceea ce face ca această pierdere să fie sensibilă la reglaj.
Triplet loss lucrează cu trei puncte de date simultan: un ancoră, un pozitiv și un negativ.
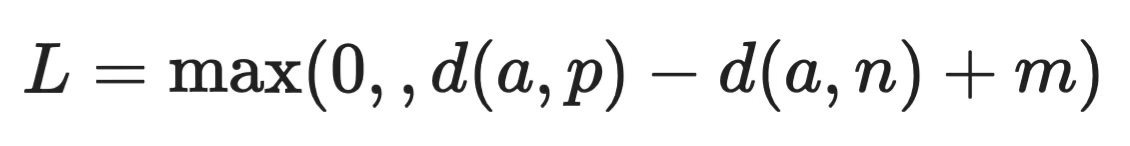
Formula triplet loss
Modelul este penalizat ori de câte ori distanța ancoră-pozitiv d(a, p) nu este mai mică decât distanța ancoră-negativ d(a, n) cu cel puțin marginea m. Dacă acea condiție este deja îndeplinită, pierderea este zero.
Această formulare oferă modelului mai mult context per actualizare decât contrastive loss, deoarece compară ambele relații simultan, nu pe rând.
InfoNCE este pierderea din spatele majorității metodelor moderne de învățare contrastivă, inclusiv SimCLR și CLIP.
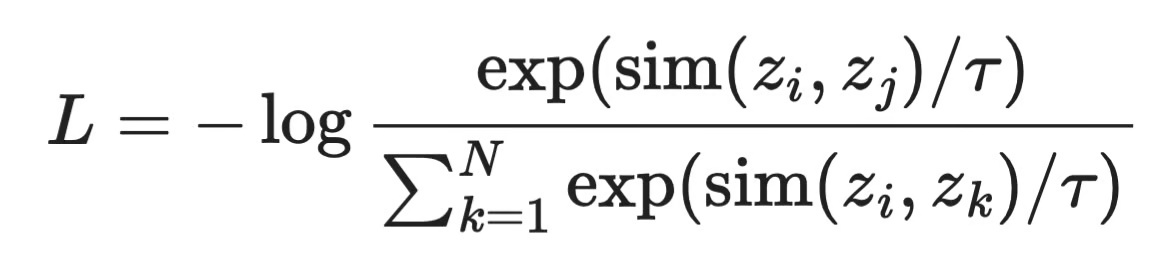
Formula InfoNCE loss
Pentru fiecare ancoră z_i, modelul trebuie să îi identifice pozitivul z_j din toate celelalte N exemple din batch. Parametrul de temperatură τ controlează cât de ascuțită este distribuția - valori mai mici fac modelul mai încrezător, valori mai mari estompează contrastul dintre perechi.
Primești mai multe negative per actualizare, ceea ce oferă modelului mai mult semnal de învățare. De asemenea, batch-urile mai mari expun modelul la negative mai dificile și, în general, produc reprezentări mai bune.
Învățarea contrastivă și auto-supervizarea funcționează bine împreună, iar înțelegând de ce, vei înțelege încotro se îndreaptă ML-ul modern.
Învățarea auto-supervizată este o abordare de antrenare în care modelul își generează singur etichetele din date, fără adnotare umană. În loc ca cineva să eticheteze mii de imagini ca „pisică” sau „câine”, datele în sine oferă semnalul de supervizare.
Învățarea contrastivă face exact asta. Când iei o imagine, creezi două versiuni augmentate ale ei și îi spui modelului că sunt o pereche pozitivă, tocmai ai creat o etichetă.
Acest lucru contează pentru că datele etichetate sunt blocajul în majoritatea fluxurilor ML. Colectarea este lentă, adnotarea e scumpă, iar unele domenii, precum imagistica medicală, nu au suficiente date etichetate.
Rezultatele de până acum sunt promițătoare. Modelele preantrenate cu obiective contrastive auto-supervizate pe seturi mari de date neetichetate au egalat sau s-au apropiat de bazele supervizate pe o serie de sarcini ulterioare, după ajustare fină pe doar o cantitate mică de date etichetate.
Tendința generală este de a ne îndepărta de antrenarea supervizată specifică sarcinii și de a merge către reprezentări cu scop general învățate din date brute la scară. Metode precum SimCLR, MoCo și BYOL urmează această tendință, iar despre ele voi vorbi în continuare.
Iată cele trei cadre cele mai influente din spatele învățării contrastive în 2026.
SimCLR, introdus de Google Research, este una dintre cele mai clare implementări ale ideii de învățare contrastivă.
Pentru fiecare imagine dintr-un batch, creează două vederi augmentate și le tratează ca pereche pozitivă. Orice altă imagine din batch devine negativă. Modelul, care este un CNN urmat de un mic cap de proiecție, învață să apropie perechile pozitive folosind pierderea InfoNCE.
Ce a diferențiat SimCLR a fost cât de mult contează mărimea batch-ului. Batch-urile mai mari înseamnă mai multe negative per actualizare, ceea ce se traduce în reprezentări mai bune. Compromisul este memoria. Deoarece SimCLR necesită batch-uri mari pentru a funcționa bine, ai nevoie de hardware bun pentru a-l valorifica la maximum.
MoCo (Momentum Contrast), de la Meta AI Research, a fost conceput pentru a rezolva exact această problemă.
În loc să se bazeze pe un batch mare pentru negative, MoCo menține o coadă - un buffer rulant de reprezentări codificate din batch-urile anterioare. Asta decuplează numărul de negative de dimensiunea batch-ului, astfel încât poți antrena cu mult mai puțină memorie și totuși expune modelul la un fond mare de negative.
Folosește, de asemenea, un encoder cu momentum, o copie actualizată lent a encoderului principal, pentru a menține reprezentările din coadă consistente în timp.
BYOL (Bootstrap Your Own Latent) merită menționat aici chiar dacă nu folosește deloc perechi negative.
În loc să împingă negativele deoparte, BYOL antrenează o rețea să prezică reprezentările alteia - o rețea țintă actualizată lent. Nu există negative și nici pierdere contrastivă. Funcționează surprinzător de bine, iar succesul său a contestat presupunerea că perechile negative sunt necesare pentru învățarea în stil contrastiv.
BYOL este undeva la granița învățării contrastive, dar e un pas bun mai departe după ce înțelegi cum funcționează metodele de bază.
Aceste două abordări rezolvă aceeași problemă, dar pornesc de la presupuneri diferite pe care e important să le înțelegi.
Învățarea supervizată necesită date etichetate. Fiecare exemplu de antrenare are nevoie de o etichetă atribuită de om, iar modelul învață mapând intrările la acele etichete. E o abordare directă și funcționează bine când ai suficiente exemple etichetate. Modelul știe ce este inputul și care este răspunsul corect.
Învățarea contrastivă își generează propria supervizare din structura datelor - similaritate și diferență - și învață reprezentări fără a vedea vreo etichetă.
Iată o reprezentare mai vizuală a modului în care se compară:
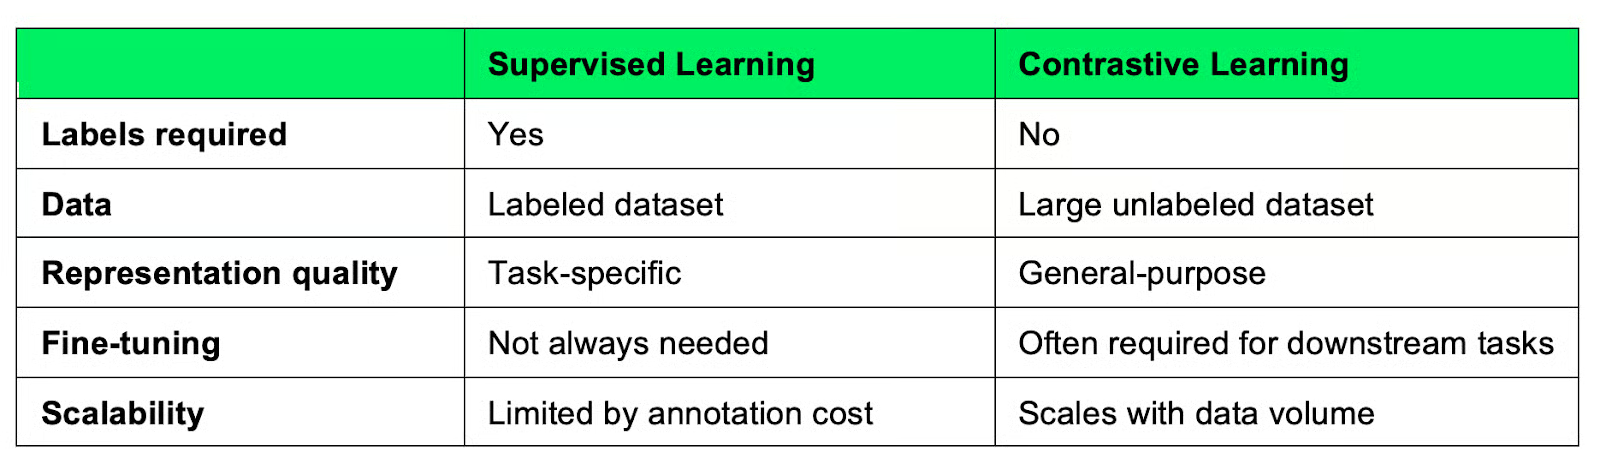
Învățarea contrastivă comparată cu învățarea supervizată
Cea mai mare diferență apare la scară. Învățarea supervizată depinde de date etichetate - iar a eticheta mai multe este costisitor. Învățarea contrastivă poate continua să se îmbunătățească pe măsură ce îi dai mai multe date neetichetate, care sunt de obicei din abundență.
Dar e important de notat că reprezentările pe care le învață un model contrastiv sunt generale, nu specifice unei sarcini, ceea ce înseamnă că de obicei vei avea nevoie de un pas de fine-tuning pentru a obține performanță bună pe o sarcină specifică. Modelele supervizate nu au nevoie de acel pas pentru că sunt antrenate direct pe obiectivul țintă.
Alegerea se reduce la situația datelor tale. Dacă ai date etichetate și o sarcină specifică, învățarea supervizată e adesea mai rapidă. Dacă lucrezi cu cantități mari de date neetichetate sau ai nevoie de reprezentări care se transferă între sarcini, învățarea contrastivă poate merita efortul suplimentar.
Hai să facem acum o implementare minimă în PyTorch. Exemplul de mai jos acoperă cele trei idei de bază discutate anterior: un model de embedding, similaritatea cosinus și pierderea NT-Xent - funcția de pierdere folosită în SimCLR, construită peste InfoNCE.
Encoderul este o rețea feedforward simplă care mapează vectorii de intrare într-un spațiu de embedding cu dimensiune mai mică.
import torch
import torch.nn as nn
import torch.nn.functional as F

class Encoder(nn.Module):
    def __init__(self, input_dim, embedding_dim):
        super().__init__()
        self.network = nn.Sequential(
            nn.Linear(input_dim, 128),
            nn.ReLU(),
            nn.Linear(128, embedding_dim)
        )

    def forward(self, x):
        return self.network(x)
În practică, ai înlocui asta cu un CNN pentru imagini sau un transformer pentru text. Arhitectura contează mai puțin decât ceea ce urmează după ea.
După ce ai două embeddinguri, măsori cât de apropiate sunt folosind similaritatea cosinus. Normalizarea vectorilor înainte menține scorurile de similaritate între -1 și 1.
def cosine_similarity(z1, z2):
    z1 = F.normalize(z1, dim=-1)
    z2 = F.normalize(z2, dim=-1)
    return torch.matmul(z1, z2.T)
Rezultatul este o matrice în care fiecare element [i, j] reprezintă similaritatea dintre embeddingul i și embeddingul j în cadrul batch-ului.
NT-Xent (Normalized Temperature-scaled Cross Entropy) este pierderea bazată pe InfoNCE. Pentru fiecare ancoră, tratează vederea asociată drept pozitivă și toate celelalte exemple din batch drept negative.
def nt_xent_loss(z1, z2, temperature=0.5):
    batch_size = z1.shape[0]

    z = torch.cat([z1, z2], dim=0)
    z = F.normalize(z, dim=-1)
    sim_matrix = torch.matmul(z, z.T) / temperature

    mask = torch.eye(2 * batch_size, dtype=torch.bool)
    sim_matrix = sim_matrix.masked_fill(mask, float("-inf"))

    labels = torch.arange(batch_size)
    labels = torch.cat([labels + batch_size, labels])

    return F.cross_entropy(sim_matrix, labels)
Parametrul temperature controlează cât de ascuțită este distribuția. Valorile mai mici fac modelul mai încrezător în privința perechii pozitive; valorile mai mari estompează contrastul.
encoder = Encoder(input_dim=64, embedding_dim=32)
optimizer = torch.optim.Adam(encoder.parameters(), lr=1e-3)

# Simulate a batch of positive pairs
x1 = torch.randn(32, 64)
x2 = torch.randn(32, 64)

# Training
optimizer.zero_grad()
z1, z2 = encoder(x1), encoder(x2)
loss = nt_xent_loss(z1, z2)
loss.backward()
optimizer.step()

print(f"Loss: {loss.item():.4f}")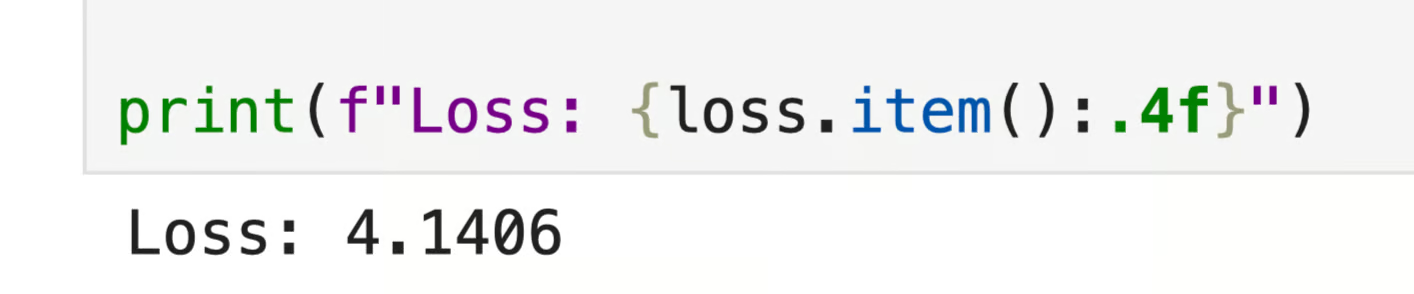
Rezultatul buclei contrastive
Aceasta este bucla contrastivă completă în cea mai simplă formă a ei. Într-o implementare reală, x1 și x2 ar fi două vederi augmentate ale aceleiași intrări, nu zgomot aleator - dar structura rămâne exact aceeași.
Învățarea contrastivă este o idee simplă cu acoperire mare.
Îi învață pe modele să înțeleagă structura prin comparație, în loc să se bazeze pe date etichetate. Adu lucrurile similare împreună, îndepărtează lucrurile diferite - acesta e întregul principiu. Se dovedește că este suficient pentru a învăța reprezentări care se transferă bine între sarcini.
Domeniul se îndepărtează de fluxurile pline de adnotări, iar învățarea contrastivă este un motiv important. Algoritmi precum SimCLR, MoCo și CLIP au ajuns în produse reale, ceea ce spune ceva despre cât de bine funcționează abordarea în practică.
Dacă vrei să aprofundezi, un pas bun este să pui mâna pe o implementare reală. Exemplul PyTorch din acest articol este un punct de plecare, dar rularea SimCLR pe un set de imagini real - chiar și unul mic - te va învăța mai mult decât orice explicație.
Iar dacă ai nevoie de resursa supremă pentru subiecte avansate de învățare automată, înscrie-te la traseul nostru Machine Learning Scientist in Python.
Învață cu DataCamp
course
course
course