Kursus
Memahami Machine Learning
2 Hr
308K
Membuat model belajar tanpa data berlabel terdengar mustahil, namun itulah gagasan di balik contrastive learning.
Seperti yang Anda tahu, memberi label data itu lambat dan mahal. Satu dataset klasifikasi gambar biasanya memerlukan ribuan jam anotasi manusia, dan itu belum termasuk kesalahan serta inkonsistensi.
Contrastive learning mengatasi masalah pelabelan ini dengan mengajari model untuk membandingkan. Jadi, alih-alih memberi tahu model apa suatu benda, Anda menunjukkan mana yang mirip dan mana yang berbeda — lalu biarkan model menyimpulkan sisanya.
Dalam artikel ini, saya akan mengulas intuisi di balik contrastive learning, cara kerjanya di balik layar, di mana ia digunakan dalam praktik — dari pengenalan gambar hingga embedding NLP — dan cara mengimplementasikannya di PyTorch.
Apa sebenarnya computer vision itu? Baca panduan pemula untuk analisis gambar kami.
Contrastive learning adalah pendekatan pelatihan di mana model belajar melalui perbandingan, bukan klasifikasi.
Alih-alih memberi tahu model "ini kucing" atau "ini anjing", Anda menunjukkan pasangan contoh dan membiarkannya mencari tahu mana yang seharusnya berpasangan dan mana yang tidak. Model belajar dengan menilai apakah dua hal tersebut mirip atau tidak.
Dengan kata lain — Anda memasukkan dua titik data sekaligus. Jika keduanya berhubungan — misalnya dua foto anjing yang sama dari sudut berbeda — itu adalah pasangan positif. Jika tidak berhubungan — foto anjing dan foto mobil — itu adalah pasangan negatif.
Tugas model adalah menghasilkan representasi (vektor numerik) yang mengikuti struktur ini. Pasangan positif harus berakhir berdekatan dalam ruang vektor. Pasangan negatif harus berakhir berjauhan.
Cara termudah memahami contrastive learning adalah melalui gambar.
Ambil sebuah foto anjing. Buat dua versinya — satu dipotong (cropped), satu dengan kecerahan disesuaikan. Kontennya sama, tetapi pikselnya berbeda. Model contrastive learning melihat kedua versi ini sebagai pasangan positif dan belajar memetakannya ke posisi yang serupa dalam ruang vektor.
Jika Anda menunjukkan foto mobil berdampingan dengan foto anjing itu, Anda akan mendapatkan pasangan negatif. Model belajar untuk menjauhkan representasinya.
Anda tidak perlu campur tangan secara manual dan menentukan "ini anjing" atau "ini mobil." Model membangun pemahamannya dari struktur kemiripan dan perbedaan.
Inilah yang membuat contrastive learning kuat.
Sinyal datang dari perbandingan. Dengan cukup banyak pasangan, model dapat mengembangkan representasi yang memahami apa yang membuat sesuatu mirip dan apa yang membedakannya.
Representasi tersebut terbukti benar-benar berguna. Model yang dilatih dengan cara ini pada gambar dapat disesuaikan (fine-tune) untuk tugas klasifikasi, deteksi, atau pencarian dengan sangat sedikit data berlabel, karena model sudah mempelajari sesuatu yang bermakna tentang dunia visual.
Contrastive learning muncul di banyak domain — berikut area yang paling sering Anda temui.
Di sinilah contrastive learning pertama kali membuktikan kemampuannya.
Model yang dilatih dengan cara ini pada gambar belajar menghasilkan representasi yang memahami kemiripan visual tanpa pernah melihat label. Dua foto dari pemandangan yang sama, diambil dari sudut atau pencahayaan berbeda, harus dipetakan ke titik-titik yang berdekatan dalam ruang vektor. Dua pemandangan yang tidak berhubungan harus dipetakan berjauhan.
Anda dapat mengambil model yang telah di-pre-train secara kontras dan melakukan fine-tune untuk klasifikasi atau deteksi objek dengan sebagian kecil dari data berlabel yang biasanya diperlukan.
Dalam NLP, contrastive learning digunakan untuk melatih embedding kalimat — representasi vektor yang memahami makna kalimat secara keseluruhan.
Kalimat dengan makna serupa harus berdekatan dalam ruang vektor, dan kalimat yang tidak berhubungan harus ditempatkan berjauhan. Model yang dilatih dengan cara ini dapat melakukan tugas seperti pencarian semantik dan kesamaan kalimat, tanpa memerlukan pasangan kalimat berlabel dalam jumlah besar.
Sistem rekomendasi menggunakan contrastive learning untuk memodelkan kemiripan pengguna-item.
Seorang pengguna dan item yang telah ia interaksikan membentuk pasangan positif. Seorang pengguna dan item acak yang belum pernah ia lihat membentuk pasangan negatif. Jika Anda melatih pada cukup banyak pasangan seperti ini, model akan mempelajari ruang bersama di mana pengguna dan item yang relevan berkumpul.
Di sinilah contrastive learning menjadi menarik.
Model seperti CLIP menggunakannya untuk menyelaraskan teks dan gambar dalam ruang vektor bersama. Foto seekor anjing dan kalimat "a dog playing in the park" seharusnya berakhir berdekatan. Foto anjing dan kalimat "a red sports car" seharusnya tidak. Ini memungkinkan model multimodal mencocokkan gambar dengan deskripsi teks dan menghasilkan caption.
Contrastive learning selalu mengikuti empat langkah yang sama, terlepas dari apakah Anda bekerja dengan gambar, teks, atau audio.
Setiap contoh pelatihan dimulai sebagai pasangan. Anda mengambil dua titik data dan memberi label hubungan sebagai mirip (positif) atau tidak mirip (negatif). Dalam praktiknya, pasangan positif sering kali berasal dari augmentasi input yang sama dengan dua cara berbeda, dan pasangan negatif berasal dari pengambilan contoh yang tidak berhubungan.
Kedua titik data melewati sebuah encoder yang mengubahnya menjadi vektor. Vektor-vektor ini, disebut embedding, adalah representasi numerik yang berada dalam ruang vektor bersama. Tujuannya adalah agar ruang tersebut mencerminkan makna semantik, bukan nilai piksel atau token mentah.
Setelah Anda memiliki dua embedding, Anda mengukur seberapa dekat keduanya. Cosine similarity adalah pilihan paling umum di sini. Ia memberikan skor antara -1 dan 1, di mana 1 berarti vektor mengarah ke arah yang sama dan -1 berarti benar-benar berlawanan.
Model membandingkan skor kemiripannya dengan skor yang seharusnya. Untuk pasangan positif, skor harus tinggi. Untuk pasangan negatif, skor harus rendah. Fungsi loss mengukur seberapa meleset model, dan backpropagation menyesuaikan bobot encoder agar lebih baik di iterasi berikutnya.
Jika Anda mengulangi langkah-langkah ini pada cukup banyak pasangan, encoder akan belajar menghasilkan embedding yang mengelompokkan hal-hal serupa menjadi dekat dan mendorong hal-hal berbeda menjauh.
Kualitas model kontras Anda bergantung pada bagaimana Anda membuat pasangan.
Pasangan positif adalah dua titik data yang harus dianggap mirip. Dalam computer vision, itu biasanya berarti dua versi augmented dari gambar yang sama. Dalam NLP, bisa berupa dua parafrasa dari kalimat yang sama, atau kalimat dan terjemahannya. Model belajar bahwa apa pun yang berbeda di antara keduanya tidak penting. Yang penting hanya apa yang sama.
Pasangan negatif adalah dua titik data yang harus dianggap berbeda. Sebagian besar implementasi mengambil negatif secara acak dari sisa dataset. Jika Anda melatih pada gambar, dua gambar dari objek berbeda merupakan pasangan negatif yang valid.
Di sinilah letak tantangannya.
Tidak semua negatif sama bermanfaatnya. Negatif acak yang jelas berbeda dari sumber — misalnya, foto anjing dipasangkan dengan foto pesawat — tidak membuat model bekerja keras. Ini disebut negatif mudah, dan terlalu banyak melatih pada jenis ini memperlambat pembelajaran.
Di sisi lain, negatif sulit adalah titik data yang tampak mirip dengan sumber tetapi berasal dari kelas berbeda — misalnya dua ras anjing, atau dua kalimat dengan susunan kata serupa tetapi makna berbeda. Model harus mengembangkan representasi yang lebih halus untuk membedakannya, yang menghasilkan embedding yang lebih baik secara keseluruhan.
Logika yang sama berlaku untuk pasangan positif. Jika augmentasi Anda terlalu halus, model tidak banyak belajar. Jika terlalu agresif, pasangan itu tidak lagi benar-benar mirip.
Fungsi loss mengubah perbandingan pasangan menjadi sinyal pembelajaran.
Setiap fungsi loss bekerja secara berbeda, tetapi semuanya memiliki tujuan yang sama: memberi penghargaan pada model saat hal-hal yang mirip berada dekat dalam ruang vektor, dan memberi penalti saat tidak demikian.
Contrastive loss diperkenalkan bersamaan dengan karya awal contrastive learning.
Ia beroperasi pada pasangan. Diberikan pasangan positif, ia memberi penalti pada model jika embedding keduanya berjauhan. Diberikan pasangan negatif, ia memberi penalti jika embedding keduanya terlalu dekat — khususnya, jika berada dalam margin yang ditentukan. Negatif yang sudah cukup jauh tidak berkontribusi pada loss.
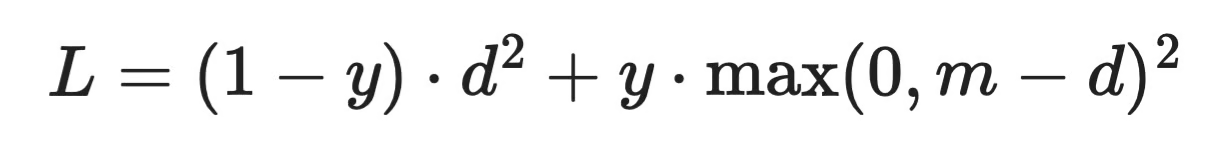
Rumus contrastive loss
Di mana d adalah jarak antara dua embedding, y bernilai 1 untuk pasangan negatif dan 0 untuk pasangan positif, dan m adalah margin. Margin adalah hiperparameter yang Anda tetapkan secara manual, sehingga loss ini sensitif terhadap penyetelan.
Triplet loss bekerja dengan tiga titik data sekaligus: anchor, positif, dan negatif.
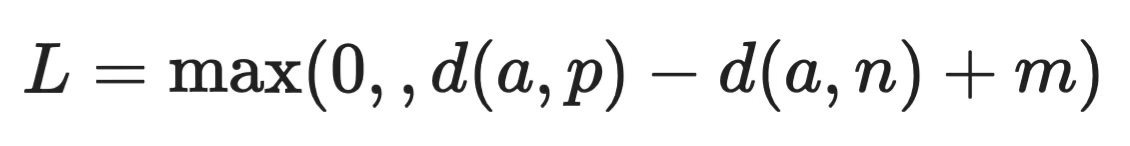
Rumus triplet loss
Model diberi penalti setiap kali jarak anchor-ke-positif d(a, p) tidak lebih kecil daripada jarak anchor-ke-negatif d(a, n) setidaknya sebesar margin m. Jika kondisi tersebut sudah terpenuhi, loss bernilai nol.
Formulasi ini memberi lebih banyak konteks per pembaruan dibanding contrastive loss, karena membandingkan kedua hubungan sekaligus, bukan satu per satu.
InfoNCE adalah loss di balik sebagian besar metode contrastive learning modern, termasuk SimCLR dan CLIP.
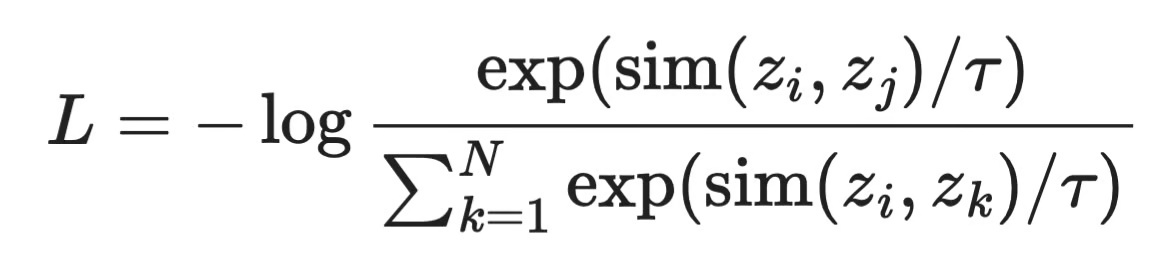
Rumus InfoNCE loss
Untuk setiap anchor z_i, model harus mengidentifikasi positifnya z_j dari semua contoh N lain dalam batch. Parameter temperatur τ mengontrol seberapa tajam distribusi — nilai lebih rendah membuat model lebih yakin, nilai lebih tinggi melunakkan kontras antar pasangan.
Anda mendapatkan lebih banyak negatif per pembaruan, yang memberi model lebih banyak sinyal pembelajaran. Ini juga berarti batch yang lebih besar mengekspos model pada negatif yang lebih sulit dan umumnya menghasilkan representasi yang lebih baik.
Contrastive learning dan self-supervised learning bekerja baik bersama, dan dengan memahami alasannya, Anda akan memahami ke mana ML modern menuju.
Self-supervised learning adalah pendekatan pelatihan di mana model menghasilkan labelnya sendiri dari data, tanpa anotasi manusia. Jadi alih-alih seseorang memberi label ribuan gambar sebagai "kucing" atau "anjing", data itu sendiri menyediakan sinyal supervisi.
Contrastive learning melakukan tepat hal itu. Saat Anda mengambil sebuah gambar, membuat dua versi augmented, dan memberi tahu model bahwa keduanya adalah pasangan positif, Anda baru saja membuat sebuah label.
Ini penting karena data berlabel adalah hambatan dalam sebagian besar pipeline ML. Mengumpulkannya lambat, anotasi mahal, dan beberapa domain, seperti pencitraan medis, tidak memiliki cukup banyak data berlabel.
Hasil sejauh ini menjanjikan. Model yang di-pre-train dengan objektif contrastive self-supervised pada dataset besar tak berlabel telah menyamai atau mendekati baseline supervised di berbagai tugas hilir, setelah fine-tuning dengan hanya sedikit data berlabel.
Tren umum adalah beralih dari pelatihan supervised spesifik tugas menuju representasi serbaguna yang dipelajari dari data mentah dalam skala besar. Metode seperti SimCLR, MoCo, dan BYOL mengikuti tren ini, dan akan saya bahas selanjutnya.
Berikut tiga kerangka kerja paling berpengaruh di balik contrastive learning pada 2026.
SimCLR, diperkenalkan oleh Google Research, adalah salah satu implementasi paling jelas dari gagasan contrastive learning.
Untuk setiap gambar dalam batch, metode ini membuat dua tampilan augmented dan memperlakukannya sebagai pasangan positif. Setiap gambar lain dalam batch menjadi negatif. Model, yang berupa CNN diikuti sebuah kepala proyeksi kecil, belajar memetakan pasangan positif agar berdekatan menggunakan InfoNCE loss.
Yang membuat SimCLR menonjol adalah betapa pentingnya ukuran batch. Batch yang lebih besar berarti lebih banyak negatif per pembaruan, yang berujung pada representasi yang lebih baik. Konsekuensinya adalah memori. Karena SimCLR memerlukan batch besar agar bekerja optimal, Anda membutuhkan perangkat keras yang baik untuk memaksimalkannya.
MoCo (Momentum Contrast), dari Meta AI Research, dirancang untuk memecahkan masalah tersebut.
Alih-alih bergantung pada batch besar untuk negatif, MoCo mempertahankan sebuah antrean — buffer berjalan dari representasi terenkode dari batch sebelumnya. Ini memisahkan jumlah negatif dari ukuran batch, sehingga Anda dapat melatih dengan jauh lebih sedikit memori sekaligus tetap mengekspos model pada kumpulan negatif yang besar.
Ia juga menggunakan momentum encoder, yakni salinan encoder utama yang diperbarui secara perlahan, untuk menjaga konsistensi representasi dalam antrean seiring waktu.
BYOL (Bootstrap Your Own Latent) patut disebut meski tidak menggunakan pasangan negatif sama sekali.
Alih-alih mendorong negatif agar menjauh, BYOL melatih satu jaringan untuk memprediksi representasi jaringan lain — sebuah target network yang diperbarui perlahan. Tidak ada negatif dan tidak ada contrastive loss. Hasilnya mengejutkan, dan keberhasilannya menantang anggapan bahwa pasangan negatif diperlukan untuk pembelajaran bergaya kontras.
BYOL berada di batas contrastive learning, tetapi merupakan langkah lanjutan yang baik setelah Anda memahami cara kerja metode inti.
Kedua pendekatan ini menyelesaikan masalah yang sama, tetapi dimulai dari asumsi berbeda yang perlu Anda pahami.
Supervised learning memerlukan data berlabel. Setiap contoh pelatihan memerlukan label yang ditetapkan manusia, dan model belajar dengan memetakan input ke label tersebut. Ini pendekatan langsung, dan bekerja baik saat Anda memiliki cukup contoh berlabel. Model mengetahui apa inputnya dan apa jawaban yang benar.
Contrastive learning menghasilkan supervisinya sendiri dari struktur data — kemiripan dan perbedaan — dan mempelajari representasi tanpa pernah melihat label.
Berikut representasi yang lebih visual tentang bagaimana keduanya dibandingkan:
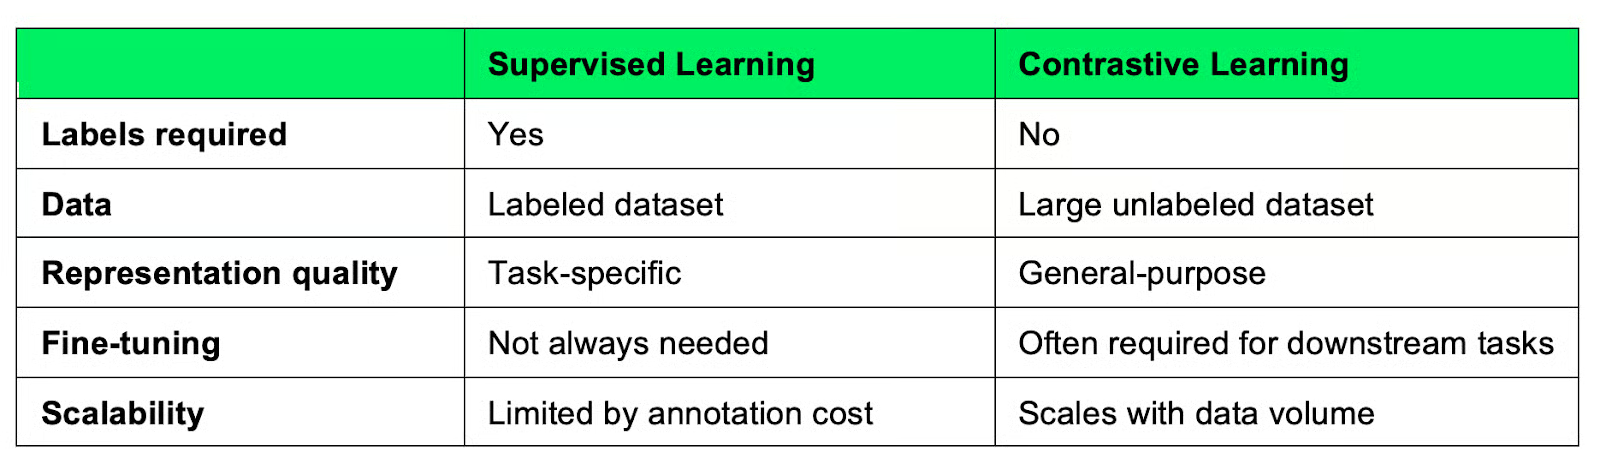
Contrastive learning dibandingkan dengan supervised learning
Sebagian besar perbedaannya tampak pada skala. Supervised learning bergantung pada data berlabel — dan menambah label itu mahal. Contrastive learning dapat terus membaik seiring Anda memasukkan lebih banyak data tak berlabel, yang biasanya melimpah.
Namun penting dicatat bahwa representasi yang dipelajari model contrastive bersifat umum, bukan spesifik tugas, yang berarti Anda biasanya memerlukan langkah fine-tuning untuk mendapatkan performa baik pada tugas tertentu. Model supervised tidak memerlukan langkah itu karena dilatih pada objektif target.
Pilihan bergantung pada situasi data Anda. Jika Anda memiliki data berlabel dan tugas spesifik, supervised learning sering kali lebih cepat. Jika Anda bekerja dengan banyak data tak berlabel atau membutuhkan representasi yang dapat ditransfer lintas tugas, contrastive learning bisa sepadan dengan upaya penyiapannya.
Sekarang mari buat implementasi PyTorch minimal. Contoh di bawah ini mencakup tiga gagasan inti yang dibahas sebelumnya: model embedding, cosine similarity, dan NT-Xent loss — fungsi loss yang digunakan di SimCLR, dibangun di atas InfoNCE.
Encoder adalah jaringan feedforward sederhana yang memetakan vektor input ke ruang embedding berdimensi lebih rendah.
import torch
import torch.nn as nn
import torch.nn.functional as F

class Encoder(nn.Module):
    def __init__(self, input_dim, embedding_dim):
        super().__init__()
        self.network = nn.Sequential(
            nn.Linear(input_dim, 128),
            nn.ReLU(),
            nn.Linear(128, embedding_dim)
        )

    def forward(self, x):
        return self.network(x)
Dalam praktiknya, Anda akan menggantinya dengan CNN untuk gambar atau transformer untuk teks. Arsitektur kurang penting dibanding apa yang datang setelahnya.
Setelah Anda memiliki dua embedding, Anda mengukur seberapa dekat keduanya menggunakan cosine similarity. Menormalkan vektor terlebih dahulu menjaga skor kemiripan tetap berada di antara -1 dan 1.
def cosine_similarity(z1, z2):
    z1 = F.normalize(z1, dim=-1)
    z2 = F.normalize(z2, dim=-1)
    return torch.matmul(z1, z2.T)
Hasilnya adalah matriks di mana setiap entri [i, j] merepresentasikan kemiripan antara embedding i dan embedding j di seluruh batch.
NT-Xent (Normalized Temperature-scaled Cross Entropy) adalah loss berbasis InfoNCE. Untuk setiap anchor, ia memperlakukan tampilan pasangannya sebagai positif dan semua contoh lain dalam batch sebagai negatif.
def nt_xent_loss(z1, z2, temperature=0.5):
    batch_size = z1.shape[0]

    z = torch.cat([z1, z2], dim=0)
    z = F.normalize(z, dim=-1)
    sim_matrix = torch.matmul(z, z.T) / temperature

    mask = torch.eye(2 * batch_size, dtype=torch.bool)
    sim_matrix = sim_matrix.masked_fill(mask, float("-inf"))

    labels = torch.arange(batch_size)
    labels = torch.cat([labels + batch_size, labels])

    return F.cross_entropy(sim_matrix, labels)
Parameter temperature mengontrol seberapa tajam distribusi. Nilai lebih rendah membuat model lebih yakin tentang pasangan mana yang positif; nilai lebih tinggi melunakkan kontras.
encoder = Encoder(input_dim=64, embedding_dim=32)
optimizer = torch.optim.Adam(encoder.parameters(), lr=1e-3)

# Simulate a batch of positive pairs
x1 = torch.randn(32, 64)
x2 = torch.randn(32, 64)

# Training
optimizer.zero_grad()
z1, z2 = encoder(x1), encoder(x2)
loss = nt_xent_loss(z1, z2)
loss.backward()
optimizer.step()

print(f"Loss: {loss.item():.4f}")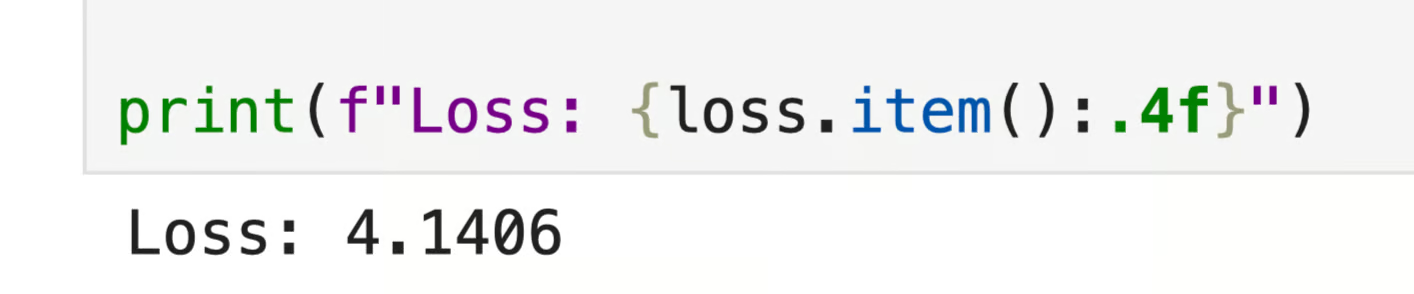
Keluaran loop kontras
Ini adalah loop kontras penuh dalam bentuk paling sederhana. Dalam implementasi nyata, x1 dan x2 akan berupa dua tampilan augmented dari input yang sama, bukan noise acak — tetapi strukturnya persis sama.
Contrastive learning adalah gagasan sederhana dengan jangkauan luas.
Ia mengajari model memahami struktur melalui perbandingan, bukan bergantung pada data berlabel. Dorong hal-hal yang mirip agar mendekat, tarik hal-hal yang berbeda agar menjauh — itulah premisnya. Ternyata, itu cukup untuk mempelajari representasi yang dapat ditransfer dengan baik lintas tugas.
Bidang ini bergerak menjauhi pipeline yang berat anotasi, dan contrastive learning adalah salah satu alasannya. Algoritma seperti SimCLR, MoCo, dan CLIP telah digunakan dalam produk nyata, yang menunjukkan seberapa baik pendekatan ini bekerja.
Jika Anda ingin menggali lebih dalam, langkah selanjutnya yang baik adalah mencoba implementasi nyata. Contoh PyTorch dalam artikel ini adalah titik awal, tetapi menjalankan SimCLR pada dataset gambar yang sesungguhnya — bahkan yang kecil — akan mengajarkan lebih banyak daripada penjelasan mana pun.
Dan jika Anda membutuhkan sumber daya utama untuk topik machine learning lanjutan, daftarlah ke jalur Machine Learning Scientist in Python kami.
Belajar dengan DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt