Cursus
Inzicht in Machine Learning
2 Hr
308K
Een model laten leren zonder gelabelde data klinkt onmogelijk, maar dat is precies het idee achter contrastive learning.
Zoals je weet is data labelen traag en duur. Een enkele dataset voor beeldclassificatie kost meestal duizenden uren aan menselijke annotatie, en dan heb je fouten en inconsistenties nog niet eens meegerekend.
Contrastive learning omzeilt dit labelprobleem door modellen te leren vergelijken. In plaats van een model te vertellen wat iets is, laat je zien wat op elkaar lijkt en wat verschilt - en laat je het de rest zelf uitzoeken.
In dit artikel neem ik je mee door de intuïtie achter contrastive learning, hoe het onder de motorkap werkt, waar het in de praktijk wordt gebruikt - van beeldherkenning tot NLP-embeddings - en hoe je het in PyTorch implementeert.
Wat is computer vision precies? Lees onze beginnersgids voor beeldanalyse.
Contrastive learning is een trainingsaanpak waarbij een model leert door vergelijking in plaats van classificatie.
In plaats van het model te vertellen "dit is een kat" of "dit is een hond", laat je het paren van voorbeelden zien en laat je het uitzoeken wat bij elkaar hoort en wat niet. Het model leert door te bepalen of twee dingen op elkaar lijken of niet.
Met andere woorden: je voert het model twee datapunten tegelijk. Als ze verwant zijn - bijvoorbeeld twee foto’s van dezelfde hond vanuit verschillende hoeken - is dat een positief paar. Als ze niet verwant zijn - een foto van een hond en een foto van een auto - is dat een negatief paar.
De taak van het model is om representaties (numerieke vectoren) te produceren die deze structuur volgen. Positieve paren moeten dicht bij elkaar eindigen in de vectorruimte. Negatieve paren juist ver uit elkaar.
De makkelijkste manier om contrastive learning te begrijpen is via beelden.
Neem een foto van een hond. Maak er nu twee versies van - één uitgesneden, één met aangepaste helderheid. De inhoud die je ziet is hetzelfde, maar de pixels verschillen. Een contrastive-learningmodel ziet deze twee versies als een positief paar en leert ze op vergelijkbare posities in de vectorruimte te plaatsen.
Als je het model een foto van een auto naast die hondenfoto laat zien, krijg je een negatief paar. Het model leert hun representaties uit elkaar te duwen.
Je hoeft niet handmatig in te grijpen en te specificeren "dit is een hond" of "dit is een auto". Het model bouwt zijn begrip op uit de structuur van gelijkenis en verschil.
Dit is wat contrastive learning krachtig maakt.
Het signaal komt uit vergelijking. Met genoeg paren kan het model representaties ontwikkelen die begrijpen wat dingen op elkaar doet lijken en wat ze onderscheidt.
Die representaties blijken echt nuttig. Een model dat zo op beelden is getraind, kan met heel weinig gelabelde data worden fijn-afgesteld voor classificatie-, detectie- of retrievaltaken, omdat het al iets betekenisvols over de visuele wereld heeft geleerd.
Contrastive learning duikt in veel domeinen op - hier zie je het het vaakst.
Hier bewees contrastive learning voor het eerst wat het kan.
Modellen die op deze manier op beelden zijn getraind, leren representaties produceren die visuele gelijkenis begrijpen zonder ooit een label te zien. Twee foto’s van dezelfde scène, genomen vanuit verschillende hoeken of onder verschillende belichting, moeten op nabijgelegen punten in de vectorruimte terechtkomen. Twee niet-gerelateerde scènes juist ver uit elkaar.
Je kunt een contrastief voorgetraind model nemen en het fijn-afstellen voor classificatie of objectdetectie met een fractie van de gelabelde data die je anders nodig zou hebben.
In NLP wordt contrastive learning gebruikt om zinsembeddings te trainen - vectorrepresentaties die de betekenis van een zin als geheel begrijpen.
Zinnen met vergelijkbare betekenissen moeten dicht bij elkaar liggen in de vectorruimte, en niet-gerelateerde zinnen verder uit elkaar. Modellen die zo zijn getraind, kunnen taken uitvoeren zoals semantisch zoeken en zinsgelijkenis, zonder grote hoeveelheden gelabelde zinsparen.
Aanbevelingssystemen gebruiken contrastive learning om gebruikers-itemgelijkenis te modelleren.
Een gebruiker en een item waarmee hij of zij interactie had, vormen een positief paar. Een gebruiker en een willekeurig item dat hij of zij nooit heeft gezien, vormen een negatief paar. Als je op genoeg van deze paren traint, leert het model een gedeelde ruimte waarin relevante gebruikers en items bij elkaar clusteren.
Hier wordt contrastive learning echt interessant.
Modellen zoals CLIP gebruiken het om tekst en afbeeldingen in één gedeelde vectorruimte uit te lijnen. Een foto van een hond en de zin "a dog playing in the park" moeten dicht bij elkaar eindigen. Een foto van een hond en de zin "a red sports car" juist niet. Dit stelt multimodale modellen in staat om afbeeldingen te matchen met tekstbeschrijvingen en bijschriften te genereren.
Contrastive learning volgt altijd dezelfde vier stappen, ongeacht of je met beelden, tekst of audio werkt.
Elk trainingsvoorbeeld begint als een paar. Je neemt twee datapunten en labelt de relatie als vergelijkbaar (positief) of ongelijk (negatief). In de praktijk komen positieve paren vaak voort uit het op twee verschillende manieren augmenteren van dezelfde input, en negatieve paren uit het sampelen van niet-gerelateerde voorbeelden.
Beide datapunten gaan door een encoder die ze omzet in vectoren. Deze vectoren, embeddings genoemd, zijn numerieke representaties die leven in een gedeelde vectorruimte. Het doel is dat die ruimte semantische betekenis weerspiegelt, en niet ruwe pixel- of tokenwaarden.
Zodra je twee embeddings hebt, meet je hoe dicht ze bij elkaar liggen. Cosinusgelijkenis is hier de meest gebruikte keuze. Die geeft een score tussen -1 en 1, waarbij 1 betekent dat de vectoren in dezelfde richting wijzen en -1 dat ze compleet tegengesteld zijn.
Het model vergelijkt zijn gelijkenisscores met wat ze zouden moeten zijn. Voor positieve paren moet de score hoog zijn. Voor negatieve paren laag. Een verliesfunctie meet hoe ver het model ernaast zit, en backpropagation past de encodergewichten aan om het de volgende keer beter te doen.
Als je deze stappen genoeg keer herhaalt over veel paren, leert de encoder embeddings te produceren die vergelijkbare dingen bij elkaar clusteren en verschillende dingen uit elkaar duwen.
De kwaliteit van je contrastieve model hangt af van hoe je je paren maakt.
Positieve paren zijn twee datapunten die als vergelijkbaar moeten worden beschouwd. In computer vision betekent dat meestal twee geaugmenteerde versies van dezelfde afbeelding. In NLP kan het gaan om twee parafrases van dezelfde zin, of een zin en de vertaling daarvan. Het model leert dat wat er tussen hen varieert er niet toe doet. Alleen het gedeelde telt.
Negatieve paren zijn twee datapunten die als verschillend moeten worden beschouwd. De meeste implementaties sampelen negatieven willekeurig uit de rest van de dataset. Als je op beelden traint, vormen twee afbeeldingen van verschillende objecten een geldig negatief paar.
Hier wordt het lastig.
Niet alle negatieven zijn even nuttig. Een willekeurig negatief dat overduidelijk verschilt van de bron - bijvoorbeeld een foto van een hond gepaard met een foto van een vliegtuig - laat het model niet hard werken. Dit noemen we gemakkelijke negatieven, en te veel daarop trainen vertraagt het leerproces.
Aan de andere kant zijn moeilijke negatieven datapunten die op de bron lijken maar tot een andere klasse behoren - twee hondenrassen bijvoorbeeld, of twee zinnen met vergelijkbare bewoording maar een andere betekenis. Het model moet fijnmazigere representaties ontwikkelen om ze te onderscheiden, wat al met al betere embeddings oplevert.
Dezelfde logica geldt voor positieven. Als je augmentaties te subtiel zijn, leert het model weinig. Als ze te agressief zijn, is het paar niet langer betekenisvol vergelijkbaar.
De verliesfunctie zet vergelijkingen van paren om in leersignalen.
Elke verliesfunctie werkt anders, maar ze delen hetzelfde doel: het model belonen wanneer vergelijkbare dingen dicht bij elkaar liggen in de vectorruimte, en het bestraffen wanneer dat niet zo is.
Contrastive loss werd geïntroduceerd naast het vroege werk aan contrastive learning.
Deze werkt op paren. Gegeven een positief paar, bestraft hij het model als hun embeddings ver uit elkaar liggen. Gegeven een negatief paar, bestraft hij het model als hun embeddings te dicht bij elkaar liggen - specifiek, als ze binnen een gedefinieerde marge vallen. Negatieven die al ver genoeg uit elkaar liggen, dragen niet bij aan het verlies.
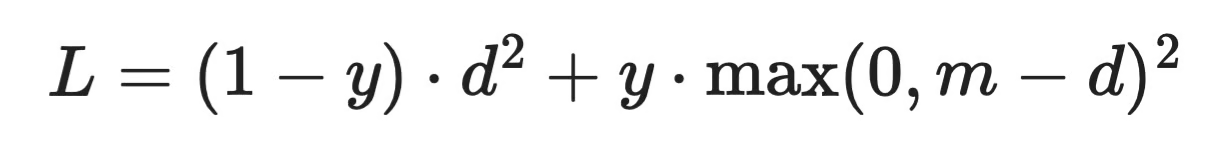
Formule voor contrastive loss
Waarbij d de afstand tussen twee embeddings is, y 1 is voor negatieve paren en 0 voor positieve paren, en m de marge is. De marge is een hyperparameter die je handmatig instelt, wat deze verliesfunctie gevoelig maakt voor afstemming.
Triplet loss werkt met drie datapunten tegelijk: een anker, een positief en een negatief.
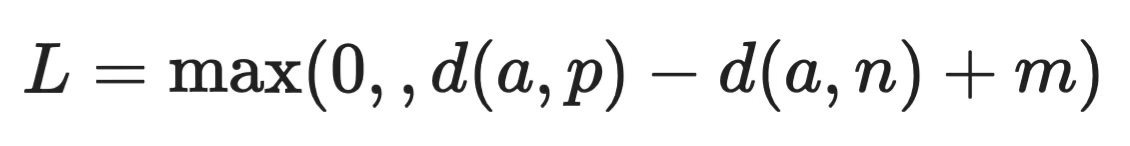
Formule voor triplet loss
Het model wordt bestraft wanneer de afstand van anker naar positief d(a, p) niet minstens met marge m kleiner is dan de afstand van anker naar negatief d(a, n). Als aan die voorwaarde al is voldaan, is het verlies nul.
Deze formulering geeft het model per update meer context dan contrastive loss, omdat het beide relaties tegelijk vergelijkt in plaats van één per keer.
InfoNCE is de verliesfunctie achter de meeste moderne contrastive-learningmethoden, waaronder SimCLR en CLIP.
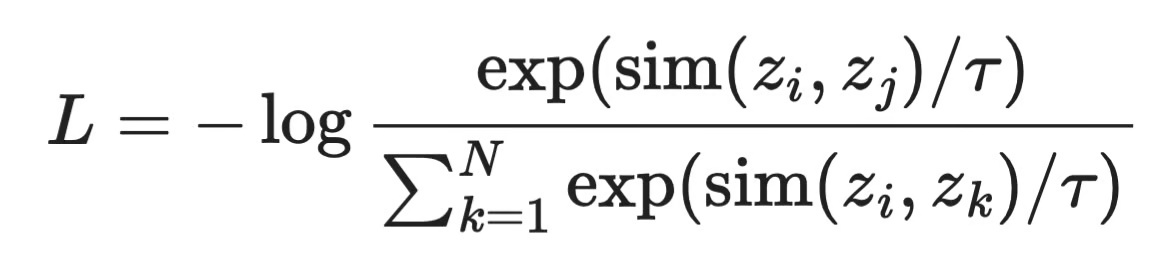
Formule voor InfoNCE-loss
Voor elk anker z_i moet het model zijn positieve z_j identificeren uit alle andere N voorbeelden in de batch. De temperatuurparameter τ bepaalt hoe scherp de verdeling is - lagere waarden maken het model zekerder, hogere waarden verzachten het contrast tussen paren.
Je krijgt per update meer negatieven, wat het model meer leersignaal geeft. Het betekent ook dat grotere batches het model blootstellen aan moeilijkere negatieven en over het algemeen betere representaties opleveren.
Contrastive learning en zelfgestuurd leren gaan goed samen, en door te begrijpen waarom, snap je waar moderne ML naartoe gaat.
Zelfgestuurd leren is een trainingsaanpak waarbij het model zijn eigen labels uit de data genereert, zonder menselijke annotatie. In plaats van dat iemand duizenden afbeeldingen labelt als "kat" of "hond", levert de data zelf het supervisiesignaal.
Contrastive learning doet precies dat. Wanneer je een afbeelding neemt, er twee geaugmenteerde versies van maakt en het model vertelt dat het een positief paar is, heb je zojuist een label gecreëerd.
Dit is belangrijk omdat gelabelde data de bottleneck is in de meeste ML-pijplijnen. Het verzamelen ervan is traag, annotatie is duur en sommige domeinen, zoals medische beeldvorming, hebben er niet genoeg van.
De resultaten tot nu toe zijn veelbelovend. Modellen die vooraf zijn getraind met contrastieve zelfgestuurde doelstellingen op grote ongelabelde datasets, evenaren of benaderen na fine-tuning op slechts een kleine hoeveelheid gelabelde data de gesuperviseerde baselines op een reeks downstreamtaken.
De algemene trend is om weg te bewegen van taakspecifieke gesuperviseerde training en toe naar generieke representaties die op schaal uit ruwe data worden geleerd. Methodes als SimCLR, MoCo en BYOL volgen allemaal deze trend, en die bespreek ik hierna.
Dit zijn de drie meest invloedrijke frameworks achter contrastive learning in 2026.
SimCLR, geïntroduceerd door Google Research, is een van de duidelijkste implementaties van het contrastive-learningidee.
Voor elke afbeelding in een batch maakt het twee geaugmenteerde weergaven en beschouwt die als een positief paar. Elke andere afbeelding in de batch wordt een negatief. Het model, een CNN gevolgd door een kleine projectiekop, leert positieve paren dicht bij elkaar te plaatsen met behulp van InfoNCE-loss.
Wat SimCLR onderscheidde, was hoe belangrijk batchgrootte is. Grotere batches betekenden meer negatieven per update, wat zich vertaalde naar betere representaties. De keerzijde is geheugen. Omdat SimCLR grote batches nodig heeft om goed te werken, heb je stevige hardware nodig om er het meeste uit te halen.
MoCo (Momentum Contrast), van Meta AI Research, is ontworpen om precies dat probleem op te lossen.
In plaats van te vertrouwen op een grote batch voor negatieven, onderhoudt MoCo een queue - een doorlopende buffer van gecodeerde representaties uit eerdere batches. Dit ontkoppelt het aantal negatieven van de batchgrootte, zodat je met veel minder geheugen kunt trainen en het model toch aan een grote pool van negatieven kunt blootstellen.
Het gebruikt ook een momentumencoder, een langzaam bijgewerkte kopie van de hoofdencoder, om de representaties in de queue in de tijd consistent te houden.
BYOL (Bootstrap Your Own Latent) is het vermelden waard, ook al gebruikt het helemaal geen negatieve paren.
In plaats van negatieven uit elkaar te duwen, traint BYOL één netwerk om de representaties van een ander - een langzaam bijgewerkt doelsnetwerk - te voorspellen. Er zijn geen negatieven en geen contrastieve verliesfunctie. Het werkt verrassend goed, en het succes ervan daagde de aanname uit dat negatieve paren noodzakelijk zijn voor contrastieve-achtige leerprocessen.
BYOL staat ergens aan de rand van contrastive learning, maar het is een goede volgende stap zodra je begrijpt hoe de kernmethoden werken.
Deze twee benaderingen lossen hetzelfde probleem op, maar vertrekken vanuit verschillende aannames die je moet begrijpen.
Gesuperviseerd leren vereist gelabelde data. Elk trainingsvoorbeeld heeft een door een mens toegekende label nodig, en het model leert door inputs aan die labels te koppelen. Het is een directe aanpak, en werkt goed wanneer je genoeg gelabelde voorbeelden hebt. Het model weet wat de input is en wat het juiste antwoord is.
Contrastive learning genereert zijn eigen supervisie uit de structuur van de data - gelijkenis en verschil - en leert representaties zonder ooit een label te zien.
Hier is een meer visuele weergave van hoe ze zich verhouden:
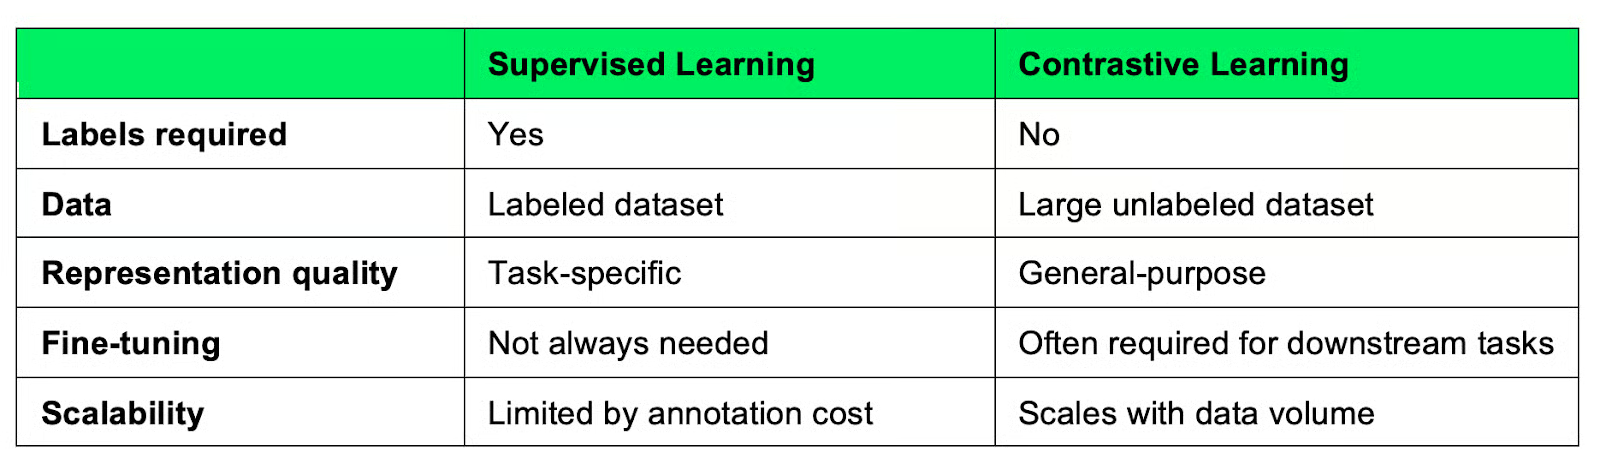
Contrastive learning vergeleken met gesuperviseerd leren
Het grootste verschil zie je op schaal. Gesuperviseerd leren is afhankelijk van gelabelde data - en meer labelen is duur. Contrastive learning kan blijven verbeteren naarmate je er meer ongelabelde data in stopt, wat meestal in overvloed aanwezig is.
Maar het is belangrijk te benadrukken dat de representaties die een contrastive-learningmodel leert algemeen zijn, niet taakspecifiek. Dat betekent dat je meestal een fine-tuningstap nodig hebt om op een specifieke taak goed te presteren. Gesuperviseerde modellen hebben die stap niet nodig omdat ze op de doelstelling zelf zijn getraind.
De keuze komt neer op je datasituatie. Als je gelabelde data en een specifieke taak hebt, is gesuperviseerd leren vaak sneller. Werk je met grote hoeveelheden ongelabelde data of heb je representaties nodig die tussen taken overdraagbaar zijn, dan kan contrastive learning de extra setup waard zijn.
Laten we nu een minimale PyTorch-implementatie maken. Het onderstaande voorbeeld dekt de drie kernideeën die eerder zijn besproken: een embeddingmodel, cosinusgelijkenis en NT-Xent-loss - de verliesfunctie die in SimCLR wordt gebruikt, gebouwd bovenop InfoNCE.
De encoder is een eenvoudig feedforwardnetwerk dat invoervectoren afbeeldt naar een embeddingruimte met lagere dimensie.
import torch
import torch.nn as nn
import torch.nn.functional as F

class Encoder(nn.Module):
    def __init__(self, input_dim, embedding_dim):
        super().__init__()
        self.network = nn.Sequential(
            nn.Linear(input_dim, 128),
            nn.ReLU(),
            nn.Linear(128, embedding_dim)
        )

    def forward(self, x):
        return self.network(x)
In de praktijk vervang je dit door een CNN voor beelden of een transformer voor tekst. De architectuur is minder belangrijk dan wat erna komt.
Zodra je twee embeddings hebt, meet je hoe dicht ze bij elkaar liggen met cosinusgelijkenis. De vectoren eerst normaliseren houdt de gelijkenisscores begrensd tussen -1 en 1.
def cosine_similarity(z1, z2):
    z1 = F.normalize(z1, dim=-1)
    z2 = F.normalize(z2, dim=-1)
    return torch.matmul(z1, z2.T)
Het resultaat is een matrix waarbij elk element [i, j] de gelijkenis weergeeft tussen embedding i en embedding j over de batch.
NT-Xent (Normalized Temperature-scaled Cross Entropy) is de InfoNCE-gebaseerde verliesfunctie. Voor elk anker behandelt die de gekoppelde view als positief en alle andere voorbeelden in de batch als negatieven.
def nt_xent_loss(z1, z2, temperature=0.5):
    batch_size = z1.shape[0]

    z = torch.cat([z1, z2], dim=0)
    z = F.normalize(z, dim=-1)
    sim_matrix = torch.matmul(z, z.T) / temperature

    mask = torch.eye(2 * batch_size, dtype=torch.bool)
    sim_matrix = sim_matrix.masked_fill(mask, float("-inf"))

    labels = torch.arange(batch_size)
    labels = torch.cat([labels + batch_size, labels])

    return F.cross_entropy(sim_matrix, labels)
De parameter temperature bepaalt hoe scherp de verdeling is. Lagere waarden maken het model zekerder over welk paar positief is; hogere waarden verzachten het contrast.
encoder = Encoder(input_dim=64, embedding_dim=32)
optimizer = torch.optim.Adam(encoder.parameters(), lr=1e-3)

# Simuleer een batch van positieve paren
x1 = torch.randn(32, 64)
x2 = torch.randn(32, 64)

# Training
optimizer.zero_grad()
z1, z2 = encoder(x1), encoder(x2)
loss = nt_xent_loss(z1, z2)
loss.backward()
optimizer.step()

print(f"Loss: {loss.item():.4f}")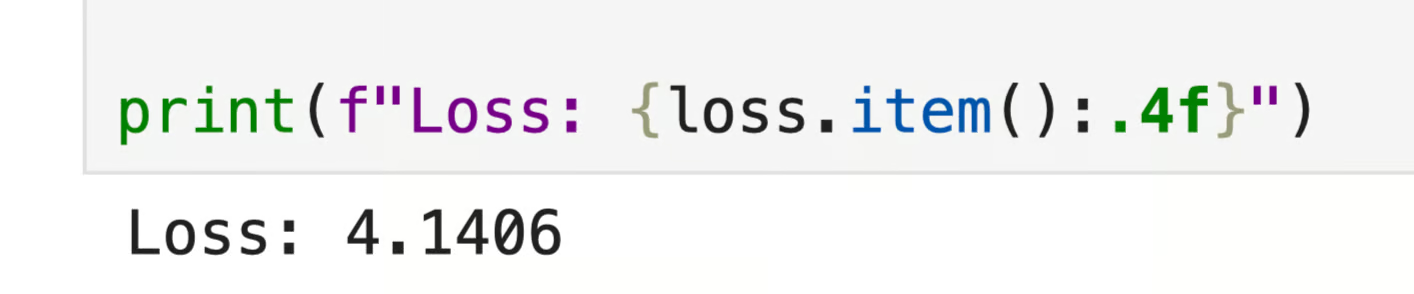
Uitvoer contrastieve loop
Dit is de volledige contrastieve loop in zijn simpelste vorm. In een echte implementatie zouden x1 en x2 twee geaugmenteerde weergaven van dezelfde input zijn in plaats van willekeurige ruis - maar de structuur blijft exact hetzelfde.
Contrastive learning is een eenvoudig idee met een groot bereik.
Het leert modellen structuur begrijpen door vergelijking in plaats van te vertrouwen op gelabelde data. Vergelijkbare dingen naar elkaar toe trekken, verschillende dingen uit elkaar duwen - dat is het hele principe. Het blijkt genoeg om representaties te leren die goed overdraagbaar zijn tussen taken.
Het veld beweegt weg van annotatiezware pijplijnen, en contrastive learning is daar een belangrijke reden voor. Algoritmen als SimCLR, MoCo en CLIP haalden het tot in echte producten, wat iets zegt over hoe goed de aanpak in de praktijk werkt.
Wil je dieper gaan, dan is een echte implementatie de volgende stap. Het PyTorch-voorbeeld in dit artikel is een vertrekpunt, maar SimCLR draaien op een echte afbeeldingsdataset - zelfs een kleine - leert je meer dan welke uitleg ook.
En als je de ultieme bron voor geavanceerde machine-learningonderwerpen zoekt, schrijf je dan in voor onze Machine Learning Scientist in Python-track.
Leer met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min