Kurs
Machine Learning'i Anlamak
2 sa
308K
Bir modelin etiketli veri olmadan öğrenmesini sağlamak imkansız gibi gelebilir, ancak karşılaştırmalı öğrenmenin arkasındaki fikir tam olarak budur.
Bildiğiniz gibi, veri etiketleme yavaş ve pahalıdır. Tek bir görüntü sınıflandırma veri kümesi genellikle binlerce saat insan anotasyonu gerektirir; üstelik bu, hata ve tutarsızlıkları hesaba katmadan önceki süredir.
Karşılaştırmalı öğrenme, modellere karşılaştırma yapmayı öğreterek bu etiketleme sorununu aşar. Yani bir modele bir şeyin ne olduğunu söylemek yerine, ona hangi şeylerin benzer, hangilerinin farklı olduğunu gösterirsiniz — geri kalanını da kendi çıkarır.
Bu yazıda, karşılaştırmalı öğrenmenin arkasındaki sezgiyi, kaputun altında nasıl çalıştığını, pratikte nerelerde kullanıldığını — görüntü tanımadan NLP yerleştirmelerine — ve PyTorch ile nasıl uygulanacağını anlatacağım.
Bilgisayarlı görü tam olarak nedir? Görüntü analizine başlangıç rehberimizi okuyun.
Karşılaştırmalı öğrenme, sınıflandırma yerine karşılaştırma ile öğrenen bir eğitim yaklaşımıdır.
Modele "bu bir kedi" ya da "bu bir köpek" demek yerine, ona örnek çiftleri gösterir ve hangilerinin bir arada olması gerektiğini, hangilerinin olmaması gerektiğini kendi bulmasına izin verirsiniz. Model, bu iki şeyin benzer olup olmadığını çözerek öğrenir.
Başka bir deyişle — modele aynı anda iki veri noktası verirsiniz. Eğer ilişkiliyseler — örneğin aynı köpeğin farklı açılardan çekilmiş iki fotoğrafı — bu bir pozitif çifttir. İlişkili değillerse — bir köpek fotoğrafı ile bir araba fotoğrafı — bu bir negatif çifttir.
Modelin görevi, bu yapıya uyan temsiller (sayısal vektörler) üretmektir. Pozitif çiftler vektör uzayında birbirine yakın olmalıdır. Negatif çiftler ise birbirinden uzak olmalıdır.
Karşılaştırmalı öğrenmeyi anlamanın en kolay yolu görseller üzerinden gitmektir.
Bir köpeğin fotoğrafını alın. Şimdi iki versiyon oluşturun — biri kırpılmış, biri parlaklığı ayarlanmış. Gördüğünüz içerik aynı, ama pikseller farklı. Karşılaştırmalı öğrenme modeli bu iki versiyonu bir pozitif çift olarak görür ve bunları vektör uzayında benzer konumlara eşlemeyi öğrenir.
Modeli, o köpek fotoğrafının yanına bir araba fotoğrafı ile birlikte gösterirseniz, negatif bir çift elde edersiniz. Model, temsilleri birbirinden uzaklaştırmayı öğrenir.
"Bu bir köpek" ya da "bu bir araba" diye elle müdahale etmenize gerek yok. Model, benzerlik ve fark yapısından kendi anlayışını kurar.
Karşılaştırmalı öğrenmeyi güçlü kılan şey budur.
Sinyal, karşılaştırmadan gelir. Yeterince çok çiftle, model neleri benzer kılanın ve neleri ayıranın ne olduğunu kavrayan temsiller geliştirebilir.
Bu temsiller gerçekten kullanışlı çıkar. Bu şekilde görüntüler üzerinde eğitilmiş bir model, sınıflandırma, tespit veya getirip bulma görevleri için çok az etiketli veriyle ince ayar yapılarak iyi performans gösterebilir; çünkü görsel dünya hakkında zaten anlamlı bir şeyler öğrenmiştir.
Karşılaştırmalı öğrenme birçok alanda karşımıza çıkar — en çok şuralarda görürsünüz:
Karşılaştırmalı öğrenmenin yapabildiklerini ilk kanıtladığı yer burasıdır.
Bu şekilde görüntüler üzerinde eğitilen modeller, hiç etiket görmeden görsel benzerliği anlayan temsiller üretmeyi öğrenir. Aynı sahnenin farklı açılardan veya farklı aydınlatmalarda çekilmiş iki fotoğrafı vektör uzayında yakın noktalara eşlenmelidir. İlgisiz iki sahne ise birbirinden uzaklara eşlenmelidir.
Karşılaştırmalı olarak önceden eğitilmiş bir modeli alıp, ihtiyacınız olan etiketli verinin küçük bir kısmıyla sınıflandırma veya nesne tespiti için ince ayar yapabilirsiniz.
NLP'de, karşılaştırmalı öğrenme; bir cümlenin anlamını bütünüyle kavrayan vektör temsiller olan cümle yerleştirmelerini eğitmek için kullanılır.
Benzer anlama sahip cümleler vektör uzayında birbirine yakın olmalı, ilgisiz cümleler ise ayrı konumlandırılmalıdır. Bu şekilde eğitilen modeller, büyük miktarda etiketli cümle çifti olmadan anlamsal arama ve cümle benzerliği gibi görevleri yerine getirebilir.
Öneri sistemleri, kullanıcı-öğe benzerliğini modellemek için karşılaştırmalı öğrenmeyi kullanır.
Bir kullanıcı ile etkileşimde bulunduğu bir öğe pozitif bir çift oluşturur. Bir kullanıcı ile hiç görmediği rastgele bir öğe ise negatif bir çift oluşturur. Bunlar üzerinde yeterince eğitim yaptığınızda, modelin ilgili kullanıcı ve öğelerin bir arada kümelendiği ortak bir alanı öğrenmesi sağlanır.
Karşılaştırmalı öğrenmenin ilginçleştiği yer burasıdır.
CLIP gibi modeller, metin ve görüntüleri ortak bir vektör uzayında hizalamak için bunu kullanır. Bir köpek fotoğrafı ile "parkta oynayan bir köpek" cümlesi birbirine yakın düşmelidir. Bir köpek fotoğrafı ile "kırmızı bir spor araba" cümlesi ise düşmemelidir. Bu sayede çok modlu modeller, görüntüleri metin açıklamalarıyla eşleştirebilir ve başlıklar üretebilir.
Karşılaştırmalı öğrenme, görüntülerle, metinle veya sesle çalışıyor olun, her zaman aynı dört adımı izler.
Her eğitim örneği bir çift olarak başlar. İki veri noktasını örnekler ve ilişkiyi benzer (pozitif) veya benzer olmayan (negatif) olarak etiketlersiniz. Pratikte pozitif çiftler çoğu zaman aynı girdinin iki farklı biçimde artırılmış versiyonundan gelir, negatif çiftler ise ilgisiz örneklerin örneklenmesinden elde edilir.
Her iki veri noktası da onları vektörlere dönüştüren bir kodlayıcıdan geçer. Bu vektörlere yerleştirme (embedding) denir; ortak bir vektör uzayında yaşayan sayısal temsillerdir. Amaç, bu uzayın ham piksel veya token değerlerini değil, anlamsal anlamı yansıtmasıdır.
İki yerleştirmeye sahip olduğunuzda, ne kadar yakın olduklarını ölçersiniz. En yaygın tercih kosinüs benzerliğidir. 1'in vektörlerin aynı yöne işaret ettiğini, -1'in ise tamamen zıt olduğunu belirttiği -1 ile 1 arasında bir skor verir.
Model, benzerlik skorlarını olması gerekenlerle karşılaştırır. Pozitif çiftler için skor yüksek olmalıdır. Negatif çiftler için düşük olmalıdır. Bir kayıp fonksiyonu, modelin ne kadar sapma gösterdiğini ölçer ve geri yayılım, kodlayıcı ağırlıklarını bir sonraki sefer daha iyi olacak şekilde ayarlar.
Bu adımları yeterince çok çift üzerinde tekrar ederseniz, kodlayıcı benzer şeyleri bir arada kümelendiren ve farklı şeyleri iten yerleştirmeler üretmeyi öğrenecektir.
Karşılaştırmalı modelinizin kalitesi, çiftleri nasıl oluşturduğunuza bağlıdır.
Pozitif çiftler, benzer kabul edilmesi gereken iki veri noktasıdır. Bilgisayarlı görmede bu genellikle aynı görüntünün iki artırılmış versiyonu anlamına gelir. NLP'de aynı cümlenin iki parafraflı versiyonu veya bir cümle ile çevirisi olabilir. Model, aralarındaki değişen şeylerin önemli olmadığını öğrenir. Önemli olan tek şey, paylaşılan kısımdır.
Negatif çiftler, farklı kabul edilmesi gereken iki veri noktasıdır. Çoğu uygulama negatifleri veri kümesinin geri kalanından rastgele örnekler. Görüntüler üzerinde eğitim yapıyorsanız, farklı nesnelerin herhangi iki görüntüsü geçerli bir negatif çift oluşturur.
Zorlayıcı olan kısım burasıdır.
Tüm negatifler eşit derecede faydalı değildir. Kaynaktan bariz şekilde farklı olan rastgele bir negatif — örneğin bir köpek fotoğrafı ile bir uçak fotoğrafını eşlemek — modeli pek zorlamaz. Bunlara kolay negatifler denir ve çok fazlası üzerinde eğitim yapmak öğrenmeyi yavaşlatır.
Öte yandan, zor negatifler kaynağa benzer görünen ancak farklı bir sınıfa ait veri noktalarıdır — örneğin iki köpek ırkı veya benzer kelimelerle kurulmuş ama farklı anlamlara sahip iki cümle. Modelin onları ayırt etmek için daha ince taneli temsiller geliştirmesi gerekir; bu da genel olarak daha iyi yerleştirmeler üretir.
Aynı mantık pozitifler için de geçerlidir. Artırmalarınız çok hafifse model pek bir şey öğrenmez. Çok agresiflerse, çift artık anlamlı biçimde benzer değildir.
Kayıp fonksiyonu, çift karşılaştırmalarını öğrenme sinyaline dönüştürür.
Her kayıp fonksiyonu farklı çalışır, fakat hepsinin ortak amacı, benzer şeyler vektör uzayında yakın olduğunda modeli ödüllendirmek, olmadığında ise cezalandırmaktır.
Karşılaştırmalı kayıp, erken dönem karşılaştırmalı öğrenme çalışmalarıyla birlikte tanıtılmıştır.
Çiftler üzerinde çalışır. Pozitif bir çift verildiğinde, yerleştirmeleri birbirinden uzaksa modeli cezalandırır. Negatif bir çift verildiğinde ise yerleştirmeler çok yakınsa — özellikle de belirli bir marj içine düşüyorsa — modeli cezalandırır. Zaten yeterince uzak olan negatifler kayba katkıda bulunmaz.
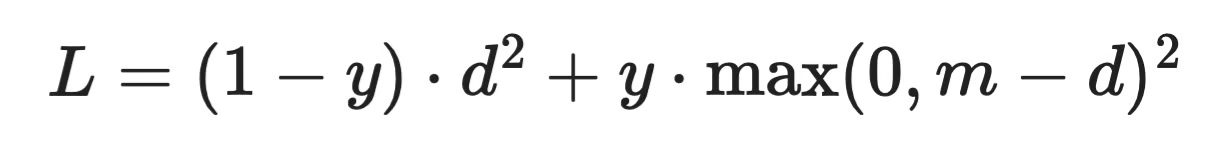
Karşılaştırmalı kayıp formülü
Burada d iki yerleştirme arasındaki mesafeyi, y negatif çiftler için 1'i, pozitif çiftler için 0'ı ve m marjı ifade eder. Marj, elle belirlediğiniz bir hiperparametredir; bu da bu kaybı ayarlara duyarlı kılar.
Üçlü kayıp aynı anda üç veri noktasıyla çalışır: bir çapa (anchor), bir pozitif ve bir negatif.
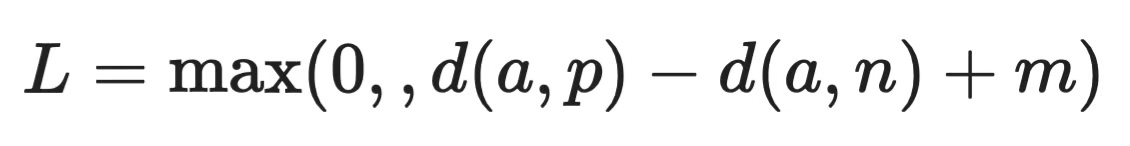
Üçlü kayıp formülü
Model, çapa-pozitif mesafesi d(a, p), çapa-negatif mesafesinden d(a, n) en az m marjı kadar küçük olmadığında cezalandırılır. Bu koşul zaten sağlanıyorsa kayıp sıfırdır.
Bu formülasyon, karşılaştırmalı kayba göre modelin her güncellemede daha fazla bağlama sahip olmasını sağlar; çünkü ilişkileri tek tek değil, aynı anda karşılaştırır.
InfoNCE, SimCLR ve CLIP dahil çoğu modern karşılaştırmalı öğrenme yönteminin arkasındaki kayıptır.
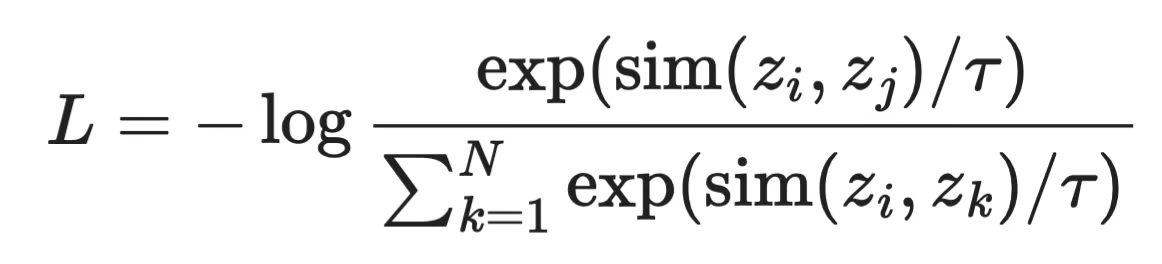
InfoNCE kayıp formülü
Her bir çapa z_i için, model eşleşen pozitifi z_j toplamdaki diğer N örnekler arasından ayırt etmek zorundadır. Sıcaklık parametresi τ dağılımın ne kadar keskin olduğunu kontrol eder — daha düşük değerler modeli daha kendinden emin kılar, daha yüksek değerler çiftler arasındaki karşıtlığı yumuşatır.
Her güncellemede daha fazla negatif elde edersiniz; bu da modele daha fazla öğrenme sinyali verir. Ayrıca daha büyük yığınlar modelin daha zor negatiflerle karşılaşmasını sağlar ve genellikle daha iyi temsiller üretir.
Karşılaştırmalı öğrenme ile kendinden gözetimli öğrenme birlikte iyi çalışır; nedenini anlarsanız modern ML'in nereye gittiğini de anlarsınız.
Kendinden gözetimli öğrenme, modelin insan anotasyonu olmadan etiketleri verinin kendisinden ürettiği bir eğitim yaklaşımıdır. Yani binlerce görüntüyü birinin "kedi" veya "köpek" olarak etiketlemesi yerine, denetim sinyalini verinin kendisi sağlar.
Karşılaştırmalı öğrenme tam olarak bunu yapar. Bir görüntü alıp iki artırılmış versiyonunu oluşturduğunuzda ve bunların pozitif bir çift olduğunu modele söylediğinizde, aslında bir etiket yaratmış olursunuz.
Bu önemlidir çünkü etiketli veri çoğu ML hattında darboğazdır. Toplamak yavaştır, anotasyon pahalıdır ve tıbbi görüntüleme gibi bazı alanlarda yeterince veri yoktur.
Şimdiye kadarki sonuçlar umut vericidir. Büyük etiketlenmemiş veri kümeleri üzerinde karşılaştırmalı kendinden gözetimli hedeflerle önceden eğitilen modeller, yalnızca az miktarda etiketli veriyle ince ayarlandıktan sonra, çok sayıda aşağı akış görevinde denetimli taban çizgilerine yetişmiş veya yaklaşmıştır.
Genel eğilim, göreve özgü denetimli eğitimden uzaklaşıp, ölçekli ham veriden öğrenilen genel amaçlı temsillere yönelmektir. SimCLR, MoCo ve BYOL gibi yöntemler bu eğilimi izler; bir sonraki bölümde bunları ele alacağım.
2026'da karşılaştırmalı öğrenmenin arkasındaki en etkili üç çerçeve şunlardır:
Google Research tarafından tanıtılan SimCLR, karşılaştırmalı öğrenme fikrinin en net uygulamalarından biridir.
Yığındaki her görüntü için iki artırılmış görünüm oluşturur ve bunları pozitif bir çift olarak ele alır. Yığındaki diğer her görüntü negatif olur. Bir CNN ve küçük bir izdüşüm başlığından oluşan model, InfoNCE kaybını kullanarak pozitif çiftleri birbirine yakın eşlemeyi öğrenir.
SimCLR'ı öne çıkaran şey, yığın boyutunun ne kadar önemli olduğuydu. Daha büyük yığınlar, her güncellemede daha fazla negatif anlamına gelir; bu da daha iyi temsillere dönüşür. Bedeli bellek kullanımıdır. SimCLR iyi çalışmak için büyük yığınlar gerektirdiğinden, en iyi verimi almak için iyi donanıma ihtiyaç duyarsınız.
Meta AI Research'ten MoCo (Momentum Contrast), tam da bu sorunu çözmek için tasarlanmıştır.
Negatifler için büyük bir yığına dayanmak yerine, MoCo bir kuyruk — önceki yığınlardan kodlanmış temsillerin çalışan bir arabelleği — tutar. Bu, negatiflerin sayısını yığın boyutundan ayırır; böylece çok daha az bellekle eğitip modeli yine de büyük bir negatif havuzuna maruz bırakabilirsiniz.
Ayrıca, kuyruktaki temsillerin zaman içinde tutarlı kalması için, ana kodlayıcının yavaşça güncellenen bir kopyası olan bir momentum kodlayıcı kullanır.
BYOL (Bootstrap Your Own Latent), negatif çiftleri hiç kullanmasa da burada anılmaya değerdir.
Negatifleri itmek yerine, BYOL bir ağı başka bir ağın — yavaşça güncellenen hedef ağın — temsillerini tahmin edecek şekilde eğitir. Negatif yoktur ve karşılaştırmalı kayıp da yoktur. Şaşırtıcı derecede iyi çalışır ve başarısı, karşılaştırmalı tarzda öğrenme için negatif çiftlerin gerekli olduğu varsayımını sorgulatmıştır.
BYOL, karşılaştırmalı öğrenmenin sınırlarında yer alır; ancak temel yöntemlerin nasıl çalıştığını anladıktan sonra iyi bir sonraki adımdır.
Bu iki yaklaşım aynı sorunu çözer, fakat farklı varsayımlardan yola çıkar; bunları anlamanız gerekir.
Denetimli öğrenme, etiketli veri gerektirir. Her eğitim örneğinin bir insan tarafından atanmış etikete ihtiyacı vardır ve model girdileri bu etiketlere eşleyerek öğrenir. Doğrudan bir yaklaşımdır ve yeterince etiketli örneğiniz olduğunda iyi çalışır. Model girdinin ne olduğunu ve doğru yanıtın ne olduğunu bilir.
Karşılaştırmalı öğrenme, denetimini verinin yapısından — benzerlik ve farktan — üretir ve hiç etiket görmeden temsilleri öğrenir.
Karşılaştırmalarının daha görsel bir temsili şöyle:
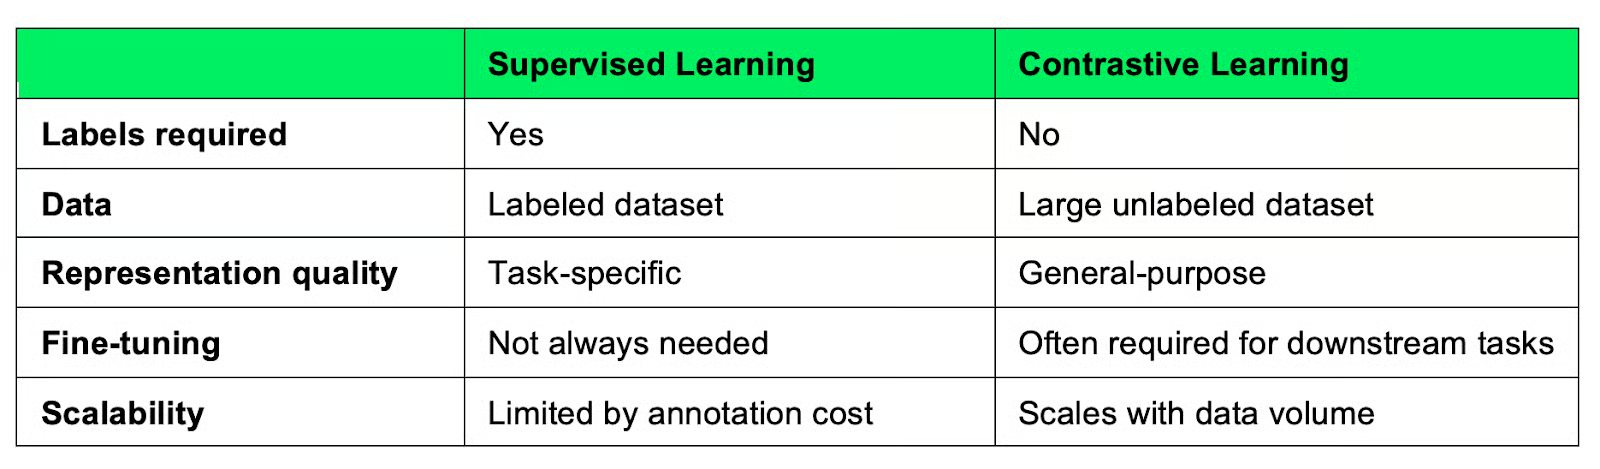
Karşılaştırmalı öğrenmenin denetimli öğrenmeyle karşılaştırılması
Farkın çoğu ölçek düzeyinde ortaya çıkar. Denetimli öğrenme etiketli veriye bağımlıdır — daha fazlasını etiketlemek pahalıdır. Karşılaştırmalı öğrenme genellikle bol bulunan etiketlenmemiş veriyi beslemeye devam ettikçe gelişebilir.
Ancak önemli bir nokta da şudur: Karşılaştırmalı öğrenme modelinin öğrendiği temsiller geneldir, göreve özgü değildir; bu da belirli bir görevde iyi performans için genellikle bir ince ayar adımına ihtiyaç duyacağınız anlamına gelir. Denetimli modeller bu adıma ihtiyaç duymaz; çünkü hedef amaca göre eğitilmiştir.
Seçim, veri durumunuza bağlıdır. Elinizde etiketli veri ve belirli bir görev varsa, denetimli öğrenme çoğu zaman daha hızlıdır. Büyük miktarda etiketlenmemiş verilerle çalışıyorsanız veya görevler arasında aktarılabilen temsillere ihtiyaç duyuyorsanız, karşılaştırmalı öğrenme ek kurulum zahmetine değebilir.
Şimdi minimal bir PyTorch uygulaması yapalım. Aşağıdaki örnek daha önce tartıştığımız üç temel fikri kapsar: bir yerleştirme modeli, kosinüs benzerliği ve InfoNCE üzerinde kurulu SimCLR'de kullanılan NT-Xent kaybı.
Kodlayıcı, girdi vektörlerini daha düşük boyutlu bir yerleştirme uzayına eşleyen basit bir ileri beslemeli ağdır.
import torch
import torch.nn as nn
import torch.nn.functional as F

class Encoder(nn.Module):
    def __init__(self, input_dim, embedding_dim):
        super().__init__()
        self.network = nn.Sequential(
            nn.Linear(input_dim, 128),
            nn.ReLU(),
            nn.Linear(128, embedding_dim)
        )

    def forward(self, x):
        return self.network(x)
Pratikte, bunu görüntüler için bir CNN veya metin için bir dönüştürücü ile değiştirirsiniz. Mimari, ondan sonra gelenlerden daha az önemlidir.
İki yerleştirmeye sahip olduğunuzda, kosinüs benzerliğini kullanarak ne kadar yakın olduklarını ölçersiniz. Vektörleri önce normalleştirmek, benzerlik skorlarının -1 ile 1 arasında sınırlı kalmasını sağlar.
def cosine_similarity(z1, z2):
    z1 = F.normalize(z1, dim=-1)
    z2 = F.normalize(z2, dim=-1)
    return torch.matmul(z1, z2.T)
Sonuç, her bir [i, j] girişinin topluluk boyunca i yerleştirmesi ile j yerleştirmesi arasındaki benzerliği temsil ettiği bir matristir.
NT-Xent (Normalized Temperature-scaled Cross Entropy), InfoNCE tabanlı bir kayıptır. Her çapa için, eşleşmiş görünümünü pozitif olarak ve yığındaki diğer tüm örnekleri negatif olarak ele alır.
def nt_xent_loss(z1, z2, temperature=0.5):
    batch_size = z1.shape[0]

    z = torch.cat([z1, z2], dim=0)
    z = F.normalize(z, dim=-1)
    sim_matrix = torch.matmul(z, z.T) / temperature

    mask = torch.eye(2 * batch_size, dtype=torch.bool)
    sim_matrix = sim_matrix.masked_fill(mask, float("-inf"))

    labels = torch.arange(batch_size)
    labels = torch.cat([labels + batch_size, labels])

    return F.cross_entropy(sim_matrix, labels)
temperature parametresi dağılımın keskinliğini kontrol eder. Daha düşük değerler, hangi çiftin pozitif olduğu konusunda modeli daha kendinden emin kılar; daha yüksek değerler karşıtlığı yumuşatır.
encoder = Encoder(input_dim=64, embedding_dim=32)
optimizer = torch.optim.Adam(encoder.parameters(), lr=1e-3)

# Simulate a batch of positive pairs
x1 = torch.randn(32, 64)
x2 = torch.randn(32, 64)

# Training
optimizer.zero_grad()
z1, z2 = encoder(x1), encoder(x2)
loss = nt_xent_loss(z1, z2)
loss.backward()
optimizer.step()

print(f"Loss: {loss.item():.4f}")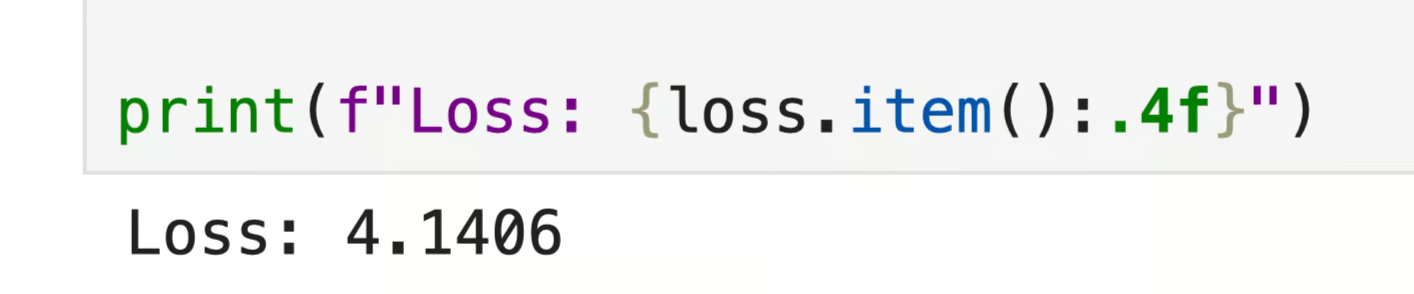
Karşılaştırmalı döngü çıktısı
Bu, en basit haliyle tam bir karşılaştırmalı döngüdür. Gerçek bir uygulamada x1 ve x2 rastgele gürültü yerine aynı girdinin iki artırılmış görünümü olur — fakat yapı aynen korunur.
Karşılaştırmalı öğrenme, geniş bir etkiye sahip basit bir fikirdir.
Etiketli veriye dayanmak yerine, karşılaştırma yoluyla yapıyı anlamayı modellere öğretir. Benzer olanları yaklaştırın, farklı olanları uzaklaştırın — tüm açılım bu; görevler arasında iyi aktarım yapan temsiller öğrenmek için yeterli olduğu ortaya çıktı.
Alan, anotasyon ağırlıklı süreçlerden uzaklaşıyor ve bunda karşılaştırmalı öğrenmenin payı büyük. SimCLR, MoCo ve CLIP gibi algoritmalar gerçek ürünlere girdi; bu da yaklaşımın pratikte ne kadar iyi çalıştığına dair bir şeyler söylüyor.
Daha derine inmek isterseniz, iyi bir sonraki adım gerçek bir uygulamayı elinize almak olur. Bu makaledeki PyTorch örneği bir başlangıçtır; ancak SimCLR'ı gerçek bir görüntü veri kümesinde — küçük de olsa — çalıştırmak, herhangi bir açıklamadan daha çok şey öğretecektir.
Ve gelişmiş makine öğrenimi konularına dair kapsamlı bir kaynak arıyorsanız, Python ile Makine Öğrenimi Bilimcisi eğitim yolumuza kaydolun.
DataCamp ile Öğrenin
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.