Courses
Understanding Machine Learning
2 ชม.
308K
การทำให้แบบจำลองเรียนรู้ได้โดยไม่มีข้อมูลกำกับดูเหมือนเป็นไปไม่ได้ แต่นั่นแหละคือแนวคิดของ contrastive learning
อย่างที่ทราบกัน การติดป้ายกำกับข้อมูลทั้งช้าและมีค่าใช้จ่ายสูง ชุดข้อมูลจัดหมวดหมู่ภาพชุดหนึ่งมักต้องใช้เวลาคนหลายพันชั่วโมงในการระบุ และนี่ยังไม่รวมความผิดพลาดและความไม่สอดคล้องกัน
Contrastive learning แก้ปัญหาการติดป้ายกำกับด้วยการสอนให้แบบจำลองรู้จักการเปรียบเทียบ แทนที่จะบอกว่าอะไรคืออะไร ก็ให้ดูว่ามีอะไรที่เหมือนกันและแตกต่างกัน แล้วปล่อยให้แบบจำลองหาคำตอบส่วนที่เหลือเอง
ในบทความนี้ จะพาไปรู้จักสัญชาตญาณเบื้องหลัง contrastive learning วิธีทำงานภายใน เบื้องหลังการใช้งานจริงตั้งแต่การรู้จำภาพไปจนถึงเวกเตอร์ฝังความหมายใน NLP และวิธีลงมือทำใน PyTorch
คอมพิวเตอร์วิทัศน์คืออะไรกันแน่ อ่านคู่มือสำหรับผู้เริ่มต้นด้านการวิเคราะห์ภาพของเรา
Contrastive learning คือแนวทางการฝึกที่ทำให้แบบจำลองเรียนรู้ด้วยการเปรียบเทียบ แทนการจัดหมวดหมู่
แทนที่จะบอกว่า "นี่คือแมว" หรือ "นี่คือสุนัข" จะให้ดูตัวอย่างเป็นคู่ แล้วปล่อยให้ตัดสินใจเองว่าอะไรควรอยู่ด้วยกันและอะไรไม่ควร แบบจำลองจะเรียนรู้จากการตัดสินใจว่าสองสิ่งนี้เหมือนกันหรือไม่
กล่าวคือ จะป้อนข้อมูลครั้งละสองจุดข้อมูล หากมีความเกี่ยวข้องกัน เช่น รูปสุนัขตัวเดียวกันถ่ายคนละมุม นั่นคือคู่บวก (positive pair) หากไม่เกี่ยวข้องกัน เช่น รูปสุนัขกับรูปรถ นั่นคือคู่ลบ (negative pair)
หน้าที่ของแบบจำลองคือสร้างการแทนค่า (เวกเตอร์เชิงตัวเลข) ที่สะท้อนโครงสร้างนี้ คู่บวกควรอยู่ใกล้กันในปริภูมิเวกเตอร์ คู่ลบควรอยู่ห่างกัน
วิธีที่เข้าใจง่ายที่สุดคือผ่านภาพ
ลองเอาภาพสุนัขหนึ่งรูป แล้วสร้างสองเวอร์ชันของมัน—อันหนึ่งครอป อีกอันปรับความสว่าง เนื้อหาที่เห็นเหมือนกัน แต่พิกเซลต่างกัน แบบจำลองแบบ contrastive มองสองเวอร์ชันนี้เป็นคู่บวก และเรียนรู้ให้แมปไปยังตำแหน่งที่คล้ายกันในปริภูมิเวกเตอร์
ถ้าแสดงรูปรถควบคู่กับรูปสุนัข จะได้คู่ลบ แบบจำลองจะเรียนรู้ให้ผลักการแทนค่าออกจากกัน
ไม่จำเป็นต้องระบุด้วยมือว่า "นี่คือสุนัข" หรือ "นี่คือรถ" แบบจำลองสร้างความเข้าใจจากโครงสร้างของความเหมือนและความต่าง
นี่เองที่ทำให้ contrastive learning ทรงพลัง
สัญญาณมาจากการเปรียบเทียบ เมื่อมีคู่มากพอ แบบจำลองก็พัฒนาการแทนค่าที่เข้าใจว่าอะไรทำให้สิ่งต่างๆ คล้ายกันและต่างกัน
การแทนค่าเหล่านี้มีประโยชน์จริง แบบจำลองที่ฝึกด้วยวิธีนี้บนภาพสามารถปรับจูนต่อสำหรับงานจัดหมวดหมู่ การตรวจจับ หรือการค้นคืน โดยใช้ข้อมูลมีป้ายกำกับเพียงเล็กน้อย เพราะได้เรียนรู้สิ่งที่มีความหมายเกี่ยวกับโลกเชิงภาพมาแล้ว
Contrastive learning ปรากฏในหลายโดเมน—พื้นที่ที่เห็นบ่อยมีดังนี้
นี่คือพื้นที่ที่ contrastive learning พิสูจน์ศักยภาพเป็นครั้งแรก
แบบจำลองที่ฝึกด้วยวิธีนี้บนภาพจะเรียนรู้การสร้างการแทนค่าที่เข้าใจความเหมือนเชิงภาพ โดยไม่ต้องเห็นป้ายกำกับเลย ภาพสองภาพของฉากเดียวกัน ถ่ายคนละมุมหรือต่างสภาพแสง ควรถูกแมปไปยังจุดที่อยู่ใกล้กันในปริภูมิเวกเตอร์ ส่วนฉากที่ไม่เกี่ยวข้องควรถูกแมปให้อยู่ห่างกัน
สามารถนำแบบจำลองที่พรีเทรนเชิงเปรียบต่างไปปรับจูนสำหรับการจัดหมวดหมู่หรือการตรวจจับวัตถุ โดยใช้ข้อมูลมีป้ายกำกับเพียงเศษเสี้ยวของที่เคยต้องใช้
ใน NLP มีการใช้ contrastive learning เพื่อฝึก sentence embeddings—การแทนค่าเวกเตอร์ที่เข้าใจความหมายของประโยคโดยรวม
ประโยคที่มีความหมายคล้ายกันควรอยู่ใกล้กันในปริภูมิเวกเตอร์ และประโยคที่ไม่เกี่ยวข้องควรถูกวางให้ห่างกัน แบบจำลองที่ฝึกด้วยวิธีนี้ทำงานอย่างการค้นหาความหมายและความคล้ายคลึงของประโยคได้ โดยไม่ต้องมีคู๋ประโยคติดป้ายกำกับจำนวนมาก
ระบบแนะนำใช้ contrastive learning เพื่อจำลองความคล้ายคลึงระหว่างผู้ใช้และไอเท็ม
ผู้ใช้กับไอเท็มที่เคยมีปฏิสัมพันธ์กันเป็นคู่บวก ผู้ใช้กับไอเท็มสุ่มที่ไม่เคยเห็นเป็นคู่ลบ หากฝึกด้วยคู๋เหล่านี้มากพอ แบบจำลองจะเรียนรู้ปริภูมิร่วมที่ผู้ใช้และไอเท็มที่เกี่ยวข้องกระจุกตัวอยู่ด้วยกัน
นี่คือจุดที่ contrastive learning น่าสนใจ
โมเดลอย่าง CLIP ใช้มันเพื่อจัดแนวข้อความและภาพให้อยู่ในปริภูมิเวกเตอร์ร่วม รูปสุนัขกับประโยค "a dog playing in the park" ควรอยู่ใกล้กัน รูปสุนัขกับประโยค "a red sports car" ไม่ควรอยู่ใกล้ วิธีนี้ทำให้โมเดลหลายสื่อจับคู่ภาพกับคำบรรยายและสร้างแคปชันได้
Contrastive learning มีสี่ขั้นตอนเหมือนกันเสมอ ไม่ว่าทำกับภาพ ข้อความ หรือเสียง
ทุกตัวอย่างฝึกเริ่มจากการเป็นคู่ สุ่มตัวอย่างข้อมูลสองจุดและระบุความสัมพันธ์ว่าเหมือนกัน (บวก) หรือไม่เหมือนกัน (ลบ) ในทางปฏิบัติ คู่บวมักมาจากการเพิ่มพูนข้อมูลอินพุตเดียวกันสองแบบ ส่วนคู่ลบมักสุ่มจากตัวอย่างที่ไม่เกี่ยวข้อง
ข้อมูลทั้งสองผ่านตัวเข้ารหัสเพื่อแปลงเป็นเวกเตอร์ เวกเตอร์เหล่านี้เรียกว่า embeddings เป็นการแทนค่าเชิงตัวเลขที่อยู่ในปริภูมิเวกเตอร์ร่วม เป้าหมายคือให้ปริภูมินั้นสะท้อนความหมายเชิงสеманติก ไม่ใช่แค่ค่าพิกเซลหรือโทเค็นดิบ
เมื่อได้ embeddings สองตัวแล้ว ให้วัดว่าพวกมันใกล้กันแค่ไหน Cosine similarity เป็นตัวเลือกที่ใช้บ่อยที่สุด ให้คะแนนระหว่าง -1 ถึง 1 โดย 1 หมายถึงเวกเตอร์ชี้ไปทิศเดียวกัน และ -1 หมายถึงตรงข้ามกันโดยสิ้นเชิง
แบบจำลองจะเปรียบเทียบคะแนนความคล้ายคลึงกับสิ่งที่ควรเป็น สำหรับคู่บวก คะแนนควรสูง สำหรับคู่ลบควรต่ำ ฟังก์ชันการสูญเสียจะวัดความคลาดเคลื่อน และทำ backpropagation เพื่อปรับน้ำหนักของตัวเข้ารหัสให้ดีขึ้นในครั้งถัดไป
หากทำซ้ำขั้นตอนเหล่านี้กับคู่จำนวนมาก ตัวเข้ารหัสจะเรียนรู้การสร้าง embeddings ที่ทำให้สิ่งที่คล้ายกันกระจุกตัว และผลักสิ่งที่ต่างกันออกจากกัน
คุณภาพของโมเดลเชิงเปรียบต่างขึ้นอยู่กับวิธีสร้างคู่ของคุณ
คู่บวกคือสองจุดข้อมูลที่ควรถูกมองว่าเหมือนกัน ในคอมพิวเตอร์วิทัศน์ โดยมากหมายถึงภาพเดียวกันที่ถูกเพิ่มพูนสองแบบ ใน NLP อาจเป็นสองพาราเฟรสของประโยคเดียวกัน หรือประโยคกับคำแปล แบบจำลองเรียนรู้ว่าสิ่งที่ต่างกันระหว่างทั้งสองไม่สำคัญ สิ่งสำคัญคือสิ่งที่เหมือนกัน
คู่ลบคือสองจุดข้อมูลที่ควรถูกมองว่าแตกต่างกัน การทำงานส่วนใหญ่จะสุ่มคู่ลบจากตัวอย่างที่เหลือของชุดข้อมูล หากฝึกบนภาพ ภาพสองภาพของวัตถุต่างชนิดถือเป็นคู่ลบที่ถูกต้อง
ตรงนี้แหละที่เริ่มยาก
ไม่ใช่คู่ลบทุกคู่จะมีประโยชน์เท่ากัน คู่ลบแบบสุ่มที่แตกต่างจากต้นฉบับอย่างชัดเจน เช่น รูปสุนัขจับคู่กับรูปเครื่องบิน ไม่ได้ทำให้โมเดลต้องทำงานหนักนัก เรียกว่าคู่ลบง่าย (easy negatives) และการฝึกด้วยสิ่งเหล่านี้มากเกินไปจะทำให้การเรียนรู้ช้าลง
ในอีกด้านหนึ่งคู่ลบยาก (hard negatives) คือจุดข้อมูลที่ดูคล้ายกับต้นฉบับแต่เป็นคนละคลาส เช่น สายพันธุ์สุนัขสองสายพันธุ์ หรือประโยคที่ถ้อยคำคล้ายกันแต่ความหมายต่างกัน โมเดลต้องพัฒนาการแทนค่าที่ละเอียดขึ้นเพื่อแยกแยะ ซึ่งทำให้ได้ embeddings ที่ดีกว่าโดยรวม
ตรรกะเดียวกันนี้ใช้กับคู่บวกด้วย หากการเพิ่มพูนละเอียดเกินไป โมเดลจะเรียนรู้ได้น้อย หากรุนแรงเกินไป คู่ก็อาจไม่เหมือนกันในเชิงความหมายอีกต่อไป
ฟังก์ชันการสูญเสียจะแปลงการเปรียบเทียบคู่ให้เป็นสัญญาณการเรียนรู้
แต่ละฟังก์ชันทำงานต่างกัน แต่มีเป้าหมายเดียวกันคือให้รางวัลเมื่อสิ่งที่คล้ายกันอยู่ใกล้กันในปริภูมิเวกเตอร์ และลงโทษเมื่อไม่เป็นเช่นนั้น
Contrastive loss ถูกนำเสนอควบคู่กับงานแรกๆ ของ contrastive learning
มันทำงานกับคู่ เมื่อเป็นคู่บวก จะลงโทษหาก embeddings อยู่ห่างกันมากเกินไป เมื่อเป็นคู่ลบ จะลงโทษหาก embeddings อยู่ใกล้กันเกินไป—เฉพาะเมื่ออยู่ภายในระยะขอบที่กำหนด คู่ลบที่ห่างกันเพียงพอแล้วจะไม่ก่อให้เกิดการสูญเสีย
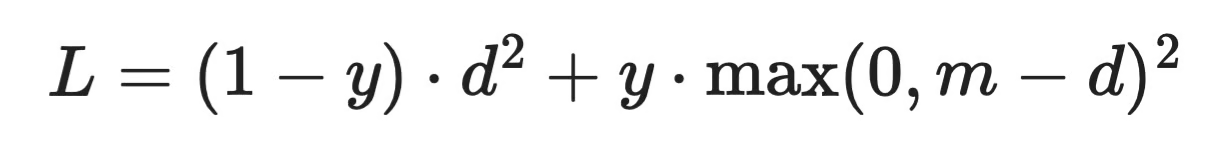
สูตร Contrastive loss
โดยที่ d คือระยะห่างระหว่าง embeddings สองตัว y เท่ากับ 1 สำหรับคู่ลบ และ 0 สำหรับคู่บวก และ m คือระยะขอบ ระยะขอบเป็นไฮเปอร์พารามิเตอร์ที่กำหนดเอง ทำให้การสูญเสียนี้อ่อนไหวต่อการจูน
Triplet loss ทำงานกับข้อมูลสามจุดพร้อมกัน: จุดยึด (anchor) คู่บวก และคู่ลบ
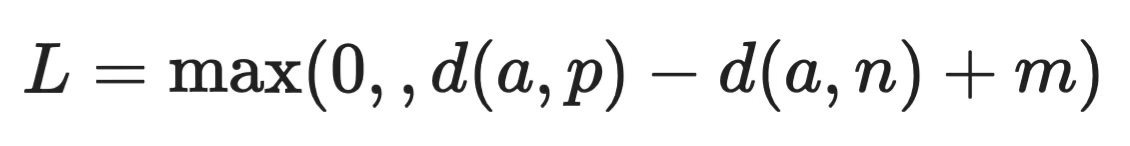
สูตร Triplet loss
โมเดลจะถูกลงโทษเมื่อระยะยึด-บวก d(a, p) ไม่ได้เล็กกว่าระยะยึด-ลบ d(a, n) อย่างน้อยเท่าระยะขอบ m หากเงื่อนไขเป็นจริงอยู่แล้ว การสูญเสียจะเป็นศูนย์
สูตรนี้ให้บริบทต่อการอัปเดตมากกว่า contrastive loss เพราะเปรียบเทียบทั้งสองความสัมพันธ์พร้อมกัน ไม่ใช่ทีละความสัมพันธ์
InfoNCE เป็นการสูญเสียเบื้องหลังวิธีสมัยใหม่ส่วนใหญ่ของ contrastive learning รวมถึง SimCLR และ CLIP
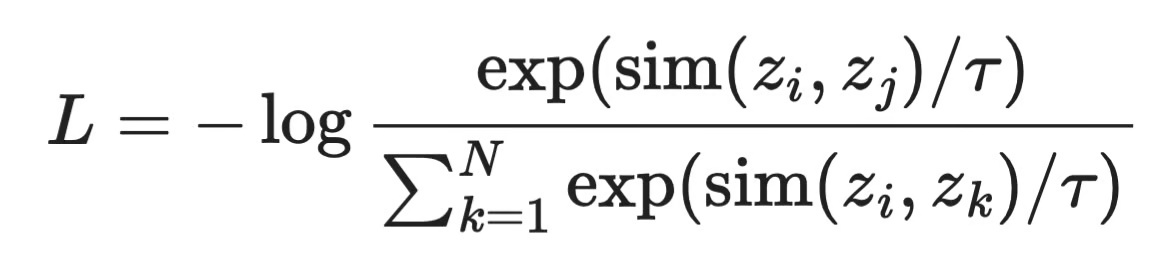
สูตร InfoNCE loss
สำหรับแต่ละจุดยึด z_i โมเดลต้องระบุค่าบวก z_j จากตัวอย่างอื่นทั้งหมด N ตัวในแบตช์ พารามิเตอร์อุณหภูมิ τ ควบคุมความคมของการกระจาย—ค่ายิ่งต่ำแบบจำลองยิ่งมั่นใจ ค่ายิ่งสูงจะทำให้ความต่างระหว่างคู่นุ่มลง
ได้คู่ลบต่อการอัปเดตมากขึ้น ซึ่งให้สัญญาณการเรียนรู้มากขึ้นด้วย นอกจากนี้ แบตช์ที่ใหญ่กว่าจะทำให้แบบจำลองเจอคู่ลบยากขึ้นและโดยทั่วไปให้การแทนค่าที่ดีกว่า
Contrastive learning และการเรียนรู้แบบกำกับตนเองทำงานร่วมกันได้ดี และเมื่อเข้าใจเหตุผล ก็จะเห็นทิศทางของ ML สมัยใหม่
การเรียนรู้แบบกำกับตนเองคือแนวทางฝึกที่ให้แบบจำลองสร้างป้ายกำกับจากข้อมูลเอง โดยไม่ต้องมีการระบุโดยมนุษย์ ดังนั้นแทนที่จะมีคนติดป้ายภาพนับพันว่า "แมว" หรือ "สุนัข" ข้อมูลเองจะให้สัญญาณกำกับ
Contrastive learning ทำสิ่งนั้นพอดี เมื่อคุณนำภาพหนึ่งภาพมาสร้างสองเวอร์ชันที่เพิ่มพูน และบอกโมเดลว่านี่คือคู่บวก คุณก็เพิ่งสร้างป้ายกำกับขึ้นมา
ประเด็นนี้สำคัญเพราะข้อมูลมีป้ายกำกับคือคอขวดในสายงาน ML ส่วนใหญ่ การเก็บข้อมูลช้า การระบุป้ายแพง และบางโดเมนอย่างภาพทางการแพทย์ก็มีไม่เพียงพอ
ผลลัพธ์ที่ผ่านมาเป็นที่น่าพอใจ โมเดลที่พรีเทรนด้วยวัตถุประสงค์แบบกำกับตนเองเชิงเปรียบต่างบนชุดข้อมูลไม่มีป้ายกำกับขนาดใหญ่ ทำผลงานทัดเทียมหรือใกล้เคียงกับวิธีกำกับแบบดั้งเดิมในงานปลายทางหลากหลาย หลังจากปรับจูนด้วยข้อมูลมีป้ายกำกับเพียงเล็กน้อย
แนวโน้มทั่วไปคือขยับออกจากการฝึกแบบกำกับเฉพาะงาน ไปสู่การเรียนรู้การแทนค่าทั่วไปจากข้อมูลดิบในสเกลใหญ่ วิธีอย่าง SimCLR, MoCo และ BYOL ล้วนเดินตามแนวโน้มนี้ และจะพูดถึงต่อไป
นี่คือสามกรอบงานที่ทรงอิทธิพลที่สุดเบื้องหลัง contrastive learning ในปี 2026
SimCLR ที่นำเสนอโดย Google Research เป็นหนึ่งในอิมพลีเมนเทชันที่ชัดเจนที่สุดของแนวคิด contrastive learning
สำหรับภาพแต่ละภาพในแบตช์ จะสร้างมุมมองที่เพิ่มพูนสองแบบและถือเป็นคู่บวก ภาพอื่นทั้งหมดในแบตช์จะเป็นคู่ลบ โมเดลซึ่งเป็น CNN ตามด้วยหัวฉายขนาดเล็ก จะเรียนรู้ให้แมปคู่บวกให้อยู่ใกล้กันด้วย InfoNCE loss
สิ่งที่ทำให้ SimCLR โดดเด่นคือขนาดแบตช์มีผลมาก แบตช์ใหญ่หมายถึงคู่ลบต่อการอัปเดตมากขึ้น ส่งผลให้การแทนค่าดีขึ้น แต่ต้องแลกกับหน่วยความจำ เนื่องจาก SimCLR ต้องการแบตช์ใหญ่เพื่อผลลัพธ์ที่ดี จึงต้องใช้ฮาร์ดแวร์ที่ดีเพื่อใช้ประโยชน์สูงสุด
MoCo (Momentum Contrast) จาก Meta AI Research ถูกออกแบบมาเพื่อแก้ปัญหานั้นโดยตรง
แทนที่จะพึ่งพาแบตช์ขนาดใหญ่เพื่อมีคู่ลบจำนวนมาก MoCo จะเก็บคิว—บัฟเฟอร์ของการแทนค่าที่เข้ารหัสจากแบตช์ก่อนหน้า วิธีนี้แยกจำนวนคู่ลบออกจากขนาดแบตช์ จึงฝึกด้วยหน่วยความจำที่น้อยลงแต่ยังให้โมเดลเจอคู่ลบจำนวนมากได้
มันยังใช้ตัวเข้ารหัสแบบโมเมนตัม ซึ่งเป็นสำเนาที่อัปเดตช้าๆ ของตัวเข้ารหัสหลัก เพื่อให้การแทนค่าในคิวคงเส้นคงวาเมื่อเวลาผ่านไป
BYOL (Bootstrap Your Own Latent) น่าพูดถึงแม้ว่าจะไม่ใช้คู่ลบเลยก็ตาม
แทนที่จะผลักคู่ลบให้ออกห่าง BYOL ฝึกเครือข่ายหนึ่งให้พยากรณ์การแทนค่าของอีกเครือข่ายหนึ่ง—ซึ่งเป็นเครือข่ายเป้าหมายที่อัปเดตช้า ไม่มีทั้งคู่ลบและ contrastive loss แต่มันทำงานได้ดีอย่างน่าประหลาด และความสำเร็จนี้ท้าทายสมมติฐานที่ว่าคู่ลบจำเป็นต่อการเรียนรู้แบบเปรียบต่าง
BYOL อยู่กึ่งกลางของ contrastive learning แต่เป็นก้าวถัดไปที่ดีเมื่อเข้าใจวิธีหลักแล้ว
ทั้งสองแนวทางแก้ปัญหาเดียวกัน แต่เริ่มจากสมมติฐานที่ต่างกันซึ่งควรเข้าใจ
การเรียนรู้แบบกำกับต้องการข้อมูลมีป้ายกำกับ ทุกตัวอย่างฝึกต้องมีฉลากที่มนุษย์กำหนด และแบบจำลองเรียนรู้โดยแมปอินพุตไปยังฉลากนั้น เป็นวิธีตรงไปตรงมาและได้ผลดีเมื่อมีตัวอย่างมีป้ายกำกับเพียงพอ แบบจำลองรู้ว่าอินพุตคืออะไรและคำตอบที่ถูกต้องคืออะไร
Contrastive learning สร้างสัญญาณกำกับจากโครงสร้างของข้อมูลเอง—ความเหมือนและความต่าง—และเรียนรู้การแทนค่าโดยไม่ต้องเห็นป้ายกำกับเลย
ต่อไปนี้คือภาพเปรียบเทียบอย่างเป็นรูปธรรม:
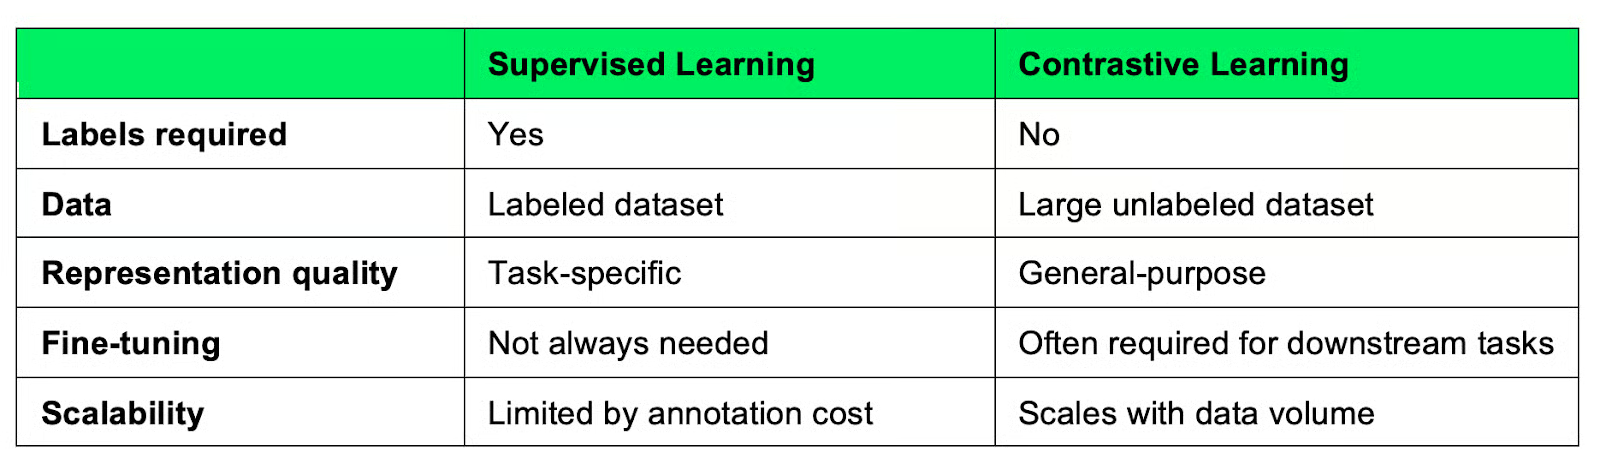
Contrastive learning เทียบกับ supervised learning
ความแตกต่างส่วนใหญ่จะเห็นชัดเมื่อขยายสเกล การเรียนรู้แบบกำกับพึ่งพาข้อมูลมีป้ายกำกับ—และการติดป้ายเพิ่มเติมมีค่าใช้จ่ายสูง Contrastive learning สามารถดีขึ้นต่อไปได้เมื่อป้อนข้อมูลไม่มีป้ายกำกับมากขึ้น ซึ่งโดยทั่วไปมีอยู่มากมาย
แต่อย่าลืมว่าการแทนค่าที่โมเดลเชิงเปรียบต่างเรียนรู้เป็นแบบทั่วไป ไม่ได้เจาะจงงาน ซึ่งมักต้องมีขั้นตอนปรับจูนเพื่อให้ได้ผลลัพธ์ที่ดีในงานเฉพาะ โมเดลแบบกำกับไม่ต้องมีขั้นตอนนี้เพราะฝึกตามวัตถุประสงค์เป้าหมายโดยตรง
การเลือกขึ้นอยู่กับสถานการณ์ข้อมูล หากมีข้อมูลมีป้ายกำกับและงานเฉพาะ การเรียนรู้แบบกำกับมักเร็วกว่า หากทำงานกับข้อมูลไม่มีป้ายกำกับจำนวนมาก หรือจำเป็นต้องมีการแทนค่าที่ถ่ายโอนไปยังงานต่างๆ ได้ Contrastive learning ก็อาจคุ้มกับการตั้งค่าที่เพิ่มขึ้น
ต่อไปมาดูอิมพลีเมนเทชัน PyTorch แบบย่อ ตัวอย่างด้านล่างครอบคลุมสามแนวคิดหลักที่กล่าวไว้ก่อนหน้า: โมเดลฝังความหมาย (embedding) ค่า cosine similarity และ NT-Xent loss—ฟังก์ชันการสูญเสียที่ใช้ใน SimCLR ซึ่งสร้างบน InfoNCE
ตัวเข้ารหัสคือเครือข่ายฟีดฟอร์เวิร์ดอย่างง่ายที่แมปเวกเตอร์อินพุตไปยังปริภูมิฝังความหมายมิติที่ต่ำกว่า
import torch
import torch.nn as nn
import torch.nn.functional as F

class Encoder(nn.Module):
    def __init__(self, input_dim, embedding_dim):
        super().__init__()
        self.network = nn.Sequential(
            nn.Linear(input_dim, 128),
            nn.ReLU(),
            nn.Linear(128, embedding_dim)
        )

    def forward(self, x):
        return self.network(x)
ในการใช้งานจริง มักแทนที่ด้วย CNN สำหรับภาพ หรือทรานส์ฟอร์เมอร์สำหรับข้อความ สถาปัตยกรรมสำคัญน้อยกว่าสิ่งที่ตามมาหลังจากนั้น
เมื่อได้ embeddings สองตัวแล้ว ให้วัดความใกล้กันด้วย cosine similarity การทำใหเวกเตอร์เป็นหน่วยก่อนช่วยให้คะแนนความคล้ายคลึงอยู่ในช่วง -1 ถึง 1
def cosine_similarity(z1, z2):
    z1 = F.normalize(z1, dim=-1)
    z2 = F.normalize(z2, dim=-1)
    return torch.matmul(z1, z2.T)
ผลลัพธ์คือเมทริกซ์ที่แต่ละช่อง [i, j] แทนความคล้ายคลึงระหว่างการฝังความหมาย i กับ j ภายในแบตช์
NT-Xent (Normalized Temperature-scaled Cross Entropy) คือการสูญเสียแบบ InfoNCE สำหรับแต่ละจุดยึด จะถือเอามุมมองคู่ของมันเป็นค่าบวก และตัวอย่างอื่นทั้งหมดในแบตช์เป็นค่าลบ
def nt_xent_loss(z1, z2, temperature=0.5):
    batch_size = z1.shape[0]

    z = torch.cat([z1, z2], dim=0)
    z = F.normalize(z, dim=-1)
    sim_matrix = torch.matmul(z, z.T) / temperature

    mask = torch.eye(2 * batch_size, dtype=torch.bool)
    sim_matrix = sim_matrix.masked_fill(mask, float("-inf"))

    labels = torch.arange(batch_size)
    labels = torch.cat([labels + batch_size, labels])

    return F.cross_entropy(sim_matrix, labels)
พารามิเตอร์ temperature ควบคุมความคมของการกระจาย ค่าต่ำทำให้แบบจำลองมั่นใจมากขึ้นว่าอันไหนเป็นคู่บวก ค่าสูงจะทำให้ความต่างนุ่มลง
encoder = Encoder(input_dim=64, embedding_dim=32)
optimizer = torch.optim.Adam(encoder.parameters(), lr=1e-3)

# Simulate a batch of positive pairs
x1 = torch.randn(32, 64)
x2 = torch.randn(32, 64)

# Training
optimizer.zero_grad()
z1, z2 = encoder(x1), encoder(x2)
loss = nt_xent_loss(z1, z2)
loss.backward()
optimizer.step()

print(f"Loss: {loss.item():.4f}")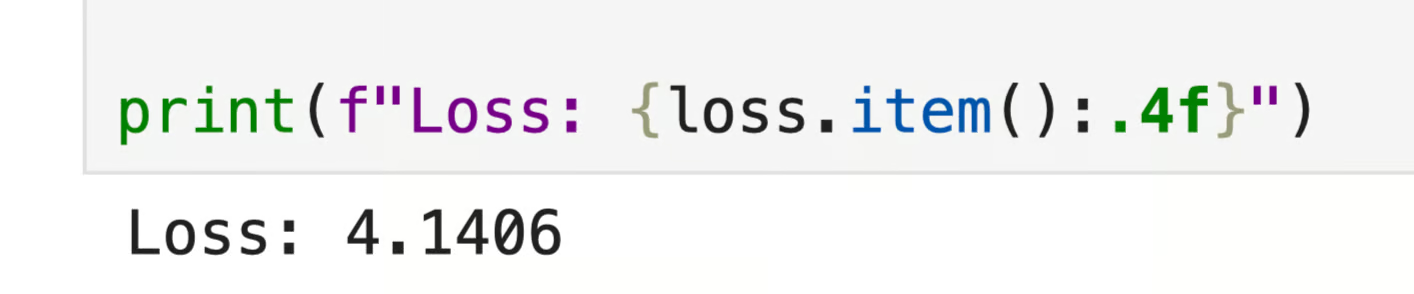
ผลลัพธ์วงรอบการเรียนรู้แบบเปรียบต่าง
นี่คือวงรอบแบบเปรียบต่างฉบับย่อที่สุด ในการใช้งานจริง x1 และ x2 จะเป็นมุมมองที่เพิ่มพูนสองแบบของอินพุตเดียวกัน ไม่ใช่สัญญาณรบกวนสุ่ม—แต่โครงสร้างคงเดิมทุกประการ
Contrastive learning เป็นแนวคิดง่ายๆ ที่ทรงอิทธิพลมาก
มันสอนให้โมเดลเข้าใจโครงสร้างผ่านการเปรียบเทียบ แทนที่จะพึ่งพาข้อมูลมีป้ายกำกับ ดันสิ่งที่เหมือนกันให้เข้ามาใกล้ ผลักสิ่งที่ต่างกันให้ออกห่าง—นี่คือสาระทั้งหมด และเพียงพอที่จะเรียนรู้การแทนค่าที่ถ่ายโอนข้ามงานได้ดี
แวดวงกำลังก้าวออกจากสายงานที่พึ่งพาการระบุป้ายกำกับอย่างหนัก และ contrastive learning คือเหตุผลสำคัญ อัลกอริทึมอย่าง SimCLR, MoCo และ CLIP ถูกนำไปใช้ในผลิตภัณฑ์จริง ซึ่งบอกอะไรบางอย่างเกี่ยวกับประสิทธิภาพของวิธีนี้
หากอยากลงลึก ขั้นตอนถัดไปที่ดีคือจับต้องอิมพลีเมนเทชันจริง ตัวอย่าง PyTorch ในบทความนี้เป็นจุดเริ่ม แต่การรัน SimCLR บนชุดข้อมูลภาพจริง—even ขนาดเล็ก—จะสอนอะไรได้มากกว่าคำอธิบายใดๆ
และหากต้องการทรัพยากรระดับสุดยอดสำหรับหัวข้อแมชชีนเลิร์นนิงขั้นสูง ลงทะเบียนหลักสูตรMachine Learning Scientist in Pythonของเรา
เรียนกับ DataCamp
Courses
Courses
Courses