courses
프롬프트 엔지니어링 이해하기
1
230.3K
처음 GPT-Live-1 브라우저 세션을 열었을 때, 저는 보통의 음성 루프—말하고, 기다리고, 답을 듣는—를 예상했습니다. 대신, assistant가 대답하는 동안에도 마이크는 계속 열려 있었습니다. 대화는 덜 경직되었지만, 앱은 여전히 그 뒤에서 일어나는 작업을 관리해야 했습니다.
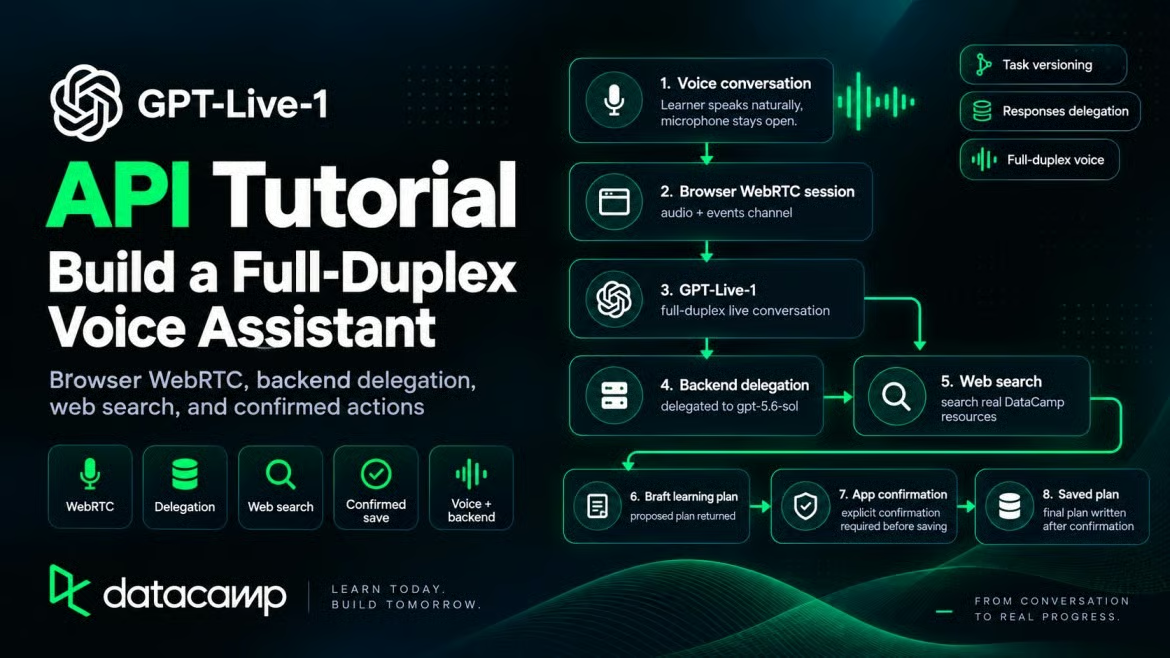
OpenAI는 먼저 7월에 ChatGPT에 GPT-Live를 도입한 뒤, 이번 주 초 API에 GPT-Live-1을 제공했습니다. 우리 GPT-Realtime-2.1 튜토리얼은 단일 모델 접근을 다루고, GPT Live Transcribe 가이드는 실시간 자막에 초점을 맞춥니다. 여기서는 실제 DataCamp 리소스를 검색하고, 확인 후에만 계획을 저장하는 음성 학습 assistant를 구축합니다.
저는 이를 DataCamp 음성 학습 assistant라고 부릅니다. 튜토리얼용 프로토타입이며, 프로덕션용 DataCamp AI Assistant는 아닙니다. 이 프로젝트는 한 학습자가 말한 목표에서 저장된 계획까지의 흐름을 따릅니다.
GPT-Live-1은 음성 교환을 백엔드 작업과 분리합니다. 다음 네 가지 관찰이 학습 assistant 설계를 이끕니다.
이 관찰들은 이 학습 계획 흐름에 적용됩니다. 프롬프트나 네트워크가 바뀌면 동작도 달라질 수 있으며, 클라이언트 위임은 제어 경계를 바꿉니다.
GPT-Live-1은 OpenAI의 전체 이중(Full‑Duplex) 음성 모델입니다. 발화 턴과 중단(사이의 침묵 포함)을 처리하고, 검색이나 도구 호출 같은 더 긴 작업은 백엔드로 보냅니다.
학습자에게 보이는 첫 차이는 그 침묵(멈춤)에서 드러납니다.
Full‑duplex는 턴 테이킹을 바꿉니다. 사용자는 생각하기 위해 멈추거나 assistant 말에 겹쳐 말할 수 있고, assistant는 멈춰 정정을 들을 수 있습니다. OpenAI의 프롬프트 가이드는 짧은 확인과 중단을 위한 프롬프트 섹션을 보여줍니다.
이는 학습 assistant에서 중요합니다. 커리어 목표를 설명하는 사람은 중간에 멈추거나 다시 시작하거나 제약을 추가할 수 있습니다. "음, 그러니까, 아마 주 5시간 정도" 같은 말을 기다려 주는 모델은 학습자가 생각을 소리 내어 정리하게 해 줍니다.
위임은 작업을 백엔드로 옮기지만, 애플리케이션 제어권까지 넘기지는 않습니다. 앱은 여전히 누가 동작할 수 있는지, 저장이 허용되는지를 결정합니다. 저장되는 작업 상태도 앱이 소유합니다.
GPT-Realtime-2.1을 사용해 보셨다면 GPT-Live-1이 이를 대체하는지 궁금할 수 있습니다. 그렇지 않습니다.
GPT-Realtime-2.1은 v1/realtime에서 청취, 추론, 도구 선택을 단일 모델로 처리하며 오디오 및 텍스트 토큰 기준으로 과금됩니다. GPT-Live-1은 v1/live/sessions를 사용하고, 음성 레이어는 초당 과금되며, 추론은 별도 백엔드로 보냅니다.
Realtime-2.1은 이전이거나 하위 옵션이 아닙니다. 설계 철학이 다릅니다.
앱은 말로 한 목표를 받아 실제 DataCamp 리소스의 정렬된 목록으로 바꿉니다. 백엔드 작업 동안 음성 세션은 열린 상태로 유지됩니다. 요청이 바뀌면, 백엔드 동작을 실행하기 전에 앱이 작업 버전을 업데이트합니다.
학습자가 앱에서 다시 확인하기 전까지는 아무것도 저장되지 않습니다.
브라우저 페이지는 WebRTC 연결과 마이크를 담당하고, 서버는 GPT-Live-1 세션을 생성하며 API 키를 보관합니다. Responses 백엔드(gpt-5.6-sol)는 웹 검색과 save_learning_plan 함수를 사용합니다. 현재 작업 버전과 확인된 계획은 앱 상태로 유지됩니다.
작업 버전은 검색 중 요청이 바뀌었을 때 앱이 어떤 백엔드 동작을 수용할지 결정합니다. 전체 실행 가능한 앱은 GitHub 저장소를 참고하세요. 다음 섹션은 GPT-Live 경로에 초점을 맞춥니다.
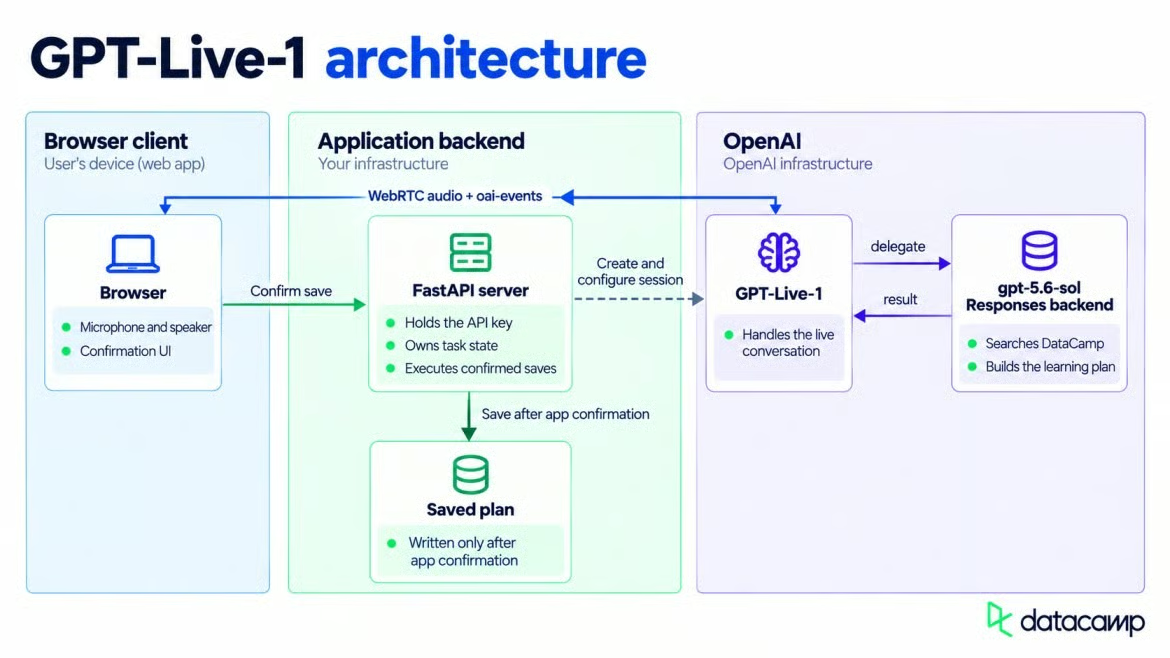
브라우저, GPT-Live-1, 백엔드 모델이 연결됩니다. 이미지: 작성자.
GPT-Live-1 접근 권한이 있는 OpenAI 프로젝트(무료 티어는 지원하지 않음), Python, 그리고 HTTPS 또는 localhost에서 실행되는 브라우저가 필요합니다(마이크 권한 팝업을 위해). 저는 Python 3.11과 openai 3.13.0을 사용했습니다. Live API는 최소 openai 3.12.0이 필요합니다. 구버전에는 클라이언트에 .live 속성이 없습니다.
동시 세션 제한은 사용 티어에 따라 다릅니다. 브라우저 탭을 많이 열기 전에 프로젝트 한도를 확인하세요.
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install openai fastapi uvicorn python-dotenv streamlit requests
macOS나 Linux에서는 source .venv/bin/activate 로 환경을 활성화하세요. 프로젝트 루트에 .env 파일을 만들고 다음 값을 추가합니다.
OPENAI_API_KEY=sk-...python-dotenv는 서버에서 임포트되는 순간 해당 파일을 자동으로 로드하므로, 키를 코드에 직접 넣을 필요가 없습니다.
OpenAI() 클라이언트도 키를 전달하지 않으면 동일한 환경 변수를 읽습니다.
브라우저는 프로젝트 키를 알 수 없습니다. 브라우저는 WebRTC offer를 서버로 전송하고, 서버는 그 키로 세션을 생성합니다. SDP 교환 후, 브라우저는 키를 받지 않은 채 WebRTC를 통해 OpenAI로 오디오를 보냅니다.
/api/session 내의 GPT-Live 호출은 SDP offer로부터 세션을 만듭니다. 이때 음성 지침, 백엔드 모델, 웹 검색, 저장 함수가 하나의 요청에 함께 전달됩니다.
result = client.live.create(
    session={
        "model": "gpt-live-1",
        "instructions": LIVE_INSTRUCTIONS,
        "delegation": {
            "type": "responses",
            "responses": {
                "model": "gpt-5.6-sol",
                "instructions": BACKEND_INSTRUCTIONS,
                "tools": [
                    {
                        "type": "web_search",
                        "filters": {
                            "allowed_domains": ["datacamp.com", "www.datacamp.com"]
                        },
                    },
                    SAVE_LEARNING_PLAN_TOOL,
                ],
                "tool_choice": "auto",
            },
        },
    },
    transport={"type": "webrtc", "sdp": sdp},
)
이 호출은 POST /v1/live/sessions 로 요청을 보내고, SDP answer와 함께 세션 ID를 반환합니다. HTTP 요청이 세션을 시작하므로, 이후에 별도의 session.start 이벤트를 보내지 마세요.
샘플 서버는 브라우저 요청을 localhost:8501과 127.0.0.1:8501에서만 허용합니다. 로컬 사용을 위한 규칙입니다.
앱을 배포한다면, 해당 오리진을 교체하고 /api/session과 /api/save-plan 모두에 인증을 적용하세요. 각 요청이 비용과 동시성을 소모하므로 세션 생성을 레이트 리밋하세요. 클라이언트는 confirmed: true를 스스로 전송할 수 있으므로, 공개 서버에서는 이 필드를 요청자의 신원 증거로 간주해서는 안 됩니다.
OpenAI의 WebRTC 가이드를 따르면, 브라우저는 마이크 접근 권한을 요청하고 RTCPeerConnection을 엽니다. 문서화된 oai-events 데이터 채널 라벨을 사용하고, SDP offer를 생성하기 전에 채널을 만드세요. 세션이 시작되면 이 채널이 양방향 JSON 이벤트를 전달합니다.
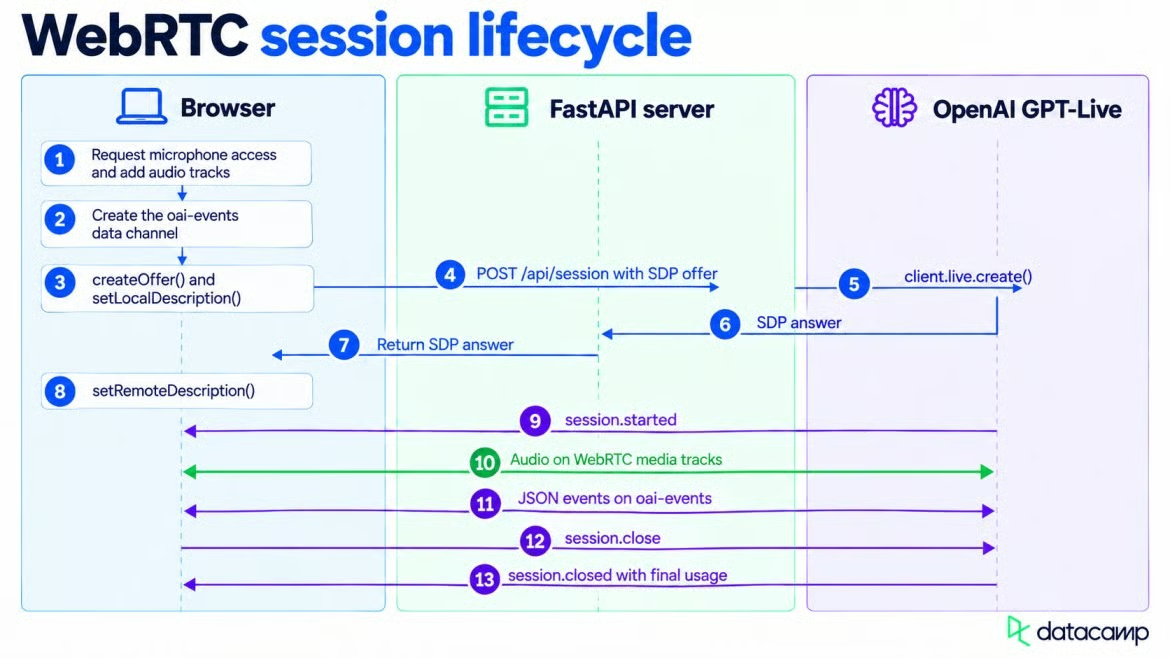
WebRTC는 시작하고, 오디오를 스트리밍한 뒤 종료합니다. 이미지: 작성자.
미디어 설정 자체는 일반적인 WebRTC입니다. GPT-Live 이벤트는 마지막 줄에서 생성한 데이터 채널을 사용합니다.
const connection = new RTCPeerConnection();
connection.addEventListener("track", (event) => {
  audio.srcObject = new MediaStream([event.track]);
  audio.play();
});
const microphone = await navigator.mediaDevices.getUserMedia({ audio: true });
for (const track of microphone.getAudioTracks()) {
  connection.addTrack(track, microphone);
}
const events = connection.createDataChannel("oai-events");
offer를 만든 뒤, 브라우저는 setLocalDescription() 을 호출하고 ICE 수집 완료를 기다립니다. 로컬 SDP를 /api/session으로 보낸 뒤, OpenAI의 answer를 setRemoteDescription()로 적용합니다. 마이크 오디오와 assistant 음성은 미디어 트랙을 통해 전송되므로 별도의 음성-텍스트 및 텍스트-음성 요청이 필요하지 않습니다.
오디오는 oai-events에 올리지 않습니다. WebRTC 데이터 채널에서 session.input_audio.append 를 보내거나 session.output_audio.delta 를 기다리지 마세요.
데이터 채널은 다른 타이밍 규칙을 따릅니다. session.started 이후에만 oai-events로 이벤트를 보내세요. 첫 시도에서는 너무 일찍 보냈고 연결이 이를 무시했습니다.
유용한 오류가 없어, 작은 순서 오류를 추적하는 데 애를 먹었습니다.
가시적인 자막이 필요 없다면, 이 하위 섹션은 건너뛰어도 됩니다. 오디오 연결은 이미 완성되었습니다.
session.input_transcript.delta와 session.output_transcript.delta 는 라이브 자막을 위한 밀리초 오프셋과 함께 텍스트 조각을 반환합니다. OpenAI 문서는 전사 조각이 완료된 턴이 아님을 경고합니다. 전달은 고르지 않을 수 있고, 사용자와 assistant의 전사 구간은 겹칠 수 있습니다.
전사 조각은 도착하는 대로 화면에 추가하되, 이를 근거로 백엔드 작업을 시작하지 마세요. 위임 시점은 모델이 결정합니다.
Live 모델의 지침은 짧게 유지하는 것이 좋습니다. OpenAI 가이드는 상세한 작업 단계를 백엔드 프롬프트에 두라고 권장합니다. 저는 작업 절차를 백엔드에 두고, Live 프롬프트는 음성에 집중하도록 했습니다.
이 발췌는 음성 동작을 학습 계획 작업과 분리합니다. 발화 규칙은 위임을 트리거하는 조건 위에 둡니다.
You are Sage, a warm, encouraging voice learning coach for DataCamp learners.
Speak naturally at an unhurried pace. Be clear and direct, not overly cheerful.

Backchannel policy: Use moderate backchannels without competing with the response.
Interruption policy: Stop speaking when the learner interrupts, and listen.

Delegation policy:
Backend tools:
- learning_plan_research: search DataCamp resources and assemble a personalized learning plan.
- save_learning_plan: propose the current plan for app confirmation when the learner asks to save.

Delegate to the backend when:
- The learner states or changes a goal, skill level, or weekly time.
- A correction changes the plan already requested.
- The learner asks to save the plan.

Do not delegate for greetings, small clarifications, or a result already given.

Saving: a proposed save only asks the app to confirm. Do not say the plan is saved until the app reports a saved result.
After a save, keep the conversation open and ask what the learner wants next.
이 규칙은 인사는 Live 레이어에 남기고, 연구나 저장 요청은 백엔드로 보냅니다. 확인은 여전히 앱의 몫입니다.
백채널과 중단 라인은 멈춤 주변에서 assistant가 어떻게 반응할지 지시합니다. "적당한 백채널"은 모든 침묵을 채우지 않으면서 가끔 "음‑흠" 같은 확인을 요청합니다. 학습자가 생각할 여지를 주기 위해 그렇게 설정했습니다. 멈춤이 더 긴 수업이라면 확인 빈도를 더 줄일 수 있습니다.
앱에 다른 동작이 필요하다면 해당 줄을 바꾸세요. "사용자가 말하는 동안 결코 말하지 않는다"를 추가하면 백채널도 사라집니다.
두 프롬프트의 역할은 다릅니다. Live 프롬프트는 발화와 핸드오프를, 백엔드 프롬프트는 연구와 답변 형식을 제어합니다. OpenAI 가이드는 상세 검색 단계를 음성 지침에 넣지 말라고 권합니다.
앞서 설명한 분리는 세션의 delegation 필드에 나타납니다. 학습자가 목표를 말하면, GPT-Live는 우리 코스 카탈로그를 검색하고 계획을 만들 수 있는 모델에 작업을 보냅니다.
GPT-Live-1은 Responses 위임과 클라이언트 위임을 제공합니다. Responses 위임은 OpenAI가 백엔드 호출을 관리하고, 클라이언트 위임은 이를 사용자 코드로 넘깁니다. 이 앱에서는 추가 백엔드 루프를 피하기 위해 Responses 위임을 사용했습니다.
저는 gpt-5.6-sol을 사용했습니다. OpenAI 위임 가이드는 시작 예제로 gpt-5.6-terra 를 사용하며, 비용이 낮은 작업에는 gpt-5.6-luna를 제시합니다. Sol에서는 백엔드가 요청한 계획 구조를 반환했습니다.
백엔드가 웹 검색 또는 저장 함수를 선택할 수 있도록 tool_choice 를 auto 로 유지하세요. 위임 모드는 시작 시 고정됩니다. 클라이언트 위임으로 전환하려면 현재 세션을 닫고 새로 만드세요.
Live 프롬프트의 규칙은 단순합니다. 인사와 짧은 질문은 Live 모델이 처리하고, 학습 계획이나 그 변경은 백엔드로 보냅니다. API에서 그 경계를 강제하진 않습니다. 앱이 받을 요청 유형으로 테스트하세요. 선택은 모델이 스스로 합니다.
위임되면, 백엔드의 임무는 하나입니다. 학습자의 목표를 링크가 포함된 짧은 DataCamp 리소스 목록으로 바꾸는 것입니다. 저는 web_search 도구에 filters.allowed_domains 를 datacamp.com과 www.datacamp.com로 설정했습니다. 이 필터는 검색 지침일 뿐, 모든 링크의 정확성을 보증하지는 않는다고 봐야 합니다.
예시 목표는 주당 5시간, 약간의 Python 지식, SQL 경험 없음으로 데이터 엔지니어링 경로를 요청합니다. 응답은 How to Learn Data Engineering From Scratch in 2026 및 Associate Data Engineer in SQL 트랙으로 시작합니다.
나머지는 프로젝트, Python 데이터베이스 코스, 다른 트랙, 마지막 파이프라인 프로젝트가 섞여 있습니다. 나열된 모든 URL은 실제 DataCamp 페이지로 열립니다.
백엔드 프롬프트는 4~7개의 순서 있는 항목을 요청합니다. 각 항목은 제목, URL, 간단한 이유와 course, project, track, article 유형을 가집니다. 구성은 학습자가 밝힌 형식 선호와 주당 시간에 따릅니다.
페이지에 명시되지 않은 경우 코스 소요 시간을 모델이 추정하라고 하지는 않았습니다. 그 경우의 정확한 수치는 출처를 넘어서는 주장일 수 있기 때문입니다.
GPT-Live는 Responses 백엔드가 동작하는 동안에도 음성 세션을 유지할 수 있습니다. 학습자가 첫 계획이 돌아오기 전에 실습 중심 제약을 추가해도, 원래 백엔드 작업은 자동으로 취소되지 않습니다.
음성 정정은 이미 시작된 백엔드 작업을 자동으로 취소하거나 재작성하지 않습니다. assistant의 말을 중단하는 것과 작업을 변경하는 것은 별개의 동작입니다. 오래된 결과를 어떻게 처리할지는 애플리케이션이 결정합니다.
서버는 task_version 카운터를 추적하고, 새로운 위임이 시작될 때마다 증가시킵니다. 결과가 도착하면 앱은 실행 전에 버전을 확인합니다. 핸들러는 오래된 결과를 로깅만 하고 실행하지 않습니다.
Responses 위임에는 한계가 있습니다. Live 모델이 백엔드 결과를 직접 받기 때문에, 버전 검사가 다음 발화 내용을 완전히 제어하진 못합니다. 클라이언트 위임은 결과가 모델에 도달하기 전에 오래된 결과를 폐기할 수 있습니다. 따라서 작업 버전은 앱 동작을 보호하지만, assistant가 말할 모든 단어를 보호하지는 못합니다.
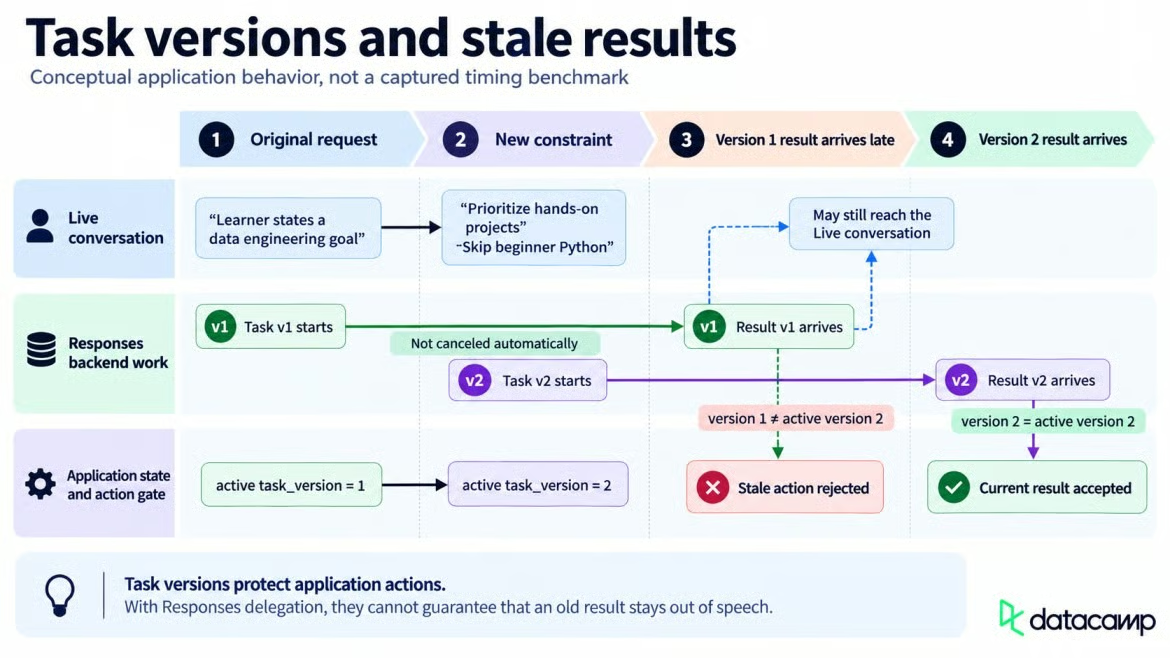
작업 버전은 더 새로운 제약을 활성 상태로 유지합니다. 이미지: 작성자.
첫 백엔드 응답이 완료된 후, 저는 실습 중심 프로젝트와 초급 Python 제외를 요청했습니다. 수정된 7개 항목 계획은 Introduction to SQL로 시작했고, 하나의 트랙, 두 개의 코스, 네 개의 프로젝트(Exploring London's Travel Network, Building a Retail Data Pipeline 포함)으로 구성되었습니다. 이는 완료된 턴 간의 수정 가능성을 보여줄 뿐, 진행 중 응답 중단에 대해서는 말해주지 않습니다.
백엔드 작업 중에는 세 가지 append 이벤트로 Live 모델을 업데이트할 수 있습니다. session.thinking.append 는 발화하지 말아야 할 컨텍스트를 추가하고, session.commentary.append 는 모델이 자신의 말로 전달해야 할 내용을 추가하며, session.instructions.append는 지침을 변경합니다.
각 append는 최대 500토큰의 일반 문자열을 담습니다. 이 이벤트들은 Live 모델의 문맥이나 동작을 업데이트하지만, 이미 실행 중인 백엔드 Responses 작업을 수정하거나 취소하지는 않습니다. 지침은 현재 Live 동작을 재지시할 수 있고, commentary는 모델이 소리 내어 전달해야 할 정보를 제공합니다.
대시보드는 백엔드 진행 상황을 기록하지만 이러한 append 이벤트는 보내지 않습니다. Responses 위임을 사용할 때도, 앱에서 발생한 업데이트를 oai-events로 전송할 수 있지만, 이때는 delegation_id: null을 사용합니다. null이 아닌 delegation ID는 클라이언트 위임 작업에 사용됩니다.
task_id 와 task_version 은 delegation_id 대신 애플리케이션 상태로 보관하세요.
이 앱에서는 모델의 답변만으로는 아무것도 저장되지 않습니다. 백엔드는 save_learning_plan 으로 보류 중 동작을 제안하고, 실제 쓰기는 /api/save-plan이 담당합니다.
백엔드 함수 호출은 response.event 내부에 도착합니다. 핸들러는 중첩된 response.output_item.done 항목을 기다린 뒤, 그 call_id, name, arguments를 읽습니다.
완료된 항목을 기다리는 것이 중요합니다. 초기 이벤트에는 호출의 일부만 있을 수 있습니다. 앱은 인수를 파싱하지만 아직 함수를 실행하지는 않습니다.
SAVE_LEARNING_PLAN_TOOL = {
    "type": "function",
    "name": "save_learning_plan",
    "description": "Propose the current learning plan for confirmation when the learner asks to save.",
    "parameters": {
        "type": "object",
        "properties": {
            "goal": {"type": "string"},
            "weekly_hours": {"type": "number"},
            "items": {
                "type": "array",
                "items": {
                    "type": "object",
                    "properties": {
                        "title": {"type": "string"},
                        "url": {"type": "string"},
                        "reason": {"type": "string"},
                        "type": {
                            "type": "string",
                            "enum": ["course", "project", "track", "article"],
                        },
                    },
                    "required": ["title", "url", "reason", "type"],
                    "additionalProperties": False,
                },
            },
        },
        "required": ["goal", "weekly_hours", "items"],
        "additionalProperties": False,
    },
    "strict": True,
}
이 스키마는 앱이 확인을 요청하기 전에 보여줄 고정 필드 집합을 제공합니다. type 필드는 저장 데이터에서 코스, 프로젝트, 트랙, 아티클을 명시적으로 유지합니다.
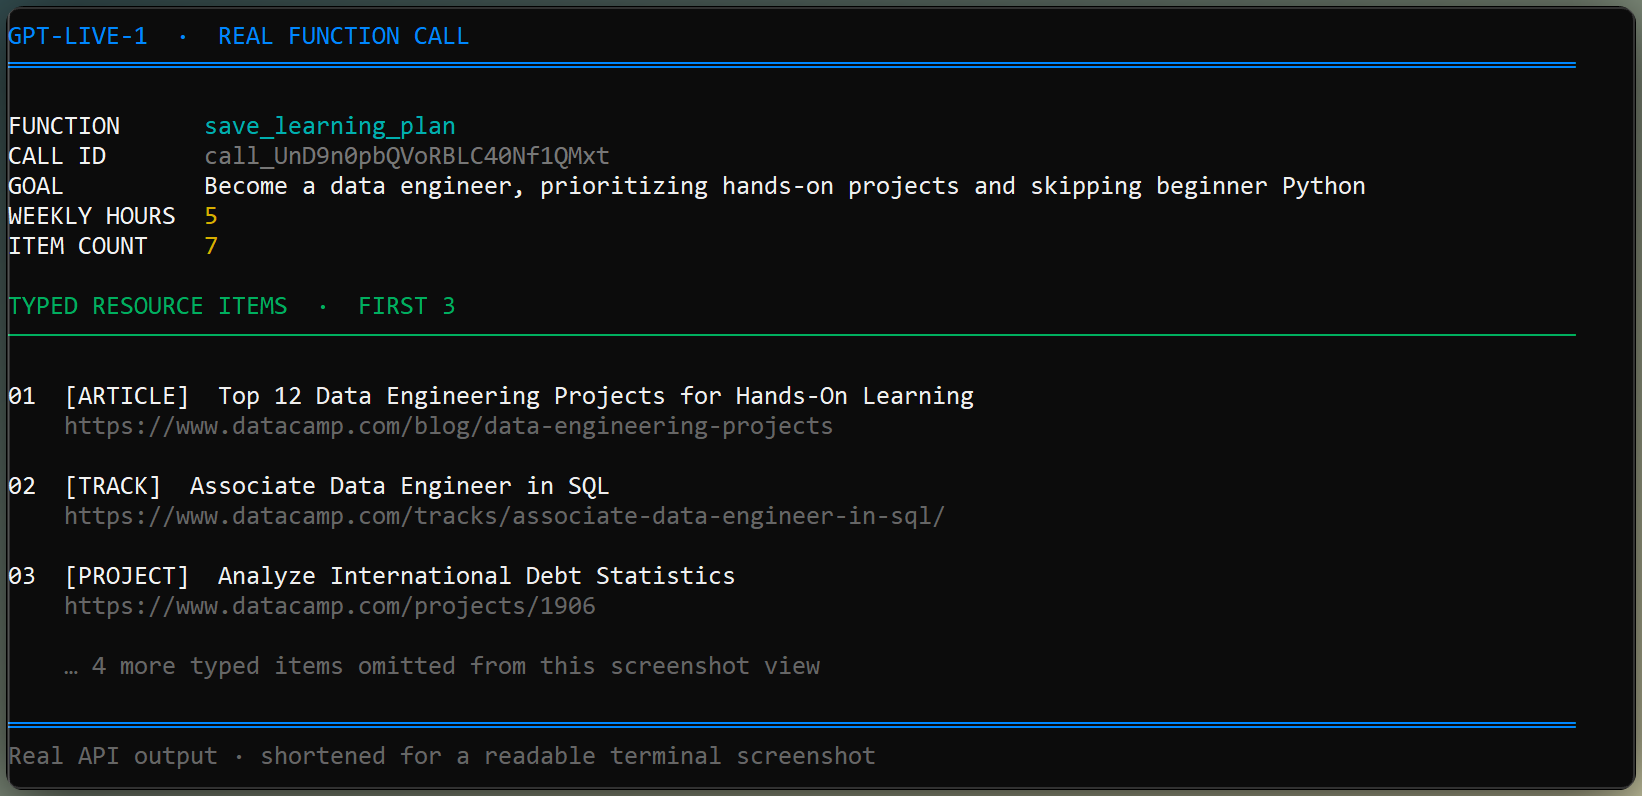
터미널에 타입이 명시된 저장 함수 인수가 표시됩니다. 이미지: 작성자.
학습자가 저장을 요청하면, 백엔드는 전체 계획으로 save_learning_plan을 호출합니다. 위젯은 그 인수를 저장하고 확인 상자를 표시하지만, 이 호출은 여전히 제안에 불과합니다.
그 함수 호출을 응답 없이 두면 위임된 응답과 이후 백엔드 턴이 막힙니다. 위젯은 즉시 "확인 대기" 결과로 응답한 뒤, 대화를 이어갈 수 있도록 response.create를 전송합니다.
events.send(JSON.stringify({
  type: "response.item.create",
  item: {
    type: "function_call_output",
    call_id: callId,
    output: JSON.stringify({
      status: "awaiting_user_confirmation",
      saved: false,
    }),
  },
}));
events.send(JSON.stringify({ type: "response.create" }));
이 시점에서는 어떤 파일도 쓰이지 않습니다. assistant는 이후 위임 작업을 막지 않으면서 학습자에게 확인 및 저장 버튼을 안내할 수 있습니다.
/api/save-plan 엔드포인트는 confirmed가 true가 아니면 쓰기를 거부합니다. 전사는 틀리거나 불완전할 수 있으므로, 음성 요청만으로는 계획을 저장하지 않습니다.
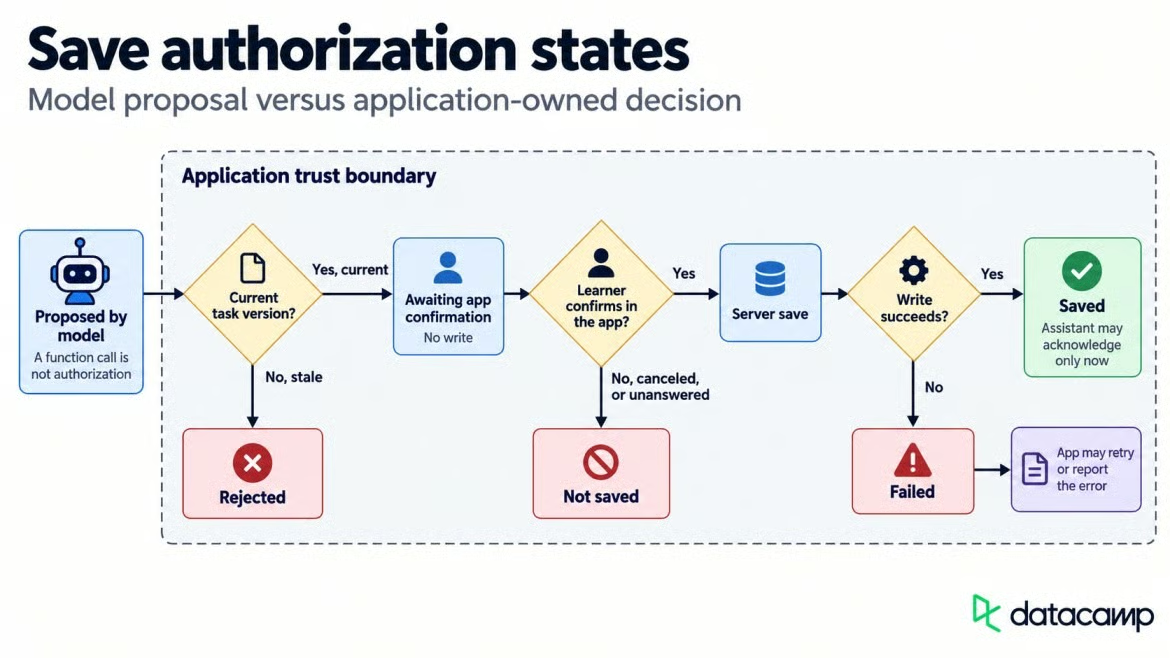
확인이 요청과 저장된 동작을 분리합니다. 이미지: 작성자.
확인 클릭은 /api/save-plan 에 보류 중 계획과 confirmed: true를 전송합니다. 서버가 계획 ID를 반환하면, 위젯은 원래 함수 호출이 이미 응답되었으므로 delegation_id: null 로 session.commentary.append 를 보냅니다.
const saveResponse = await fetch(${SERVER}/api/save-plan, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    confirmed: true,
    plan: pendingFunctionCall.args,
  }),
});
const saveResult = await saveResponse.json();

events.send(JSON.stringify({
  type: "session.commentary.append",
  delegation_id: null,
  content: The plan was saved as ${saveResult.plan_id}.,
}));
commentary 업데이트는 Live 모델에 완료된 쓰기를 알려, 저장 사실을 음성으로 확인하게 합니다. 이전 함수 호출은 닫힌 상태를 유지하며, 음성 세션은 학습자의 다음 요청을 위해 계속 열려 있습니다.
앞서 링크한 GitHub 저장소에는 FastAPI 서버, Streamlit 인터페이스, 그리고 app/ 내부 WebRTC 위젯이 포함되어 있습니다. 클론한 뒤, 해당 폴더에서 두 개의 터미널을 여세요. 하나에서는 uvicorn server:app --host 127.0.0.1 --port 8000을, 다른 하나에서는 streamlit run streamlit_app.py 를 실행하세요.
Streamlit 인터페이스는 빌드 전반에 걸쳐 사용한 동일한 서버와 위젯을 래핑합니다. 라이브 대화를 학습 계획과 백엔드 활동 옆에 배치하며, 대시보드는 통화를 리셋하지 않고 업데이트됩니다.
아래 영상은 말로 한 목표, 백엔드 검색, 수정된 계획, 확인된 저장까지를 보여줍니다. 저장 후에도 통화는 열려 있어 학습을 이어갈 수 있습니다.
DataCamp와 함께 배우기
courses
courses
courses