Corso
Comprendere l'ingegneria del prompt
1 h
230.3K
La prima volta che ho aperto una sessione GPT-Live-1 nel browser, mi aspettavo il solito loop vocale: parla, aspetta, poi ascolta la risposta. Invece, il microfono è rimasto aperto mentre l’assistente rispondeva. La conversazione sembrava meno rigida, ma l’app doveva comunque gestire il lavoro che avveniva dietro le quinte.
OpenAI ha introdotto per la prima volta GPT-Live in ChatGPT a luglio, poi ha portato GPT-Live-1 nell’API all’inizio di questa settimana, proprio prima che iniziassi questo progetto. Il nostro tutorial su GPT-Realtime-2.1 copre l’approccio a modello unico, mentre la nostra guida a GPT Live Transcribe si concentra sui sottotitoli live. Qui costruirai un assistente vocale per l’apprendimento che cerca risorse reali di DataCamp e salva un piano solo dopo la conferma.
Lo chiamo DataCamp Voice Learning Assistant. È un prototipo per il tutorial, non il DataCamp AI Assistant in produzione. Il progetto segue un learner da un obiettivo espresso a voce fino a un piano salvato.
GPT-Live-1 separa lo scambio parlato dal lavoro del backend. Quattro constatazioni guidano l’assistente per l’apprendimento.
Queste osservazioni valgono per questo flusso di piano di apprendimento. Un prompt o una rete diversi possono cambiare il comportamento, e la delega lato client cambia il perimetro di controllo.
GPT-Live-1 è il modello vocale full‑duplex di OpenAI. Gestisce turni e interruzioni a voce, incluse le pause tra di essi, e invia lavori più lunghi come ricerche o chiamate a strumenti a un backend.
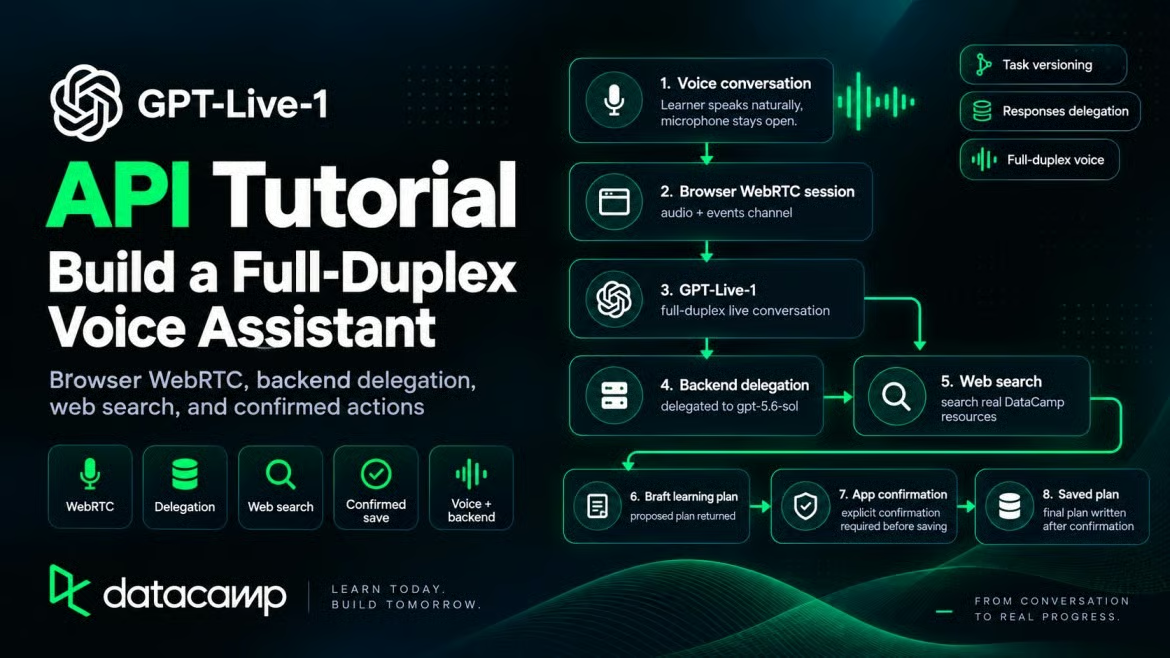
Per chi impara, la prima differenza visibile è proprio in quelle pause.
Il full duplex cambia la presa di turno. Puoi fermarti a pensare o parlare sopra l’assistente, e lui può interrompersi per ascoltare la correzione. La guida ai prompt di OpenAI mostra sezioni per brevi riscontri e interruzioni.
Questo conta in un assistente per l’apprendimento. Chi descrive un obiettivo di carriera può fermarsi, ricominciare o aggiungere un vincolo a metà. Un modello che aspetta attraverso “beh, credo, magari cinque ore a settimana” lascia spazio per pensare a voce alta.
La delega sposta un task al backend, ma non cede il controllo dell’applicazione. L’app decide ancora chi può agire e se è consentito un salvataggio. Inoltre detiene lo stato del task memorizzato.
Se hai usato GPT-Realtime-2.1, potresti chiederti se GPT-Live-1 lo sostituisca. Non è così.
GPT-Realtime-2.1 gestisce ascolto, ragionamento e selezione degli strumenti in un unico modello su v1/realtime, con tariffazione per token audio e testuali. GPT-Live-1 usa v1/live/sessions, tariffa il layer vocale al secondo e invia il ragionamento a un backend separato.
Realtime-2.1 non è un’opzione più vecchia o inferiore. Usa un design diverso.
L’app prende un obiettivo espresso a voce e lo trasforma in un elenco ordinato di risorse reali di DataCamp. La sessione vocale resta aperta durante il lavoro del backend. Quando la richiesta cambia, l’app aggiorna la sua versione del task prima di eseguire un’azione di backend.
Non viene scritto nulla finché chi apprende non conferma di nuovo nell’app.
La pagina del browser mantiene la connessione WebRTC e il microfono, mentre il server crea la sessione GPT-Live-1 e detiene la chiave API. Un backend Responses (gpt-5.6-sol) usa la ricerca sul web e la funzione save_learning_plan . La versione corrente del task e il piano confermato restano nello stato dell’app.
La versione del task decide quale azione di backend l’app accetti quando una richiesta cambia durante una ricerca. Usa il repository GitHub per l’app completa eseguibile; le prossime sezioni si concentrano sul percorso GPT-Live.
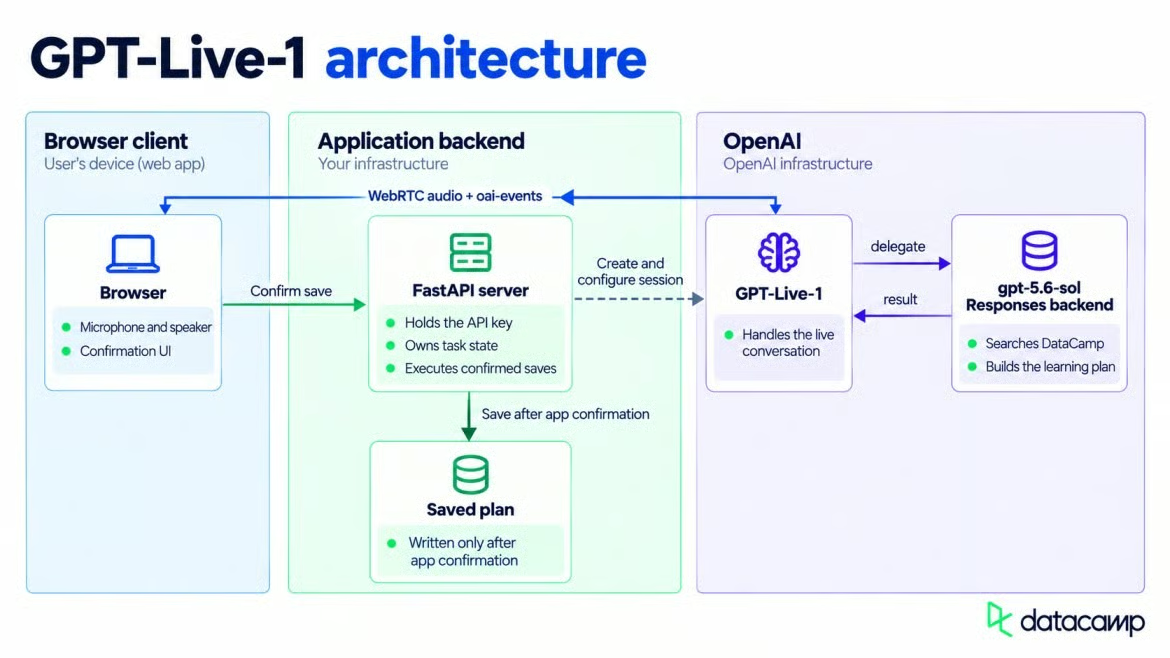
Browser, GPT-Live-1 e modello backend si connettono. Immagine dell’autore.
Ti serve un progetto OpenAI con accesso a GPT-Live-1 (il livello gratuito non lo supporta), Python e un browser in esecuzione su HTTPS o localhost affinché appaia il prompt del microfono. Ho usato Python 3.11 e openai 3.13.0. La Live API richiede almeno openai 3.12.0; le versioni precedenti non hanno l’attributo .live sul client.
I limiti di sessioni concorrenti dipendono dal tuo livello di utilizzo. Controlla il limite del progetto prima di aprire molte schede del browser.
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install openai fastapi uvicorn python-dotenv streamlit requests
Su macOS o Linux, attiva l’ambiente con source .venv/bin/activate invece. Crea un file .env alla radice del progetto e aggiungi questo valore.
OPENAI_API_KEY=sk-...python-dotenv carica quel file automaticamente una volta che il server lo importa, quindi la chiave non deve mai comparire nel codice.
Il client OpenAI() legge la stessa variabile d’ambiente quando non passi una chiave.
Il browser non vede mai la tua chiave di progetto. Invia un’offerta WebRTC al tuo server, che usa la chiave per creare la sessione. Dopo lo scambio SDP, il browser invia l’audio a OpenAI tramite WebRTC senza ricevere quella chiave.
La chiamata GPT-Live all’interno di /api/session crea la sessione dall’offerta SDP. Passa le istruzioni vocali, il modello backend, la ricerca sul web e la funzione di salvataggio nella stessa richiesta.
result = client.live.create(
    session={
        "model": "gpt-live-1",
        "instructions": LIVE_INSTRUCTIONS,
        "delegation": {
            "type": "responses",
            "responses": {
                "model": "gpt-5.6-sol",
                "instructions": BACKEND_INSTRUCTIONS,
                "tools": [
                    {
                        "type": "web_search",
                        "filters": {
                            "allowed_domains": ["datacamp.com", "www.datacamp.com"]
                        },
                    },
                    SAVE_LEARNING_PLAN_TOOL,
                ],
                "tool_choice": "auto",
            },
        },
    },
    transport={"type": "webrtc", "sdp": sdp},
)
Quella chiamata invia una richiesta a POST /v1/live/sessions e restituisce un ID sessione con una risposta SDP. La richiesta HTTP avvia la sessione, quindi non inviare un evento session.start separato dopo.
Il server di esempio accetta richieste dal browser solo da localhost:8501 e 127.0.0.1:8501. Questa regola è per l’uso locale.
Se distribuisci l’app, sostituisci quegli origin e autentica sia /api/session sia /api/save-plan. Limita la frequenza di creazione delle sessioni perché ogni richiesta può spendere denaro e consumare concorrenza. Un client può inviare confirmed: true da solo, quindi un server pubblico non può trattare quel campo come prova di chi ha fatto la richiesta.
Seguendo la guida WebRTC di OpenAI, il browser chiede l’accesso al microfono e apre un RTCPeerConnection. Usa l’etichetta del data channel documentata oai-events e crealo prima di generare l’offerta SDP. Quel canale trasporta eventi JSON in entrambe le direzioni una volta avviata la sessione.
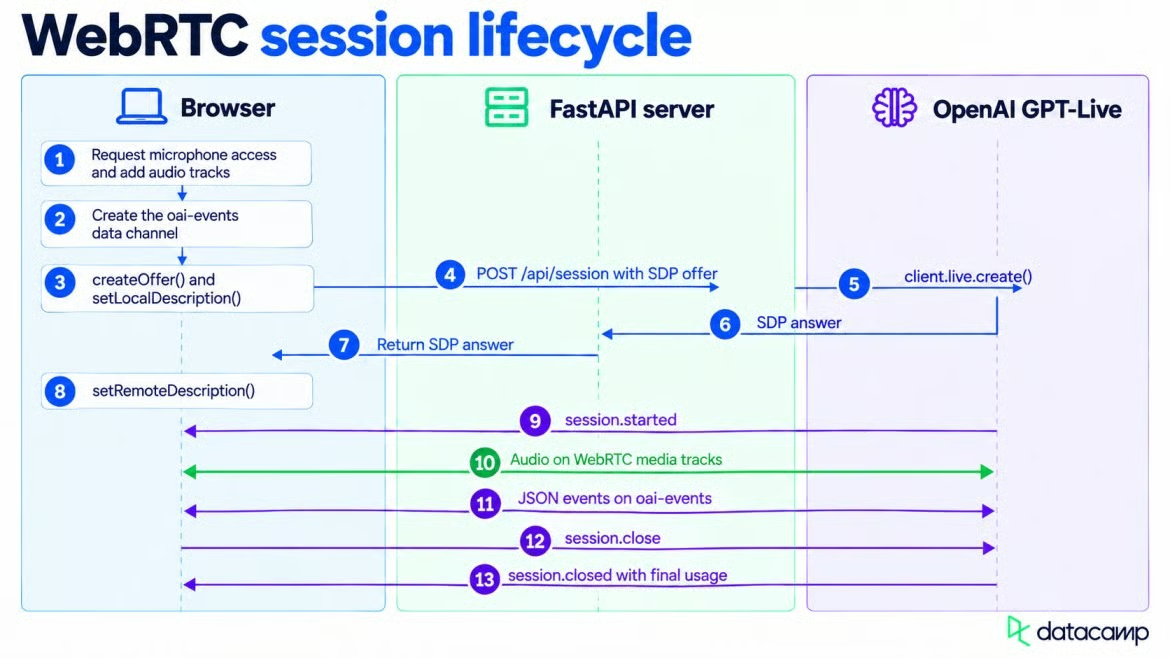
WebRTC avvia, trasmette audio, poi chiude. Immagine dell’autore.
La configurazione dei media è il normale WebRTC. Gli eventi GPT-Live usano il data channel creato all’ultima riga.
const connection = new RTCPeerConnection();
connection.addEventListener("track", (event) => {
  audio.srcObject = new MediaStream([event.track]);
  audio.play();
});
const microphone = await navigator.mediaDevices.getUserMedia({ audio: true });
for (const track of microphone.getAudioTracks()) {
  connection.addTrack(track, microphone);
}
const events = connection.createDataChannel("oai-events");
Dopo aver creato l’offerta, il browser chiama setLocalDescription() e attende la fine dell’ICE gathering. Invia l’SDP locale a /api/session, quindi applica la risposta di OpenAI con setRemoteDescription(). L’audio del microfono e la voce dell’assistente viaggiano sulle tracce media, quindi non servono richieste separate di speech-to-text e text-to-speech.
L’audio non appartiene a oai-events. Non inviare session.input_audio.append né aspettare session.output_audio.delta su un data channel WebRTC.
Il data channel segue una regola di timing diversa. Aspetta session.started prima di inviare un evento tramite oai-events. Al mio primo tentativo, ne ho inviato uno troppo presto e la connessione l’ha ignorato.
Non ho ricevuto errori utili, il che ha reso fastidioso individuare un piccolo errore d’ordine.
Se non ti servono sottotitoli visibili, puoi saltare questa sottosezione; la connessione audio è già completa.
session.input_transcript.delta e session.output_transcript.delta restituiscono frammenti di testo con offset in millisecondi per i sottotitoli live. La documentazione di OpenAI avverte che i frammenti del transcript non sono turni conclusi. La consegna può essere irregolare e gli intervalli di transcript di utente e assistente possono sovrapporsi.
Accoda i frammenti a schermo man mano che arrivano, ma non avviare da essi il lavoro del backend. È il modello a decidere quando delegare.
Le istruzioni del modello Live dovrebbero essere brevi. La guida di OpenAI colloca i passaggi dettagliati del task nel prompt del backend. Ho mantenuto lì la procedura del task e lasciato il prompt Live focalizzato sulla voce.
Questo estratto mantiene il comportamento vocale separato dal task del piano di apprendimento. Le regole di parlato restano sopra le condizioni che attivano la delega.
You are Sage, a warm, encouraging voice learning coach for DataCamp learners.
Speak naturally at an unhurried pace. Be clear and direct, not overly cheerful.

Backchannel policy: Use moderate backchannels without competing with the response.
Interruption policy: Stop speaking when the learner interrupts, and listen.

Delegation policy:
Backend tools:
- learning_plan_research: search DataCamp resources and assemble a personalized learning plan.
- save_learning_plan: propose the current plan for app confirmation when the learner asks to save.

Delegate to the backend when:
- The learner states or changes a goal, skill level, or weekly time.
- A correction changes the plan already requested.
- The learner asks to save the plan.

Do not delegate for greetings, small clarifications, or a result already given.

Saving: a proposed save only asks the app to confirm. Do not say the plan is saved until the app reports a saved result.
After a save, keep the conversation open and ask what the learner wants next.
Queste regole lasciano i saluti nel layer Live e inviano al backend le richieste di ricerca o salvataggio. La conferma resta comunque di competenza dell’app.
Le righe su backchannel e interruzioni dicono all’assistente come reagire attorno alle pause. “Backchannel moderati” chiede riscontri occasionali come “mm-hmm” senza riempire ogni silenzio. Ho scelto quel livello per lasciare spazio al learner; una lezione con pause più lunghe può richiedere meno riscontri.
Modifica quella riga se la tua app richiede un comportamento diverso; aggiungere “non parlare mai mentre parla l’utente” rimuove anche i backchannel.
I due prompt hanno compiti diversi. Il prompt Live controlla parlato e handoff, mentre il prompt del backend controlla ricerca e formato della risposta. La guida di OpenAI sconsiglia di inserire passaggi di ricerca dettagliati nelle istruzioni vocali.
La separazione descritta prima appare nel campo delegation della sessione. Quando il learner dichiara un obiettivo, GPT-Live invia il task a un modello che può cercare nel nostro catalogo corsi e creare il piano.
GPT-Live-1 offre delega Responses e delega client. La delega Responses lascia a OpenAI la gestione della chiamata di backend, mentre la delega client la affida al tuo codice. Ho usato la delega Responses perché evita un altro loop di backend in questa app.
Ho usato gpt-5.6-sol. La guida alla delega di OpenAI usa gpt-5.6-terra come esempio iniziale e cita gpt-5.6-luna per task a costo inferiore. Con Sol, il backend ha restituito la struttura di piano richiesta.
Mantieni tool_choice su auto così il backend può scegliere tra ricerca web o funzione di salvataggio. La modalità di delega è fissata all’avvio; passa alla delega client chiudendo la sessione corrente e creandone un’altra.
La regola nel prompt Live è semplice: saluti e domande brevi restano al modello Live, mentre un piano di apprendimento o una modifica a quel piano vanno al backend. Nulla nell’API impone quel confine. Provalo con i tipi di richieste che riceverà la tua app, perché è il modello a fare la scelta.
Una volta delegato, il backend ha un compito: trasformare l’obiettivo del learner in un breve elenco di risorse DataCamp con link. Gli ho dato lo strumento web_search con filters.allowed_domains impostato su datacamp.com e www.datacamp.com. Considera quel filtro come un’istruzione di ricerca, non la prova che ogni link sia corretto.
L’obiettivo di esempio chiede un percorso di data engineering con 5 ore a settimana, qualche conoscenza di Python e nessuna esperienza con SQL. La risposta inizia con How to Learn Data Engineering From Scratch in 2026 e il track Associate Data Engineer in SQL.
Gli elementi rimanenti mescolano un progetto, un corso su database in Python, un altro track e un progetto finale di pipeline. Ogni URL elencato apre una pagina esistente su DataCamp.
Il prompt del backend chiede da quattro a sette elementi ordinati. Ogni elemento ha un titolo, un URL, una breve motivazione e un tipo tra course, project, track o article. Il mix segue la preferenza di formato dichiarata dal learner e il tempo settimanale.
Non ho chiesto al modello di stimare la durata di un corso quando la pagina non la indica. Un numero esatto in quel caso affermerebbe più di quanto supporti la fonte.
GPT-Live può mantenere attiva la sessione vocale mentre il backend Responses lavora. Se il learner aggiunge il vincolo “hands-on” prima che torni il primo piano, il lavoro di backend originale non viene annullato automaticamente.
Una correzione a voce non annulla automaticamente o riscrive il lavoro che il backend ha già iniziato. Interrompere la voce dell’assistente e cambiare il task sono azioni separate. L’applicazione decide cosa fare del risultato precedente.
Il server tiene traccia di un contatore task_version e lo incrementa ogni volta che parte una nuova delega. Quando arriva un risultato, l’app ne verifica la versione prima di agire; il suo stesso handler registra un risultato vecchio e non lo esegue.
La delega Responses ha un limite qui: il modello Live riceve direttamente il risultato del backend, quindi il controllo di versione non può governare pienamente la sua prossima risposta parlata. La delega client permette al tuo codice di scartare un vecchio risultato prima che raggiunga il modello. La versione del task, quindi, protegge le azioni dell’app, non ogni parola che l’assistente potrebbe dire.
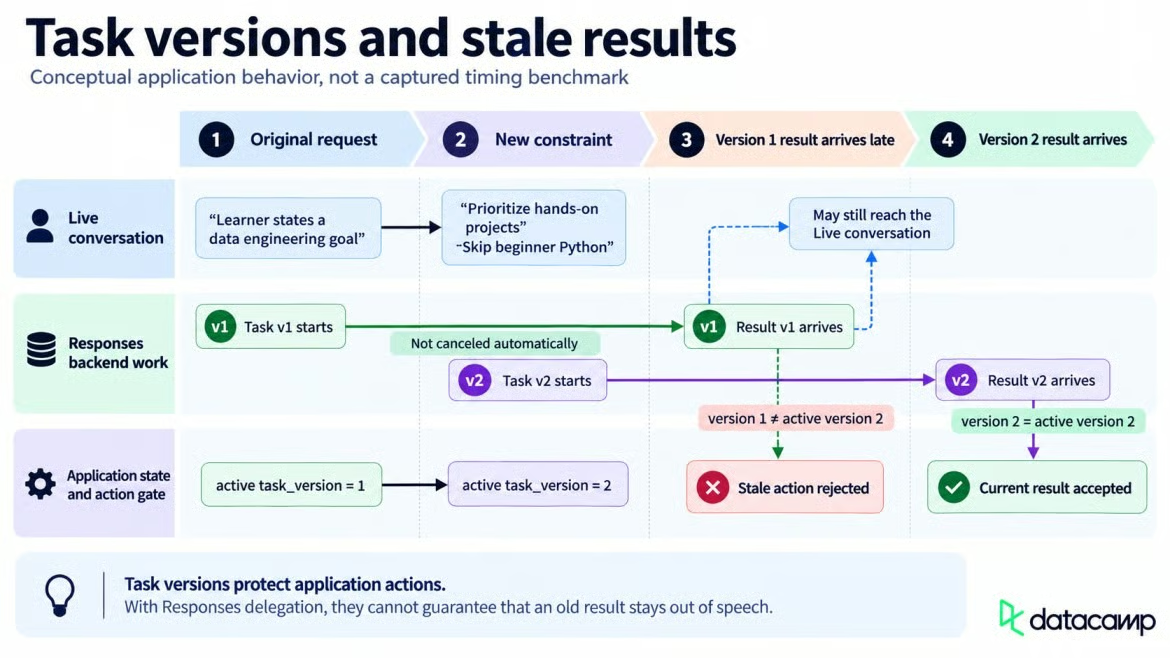
Le versioni di task mantengono attivi i vincoli più recenti. Immagine dell’autore.
Dopo che la prima risposta del backend è stata completata, ho inviato un seguito chiedendo progetti pratici e niente Python per principianti. Il piano rivisto in sette elementi è partito con Introduction to SQL, poi ha mescolato un track, due corsi e quattro progetti, tra cui Exploring London's Travel Network e Building a Retail Data Pipeline. Questo mostra una revisione tra turni conclusi; non dice nulla sul fermare una risposta in corso.
Durante il lavoro del backend, tre eventi di append possono aggiornare il modello Live. session.thinking.append aggiunge contesto che non deve essere detto, session.commentary.append aggiunge testo che il modello deve dire con parole proprie, e session.instructions.append cambia le sue istruzioni.
Ogni append trasporta una stringa semplice di massimo 500 token. Questi eventi aggiornano il contesto o il comportamento del modello Live; non modificano né annullano un task Responses già in esecuzione. Un’istruzione può reindirizzare il comportamento Live attuale, mentre il commentary fornisce informazioni che il modello dovrebbe comunicare a voce.
La dashboard registra l’avanzamento del backend ma non invia questi eventi di append. Con la delega Responses, aggiornamenti dalla tua app possono comunque essere inviati tramite oai-events, ma usano delegation_id: null. Gli ID di delega non nulli sono usati per i task delegati al client.
Mantieni task_id e task_version nello stato dell’applicazione invece di usare delegation_id per uno dei due.
In questa app, una risposta del modello non salva nulla da sola. Il backend usa save_learning_plan per proporre l’azione in sospeso, mentre /api/save-plan esegue effettivamente la scrittura.
Le chiamate di funzione del backend arrivano dentro response.event. L’handler aspetta un elemento annidato response.output_item.done, poi legge call_id, name e arguments.
Aspettare l’elemento completato è importante perché gli eventi precedenti possono contenere solo parte della chiamata. L’app analizza gli argomenti ma non esegue ancora la funzione.
SAVE_LEARNING_PLAN_TOOL = {
    "type": "function",
    "name": "save_learning_plan",
    "description": "Propose the current learning plan for confirmation when the learner asks to save.",
    "parameters": {
        "type": "object",
        "properties": {
            "goal": {"type": "string"},
            "weekly_hours": {"type": "number"},
            "items": {
                "type": "array",
                "items": {
                    "type": "object",
                    "properties": {
                        "title": {"type": "string"},
                        "url": {"type": "string"},
                        "reason": {"type": "string"},
                        "type": {
                            "type": "string",
                            "enum": ["course", "project", "track", "article"],
                        },
                    },
                    "required": ["title", "url", "reason", "type"],
                    "additionalProperties": False,
                },
            },
        },
        "required": ["goal", "weekly_hours", "items"],
        "additionalProperties": False,
    },
    "strict": True,
}
Lo schema offre all’app un set fisso di campi da mostrare prima di chiedere la conferma al learner. Il campo type mantiene espliciti corsi, progetti, track e articoli nei dati salvati.
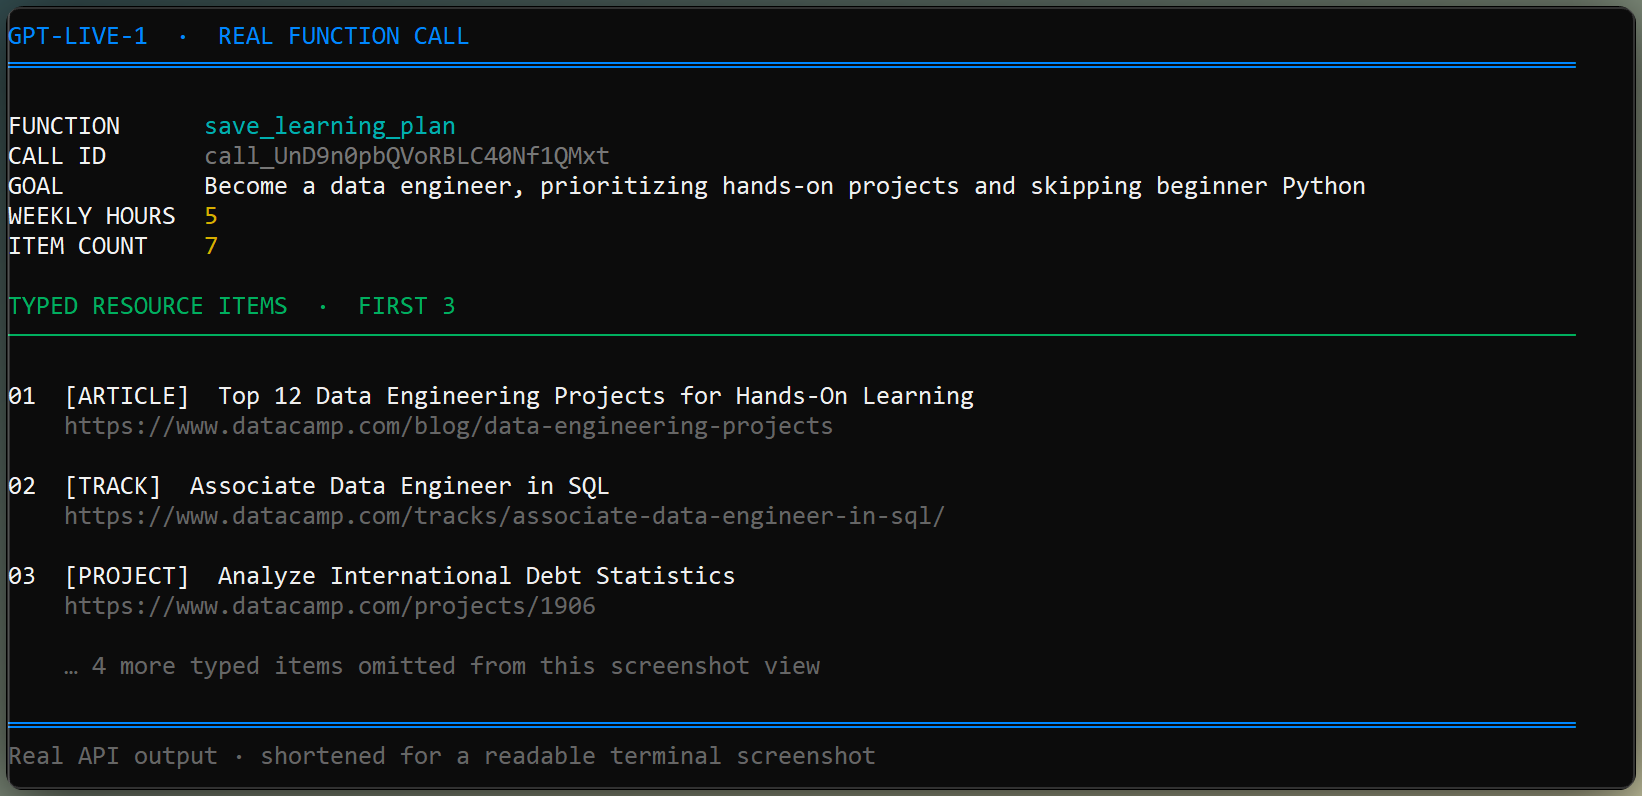
Il terminale mostra argomenti tipizzati della funzione di salvataggio. Immagine dell’autore.
Quando il learner chiede di salvare, il backend chiama save_learning_plan con il piano completo. Il widget memorizza quegli argomenti e mostra il riquadro di conferma, ma la chiamata è ancora solo una proposta.
Lasciare quella chiamata di funzione senza risposta bloccherebbe la risposta delegata e i turni successivi del backend. Il widget la risponde subito con un risultato di attesa‑conferma, poi invia response.create così la conversazione può continuare.
events.send(JSON.stringify({
  type: "response.item.create",
  item: {
    type: "function_call_output",
    call_id: callId,
    output: JSON.stringify({
      status: "awaiting_user_confirmation",
      saved: false,
    }),
  },
}));
events.send(JSON.stringify({ type: "response.create" }));
A questo punto non viene scritto alcun file. L’assistente può indirizzare il learner al pulsante Conferma e salva senza bloccare il lavoro delegato successivo.
L’endpoint /api/save-plan rifiuta di scrivere a meno che confirmed sia true. Poiché un transcript può essere errato o incompleto, la sola richiesta vocale non salva il piano.
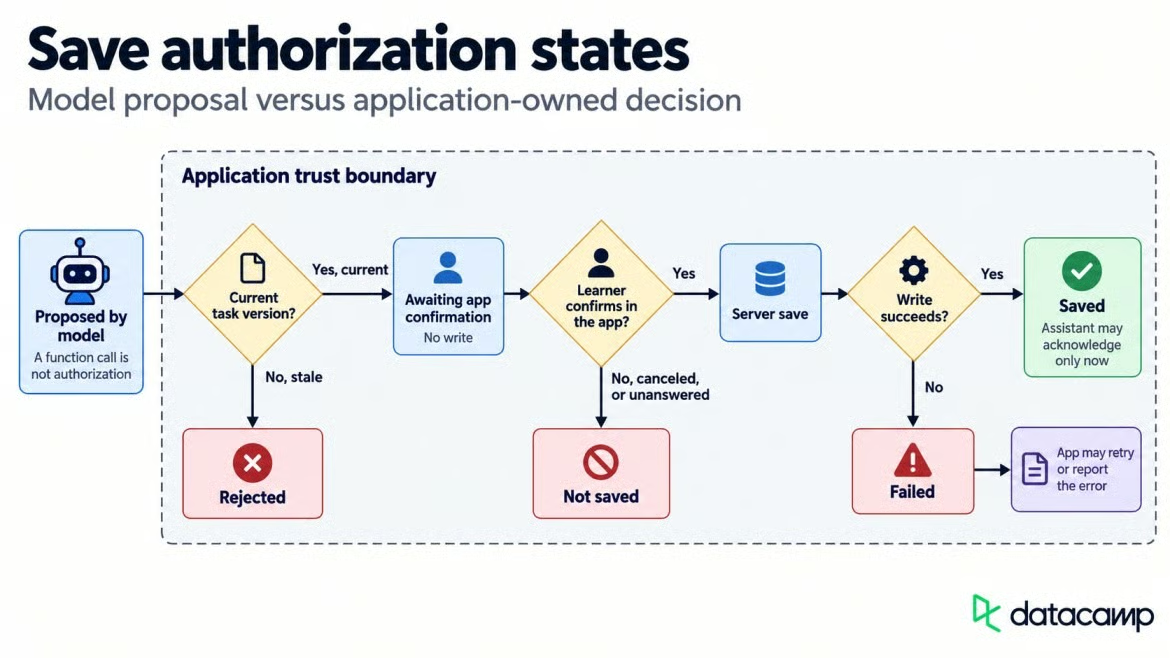
La conferma separa le richieste dalle azioni salvate. Immagine dell’autore.
Il clic su Conferma invia a /api/save-plan il piano in sospeso e confirmed: true. Dopo che il server restituisce un ID piano, il widget invia session.commentary.append con delegation_id: null perché la chiamata di funzione originale era già stata risposta.
const saveResponse = await fetch(${SERVER}/api/save-plan, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    confirmed: true,
    plan: pendingFunctionCall.args,
  }),
});
const saveResult = await saveResponse.json();

events.send(JSON.stringify({
  type: "session.commentary.append",
  delegation_id: null,
  content: The plan was saved as ${saveResult.plan_id}.,
}));
L’aggiornamento di commentary informa il modello Live della scrittura completata e gli consente di riconoscere a voce il salvataggio. La chiamata di funzione precedente resta chiusa e la sessione vocale rimane disponibile per la prossima richiesta del learner.
Il repository GitHub collegato prima contiene il server FastAPI, l’interfaccia Streamlit e il widget WebRTC dentro app/. Dopo averlo clonato, apri due terminali in quella cartella. Esegui uvicorn server:app --host 127.0.0.1 --port 8000 in uno e streamlit run streamlit_app.py nell’altro.
L’interfaccia Streamlit incapsula lo stesso server e widget usati in tutto il progetto. Colloca la conversazione live accanto al piano di apprendimento e all’attività del backend, mentre la dashboard si aggiorna senza resettare la chiamata.
Il video qui sotto segue l’obiettivo espresso a voce, la ricerca di backend, il piano rivisto e il salvataggio confermato. La chiamata resta aperta dopo il salvataggio così il learner può continuare.
Impara con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min