
Courses
Tìm hiểu kỹ thuật viết lệnh (Prompt Engineering)
1 giờ
230.3K
Lần đầu tôi mở một phiên GPT-Live-1 trên trình duyệt, tôi kỳ vọng vòng lặp thoại quen thuộc: nói, chờ, rồi nghe câu trả lời. Thay vào đó, mic vẫn mở trong khi trợ lý phản hồi. Cuộc trò chuyện bớt cứng nhắc hơn, nhưng ứng dụng vẫn phải quản lý phần việc diễn ra phía sau.
OpenAI lần đầu giới thiệu GPT-Live trong ChatGPT vào tháng 7, rồi đưa GPT-Live-1 lên API hồi đầu tuần này, ngay trước khi tôi bắt tay vào xây dựng. Hướng dẫn GPT-Realtime-2.1 của chúng tôi đề cập cách tiếp cận một mô hình, trong khi hướng dẫn GPT Live Transcribe tập trung vào phụ đề trực tiếp. Tại đây, bạn sẽ xây một trợ lý học tập bằng giọng nói có thể tìm kiếm tài nguyên DataCamp thật và chỉ lưu kế hoạch sau khi được xác nhận.
Tôi gọi nó là Trợ lý Học tập Bằng giọng nói của DataCamp. Đây là nguyên mẫu cho hướng dẫn, không phải DataCamp AI Assistant bản sản xuất. Dự án theo sát một người học từ mục tiêu nói ra đến kế hoạch được lưu.
GPT-Live-1 tách phần trao đổi lời nói khỏi công việc backend. Bốn phát hiện định hình trợ lý học tập này.
Những phát hiện này áp dụng cho luồng lập kế hoạch học tập này. Lời nhắc khác hoặc mạng khác có thể thay đổi hành vi, và ủy thác phía client sẽ thay đổi ranh giới kiểm soát.
GPT-Live-1 là mô hình giọng nói full-duplex của OpenAI. Nó xử lý các lượt nói và ngắt lời, bao gồm cả các khoảng ngừng giữa chúng, rồi gửi các công việc dài hơn như tìm kiếm hay gọi công cụ về backend.
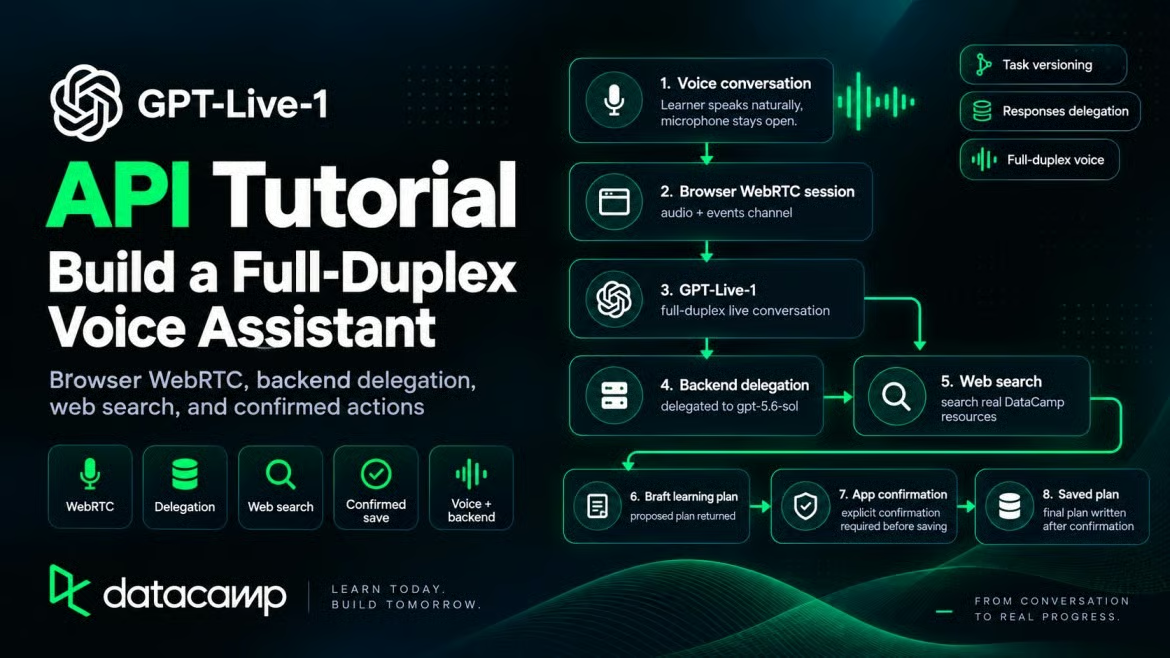
Với người học, khác biệt dễ thấy đầu tiên nằm ở những khoảng ngừng đó.
Full duplex thay đổi cách luân phiên lượt nói. Bạn có thể tạm dừng để nghĩ hoặc nói chèn lên trợ lý, và trợ lý có thể dừng để nghe chỉnh sửa. Hướng dẫn nhắc lệnh của OpenAI cho thấy các phần cho gợi ý ngắn và ngắt lời.
Điều này quan trọng trong một trợ lý học tập. Người mô tả mục tiêu nghề nghiệp có thể tạm dừng, bắt đầu lại, hoặc thêm ràng buộc giữa chừng. Một mô hình chờ qua đoạn "ừm, tôi nghĩ, có lẽ 5 giờ mỗi tuần" sẽ cho người học nghĩ thành lời.
Ủy thác chuyển giao một tác vụ về backend, nhưng không trao quyền kiểm soát ứng dụng. Ứng dụng vẫn quyết định ai có thể hành động và có cho phép lưu hay không. Ứng dụng cũng sở hữu trạng thái tác vụ đã lưu trữ.
Nếu bạn đã dùng GPT-Realtime-2.1, bạn có thể tự hỏi GPT-Live-1 có thay thế nó không. Câu trả lời là không.
GPT-Realtime-2.1 xử lý lắng nghe, suy luận và chọn công cụ trong một mô hình qua v1/realtime, tính phí theo token âm thanh và văn bản. GPT-Live-1 dùng v1/live/sessions, tính phí lớp giọng nói theo giây, và gửi suy luận sang một backend riêng.
Realtime-2.1 không phải lựa chọn cũ hay thấp hơn. Nó dùng một thiết kế khác.
Ứng dụng nhận mục tiêu nói ra và biến nó thành danh sách có thứ tự các tài nguyên DataCamp thật. Phiên thoại giọng nói vẫn mở trong khi backend làm việc. Khi yêu cầu thay đổi, ứng dụng cập nhật phiên bản tác vụ trước khi thực thi một hành động backend.
Không có gì được ghi lại cho đến khi người học xác nhận lần nữa trong ứng dụng.
Trang trình duyệt giữ kết nối WebRTC và mic, trong khi máy chủ tạo phiên GPT-Live-1 và giữ khóa API. Một backend Responses (gpt-5.6-sol) dùng tìm kiếm web và hàm save_learning_plan . Phiên bản tác vụ hiện tại và kế hoạch đã xác nhận nằm trong trạng thái ứng dụng.
Phiên bản tác vụ quyết định ứng dụng chấp nhận hành động backend nào khi yêu cầu thay đổi trong lúc đang tìm kiếm. Hãy dùng kho GitHub cho ứng dụng hoàn chỉnh chạy được; các phần tiếp theo tập trung vào luồng GPT-Live của nó.
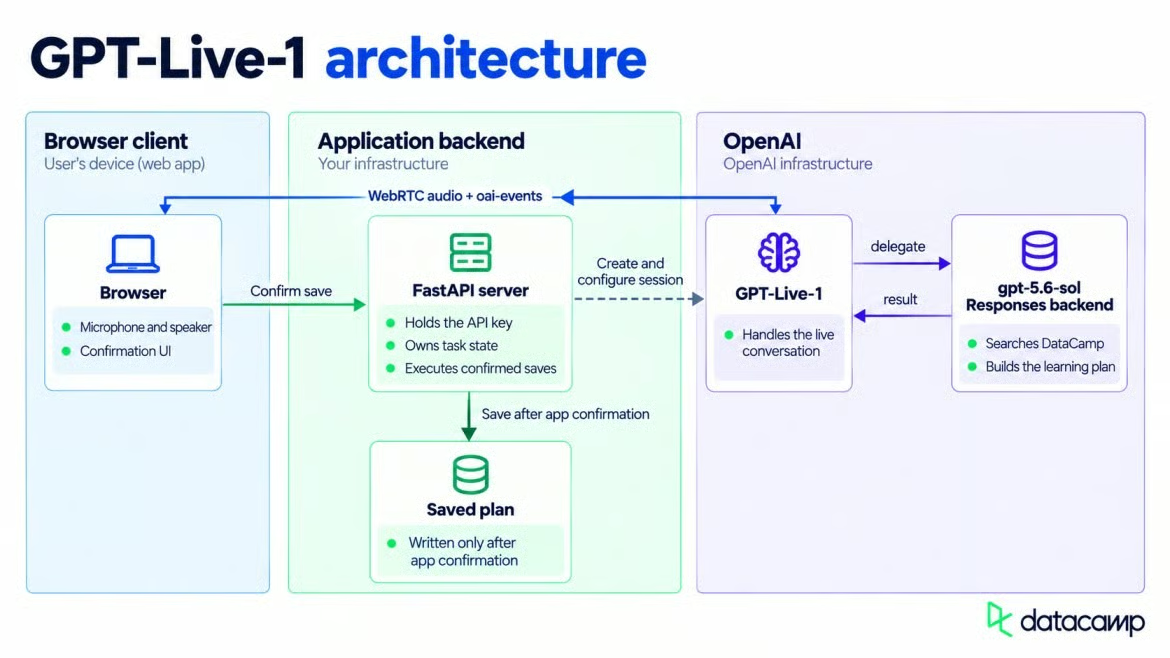
Trình duyệt, GPT-Live-1 và mô hình backend kết nối. Ảnh: Tác giả.
Bạn cần một dự án OpenAI có quyền truy cập GPT-Live-1 (gói miễn phí không hỗ trợ), Python, và một trình duyệt chạy trên HTTPS hoặc localhost để lời nhắc quyền mic có thể xuất hiện. Tôi dùng Python 3.11 và openai 3.13.0. Live API cần ít nhất openai 3.12.0; các phiên bản cũ không có thuộc tính .live trên client.
Giới hạn số phiên đồng thời phụ thuộc vào bậc sử dụng của bạn. Kiểm tra giới hạn dự án trước khi mở nhiều tab trình duyệt.
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install openai fastapi uvicorn python-dotenv streamlit requests
Trên macOS hoặc Linux, kích hoạt môi trường với source .venv/bin/activate thay vì vậy. Tạo một tệp .env ở thư mục gốc dự án và thêm giá trị sau.
OPENAI_API_KEY=sk-...python-dotenv tự động nạp tệp đó khi máy chủ import, nên khóa không cần xuất hiện trong mã.
Client OpenAI() đọc cùng biến môi trường khi bạn không truyền khóa.
Trình duyệt không bao giờ thấy khóa dự án của bạn. Nó gửi một đề nghị WebRTC lên máy chủ của bạn, máy chủ dùng khóa để tạo phiên. Sau trao đổi SDP, trình duyệt gửi âm thanh đến OpenAI qua WebRTC mà không nhận khóa đó.
Lời gọi GPT-Live bên trong /api/session tạo phiên từ đề nghị SDP. Nó truyền hướng dẫn giọng nói, mô hình backend, tìm kiếm web và hàm lưu trong cùng một yêu cầu.
result = client.live.create(
    session={
        "model": "gpt-live-1",
        "instructions": LIVE_INSTRUCTIONS,
        "delegation": {
            "type": "responses",
            "responses": {
                "model": "gpt-5.6-sol",
                "instructions": BACKEND_INSTRUCTIONS,
                "tools": [
                    {
                        "type": "web_search",
                        "filters": {
                            "allowed_domains": ["datacamp.com", "www.datacamp.com"]
                        },
                    },
                    SAVE_LEARNING_PLAN_TOOL,
                ],
                "tool_choice": "auto",
            },
        },
    },
    transport={"type": "webrtc", "sdp": sdp},
)
Lời gọi đó gửi yêu cầu đến POST /v1/live/sessions và trả về ID phiên kèm SDP answer. Yêu cầu HTTP khởi động phiên, nên không gửi sự kiện session.start riêng sau đó.
Máy chủ mẫu chỉ chấp nhận yêu cầu từ trình duyệt tại localhost:8501 và 127.0.0.1:8501. Quy tắc đó chỉ dùng cho cục bộ.
Nếu bạn triển khai ứng dụng, hãy thay các origin đó và xác thực cả /api/session lẫn /api/save-plan. Giới hạn tốc độ tạo phiên vì mỗi yêu cầu đều có thể tốn tiền và tiêu thụ đồng thời. Client có thể tự gửi confirmed: true, nên máy chủ công khai không thể coi trường đó như bằng chứng về người gửi yêu cầu.
Theo hướng dẫn WebRTC của OpenAI, trình duyệt xin quyền truy cập mic và mở một RTCPeerConnection. Hãy dùng nhãn kênh dữ liệu được ghi oai-events và tạo nó trước khi sinh SDP offer. Kênh đó mang các sự kiện JSON hai chiều sau khi phiên bắt đầu.
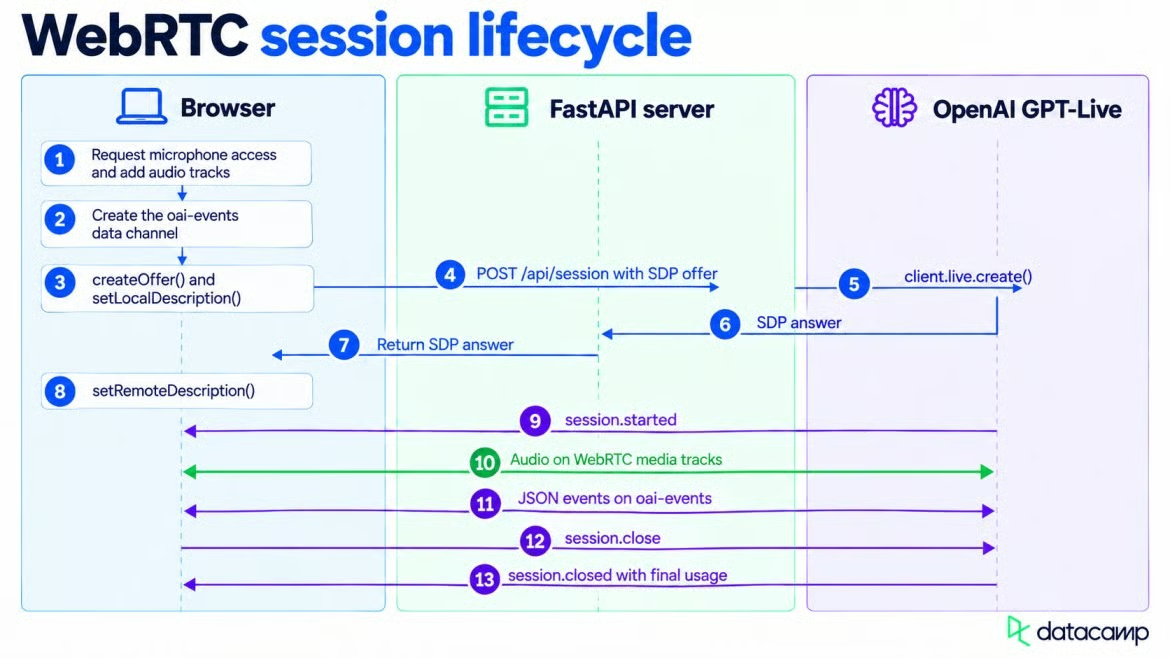
WebRTC khởi động, truyền âm thanh, rồi đóng. Ảnh: Tác giả.
Thiết lập media bản thân nó là WebRTC thông thường. Sự kiện GPT-Live dùng kênh dữ liệu được tạo ở dòng cuối.
const connection = new RTCPeerConnection();
connection.addEventListener("track", (event) => {
  audio.srcObject = new MediaStream([event.track]);
  audio.play();
});
const microphone = await navigator.mediaDevices.getUserMedia({ audio: true });
for (const track of microphone.getAudioTracks()) {
  connection.addTrack(track, microphone);
}
const events = connection.createDataChannel("oai-events");
Sau khi tạo offer, trình duyệt gọi setLocalDescription() và chờ ICE gathering hoàn tất. Nó gửi SDP cục bộ tới /api/session, rồi áp dụng answer của OpenAI bằng setRemoteDescription(). Âm thanh từ mic và giọng nói của trợ lý đi trên các luồng media, nên không cần các yêu cầu riêng cho chuyển giọng nói thành văn bản và chuyển văn bản thành giọng nói.
Âm thanh không thuộc về oai-events. Đừng gửi session.input_audio.append hoặc chờ session.output_audio.delta trên một kênh dữ liệu WebRTC.
Kênh dữ liệu tuân quy tắc thời gian khác. Hãy đợi session.started trước khi gửi sự kiện qua oai-events. Lần đầu tôi gửi quá sớm và kết nối đã bỏ qua.
Tôi không nhận được lỗi hữu ích nào, khiến một lỗi nhỏ về thứ tự trở nên khó lần ra.
Nếu bạn không cần phụ đề hiển thị, có thể bỏ qua tiểu mục này; kết nối âm thanh đã hoàn chỉnh.
session.input_transcript.delta và session.output_transcript.delta trả về các đoạn văn bản kèm mốc lệch mili-giây cho phụ đề trực tiếp. Tài liệu của OpenAI lưu ý rằng các mảnh bản chép lời không phải là lượt hoàn tất. Việc giao có thể không đều, và khoảng thời gian bản chép lời của người dùng và trợ lý có thể chồng lấn.
Hãy nối các mảnh bản chép lời lên màn hình khi chúng đến, nhưng đừng khởi động công việc backend từ đó. Mô hình sẽ quyết định khi nào cần ủy thác.
Hướng dẫn của mô hình Live nên ngắn gọn. Hướng dẫn của OpenAI đặt các bước tác vụ chi tiết ở prompt backend. Tôi giữ quy trình tác vụ ở đó và để prompt Live tập trung vào lời nói.
Đoạn trích này giữ hành vi giọng nói tách biệt khỏi tác vụ lập kế hoạch học tập. Quy tắc lời nói nằm trên các điều kiện kích hoạt ủy thác.
You are Sage, a warm, encouraging voice learning coach for DataCamp learners.
Speak naturally at an unhurried pace. Be clear and direct, not overly cheerful.

Backchannel policy: Use moderate backchannels without competing with the response.
Interruption policy: Stop speaking when the learner interrupts, and listen.

Delegation policy:
Backend tools:
- learning_plan_research: search DataCamp resources and assemble a personalized learning plan.
- save_learning_plan: propose the current plan for app confirmation when the learner asks to save.

Delegate to the backend when:
- The learner states or changes a goal, skill level, or weekly time.
- A correction changes the plan already requested.
- The learner asks to save the plan.

Do not delegate for greetings, small clarifications, or a result already given.

Saving: a proposed save only asks the app to confirm. Do not say the plan is saved until the app reports a saved result.
After a save, keep the conversation open and ask what the learner wants next.
Các quy tắc này để lời chào ở lớp Live và gửi yêu cầu nghiên cứu hoặc lưu về backend. Quyền xác nhận vẫn thuộc về ứng dụng.
Các dòng về backchannel và ngắt lời cho trợ lý biết cách phản hồi xung quanh các khoảng ngừng. "Backchannel vừa phải" yêu cầu các lời xác nhận thoảng như "ừ hử" mà không lấp đầy mọi khoảng lặng. Tôi chọn mức đó để chừa không gian suy nghĩ cho người học; một bài học có khoảng ngừng dài hơn có thể cần ít phản hồi hơn.
Hãy thay dòng đó nếu ứng dụng của bạn cần hành vi khác; thêm "không bao giờ nói khi người dùng đang nói" cũng loại bỏ backchannel.
Hai prompt có vai trò khác nhau. Prompt Live điều khiển giọng nói và chuyển giao, trong khi prompt backend điều khiển nghiên cứu và định dạng trả lời. Hướng dẫn của OpenAI khuyên không đặt các bước tìm kiếm chi tiết vào hướng dẫn giọng nói.
Sự tách bạch mô tả trước đó xuất hiện trong trường delegation của phiên. Khi người học nêu mục tiêu, GPT-Live gửi tác vụ đến một mô hình có thể tìm kiếm danh mục khóa học của chúng tôi và lập kế hoạch.
GPT-Live-1 cung cấp ủy thác Responses và ủy thác phía client. Ủy thác Responses để OpenAI quản lý cuộc gọi backend, còn ủy thác phía client trao cho mã của bạn. Tôi dùng ủy thác Responses vì nó tránh thêm một vòng lặp backend nữa trong ứng dụng này.
Tôi dùng gpt-5.6-sol. Hướng dẫn ủy thác của OpenAI dùng gpt-5.6-terra làm ví dụ khởi đầu và liệt kê gpt-5.6-luna cho tác vụ chi phí thấp hơn. Với Sol, backend trả về cấu trúc kế hoạch theo yêu cầu.
Giữ tool_choice ở auto để backend có thể chọn tìm kiếm web hoặc hàm lưu. Chế độ ủy thác được cố định khi khởi động; chuyển sang ủy thác phía client bằng cách đóng phiên hiện tại và tạo phiên khác.
Quy tắc trong prompt Live rất đơn giản: lời chào và câu hỏi ngắn ở lại với mô hình Live, còn kế hoạch học tập hoặc thay đổi kế hoạch đó chuyển về backend. Không có gì trong API cưỡng chế ranh giới đó. Hãy kiểm thử với kiểu yêu cầu ứng dụng của bạn sẽ nhận vì mô hình tự đưa ra lựa chọn.
Khi đã được ủy thác, backend có một nhiệm vụ: biến mục tiêu của người học thành danh sách ngắn các tài nguyên DataCamp kèm liên kết. Tôi cung cấp công cụ web_search với filters.allowed_domains đặt là datacamp.com và www.datacamp.com. Hãy coi bộ lọc đó là hướng dẫn tìm kiếm, không phải bằng chứng rằng mọi liên kết đều chính xác.
Mục tiêu mẫu yêu cầu lộ trình kỹ sư dữ liệu với 5 giờ mỗi tuần, biết chút Python, và chưa biết SQL. Phản hồi bắt đầu với Cách học Kỹ sư Dữ liệu từ số 0 năm 2026 và track Associate Data Engineer in SQL.
Các mục còn lại pha trộn một dự án, khóa học cơ sở dữ liệu Python, một track khác và một dự án pipeline cuối. Mỗi URL liệt kê đều mở trang DataCamp hiện có.
Prompt backend yêu cầu 4 đến 7 mục có thứ tự. Mỗi mục có tiêu đề, URL, lý do ngắn, và kiểu course, project, track, hoặc article. Sự pha trộn theo sở thích định dạng người học nêu ra và thời lượng mỗi tuần.
Tôi không yêu cầu mô hình đoán thời lượng khóa học khi trang không nêu. Một con số chính xác trong trường hợp đó sẽ khẳng định quá mức so với nguồn.
GPT-Live có thể giữ phiên giọng nói hoạt động trong khi backend Responses làm việc. Nếu người học thêm ràng buộc thực hành trước khi kế hoạch đầu tiên trả về, công việc backend ban đầu không tự động bị hủy.
Một chỉnh sửa bằng lời nói không tự động hủy hoặc viết lại công việc backend đã bắt đầu. Ngắt lời giọng trợ lý và thay đổi tác vụ là hai hành động riêng. Ứng dụng quyết định sẽ làm gì với kết quả cũ.
Máy chủ theo dõi bộ đếm task_version và tăng nó mỗi khi một ủy thác mới bắt đầu. Khi kết quả đến, ứng dụng kiểm tra phiên bản trước khi hành động; bộ xử lý của nó ghi log kết quả cũ và không thực thi.
Ủy thác Responses có một giới hạn: mô hình Live nhận kết quả backend trực tiếp, nên kiểm tra phiên bản không thể kiểm soát trọn vẹn câu nói tiếp theo của nó. Ủy thác phía client cho phép mã của bạn loại bỏ kết quả cũ trước khi nó đến mô hình. Vì vậy, phiên bản tác vụ bảo vệ hành động của ứng dụng, không phải mọi lời trợ lý có thể nói.
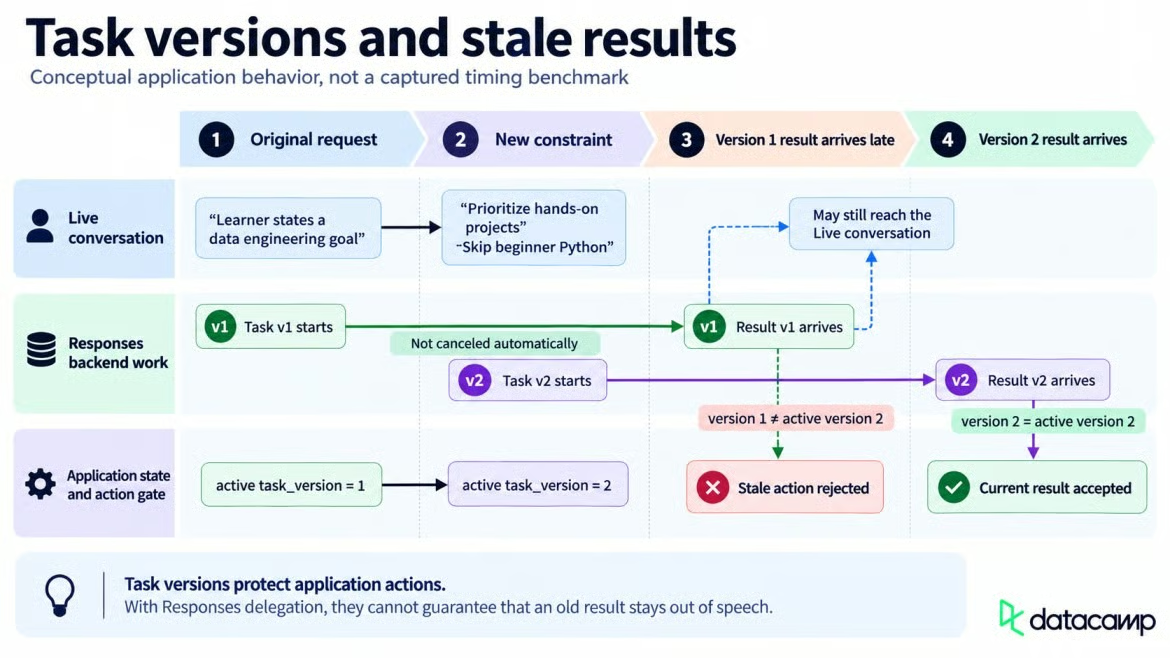
Phiên bản tác vụ giữ các ràng buộc mới hoạt động. Ảnh: Tác giả.
Sau khi phản hồi backend đầu tiên hoàn tất, tôi gửi bổ sung yêu cầu dự án thực hành và không Python cho người mới. Kế hoạch 7 mục đã chỉnh bắt đầu với Introduction to SQL, rồi pha một track, hai khóa học, và bốn dự án, gồm Khám phá mạng lưới giao thông London và Xây dựng pipeline dữ liệu bán lẻ. Điều đó cho thấy khả năng chỉnh sửa qua các lượt đã hoàn tất; không nói gì về việc dừng một phản hồi đang hoạt động.
Trong lúc backend làm việc, ba sự kiện append có thể cập nhật mô hình Live. session.thinking.append thêm ngữ cảnh không nên nói ra, session.commentary.append thêm văn bản để mô hình nói bằng lời của mình, và session.instructions.append thay đổi hướng dẫn.
Mỗi lệnh append mang một chuỗi thuần tối đa 500 token. Những sự kiện này cập nhật ngữ cảnh hoặc hành vi của mô hình Live; chúng không sửa đổi hay hủy một tác vụ Responses backend đang chạy. Một hướng dẫn có thể điều hướng hành vi Live hiện tại, còn commentary cung cấp thông tin mô hình nên truyền đạt bằng lời.
Bảng điều khiển ghi lại tiến độ backend nhưng không gửi các sự kiện append này. Với ủy thác Responses, cập nhật từ ứng dụng của bạn vẫn có thể gửi qua oai-events, nhưng chúng dùng delegation_id: null. delegation ID khác null dùng cho các tác vụ ủy thác phía client.
Giữ task_id và task_version trong trạng thái ứng dụng thay vì dùng delegation_id cho bất kỳ cái nào.
Trong ứng dụng này, phản hồi của mô hình không tự lưu bất cứ thứ gì. Backend dùng save_learning_plan để đề xuất hành động chờ xử lý, còn /api/save-plan chịu trách nhiệm ghi thật.
Các lời gọi hàm từ backend đến trong response.event. Bộ xử lý chờ một mục lồng response.output_item.done, rồi đọc call_id, name, và arguments của nó.
Việc chờ mục hoàn tất là quan trọng vì các sự kiện sớm hơn có thể chỉ chứa một phần của lời gọi. Ứng dụng phân tích tham số nhưng chưa chạy hàm.
SAVE_LEARNING_PLAN_TOOL = {
    "type": "function",
    "name": "save_learning_plan",
    "description": "Propose the current learning plan for confirmation when the learner asks to save.",
    "parameters": {
        "type": "object",
        "properties": {
            "goal": {"type": "string"},
            "weekly_hours": {"type": "number"},
            "items": {
                "type": "array",
                "items": {
                    "type": "object",
                    "properties": {
                        "title": {"type": "string"},
                        "url": {"type": "string"},
                        "reason": {"type": "string"},
                        "type": {
                            "type": "string",
                            "enum": ["course", "project", "track", "article"],
                        },
                    },
                    "required": ["title", "url", "reason", "type"],
                    "additionalProperties": False,
                },
            },
        },
        "required": ["goal", "weekly_hours", "items"],
        "additionalProperties": False,
    },
    "strict": True,
}
Schema cung cấp cho ứng dụng một tập trường cố định để hiển thị trước khi hỏi người học xác nhận. Trường type giữ rõ ràng khóa học, dự án, track và bài viết trong dữ liệu lưu.
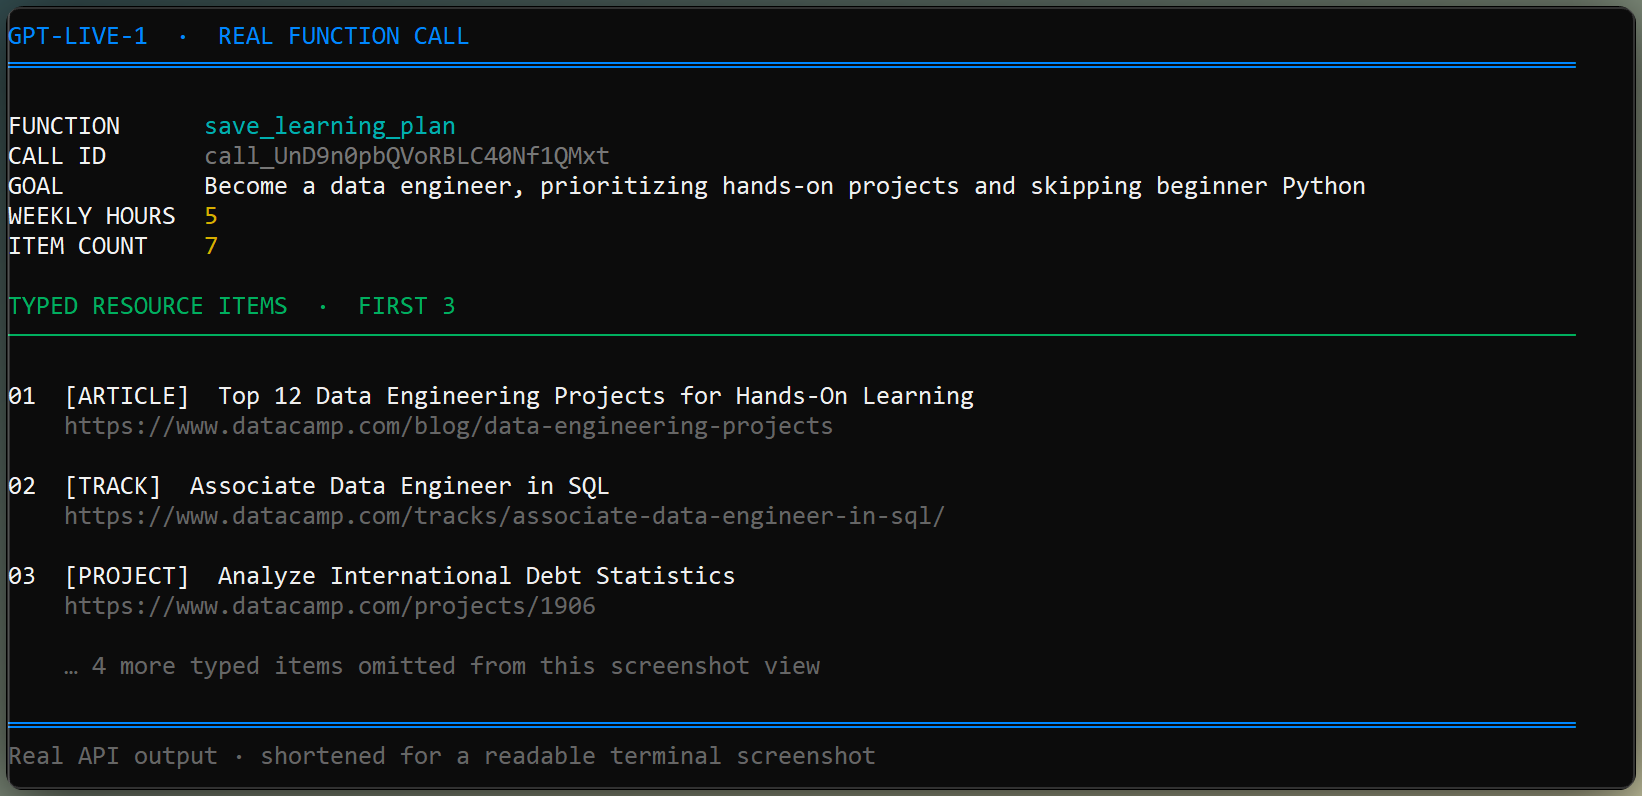
Terminal hiển thị tham số kiểu của hàm lưu. Ảnh: Tác giả.
Khi người học yêu cầu lưu, backend gọi save_learning_plan với toàn bộ kế hoạch. Widget lưu các tham số đó và hiển thị hộp xác nhận, nhưng lời gọi vẫn chỉ là đề xuất.
Để lời gọi hàm đó chưa được trả lời sẽ chặn phản hồi được ủy thác và các lượt backend sau này. Widget lập tức trả lời nó bằng kết quả đang chờ xác nhận, rồi gửi response.create để cuộc trò chuyện tiếp tục.
events.send(JSON.stringify({
  type: "response.item.create",
  item: {
    type: "function_call_output",
    call_id: callId,
    output: JSON.stringify({
      status: "awaiting_user_confirmation",
      saved: false,
    }),
  },
}));
events.send(JSON.stringify({ type: "response.create" }));
Thời điểm này chưa có tệp nào được ghi. Trợ lý có thể hướng dẫn người học đến nút Xác nhận và lưu mà không chặn công việc ủy thác tiếp theo.
Đầu cuối /api/save-plan từ chối ghi trừ khi confirmed là true. Vì bản chép lời có thể sai hoặc chưa đủ, yêu cầu nói ra một mình không lưu kế hoạch.
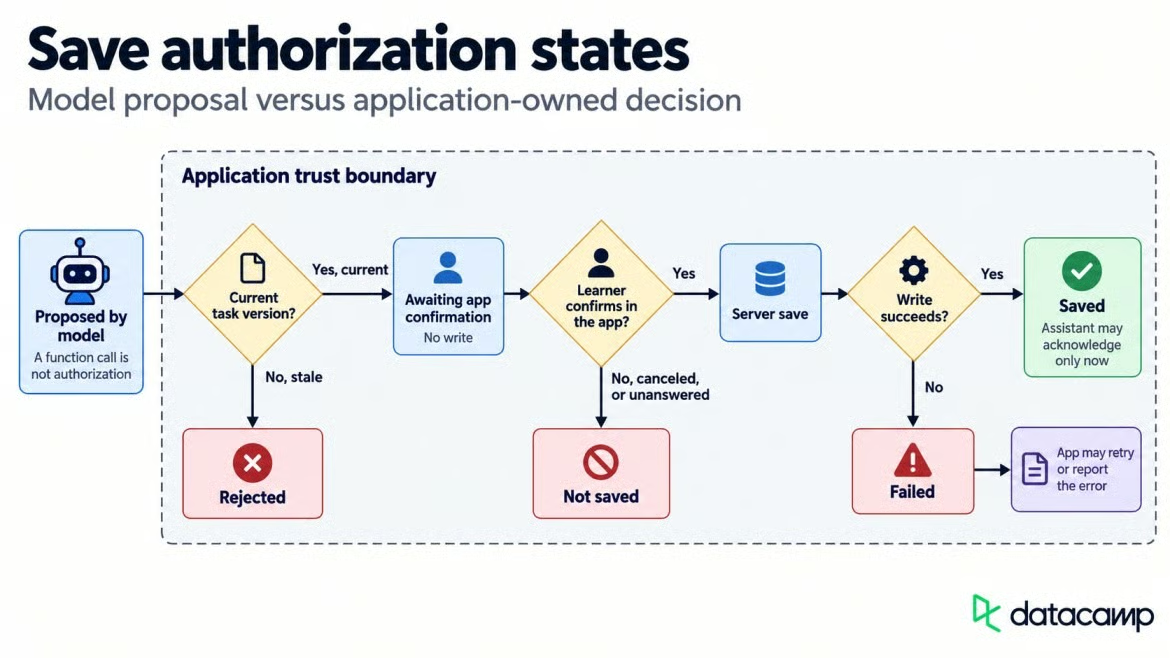
Xác nhận tách yêu cầu khỏi hành động đã lưu. Ảnh: Tác giả.
Cú nhấp Xác nhận gửi tới /api/save-plan kế hoạch đang chờ và confirmed: true. Sau khi máy chủ trả về ID kế hoạch, widget gửi session.commentary.append với delegation_id: null vì lời gọi hàm gốc đã được trả lời.
const saveResponse = await fetch(${SERVER}/api/save-plan, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    confirmed: true,
    plan: pendingFunctionCall.args,
  }),
});
const saveResult = await saveResponse.json();

events.send(JSON.stringify({
  type: "session.commentary.append",
  delegation_id: null,
  content: The plan was saved as ${saveResult.plan_id}.,
}));
Bản cập nhật commentary báo cho mô hình Live về thao tác ghi đã hoàn tất và cho phép nó xác nhận việc lưu bằng lời. Lời gọi hàm trước đó vẫn đóng, và phiên giọng nói vẫn sẵn sàng cho yêu cầu tiếp theo của người học.
Kho GitHub đã dẫn ở trên chứa máy chủ FastAPI, giao diện Streamlit, và widget WebRTC trong app/. Sau khi clone, mở hai terminal trong thư mục đó. Chạy uvicorn server:app --host 127.0.0.1 --port 8000 ở một cái và streamlit run streamlit_app.py ở cái còn lại.
Giao diện Streamlit bọc cùng máy chủ và widget được dùng xuyên suốt quá trình xây dựng. Nó đặt hội thoại trực tiếp cạnh kế hoạch học tập và hoạt động backend, trong khi bảng điều khiển cập nhật mà không đặt lại cuộc gọi.
Video dưới đây theo dõi mục tiêu nói ra, tìm kiếm backend, kế hoạch đã chỉnh, và lưu đã xác nhận. Cuộc gọi vẫn mở sau khi lưu để người học tiếp tục.
Học với DataCamp
Courses
Courses
Courses
blogs
Matt Crabtree
10 phút
