course
Förstå prompt engineering
1 timmar
230.3K
Första gången jag öppnade en GPT-Live-1-session i webbläsaren förväntade jag mig den vanliga röstloopen: prata, vänta och sedan höra ett svar. Istället förblev mikrofonen öppen medan assistenten svarade. Samtalet kändes mindre stelt, men appen behövde fortfarande hantera arbetet som sker bakom kulisserna.
OpenAI introducerade först GPT-Live i ChatGPT i juli och tog sedan GPT-Live-1 till API:et tidigare i veckan, precis innan jag började bygget. Vår handledning för GPT-Realtime-2.1 täcker enmodellsupplägget, medan vår guide för GPT Live Transcribe fokuserar på liveundertexter. Här bygger du en röstbaserad lärarassistent som söker i faktiska DataCamp-resurser och sparar en plan först efter bekräftelse.
Jag kallar den DataCamp Voice Learning Assistant. Det är en prototyp för handledningen, inte den produktionsklara DataCamp AI Assistant. Projektet följer en lärande från ett uttalat mål till en sparad plan.
GPT-Live-1 separerar det talade utbytet från backend-arbetet. Fyra iakttagelser formar lärarassistenten.
Dessa iakttagelser gäller för detta flöde för lärandeplaner. Ett annat promptupplägg eller nätverk kan ändra beteendet, och klientdelegering ändrar kontrollgränsen.
GPT-Live-1 är OpenAI:s röstmodell med full duplex. Den hanterar talade vändor och avbrott, inklusive pauserna mellan dem, och skickar sedan längre arbeten som sökning eller verktygsanrop till ett backend.
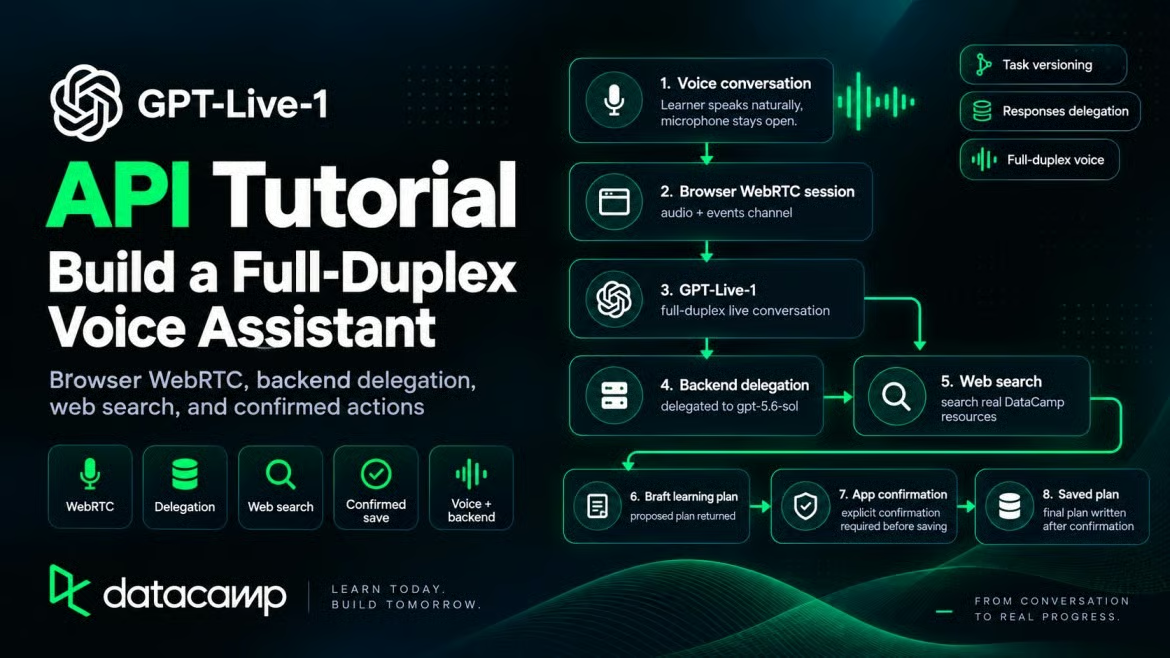
För den lärande är den första synliga skillnaden just i dessa pauser.
Full duplex ändrar turordningen. Du kan pausa för att tänka eller prata över assistenten, och den kan sluta för att höra rättelsen. OpenAI:s promptguide visar promptavsnitt för korta bekräftelser och avbrott.
Detta spelar roll i en lärarassistent. En person som beskriver ett karriärmål kan pausa, börja om eller lägga till en begränsning halvvägs. En modell som väntar genom ”tja, jag tror, kanske fem timmar i veckan” låter den lärande tänka högt.
Delegering flyttar en uppgift till backend, men överlämnar inte applikationskontrollen. Appen beslutar fortfarande vem som får agera och om en sparning är tillåten. Den äger också det lagrade uppgiftsläget.
Om du har använt GPT-Realtime-2.1 kanske du undrar om GPT-Live-1 ersätter den. Det gör den inte.
GPT-Realtime-2.1 hanterar lyssning, resonemang och verktygsval i en och samma modell över v1/realtime, debiterat per ljud- och texttoken. GPT-Live-1 använder v1/live/sessions, debiterar röstlagret per sekund och skickar resonemang till ett separat backend.
Realtime-2.1 är inte ett äldre eller sämre alternativ. Den använder en annan design.
Appen tar ett uttalat mål och gör det till en ordnad lista med riktiga DataCamp-resurser. Röstsessionen förblir öppen under backend-arbetet. När begäran ändras uppdaterar appen sin uppgiftsversion innan en backend-åtgärd körs.
Inget skrivs förrän den lärande bekräftar igen i appen.
Webbläsarsidan håller WebRTC-anslutningen och mikrofonen, medan servern skapar GPT-Live-1-sessionen och behåller API-nyckeln. Ett Responses-backend (gpt-5.6-sol) använder webbsökning och save_learning_plan funktionen. Den aktuella uppgiftsversionen och den bekräftade planen ligger kvar i appens tillstånd.
Uppgiftsversionen avgör vilken backend-åtgärd appen accepterar när en begäran ändras under en sökning. Använd GitHub-repot för hela körbara appen; nästa avsnitt fokuserar på dess GPT-Live-flöde.
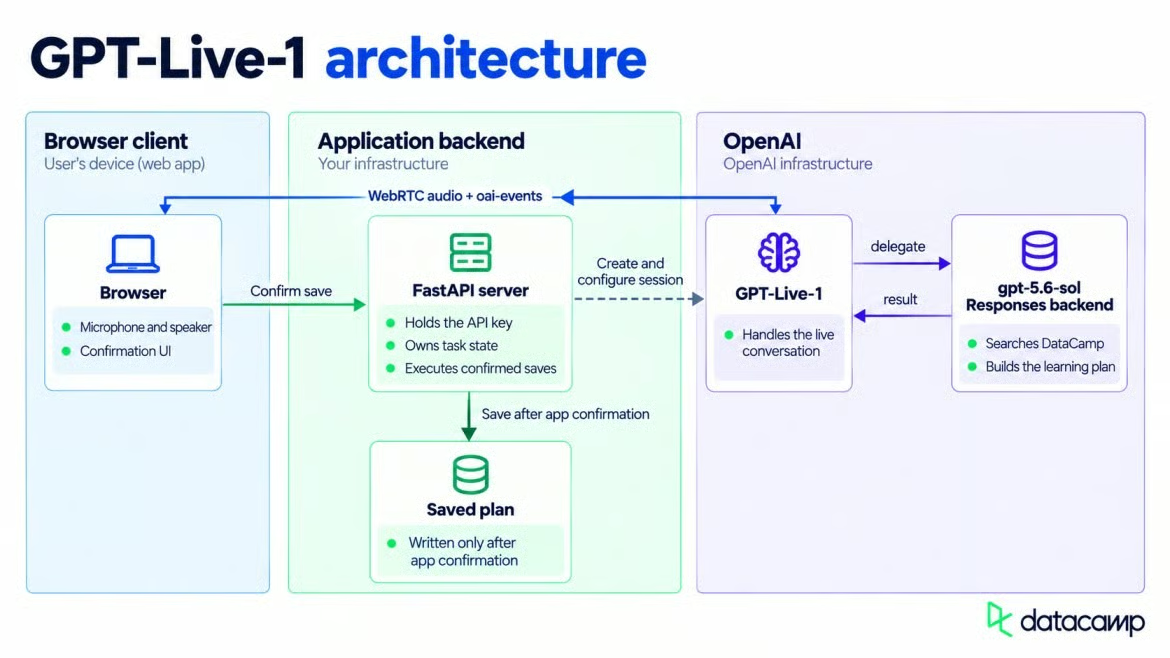
Webbläsare, GPT-Live-1 och backend-modell kopplas samman. Bild av författaren.
Du behöver ett OpenAI-projekt med åtkomst till GPT-Live-1 (gratistjänsten stöder det inte), Python och en webbläsare som körs över HTTPS eller localhost så att mikrofonprompten kan visas. Jag använde Python 3.11 och openai 3.13.0. Live-API:et kräver minst openai 3.12.0; äldre versioner har inte ett .live attribut på klienten.
Begränsningar för samtidiga sessioner beror på din användningsnivå. Kontrollera projektets gräns innan du öppnar många webbläsarflikar.
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install openai fastapi uvicorn python-dotenv streamlit requests
På macOS eller Linux aktiverar du miljön med source .venv/bin/activate i stället. Skapa en .env-fil i projektroten och lägg till detta värde.
OPENAI_API_KEY=sk-...python-dotenv laddar den filen automatiskt när servern importerar den, så nyckeln behöver aldrig förekomma i koden.
Klienten OpenAI() läser samma miljövariabel när du inte skickar med en nyckel.
Webbläsaren ser aldrig din projektnyckel. Den postar ett WebRTC-erbjudande till din server, som använder nyckeln för att skapa sessionen. Efter SDP-utbytet skickar webbläsaren ljud till OpenAI över WebRTC utan att ta emot den nyckeln.
GPT-Live-anropet i /api/session skapar sessionen från SDP-erbjudandet. Det skickar röstinstruktionerna, backend-modellen, webbsökning och sparfunktion i samma begäran.
result = client.live.create(
    session={
        "model": "gpt-live-1",
        "instructions": LIVE_INSTRUCTIONS,
        "delegation": {
            "type": "responses",
            "responses": {
                "model": "gpt-5.6-sol",
                "instructions": BACKEND_INSTRUCTIONS,
                "tools": [
                    {
                        "type": "web_search",
                        "filters": {
                            "allowed_domains": ["datacamp.com", "www.datacamp.com"]
                        },
                    },
                    SAVE_LEARNING_PLAN_TOOL,
                ],
                "tool_choice": "auto",
            },
        },
    },
    transport={"type": "webrtc", "sdp": sdp},
)
Det anropet skickar en begäran till POST /v1/live/sessions och returnerar ett sessions-ID med ett SDP-svar. HTTP-begäran startar sessionen, så skicka inte en separat session.start-händelse efteråt.
Exempelservern accepterar webbläsarbegäranden endast från localhost:8501 och 127.0.0.1:8501. Den regeln är för lokal användning.
Om du distribuerar appen, ersätt dessa ursprung och autentisera både /api/session och /api/save-plan. Begränsa frekvensen för att skapa sessioner eftersom varje begäran kan kosta pengar och förbruka samtidighet. En klient kan själv skicka confirmed: true, så en publik server kan inte betrakta det fältet som bevis på vem som gjorde begäran.
Följ OpenAI:s WebRTC-guide: webbläsaren begär mikrofonåtkomst och öppnar en RTCPeerConnection. Använd den dokumenterade oai-events etiketten för data-kanalen och skapa den innan du genererar SDP-erbjudandet. Den kanalen bär JSON-händelser i båda riktningar när sessionen startar.
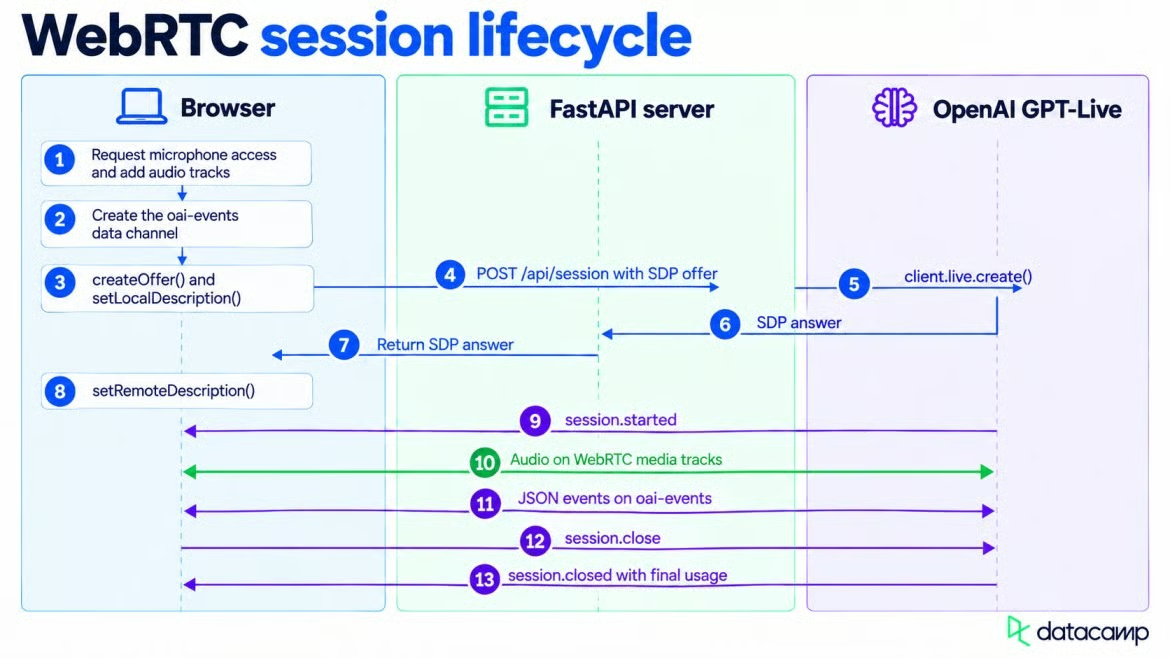
WebRTC startar, strömmar ljud och stänger sedan. Bild av författaren.
Själva mediainställningen är vanlig WebRTC. GPT-Live-händelser använder datakanalen som skapades på sista raden.
const connection = new RTCPeerConnection();
connection.addEventListener("track", (event) => {
  audio.srcObject = new MediaStream([event.track]);
  audio.play();
});
const microphone = await navigator.mediaDevices.getUserMedia({ audio: true });
for (const track of microphone.getAudioTracks()) {
  connection.addTrack(track, microphone);
}
const events = connection.createDataChannel("oai-events");
Efter att ha skapat erbjudandet anropar webbläsaren setLocalDescription() och väntar på att ICE-insamlingen ska bli klar. Den skickar den lokala SDP:n till /api/session och applicerar sedan OpenAI:s svar med setRemoteDescription(). Mikrofonljud och assistentens tal färdas på mediakanalerna, så separata tal-till-text- och text-till-tal-begäranden behövs inte.
Ljud hör inte hemma på oai-events. Skicka inte session.input_audio.append eller vänta på session.output_audio.delta på en WebRTC-datakanal.
Datakanalen följer en annan tidsregel. Vänta på session.started innan du skickar en händelse via oai-events. Vid mitt första försök skickade jag en för tidigt och anslutningen ignorerade den.
Jag fick inget användbart felmeddelande, vilket gjorde ett litet ordningsfel irriterande att felsöka.
Om du inte behöver synliga undertexter kan du hoppa över detta avsnitt; ljudanslutningen är redan komplett.
session.input_transcript.delta och session.output_transcript.delta returnerar textfragment med millisekundförskjutningar för liveundertexter. OpenAI:s dokumentation varnar för att transkriptfragment inte är avslutade vändor. Leveransen kan vara ojämn, och användar- och assistentintervall kan överlappa.
Lägg till transkriptfragment på skärmen när de anländer, men starta inte backend-arbete från dem. Modellen avgör när den ska delegera.
Live-modellens instruktioner bör vara korta. OpenAI:s guide placerar detaljerade arbetssteg i backend-prompten. Jag behöll arbetsgången där och lät Live-prompten fokusera på talet.
Detta utdrag håller röstbeteendet separat från uppgiften med lärandeplanen. Talsreglerna ligger ovanför villkoren som utlöser delegering.
You are Sage, a warm, encouraging voice learning coach for DataCamp learners.
Speak naturally at an unhurried pace. Be clear and direct, not overly cheerful.

Backchannel policy: Use moderate backchannels without competing with the response.
Interruption policy: Stop speaking when the learner interrupts, and listen.

Delegation policy:
Backend tools:
- learning_plan_research: search DataCamp resources and assemble a personalized learning plan.
- save_learning_plan: propose the current plan for app confirmation when the learner asks to save.

Delegate to the backend when:
- The learner states or changes a goal, skill level, or weekly time.
- A correction changes the plan already requested.
- The learner asks to save the plan.

Do not delegate for greetings, small clarifications, or a result already given.

Saving: a proposed save only asks the app to confirm. Do not say the plan is saved until the app reports a saved result.
After a save, keep the conversation open and ask what the learner wants next.
Dessa regler lämnar hälsningar i Live-lagret och skickar forskning eller sparbegäranden till backend. Bekräftelsen tillhör fortfarande appen.
Raderna om backchannel och avbrott talar om för assistenten hur den ska svara runt pauser. ”Måttliga backchannels” ber om sporadiska bekräftelser som ”mm-hmm” utan att fylla varje tystnad. Jag valde den nivån för att ge den lärande utrymme att tänka; en lektion med längre pauser kan behöva färre bekräftelser.
Ändra den raden om din app kräver annat beteende; att lägga till ”prata aldrig medan användaren pratar” tar också bort backchannels.
De två promptarna har olika uppgifter. Live-prompten styr tal och överlämning, medan backend-prompten styr research och svarformat. OpenAI:s guide avråder från att placera detaljerade söksteg i röstinstruktionerna.
Uppdelningen som beskrevs tidigare syns i sessionens delegation-fält. När den lärande anger ett mål, skickar GPT-Live uppgiften till en modell som kan söka i vår kurskatalog och göra planen.
GPT-Live-1 erbjuder Responses-delegering och klientdelegering. Responses-delegering låter OpenAI hantera backend-anropet, medan klientdelegering lämnar över det till din kod. Jag använde Responses-delegering eftersom det undviker ytterligare en backend-loop i den här appen.
Jag använde gpt-5.6-sol. OpenAI:s delegeringsguide använder gpt-5.6-terra som utgångsexempel och listar gpt-5.6-luna för billigare uppgifter. Med Sol returnerade backend den begärda planstrukturen.
Låt tool_choice vara auto så att backend kan välja webbsökning eller sparfunktionen. Delegeringsläget är fast vid start; byt till klientdelegering genom att stänga den aktuella sessionen och skapa en ny.
Regeln i Live-prompten är enkel: hälsningar och korta frågor stannar hos Live-modellen, medan en lärandeplan eller en ändring av den går till backend. Inget i API:et upprätthåller den gränsen. Testa med de typer av begäranden som din app kommer att få, eftersom modellen gör valet själv.
Väl delegerad har backend en uppgift: att omvandla den lärandes mål till en kort lista med DataCamp-resurser med länkar. Jag gav den verktyget web_search med filters.allowed_domains satt till datacamp.com och www.datacamp.com. Behandla det filtret som en sökinstruktion, inte som bevis på att varje länk är korrekt.
Exempel-målet ber om en dataingenjörsväg med 5 timmar per vecka, viss Python-kunskap och ingen SQL-erfarenhet. Svaret börjar med How to Learn Data Engineering From Scratch in 2026 och spåret Associate Data Engineer in SQL.
Återstående punkter blandar ett projekt, en Python-databaskurs, ytterligare ett spår och ett sista pipeline-projekt. Varje listad URL öppnar en befintlig DataCamp-sida.
Backend-prompten ber om fyra till sju ordnade objekt. Varje objekt har en titel, URL, kort motivering och en typ av course, project, track, eller article. Blandningen följer den lärandes angivna formatpreferens och veckotid.
Jag bad inte modellen gissa en kurslängd när sidan inte angav någon. Ett exakt tal i det fallet skulle påstå mer än källan stöder.
GPT-Live kan hålla röstsessionen aktiv medan Responses-backenden arbetar. Om den lärande lägger till kravet ”hands-on” innan den första planen returneras, avbryts inte det ursprungliga backend-arbetet automatiskt.
En muntlig rättelse avbryter inte automatiskt eller skriver om arbete som backend redan har påbörjat. Att avbryta assistentens tal och att ändra uppgiften är separata åtgärder. Applikationen avgör vad som händer med det äldre resultatet.
Servern spårar en task_version -räknare och ökar den när en ny delegering startar. När ett resultat anländer kontrollerar appen dess version innan den agerar; dess egen hanterare loggar ett gammalt resultat och kör det inte.
Responses-delegering har en begränsning här: Live-modellen tar emot backend-resultatet direkt, så versionskontrollen kan inte fullt ut styra dess nästa talade svar. Klientdelegering låter din kod kassera ett gammalt resultat innan det når modellen. Uppgiftsversionen skyddar alltså appåtgärder, inte varje ord assistenten kan säga.
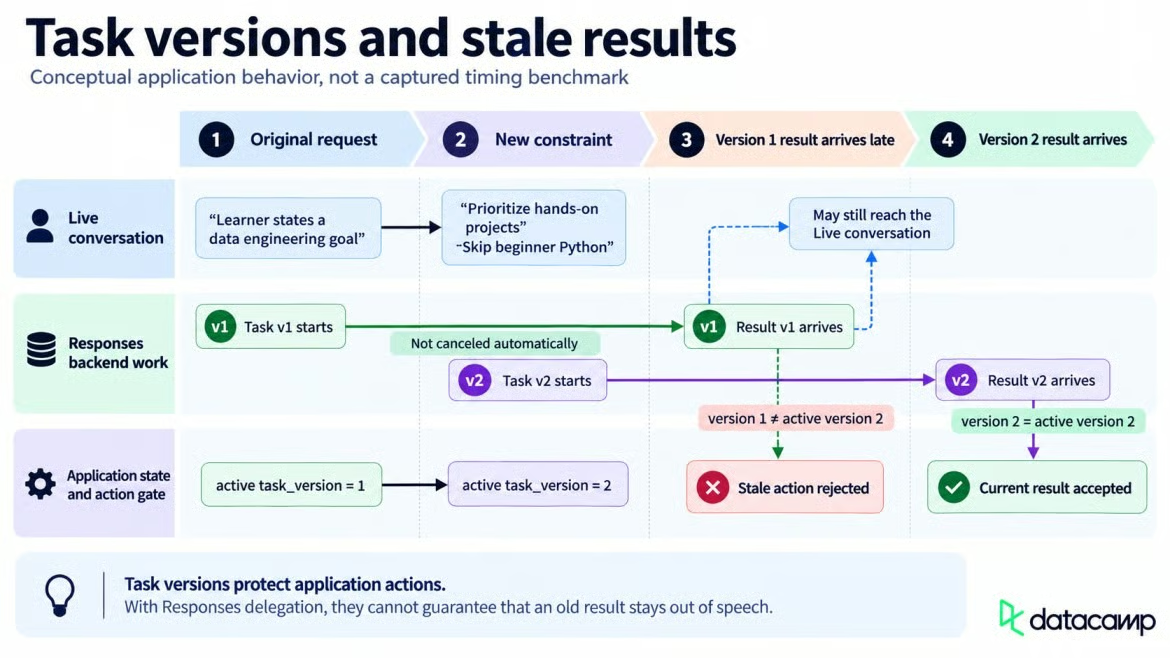
Uppgiftsversioner håller nyare begränsningar aktiva. Bild av författaren.
Efter att det första backend-svaret slutförts skickade jag en uppföljning med önskemål om praktiska projekt och ingen nybörjar-Python. Den reviderade sjuobjektsplanen började med Introduction to SQL, och blandade sedan ett spår, två kurser och fyra projekt, inklusive Exploring London's Travel Network och Building a Retail Data Pipeline. Det visar revidering över avslutade vändor; det säger inget om att stoppa ett aktivt svar.
Under backend-arbetet kan tre append-händelser uppdatera Live-modellen. session.thinking.append lägger till kontext som inte ska sägas högt, session.commentary.append lägger till text som modellen ska säga med egna ord, och session.instructions.append ändrar dess instruktioner.
Varje tillägg bär en vanlig sträng på högst 500 token. Dessa händelser uppdaterar Live-modellens kontext eller beteende; de modifierar eller avbryter inte en backend-Responses-uppgift som redan körs. En instruktion kan styra om aktuellt Live-beteende, medan commentary förser modellen med information som den bör förmedla högt.
Instrumentpanelen registrerar backend-framsteg men skickar inte dessa tilläggshändelser. Med Responses-delegering kan uppdateringar från din app fortfarande skickas via oai-events, men de använder delegation_id: null. Icke-nulla delegation-ID används för klientdelegerade uppgifter.
Behåll task_id och task_version i applikationstillståndet i stället för att använda delegation_id för något av dem.
I denna app sparar inte ett modellsvar någonting i sig. Backend använder save_learning_plan för att föreslå den väntande åtgärden, medan /api/save-plan äger själva skrivningen.
Backend-funktionsanrop anländer inuti response.event. Hanteraren väntar på ett nästlat response.output_item.done-objekt och läser sedan dess call_id, name, och arguments.
Att vänta på det slutförda objektet spelar roll eftersom tidigare händelser kan innehålla endast en del av anropet. Appen tolkar argumenten men kör inte funktionen än.
SAVE_LEARNING_PLAN_TOOL = {
    "type": "function",
    "name": "save_learning_plan",
    "description": "Propose the current learning plan for confirmation when the learner asks to save.",
    "parameters": {
        "type": "object",
        "properties": {
            "goal": {"type": "string"},
            "weekly_hours": {"type": "number"},
            "items": {
                "type": "array",
                "items": {
                    "type": "object",
                    "properties": {
                        "title": {"type": "string"},
                        "url": {"type": "string"},
                        "reason": {"type": "string"},
                        "type": {
                            "type": "string",
                            "enum": ["course", "project", "track", "article"],
                        },
                    },
                    "required": ["title", "url", "reason", "type"],
                    "additionalProperties": False,
                },
            },
        },
        "required": ["goal", "weekly_hours", "items"],
        "additionalProperties": False,
    },
    "strict": True,
}
Schemat ger appen en fast uppsättning fält att visa innan den ber den lärande om bekräftelse. Fältet type håller kurser, projekt, spår och artiklar explicita i den sparade datan.
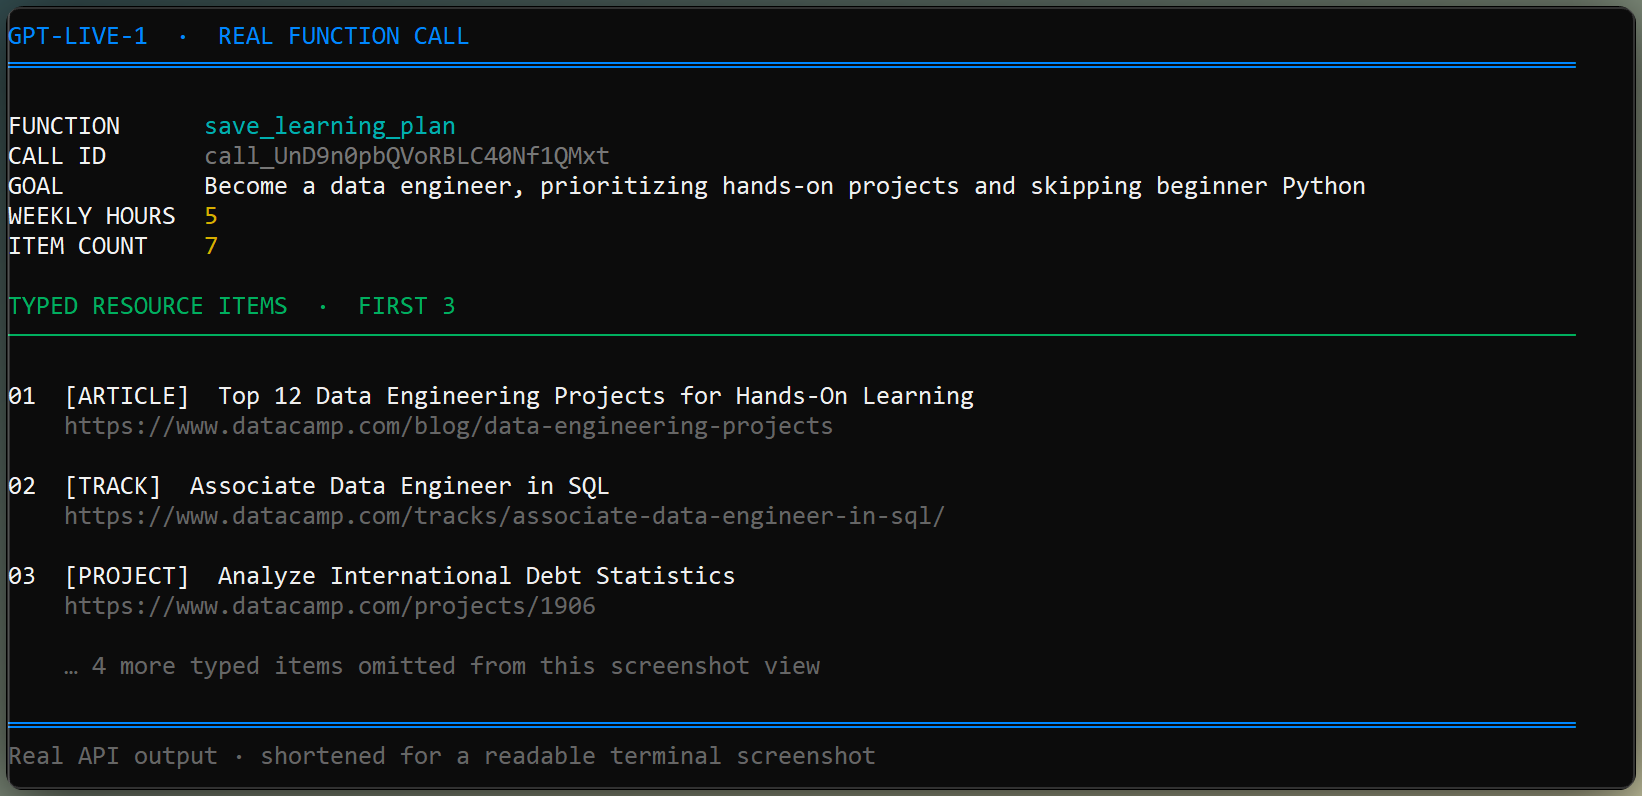
Terminalen visar typade argument till sparfunktionen. Bild av författaren.
När den lärande ber om att spara, anropar backend save_learning_plan med hela planen. Widgeten lagrar dessa argument och visar bekräftelserutan, men anropet är fortfarande bara ett förslag.
Att lämna det funktionsanropet obesvarat skulle blockera det delegerade svaret och senare backend-vändor. Widgeten besvarar det omedelbart med ett resultat i väntan på bekräftelse och skickar sedan response.create så att konversationen kan fortsätta.
events.send(JSON.stringify({
  type: "response.item.create",
  item: {
    type: "function_call_output",
    call_id: callId,
    output: JSON.stringify({
      status: "awaiting_user_confirmation",
      saved: false,
    }),
  },
}));
events.send(JSON.stringify({ type: "response.create" }));
Ingen fil skrivs vid denna tidpunkt. Assistenten kan hänvisa den lärande till knappen Bekräfta och spara utan att blockera senare delegerat arbete.
Slutpunkten /api/save-plan vägrar att skriva om inte confirmed är true. Eftersom ett transkript kan vara felaktigt eller ofullständigt sparar inte den muntliga begäran i sig planen.
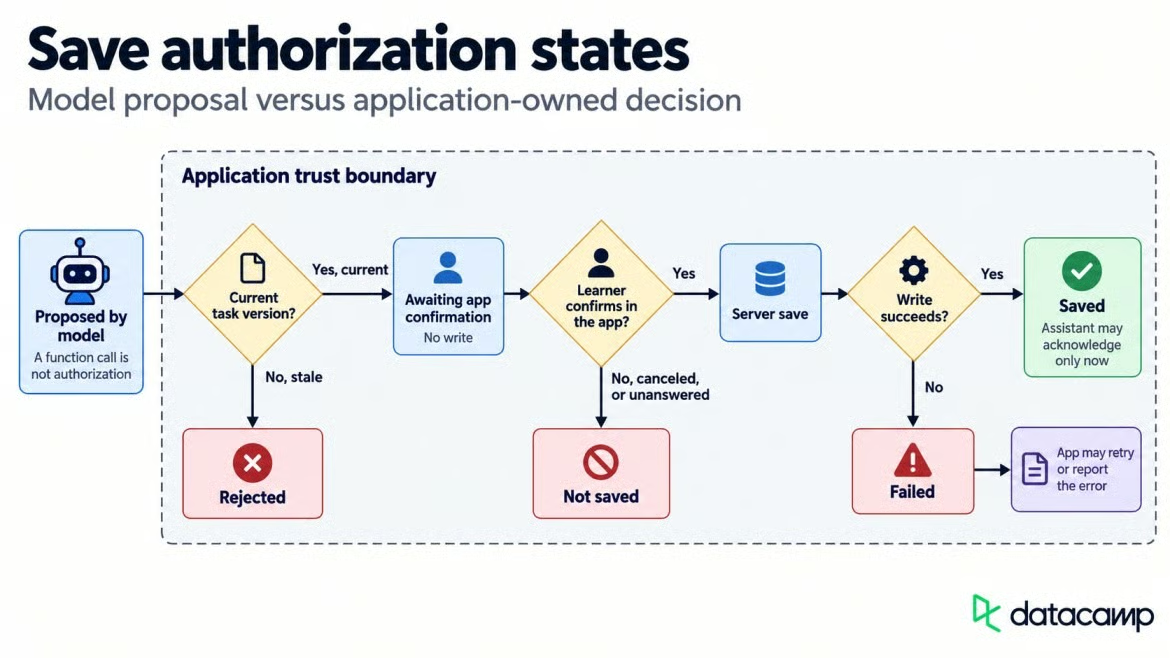
Bekräftelse skiljer begäranden från sparade åtgärder. Bild av författaren.
Klicket på Bekräfta skickar /api/save-plan den väntande planen och confirmed: true. Efter att servern returnerat ett plan-ID, skickar widgeten session.commentary.append med delegation_id: null eftersom det ursprungliga funktionsanropet redan var besvarat.
const saveResponse = await fetch(${SERVER}/api/save-plan, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    confirmed: true,
    plan: pendingFunctionCall.args,
  }),
});
const saveResult = await saveResponse.json();

events.send(JSON.stringify({
  type: "session.commentary.append",
  delegation_id: null,
  content: The plan was saved as ${saveResult.plan_id}.,
}));
Commentary-uppdateringen berättar för Live-modellen om den slutförda skrivningen och låter den bekräfta sparningen högt. Det tidigare funktionsanropet förblir stängt, och röstsessionen är fortsatt tillgänglig för den lärandes nästa begäran.
GitHub-repot som länkades tidigare innehåller FastAPI-servern, Streamlit-gränssnittet och WebRTC-widgeten i app/. Efter att du klonat det, öppna två terminaler i den mappen. Kör uvicorn server:app --host 127.0.0.1 --port 8000 i den ena och streamlit run streamlit_app.py i den andra.
Streamlit-gränssnittet omsluter samma server och widget som används genom hela bygget. Det placerar det levande samtalet bredvid lärandeplanen och backend-aktiviteten, medan instrumentpanelen uppdateras utan att återställa samtalet.
Videon nedan följer det uttalade målet, backend-sökningen, den reviderade planen och den bekräftade sparningen. Samtalet förblir öppet efter sparningen så att den lärande kan fortsätta.
Lär dig med DataCamp
course
course
course