Kursus
Memahami Prompt Engineering
1 Hr
230.3K
Saat pertama kali saya membuka sesi peramban GPT-Live-1, saya mengira akan mendapatkan pola suara yang biasa: bicara, tunggu, lalu dengar jawaban. Alih-alih, mikrofon tetap terbuka saat asisten merespons. Percakapannya terasa tidak kaku, tetapi aplikasi tetap harus mengelola pekerjaan yang berlangsung di belakangnya.
OpenAI pertama kali memperkenalkan GPT-Live di ChatGPT pada bulan Juli, lalu membawa GPT-Live-1 ke API awal minggu ini, tepat sebelum saya memulai build ini. Tutorial GPT-Realtime-2.1 kami membahas pendekatan satu model, sementara panduan GPT Live Transcribe kami berfokus pada teks langsung. Di sini, Anda akan membangun asisten pembelajaran suara yang menelusuri sumber daya DataCamp nyata dan menyimpan rencana hanya setelah konfirmasi.
Saya menamainya DataCamp Voice Learning Assistant. Ini adalah prototipe tutorial, bukan DataCamp AI Assistant produksi. Proyek ini mengikuti satu pembelajar dari tujuan yang diucapkan hingga rencana yang tersimpan.
GPT-Live-1 memisahkan pertukaran lisan dari pekerjaan backend. Empat temuan membentuk asisten pembelajaran ini.
Temuan-temuan ini berlaku untuk alur rencana pembelajaran ini. Prompt atau jaringan yang berbeda dapat mengubah perilaku, dan delegasi klien mengubah batas kendali.
GPT-Live-1 adalah model suara full-duplex dari OpenAI. Model ini menangani giliran bicara dan interupsi, termasuk jeda di antaranya, lalu mengirim pekerjaan yang lebih panjang seperti penelusuran atau pemanggilan alat ke backend.
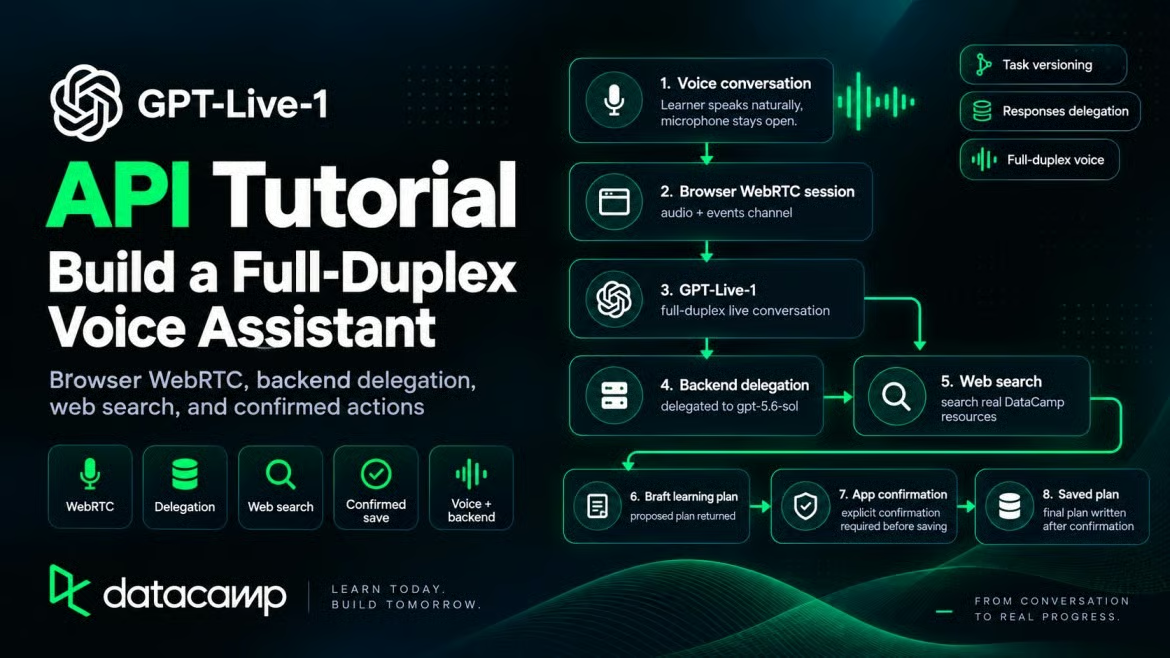
Bagi pembelajar, perbedaan pertama yang terlihat ada pada jeda tersebut.
Full duplex mengubah giliran berbicara. Anda bisa berhenti sejenak untuk berpikir atau berbicara bersamaan dengan asisten, dan asisten dapat berhenti untuk mendengar koreksi. Panduan prompting OpenAI menampilkan bagian prompt untuk pengakuan singkat dan interupsi.
Ini penting pada asisten pembelajaran. Seseorang yang menggambarkan tujuan karier mungkin berhenti, mengulang, atau menambahkan batasan di tengah jalan. Model yang menunggu lewat kalimat seperti "yah, sepertinya, mungkin lima jam seminggu" memungkinkan pembelajar berpikir keras.
Delegasi memindahkan tugas ke backend, tetapi tidak menyerahkan kendali aplikasi. Aplikasi tetap memutuskan siapa yang boleh bertindak dan apakah penyimpanan diizinkan. Aplikasi juga memiliki status tugas yang disimpan.
Jika Anda pernah menggunakan GPT-Realtime-2.1, Anda mungkin bertanya-tanya apakah GPT-Live-1 menggantikannya. Tidak.
GPT-Realtime-2.1 menangani mendengarkan, penalaran, dan pemilihan alat dalam satu model melalui v1/realtime, ditagihkan berdasarkan token audio dan teks. GPT-Live-1 menggunakan v1/live/sessions, menagih lapisan suara per detik, dan mengirim penalaran ke backend terpisah.
Realtime-2.1 bukan opsi yang lebih lama atau lebih rendah. Ia menggunakan desain yang berbeda.
Aplikasi mengambil tujuan yang diucapkan dan mengubahnya menjadi daftar berurutan sumber daya DataCamp nyata. Sesi suara tetap terbuka selama pekerjaan backend berlangsung. Saat permintaan berubah, aplikasi memperbarui versi tugasnya sebelum menjalankan aksi backend.
Tidak ada yang ditulis sampai pembelajar mengonfirmasi lagi di aplikasi.
Halaman peramban menahan koneksi WebRTC dan mikrofon, sementara server membuat sesi GPT-Live-1 dan menyimpan kunci API. Backend Responses (gpt-5.6-sol) menggunakan penelusuran web dan fungsi save_learning_plan . Versi tugas saat ini dan rencana yang dikonfirmasi tetap berada dalam state aplikasi.
Versi tugas menentukan aksi backend mana yang diterima aplikasi ketika permintaan berubah selama penelusuran. Gunakan repositori GitHub untuk aplikasi lengkap yang dapat dijalankan; bagian selanjutnya berfokus pada jalur GPT-Live-nya.
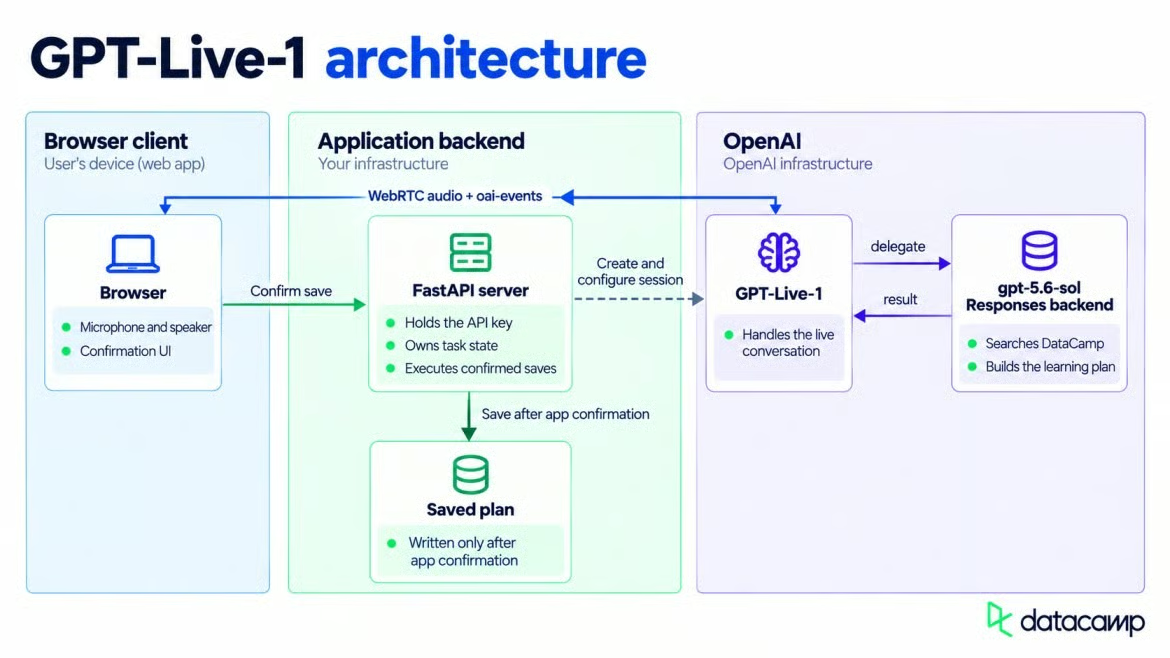
Peramban, GPT-Live-1, dan model backend terhubung. Gambar oleh Penulis.
Anda membutuhkan proyek OpenAI dengan akses GPT-Live-1 (tier gratis tidak mendukungnya), Python, dan peramban yang berjalan di HTTPS atau localhost agar prompt mikrofon dapat muncul. Saya menggunakan Python 3.11 dan openai 3.13.0. Live API membutuhkan minimal openai 3.12.0; versi yang lebih lama tidak memiliki atribut .live pada klien.
Batas sesi bersamaan bergantung pada tier penggunaan Anda. Periksa batas proyek sebelum membuka banyak tab peramban.
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install openai fastapi uvicorn python-dotenv streamlit requests
Di macOS atau Linux, aktifkan environment dengan source .venv/bin/activate sebagai gantinya. Buat berkas .env di root proyek dan tambahkan nilai berikut.
OPENAI_API_KEY=sk-...python-dotenv memuat berkas tersebut secara otomatis setelah server mengimpornya, sehingga kunci tidak perlu muncul di kode.
Klien OpenAI() membaca variabel lingkungan yang sama saat Anda tidak meneruskan kunci.
Peramban tidak pernah melihat kunci proyek Anda. Peramban mengirim penawaran WebRTC ke server Anda, yang menggunakan kunci untuk membuat sesi. Setelah pertukaran SDP, peramban mengirim audio ke OpenAI melalui WebRTC tanpa menerima kunci tersebut.
Panggilan GPT-Live di dalam /api/session membuat sesi dari penawaran SDP. Panggilan tersebut meneruskan instruksi suara, model backend, penelusuran web, dan fungsi simpan dalam permintaan yang sama.
result = client.live.create(
    session={
        "model": "gpt-live-1",
        "instructions": LIVE_INSTRUCTIONS,
        "delegation": {
            "type": "responses",
            "responses": {
                "model": "gpt-5.6-sol",
                "instructions": BACKEND_INSTRUCTIONS,
                "tools": [
                    {
                        "type": "web_search",
                        "filters": {
                            "allowed_domains": ["datacamp.com", "www.datacamp.com"]
                        },
                    },
                    SAVE_LEARNING_PLAN_TOOL,
                ],
                "tool_choice": "auto",
            },
        },
    },
    transport={"type": "webrtc", "sdp": sdp},
)
Panggilan tersebut mengirim permintaan ke POST /v1/live/sessions dan mengembalikan ID sesi dengan jawaban SDP. Permintaan HTTP memulai sesi, jadi jangan kirim peristiwa session.start terpisah setelahnya.
Server contoh hanya menerima permintaan peramban dari localhost:8501 dan 127.0.0.1:8501. Aturan itu untuk penggunaan lokal.
Jika Anda menerapkan aplikasi, ganti origin tersebut dan lakukan autentikasi pada /api/session dan /api/save-plan. Batasi laju pembuatan sesi karena setiap permintaan dapat menghabiskan biaya dan konsumsi konkuren. Klien dapat mengirim confirmed: true sendiri, jadi server publik tidak bisa memperlakukan field tersebut sebagai bukti siapa yang membuat permintaan.
Mengikuti panduan WebRTC OpenAI, peramban meminta akses mikrofon dan membuka RTCPeerConnection. Gunakan label kanal data terdokumentasi oai-events dan buat sebelum menghasilkan penawaran SDP. Kanal itu membawa peristiwa JSON dua arah setelah sesi dimulai.
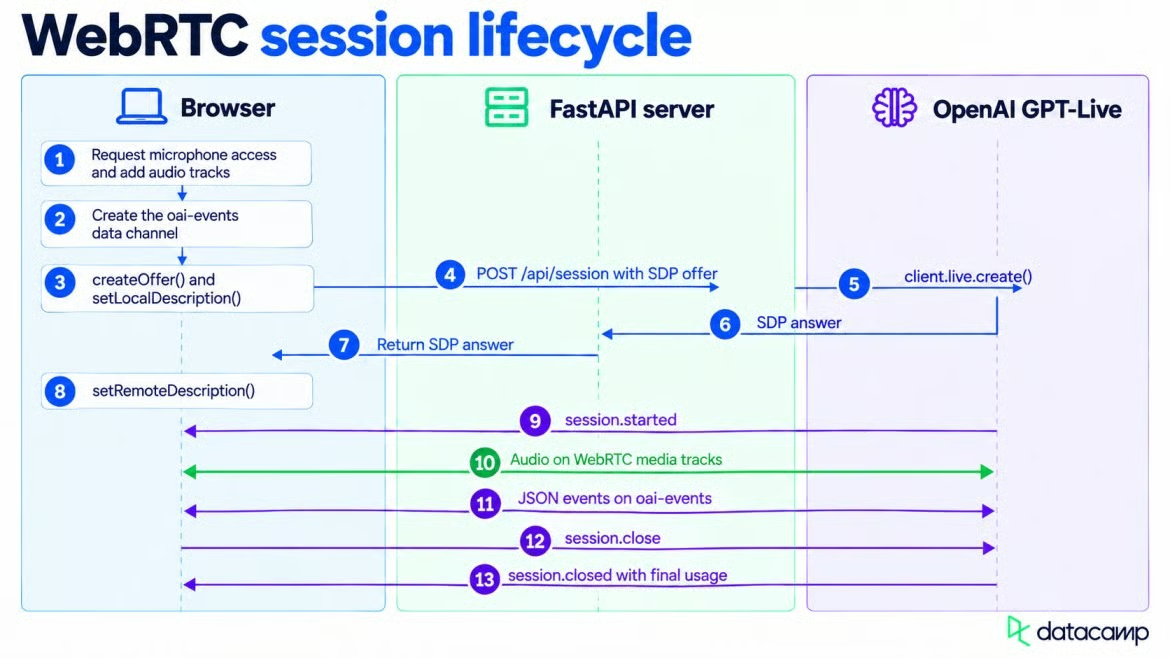
WebRTC dimulai, melakukan streaming audio, lalu ditutup. Gambar oleh Penulis.
Penyiapan media itu sendiri adalah WebRTC biasa. Peristiwa GPT-Live menggunakan kanal data yang dibuat di baris terakhir.
const connection = new RTCPeerConnection();
connection.addEventListener("track", (event) => {
  audio.srcObject = new MediaStream([event.track]);
  audio.play();
});
const microphone = await navigator.mediaDevices.getUserMedia({ audio: true });
for (const track of microphone.getAudioTracks()) {
  connection.addTrack(track, microphone);
}
const events = connection.createDataChannel("oai-events");
Setelah membuat penawaran, peramban memanggil setLocalDescription() dan menunggu pengumpulan ICE selesai. Peramban mengirim SDP lokal ke /api/session, lalu menerapkan jawaban OpenAI dengan setRemoteDescription(). Audio mikrofon dan ucapan asisten berjalan pada trek media, sehingga permintaan speech-to-text dan text-to-speech terpisah tidak diperlukan.
Audio tidak ditempatkan pada oai-events. Jangan kirim session.input_audio.append atau menunggu session.output_audio.delta di kanal data WebRTC.
Kanal data mengikuti aturan waktu yang berbeda. Tunggu session.started sebelum mengirim peristiwa melalui oai-events. Pada percobaan pertama saya, saya mengirim satu peristiwa terlalu dini dan koneksi mengabaikannya.
Saya tidak mendapat galat yang berguna, yang membuat kesalahan urutan kecil itu cukup mengganggu untuk dilacak.
Jika Anda tidak memerlukan teks langsung yang terlihat, Anda bisa melewatkan subbagian ini; koneksi audio sudah lengkap.
session.input_transcript.delta dan session.output_transcript.delta mengembalikan potongan teks dengan offset milidetik untuk teks langsung. Dokumentasi OpenAI mengingatkan bahwa potongan transkrip bukan giliran yang sudah selesai. Pengiriman bisa tidak merata, dan interval transkrip pengguna dan asisten bisa tumpang tindih.
Tambahkan potongan transkrip ke layar saat tiba, tetapi jangan memulai pekerjaan backend darinya. Model yang memutuskan kapan mendelegasikan.
Instruksi model Live sebaiknya singkat. Panduan OpenAI menempatkan langkah tugas terperinci di prompt backend. Saya mempertahankan prosedur tugas di sana dan membuat prompt Live berfokus pada ujaran.
Kutipan ini memisahkan perilaku suara dari tugas rencana pembelajaran. Aturan ujaran tetap di atas kondisi yang memicu delegasi.
You are Sage, a warm, encouraging voice learning coach for DataCamp learners.
Speak naturally at an unhurried pace. Be clear and direct, not overly cheerful.

Backchannel policy: Use moderate backchannels without competing with the response.
Interruption policy: Stop speaking when the learner interrupts, and listen.

Delegation policy:
Backend tools:
- learning_plan_research: search DataCamp resources and assemble a personalized learning plan.
- save_learning_plan: propose the current plan for app confirmation when the learner asks to save.

Delegate to the backend when:
- The learner states or changes a goal, skill level, or weekly time.
- A correction changes the plan already requested.
- The learner asks to save the plan.

Do not delegate for greetings, small clarifications, or a result already given.

Saving: a proposed save only asks the app to confirm. Do not say the plan is saved until the app reports a saved result.
After a save, keep the conversation open and ask what the learner wants next.
Aturan ini membiarkan sapaan di lapisan Live dan mengirim permintaan riset atau simpan ke backend. Konfirmasi tetap menjadi milik aplikasi.
Baris backchannel dan interupsi memberi tahu asisten cara merespons di sekitar jeda. "Backchannel moderat" meminta pengakuan sesekali seperti "mm-hmm" tanpa mengisi setiap keheningan. Saya memilih tingkat itu untuk memberi ruang bagi pembelajar berpikir; pelajaran dengan jeda lebih panjang mungkin membutuhkan pengakuan yang lebih sedikit.
Ubah baris tersebut jika aplikasi Anda membutuhkan perilaku berbeda; menambahkan "jangan pernah berbicara saat pengguna sedang berbicara" juga menghapus backchannel.
Kedua prompt memiliki tugas berbeda. Prompt Live mengendalikan ujaran dan alih-tugas, sementara prompt backend mengendalikan riset dan format jawaban. Panduan OpenAI menyarankan untuk tidak menempatkan langkah penelusuran terperinci dalam instruksi suara.
Pemisahan yang dijelaskan sebelumnya muncul di field delegation sesi. Saat pembelajar menyatakan tujuan, GPT-Live mengirim tugas ke model yang dapat menelusuri katalog kursus kami dan membuat rencana.
GPT-Live-1 menawarkan delegasi Responses dan delegasi klien. Delegasi Responses membiarkan OpenAI mengelola panggilan backend, sementara delegasi klien menyerahkannya ke kode Anda. Saya menggunakan delegasi Responses karena menghindari putaran backend lain di aplikasi ini.
Saya menggunakan gpt-5.6-sol. Panduan delegasi OpenAI menggunakan gpt-5.6-terra sebagai contoh awal dan mencantumkan gpt-5.6-luna untuk tugas berbiaya lebih rendah. Dengan Sol, backend mengembalikan struktur rencana yang diminta.
Biarkan tool_choice disetel ke auto agar backend dapat memilih penelusuran web atau fungsi simpan. Mode delegasi ditetapkan saat startup; beralih ke delegasi klien dengan menutup sesi saat ini dan membuat yang baru.
Aturan dalam prompt Live sederhana: sapaan dan pertanyaan singkat tetap pada model Live, sementara rencana pembelajaran atau perubahan pada rencana tersebut masuk ke backend. Tidak ada yang di API yang menegakkan batasan itu. Ujilah dengan jenis permintaan yang akan diterima aplikasi Anda karena model yang membuat pilihan sendiri.
Setelah didelegasikan, backend memiliki satu tugas: mengubah tujuan pembelajar menjadi daftar singkat sumber daya DataCamp dengan tautan. Saya memberinya alat web_search dengan filters.allowed_domains disetel ke datacamp.com dan www.datacamp.com. Perlakukan filter tersebut sebagai instruksi penelusuran, bukan bukti bahwa setiap tautan benar.
Tujuan contoh meminta jalur rekayasa data dengan 5 jam per minggu, sedikit pengetahuan Python, dan tanpa pengalaman SQL. Respons dimulai dengan Cara Belajar Data Engineering dari Nol pada 2026 dan track Associate Data Engineer in SQL.
Item yang tersisa mencampurkan sebuah proyek, kursus basis data Python, track lainnya, dan proyek pipeline terakhir. Setiap URL yang terdaftar membuka halaman DataCamp yang ada.
Prompt backend meminta empat hingga tujuh item berurutan. Setiap item memiliki judul, URL, alasan singkat, dan tipe course, project, track, atau article. Komposisinya mengikuti preferensi format yang dinyatakan pembelajar dan waktu mingguan.
Saya tidak meminta model menebak durasi kursus ketika halamannya tidak menyebutkannya. Angka tepat dalam kasus itu akan mengklaim lebih dari yang didukung sumbernya.
GPT-Live dapat menjaga sesi suara tetap aktif saat backend Responses bekerja. Jika pembelajar menambahkan batasan praktik langsung sebelum rencana pertama kembali, pekerjaan backend asli tidak dibatalkan secara otomatis.
Koreksi lisan tidak secara otomatis membatalkan atau menulis ulang pekerjaan yang sudah dimulai backend. Menginterupsi ucapan asisten dan mengubah tugas adalah aksi terpisah. Aplikasi yang memutuskan apa yang terjadi pada hasil yang lebih lama.
Server melacak penghitung task_version dan menambahkannya setiap kali delegasi baru dimulai. Saat hasil tiba, aplikasi memeriksa versinya sebelum bertindak; handler miliknya mencatat hasil lama dan tidak mengeksekusinya.
Delegasi Responses memiliki batas di sini: model Live menerima hasil backend secara langsung, sehingga pemeriksaan versi tidak bisa sepenuhnya mengendalikan balasan lisan berikutnya. Delegasi klien memungkinkan kode Anda mengabaikan hasil lama sebelum mencapai model. Karena itu, versi tugas melindungi aksi aplikasi, bukan setiap kata yang mungkin diucapkan asisten.
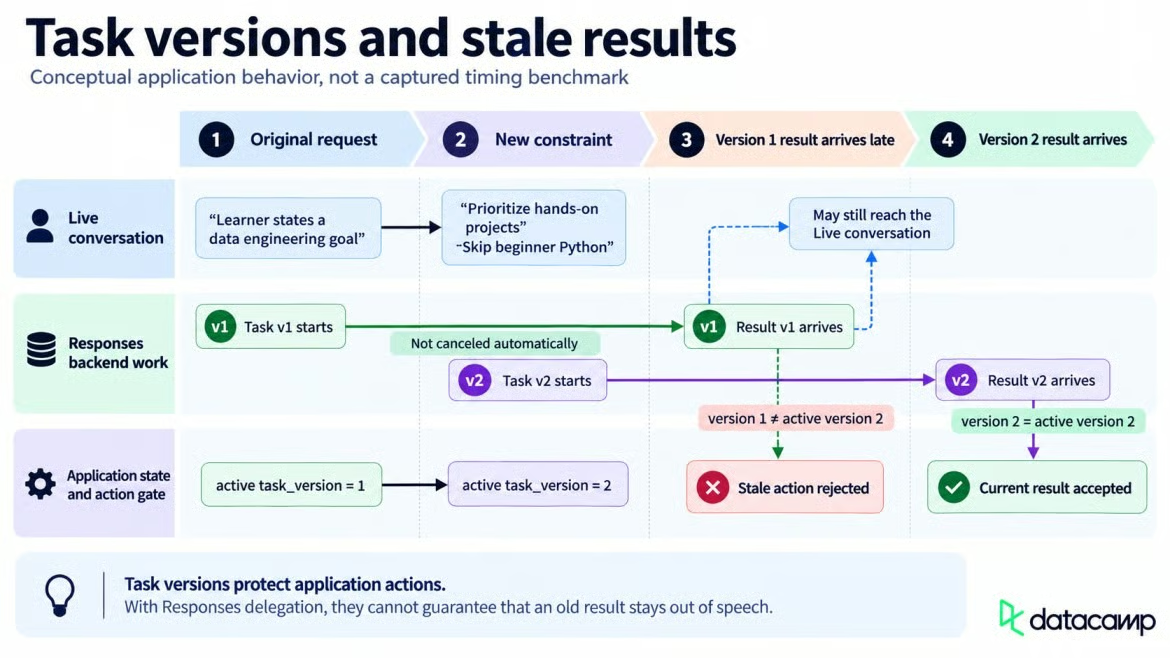
Versi tugas menjaga batasan yang lebih baru tetap aktif. Gambar oleh Penulis.
Setelah respons backend pertama selesai, saya mengirim tindak lanjut yang meminta proyek praktik langsung dan tanpa Python pemula. Rencana tujuh item yang direvisi dimulai dengan Introduction to SQL, lalu mencampurkan satu track, dua kursus, dan empat proyek, termasuk Exploring London's Travel Network dan Building a Retail Data Pipeline. Itu menunjukkan revisi lintas giliran yang sudah selesai; tidak mengatakan apa pun tentang menghentikan respons aktif.
Selama pekerjaan backend, tiga peristiwa append dapat memperbarui model Live. session.thinking.append menambahkan konteks yang tidak boleh diucapkan, session.commentary.append menambahkan teks untuk diucapkan model dengan kata-katanya sendiri, dan session.instructions.append mengubah instruksinya.
Setiap append membawa string polos maksimal 500 token. Peristiwa ini memperbarui konteks atau perilaku model Live; peristiwa ini tidak memodifikasi atau membatalkan tugas Responses backend yang sudah berjalan. Instruksi dapat mengarahkan ulang perilaku Live saat ini, sementara commentary memasok informasi yang harus dikomunikasikan model secara lisan.
Dasbor mencatat progres backend tetapi tidak mengirim peristiwa append ini. Dengan delegasi Responses, pembaruan dari aplikasi Anda tetap dapat dikirim melalui oai-events, tetapi menggunakan delegation_id: null. ID delegasi non-null digunakan untuk tugas yang didelegasikan klien.
Simpan task_id dan task_version di state aplikasi, bukan menggunakan delegation_id untuk keduanya.
Di aplikasi ini, balasan model tidak menyimpan apa pun dengan sendirinya. Backend menggunakan save_learning_plan untuk mengusulkan aksi tertunda, sementara /api/save-plan memiliki kendali atas penulisan sebenarnya.
Panggilan fungsi backend tiba di dalam response.event. Handler menunggu item bersarang response.output_item.done, lalu membaca call_id, name, dan arguments-nya.
Menunggu item yang sudah selesai itu penting karena peristiwa sebelumnya mungkin hanya berisi sebagian dari panggilan. Aplikasi mengurai argumen tetapi belum menjalankan fungsinya.
SAVE_LEARNING_PLAN_TOOL = {
    "type": "function",
    "name": "save_learning_plan",
    "description": "Propose the current learning plan for confirmation when the learner asks to save.",
    "parameters": {
        "type": "object",
        "properties": {
            "goal": {"type": "string"},
            "weekly_hours": {"type": "number"},
            "items": {
                "type": "array",
                "items": {
                    "type": "object",
                    "properties": {
                        "title": {"type": "string"},
                        "url": {"type": "string"},
                        "reason": {"type": "string"},
                        "type": {
                            "type": "string",
                            "enum": ["course", "project", "track", "article"],
                        },
                    },
                    "required": ["title", "url", "reason", "type"],
                    "additionalProperties": False,
                },
            },
        },
        "required": ["goal", "weekly_hours", "items"],
        "additionalProperties": False,
    },
    "strict": True,
}
Skema tersebut memberi aplikasi seperangkat field tetap untuk ditampilkan sebelum meminta konfirmasi pembelajar. Field type menjaga kursus, proyek, track, dan artikel tetap eksplisit dalam data yang disimpan.
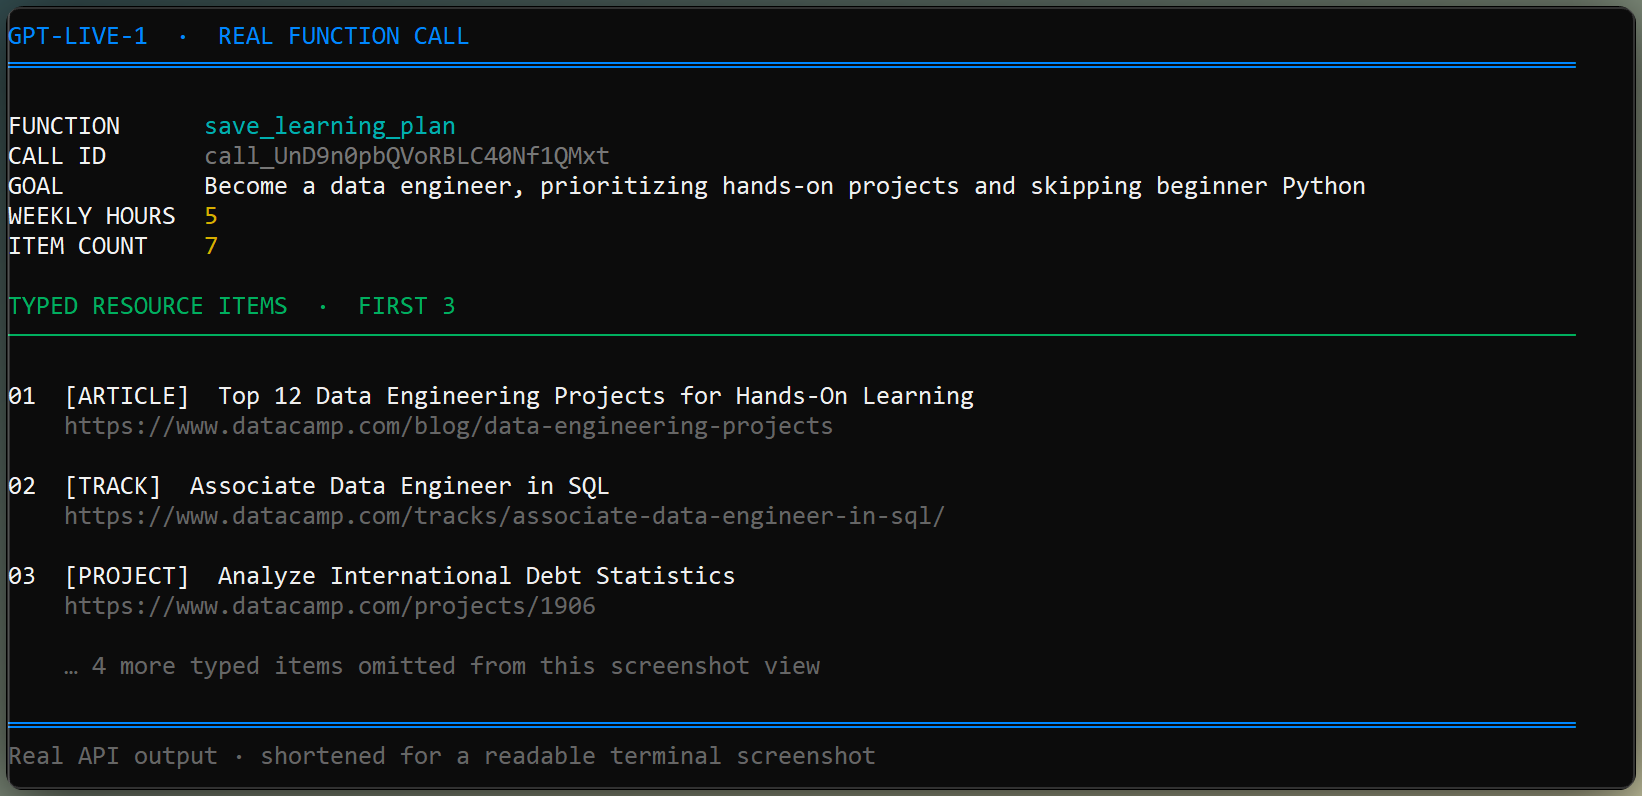
Terminal menampilkan argumen fungsi simpan bertipe. Gambar oleh Penulis.
Saat pembelajar meminta untuk menyimpan, backend memanggil save_learning_plan dengan rencana lengkap. Widget menyimpan argumen tersebut dan menampilkan kotak konfirmasi, tetapi panggilan itu tetap hanya usulan.
Membiarkan panggilan fungsi itu tanpa jawaban akan memblokir respons yang didelegasikan dan giliran backend selanjutnya. Widget segera menjawabnya dengan hasil menunggu konfirmasi, lalu mengirim response.create agar percakapan dapat berlanjut.
events.send(JSON.stringify({
  type: "response.item.create",
  item: {
    type: "function_call_output",
    call_id: callId,
    output: JSON.stringify({
      status: "awaiting_user_confirmation",
      saved: false,
    }),
  },
}));
events.send(JSON.stringify({ type: "response.create" }));
Belum ada berkas yang ditulis pada titik ini. Asisten dapat mengarahkan pembelajar ke tombol Konfirmasi dan simpan tanpa memblokir pekerjaan yang didelegasikan selanjutnya.
Endpoint /api/save-plan menolak menulis kecuali confirmed bernilai true. Karena transkrip mungkin salah atau tidak lengkap, permintaan lisan saja tidak menyimpan rencana.
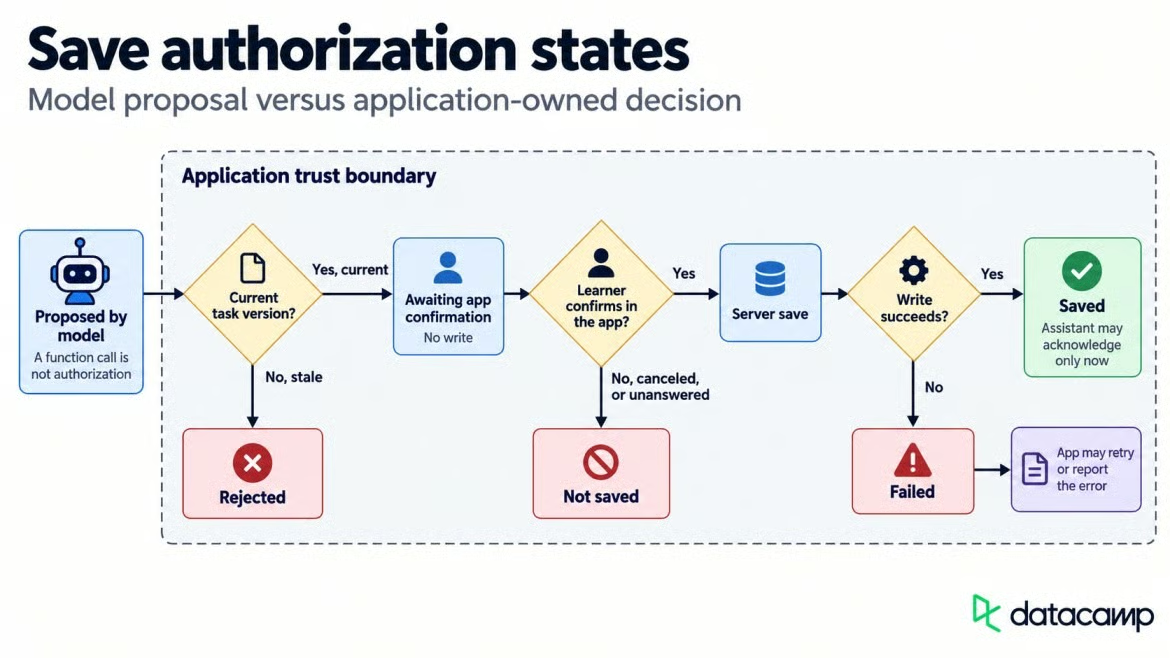
Konfirmasi memisahkan permintaan dari aksi tersimpan. Gambar oleh Penulis.
Klik Konfirmasi mengirim /api/save-plan rencana tertunda dan confirmed: true. Setelah server mengembalikan ID rencana, widget mengirim session.commentary.append dengan delegation_id: null karena panggilan fungsi asli sudah dijawab.
const saveResponse = await fetch(${SERVER}/api/save-plan, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    confirmed: true,
    plan: pendingFunctionCall.args,
  }),
});
const saveResult = await saveResponse.json();

events.send(JSON.stringify({
  type: "session.commentary.append",
  delegation_id: null,
  content: The plan was saved as ${saveResult.plan_id}.,
}));
Pembaruan commentary memberi tahu model Live tentang penulisan yang telah selesai dan membiarkannya mengakui penyimpanan secara lisan. Panggilan fungsi sebelumnya tetap tertutup, dan sesi suara tetap tersedia untuk permintaan berikutnya dari pembelajar.
Repositori GitHub yang ditautkan sebelumnya memuat server FastAPI, antarmuka Streamlit, dan widget WebRTC di dalam app/. Setelah mengkloningnya, buka dua terminal di folder tersebut. Jalankan uvicorn server:app --host 127.0.0.1 --port 8000 di salah satunya dan streamlit run streamlit_app.py di yang lain.
Antarmuka Streamlit membungkus server dan widget yang sama yang digunakan sepanjang build. Antarmuka menempatkan percakapan langsung di samping rencana pembelajaran dan aktivitas backend, sementara dasbor memperbarui tanpa mengatur ulang panggilan.
Video di bawah ini mengikuti tujuan yang diucapkan, penelusuran backend, rencana yang direvisi, dan simpan yang terkonfirmasi. Panggilan tetap terbuka setelah menyimpan sehingga pembelajar dapat melanjutkan.
Belajar bersama DataCamp
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt