Courses
ทำความเข้าใจ Prompt Engineering
1 ชม.
230.3K
ตอนที่เปิดเซสชันเบราว์เซอร์ GPT-Live-1 ครั้งแรก คาดหวังลูปเสียงแบบเดิมๆ: พูด รอ แล้วค่อยได้ยินคำตอบ แต่สิ่งที่เกิดขึ้นคือไมโครโฟนยังคงเปิดค้างขณะผู้ช่วยตอบ การสนทนาดูยืดหยุ่นขึ้น แต่แอปก็ยังต้องจัดการงานที่เกิดขึ้นเบื้องหลัง
OpenAI เปิดตัว GPT-Live ใน ChatGPT ครั้งแรกในเดือนกรกฎาคม แล้ว นำ GPT-Live-1 มาสู่ API เมื่อต้นสัปดาห์นี้ไม่นานก่อนเริ่มโปรเจกต์นี้ บทช่วยสอน GPT-Realtime-2.1 ของเราอธิบายแนวทางใช้โมเดลเดียว ขณะที่ คู่มือ GPT Live Transcribe เน้นคำบรรยายสด ที่นี่จะสร้างผู้ช่วยการเรียนรู้ด้วยเสียงที่ค้นหาทรัพยากรจริงของ DataCamp และบันทึกแผนเฉพาะหลังผ่านการยืนยัน
โปรเจกต์นี้เรียกว่า DataCamp Voice Learning Assistant เป็นต้นแบบสำหรับบทช่วยสอน ไม่ใช่ DataCamp AI Assistant ที่ใช้จริง โปรเจกต์นี้ติดตามผู้เรียนคนหนึ่งตั้งแต่เป้าหมายที่พูดออกมาจนถึงแผนที่ถูกบันทึก
GPT-Live-1 แยกการสนทนาเสียงออกจากงานแบ็กเอนด์ มี 4 ข้อค้นพบที่กำหนดรูปแบบผู้ช่วยการเรียนรู้นี้
ข้อค้นพบเหล่านี้ใช้กับโฟลว์การสร้างแผนการเรียนนี้เป็นหลัก คำสั่งหรือเครือข่ายที่ต่างออกไปอาจเปลี่ยนพฤติกรรมได้ และการมอบหมายงานฝั่งไคลเอนต์ก็เปลี่ยนขอบเขตการควบคุม
GPT-Live-1 เป็นโมเดลเสียงแบบฟูลดูเพล็กซ์ของ OpenAI รองรับเทิร์นการพูดและการขัดจังหวะ รวมถึงช่วงหยุดระหว่างนั้น แล้วส่งงานที่ใช้เวลานานกว่า เช่น การค้นหา หรือการเรียกใช้เครื่องมือ ไปยังแบ็กเอนด์
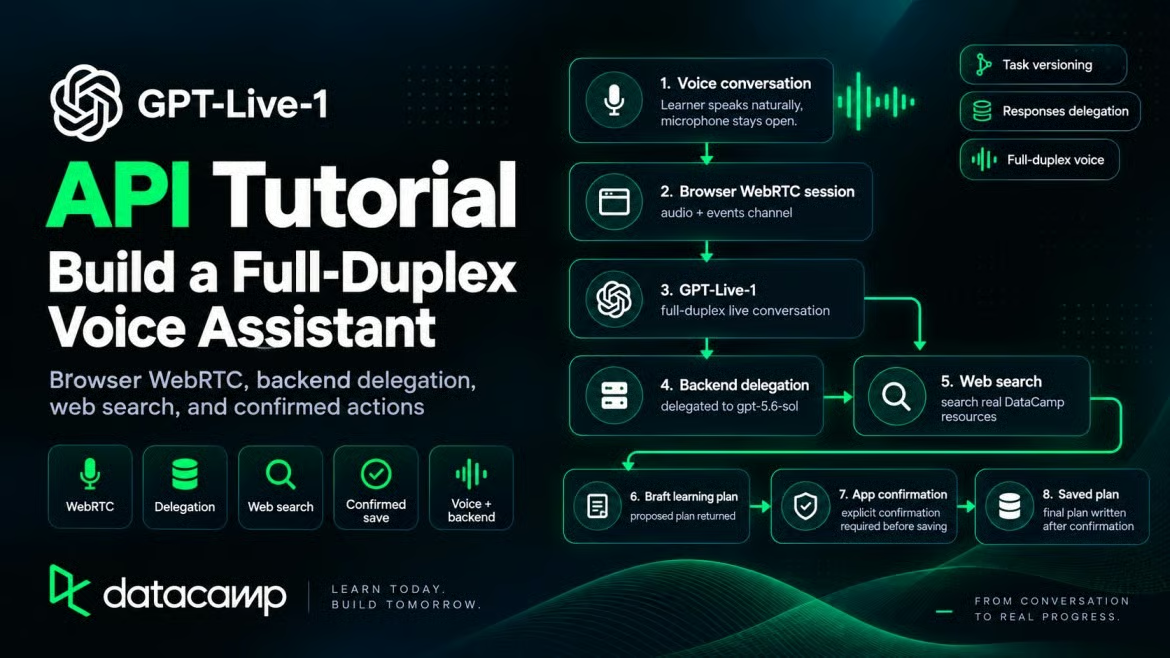
สำหรับผู้เรียน ความแตกต่างที่เห็นชัดที่สุดอยู่ที่ช่วงหยุดเหล่านั้น
โหมดฟูลดูเพล็กซ์เปลี่ยนวิธีรับส่งเทิร์น สามารถหยุดคิดหรือพูดแทรกผู้ช่วยได้ และผู้ช่วยก็หยุดเพื่อฟังการแก้ไขได้ คู่มือพรอมป์ตของ OpenAI แสดงส่วนพรอมป์ตสำหรับคำรับสั้นๆ และการขัดจังหวะ
สิ่งนี้สำคัญสำหรับผู้ช่วยการเรียนรู้ คนที่อธิบายเป้าหมายอาชีพอาจหยุด เริ่มใหม่ หรือใส่ข้อจำกัดกลางคัน โมเดลที่รอผ่านช่วง “เอ่อ คิดว่า อาจจะสัปดาห์ละห้าชั่วโมง” เปิดโอกาสให้ผู้เรียนคิดออกเสียง
การมอบหมายจะย้ายงานไปยังแบ็กเอนด์ แต่ไม่ได้โอนการควบคุมแอป แอปยังคงตัดสินใจว่าใครทำอะไรได้ และจะอนุญาตให้บันทึกหรือไม่ อีกทั้งยังเป็นเจ้าของสถานะของงานที่เก็บไว้
ถ้าเคยใช้ GPT-Realtime-2.1 อาจสงสัยว่า GPT-Live-1 มาแทนหรือไม่ คำตอบคือไม่
GPT-Realtime-2.1 จัดการการฟัง การให้เหตุผล และการเลือกเครื่องมือในโมเดลเดียวผ่าน v1/realtime โดยคิดค่าบริการตามโทเคนเสียงและข้อความ ส่วน GPT-Live-1 ใช้ v1/live/sessions คิดค่าบริการชั้นเสียงตามวินาที และส่งการให้เหตุผลไปยังแบ็กเอนด์แยกต่างหาก
Realtime-2.1 ไม่ได้เก่าหรือด้อยกว่า แต่ใช้การออกแบบคนละแบบ
แอปรับเป้าหมายที่พูดออกมาแล้วแปลงเป็นรายการเรียงลำดับของทรัพยากร DataCamp จริง เซสชันเสียงยังคงเปิดระหว่างที่แบ็กเอนด์ทำงาน เมื่อคำขอเปลี่ยน แอปจะอัปเดตเวอร์ชันของงานก่อนดำเนินการในแบ็กเอนด์
ยังไม่เขียนข้อมูลใดๆ จนกว่าผู้เรียนจะยืนยันอีกครั้งในแอป
หน้าเบราว์เซอร์ถือการเชื่อมต่อ WebRTC และไมโครโฟน ส่วนเซิร์ฟเวอร์สร้างเซสชัน GPT-Live-1 และเก็บคีย์ API ไว้ แบ็กเอนด์ของ Responses (gpt-5.6-sol) ใช้การค้นเว็บและฟังก์ชัน save_learning_plan เวอร์ชันงานปัจจุบันและแผนที่ยืนยันแล้วถูกเก็บไว้ในสถานะแอป
เวอร์ชันของงานเป็นตัวตัดสินว่าแอปจะยอมรับการกระทำของแบ็กเอนด์ใดเมื่อคำขอเปลี่ยนระหว่างการค้นหา ใช้ ที่เก็บ GitHub สำหรับแอปที่รันได้ครบถ้วน ส่วนต่อไปจะโฟกัสเส้นทาง GPT-Live ของแอปนี้
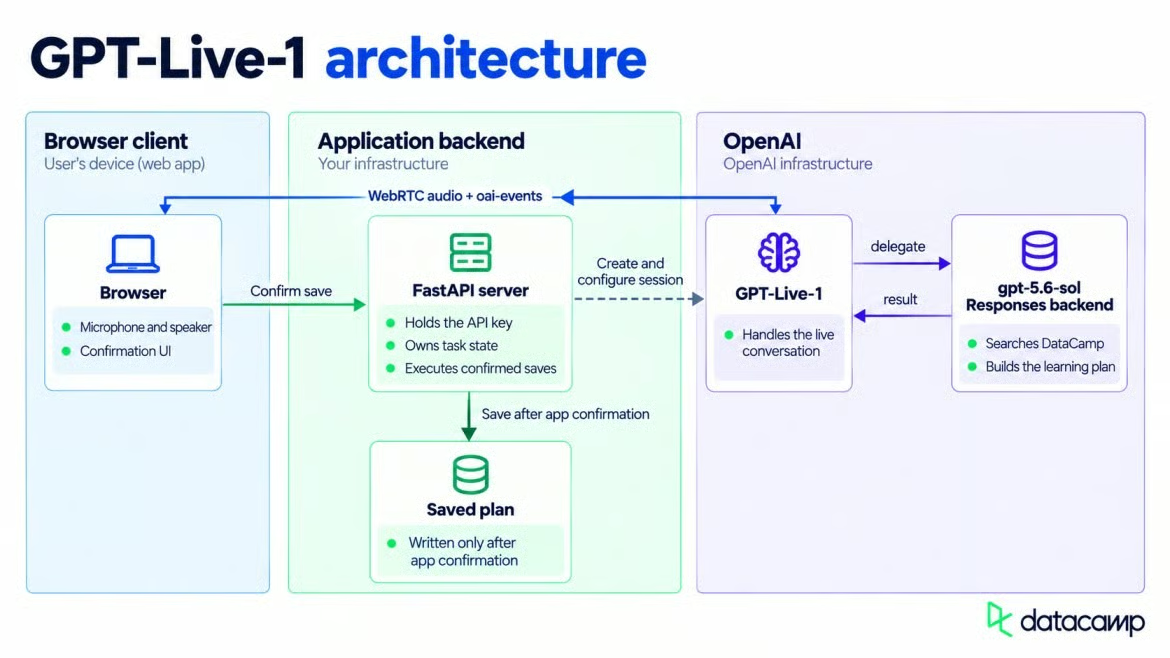
เบราว์เซอร์ GPT-Live-1 และโมเดลแบ็กเอนด์เชื่อมต่อกัน ภาพโดยผู้เขียน
ต้องมีโปรเจกต์ OpenAI ที่เข้าถึง GPT-Live-1 ได้ (ระดับฟรีไม่รองรับ) Python และเบราว์เซอร์ที่รันบน HTTPS หรือ localhost เพื่อให้พรอมป์ตไมโครโฟนแสดงได้ ใช้ Python 3.11 และ openai เวอร์ชัน 3.13.0 Live API ต้องการอย่างน้อย openai 3.12.0; เวอร์ชันเก่าไม่มีแอตทริบิวต์ .live บนไคลเอนต์
จำนวนเซสชันที่ใช้พร้อมกันขึ้นกับระดับการใช้งานของโปรเจกต์ ตรวจสอบลิมิตก่อนเปิดแท็บเบราว์เซอร์จำนวนมาก
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install openai fastapi uvicorn python-dotenv streamlit requests
บน macOS หรือ Linux ให้เปิดใช้งานสภาพแวดล้อมด้วย source .venv/bin/activate แทน จากนั้นสร้างไฟล์ .env ที่รูทของโปรเจกต์และเพิ่มค่านี้
OPENAI_API_KEY=sk-...python-dotenv จะโหลดไฟล์นั้นอัตโนมัติเมื่อเซิร์ฟเวอร์อิมพอร์ต ทำให้ไม่ต้องใส่คีย์ในโค้ด
ไคลเอนต์ OpenAI() จะอ่านตัวแปรสภาพแวดล้อมเดียวกันเมื่อไม่ส่งคีย์เข้าไป
เบราว์เซอร์จะไม่เห็นคีย์โปรเจกต์ของคุณ มันจะโพสต์ข้อเสนอ WebRTC ไปยังเซิร์ฟเวอร์ ซึ่งใช้คีย์เพื่อสร้างเซสชัน หลังการแลกเปลี่ยน SDP เบราว์เซอร์จะส่งเสียงไปยัง OpenAI ผ่าน WebRTC โดยไม่รับคีย์นั้น
การเรียก GPT-Live ภายใน /api/session จะสร้างเซสชันจากข้อเสนอ SDP พร้อมส่งคำสั่งเสียง โมเดลแบ็กเอนด์ การค้นเว็บ และฟังก์ชันบันทึก ในคำขอเดียวกัน
result = client.live.create(
    session={
        "model": "gpt-live-1",
        "instructions": LIVE_INSTRUCTIONS,
        "delegation": {
            "type": "responses",
            "responses": {
                "model": "gpt-5.6-sol",
                "instructions": BACKEND_INSTRUCTIONS,
                "tools": [
                    {
                        "type": "web_search",
                        "filters": {
                            "allowed_domains": ["datacamp.com", "www.datacamp.com"]
                        },
                    },
                    SAVE_LEARNING_PLAN_TOOL,
                ],
                "tool_choice": "auto",
            },
        },
    },
    transport={"type": "webrtc", "sdp": sdp},
)
คำสั่งนี้ส่งคำขอไปที่ POST /v1/live/sessions และคืนค่า session ID พร้อม SDP answer คำขอ HTTP จะเริ่มเซสชันทันที ดังนั้นไม่ต้องส่งเหตุการณ์ session.start แยกต่างหากภายหลัง
ตัวอย่างเซิร์ฟเวอร์ยอมรับคำขอจากเบราว์เซอร์เฉพาะ localhost:8501 และ 127.0.0.1:8501 กฎนี้ใช้สำหรับการใช้งานภายในเครื่อง
หากต้องการดีพลอยแอป ให้เปลี่ยน origin เหล่านั้นและยืนยันตัวตนทั้ง /api/session และ /api/save-plan จำกัดอัตราการสร้างเซสชันเพราะแต่ละคำขอมีค่าใช้จ่ายและกินทรัพยากรพร้อมกัน ไคลเอนต์สามารถส่ง confirmed: true ได้เอง ดังนั้นเซิร์ฟเวอร์สาธารณะห้ามใช้ฟิลด์นั้นเป็นหลักฐานยืนยันตัวผู้ส่งคำขอ
ตามคู่มือ WebRTC ของ OpenAI เบราว์เซอร์จะขอสิทธิ์ใช้ไมโครโฟนและเปิด RTCPeerConnection ใช้ป้ายกำกับช่องข้อมูล oai-events ตามเอกสาร และสร้างช่องนี้ก่อนสร้างข้อเสนอ SDP ช่องนี้จะขนส่งเหตุการณ์ JSON ได้สองทางเมื่อเซสชันเริ่ม
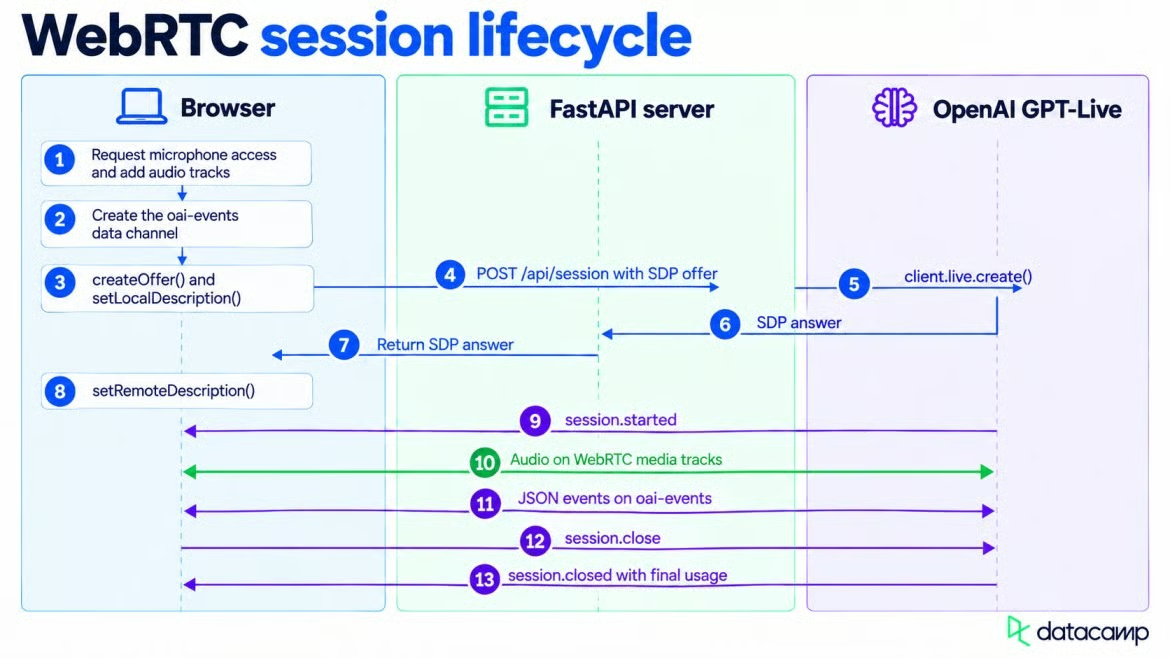
WebRTC เริ่ม สตรีมเสียง แล้วปิดอย่างเหมาะสม ภาพโดยผู้เขียน
การตั้งค่าสื่อเป็น WebRTC ปกติ เหตุการณ์ GPT-Live ใช้ช่องข้อมูลที่สร้างในบรรทัดสุดท้าย
const connection = new RTCPeerConnection();
connection.addEventListener("track", (event) => {
  audio.srcObject = new MediaStream([event.track]);
  audio.play();
});
const microphone = await navigator.mediaDevices.getUserMedia({ audio: true });
for (const track of microphone.getAudioTracks()) {
  connection.addTrack(track, microphone);
}
const events = connection.createDataChannel("oai-events");
หลังสร้างข้อเสนอแล้ว เบราว์เซอร์เรียก setLocalDescription() และรอให้การรวบรวม ICE เสร็จ แล้วส่ง SDP ฝั่งตนไปยัง /api/session จากนั้นนำคำตอบของ OpenAI มาตั้งด้วย setRemoteDescription() เสียงไมโครโฟนและเสียงผู้ช่วยเดินทางบนแทร็กสื่อ จึงไม่ต้องมีคำขอ speech-to-text และ text-to-speech แยกต่างหาก
เสียงไม่ควรถูกส่งบน oai-events ไม่ต้องส่ง session.input_audio.append หรือรอ session.output_audio.delta บนช่องข้อมูล WebRTC
ช่องข้อมูลมีหลักการเรื่องเวลาอีกแบบหนึ่ง รอเหตุการณ์ session.started ก่อนส่งเหตุการณ์ผ่าน oai-events ครั้งแรกลองส่งเร็วเกินไป การเชื่อมต่อก็เมินเฉย
ไม่ได้ข้อผิดพลาดที่เป็นประโยชน์ ทำให้การตามลำดับที่ผิดเล็กน้อยกลายเป็นเรื่องน่ารำคาญ
ถ้าไม่ต้องแสดงคำบรรยายสด สามารถข้ามส่วนย่อยนี้ได้ การเชื่อมต่อเสียงเสร็จสมบูรณ์แล้ว
session.input_transcript.delta และ session.output_transcript.delta ส่งคืนชิ้นข้อความพร้อมออฟเซ็ตระดับมิลลิวินาทีเพื่อใช้เป็นคำบรรยายสด เอกสารของ OpenAI เตือนว่าชิ้นทรานสคริปต์ไม่ใช่เทิร์นที่เสร็จสมบูรณ์ การจัดส่งอาจไม่สม่ำเสมอ และช่วงของผู้ใช้กับผู้ช่วยอาจทับซ้อน
นำชิ้นทรานสคริปต์มาต่อแสดงบนหน้าจอตามที่มาถึง แต่ไม่ควรเริ่มงานแบ็กเอนด์จากชิ้นเหล่านั้น โมเดลจะเป็นผู้ตัดสินใจว่าเมื่อใดควรมอบหมาย
คำสั่งของโมเดล Live ควรกระชับ คู่มือของ OpenAI แนะนำให้วางขั้นตอนงานที่ละเอียดในพรอมป์ตฝั่งแบ็กเอนด์ จึงเก็บขั้นตอนงานไว้ที่นั่นและปล่อยให้พรอมป์ต Live โฟกัสกับการพูด
ตัวอย่างนี้แยกพฤติกรรมเสียงออกจากงานจัดทำแผนการเรียน กฎการพูดวางไว้เหนือเงื่อนไขที่กระตุ้นให้มอบหมาย
You are Sage, a warm, encouraging voice learning coach for DataCamp learners.
Speak naturally at an unhurried pace. Be clear and direct, not overly cheerful.

Backchannel policy: Use moderate backchannels without competing with the response.
Interruption policy: Stop speaking when the learner interrupts, and listen.

Delegation policy:
Backend tools:
- learning_plan_research: search DataCamp resources and assemble a personalized learning plan.
- save_learning_plan: propose the current plan for app confirmation when the learner asks to save.

Delegate to the backend when:
- The learner states or changes a goal, skill level, or weekly time.
- A correction changes the plan already requested.
- The learner asks to save the plan.

Do not delegate for greetings, small clarifications, or a result already given.

Saving: a proposed save only asks the app to confirm. Do not say the plan is saved until the app reports a saved result.
After a save, keep the conversation open and ask what the learner wants next.
กฎเหล่านี้ปล่อยให้การทักทายอยู่ในเลเยอร์ Live และส่งคำขอค้นคว้าหรือบันทึกไปยังแบ็กเอนด์ ส่วนการยืนยันยังเป็นหน้าที่ของแอป
บรรทัดที่ว่าด้วย backchannel และการขัดจังหวะบอกผู้ช่วยว่าควรตอบสนองอย่างไรระหว่างช่วงหยุด “backchannel ระดับปานกลาง” ขอให้มีคำรับเป็นระยะ เช่น “อือฮึ” โดยไม่กลบเสียงผู้เรียน เลือกระดับนี้เพื่อเปิดพื้นที่ให้ผู้เรียนได้คิด บทเรียนที่ต้องการช่วงหยุดยาวขึ้นอาจต้องลดคำรับลง
ปรับบรรทัดนั้นได้ตามพฤติกรรมที่แอปต้องการ เช่น เพิ่ม “ห้ามพูดทับขณะผู้ใช้กำลังพูด” ก็จะตัด backchannel ออกไปด้วย
พรอมป์ตสองชุดทำหน้าที่ต่างกัน พรอมป์ต Live ควบคุมการพูดและการส่งต่องาน ส่วนพรอมป์ตฝั่งแบ็กเอนด์ควบคุมการค้นคว้าและรูปแบบคำตอบ คู่มือของ OpenAI ไม่แนะนำให้ใส่ขั้นตอนค้นหาอย่างละเอียดไว้ในคำสั่งเสียง
การแยกที่กล่าวมาก่อนหน้านี้ปรากฏในฟิลด์ delegation ของเซสชัน เมื่อผู้เรียนระบุเป้าหมาย GPT-Live จะส่งงานไปยังโมเดลที่ค้นหาคอร์สในแค็ตตาล็อกของเราและจัดทำแผน
GPT-Live-1 มีการมอบหมายงานแบบ Responses และแบบฝั่งไคลเอนต์ การมอบหมายให้ Responses ให้ OpenAI จัดการการเรียกแบ็กเอนด์ ส่วนแบบฝั่งไคลเอนต์ส่งไปให้โค้ดของคุณ ใช้แบบ Responses เพราะเลี่ยงลูปแบ็กเอนด์เพิ่มเติมในแอปนี้
ใช้ gpt-5.6-sol คู่มือการมอบหมายของ OpenAI ใช้ gpt-5.6-terra เป็นตัวอย่างตั้งต้นและระบุ gpt-5.6-luna สำหรับงานที่ต้นทุนต่ำกว่า กับ Sol แบ็กเอนด์ส่งคืนโครงสร้างแผนตามที่ร้องขอ
คงค่า tool_choice ไว้ที่ auto เพื่อให้แบ็กเอนด์เลือกการค้นเว็บหรือฟังก์ชันบันทึกได้ โหมดการมอบหมายถูกกำหนดตั้งแต่เริ่มต้น สลับเป็นแบบฝั่งไคลเอนต์ได้โดยปิดเซสชันปัจจุบันแล้วสร้างใหม่
กฎในพรอมป์ต Live นั้นเรียบง่าย: การทักทายและคำถามสั้นๆ อยู่กับโมเดล Live ส่วนแผนการเรียนหรือการเปลี่ยนแปลงแผนจะส่งไปแบ็กเอนด์ ไม่มีสิ่งใดใน API บังคับเส้นแบ่งนั้น ทดสอบด้วยคำขอประเภทที่แอปของคุณจะได้รับเพราะโมเดลเป็นผู้เลือกเอง
เมื่อถูกมอบหมาย แบ็กเอนด์มีงานเดียว: แปลงเป้าหมายของผู้เรียนเป็นรายการสั้นๆ ของทรัพยากร DataCamp พร้อมลิงก์ ให้เครื่องมือ web_search โดยตั้งค่า filters.allowed_domains เป็น datacamp.com และ www.datacamp.com ปฏิบัติตัวกรองนั้นเป็นคำสั่งค้นหา ไม่ใช่หลักฐานว่าทุกลิงก์ถูกต้อง
เป้าหมายตัวอย่างขอเส้นทางสู่สาย Data Engineering สัปดาห์ละ 5 ชั่วโมง มีความรู้ Python บ้าง และไม่มีพื้นฐาน SQL คำตอบเริ่มจาก How to Learn Data Engineering From Scratch in 2026 และแทร็ก Associate Data Engineer in SQL
รายการที่เหลือผสมโปรเจกต์ คอร์สฐานข้อมูล Python อีกหนึ่งแทร็ก และโปรเจกต์ปิดท้ายด้าน Pipeline ทุก URL ที่ระบุเปิดไปยังหน้าของ DataCamp ที่มีอยู่จริง
พรอมป์ตแบ็กเอนด์ขอไอเท็ม 4 ถึง 7 รายการตามลำดับ แต่ละรายการมีชื่อ URL เหตุผลสั้นๆ และชนิดเป็น course, project, track, หรือ article ส่วนผสมขึ้นอยู่กับรูปแบบที่ผู้เรียนชอบและเวลาต่อสัปดาห์
ไม่ได้ขอให้โมเดลคาดเดาระยะเวลาคอร์สเมื่อหน้าเพจไม่ได้ระบุ ตัวเลขที่แน่นอนในกรณีนั้นจะเกินกว่าที่แหล่งอ้างอิงรองรับ
GPT-Live สามารถเปิดเซสชันเสียงค้างในขณะที่แบ็กเอนด์แบบ Responses ทำงาน หากผู้เรียนเพิ่มข้อจำกัดแบบลงมือทำก่อนแผนแรกจะกลับมา งานแบ็กเอนด์เดิมจะไม่ถูกยกเลิกโดยอัตโนมัติ
การแก้ไขด้วยเสียงไม่ได้ยกเลิกหรือเขียนทับงานที่แบ็กเอนด์เริ่มไปแล้วโดยอัตโนมัติ การขัดจังหวะคำพูดของผู้ช่วยและการเปลี่ยนงานเป็นการกระทำคนละส่วน แอปเป็นผู้ตัดสินใจว่าจะจัดการผลลัพธ์เก่าอย่างไร
เซิร์ฟเวอร์ติดตามตัวนับ task_version และเพิ่มค่าทุกครั้งที่มีการมอบหมายใหม่ เมื่อผลลัพธ์มาถึง แอปจะตรวจเวอร์ชันก่อนดำเนินการ หากเป็นผลลัพธ์เก่า ตัวจัดการจะล็อกไว้และไม่รันต่อ
การมอบหมายงานแบบ Responses มีข้อจำกัดตรงนี้: โมเดล Live จะได้รับผลลัพธ์แบ็กเอนด์โดยตรง จึงตรวจสอบเวอร์ชันควบคุมคำตอบถัดไปได้ไม่เต็มที่ การมอบหมายแบบฝั่งไคลเอนต์ทำให้โค้ดของคุณทิ้งผลลัพธ์เก่าได้ก่อนส่งถึงโมเดล ดังนั้นเลขเวอร์ชันงานจึงปกป้องการกระทำของแอป ไม่ใช่ทุกคำที่ผู้ช่วยอาจพูด
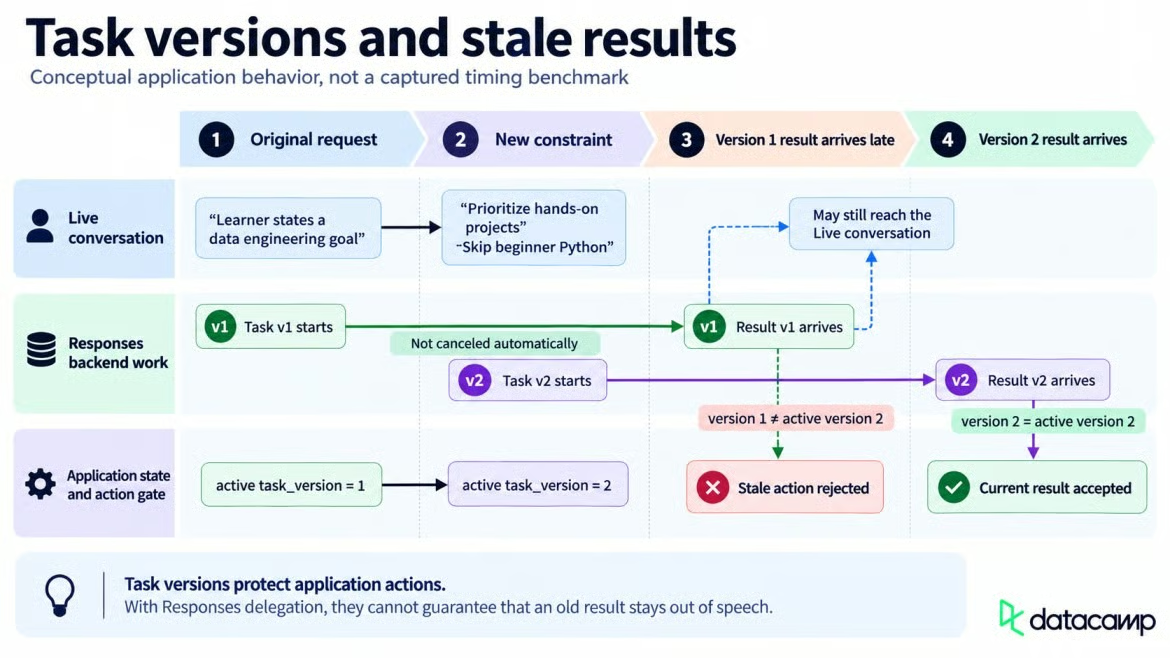
เวอร์ชันของงานช่วยให้ข้อจำกัดใหม่ยังมีผลอยู่ ภาพโดยผู้เขียน
หลังจากผลลัพธ์แบ็กเอนด์ชุดแรกเสร็จ ได้ส่งคำขอต่อเนื่องให้เน้นโปรเจกต์ลงมือทำและไม่เอา Python ระดับเริ่มต้น แผน 7 รายการที่แก้ไขเริ่มจาก Introduction to SQL แล้วผสมแทร็กหนึ่งรายการ คอร์สสองรายการ และโปรเจกต์สี่รายการ รวมถึง Exploring London's Travel Network และ Building a Retail Data Pipeline ตัวอย่างนี้แสดงการแก้ไขข้ามเทิร์นที่เสร็จแล้ว ไม่ได้หมายความว่าสามารถหยุดคำตอบที่กำลังพูดอยู่
ระหว่างที่แบ็กเอนด์ทำงาน มีเหตุการณ์ append สามแบบที่อัปเดตโมเดล Live ได้ คือ session.thinking.append เพิ่มบริบทที่ไม่ควรถูกพูด session.commentary.append เพิ่มข้อความให้โมเดลสื่อสารด้วยคำพูดของตนเอง และ session.instructions.append เปลี่ยนคำสั่งของโมเดล
แต่ละเหตุการณ์พกสตริงธรรมดาสูงสุด 500 โทเคน เหตุการณ์เหล่านี้อัปเดตบริบทหรือพฤติกรรมของโมเดล Live ไม่ได้แก้ไขหรือยกเลิกงาน Responses ของแบ็กเอนด์ที่รันอยู่ คำสั่งสามารถเปลี่ยนท่าทีของ Live ปัจจุบัน ขณะที่ commentary ให้ข้อมูลที่โมเดลควรสื่อออกเสียง
แดชบอร์ดบันทึกความคืบหน้าของแบ็กเอนด์แต่ไม่ส่งเหตุการณ์ append เหล่านี้ เมื่อใช้การมอบหมายแบบ Responses การอัปเดตจากแอปของคุณยังส่งผ่าน oai-events ได้ แต่จะใช้ delegation_id: null ค่า delegation ที่ไม่เป็น null ใช้กับงานที่มอบหมายฝั่งไคลเอนต์
เก็บ task_id และ task_version ไว้ในสถานะแอปพลิเคชัน แทนการใช้ delegation_id กับสองค่านี้
ในแอปนี้ คำตอบของโมเดลเพียงอย่างเดียวจะไม่บันทึกอะไร แบ็กเอนด์ใช้ save_learning_plan เพื่อเสนอการดำเนินการที่รอดำเนินการ ขณะที่ /api/save-plan เป็นเจ้าของการเขียนจริง
การเรียกฟังก์ชันของแบ็กเอนด์จะมาภายใน response.event ตัวจัดการรอไอเท็มซ้อนที่เป็น response.output_item.done แล้วอ่านค่า call_id, name, และ arguments ของมัน
การรอให้ไอเท็มเสร็จสมบูรณ์สำคัญ เพราะเหตุการณ์ก่อนหน้านั้นอาจมีเพียงบางส่วนของการเรียก แอปจะแปลงอาร์กิวเมนต์แต่ยังไม่รันฟังก์ชัน
SAVE_LEARNING_PLAN_TOOL = {
    "type": "function",
    "name": "save_learning_plan",
    "description": "Propose the current learning plan for confirmation when the learner asks to save.",
    "parameters": {
        "type": "object",
        "properties": {
            "goal": {"type": "string"},
            "weekly_hours": {"type": "number"},
            "items": {
                "type": "array",
                "items": {
                    "type": "object",
                    "properties": {
                        "title": {"type": "string"},
                        "url": {"type": "string"},
                        "reason": {"type": "string"},
                        "type": {
                            "type": "string",
                            "enum": ["course", "project", "track", "article"],
                        },
                    },
                    "required": ["title", "url", "reason", "type"],
                    "additionalProperties": False,
                },
            },
        },
        "required": ["goal", "weekly_hours", "items"],
        "additionalProperties": False,
    },
    "strict": True,
}
สคีมาทำให้แอปมีชุดฟิลด์ตายตัวเพื่อแสดงก่อนขอให้ผู้เรียนยืนยัน ฟิลด์ type เก็บชนิดคอร์ส โปรเจกต์ แทร็ก และบทความให้ชัดเจนในข้อมูลที่บันทึก
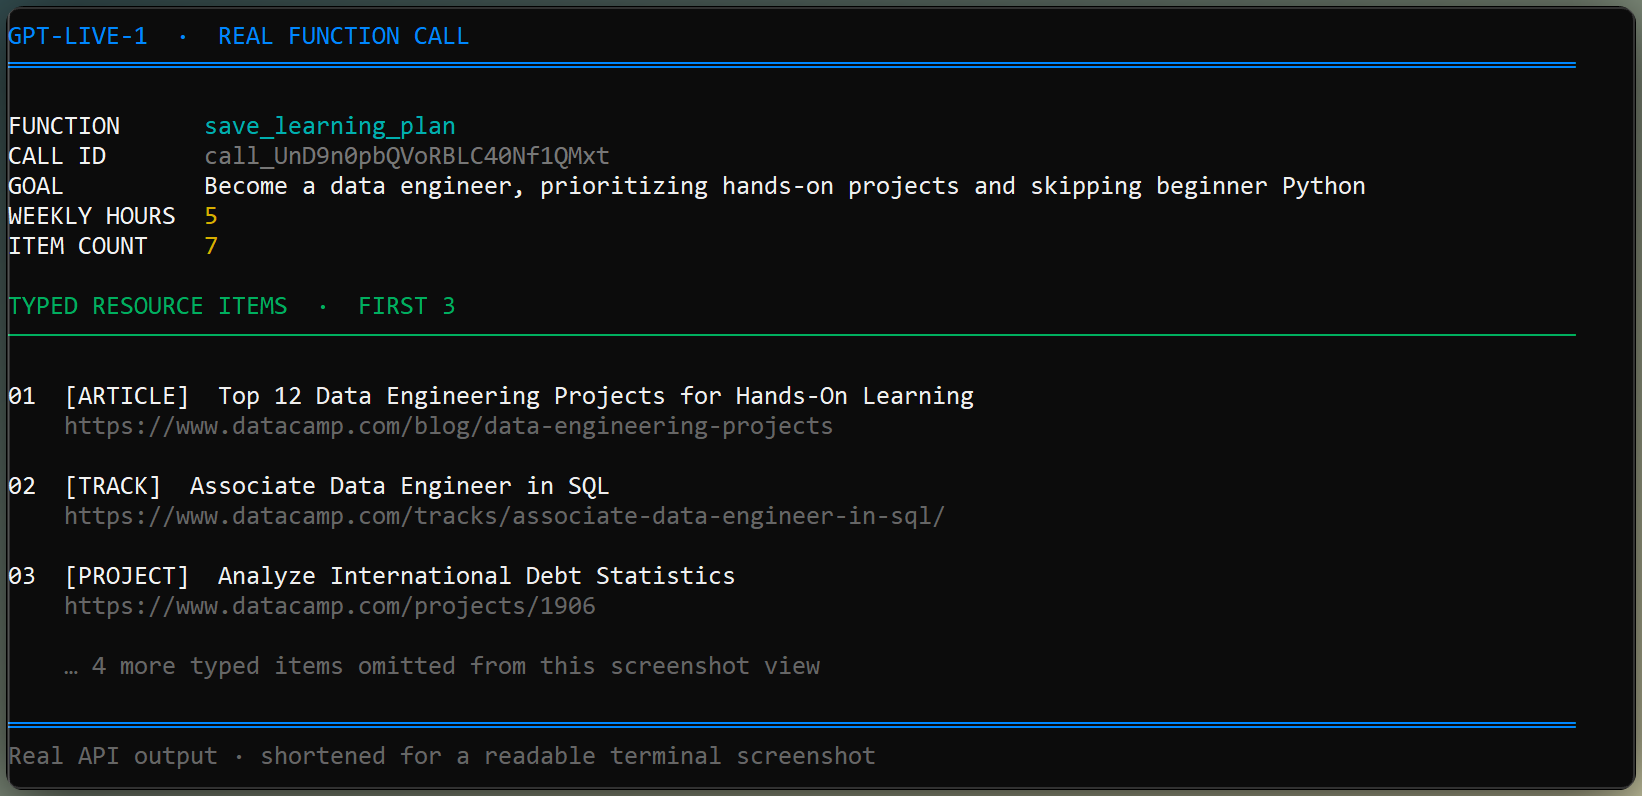
เทอร์มินัลแสดงอาร์กิวเมนต์ของฟังก์ชันบันทึกที่มีชนิดข้อมูล ภาพโดยผู้เขียน
เมื่อผู้เรียนขอบันทึก แบ็กเอนด์จะเรียก save_learning_plan พร้อมแผนเต็ม วิดเจ็ตจะเก็บอาร์กิวเมนต์เหล่านั้นและแสดงกล่องยืนยัน แต่การเรียกนั้นยังเป็นเพียงข้อเสนอ
หากปล่อยให้การเรียกฟังก์ชันค้างไว้ จะบล็อกคำตอบที่มอบหมายและเทิร์นแบ็กเอนด์ถัดไป วิดเจ็ตจึงตอบกลับทันทีด้วยผลลัพธ์ “รอการยืนยันจากผู้ใช้” จากนั้นส่ง response.create เพื่อให้การสนทนาดำเนินต่อ
events.send(JSON.stringify({
  type: "response.item.create",
  item: {
    type: "function_call_output",
    call_id: callId,
    output: JSON.stringify({
      status: "awaiting_user_confirmation",
      saved: false,
    }),
  },
}));
events.send(JSON.stringify({ type: "response.create" }));
ยังไม่มีไฟล์ใดถูกเขียน ณ จุดนี้ ผู้ช่วยสามารถชี้ผู้เรียนไปยังปุ่ม Confirm and save ได้โดยไม่บล็อกงานที่มอบหมายในภายหลัง
เอ็นด์พอยต์ /api/save-plan จะปฏิเสธการเขียนหาก confirmed เป็น true ไม่ถูกส่งมา เนื่องจากทรานสคริปต์อาจผิดหรือไม่ครบถ้วน คำขอที่พูดเท่านั้นจึงไม่เพียงพอในการบันทึกแผน
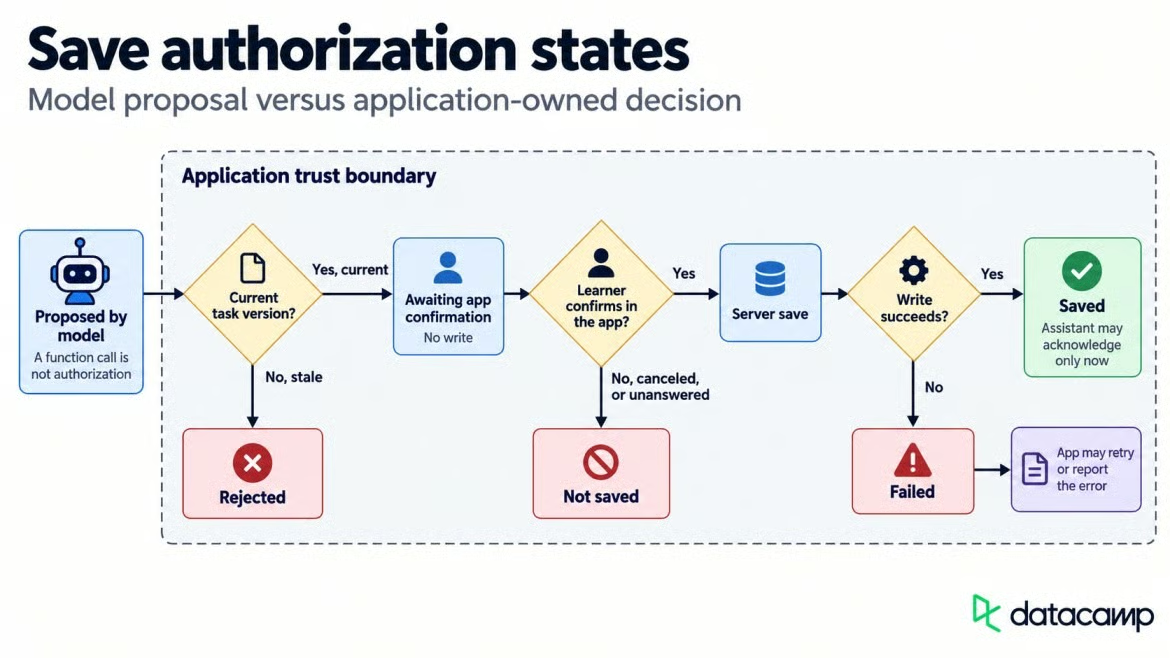
การยืนยันแยกคำขอออกจากการกระทำที่บันทึกจริง ภาพโดยผู้เขียน
เมื่อคลิก Confirm จะส่งไปยัง /api/save-plan พร้อมแผนที่รอดำเนินการและ confirmed: true หลังจากเซิร์ฟเวอร์ส่งคืนรหัสแผน วิดเจ็ตจะส่ง session.commentary.append โดยใช้ delegation_id: null เพราะการเรียกฟังก์ชันเดิมถูกตอบไปแล้ว
const saveResponse = await fetch(${SERVER}/api/save-plan, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    confirmed: true,
    plan: pendingFunctionCall.args,
  }),
});
const saveResult = await saveResponse.json();

events.send(JSON.stringify({
  type: "session.commentary.append",
  delegation_id: null,
  content: The plan was saved as ${saveResult.plan_id}.,
}));
การอัปเดตผ่าน commentary แจ้งโมเดล Live ถึงการเขียนที่เสร็จสมบูรณ์และให้มันกล่าวยืนยันการบันทึกออกเสียงได้ การเรียกฟังก์ชันก่อนหน้านั้นยังปิดอยู่ และเซสชันเสียงยังพร้อมสำหรับคำขอถัดไปของผู้เรียน
ที่เก็บ GitHub ที่ลิงก์ไว้ก่อนหน้านี้มีเซิร์ฟเวอร์ FastAPI อินเทอร์เฟซ Streamlit และวิดเจ็ต WebRTC อยู่ในโฟลเดอร์ app/ หลังโคลน ให้เปิดเทอร์มินัลสองหน้าต่างในโฟลเดอร์นั้น รัน uvicorn server:app --host 127.0.0.1 --port 8000 ในหน้าต่างหนึ่ง และ streamlit run streamlit_app.py ในอีกหน้าต่างหนึ่ง
อินเทอร์เฟซ Streamlit ห่อเซิร์ฟเวอร์และวิดเจ็ตเดียวกันกับที่ใช้ตลอดการสร้าง วางการสนทนาสดไว้ข้างแผนการเรียนและกิจกรรมของแบ็กเอนด์ ขณะที่แดชบอร์ดอัปเดตโดยไม่ต้องรีเซ็ตการโทร
วิดีโอด้านล่างติดตามเป้าหมายที่พูด การค้นหาแบ็กเอนด์ แผนที่แก้ไข และการบันทึกที่ยืนยันแล้ว สายยังคงเปิดหลังการบันทึกเพื่อให้ผู้เรียนดำเนินต่อได้
เรียนรู้กับ DataCamp
Courses
Courses
Courses