course
Podstawy inżynierii promptów
1 godz.
230.3K
Gdy pierwszy raz otworzyłem sesję przeglądarkową GPT-Live-1, spodziewałem się zwykłej pętli głosowej: mówisz, czekasz, po czym słyszysz odpowiedź. Zamiast tego mikrofon pozostał otwarty, gdy asystent odpowiadał. Rozmowa była mniej sztywna, ale aplikacja wciąż musiała zarządzać pracą dziejącą się w tle.
OpenAI najpierw wprowadziło GPT-Live w ChatGPT w lipcu, a następnie udostępniło GPT-Live-1 w API na początku tego tygodnia, tuż przed startem tej budowy. Nasz samouczek GPT-Realtime-2.1 omawia podejście z jednym modelem, a nasz przewodnik GPT Live Transcribe skupia się na napisach na żywo. Tutaj zbudujesz głosowego asystenta do nauki, który przeszukuje prawdziwe zasoby DataCamp i zapisuje plan dopiero po potwierdzeniu.
Nazywam go DataCamp Voice Learning Assistant. To prototyp do samouczka, a nie produkcyjny DataCamp AI Assistant. Projekt śledzi jednego uczącego się od wypowiedzianego celu do zapisanego planu.
GPT-Live-1 rozdziela wymianę głosową od pracy backendu. Cztery wnioski kształtują asystenta do nauki.
Te wnioski dotyczą tego przepływu tworzenia planu nauki. Inna podpowiedź lub sieć mogą zmienić zachowanie, a delegowanie po stronie klienta zmienia granicę kontroli.
GPT-Live-1 to pełnodupleksowy model głosowy OpenAI. Obsługuje wypowiadane tury i przerwania, włącznie z pauzami między nimi, a dłuższą pracę, taką jak wyszukiwanie czy wywołania narzędzi, przekazuje do backendu.
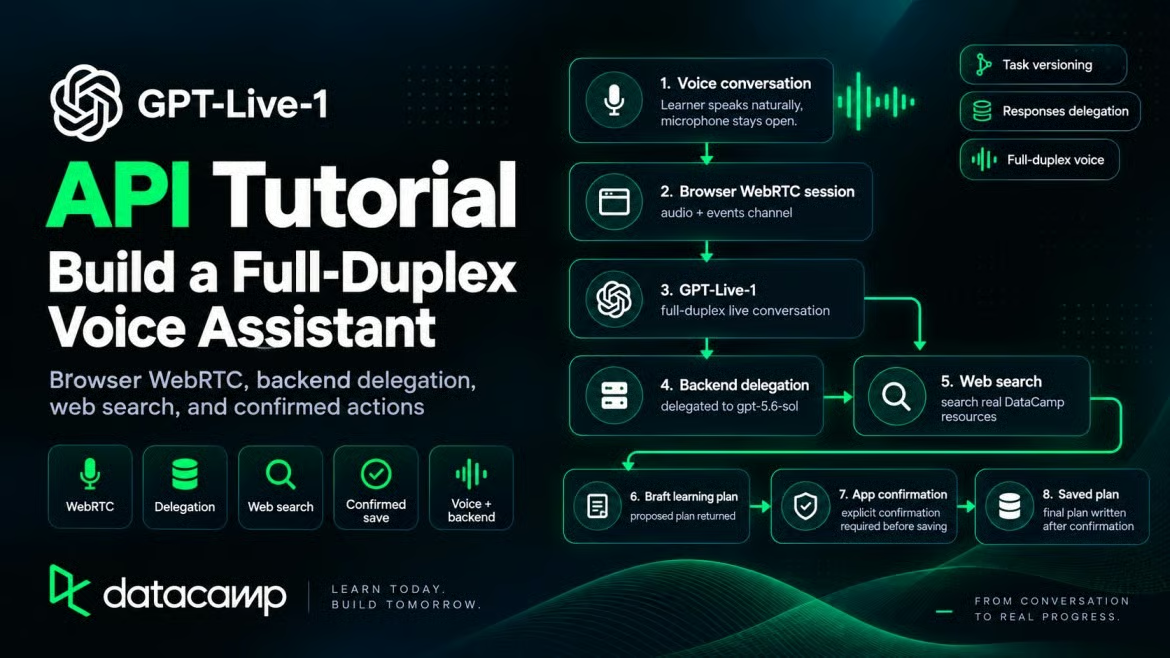
Dla osoby uczącej się pierwszą widoczną różnicą są właśnie te pauzy.
Pełny dupleks zmienia zasady zabierania głosu. Możesz się zatrzymać, żeby pomyśleć, lub mówić jednocześnie z asystentem, a on może przerwać, by usłyszeć sprostowanie. Przewodnik do promptów OpenAI pokazuje sekcje podpowiedzi dla krótkich potwierdzeń i przerwań.
To ma znaczenie w asystencie do nauki. Osoba opisująca cel zawodowy może robić pauzy, zaczynać od nowa lub dodać ograniczenie w połowie wypowiedzi. Model, który poczeka przez „no, chyba, może pięć godzin tygodniowo”, pozwala myśleć na głos.
Delegowanie przenosi zadanie do backendu, ale nie oddaje kontroli aplikacyjnej. Aplikacja wciąż decyduje, kto może działać i czy zapis jest dozwolony. Należy do niej też przechowywany stan zadania.
Jeśli używałeś GPT-Realtime-2.1, możesz się zastanawiać, czy GPT-Live-1 go zastępuje. Nie.
GPT-Realtime-2.1 obsługuje nasłuchiwanie, rozumowanie i wybór narzędzi w jednym modelu przez v1/realtime, rozliczane według tokenów audio i tekstowych. GPT-Live-1 używa v1/live/sessions, rozlicza warstwę głosową za sekundę i wysyła rozumowanie do osobnego backendu.
Realtime-2.1 nie jest starszą ani gorszą opcją. Ma po prostu inną architekturę.
Aplikacja bierze wypowiedziany cel i zamienia go w uporządkowaną listę prawdziwych zasobów DataCamp. Sesja głosowa pozostaje otwarta podczas pracy backendu. Gdy prośba się zmienia, aplikacja aktualizuje wersję zadania, zanim wykona akcję backendu.
Nic nie jest zapisywane, dopóki uczący się nie potwierdzi tego ponownie w aplikacji.
Strona w przeglądarce utrzymuje połączenie WebRTC i mikrofon, a serwer tworzy sesję GPT-Live-1 i przechowuje klucz API. Backend Responses (gpt-5.6-sol) używa wyszukiwania w sieci oraz funkcji save_learning_plan . Bieżąca wersja zadania i potwierdzony plan pozostają w stanie aplikacji.
Wersja zadania decyduje, którą akcję backendu aplikacja zaakceptuje, gdy prośba zmienia się w trakcie wyszukiwania. Skorzystaj z repozytorium GitHub, aby uruchomić kompletną aplikację; kolejne sekcje skupiają się na ścieżce GPT-Live.
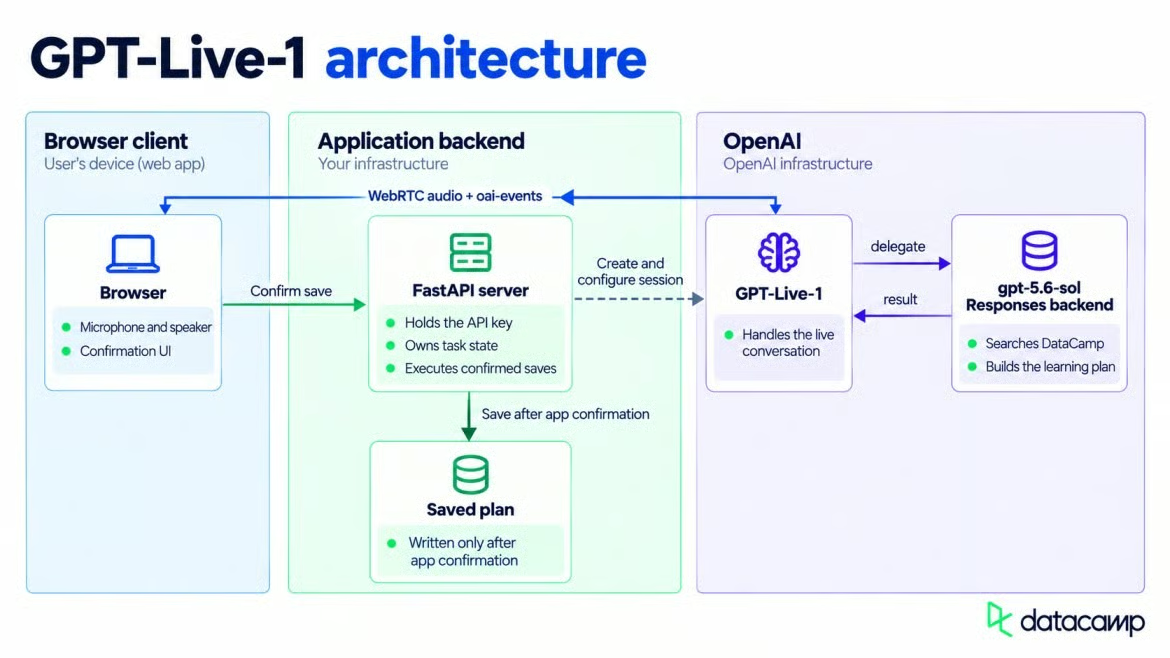
Przeglądarka, GPT-Live-1 i model backendowy łączą się. Obraz autora.
Potrzebujesz projektu OpenAI z dostępem do GPT-Live-1 (darmowy poziom go nie obsługuje), Pythona i przeglądarki działającej przez HTTPS lub localhost, aby mógł pojawić się monit o dostęp do mikrofonu. Użyłem Pythona 3.11 i openai 3.13.0. Live API wymaga co najmniej openai 3.12.0; starsze wersje nie mają atrybutu .live w kliencie.
Limity jednoczesnych sesji zależą od twojego poziomu użycia. Sprawdź limit projektu, zanim otworzysz wiele kart przeglądarki.
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install openai fastapi uvicorn python-dotenv streamlit requests
Na macOS lub Linuksie aktywuj środowisko poleceniem source .venv/bin/activate . Utwórz plik .env w katalogu głównym projektu i dodaj tę wartość.
OPENAI_API_KEY=sk-...python-dotenv ładuje ten plik automatycznie po zaimportowaniu go przez serwer, więc klucz nigdy nie musi pojawiać się w kodzie.
Klient OpenAI() odczytuje tę samą zmienną środowiskową, gdy nie przekażesz klucza.
Przeglądarka nigdy nie zobaczy klucza twojego projektu. Wysyła ofertę WebRTC do twojego serwera, który używa klucza do utworzenia sesji. Po wymianie SDP przeglądarka wysyła audio do OpenAI przez WebRTC, nie otrzymując tego klucza.
Wywołanie GPT-Live w ramach /api/session tworzy sesję na podstawie oferty SDP. Przekazuje instrukcje głosowe, model backendowy, wyszukiwanie w sieci i funkcję zapisu w tym samym żądaniu.
result = client.live.create(
    session={
        "model": "gpt-live-1",
        "instructions": LIVE_INSTRUCTIONS,
        "delegation": {
            "type": "responses",
            "responses": {
                "model": "gpt-5.6-sol",
                "instructions": BACKEND_INSTRUCTIONS,
                "tools": [
                    {
                        "type": "web_search",
                        "filters": {
                            "allowed_domains": ["datacamp.com", "www.datacamp.com"]
                        },
                    },
                    SAVE_LEARNING_PLAN_TOOL,
                ],
                "tool_choice": "auto",
            },
        },
    },
    transport={"type": "webrtc", "sdp": sdp},
)
To wywołanie wysyła żądanie do POST /v1/live/sessions i zwraca identyfikator sesji oraz odpowiedź SDP. Żądanie HTTP uruchamia sesję, więc nie wysyłaj osobnego zdarzenia session.start później.
Przykładowy serwer akceptuje żądania z przeglądarki tylko z localhost:8501 i 127.0.0.1:8501. Ta reguła jest do użytku lokalnego.
Jeśli wdrożysz aplikację, zastąp te pochodzenia i uwierzytelnij zarówno /api/session, jak i /api/save-plan. Ogranicz tempo tworzenia sesji, ponieważ każde żądanie może generować koszty i zużywać współbieżność. Klient może sam wysłać confirmed: true, więc publiczny serwer nie może traktować tego pola jako dowodu, kto złożył żądanie.
Zgodnie z przewodnikiem WebRTC OpenAI przeglądarka prosi o dostęp do mikrofonu i otwiera RTCPeerConnection. Użyj udokumentowanej etykiety kanału danych oai-events i utwórz go przed wygenerowaniem oferty SDP. Ten kanał przenosi zdarzenia JSON w obu kierunkach po starcie sesji.
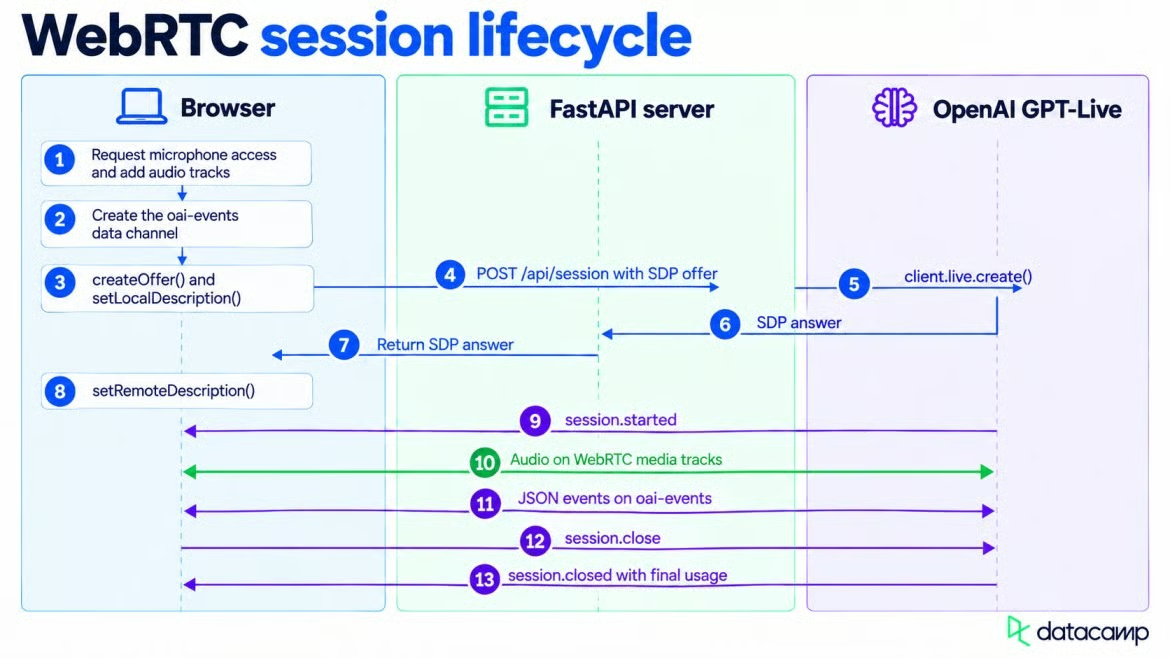
WebRTC startuje, strumieniuje audio, a potem się zamyka. Obraz autora.
Samo ustawienie mediów to zwykłe WebRTC. Zdarzenia GPT-Live używają kanału danych utworzonego w ostatniej linii.
const connection = new RTCPeerConnection();
connection.addEventListener("track", (event) => {
  audio.srcObject = new MediaStream([event.track]);
  audio.play();
});
const microphone = await navigator.mediaDevices.getUserMedia({ audio: true });
for (const track of microphone.getAudioTracks()) {
  connection.addTrack(track, microphone);
}
const events = connection.createDataChannel("oai-events");
Po utworzeniu oferty przeglądarka wywołuje setLocalDescription() i czeka na zakończenie zbierania ICE. Wysyła lokalne SDP do /api/session, po czym stosuje odpowiedź OpenAI przez setRemoteDescription(). Dźwięk z mikrofonu i mowa asystenta podróżują po ścieżkach multimedialnych, więc osobne żądania zamiany mowy na tekst i tekstu na mowę nie są potrzebne.
Audio nie należy do oai-events. Nie wysyłaj session.input_audio.append ani nie czekaj na session.output_audio.delta na kanale danych WebRTC.
Kanał danych rządzi się innym czasowaniem. Poczekaj na session.started zanim wyślesz zdarzenie przez oai-events. Za pierwszym razem wysłałem jedno za wcześnie i połączenie je zignorowało.
Nie dostałem użytecznego błędu, co sprawiło, że drobny błąd w kolejności trudno było wyśledzić.
Jeśli nie potrzebujesz widocznych napisów, możesz pominąć ten podrozdział; połączenie audio jest już kompletne.
session.input_transcript.delta i session.output_transcript.delta zwracają fragmenty tekstu z milisekundowymi offsetami dla napisów na żywo. Dokumentacja OpenAI ostrzega, że fragmenty transkrypcji nie są ukończonymi turami. Dostarczanie może być nierówne, a przedziały transkrypcji użytkownika i asystenta mogą się nakładać.
Dołączaj fragmenty transkrypcji do ekranu w miarę ich przychodzenia, ale nie uruchamiaj na ich podstawie pracy backendu. Model sam decyduje, kiedy delegować.
Instrukcje dla modelu Live powinny być krótkie. Przewodnik OpenAI umieszcza szczegółowe kroki zadania w promptach backendu. Zostawiłem procedurę zadania tam, a prompt Live skupiłem na mowie.
Ten fragment oddziela zachowanie głosowe od zadania planu nauki. Zasady mowy są ponad warunkami wyzwalającymi delegowanie.
You are Sage, a warm, encouraging voice learning coach for DataCamp learners.
Speak naturally at an unhurried pace. Be clear and direct, not overly cheerful.

Backchannel policy: Use moderate backchannels without competing with the response.
Interruption policy: Stop speaking when the learner interrupts, and listen.

Delegation policy:
Backend tools:
- learning_plan_research: search DataCamp resources and assemble a personalized learning plan.
- save_learning_plan: propose the current plan for app confirmation when the learner asks to save.

Delegate to the backend when:
- The learner states or changes a goal, skill level, or weekly time.
- A correction changes the plan already requested.
- The learner asks to save the plan.

Do not delegate for greetings, small clarifications, or a result already given.

Saving: a proposed save only asks the app to confirm. Do not say the plan is saved until the app reports a saved result.
After a save, keep the conversation open and ask what the learner wants next.
Te zasady zostawiają przywitania w warstwie Live, a badania lub prośby o zapis kierują do backendu. Potwierdzenie wciąż należy do aplikacji.
Linie dotyczące backchannelu i przerwań mówią asystentowi, jak reagować wokół pauz. „Umiarkowane backchannele” proszą o okazjonalne potwierdzenia typu „mhm” bez wypełniania każdej ciszy. Wybrałem ten poziom, by dać uczącemu się przestrzeń do myślenia; lekcja z dłuższymi pauzami może potrzebować mniej potwierdzeń.
Zmień tę linię, jeśli twoja aplikacja potrzebuje innego zachowania; dodanie „nigdy nie mów, gdy mówi użytkownik” usuwa też backchannele.
Dwa prompty mają różne zadania. Prompt Live kontroluje mowę i przekazanie dalej, a prompt backendu kontroluje badania i format odpowiedzi. Przewodnik OpenAI odradza umieszczanie szczegółowych kroków wyszukiwania w instrukcjach głosowych.
Rozdział opisany wcześniej pojawia się w polu delegation sesji. Gdy uczący się podaje cel, GPT-Live wysyła zadanie do modelu, który potrafi przeszukać nasz katalog kursów i ułożyć plan.
GPT-Live-1 oferuje delegowanie Responses oraz delegowanie po stronie klienta. Delegowanie Responses pozwala OpenAI zarządzać wywołaniem backendu, a delegowanie klienckie przekazuje je twojemu kodowi. Użyłem delegowania Responses, bo unika kolejnej pętli backendu w tej aplikacji.
Użyłem gpt-5.6-sol. Przewodnik o delegowaniu OpenAI używa gpt-5.6-terra jako przykładu startowego i wymienia gpt-5.6-luna do tańszych zadań. Z Sol backend zwrócił żądaną strukturę planu.
Pozostaw tool_choice ustawione na auto , aby backend mógł wybrać wyszukiwanie w sieci lub funkcję zapisu. Tryb delegowania jest ustalany przy starcie; przełącz na delegowanie klienckie, zamykając bieżącą sesję i tworząc nową.
Zasada w promcie Live jest prosta: przywitania i krótkie pytania zostają w modelu Live, a plan nauki lub jego zmiana idzie do backendu. Nic w API nie egzekwuje tej granicy. Testuj ją na rodzajach próśb, jakie twoja aplikacja będzie otrzymywać, bo model sam dokonuje wyboru.
Po delegowaniu backend ma jedno zadanie: zamienić cel uczącego się w krótką listę zasobów DataCamp z linkami. Dałem mu narzędzie web_search z filters.allowed_domains ustawionym na datacamp.com i www.datacamp.com. Traktuj ten filtr jako instrukcję wyszukiwania, a nie dowód, że każdy link jest poprawny.
Przykładowy cel prosi o ścieżkę data engineering z 5 godzinami tygodniowo, pewną znajomością Pythona i brakiem doświadczenia z SQL. Odpowiedź zaczyna się od How to Learn Data Engineering From Scratch in 2026 oraz ścieżki Associate Data Engineer in SQL.
Pozostałe pozycje mieszają projekt, kurs Pythona o bazach danych, kolejną ścieżkę i końcowy projekt pipeline’u. Każdy wymieniony URL otwiera istniejącą stronę DataCamp.
Prompt backendu prosi o cztery do siedmiu uporządkowanych pozycji. Każda pozycja ma tytuł, URL, krótki powód i typ course, project, track lub article. Dobór mieszaniny zależy od preferowanego formatu uczącego się i tygodniowego czasu.
Nie prosiłem modelu o zgadywanie czasu trwania kursu, gdy strona go nie podaje. Dokładna liczba w takim przypadku przypisywałaby więcej, niż wynika ze źródła.
GPT-Live może utrzymać sesję głosową aktywną podczas pracy backendu Responses. Jeśli uczący się doda ograniczenie „hands-on” przed powrotem pierwszego planu, pierwotna praca backendu nie jest automatycznie anulowana.
Wypowiedziane sprostowanie nie anuluje automatycznie ani nie przerabia pracy, którą backend już rozpoczął. Przerwanie mowy asystenta i zmiana zadania to osobne działania. Aplikacja decyduje, co zrobić ze starszym wynikiem.
Serwer śledzi licznik task_version i inkrementuje go za każdym razem, gdy zaczyna się nowe delegowanie. Gdy nadchodzi wynik, aplikacja sprawdza jego wersję przed podjęciem działania; jej własny handler loguje stary wynik i go nie wykonuje.
Delegowanie Responses ma tu ograniczenie: model Live otrzymuje wynik backendu bezpośrednio, więc sprawdzenie wersji nie może w pełni kontrolować jego następnej wypowiedzianej odpowiedzi. Delegowanie klienckie pozwala twojemu kodowi odrzucić stary wynik, zanim dotrze do modelu. Wersja zadania chroni więc akcje aplikacji, a nie każde słowo, które asystent może wypowiedzieć.
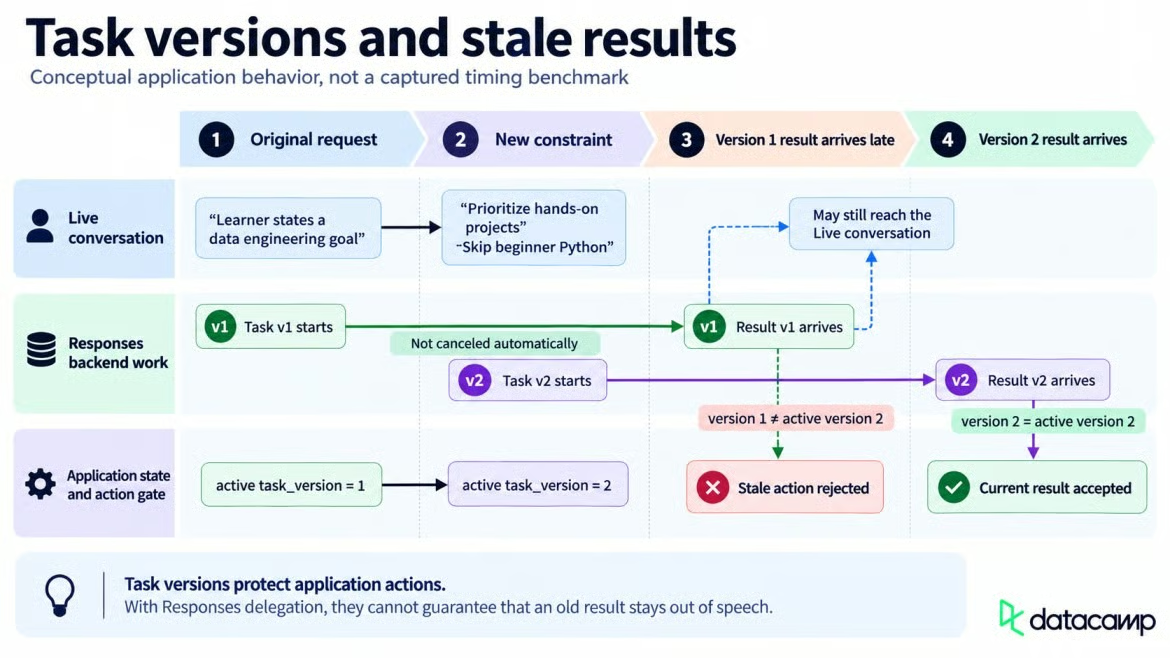
Wersje zadań utrzymują nowsze ograniczenia w mocy. Obraz autora.
Po zakończeniu pierwszej odpowiedzi backendu wysłałem prośbę o projekty praktyczne i bez Pythona dla początkujących. Zmieniony plan siedmiu pozycji zaczął się od Introduction to SQL, po czym mieszał jedną ścieżkę, dwa kursy i cztery projekty, w tym Exploring London's Travel Network i Building a Retail Data Pipeline. To pokazuje rewizję między zakończonymi turami; nie mówi nic o zatrzymaniu aktywnej odpowiedzi.
Podczas pracy backendu trzy zdarzenia append mogą aktualizować model Live. session.thinking.append dodaje kontekst, którego nie należy wypowiadać, session.commentary.append dodaje tekst do wypowiedzenia własnymi słowami modelu, a session.instructions.append zmienia jego instrukcje.
Każdy append niesie zwykły łańcuch do 500 tokenów. Te zdarzenia aktualizują kontekst lub zachowanie modelu Live; nie modyfikują ani nie anulują zadania Responses, które już działa. Instrukcja może przekierować bieżące zachowanie Live, a komentarz dostarcza informacji, które model powinien przekazać na głos.
Panel rejestruje postęp backendu, ale nie wysyła tych zdarzeń append. Przy delegowaniu Responses aktualizacje z twojej aplikacji wciąż można wysłać przez oai-events, ale używają delegation_id: null. Nienullowe delegation_id są używane dla zadań delegowanych po stronie klienta.
Przechowuj task_id i task_version w stanie aplikacji, a nie używaj delegation_id do żadnego z nich.
W tej aplikacji odpowiedź modelu sama z siebie niczego nie zapisuje. Backend używa save_learning_plan do zaproponowania oczekującej akcji, a /api/save-plan odpowiada za faktyczny zapis.
Wywołania funkcji backendu przychodzą wewnątrz response.event. Handler czeka na zagnieżdżony element response.output_item.done, a następnie odczytuje jego call_id, name i arguments.
Czekanie na ukończony element ma znaczenie, ponieważ wcześniejsze zdarzenia mogą zawierać tylko część wywołania. Aplikacja parsuje argumenty, ale jeszcze nie uruchamia funkcji.
SAVE_LEARNING_PLAN_TOOL = {
    "type": "function",
    "name": "save_learning_plan",
    "description": "Propose the current learning plan for confirmation when the learner asks to save.",
    "parameters": {
        "type": "object",
        "properties": {
            "goal": {"type": "string"},
            "weekly_hours": {"type": "number"},
            "items": {
                "type": "array",
                "items": {
                    "type": "object",
                    "properties": {
                        "title": {"type": "string"},
                        "url": {"type": "string"},
                        "reason": {"type": "string"},
                        "type": {
                            "type": "string",
                            "enum": ["course", "project", "track", "article"],
                        },
                    },
                    "required": ["title", "url", "reason", "type"],
                    "additionalProperties": False,
                },
            },
        },
        "required": ["goal", "weekly_hours", "items"],
        "additionalProperties": False,
    },
    "strict": True,
}
Schemat daje aplikacji stały zestaw pól do wyświetlenia, zanim poprosi uczącego się o potwierdzenie. Pole type utrzymuje jawność kursów, projektów, ścieżek i artykułów w zapisanych danych.
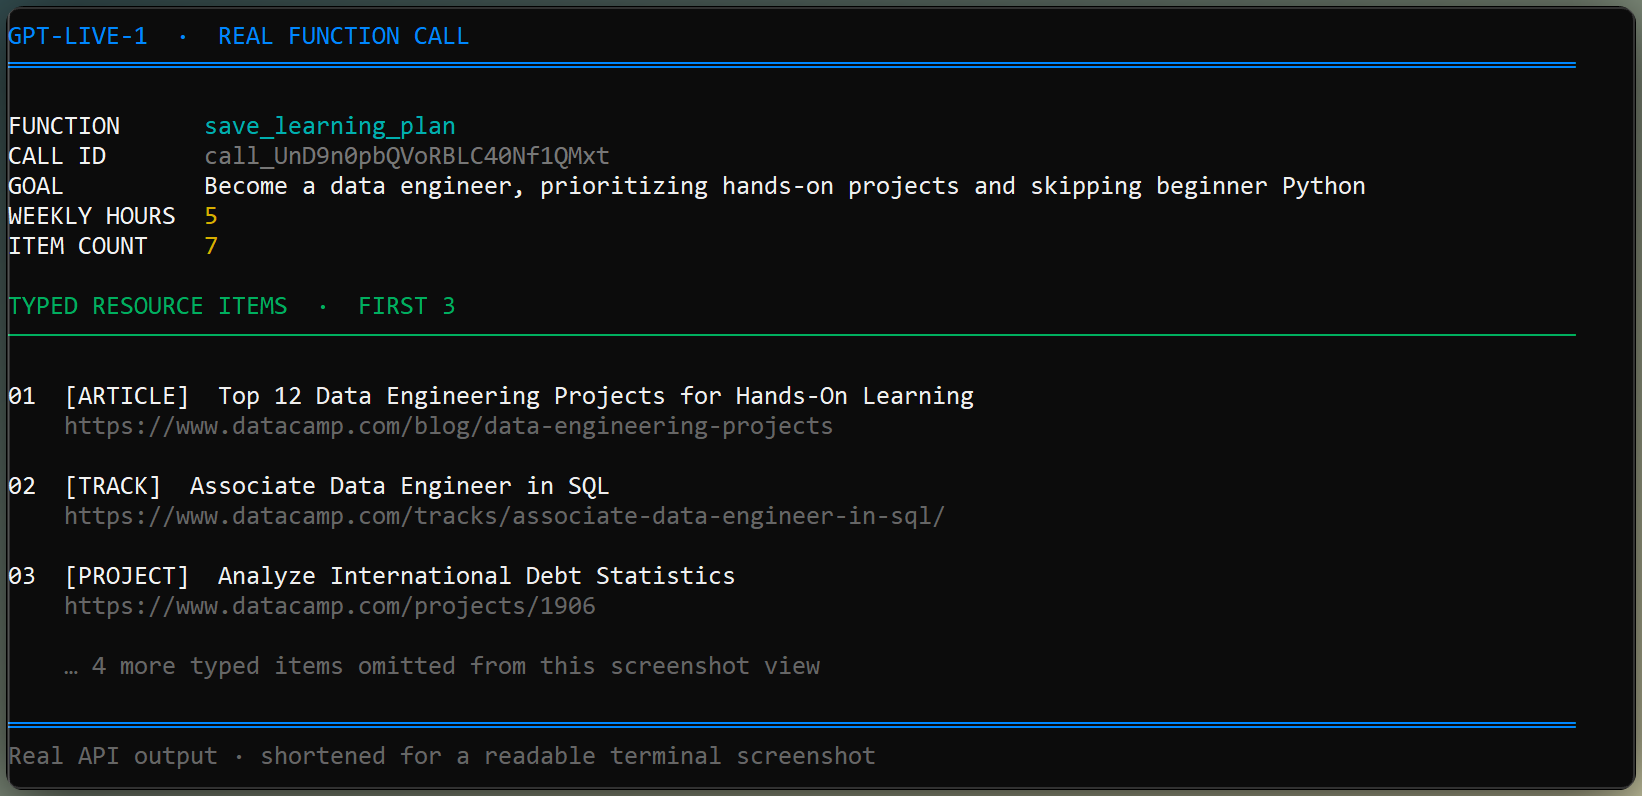
Terminal pokazuje typowane argumenty funkcji zapisu. Obraz autora.
Gdy uczący się prosi o zapis, backend wywołuje save_learning_plan z pełnym planem. Widget przechowuje te argumenty i pokazuje okno potwierdzenia, ale to wywołanie jest wciąż tylko propozycją.
Pozostawienie tego wywołania funkcji bez odpowiedzi zablokowałoby delegowaną odpowiedź i późniejsze tury backendu. Widget natychmiast odpowiada wynikiem „oczekiwanie na potwierdzenie”, a potem wysyła response.create, aby rozmowa mogła toczyć się dalej.
events.send(JSON.stringify({
  type: "response.item.create",
  item: {
    type: "function_call_output",
    call_id: callId,
    output: JSON.stringify({
      status: "awaiting_user_confirmation",
      saved: false,
    }),
  },
}));
events.send(JSON.stringify({ type: "response.create" }));
Na tym etapie żaden plik nie jest zapisywany. Asystent może skierować uczącego się do przycisku Potwierdź i zapisz bez blokowania późniejszej delegowanej pracy.
Punkt końcowy /api/save-plan odmawia zapisu, chyba że confirmed ma wartość true. Ponieważ transkrypcja może być błędna lub niepełna, sama prośba mówiona nie zapisuje planu.
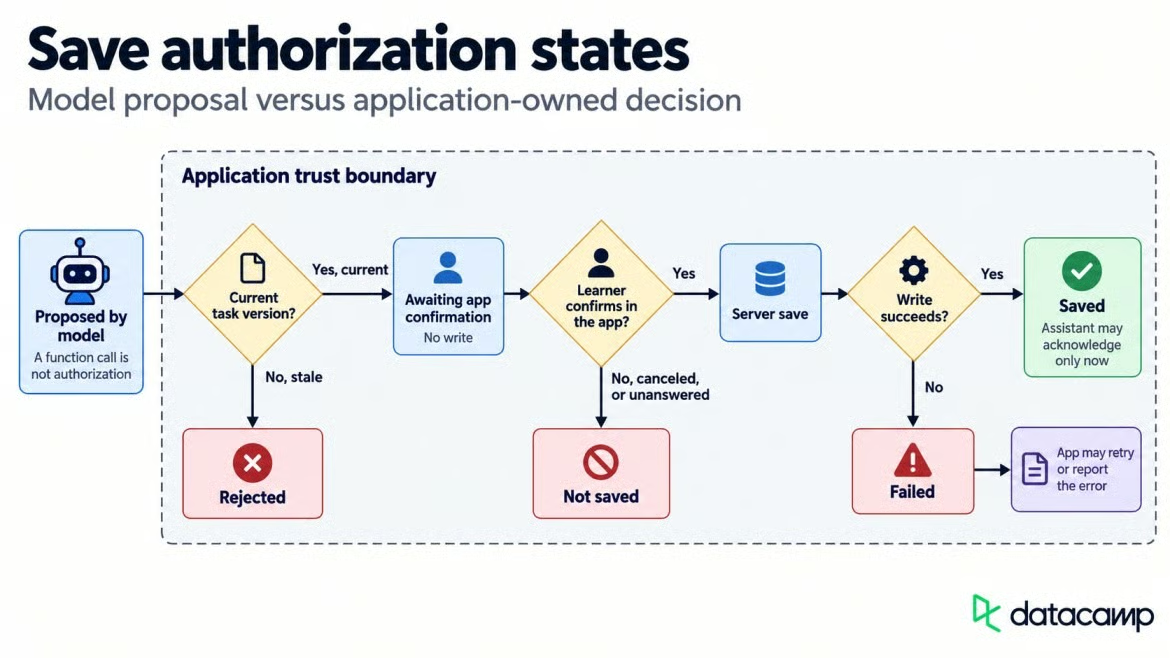
Potwierdzenie oddziela prośby od zapisanych działań. Obraz autora.
Kliknięcie Potwierdź wysyła do /api/save-plan oczekujący plan oraz confirmed: true. Po tym jak serwer zwróci identyfikator planu, widget wysyła session.commentary.append z delegation_id: null , ponieważ pierwotne wywołanie funkcji zostało już obsłużone.
const saveResponse = await fetch(${SERVER}/api/save-plan, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    confirmed: true,
    plan: pendingFunctionCall.args,
  }),
});
const saveResult = await saveResponse.json();

events.send(JSON.stringify({
  type: "session.commentary.append",
  delegation_id: null,
  content: The plan was saved as ${saveResult.plan_id}.,
}));
Aktualizacja commentary informuje model Live o ukończonym zapisie i pozwala mu potwierdzić zapis na głos. Wcześniejsze wywołanie funkcji pozostaje zamknięte, a sesja głosowa jest nadal dostępna dla kolejnej prośby uczącego się.
Repozytorium GitHub podlinkowane wcześniej zawiera serwer FastAPI, interfejs Streamlit i widget WebRTC w katalogu app/. Po sklonowaniu otwórz dwa terminale w tym folderze. Uruchom uvicorn server:app --host 127.0.0.1 --port 8000 w jednym i streamlit run streamlit_app.py w drugim.
Interfejs Streamlit opakowuje ten sam serwer i widget używane w całej budowie. Umieszcza rozmowę na żywo obok planu nauki i aktywności backendu, a panel aktualizuje się bez resetowania połączenia.
Poniższe wideo pokazuje wypowiedziany cel, wyszukiwanie backendu, zmieniony plan i potwierdzony zapis. Po zapisaniu połączenie pozostaje otwarte, aby uczący się mógł kontynuować.
Ucz się z DataCamp
course
course
course