Curso
Noções Básicas de Engenharia de Prompts.
1 h
230.3K
Na primeira vez que abri uma sessão de navegador com GPT-Live-1, eu esperava o ciclo de voz de sempre: falar, esperar e ouvir a resposta. Em vez disso, o microfone ficou aberto enquanto o assistente respondia. A conversa ficou menos engessada, mas o app ainda precisava gerenciar o trabalho acontecendo por trás.
A OpenAI apresentou primeiro o GPT-Live no ChatGPT em julho e, nesta semana, trouxe o GPT-Live-1 para a API, bem quando comecei este projeto. Nosso tutorial do GPT-Realtime-2.1 cobre a abordagem com um único modelo, enquanto nosso guia GPT Live Transcribe foca em legendas ao vivo. Aqui, você vai criar um assistente de aprendizado por voz que pesquisa recursos reais do DataCamp e só salva um plano após confirmação.
Eu o chamo de DataCamp Voice Learning Assistant. É um protótipo de tutorial, não o DataCamp AI Assistant em produção. O projeto acompanha um aluno do objetivo falado até um plano salvo.
O GPT-Live-1 separa a conversa falada do trabalho no backend. Quatro descobertas moldam o assistente de aprendizado.
Esses pontos valem para este fluxo de plano de aprendizado. Um prompt ou rede diferentes podem mudar o comportamento, e a delegação no cliente altera a fronteira de controle.
O GPT-Live-1 é o modelo de voz full-duplex da OpenAI. Ele cuida de turnos falados e interrupções, incluindo as pausas entre eles, e envia trabalhos mais longos, como buscas ou chamadas de ferramentas, para um backend.
Para o aluno, a primeira diferença visível está nessas pausas.
Full-duplex muda a tomada de turnos. Você pode pausar para pensar ou falar por cima do assistente, e ele pode parar para ouvir a correção. O guia de prompts da OpenAI mostra seções para reconhecimentos curtos e interrupções.
Isso importa em um assistente de aprendizado. Alguém descrevendo um objetivo de carreira pode pausar, recomeçar ou acrescentar um limite no meio. Um modelo que espera por "bem, acho que talvez cinco horas por semana" permite que o aluno pense em voz alta.
Delegar move uma tarefa para o backend, mas não entrega o controle do aplicativo. O app ainda decide quem pode agir e se um salvamento é permitido. Ele também é dono do estado de tarefa armazenado.
Se você já usou o GPT-Realtime-2.1, pode se perguntar se o GPT-Live-1 o substitui. Não substitui.
O GPT-Realtime-2.1 faz escuta, raciocínio e seleção de ferramentas em um único modelo via v1/realtime, com cobrança por tokens de áudio e texto. O GPT-Live-1 usa v1/live/sessions, cobra a camada de voz por segundo e envia o raciocínio para um backend separado.
Realtime-2.1 não é uma opção mais antiga ou inferior. É um design diferente.
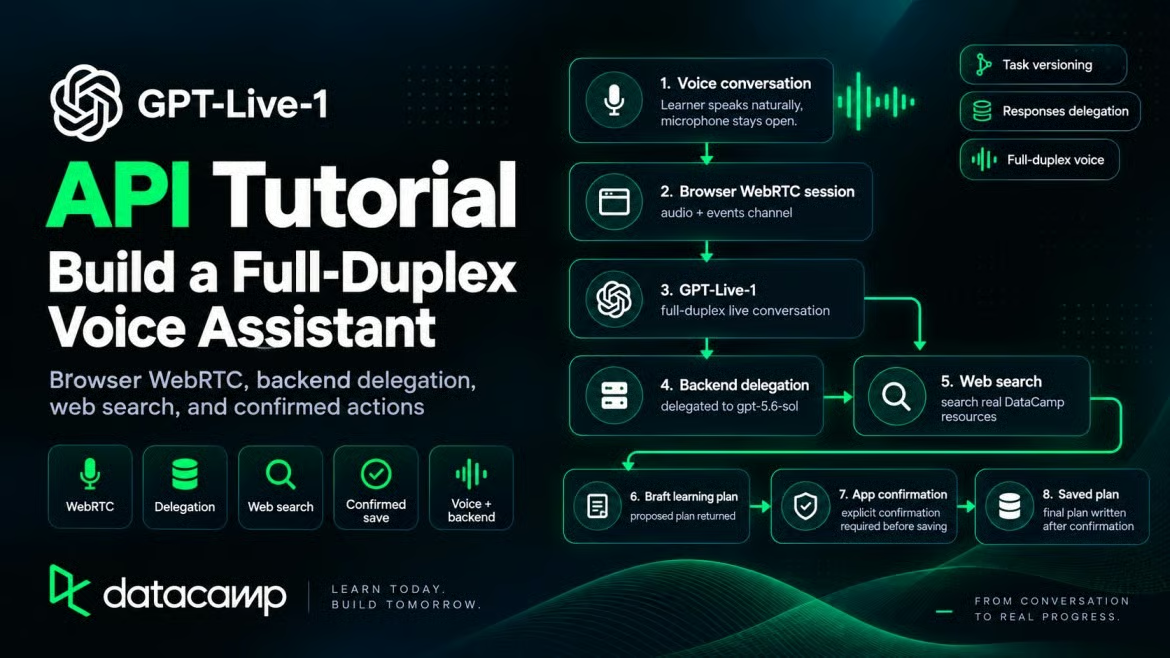
O app recebe um objetivo falado e transforma em uma lista ordenada de recursos reais do DataCamp. A sessão de voz fica aberta durante o trabalho de backend. Quando o pedido muda, o app atualiza a versão da tarefa antes de executar uma ação no backend.
Nada é gravado até o aluno confirmar novamente no app.
A página no navegador mantém a conexão WebRTC e o microfone, enquanto o servidor cria a sessão do GPT-Live-1 e guarda a chave da API. Um backend de Responses (gpt-5.6-sol) usa busca na web e a função save_learning_plan . A versão atual da tarefa e o plano confirmado ficam no estado do app.
A versão da tarefa decide qual ação de backend o app aceita quando um pedido muda durante uma busca. Use o repositório no GitHub para o app completo executável; as próximas seções focam no caminho do GPT-Live.
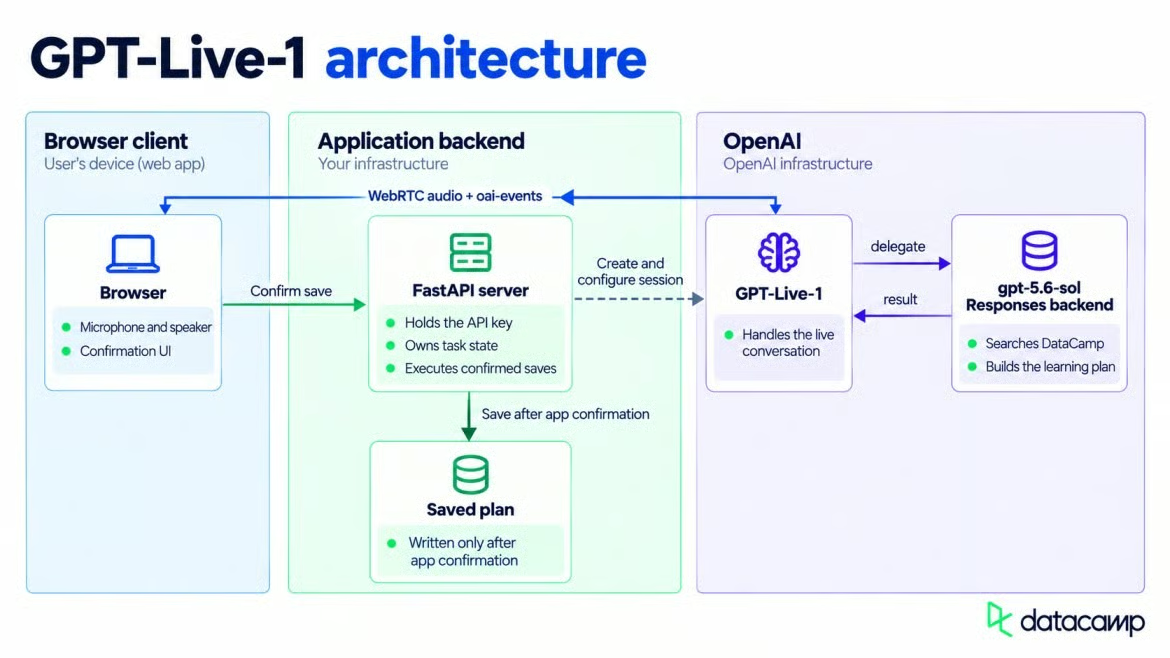
Navegador, GPT-Live-1 e modelo de backend conectados. Imagem do autor.
Você precisa de um projeto OpenAI com acesso ao GPT-Live-1 (o plano gratuito não oferece suporte), Python e um navegador rodando em HTTPS ou localhost para o prompt do microfone aparecer. Usei Python 3.11 e openai 3.13.0. A Live API requer pelo menos openai 3.12.0; versões anteriores não têm o atributo .live no client.
Os limites de sessões concorrentes dependem do seu nível de uso. Verifique o limite do projeto antes de abrir muitas abas do navegador.
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install openai fastapi uvicorn python-dotenv streamlit requests
No macOS ou Linux, ative o ambiente com source .venv/bin/activate . Crie um arquivo .env na raiz do projeto e adicione este valor.
OPENAI_API_KEY=sk-...python-dotenv carrega esse arquivo automaticamente assim que o servidor o importa, então a chave nunca precisa aparecer no código.
O client OpenAI() lê a mesma variável de ambiente quando você não passa a chave.
O navegador nunca vê a sua chave do projeto. Ele envia uma oferta WebRTC para o seu servidor, que usa a chave para criar a sessão. Após a troca de SDP, o navegador envia áudio para a OpenAI via WebRTC sem receber essa chave.
A chamada do GPT-Live dentro de /api/session cria a sessão a partir da oferta SDP. Ela envia as instruções de voz, o modelo de backend, a busca na web e a função de salvamento no mesmo request.
result = client.live.create(
    session={
        "model": "gpt-live-1",
        "instructions": LIVE_INSTRUCTIONS,
        "delegation": {
            "type": "responses",
            "responses": {
                "model": "gpt-5.6-sol",
                "instructions": BACKEND_INSTRUCTIONS,
                "tools": [
                    {
                        "type": "web_search",
                        "filters": {
                            "allowed_domains": ["datacamp.com", "www.datacamp.com"]
                        },
                    },
                    SAVE_LEARNING_PLAN_TOOL,
                ],
                "tool_choice": "auto",
            },
        },
    },
    transport={"type": "webrtc", "sdp": sdp},
)
Essa chamada envia um request para POST /v1/live/sessions e retorna um ID de sessão com uma resposta SDP. O request HTTP inicia a sessão, então não envie um evento session.start separado depois.
O servidor de exemplo aceita requests do navegador apenas de localhost:8501 e 127.0.0.1:8501. Essa regra é para uso local.
Se você for publicar o app, substitua essas origens e faça autenticação tanto em /api/session quanto em /api/save-plan. Faça rate limit na criação de sessões, pois cada pedido pode gerar custo e consumir concorrência. Um cliente pode enviar confirmed: true por conta própria, então um servidor público não pode tratar esse campo como prova de quem fez o pedido.
Seguindo o guia de WebRTC da OpenAI, o navegador pede acesso ao microfone e abre um RTCPeerConnection. Use o rótulo documentado oai-events no data channel e crie-o antes de gerar a oferta SDP. Esse canal carrega eventos JSON nos dois sentidos quando a sessão começa.
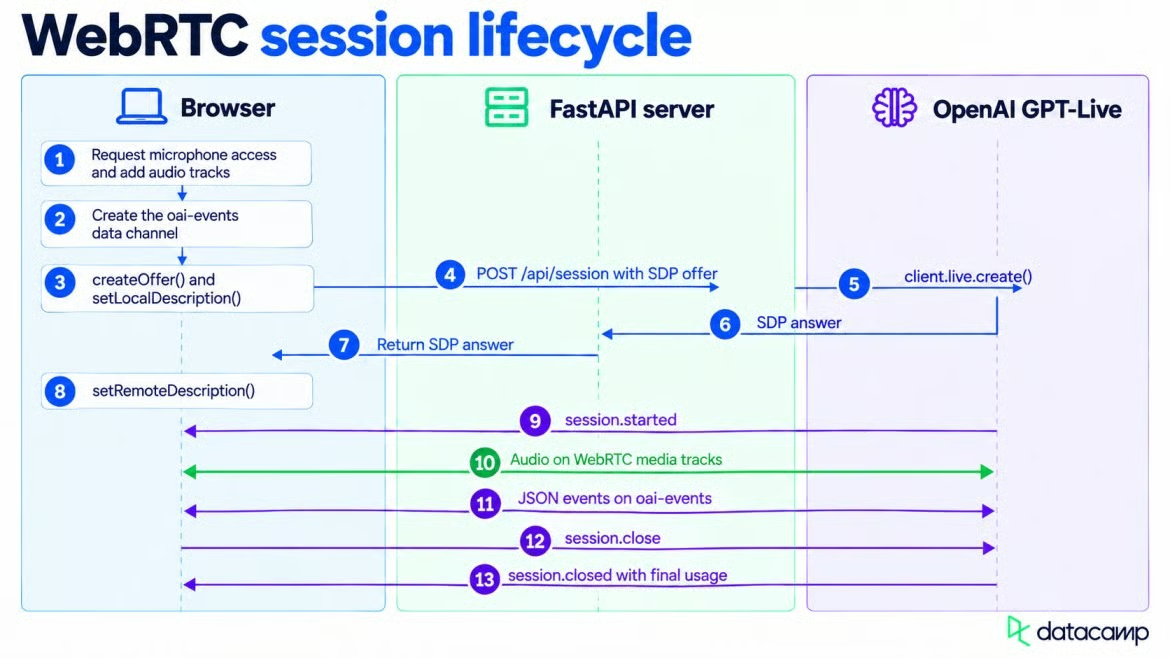
O WebRTC inicia, transmite áudio e depois fecha. Imagem do autor.
A configuração de mídia é o próprio WebRTC tradicional. Os eventos do GPT-Live usam o data channel criado na última linha.
const connection = new RTCPeerConnection();
connection.addEventListener("track", (event) => {
  audio.srcObject = new MediaStream([event.track]);
  audio.play();
});
const microphone = await navigator.mediaDevices.getUserMedia({ audio: true });
for (const track of microphone.getAudioTracks()) {
  connection.addTrack(track, microphone);
}
const events = connection.createDataChannel("oai-events");
Depois de criar a oferta, o navegador chama setLocalDescription() e espera o término da coleta ICE. Ele envia o SDP local para /api/session e depois aplica a resposta da OpenAI com setRemoteDescription(). O áudio do microfone e a fala do assistente viajam nas trilhas de mídia, então não são necessários pedidos separados de speech-to-text e text-to-speech.
Áudio não deve ir em oai-events. Não envie session.input_audio.append nem espere por session.output_audio.delta em um data channel WebRTC.
O data channel segue uma regra de temporização diferente. Aguarde session.started antes de enviar um evento por oai-events. Na minha primeira tentativa, enviei um cedo demais e a conexão o ignorou.
Não recebi um erro útil, o que tornou um pequeno erro de ordem chato de rastrear.
Se você não precisa de legendas visíveis, pode pular esta subseção; a conexão de áudio já está completa.
session.input_transcript.delta e session.output_transcript.delta retornam fragmentos de texto com offsets em milissegundos para legendas ao vivo. A documentação da OpenAI alerta que fragmentos de transcrição não são turnos concluídos. A entrega pode ser irregular, e intervalos de transcrição de usuário e assistente podem se sobrepor.
Acrescente fragmentos de transcrição na tela conforme chegam, mas não inicie trabalho de backend a partir deles. O modelo decide quando delegar.
As instruções do modelo Live devem ser curtas. O guia da OpenAI coloca etapas detalhadas da tarefa no prompt do backend. Mantive o procedimento lá e deixei o prompt Live focado na fala.
Este trecho separa o comportamento de voz da tarefa de plano de aprendizado. As regras de fala ficam acima das condições que disparam a delegação.
You are Sage, a warm, encouraging voice learning coach for DataCamp learners.
Speak naturally at an unhurried pace. Be clear and direct, not overly cheerful.

Backchannel policy: Use moderate backchannels without competing with the response.
Interruption policy: Stop speaking when the learner interrupts, and listen.

Delegation policy:
Backend tools:
- learning_plan_research: search DataCamp resources and assemble a personalized learning plan.
- save_learning_plan: propose the current plan for app confirmation when the learner asks to save.

Delegate to the backend when:
- The learner states or changes a goal, skill level, or weekly time.
- A correction changes the plan already requested.
- The learner asks to save the plan.

Do not delegate for greetings, small clarifications, or a result already given.

Saving: a proposed save only asks the app to confirm. Do not say the plan is saved until the app reports a saved result.
After a save, keep the conversation open and ask what the learner wants next.
Essas regras deixam saudações na camada Live e enviam pedidos de pesquisa ou salvamento para o backend. A confirmação continua sendo do app.
As linhas de backchannel e de interrupção dizem ao assistente como responder ao redor das pausas. "Backchannels moderados" pedem reconhecimentos ocasionais, como "uh-huh", sem preencher cada silêncio. Escolhi esse nível para dar espaço ao aluno; uma aula com pausas mais longas pode pedir menos reconhecimentos.
Ajuste essa linha se seu app precisar de outro comportamento; adicionar "nunca fale enquanto o usuário estiver falando" também remove os backchannels.
Os dois prompts têm trabalhos diferentes. O prompt Live controla a fala e a entrega, enquanto o prompt do backend controla a pesquisa e o formato da resposta. O guia da OpenAI recomenda não colocar etapas detalhadas de busca nas instruções de voz.
A divisão descrita antes aparece no campo delegation da sessão. Quando o aluno informa um objetivo, o GPT-Live envia a tarefa para um modelo que pode pesquisar nosso catálogo de cursos e montar o plano.
O GPT-Live-1 oferece delegação via Responses e delegação no cliente. A delegação via Responses deixa a OpenAI gerenciar a chamada de backend, enquanto a delegação no cliente entrega para o seu código. Usei a delegação via Responses para evitar outro loop de backend neste app.
Usei gpt-5.6-sol. O guia de delegação da OpenAI usa gpt-5.6-terra como exemplo inicial e lista gpt-5.6-luna para tarefas de menor custo. Com o Sol, o backend retornou a estrutura de plano solicitada.
Mantenha tool_choice em auto para o backend poder escolher entre busca na web ou a função de salvar. O modo de delegação é fixo na inicialização; troque para delegação no cliente fechando a sessão atual e criando outra.
A regra no prompt Live é simples: saudações e dúvidas curtas ficam com o modelo Live, enquanto um plano de aprendizado ou mudanças nesse plano vão para o backend. Nada na API impõe essa fronteira. Teste com os tipos de pedidos que seu app vai receber, pois o modelo faz a escolha por conta própria.
Uma vez delegado, o backend tem uma tarefa: transformar o objetivo do aluno em uma lista curta de recursos do DataCamp com links. Dei a ele a ferramenta web_search com filters.allowed_domains em datacamp.com e www.datacamp.com. Trate esse filtro como instrução de busca, não como prova de que todo link está correto.
O objetivo de exemplo pede um caminho de engenharia de dados com 5 horas por semana, algum conhecimento de Python e nenhuma experiência em SQL. A resposta começa com How to Learn Data Engineering From Scratch in 2026 e a trilha Associate Data Engineer in SQL.
Os demais itens misturam um projeto, um curso de banco de dados em Python, outra trilha e um projeto final de pipeline. Cada URL listado abre uma página existente do DataCamp.
O prompt do backend pede de quatro a sete itens ordenados. Cada item tem título, URL, motivo curto e um tipo entre course, project, track, ou article. A mistura segue a preferência de formato do aluno e o tempo semanal.
Eu não pedi que o modelo estimasse a duração de um curso quando a página não informava. Um número exato nesse caso afirmaria mais do que a fonte sustenta.
O GPT-Live consegue manter a sessão de voz ativa enquanto o backend via Responses trabalha. Se o aluno acrescenta a restrição de "mão na massa" antes do retorno do primeiro plano, o trabalho original no backend não é cancelado automaticamente.
Uma correção falada não cancela ou reescreve automaticamente o trabalho que o backend já iniciou. Interromper a fala do assistente e mudar a tarefa são ações separadas. O aplicativo decide o que fazer com o resultado antigo.
O servidor rastreia um contador task_version e o incrementa sempre que uma nova delegação começa. Quando chega um resultado, o app confere sua versão antes de agir; o próprio handler registra um resultado antigo e não o executa.
A delegação via Responses tem um limite aqui: o modelo Live recebe o resultado do backend diretamente, então a checagem de versão não controla totalmente a próxima fala do assistente. A delegação no cliente permite ao seu código descartar um resultado antigo antes que chegue ao modelo. A versão da tarefa, portanto, protege ações do app, não cada palavra que o assistente pode dizer.
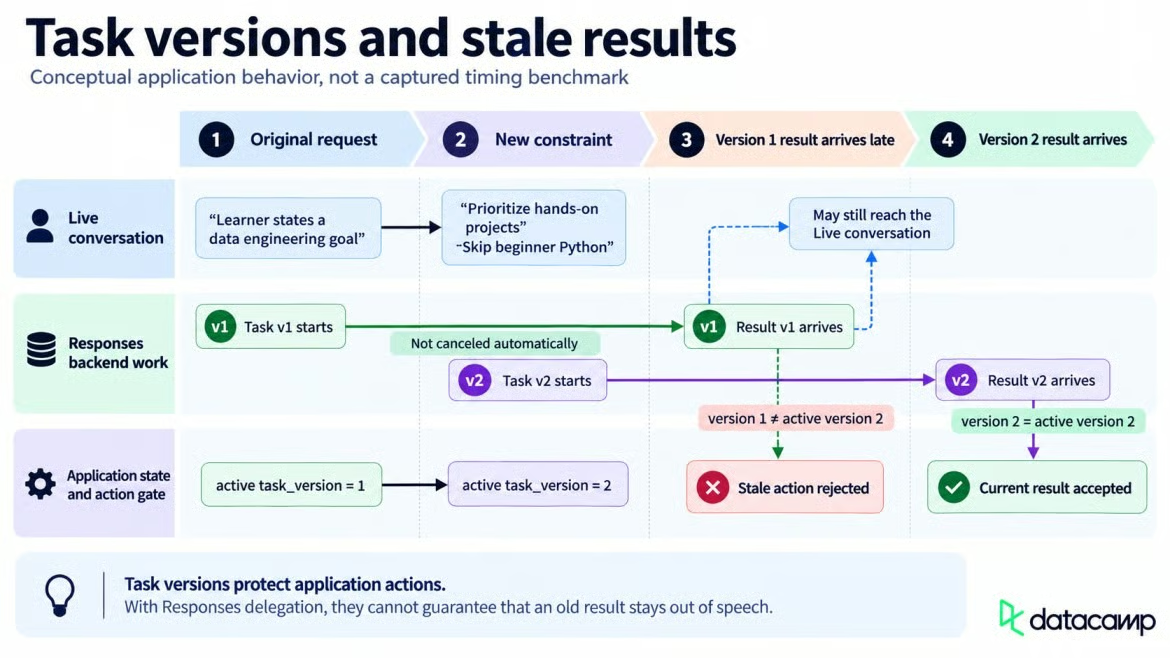
Versões de tarefa mantêm as restrições mais novas ativas. Imagem do autor.
Depois que a primeira resposta do backend foi concluída, enviei um follow-up pedindo projetos práticos e sem Python para iniciantes. O plano revisado de sete itens começou com Introduction to SQL, depois misturou uma trilha, dois cursos e quatro projetos, incluindo Exploring London's Travel Network e Building a Retail Data Pipeline. Isso mostra revisão entre turnos concluídos; não fala sobre interromper uma resposta ativa.
Durante o trabalho de backend, três eventos de append podem atualizar o modelo Live: session.thinking.append adiciona contexto que não deve ser falado, session.commentary.append adiciona texto para o modelo dizer com as próprias palavras, e session.instructions.append muda suas instruções.
Cada append carrega uma string simples de no máximo 500 tokens. Esses eventos atualizam o contexto ou o comportamento do modelo Live; eles não modificam nem cancelam uma tarefa de Responses que já esteja rodando. Uma instrução pode redirecionar o comportamento atual do Live, enquanto o comentário fornece informação que o modelo deve comunicar em voz alta.
O dashboard registra o progresso do backend mas não envia esses eventos de append. Com delegação via Responses, atualizações do seu app ainda podem ser enviadas por oai-events, mas usando delegation_id: null. IDs de delegação não nulos são usados para tarefas delegadas no cliente.
Mantenha task_id e task_version no estado da aplicação em vez de usar delegation_id para qualquer um deles.
Neste app, uma resposta do modelo não salva nada sozinha. O backend usa save_learning_plan para propor a ação pendente, enquanto /api/save-plan é o dono da gravação de fato.
Chamadas de função do backend chegam dentro de response.event. O handler espera por um item aninhado response.output_item.done, então lê call_id, name e arguments.
Esperar pelo item concluído é importante porque eventos anteriores podem conter apenas parte da chamada. O app faz o parse dos argumentos, mas ainda não executa a função.
SAVE_LEARNING_PLAN_TOOL = {
    "type": "function",
    "name": "save_learning_plan",
    "description": "Propose the current learning plan for confirmation when the learner asks to save.",
    "parameters": {
        "type": "object",
        "properties": {
            "goal": {"type": "string"},
            "weekly_hours": {"type": "number"},
            "items": {
                "type": "array",
                "items": {
                    "type": "object",
                    "properties": {
                        "title": {"type": "string"},
                        "url": {"type": "string"},
                        "reason": {"type": "string"},
                        "type": {
                            "type": "string",
                            "enum": ["course", "project", "track", "article"],
                        },
                    },
                    "required": ["title", "url", "reason", "type"],
                    "additionalProperties": False,
                },
            },
        },
        "required": ["goal", "weekly_hours", "items"],
        "additionalProperties": False,
    },
    "strict": True,
}
O schema dá ao app um conjunto fixo de campos para exibir antes de pedir a confirmação do aluno. O campo type mantém cursos, projetos, trilhas e artigos explícitos nos dados salvos.
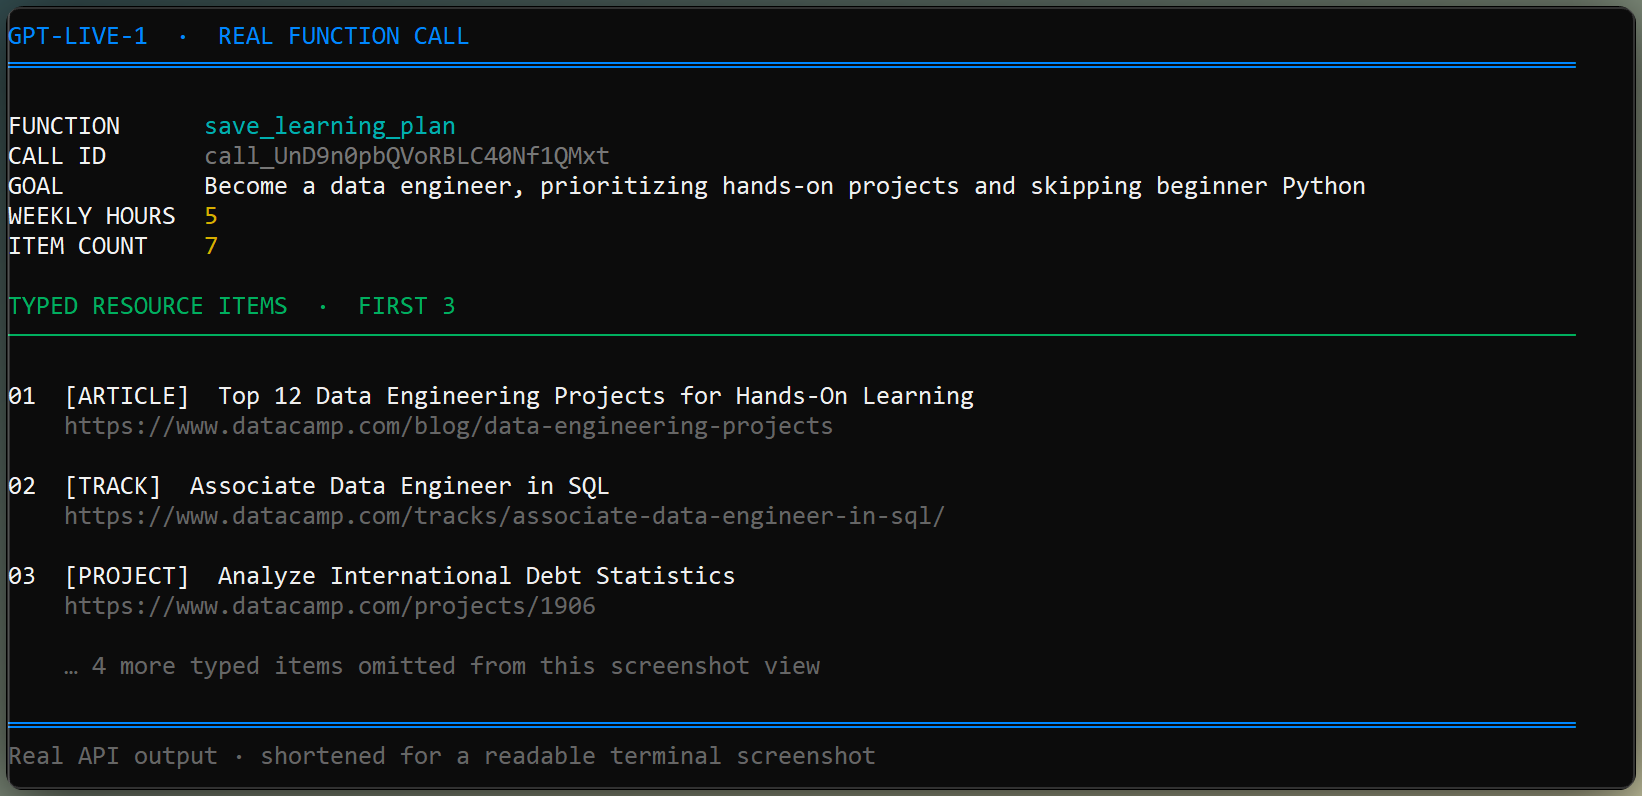
Terminal mostra argumentos tipados da função de salvamento. Imagem do autor.
Quando o aluno pede para salvar, o backend chama save_learning_plan com o plano completo. O widget armazena esses argumentos e mostra a caixa de confirmação, mas a chamada ainda é apenas uma proposta.
Deixar essa chamada de função sem resposta bloquearia a resposta delegada e turnos futuros no backend. O widget a responde imediatamente com um resultado de "aguardando confirmação" e depois envia response.create para a conversa continuar.
events.send(JSON.stringify({
  type: "response.item.create",
  item: {
    type: "function_call_output",
    call_id: callId,
    output: JSON.stringify({
      status: "awaiting_user_confirmation",
      saved: false,
    }),
  },
}));
events.send(JSON.stringify({ type: "response.create" }));
Nenhum arquivo é gravado neste ponto. O assistente pode orientar o aluno para o botão Confirmar e salvar sem bloquear trabalhos delegados posteriores.
O endpoint /api/save-plan recusa gravar a menos que confirmed seja true. Como a transcrição pode estar errada ou incompleta, o pedido falado sozinho não salva o plano.
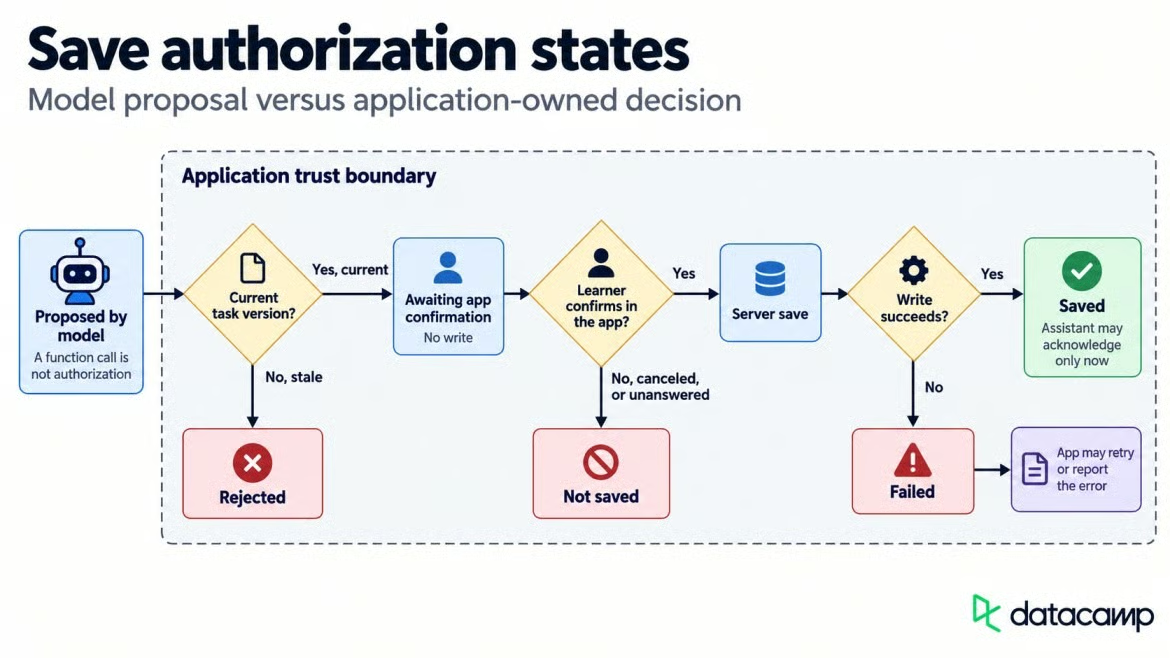
A confirmação separa pedidos de ações salvas. Imagem do autor.
O clique em Confirmar envia para /api/save-plan o plano pendente e confirmed: true. Depois que o servidor retorna um ID de plano, o widget envia session.commentary.append com delegation_id: null porque a chamada de função original já foi respondida.
const saveResponse = await fetch(${SERVER}/api/save-plan, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    confirmed: true,
    plan: pendingFunctionCall.args,
  }),
});
const saveResult = await saveResponse.json();

events.send(JSON.stringify({
  type: "session.commentary.append",
  delegation_id: null,
  content: The plan was saved as ${saveResult.plan_id}.,
}));
A atualização de commentary informa ao modelo Live sobre a gravação concluída e permite que ele reconheça o salvamento em voz alta. A chamada de função anterior permanece encerrada, e a sessão de voz continua disponível para o próximo pedido do aluno.
O repositório no GitHub citado contém o servidor FastAPI, a interface em Streamlit e o widget WebRTC dentro de app/. Depois de clonar, abra dois terminais nessa pasta. Rode uvicorn server:app --host 127.0.0.1 --port 8000 em um e streamlit run streamlit_app.py no outro.
A interface em Streamlit envolve o mesmo servidor e widget usados em todo o build. Ela coloca a conversa ao vivo ao lado do plano de aprendizado e da atividade do backend, enquanto o dashboard se atualiza sem reiniciar a chamada.
O vídeo abaixo acompanha o objetivo falado, a busca no backend, o plano revisado e o salvamento confirmado. A chamada permanece aberta após salvar para o aluno continuar.
Aprenda com a DataCamp
Curso
Curso
Curso
blog
Matt Crabtree
12 min
Tutorial
Moez Ali
11 min
Tutorial
Matt Crabtree
6 min
Tutorial
Zoumana Keita
14 min
Tutorial
Matt Crabtree
10 min
Tutorial
Kurtis Pykes
12 min