Cursus
Prompt Engineering begrijpen
1 Hr
230.3K
Toen ik voor het eerst een GPT-Live-1-browsersessie opende, verwachtte ik de gebruikelijke spraaklus: praten, wachten en dan een antwoord horen. In plaats daarvan bleef de microfoon open terwijl de assistent antwoordde. Het gesprek voelde minder stijf, maar de app moest nog steeds het werk erachter aansturen.
OpenAI introduceerde GPT-Live eerst in ChatGPT in juli en bracht GPT-Live-1 daarna naar de API eerder deze week, net voordat ik aan deze build begon. Onze GPT-Realtime-2.1-tutorial behandelt de één-modelaanpak, terwijl onze GPT Live Transcribe-gids zich richt op live ondertiteling. Hier bouw je een spraakleerassistent die echte DataCamp-bronnen doorzoekt en pas na bevestiging een plan opslaat.
Ik noem hem de DataCamp Voice Learning Assistant. Het is een tutorialprototype, niet de productieversie van de DataCamp AI Assistant. Het project volgt één learner van een uitgesproken doel naar een opgeslagen plan.
GPT-Live-1 scheidt de gesproken uitwisseling van het backendwerk. Vier bevindingen bepalen de leerassistent.
Deze bevindingen gelden voor deze leerplan-flow. Een andere prompt of netwerk kan het gedrag veranderen, en clientdelegatie verschuift de controlegrens.
GPT-Live-1 is OpenAI's full-duplex spraakmodel. Het verwerkt gesproken beurten en onderbrekingen, inclusief de pauzes ertussen, en stuurt langer werk zoals zoekopdrachten of toolcalls naar een backend.
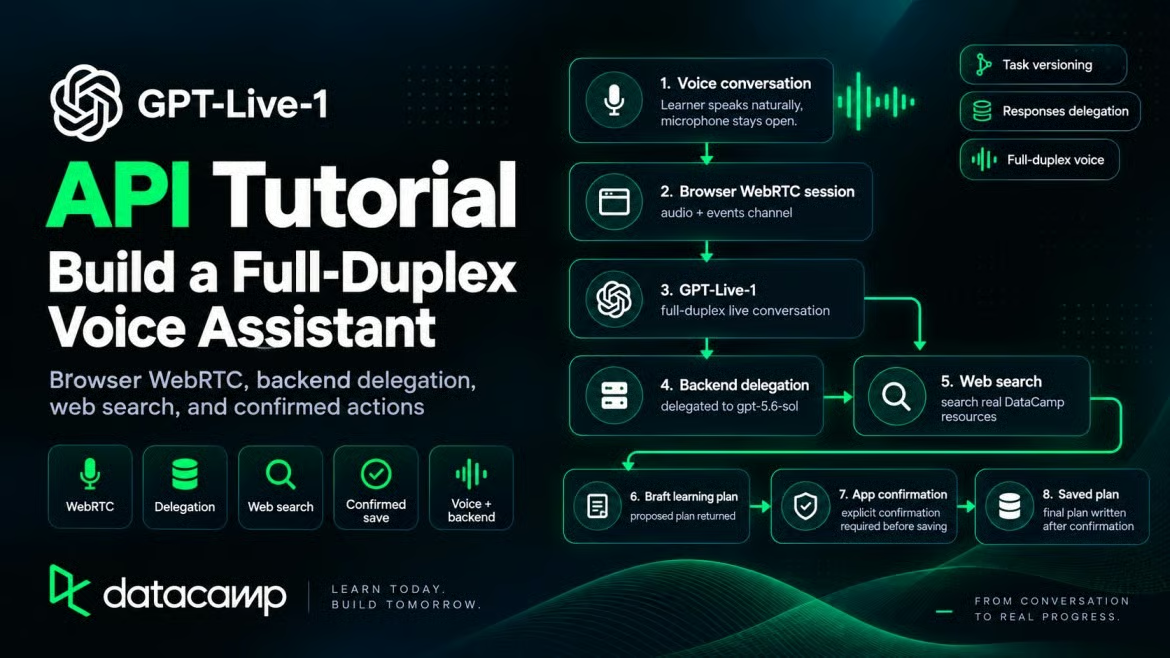
Voor de learner is het eerste zichtbare verschil in die pauzes.
Full duplex verandert het nemen van beurten. Je kunt pauzeren om na te denken of door de assistent heen praten, en die kan stoppen om de correctie te horen. OpenAI's promptinggids laat promptsecties zien voor korte bevestigingen en onderbrekingen.
Dit is belangrijk in een leerassistent. Iemand die een carrièredoel beschrijft, kan pauzeren, opnieuw beginnen of halverwege een beperking toevoegen. Een model dat wacht tijdens "eh, ik denk, misschien vijf uur per week" laat de learner hardop nadenken.
Delegatie verplaatst een taak naar de backend, maar draagt de applicatiecontrole niet over. De app beslist nog steeds wie mag handelen en of opslaan is toegestaan. Ook beheert de app de opgeslagen taakstatus.
Als je GPT-Realtime-2.1 hebt gebruikt, vraag je je misschien af of GPT-Live-1 het vervangt. Dat is niet zo.
GPT-Realtime-2.1 verwerkt luisteren, redeneren en toolselectie in één model via v1/realtime, afgerekend op audio- en teksttokens. GPT-Live-1 gebruikt v1/live/sessions, rekent de spraaklaag per seconde af en stuurt redeneren naar een aparte backend.
Realtime-2.1 is geen oudere of mindere optie. Het gebruikt een ander ontwerp.
De app neemt een uitgesproken doel en zet dat om in een geordende lijst van echte DataCamp-bronnen. De spraaksessie blijft open tijdens backendwerk. Als het verzoek verandert, werkt de app zijn taakversie bij voordat een backendactie wordt uitgevoerd.
Er wordt niets weggeschreven totdat de learner het opnieuw in de app bevestigt.
De browserpagina beheert de WebRTC-verbinding en microfoon, terwijl de server de GPT-Live-1-sessie aanmaakt en de API-sleutel bewaart. Een Responses-backend (gpt-5.6-sol) gebruikt webzoekopdrachten en de save_learning_plan functie. De huidige taakversie en het bevestigde plan blijven in appstatus.
De taakversie bepaalt welke backendactie de app accepteert wanneer een verzoek verandert tijdens een zoekopdracht. Gebruik de GitHub-repository voor de volledige uitvoerbare app; de volgende secties richten zich op het GPT-Live-pad.
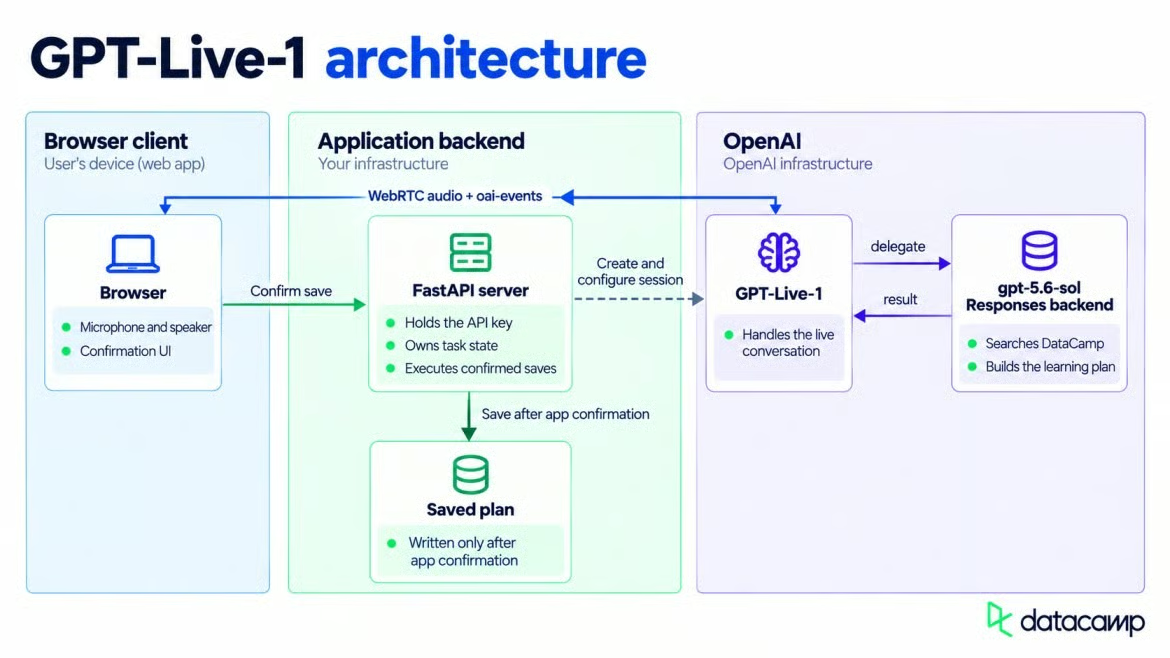
Browser, GPT-Live-1 en backendmodel zijn verbonden. Afbeelding door de auteur.
Je hebt een OpenAI-project met toegang tot GPT-Live-1 nodig (de gratis laag ondersteunt dit niet), Python en een browser die via HTTPS of localhost draait zodat de microfoonprompt kan verschijnen. Ik gebruikte Python 3.11 en openai 3.13.0. De Live API heeft minimaal openai 3.12.0 nodig; oudere versies hebben geen .live attribuut op de client.
Limieten voor gelijktijdige sessies hangen af van je gebruiksniveau. Controleer de projectlimiet voordat je veel browsertabs opent.
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install openai fastapi uvicorn python-dotenv streamlit requests
Op macOS of Linux activeer je de omgeving met source .venv/bin/activate . Maak een .env-bestand in de projectroot en voeg deze waarde toe.
OPENAI_API_KEY=sk-...python-dotenv laadt dat bestand automatisch zodra de server het importeert, zodat de sleutel nooit in code hoeft te verschijnen.
De OpenAI()-client leest dezelfde omgevingsvariabele wanneer je geen sleutel doorgeeft.
De browser ziet je projectsleutel nooit. Hij post een WebRTC-offer naar je server, die de sleutel gebruikt om de sessie aan te maken. Na de SDP-uitwisseling stuurt de browser audio naar OpenAI via WebRTC zonder die sleutel te ontvangen.
De GPT-Live-aanroep binnen /api/session maakt de sessie aan op basis van het SDP-offer. Hij geeft de spraakinstructies, backendmodel, webzoekfunctie en opslaffunctie mee in dezelfde request.
result = client.live.create(
    session={
        "model": "gpt-live-1",
        "instructions": LIVE_INSTRUCTIONS,
        "delegation": {
            "type": "responses",
            "responses": {
                "model": "gpt-5.6-sol",
                "instructions": BACKEND_INSTRUCTIONS,
                "tools": [
                    {
                        "type": "web_search",
                        "filters": {
                            "allowed_domains": ["datacamp.com", "www.datacamp.com"]
                        },
                    },
                    SAVE_LEARNING_PLAN_TOOL,
                ],
                "tool_choice": "auto",
            },
        },
    },
    transport={"type": "webrtc", "sdp": sdp},
)
Die aanroep stuurt een verzoek naar POST /v1/live/sessions en retourneert een sessie-ID met een SDP-antwoord. De HTTP-aanvraag start de sessie, dus stuur daarna geen apart session.start-event.
De voorbeeldserver accepteert browserverzoeken alleen van localhost:8501 en 127.0.0.1:8501. Die regel is voor lokaal gebruik.
Als je de app uitrolt, vervang die origins en beveilig zowel /api/session als /api/save-plan met authenticatie. Beperk het aanmaken van sessies met rate limiting, want elke aanvraag kan geld kosten en gelijktijdigheid verbruiken. Een client kan zelf confirmed: true sturen, dus een publieke server kan dat veld niet zien als bewijs van wie het verzoek deed.
Volgens OpenAI's WebRTC-gids vraagt de browser om microfoontoegang en opent een RTCPeerConnection. Gebruik het gedocumenteerde oai-events label voor het datachannel en maak het aan vóór het genereren van het SDP-offer. Dat kanaal draagt JSON-events in beide richtingen zodra de sessie start.
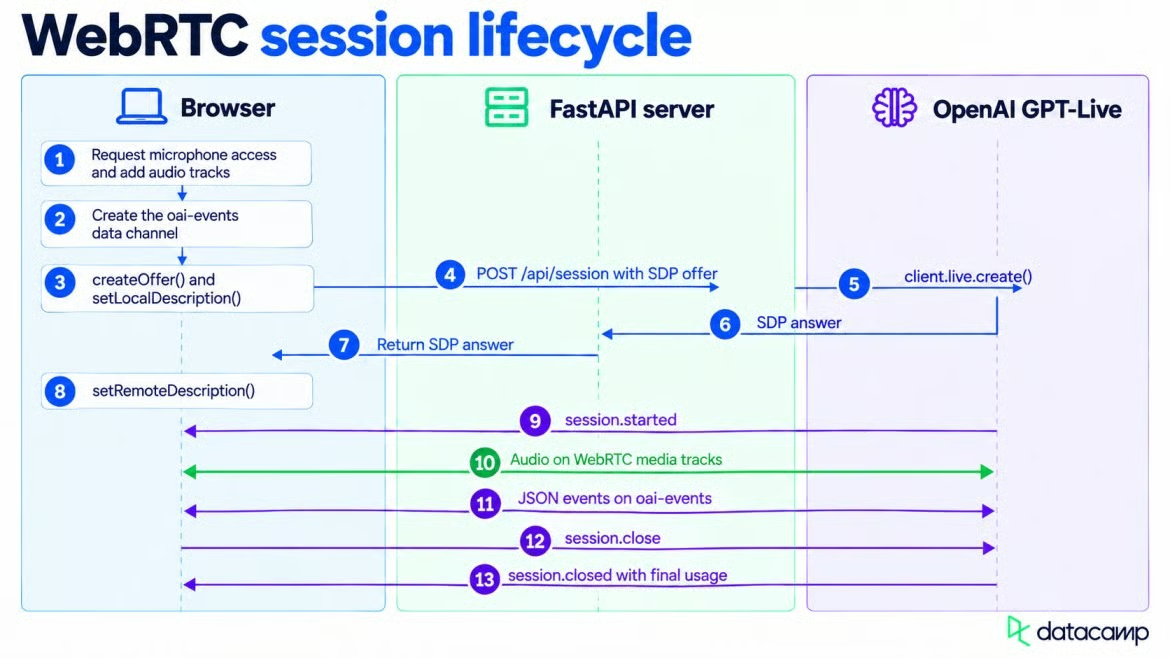
WebRTC start, streamt audio en sluit dan af. Afbeelding door de auteur.
De mediaset-up zelf is gewone WebRTC. GPT-Live-events gebruiken het datachannel dat in de laatste regel is aangemaakt.
const connection = new RTCPeerConnection();
connection.addEventListener("track", (event) => {
  audio.srcObject = new MediaStream([event.track]);
  audio.play();
});
const microphone = await navigator.mediaDevices.getUserMedia({ audio: true });
for (const track of microphone.getAudioTracks()) {
  connection.addTrack(track, microphone);
}
const events = connection.createDataChannel("oai-events");
Na het maken van het offer roept de browser setLocalDescription() aan en wacht tot ICE-gathering klaar is. Hij stuurt de lokale SDP naar /api/session en past vervolgens OpenAI's antwoord toe met setRemoteDescription(). Microfoonaudio en de spraak van de assistent reizen over de mediatracks, dus aparte speech-to-text- en text-to-speech-aanvragen zijn niet nodig.
Audio hoort niet op oai-events. Verstuur geen session.input_audio.append en wacht niet op session.output_audio.delta via een WebRTC-datachannel.
Het datachannel volgt een andere timingregel. Wacht op session.started voordat je een event via oai-events verstuurt. Bij mijn eerste poging stuurde ik er één te vroeg en negeerde de verbinding die.
Ik kreeg geen bruikbare foutmelding, wat een kleine volgordefout lastig maakte om te achterhalen.
Als je geen zichtbare ondertiteling nodig hebt, kun je deze subsectie overslaan; de audioverbinding is al compleet.
session.input_transcript.delta en session.output_transcript.delta geven tekstfragmenten terug met milliseconde-offsets voor live ondertiteling. De documentatie van OpenAI waarschuwt dat transcriptfragmenten geen afgeronde beurten zijn. De levering kan ongelijk zijn en transcriptintervallen van gebruiker en assistent kunnen overlappen.
Voeg transcriptfragmenten toe aan het scherm zodra ze binnenkomen, maar start er geen backendwerk mee. Het model beslist wanneer het delegeert.
De instructies van het Live-model moeten kort zijn. OpenAI's gids plaatst gedetailleerde taakstappen in de backendprompt. Ik hield de taakprocedure daar en liet de Live-prompt focussen op spraak.
Dit fragment houdt het stemgedrag gescheiden van de leerplantaak. Spraakregels staan boven de voorwaarden die delegatie activeren.
You are Sage, a warm, encouraging voice learning coach for DataCamp learners.
Speak naturally at an unhurried pace. Be clear and direct, not overly cheerful.

Backchannel policy: Use moderate backchannels without competing with the response.
Interruption policy: Stop speaking when the learner interrupts, and listen.

Delegation policy:
Backend tools:
- learning_plan_research: search DataCamp resources and assemble a personalized learning plan.
- save_learning_plan: propose the current plan for app confirmation when the learner asks to save.

Delegate to the backend when:
- The learner states or changes a goal, skill level, or weekly time.
- A correction changes the plan already requested.
- The learner asks to save the plan.

Do not delegate for greetings, small clarifications, or a result already given.

Saving: a proposed save only asks the app to confirm. Do not say the plan is saved until the app reports a saved result.
After a save, keep the conversation open and ask what the learner wants next.
Deze regels laten begroetingen in de Live-laag en sturen onderzoeks- of opslagverzoeken naar de backend. De bevestiging blijft bij de app horen.
De backchannel- en onderbrekingsregels vertellen de assistent hoe te reageren rond pauzes. "Gematigde backchannels" vraagt om af en toe een bevestiging zoals "hmm-hmm" zonder elke stilte op te vullen. Ik koos dat niveau om de learner ruimte te geven om na te denken; een les met langere pauzes kan minder bevestigingen nodig hebben.
Pas die regel aan als je app ander gedrag nodig heeft; toevoegen van "spreek nooit terwijl de gebruiker spreekt" haalt de backchannels ook weg.
De twee prompts hebben verschillende taken. De Live-prompt stuurt spraak en overdracht, terwijl de backendprompt onderzoek en antwoordopmaak aanstuurt. De gids van OpenAI raadt af om gedetailleerde zoekstappen in de steminstructies te zetten.
De eerder beschreven splitsing verschijnt in het delegation veld van de sessie. Wanneer de learner een doel uitspreekt, stuurt GPT-Live de taak naar een model dat onze cursuscatalogus kan doorzoeken en het plan kan maken.
GPT-Live-1 biedt Responses-delegatie en clientdelegatie. Met Responses-delegatie beheert OpenAI de backendanroep, terwijl clientdelegatie het aan jouw code overlaat. Ik gebruikte Responses-delegatie omdat dit in deze app nog een extra backendlus voorkomt.
Ik gebruikte gpt-5.6-sol. OpenAI's delegatiegids gebruikt gpt-5.6-terra als uitgangspunt en noemt gpt-5.6-luna voor taken met lagere kosten. Met Sol gaf de backend de gevraagde planstructuur terug.
Laat tool_choice op auto staan zodat de backend webzoek of de opslaffunctie kan kiezen. De delegatiemodus staat vast bij de start; schakel naar clientdelegatie door de huidige sessie te sluiten en een nieuwe te maken.
De regel in de Live-prompt is simpel: begroetingen en korte vragen blijven bij het Live-model, terwijl een leerplan of een wijziging daarin naar de backend gaat. Niets in de API dwingt die grens af. Test met de soorten verzoeken die je app zal ontvangen, want het model maakt de keuze zelf.
Eenmaal gedelegeerd heeft de backend één taak: het doel van de learner omzetten in een korte lijst DataCamp-bronnen met links. Ik gaf het de web_search tool met filters.allowed_domains op datacamp.com en www.datacamp.com. Zie die filter als een zoekinstructie, niet als bewijs dat elke link klopt.
Het voorbeelddoel vraagt om een data-engineeringpad met 5 uur per week, wat Pythonkennis en geen SQL-ervaring. Het antwoord begint met How to Learn Data Engineering From Scratch in 2026 en de Associate Data Engineer in SQL-track.
De overige items mengen een project, een Python-databascursus, nog een track en een laatste pipelineproject. Elke vermelde URL opent een bestaande DataCamp-pagina.
De backendprompt vraagt om vier tot zeven geordende items. Elk item heeft een titel, URL, korte reden en een type course, project, track, of article. De mix volgt de opgegeven voorkeur voor formaat en wekelijkse tijd van de learner.
Ik vroeg het model niet om een cursustijd te raden wanneer die niet op de pagina stond. Een exact getal in dat geval zou meer claimen dan de bron ondersteunt.
GPT-Live kan de spraaksessie actief houden terwijl de Responses-backend werkt. Als de learner vóór het eerste plan de hands-on-beperking toevoegt, wordt het oorspronkelijke backendwerk niet automatisch geannuleerd.
Een gesproken correctie annuleert of herschrijft niet automatisch werk dat de backend al is gestart. Het onderbreken van de spraak van de assistent en het wijzigen van de taak zijn afzonderlijke acties. De applicatie beslist wat er met het oudere resultaat gebeurt.
De server houdt een task_version teller bij en verhoogt die wanneer een nieuwe delegatie start. Wanneer een resultaat binnenkomt, controleert de app de versie voordat hij erop reageert; zijn eigen handler logt een oud resultaat en voert het niet uit.
Responses-delegatie kent hier een grens: het Live-model ontvangt het backendresultaat rechtstreeks, dus de versiecheck kan zijn volgende gesproken antwoord niet volledig sturen. Met clientdelegatie kan je code een oud resultaat verwerpen voordat het het model bereikt. De taakversie beschermt dus de appacties, niet elk woord dat de assistent mogelijk zegt.
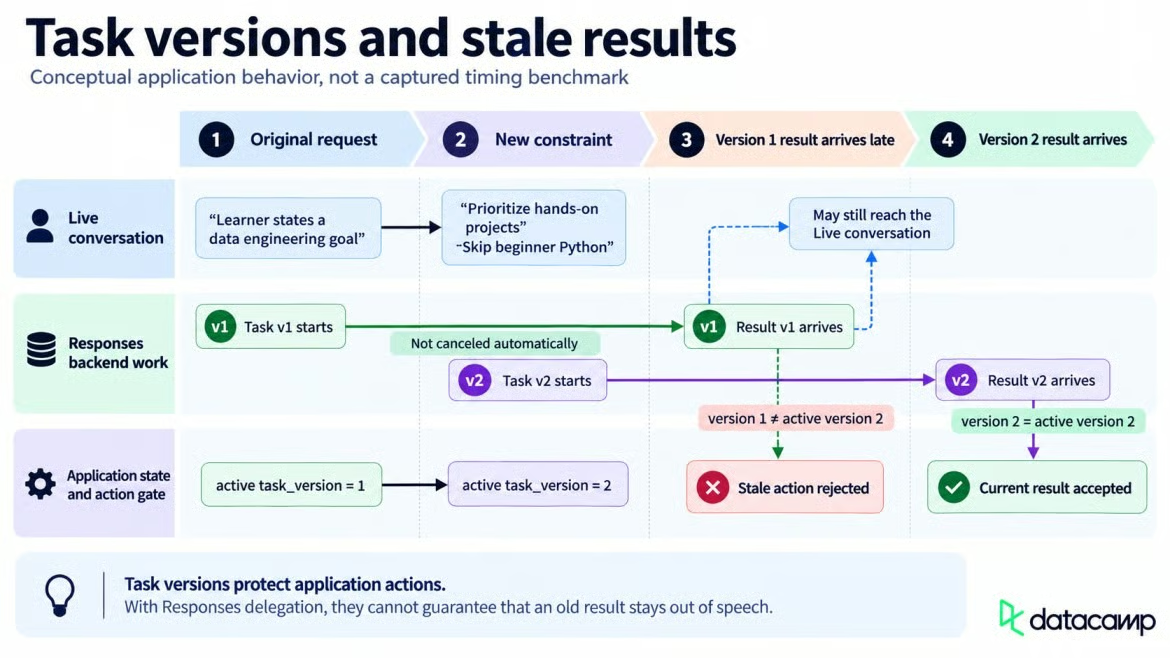
Taakversies houden nieuwere beperkingen actief. Afbeelding door de auteur.
Nadat de eerste backendrespons was voltooid, stuurde ik een vervolgvraag met hands-on-projecten en geen beginners-Python. Het herziene zevendelige plan begon met Introduction to SQL, en mengde daarna één track, twee cursussen en vier projecten, waaronder Exploring London's Travel Network en Building a Retail Data Pipeline. Dat laat revisie over afgeronde beurten zien; het zegt niets over het stoppen van een actieve respons.
Tijdens backendwerk kunnen drie append-events het Live-model bijwerken. session.thinking.append voegt context toe die niet uitgesproken moet worden, session.commentary.append voegt tekst toe die het model in eigen woorden moet zeggen, en session.instructions.append wijzigt de instructies.
Elke toevoeging bevat een platte string van maximaal 500 tokens. Deze events werken de context of het gedrag van het Live-model bij; ze wijzigen of annuleren geen backend-Responses-taak die al loopt. Een instructie kan het huidige Live-gedrag ombuigen, terwijl commentary informatie aanreikt die het model hardop moet communiceren.
Het dashboard registreert backendvoortgang maar stuurt deze append-events niet. Met Responses-delegatie kunnen updates van je app nog steeds via oai-events worden verzonden, maar ze gebruiken delegation_id: null. Niet-lege delegation-ID's worden gebruikt voor client-gedelegeerde taken.
Houd task_id en task_version in de applicatiestatus in plaats van delegation_id voor een van beide te gebruiken.
In deze app slaat een modelantwoord niets zelfstandig op. De backend gebruikt save_learning_plan om de voorgenomen actie voor te stellen, terwijl /api/save-plan het daadwerkelijke wegschrijven beheert.
Back-endfunctieaanroepen komen binnen in response.event. De handler wacht op een genest response.output_item.done-item en leest dan de call_id, name en arguments daarvan uit.
Wachten op het afgeronde item is belangrijk, want eerdere events kunnen slechts een deel van de call bevatten. De app parseert de argumenten maar voert de functie nog niet uit.
SAVE_LEARNING_PLAN_TOOL = {
    "type": "function",
    "name": "save_learning_plan",
    "description": "Propose the current learning plan for confirmation when the learner asks to save.",
    "parameters": {
        "type": "object",
        "properties": {
            "goal": {"type": "string"},
            "weekly_hours": {"type": "number"},
            "items": {
                "type": "array",
                "items": {
                    "type": "object",
                    "properties": {
                        "title": {"type": "string"},
                        "url": {"type": "string"},
                        "reason": {"type": "string"},
                        "type": {
                            "type": "string",
                            "enum": ["course", "project", "track", "article"],
                        },
                    },
                    "required": ["title", "url", "reason", "type"],
                    "additionalProperties": False,
                },
            },
        },
        "required": ["goal", "weekly_hours", "items"],
        "additionalProperties": False,
    },
    "strict": True,
}
Het schema geeft de app een vaste set velden om te tonen voordat hij de learner om bevestiging vraagt. Het veld type houdt cursussen, projecten, tracks en artikelen expliciet in de opgeslagen data.
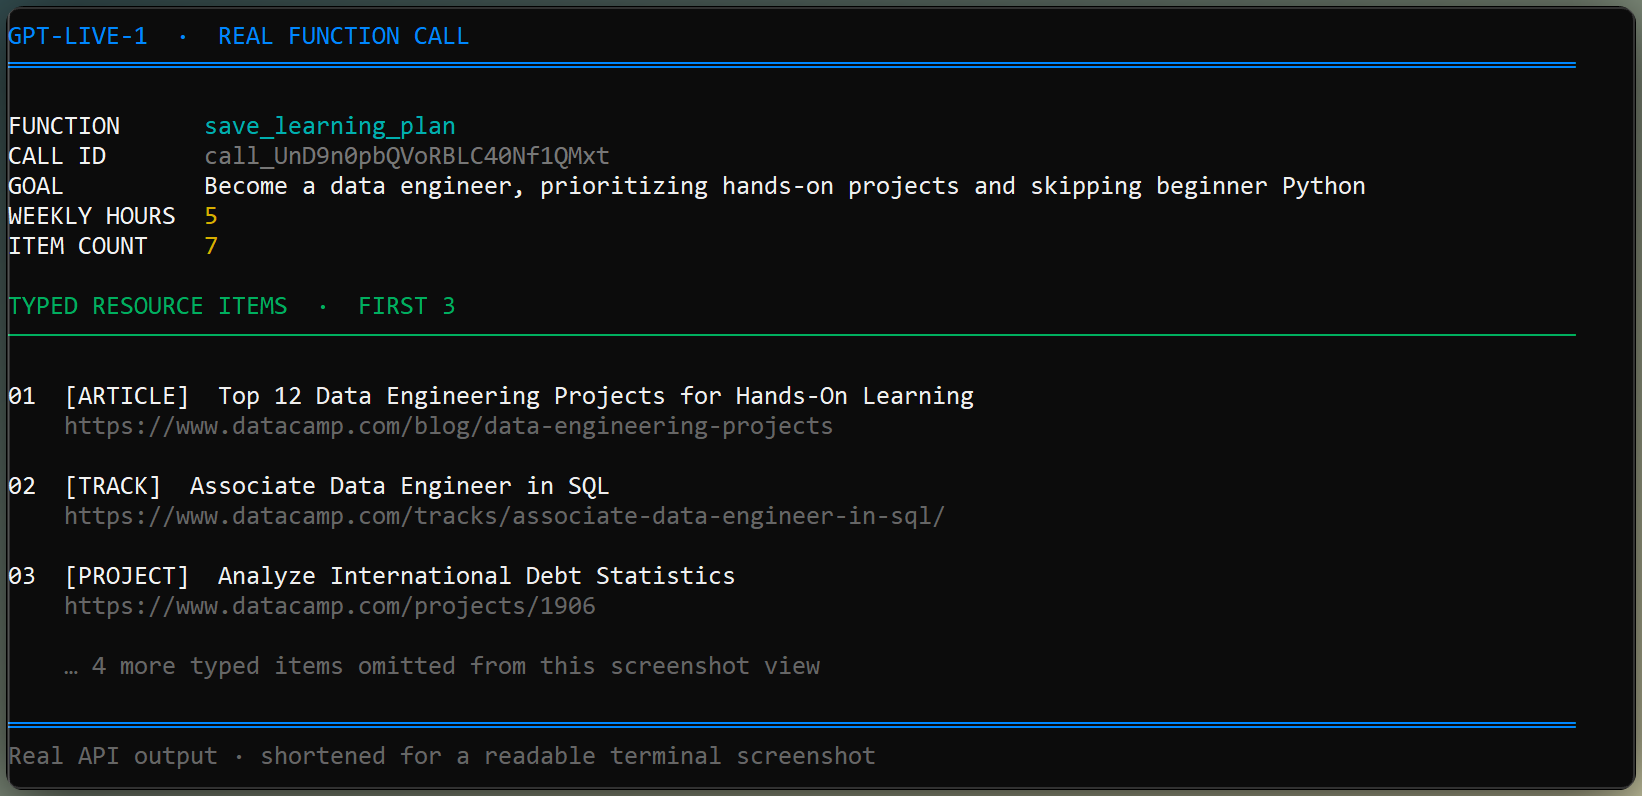
Terminal toont getypte argumenten van de opslaffunctie. Afbeelding door de auteur.
Wanneer de learner vraagt om op te slaan, roept de backend save_learning_plan aan met het volledige plan. De widget slaat die argumenten op en toont het bevestigingsvak, maar de call is nog steeds slechts een voorstel.
Die functieaanroep onbeantwoord laten zou de gedelegeerde respons en latere backendbeurten blokkeren. De widget beantwoordt hem direct met een afwachting-van-bevestigingresultaat en stuurt daarna response.create zodat het gesprek door kan gaan.
events.send(JSON.stringify({
  type: "response.item.create",
  item: {
    type: "function_call_output",
    call_id: callId,
    output: JSON.stringify({
      status: "awaiting_user_confirmation",
      saved: false,
    }),
  },
}));
events.send(JSON.stringify({ type: "response.create" }));
Er wordt nu nog geen bestand geschreven. De assistent kan de learner naar de knop Bevestigen en opslaan verwijzen zonder later gedelegeerd werk te blokkeren.
Het /api/save-plan-endpoint weigert te schrijven tenzij confirmed true is. Omdat een transcript onjuist of onvolledig kan zijn, slaat het gesproken verzoek alleen het plan niet op.
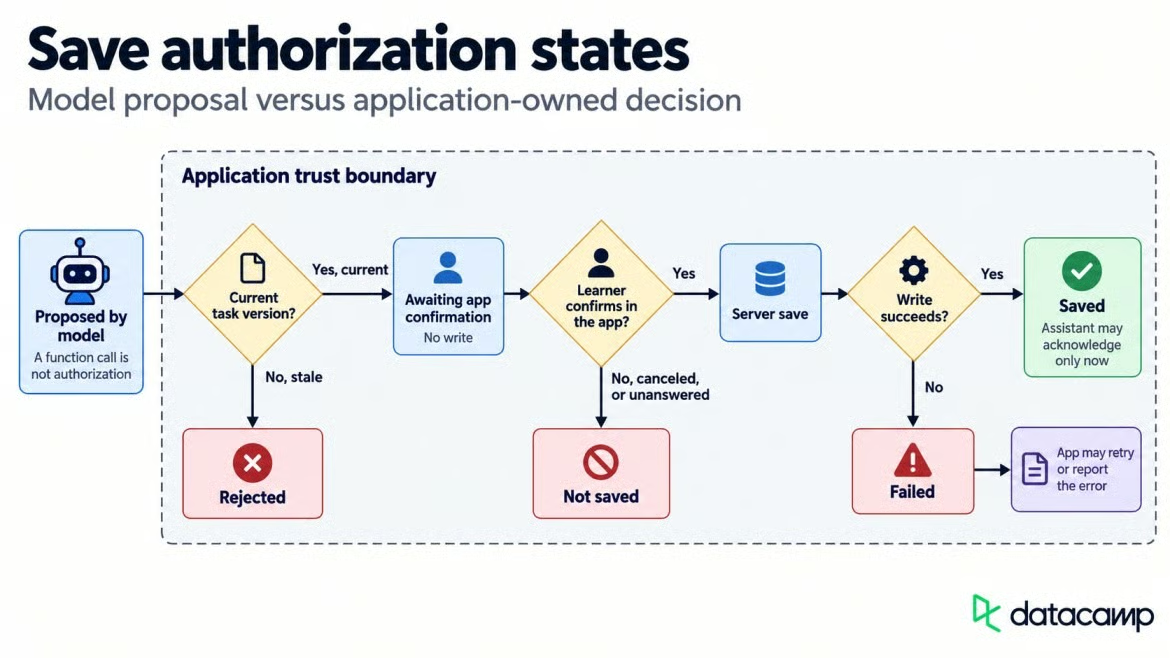
Bevestiging scheidt verzoeken van opgeslagen acties. Afbeelding door de auteur.
De klik op Bevestigen stuurt /api/save-plan het in behandeling zijnde plan en confirmed: true. Nadat de server een plan-ID retourneert, stuurt de widget session.commentary.append met delegation_id: null omdat de oorspronkelijke functieaanroep al is beantwoord.
const saveResponse = await fetch(${SERVER}/api/save-plan, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    confirmed: true,
    plan: pendingFunctionCall.args,
  }),
});
const saveResult = await saveResponse.json();

events.send(JSON.stringify({
  type: "session.commentary.append",
  delegation_id: null,
  content: The plan was saved as ${saveResult.plan_id}.,
}));
De commentary-update vertelt het Live-model over het voltooide wegschrijven en laat het de opslag hardop bevestigen. De eerdere functieaanroep blijft gesloten en de spraaksessie blijft beschikbaar voor het volgende verzoek van de learner.
De eerder gelinkte GitHub-repository bevat de FastAPI-server, de Streamlit-interface en de WebRTC-widget in app/. Na het clonen open je twee terminals in die map. Voer uvicorn server:app --host 127.0.0.1 --port 8000 uit in de ene en streamlit run streamlit_app.py in de andere.
De Streamlit-interface wikkelt dezelfde server en widget als in de hele build. Hij plaatst het livegesprek naast het leerplan en de backendactiviteit, terwijl het dashboard bijwerkt zonder het gesprek te resetten.
De onderstaande video volgt het uitgesproken doel, de backendzoekopdracht, het herziene plan en de bevestigde opslag. De call blijft open na het opslaan zodat de learner kan doorgaan.
Leren met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min