Courses
理解 Prompt Engineering
1小时
230.3K
我第一次打开 GPT-Live-1 浏览会话时,本以为会是常见的语音循环:说话、等待,然后听答案。结果却是,助手在回复时麦克风一直保持开启。对话不再拘谨,但应用仍需管理背后的工作。
OpenAI 先是在 7 月于 ChatGPT 中推出 GPT-Live,随后在本周早些时候将 GPT-Live-1 引入 API,恰好赶在我开始这个项目之前。我们的 GPT-Realtime-2.1 教程介绍了单模型方案,而 GPT Live 转写指南侧重于实时字幕。在本文中,您将构建一个语音学习助手,它会搜索真实的 DataCamp 资源,并且只在确认后才保存计划。
我称之为 DataCamp 语音学习助手。这是一个教程原型,而非正式的 DataCamp AI 助手。项目将跟随一位学习者,从口述目标到保存计划的全过程。
GPT-Live-1 将口语交互与后端工作分离。以下四点塑造了这个学习助手:
这些结论适用于此学习计划流程。不同的提示或网络环境可能改变行为,使用客户端委托也会改变控制边界。
GPT-Live-1 是 OpenAI 的全双工语音模型。它处理口语轮次与打断(包括其中的停顿),并将搜索或工具调用等更长的工作发送到后端。
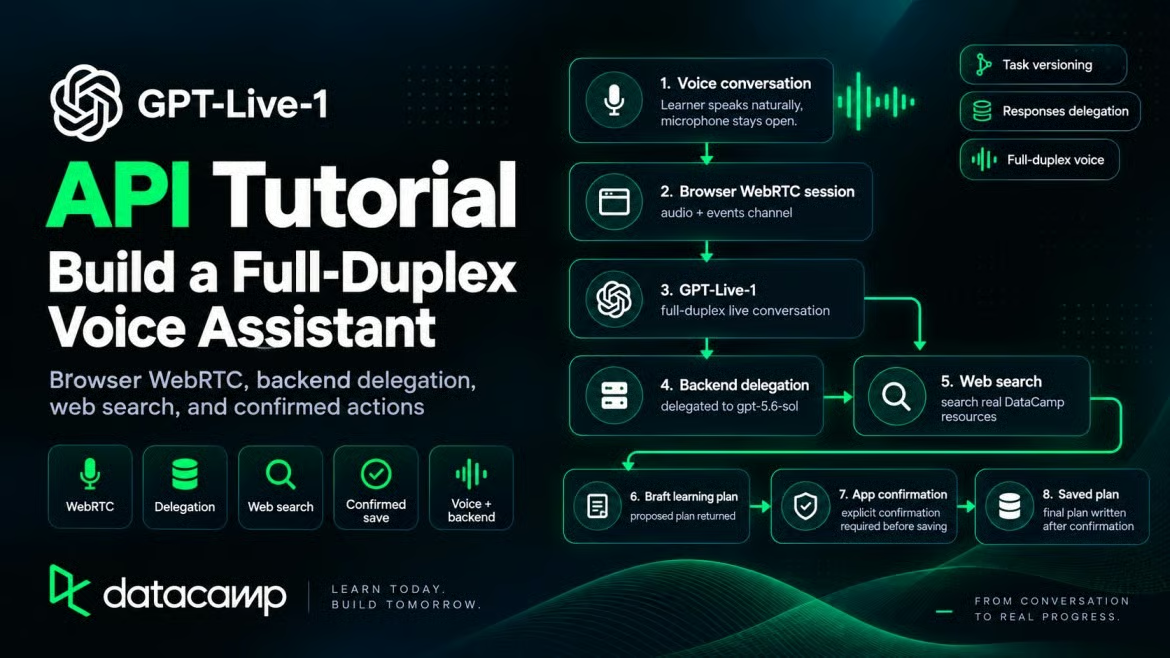
对学习者而言,最直观的不同首先体现在这些停顿上。
全双工改变了轮流发言的方式。您可以停顿思考或打断助手,助手也能停下来听取更正。OpenAI 的提示指南展示了用于简短致意与打断的提示片段。
这对学习助手很重要。描述职业目标的人可能会停顿、重来,或在中途添加限制。一个愿意等待“嗯,我想,每周大概五小时吧”的模型能让学习者把想法说出来。
委托会把任务移到后端,但不会交出应用控制权。应用仍决定谁能执行操作,以及是否允许保存。它也拥有已存储的任务状态。
如果您用过 GPT-Realtime-2.1,或许会想 GPT-Live-1 是否取代了它。并没有。
GPT-Realtime-2.1 在 v1/realtime 路径上,用一个模型处理聆听、推理与工具选择,按音频与文本 Token 计费。GPT-Live-1 使用 v1/live/sessions,语音层按秒计费,并将推理发送到独立后端。
Realtime-2.1 不是更旧或更弱的选项。它只是采用了不同的设计。
应用接收口述目标并将其转化为有顺序的真实 DataCamp 资源列表。后端工作期间语音会话保持开启。当请求发生变化,应用会在执行后端动作前更新其任务版本。
在学习者于应用内再次确认之前,不会写入任何内容。
浏览器页面负责 WebRTC 连接与麦克风,服务器创建 GPT-Live-1 会话并保管 API 密钥。Responses 后端(gpt-5.6-sol)使用网页搜索与 save_learning_plan 函数。当前任务版本与已确认计划保存在应用状态中。
当搜索过程中请求发生变化时,任务版本决定应用接受哪个后端动作。完整可运行应用请查看 GitHub 仓库;接下来的章节将聚焦其 GPT-Live 路径。
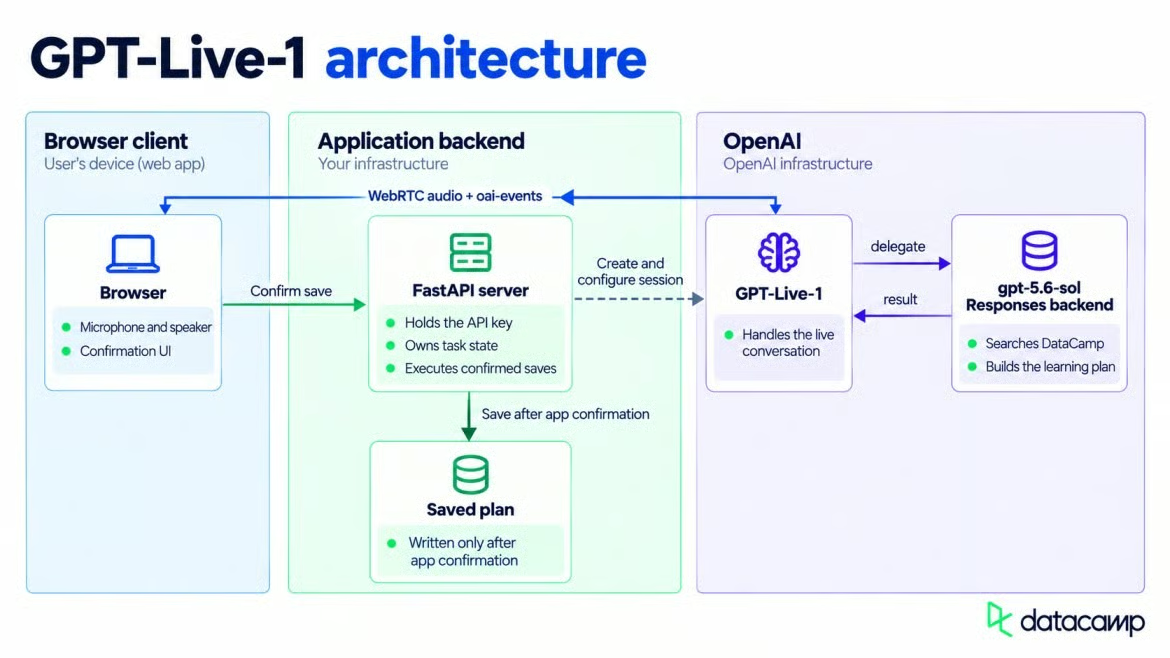
浏览器、GPT-Live-1 与后端模型相连。作者供图。
您需要一个具备 GPT-Live-1 访问权限的 OpenAI 项目(免费层不支持)、Python,以及运行在 HTTPS 或 localhost 上的浏览器以便弹出麦克风授权。我使用的是 Python 3.11 与 openai 3.13.0。Live API 需要至少 openai 3.12.0;更早版本的客户端没有 .live 属性。
并发会话上限取决于您的用量等级。在打开多个浏览器标签页前,请检查项目限制。
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install openai fastapi uvicorn python-dotenv streamlit requests
在 macOS 或 Linux 上,请使用 source .venv/bin/activate 激活环境。于项目根目录创建 .env 文件并添加如下值。
OPENAI_API_KEY=sk-...python-dotenv 会在服务器导入后自动加载该文件,因此密钥无需出现在代码中。
OpenAI() 客户端在未显式传入密钥时,也会读取同名环境变量。
浏览器永远不会看到您的项目密钥。它会将 WebRTC offer 发给您的服务器,服务器再使用该密钥创建会话。完成 SDP 交换后,浏览器通过 WebRTC 将音频发送至 OpenAI,而无需接收该密钥。
位于 /api/session 之内的 GPT-Live 调用,会根据 SDP offer 创建会话。它在同一请求中传递语音指令、后端模型、网页搜索与保存函数。
result = client.live.create(
    session={
        "model": "gpt-live-1",
        "instructions": LIVE_INSTRUCTIONS,
        "delegation": {
            "type": "responses",
            "responses": {
                "model": "gpt-5.6-sol",
                "instructions": BACKEND_INSTRUCTIONS,
                "tools": [
                    {
                        "type": "web_search",
                        "filters": {
                            "allowed_domains": ["datacamp.com", "www.datacamp.com"]
                        },
                    },
                    SAVE_LEARNING_PLAN_TOOL,
                ],
                "tool_choice": "auto",
            },
        },
    },
    transport={"type": "webrtc", "sdp": sdp},
)
该调用会向 POST /v1/live/sessions 发送请求,并返回会话 ID 与 SDP answer。HTTP 请求即开启会话,因此不要在之后再发送 session.start 事件。
示例服务器仅接受来自 localhost:8501 与 127.0.0.1:8501 的浏览器请求。该规则仅供本地使用。
如果部署应用,请替换这些来源,并对 /api/session 与 /api/save-plan 进行认证。限制会话创建频率,因为每个请求都会花费费用并占用并发。客户端可以自行发送 confirmed: true,因此公共服务器不能将该字段视为请求者身份的证明。
遵循 OpenAI 的 WebRTC 指南,浏览器会请求麦克风访问并打开一个 RTCPeerConnection。使用文档中的 oai-events 数据通道标签,并在生成 SDP offer 之前创建它。会话开始后,该通道双向承载 JSON 事件。
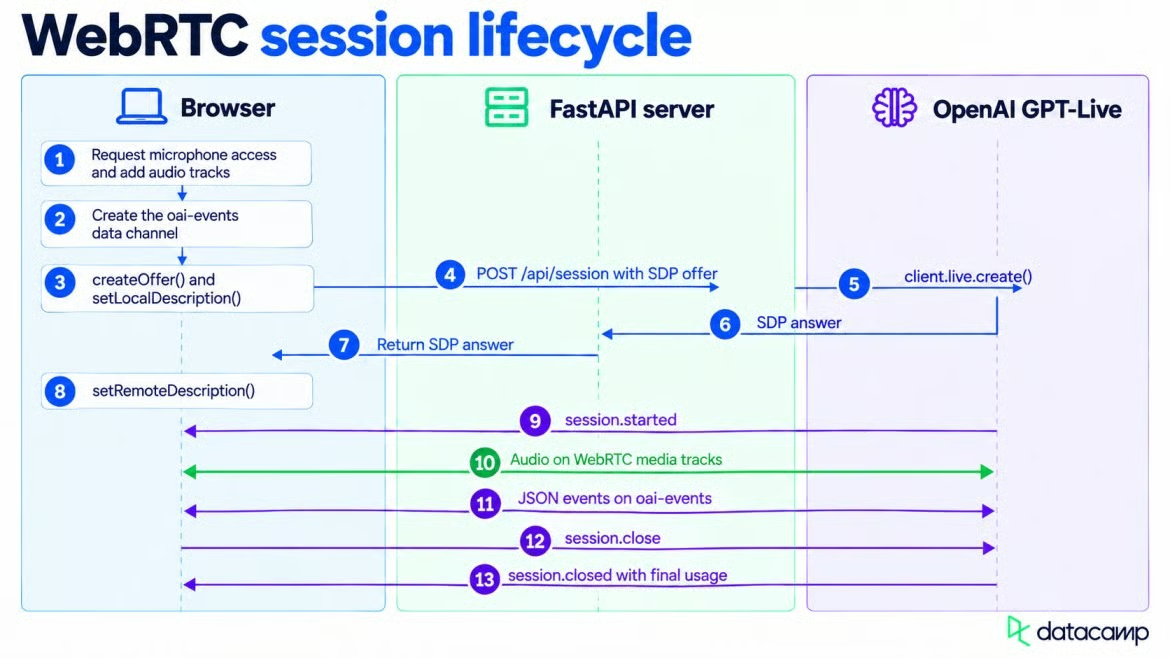
WebRTC 启动、流式传输音频,然后关闭。作者供图。
媒体设置本身属于常规 WebRTC。GPT-Live 事件使用上一行创建的数据通道。
const connection = new RTCPeerConnection();
connection.addEventListener("track", (event) => {
  audio.srcObject = new MediaStream([event.track]);
  audio.play();
});
const microphone = await navigator.mediaDevices.getUserMedia({ audio: true });
for (const track of microphone.getAudioTracks()) {
  connection.addTrack(track, microphone);
}
const events = connection.createDataChannel("oai-events");
创建 offer 后,浏览器调用 setLocalDescription() 并等待 ICE 收集完成。它将本地 SDP 发送至 /api/session,然后使用 setRemoteDescription() 应用 OpenAI 的 answer。麦克风音频与助手语音都在媒体轨道上传输,因此无需额外的 语音转文本与文本转语音 请求。
请勿在 oai-events 上承载音频。不要在 WebRTC 数据通道上发送 session.input_audio.append 或等待 session.output_audio.delta。
数据通道遵循不同的时序规则。请等待 session.started 后再通过 oai-events 发送事件。我的第一次尝试过早发送,连接直接忽略了它。
没有得到有用的错误信息,这让一个小小的顺序问题排查起来颇为恼人。
如果您不需要可见字幕,可以跳过本小节;音频连接已经就绪。
session.input_transcript.delta 与 session.output_transcript.delta 返回带有毫秒偏移的文本片段,用于实时字幕。OpenAI 文档提醒,转写片段不是已完成的轮次。传递可能不均匀,用户与助手的转写区间可能重叠。
将转写片段抵达即附加到屏幕,但不要据此发起后端工作。由模型决定何时进行委托。
Live 模型的说明应尽量简短。OpenAI 指南建议将详细的任务步骤放在后端提示中。我将任务流程放在后端提示里,使 Live 提示专注于语音。
这段摘录将语音行为与学习计划任务分离。语音规则置于触发委托的条件之上。
You are Sage, a warm, encouraging voice learning coach for DataCamp learners.
Speak naturally at an unhurried pace. Be clear and direct, not overly cheerful.

Backchannel policy: Use moderate backchannels without competing with the response.
Interruption policy: Stop speaking when the learner interrupts, and listen.

Delegation policy:
Backend tools:
- learning_plan_research: search DataCamp resources and assemble a personalized learning plan.
- save_learning_plan: propose the current plan for app confirmation when the learner asks to save.

Delegate to the backend when:
- The learner states or changes a goal, skill level, or weekly time.
- A correction changes the plan already requested.
- The learner asks to save the plan.

Do not delegate for greetings, small clarifications, or a result already given.

Saving: a proposed save only asks the app to confirm. Do not say the plan is saved until the app reports a saved result.
After a save, keep the conversation open and ask what the learner wants next.
这些规则让问候语停留在 Live 层面,而把研究或保存请求发往后端。确认权仍属于应用。
“backchannel” 与“打断”两行指示助手如何围绕停顿作出反应。“适度 backchannel”表示偶尔以“嗯哼”等方式确认,但不要填满每一段沉默。我选择这一程度是为了给学习者留出思考空间;若课程停顿更长,可能需要更少的回应。
若您的应用需要不同行为,可修改该行;例如添加“当用户说话时绝不发声”也会去除 backchannel。
两类提示各司其职。Live 提示控制语音与交接,而后端提示控制检索与答案格式。OpenAI 指南不建议将详细搜索步骤置于语音指令中。
前述的拆分体现在会话的 delegation 字段中。当学习者陈述目标时,GPT-Live 会将任务发送给能够搜索课程目录并制定计划的模型。
GPT-Live-1 提供 Responses 委托与客户端委托。Responses 委托由 OpenAI 管理后端调用;客户端委托则交由您的代码处理。本应用使用 Responses 委托,以避免再套一层后端循环。
我使用 gpt-5.6-sol。OpenAI 委托指南以 gpt-5.6-terra 为示例,并列出 gpt-5.6-luna 以应对低成本任务。使用 Sol,后端返回了所需的计划结构。
将 tool_choice 保持为 auto ,便于后端在网页搜索与保存函数之间做出选择。委托模式在启动时固定;如需切换到客户端委托,请关闭当前会话并创建新会话。
Live 提示中的规则很简单:问候与简短问题留给 Live 模型,学习计划或对该计划的更改交给后端。API 不会强制这一边界。请用您的应用将会收到的请求类型进行测试,因为最终由模型自行做出选择。
一旦委托,后端只有一个任务:将学习者的目标转化为带链接的 DataCamp 资源简短清单。我为其提供了 web_search 工具,并将 filters.allowed_domains 设置为 datacamp.com 与 www.datacamp.com。请将该过滤器视为搜索指令,而非每个链接都正确的证明。
示例目标是每周 5 小时,具备部分 Python 基础、但无 SQL 经验的数据工程路径。回复以 How to Learn Data Engineering From Scratch in 2026 与 Associate Data Engineer in SQL 方向开篇。
其余条目包含一个项目、一个 Python 数据库课程、另一个路径,以及最后的流水线项目。所有列出的 URL 都能打开现有的 DataCamp 页面。
后端提示要求输出 4 到 7 个有序条目。每个条目包含标题、URL、简短理由,以及类型 course、project、track 或 article。组合会遵循学习者所述的格式偏好与每周时长。
当页面未标注课程时长时,我没有要求模型去猜测。此类情况下给出精确数字会超出来源可支持的范围。
GPT-Live 可在 Responses 后端工作期间保持语音会话活跃。如果学习者在第一个计划返回前添加了“动手实践”的限制,原先的后端工作不会被自动取消。
口头更正不会自动取消或重写后端已开始的工作。打断助手发声与更改任务是两件事。由应用决定如何处理较早的结果。
服务器跟踪一个 task_version 计数器,并在每次新委托开始时自增。当结果到达时,应用会在执行前检查其版本;处理器会记录旧版本结果但不执行。
Responses 委托在这里有个限制:Live 模型会直接接收后端结果,因此版本检查无法完全控制其下一句口头回复。客户端委托允许您的代码在结果到达模型前丢弃旧结果。因此,任务版本保护的是应用动作,而非助手可能说出的每个字。
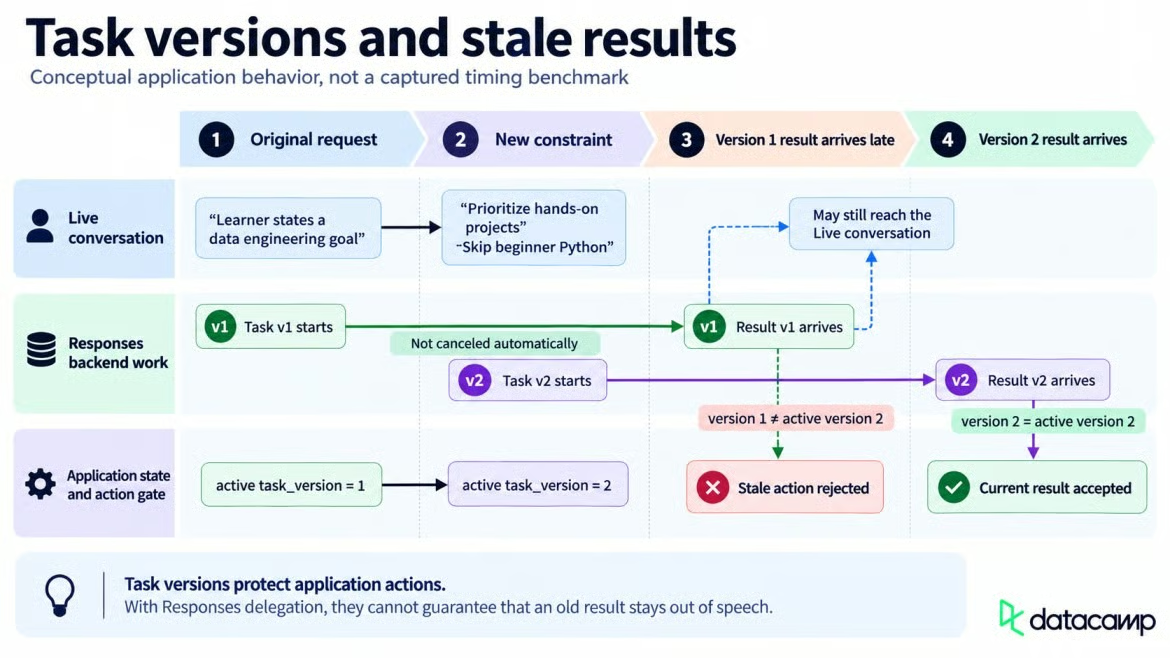
任务版本保持新约束生效。作者供图。
第一轮后端响应完成后,我又补充要求“动手项目,且不要初级 Python”。修订后的 7 项计划以 Introduction to SQL 开头,随后混合了 1 个路径、2 门课程与 4 个项目,包括 Exploring London's Travel Network 与 Building a Retail Data Pipeline。这展示了跨已完成轮次的修订;并不涉及如何停止一条正在进行的响应。
后端工作期间,有三种追加事件可更新 Live 模型: session.thinking.append 添加不应口述的上下文,session.commentary.append 添加应由模型用自己的话说出的文本,session.instructions.append 则可改变其指令。
每次追加传递一段不超过 500 个 token 的纯字符串。这些事件会更新 Live 模型的上下文或行为;并不会修改或取消已在运行中的后端 Responses 任务。指令可以重定向当前的 Live 行为,而评论内容为模型提供应当口述的信息。
仪表板会记录后端进度,但不会发送这些追加事件。使用 Responses 委托时,您的应用仍可通过 oai-events 发送更新,但需要使用 delegation_id: null。非空 delegation ID 用于客户端委托任务。
请将 task_id 与 task_version 保存在应用状态中,而不要将 delegation_id 用于任一者。
在本应用中,模型回复本身不会保存任何内容。后端使用 save_learning_plan 来提出待执行的操作,而 /api/save-plan 负责实际写入。
后端函数调用出现在 response.event 内部。处理器会等待嵌套的 response.output_item.done 项,然后读取其 call_id、name 与 arguments。
等待完成项至关重要,因为更早的事件可能只包含调用的一部分。应用会解析参数,但暂不运行该函数。
SAVE_LEARNING_PLAN_TOOL = {
    "type": "function",
    "name": "save_learning_plan",
    "description": "Propose the current learning plan for confirmation when the learner asks to save.",
    "parameters": {
        "type": "object",
        "properties": {
            "goal": {"type": "string"},
            "weekly_hours": {"type": "number"},
            "items": {
                "type": "array",
                "items": {
                    "type": "object",
                    "properties": {
                        "title": {"type": "string"},
                        "url": {"type": "string"},
                        "reason": {"type": "string"},
                        "type": {
                            "type": "string",
                            "enum": ["course", "project", "track", "article"],
                        },
                    },
                    "required": ["title", "url", "reason", "type"],
                    "additionalProperties": False,
                },
            },
        },
        "required": ["goal", "weekly_hours", "items"],
        "additionalProperties": False,
    },
    "strict": True,
}该模式为应用在询问学习者确认前提供了一组固定字段。type 字段使课程、项目、路径与文章在保存数据中保持明确。
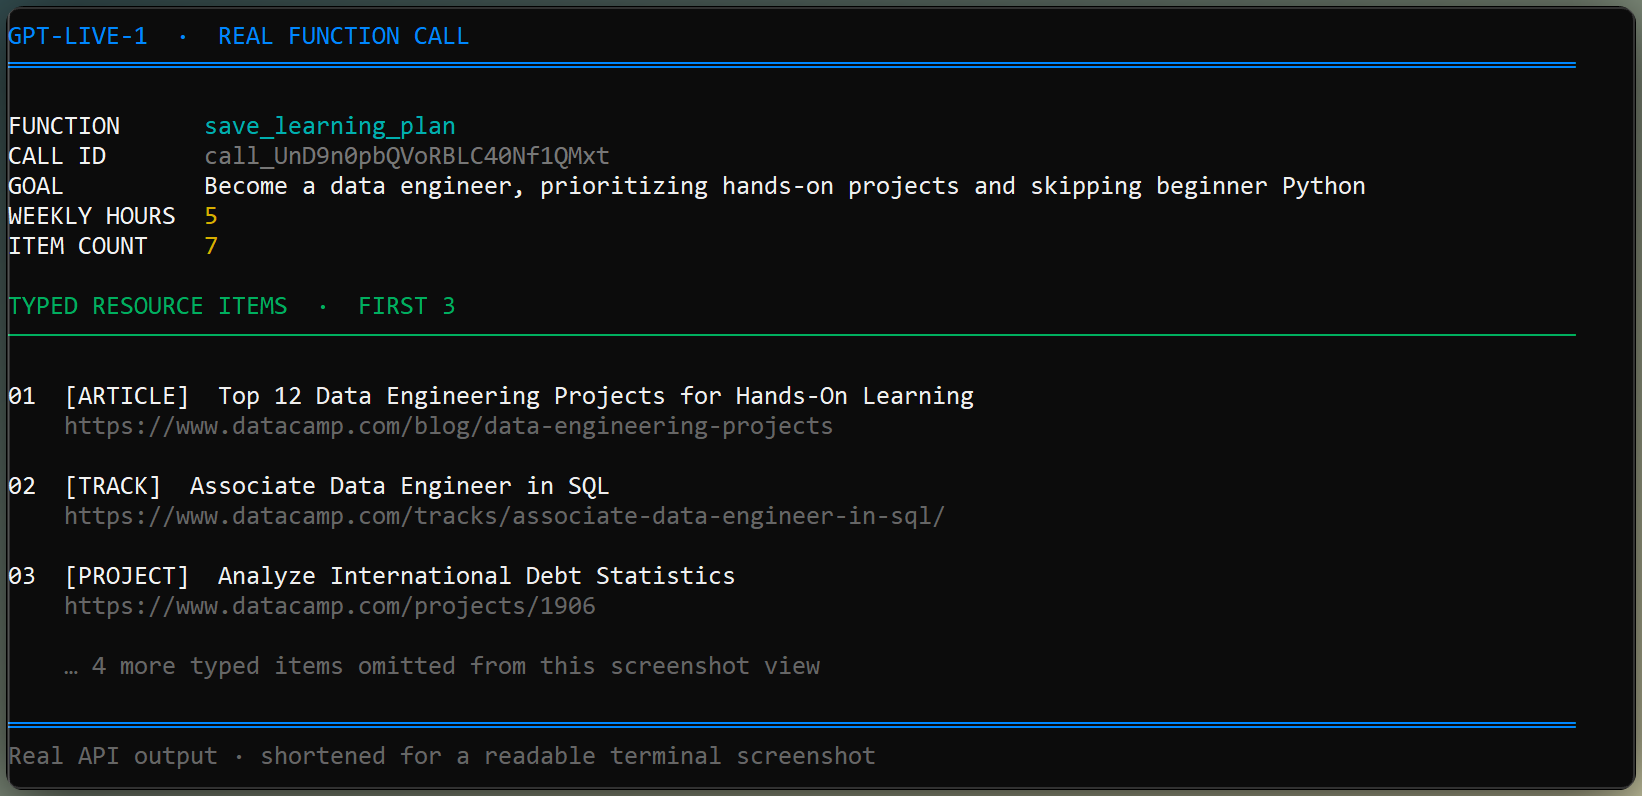
终端显示带类型的保存函数参数。作者供图。
当学习者提出保存请求时,后端会以完整计划调用 save_learning_plan。组件会暂存这些参数并显示确认框,但该调用仍只是一个提议。
若不对该函数调用作出响应,会阻塞当前的委托回复以及后续后端轮次。组件会立即以“等待用户确认”的结果进行答复,然后发送 response.create,以便对话继续进行。
events.send(JSON.stringify({
  type: "response.item.create",
  item: {
    type: "function_call_output",
    call_id: callId,
    output: JSON.stringify({
      status: "awaiting_user_confirmation",
      saved: false,
    }),
  },
}));
events.send(JSON.stringify({ type: "response.create" }));
此时尚未写入任何文件。助手可以引导学习者点击“确认并保存”按钮,同时不阻塞后续委托工作。
/api/save-plan 端点在 confirmed 为 true 之前拒绝写入。由于转写可能有误或不完整,仅凭口头请求不会保存计划。
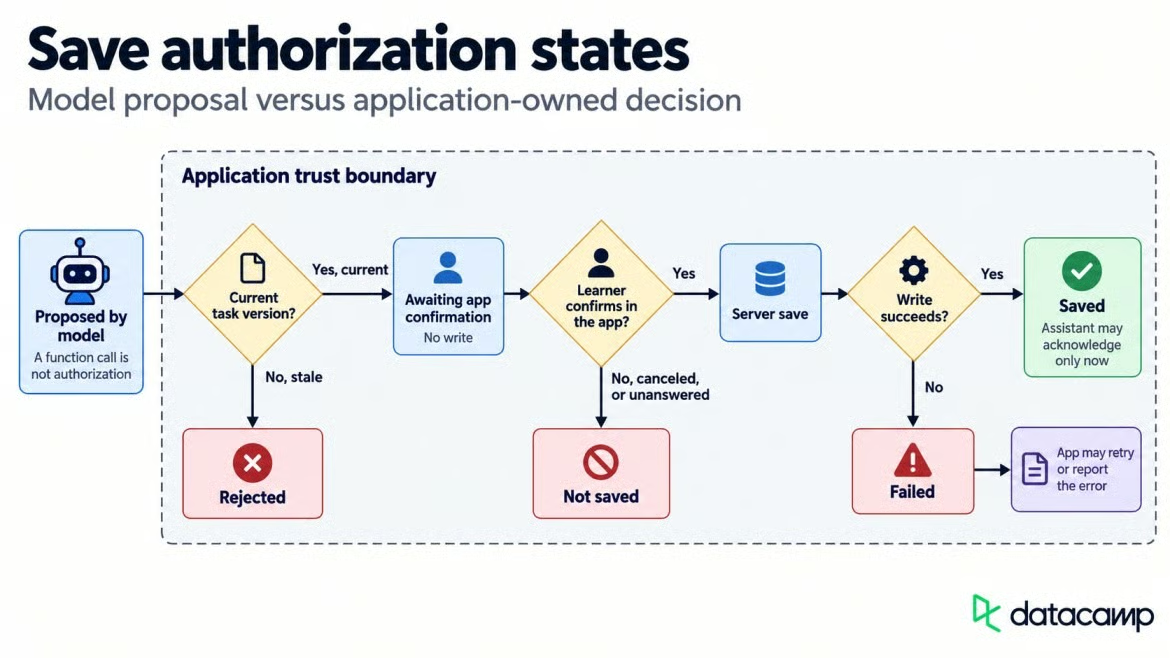
确认将请求与已保存动作区分开来。作者供图。
点击“确认”会向 /api/save-plan 发送待处理计划与 confirmed: true。服务器返回计划 ID 后,组件发送 session.commentary.append 并使用 delegation_id: null ,因为原函数调用已被答复。
const saveResponse = await fetch(${SERVER}/api/save-plan, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    confirmed: true,
    plan: pendingFunctionCall.args,
  }),
});
const saveResult = await saveResponse.json();

events.send(JSON.stringify({
  type: "session.commentary.append",
  delegation_id: null,
  content: The plan was saved as ${saveResult.plan_id}.,
}));
该评论更新会告知 Live 模型写入已完成,并让其口头确认保存。早先的函数调用保持关闭状态,语音会话仍可用于学习者的下一条请求。
前文的 GitHub 仓库包含 FastAPI 服务器、Streamlit 界面与置于 app/ 中的 WebRTC 组件。克隆后,在该文件夹中打开两个终端。在一端运行 uvicorn server:app --host 127.0.0.1 --port 8000,在另一端运行 streamlit run streamlit_app.py 。
Streamlit 界面封装了贯穿整个构建过程所用的同一服务器与组件。它将实时对话与学习计划、后端活动并列展示,同时仪表板在不重置通话的情况下更新。
下方视频演示了口述目标、后端搜索、修订计划与确认保存的流程。保存后通话仍保持开启,学习者可以继续交流。
与 DataCamp 一起学习
Courses
Courses
Courses