
Cours
Comprendre l'ingénierie des prompts
1 h
230.3K
La première fois que j’ai ouvert une session navigateur GPT-Live-1, je m’attendais à la boucle vocale habituelle : parler, attendre, puis écouter la réponse. À la place, le micro est resté ouvert pendant que l’assistant répondait. La conversation paraissait moins rigide, mais l’application devait toujours piloter le travail en arrière-plan.
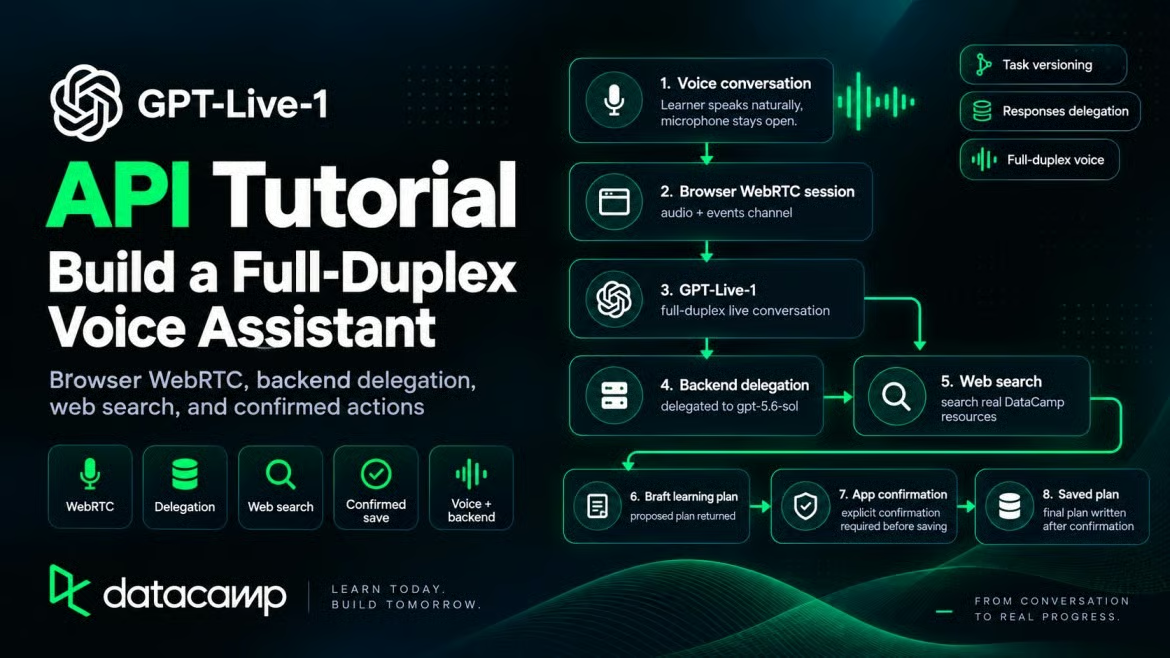
OpenAI a d’abord lancé GPT-Live dans ChatGPT en juillet, puis a porté GPT-Live-1 sur l’API plus tôt cette semaine, juste avant que je ne démarre ce projet. Notre tutoriel GPT-Realtime-2.1 couvre l’approche monomodèle, tandis que notre guide GPT Live Transcribe se concentre sur les sous-titres en direct. Ici, vous allez créer un assistant vocal d’apprentissage qui recherche de vraies ressources DataCamp et n’enregistre un plan qu’après confirmation.
Je l’appelle le DataCamp Voice Learning Assistant. C’est un prototype de tutoriel, pas le DataCamp AI Assistant en production. Le projet suit un apprenant d’un objectif énoncé à l’oral jusqu’à un plan enregistré.
GPT-Live-1 sépare l’échange parlé du travail backend. Quatre constats structurent l’assistant d’apprentissage.
Ces constats s’appliquent à ce flux de création de plan. Un autre prompt ou un autre réseau peut modifier le comportement, et la délégation côté client change la frontière de contrôle.
GPT-Live-1 est le modèle vocal full‑duplex d’OpenAI. Il gère les tours de parole et les interruptions, y compris les silences entre eux, puis délègue les tâches plus longues comme la recherche ou les appels d’outils à un backend.
Pour l’apprenant, la première différence visible se joue dans ces silences.
Le full‑duplex change la prise de parole. Vous pouvez faire une pause pour réfléchir ou couper la parole à l’assistant, et celui‑ci peut s’arrêter pour écouter la correction. Le guide de prompt d’OpenAI montre des sections dédiées aux brefs acquiescements et aux interruptions.
C’est crucial pour un assistant d’apprentissage. En décrivant un objectif de carrière, on peut hésiter, recommencer, ou ajouter une contrainte en cours de route. Un modèle qui laisse passer « eh bien, je pense, peut‑être cinq heures par semaine » permet à l’apprenant de penser à voix haute.
La délégation envoie une tâche au backend, sans pour autant céder le contrôle applicatif. L’app décide encore qui peut agir et si un enregistrement est autorisé. Elle est aussi propriétaire de l’état de la tâche stockée.
Si vous avez utilisé GPT-Realtime-2.1, vous vous demandez peut‑être si GPT-Live-1 le remplace. Non.
GPT-Realtime-2.1 gère l’écoute, le raisonnement et le choix des outils dans un seul modèle via v1/realtime, facturé en jetons audio et texte. GPT-Live-1 utilise v1/live/sessions, facture la couche vocale à la seconde, et envoie le raisonnement à un backend séparé.
Realtime-2.1 n’est ni plus ancien ni inférieur. C’est un autre design.
L’app capte un objectif énoncé à l’oral et le transforme en liste ordonnée de ressources DataCamp réelles. La session vocale reste ouverte pendant le travail backend. Quand la demande change, l’app met à jour la version de tâche avant d’exécuter une action backend.
Rien n’est écrit tant que l’apprenant n’a pas confirmé à nouveau dans l’app.
La page du navigateur maintient la connexion WebRTC et le micro, tandis que le serveur crée la session GPT-Live-1 et conserve la clé API. Un backend Responses (gpt-5.6-sol) utilise la recherche web et la fonction save_learning_plan . La version de tâche en cours et le plan confirmé restent dans l’état applicatif.
La version de tâche détermine quelle action backend l’app accepte quand une demande change au milieu d’une recherche. Servez‑vous du référentiel GitHub pour l’app exécutable complète ; les sections suivantes se concentrent sur le flux GPT-Live.
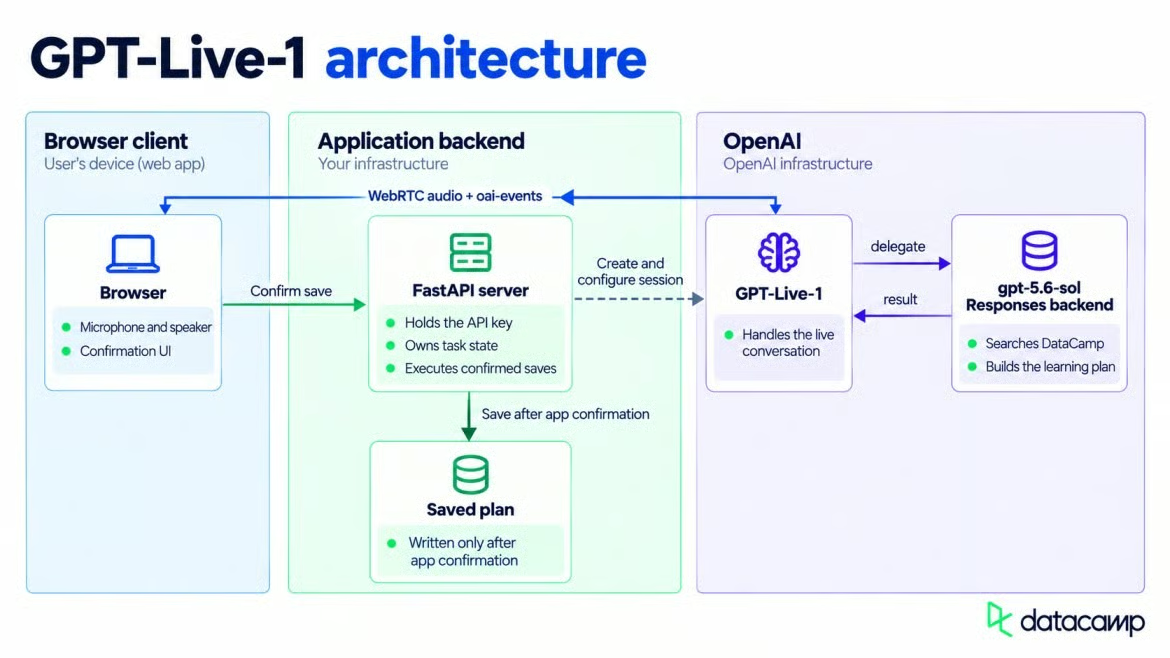
Le navigateur, GPT-Live-1 et le modèle backend se connectent. Image de l’auteur.
Vous avez besoin d’un projet OpenAI avec accès à GPT-Live-1 (l’offre gratuite ne le prend pas en charge), de Python, et d’un navigateur exécuté en HTTPS ou en localhost pour que l’invite micro apparaisse. J’ai utilisé Python 3.11 et openai 3.13.0. L’API Live nécessite au minimum openai 3.12.0 ; les versions plus anciennes n’ont pas l’attribut .live sur le client.
Le plafond de sessions simultanées dépend de votre niveau d’usage. Vérifiez la limite du projet avant d’ouvrir de nombreux onglets.
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install openai fastapi uvicorn python-dotenv streamlit requests
Sur macOS ou Linux, activez l’environnement avec source .venv/bin/activate à la place. Créez un fichier .env à la racine du projet et ajoutez cette valeur.
OPENAI_API_KEY=sk-...python-dotenv charge ce fichier automatiquement dès que le serveur l’importe, ainsi la clé n’apparaît jamais dans le code.
Le client OpenAI() lit la même variable d’environnement si vous ne passez pas de clé.
Le navigateur ne voit jamais la clé de votre projet. Il envoie une offre WebRTC à votre serveur, qui utilise la clé pour créer la session. Après l’échange SDP, le navigateur envoie l’audio à OpenAI via WebRTC sans recevoir cette clé.
L’appel GPT-Live à l’intérieur de /api/session crée la session à partir de l’offre SDP. Il transmet dans la même requête les instructions vocales, le modèle backend, la recherche web et la fonction d’enregistrement.
result = client.live.create(
    session={
        "model": "gpt-live-1",
        "instructions": LIVE_INSTRUCTIONS,
        "delegation": {
            "type": "responses",
            "responses": {
                "model": "gpt-5.6-sol",
                "instructions": BACKEND_INSTRUCTIONS,
                "tools": [
                    {
                        "type": "web_search",
                        "filters": {
                            "allowed_domains": ["datacamp.com", "www.datacamp.com"]
                        },
                    },
                    SAVE_LEARNING_PLAN_TOOL,
                ],
                "tool_choice": "auto",
            },
        },
    },
    transport={"type": "webrtc", "sdp": sdp},
)
Cet appel envoie une requête à POST /v1/live/sessions et renvoie un ID de session avec une réponse SDP. La requête HTTP démarre la session, n’envoyez donc pas ensuite un événement session.start séparé.
Le serveur d’exemple accepte les requêtes du navigateur uniquement depuis localhost:8501 et 127.0.0.1:8501. Cette règle vise un usage local.
Si vous déployez l’app, remplacez ces origines et authentifiez /api/session et /api/save-plan. Limitez le débit de création de sessions, car chaque requête peut coûter et consommer de la concurrence. Un client peut envoyer confirmed: true lui‑même, donc un serveur public ne peut pas considérer ce champ comme une preuve de l’émetteur.
En suivant le guide WebRTC d’OpenAI, le navigateur demande l’accès au micro et ouvre un RTCPeerConnection. Utilisez l’étiquette de data channel documentée oai-events et créez‑la avant de générer l’offre SDP. Ce canal transporte des événements JSON dans les deux sens une fois la session démarrée.
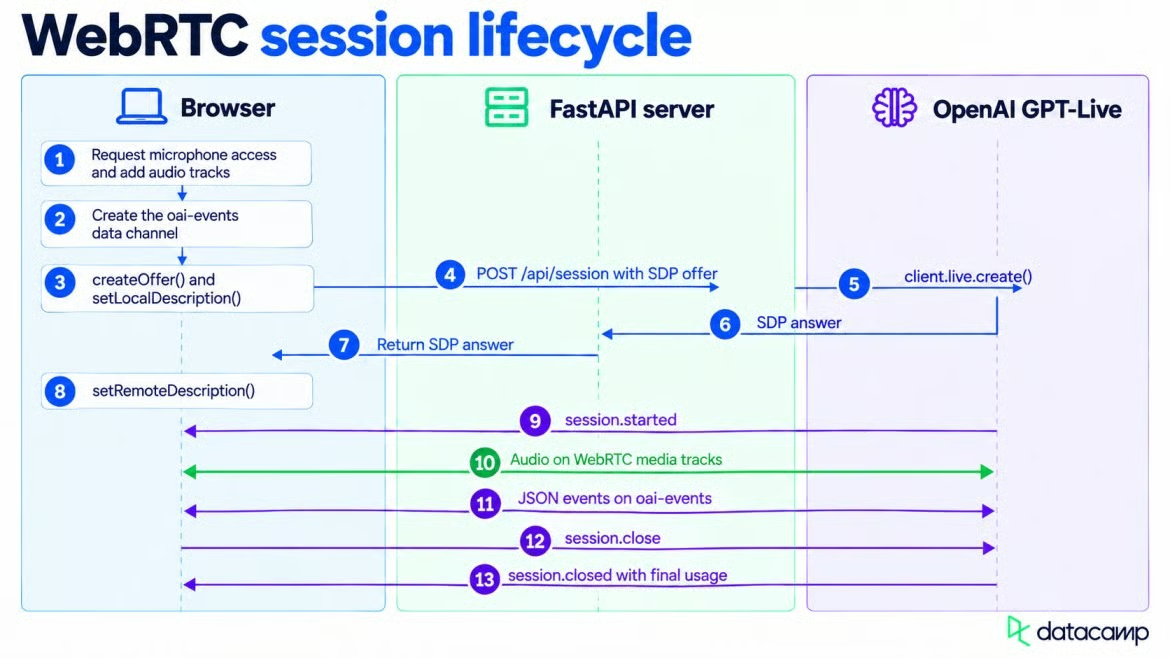
WebRTC démarre, diffuse l’audio, puis se ferme. Image de l’auteur.
La configuration média elle‑même est du WebRTC classique. Les événements GPT-Live utilisent le data channel créé à la dernière ligne.
const connection = new RTCPeerConnection();
connection.addEventListener("track", (event) => {
  audio.srcObject = new MediaStream([event.track]);
  audio.play();
});
const microphone = await navigator.mediaDevices.getUserMedia({ audio: true });
for (const track of microphone.getAudioTracks()) {
  connection.addTrack(track, microphone);
}
const events = connection.createDataChannel("oai-events");
Après avoir créé l’offre, le navigateur appelle setLocalDescription() et attend la fin de la collecte ICE. Il envoie le SDP local à /api/session, puis applique la réponse d’OpenAI avec setRemoteDescription(). L’audio du micro et la voix de l’assistant circulent sur les pistes média ; il n’y a donc pas besoin de requêtes speech‑to‑text et text‑to‑speech séparées.
L’audio n’a pas sa place sur oai-events. N’envoyez pas session.input_audio.append et n’attendez pas session.output_audio.delta sur un data channel WebRTC.
Le data channel suit une autre règle de synchronisation. Attendez session.started avant d’envoyer un événement via oai-events. Lors de mon premier essai, j’en ai envoyé un trop tôt et la connexion l’a ignoré.
Je n’ai reçu aucune erreur utile, ce qui a rendu agaçante la traque de ce petit problème d’ordre.
Si vous n’avez pas besoin de sous‑titres visibles, vous pouvez passer cette sous‑section ; la connexion audio est déjà en place.
session.input_transcript.delta et session.output_transcript.delta renvoient des fragments de texte avec des offsets en millisecondes pour des sous‑titres en direct. La documentation d’OpenAI avertit que ces fragments ne constituent pas des tours aboutis. La livraison peut être irrégulière et les intervalles utilisateur/assistant se chevaucher.
Ajoutez les fragments à l’écran au fil de l’eau, mais ne lancez pas de travail backend à partir d’eux. Le modèle décide quand déléguer.
Les instructions du modèle Live doivent rester concises. Le guide d’OpenAI place les étapes détaillées dans le prompt backend. J’y ai gardé la procédure de tâche et limité le prompt Live à la gestion de la parole.
Cet extrait isole le comportement vocal de la tâche de plan d’apprentissage. Les règles de parole restent au‑dessus des conditions qui déclenchent la délégation.
You are Sage, a warm, encouraging voice learning coach for DataCamp learners.
Speak naturally at an unhurried pace. Be clear and direct, not overly cheerful.

Backchannel policy: Use moderate backchannels without competing with the response.
Interruption policy: Stop speaking when the learner interrupts, and listen.

Delegation policy:
Backend tools:
- learning_plan_research: search DataCamp resources and assemble a personalized learning plan.
- save_learning_plan: propose the current plan for app confirmation when the learner asks to save.

Delegate to the backend when:
- The learner states or changes a goal, skill level, or weekly time.
- A correction changes the plan already requested.
- The learner asks to save the plan.

Do not delegate for greetings, small clarifications, or a result already given.

Saving: a proposed save only asks the app to confirm. Do not say the plan is saved until the app reports a saved result.
After a save, keep the conversation open and ask what the learner wants next.
Ces règles laissent les salutations au niveau Live et envoient la recherche ou l’enregistrement au backend. La confirmation reste du ressort de l’app.
Les lignes sur l’« acquiescement » et l’interruption indiquent à l’assistant comment réagir autour des silences. « Acquiescements modérés » signifie des signes d’écoute occasionnels comme « mm‑hmm » sans combler tous les vides. J’ai choisi ce niveau pour laisser à l’apprenant l’espace de réfléchir ; une leçon avec des pauses plus longues peut demander moins d’acquiescements.
Modifiez cette ligne si votre app exige un autre comportement ; ajouter « ne parlez jamais pendant que l’utilisateur parle » supprime aussi les acquiescements.
Les deux prompts ont des rôles différents. Le prompt Live contrôle la parole et la remise, tandis que le prompt backend gère la recherche et le format de réponse. Le guide d’OpenAI déconseille d’insérer des étapes de recherche détaillées dans les consignes vocales.
La séparation décrite plus haut apparaît dans le champ delegation de la session. Quand l’apprenant énonce un objectif, GPT-Live envoie la tâche à un modèle capable de chercher dans notre catalogue et de composer le plan.
GPT-Live-1 propose la délégation Responses et la délégation côté client. La délégation Responses laisse OpenAI gérer l’appel backend, tandis que la délégation client la confie à votre code. J’ai choisi Responses pour éviter une autre boucle backend dans cette app.
J’ai utilisé gpt-5.6-sol. Le guide de délégation d’OpenAI utilise gpt-5.6-terra comme exemple de départ et cite gpt-5.6-luna pour des tâches moins coûteuses. Avec Sol, le backend a renvoyé la structure de plan attendue.
Laissez tool_choice sur auto pour que le backend choisisse la recherche web ou la fonction d’enregistrement. Le mode de délégation est fixé au démarrage ; passez en délégation client en fermant la session en cours et en en créant une autre.
La règle dans le prompt Live est simple : salutations et petites clarifications restent avec le modèle Live, tandis qu’un plan d’apprentissage ou une modification de ce plan part au backend. Rien dans l’API n’impose cette frontière. Testez‑la avec les requêtes typiques de votre app, car le modèle choisit de lui‑même.
Une fois délégué, le backend a une mission : transformer l’objectif de l’apprenant en courte liste de ressources DataCamp avec liens. Je lui ai fourni l’outil web_search avec filters.allowed_domains réglé sur datacamp.com et www.datacamp.com. Considérez ce filtre comme une instruction de recherche, pas une preuve que chaque lien est correct.
L’objectif d’exemple demande un parcours d’ingénierie des données à 5 heures par semaine, avec quelques notions de Python et aucune expérience SQL. La réponse commence par How to Learn Data Engineering From Scratch in 2026 et le parcours Associate Data Engineer in SQL.
Les autres éléments mêlent un projet, un cours Python sur les bases de données, un autre parcours et un projet final de pipeline. Chaque URL listée renvoie vers une page DataCamp existante.
Le prompt backend demande de quatre à sept éléments ordonnés. Chaque élément a un titre, une URL, une brève raison et un type course, project, track ou article. Le mélange respecte les préférences de format et le temps hebdomadaire indiqué.
Je n’ai pas demandé au modèle d’estimer une durée de cours quand la page ne l’indiquait pas. Dans ce cas, un chiffre exact affirmerait plus que la source ne le permet.
GPT-Live peut garder la session vocale active pendant que le backend Responses opère. Si l’apprenant ajoute la contrainte « pratique » avant le premier plan, le travail backend initial n’est pas annulé automatiquement.
Une correction orale n’annule ni ne réécrit automatiquement un travail déjà lancé côté backend. Couper la parole de l’assistant et changer la tâche sont deux actions distinctes. L’application décide du sort de l’ancien résultat.
Le serveur suit un compteur task_version et l’incrémente à chaque nouvelle délégation. Quand un résultat arrive, l’app vérifie sa version avant d’agir ; son propre gestionnaire journalise un ancien résultat et ne l’exécute pas.
La délégation Responses a ici une limite : le modèle Live reçoit directement le résultat backend, donc le contrôle par version ne peut pas entièrement maîtriser la prochaine réponse orale. La délégation client permet à votre code d’écarter un ancien résultat avant qu’il n’atteigne le modèle. La version de tâche protège donc les actions de l’app, pas nécessairement chaque mot prononcé par l’assistant.
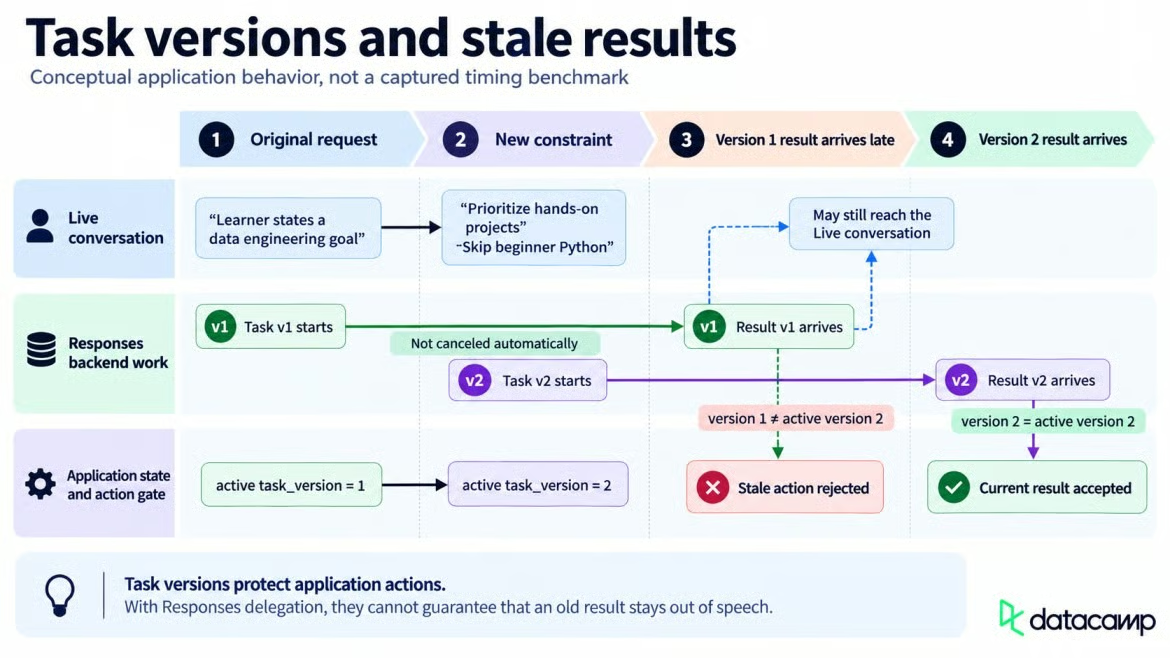
Les versions de tâche maintiennent les nouvelles contraintes actives. Image de l’auteur.
Après la première réponse backend, j’ai envoyé un complément demandant des projets pratiques et pas de Python débutant. Le plan révisé en sept éléments commençait par Introduction to SQL, puis mêlait un parcours, deux cours et quatre projets, dont Exploring London's Travel Network et Building a Retail Data Pipeline. Cela illustre une révision sur tours achevés ; sans dire quoi que ce soit de l’arrêt d’une réponse en cours.
Pendant le travail backend, trois événements d’« append » peuvent mettre à jour le modèle Live : session.thinking.append ajoute du contexte non destiné à être dit, session.commentary.append ajoute un texte que le modèle exprimera avec ses mots, et session.instructions.append change ses instructions.
Chaque ajout transporte une simple chaîne, jusqu’à 500 tokens. Ces événements mettent à jour le contexte ou le comportement du modèle Live ; ils ne modifient ni n’annulent une tâche Responses déjà en cours. Une instruction peut réorienter le comportement Live actuel, tandis que le commentaire fournit une information à communiquer à voix haute.
Le tableau de bord enregistre la progression backend mais n’envoie pas ces ajouts. Avec la délégation Responses, les mises à jour depuis votre app peuvent encore transiter par oai-events, mais avec delegation_id: null. Les IDs non nuls servent aux tâches déléguées côté client.
Conservez task_id et task_version dans l’état applicatif plutôt que d’utiliser delegation_id pour l’un ou l’autre.
Dans cette app, une réponse du modèle ne sauvegarde rien à elle seule. Le backend utilise save_learning_plan pour proposer l’action en attente, tandis que /api/save-plan détient l’écriture effective.
Les appels de fonction backend arrivent dans response.event. Le gestionnaire attend un élément imbriqué response.output_item.done, puis lit son call_id, name et arguments.
Attendre l’élément complété est important, car les événements précédents peuvent ne contenir qu’une partie de l’appel. L’app analyse les arguments mais n’exécute pas encore la fonction.
SAVE_LEARNING_PLAN_TOOL = {
    "type": "function",
    "name": "save_learning_plan",
    "description": "Propose the current learning plan for confirmation when the learner asks to save.",
    "parameters": {
        "type": "object",
        "properties": {
            "goal": {"type": "string"},
            "weekly_hours": {"type": "number"},
            "items": {
                "type": "array",
                "items": {
                    "type": "object",
                    "properties": {
                        "title": {"type": "string"},
                        "url": {"type": "string"},
                        "reason": {"type": "string"},
                        "type": {
                            "type": "string",
                            "enum": ["course", "project", "track", "article"],
                        },
                    },
                    "required": ["title", "url", "reason", "type"],
                    "additionalProperties": False,
                },
            },
        },
        "required": ["goal", "weekly_hours", "items"],
        "additionalProperties": False,
    },
    "strict": True,
}
Le schéma donne à l’app un ensemble de champs fixes à afficher avant de demander la confirmation à l’apprenant. Le champ type conserve explicitement cours, projets, parcours et articles dans les données enregistrées.
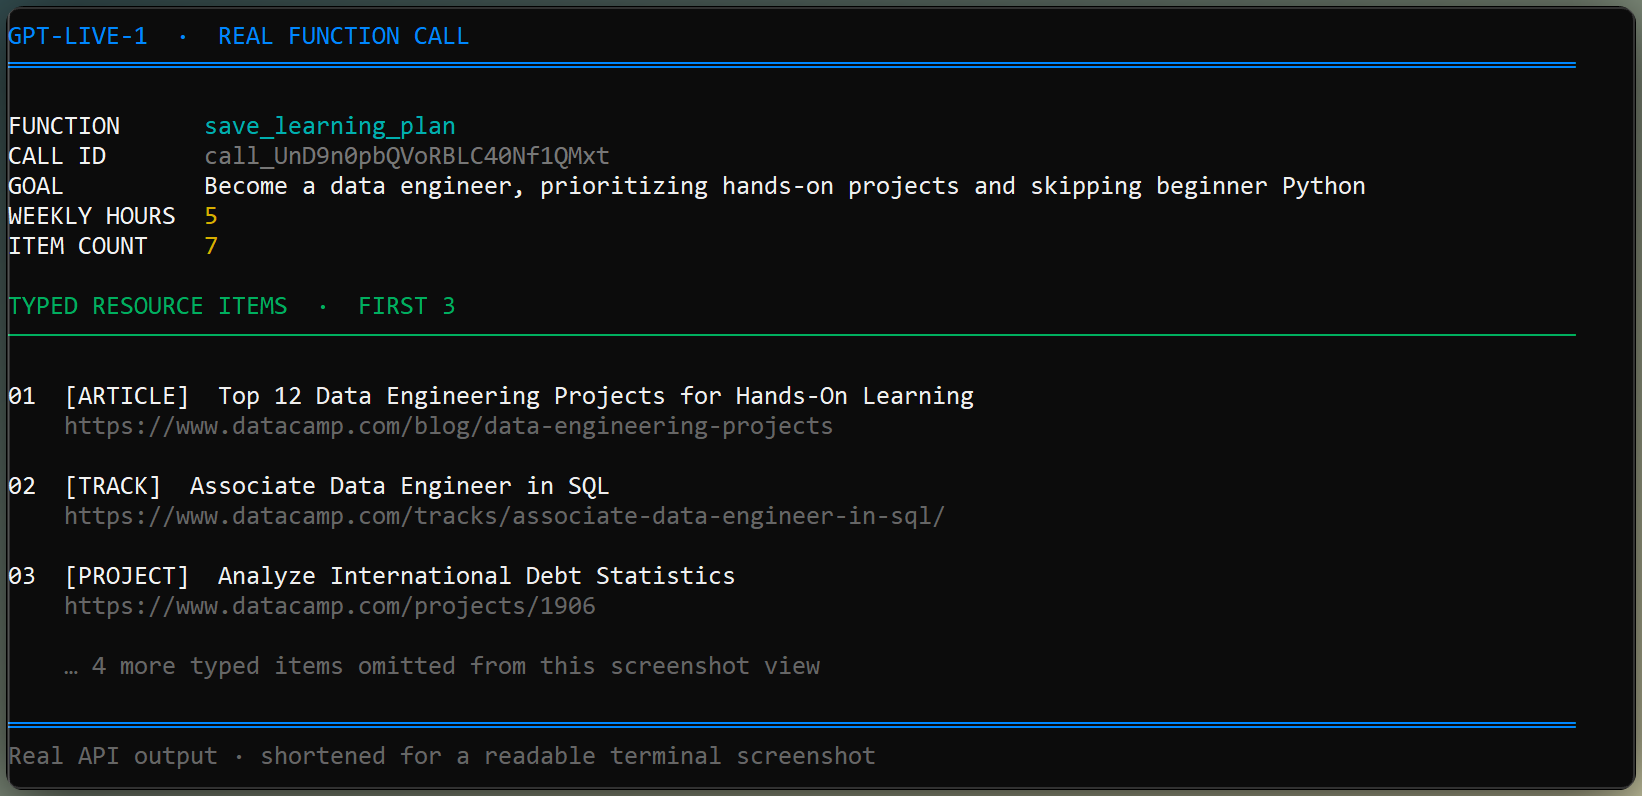
Le terminal montre des arguments typés pour la fonction d’enregistrement. Image de l’auteur.
Quand l’apprenant demande l’enregistrement, le backend appelle save_learning_plan avec le plan complet. Le widget stocke ces arguments et affiche la boîte de confirmation, mais l’appel reste une proposition.
Laisser cet appel sans réponse bloquerait la réponse déléguée et les tours backend suivants. Le widget y répond immédiatement avec un résultat « en attente de confirmation », puis envoie response.create pour poursuivre la conversation.
events.send(JSON.stringify({
  type: "response.item.create",
  item: {
    type: "function_call_output",
    call_id: callId,
    output: JSON.stringify({
      status: "awaiting_user_confirmation",
      saved: false,
    }),
  },
}));
events.send(JSON.stringify({ type: "response.create" }));
Aucun fichier n’est écrit à ce stade. L’assistant peut orienter l’apprenant vers le bouton Confirmer et enregistrer sans bloquer les travaux délégués ultérieurs.
Le point de terminaison /api/save-plan refuse d’écrire sauf si confirmed vaut true. Comme une transcription peut être erronée ou incomplète, la seule demande parlée n’enregistre pas le plan.
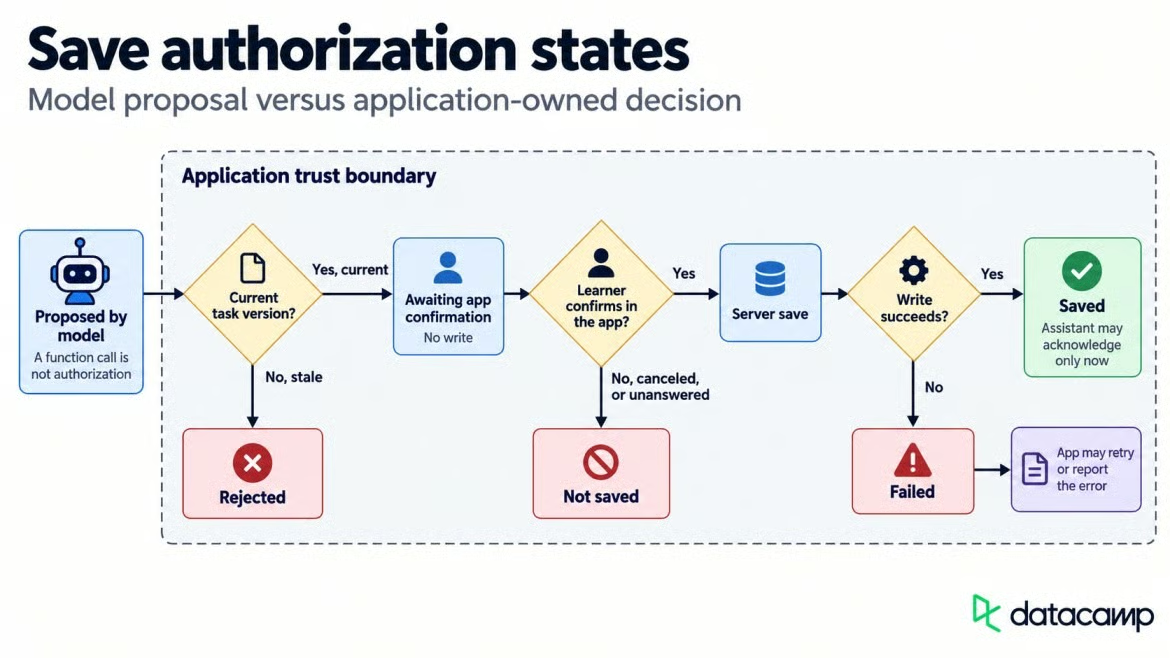
La confirmation distingue les demandes des actions enregistrées. Image de l’auteur.
Le clic sur Confirmer envoie à /api/save-plan le plan en attente avec confirmed: true. Après le retour d’un ID de plan par le serveur, le widget envoie session.commentary.append avec delegation_id: null car l’appel de fonction initial était déjà répondu.
const saveResponse = await fetch(${SERVER}/api/save-plan, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    confirmed: true,
    plan: pendingFunctionCall.args,
  }),
});
const saveResult = await saveResponse.json();

events.send(JSON.stringify({
  type: "session.commentary.append",
  delegation_id: null,
  content: The plan was saved as ${saveResult.plan_id}.,
}));
La mise à jour « commentary » informe le modèle Live de l’écriture réalisée et lui permet d’accuser réception à voix haute. L’ancien appel de fonction reste fermé, et la session vocale demeure disponible pour la prochaine demande de l’apprenant.
Le référentiel GitHub mentionné plus haut contient le serveur FastAPI, l’interface Streamlit et le widget WebRTC dans app/. Après clonage, ouvrez deux terminaux dans ce dossier. Lancez uvicorn server:app --host 127.0.0.1 --port 8000 dans l’un, puis streamlit run streamlit_app.py dans l’autre.
L’interface Streamlit encapsule le même serveur et widget utilisés tout au long du build. Elle place la conversation en direct à côté du plan d’apprentissage et de l’activité backend, tandis que le tableau de bord se met à jour sans réinitialiser l’appel.
La vidéo ci‑dessous suit l’objectif énoncé, la recherche backend, le plan révisé et l’enregistrement confirmé. L’appel reste ouvert après l’enregistrement pour que l’apprenant poursuive.
Learn with DataCamp
Cours
Cours
Cours