course
Înțelegerea Prompt Engineering
1 oră
230.3K
Prima dată când am deschis o sesiune în browser GPT-Live-1, mă așteptam la bucla vocală obișnuită: vorbești, aștepți, apoi auzi un răspuns. În schimb, microfonul a rămas deschis în timp ce asistentul răspundea. Conversația părea mai puțin rigidă, dar aplicația tot trebuia să gestioneze munca din spate.
OpenAI a introdus inițial GPT-Live în ChatGPT în iulie, apoi a adus GPT-Live-1 în API la începutul acestei săptămâni, chiar înainte să încep acest build. Tutorialul nostru GPT-Realtime-2.1 acoperă abordarea cu un singur model, iar ghidul GPT Live Transcribe se concentrează pe subtitrări live. Aici, vei construi un asistent vocal pentru învățare care caută resurse reale DataCamp și salvează un plan doar după confirmare.
Îi spun Asistentul Vocal DataCamp pentru Învățare. Este un prototip de tutorial, nu Asistentul AI DataCamp de producție. Proiectul urmărește un cursant de la un obiectiv rostit până la un plan salvat.
GPT-Live-1 separă schimbul vorbit de munca backend. Patru constatări modelează asistentul de învățare.
Aceste constatări se aplică acestui flux de creare a unui plan de învățare. Un alt prompt sau o altă rețea poate schimba comportamentul, iar delegarea pe client schimbă limita de control.
GPT-Live-1 este modelul vocal full-duplex al OpenAI. Gestionează turele vorbite și întreruperile, inclusiv pauzele dintre ele, apoi trimite lucrări mai lungi, cum ar fi căutarea sau apelurile de tool-uri, către un backend.
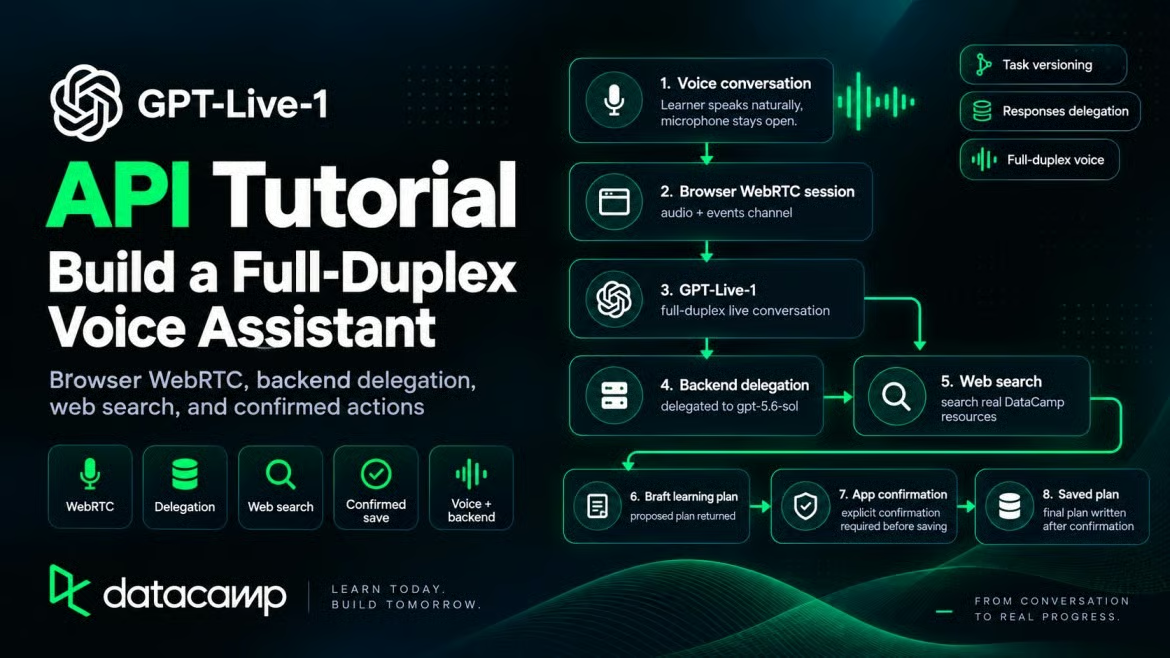
Pentru cursant, prima diferență vizibilă este în acele pauze.
Full duplex schimbă preluarea turelor. Poți face pauze ca să te gândești sau poți vorbi peste asistent, iar acesta se poate opri ca să audă corecția. Ghidul de prompting al OpenAI arată secțiuni de prompt pentru confirmări scurte și întreruperi.
Acest lucru contează într-un asistent de învățare. O persoană care descrie un obiectiv de carieră poate face pauze, poate relua sau poate adăuga o limitare la jumătatea drumului. Un model care așteaptă prin „păi, cred, poate cinci ore pe săptămână” îi permite cursantului să gândească cu voce tare.
Delegarea mută o sarcină în backend, dar nu predă controlul aplicației. Aplicația tot decide cine poate acționa și dacă este permisă o salvare. Deține, de asemenea, starea de task stocată.
Dacă ai folosit GPT-Realtime-2.1, te poți întreba dacă GPT-Live-1 îl înlocuiește. Nu îl înlocuiește.
GPT-Realtime-2.1 gestionează ascultarea, raționarea și selecția tool-urilor într-un singur model prin v1/realtime, taxat pe jetoane audio și text. GPT-Live-1 folosește v1/live/sessions, taxează stratul vocal pe secundă și trimite raționarea către un backend separat.
Realtime-2.1 nu este o opțiune mai veche sau inferioară. Folosește un design diferit.
Aplicația ia un obiectiv rostit și îl transformă într-o listă ordonată de resurse DataCamp reale. Sesiunea vocală rămâne deschisă în timpul muncii din backend. Când cererea se schimbă, aplicația își actualizează versiunea task-ului înainte de a executa o acțiune în backend.
Nimic nu este scris până când cursantul nu confirmă din nou în aplicație.
Pagina din browser deține conexiunea WebRTC și microfonul, în timp ce serverul creează sesiunea GPT-Live-1 și păstrează cheia API. Un backend Responses (gpt-5.6-sol) folosește căutarea web și funcția save_learning_plan . Versiunea curentă a task-ului și planul confirmat rămân în starea aplicației.
Versiunea task-ului decide ce acțiune de backend acceptă aplicația când o cerere se schimbă în timpul unei căutări. Folosește repository-ul de pe GitHub pentru aplicația completă care poate rula; următoarele secțiuni se concentrează pe traseul GPT-Live al acesteia.
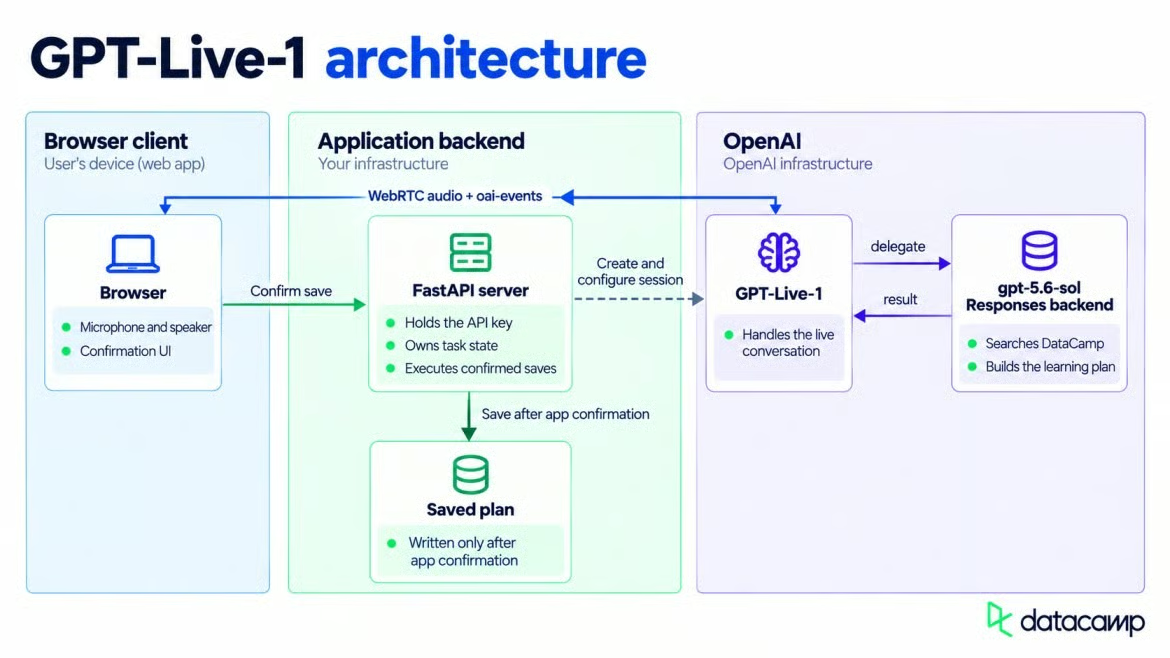
Browserul, GPT-Live-1 și modelul backend se conectează. Imagine de Autor.
Ai nevoie de un proiect OpenAI cu acces la GPT-Live-1 (nivelul gratuit nu îl suportă), Python și un browser care rulează pe HTTPS sau localhost pentru ca promptul de microfon să poată apărea. Am folosit Python 3.11 și openai 3.13.0. Live API are nevoie de cel puțin openai 3.12.0; versiunile mai vechi nu au atributul .live pe client.
Limitele pentru sesiuni concurente depind de nivelul tău de utilizare. Verifică limita proiectului înainte de a deschide multe tab-uri în browser.
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install openai fastapi uvicorn python-dotenv streamlit requests
Pe macOS sau Linux, activează mediul cu source .venv/bin/activate în schimb. Creează un fișier .env la rădăcina proiectului și adaugă această valoare.
OPENAI_API_KEY=sk-...python-dotenv încarcă acel fișier automat odată ce serverul îl importă, astfel că cheia nu trebuie să apară niciodată în cod.
Clientul OpenAI() citește aceeași variabilă de mediu când nu transmiți o cheie.
Browserul nu vede niciodată cheia proiectului tău. Trimite o ofertă WebRTC către serverul tău, care folosește cheia pentru a crea sesiunea. După schimbul SDP, browserul trimite audio către OpenAI prin WebRTC fără a primi acea cheie.
Apelul GPT-Live din interiorul /api/session creează sesiunea din oferta SDP. Transmite instrucțiunile vocale, modelul backend, căutarea web și funcția de salvare în același request.
result = client.live.create(
    session={
        "model": "gpt-live-1",
        "instructions": LIVE_INSTRUCTIONS,
        "delegation": {
            "type": "responses",
            "responses": {
                "model": "gpt-5.6-sol",
                "instructions": BACKEND_INSTRUCTIONS,
                "tools": [
                    {
                        "type": "web_search",
                        "filters": {
                            "allowed_domains": ["datacamp.com", "www.datacamp.com"]
                        },
                    },
                    SAVE_LEARNING_PLAN_TOOL,
                ],
                "tool_choice": "auto",
            },
        },
    },
    transport={"type": "webrtc", "sdp": sdp},
)
Acest apel trimite o cerere către POST /v1/live/sessions și returnează un ID de sesiune cu un răspuns SDP. Cererea HTTP pornește sesiunea, deci nu trimite un eveniment separat session.start după aceea.
Serverul de exemplu acceptă cereri din browser doar de la localhost:8501 și 127.0.0.1:8501. Acea regulă este pentru uz local.
Dacă distribui aplicația, înlocuiește acele origini și autentifică atât /api/session, cât și /api/save-plan. Limitează rata de creare a sesiunilor deoarece fiecare cerere poate cheltui bani și consuma concurență. Un client poate trimite confirmed: true singur, deci un server public nu poate trata acel câmp ca dovadă a cui a făcut cererea.
Urmând ghidul WebRTC al OpenAI, browserul cere acces la microfon și deschide un RTCPeerConnection. Folosește eticheta documentată oai-events a canalului de date și creeaz-o înainte de a genera oferta SDP. Acel canal transportă evenimente JSON în ambele direcții odată ce sesiunea pornește.
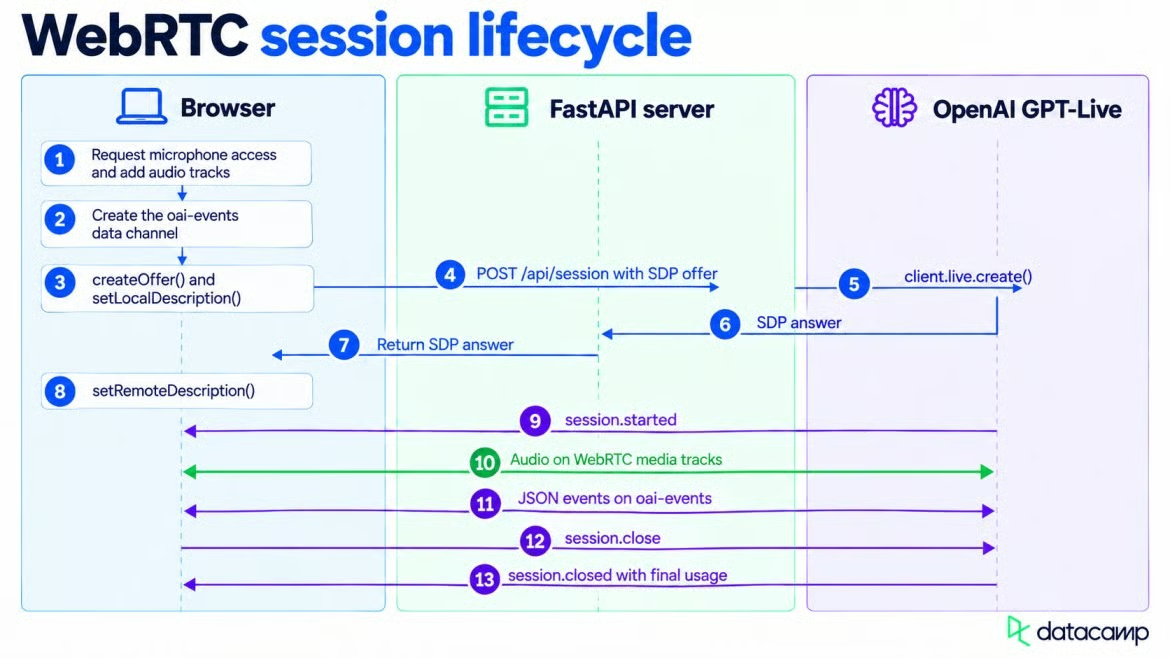
WebRTC pornește, transmite audio, apoi se închide. Imagine de Autor.
Setarea media în sine este WebRTC obișnuit. Evenimentele GPT-Live folosesc canalul de date creat în ultima linie.
const connection = new RTCPeerConnection();
connection.addEventListener("track", (event) => {
  audio.srcObject = new MediaStream([event.track]);
  audio.play();
});
const microphone = await navigator.mediaDevices.getUserMedia({ audio: true });
for (const track of microphone.getAudioTracks()) {
  connection.addTrack(track, microphone);
}
const events = connection.createDataChannel("oai-events");
După crearea ofertei, browserul apelează setLocalDescription() și așteaptă finalizarea strângerii ICE. Trimite SDP-ul local către /api/session, apoi aplică răspunsul OpenAI cu setRemoteDescription(). Audio de la microfon și vorbirea asistentului circulă pe pistele media, astfel că nu sunt necesare cereri separate de speech-to-text și text-to-speech.
Audio nu are ce căuta pe oai-events. Nu trimite session.input_audio.append și nu aștepta session.output_audio.delta pe un canal de date WebRTC.
Canalul de date urmează o regulă de temporizare diferită. Așteaptă session.started înainte de a trimite un eveniment prin oai-events. La prima mea încercare, am trimis unul prea devreme și conexiunea l-a ignorat.
Nu am primit o eroare utilă, ceea ce a făcut ca o mică greșeală de ordonare să fie enervant de depistat.
Dacă nu ai nevoie de subtitrări vizibile, poți să sari peste această subsecțiune; conexiunea audio este deja completă.
session.input_transcript.delta și session.output_transcript.delta returnează fragmente de text cu offset-uri în milisecunde pentru subtitrări live. Documentația OpenAI avertizează că fragmentele de transcript nu sunt ture încheiate. Livrarea poate fi neuniformă, iar intervalele transcriptului utilizatorului și ale asistentului se pot suprapune.
Adaugă fragmentele de transcript pe ecran pe măsură ce sosesc, dar nu porni munca din backend de la ele. Modelul decide când să delege.
Instrucțiunile modelului Live ar trebui să fie scurte. Ghidul OpenAI pune pașii detaliați ai sarcinii în promptul backend. Am păstrat procedura de task acolo și am lăsat promptul Live concentrat pe vorbire.
Acest extras păstrează comportamentul vocal separat de task-ul planului de învățare. Regulile de vorbire rămân deasupra condițiilor care declanșează delegarea.
You are Sage, a warm, encouraging voice learning coach for DataCamp learners.
Speak naturally at an unhurried pace. Be clear and direct, not overly cheerful.

Backchannel policy: Use moderate backchannels without competing with the response.
Interruption policy: Stop speaking when the learner interrupts, and listen.

Delegation policy:
Backend tools:
- learning_plan_research: search DataCamp resources and assemble a personalized learning plan.
- save_learning_plan: propose the current plan for app confirmation when the learner asks to save.

Delegate to the backend when:
- The learner states or changes a goal, skill level, or weekly time.
- A correction changes the plan already requested.
- The learner asks to save the plan.

Do not delegate for greetings, small clarifications, or a result already given.

Saving: a proposed save only asks the app to confirm. Do not say the plan is saved until the app reports a saved result.
After a save, keep the conversation open and ask what the learner wants next.
Aceste reguli lasă saluturile în stratul Live și trimit cercetarea sau cererile de salvare către backend. Confirmarea rămâne tot în aplicație.
Liniile despre backchannel și întreruperi îi spun asistentului cum să răspundă în jurul pauzelor. „Backchannel-uri moderate” solicită confirmări ocazionale precum „mhm” fără a umple fiecare liniște. Am ales acest nivel pentru a-i lăsa cursantului spațiu să gândească; o lecție cu pauze mai lungi poate avea nevoie de mai puține confirmări.
Schimbă acea linie dacă aplicația ta are nevoie de alt comportament; adăugarea „nu vorbi niciodată când utilizatorul vorbește” elimină, de asemenea, backchannel-urile.
Cele două prompturi au joburi diferite. Promptul Live controlează vorbirea și predarea, în timp ce promptul backend controlează cercetarea și formatul răspunsului. Ghidul OpenAI sfătuiește să nu pui pași de căutare detaliați în instrucțiunile vocale.
Separarea descrisă mai devreme apare în câmpul delegation al sesiunii. Când cursantul declară un obiectiv, GPT-Live trimite task-ul către un model care poate căuta în catalogul nostru de cursuri și poate face planul.
GPT-Live-1 oferă delegare Responses și delegare pe client. Delegarea Responses lasă OpenAI să gestioneze apelul backend, în timp ce delegarea pe client îl predă codului tău. Am folosit delegarea Responses pentru că evită o altă buclă backend în această aplicație.
Am folosit gpt-5.6-sol. Ghidul de delegare al OpenAI folosește gpt-5.6-terra ca exemplu de pornire și listează gpt-5.6-luna pentru task-uri cu cost redus. Cu Sol, backend-ul a returnat structura de plan cerută.
Păstrează tool_choice setat la auto astfel încât backend-ul să poată alege căutarea web sau funcția de salvare. Modul de delegare este fixat la pornire; treci la delegarea pe client închizând sesiunea curentă și creând alta.
Regula din promptul Live este simplă: saluturile și întrebările scurte rămân la modelul Live, în timp ce un plan de învățare sau o schimbare a acelui plan merge la backend. Nimic din API nu impune acea limită. Testeaz-o cu tipurile de cereri pe care le va primi aplicația ta deoarece modelul face singur alegerea.
Odată delegat, backend-ul are o singură sarcină: să transforme obiectivul cursantului într-o listă scurtă de resurse DataCamp cu linkuri. I-am dat tool-ul web_search cu filters.allowed_domains setat la datacamp.com și www.datacamp.com. Tratează acel filtru ca pe o instrucțiune de căutare, nu ca pe o dovadă că fiecare link este corect.
Obiectivul de exemplu cere o cale de data engineering cu 5 ore pe săptămână, ceva cunoștințe de Python și fără experiență în SQL. Răspunsul începe cu How to Learn Data Engineering From Scratch in 2026 și track-ul Associate Data Engineer in SQL.
Elementele rămase amestecă un proiect, un curs de baze de date în Python, un alt track și un proiect final de pipeline. Fiecare URL listat deschide o pagină DataCamp existentă.
Promptul backend cere patru până la șapte elemente ordonate. Fiecare element are un titlu, URL, motiv scurt și un tip course, project, track sau article. Mixul urmează preferința de format declarată de cursant și timpul săptămânal.
Nu am cerut modelului să ghicească durata unui curs când pagina nu o specifica. Un număr exact în acel caz ar afirma mai mult decât susține sursa.
GPT-Live poate menține sesiunea vocală activă în timp ce backend-ul Responses lucrează. Dacă cursantul adaugă constrângerea hands-on înainte să revină primul plan, munca inițială din backend nu este anulată automat.
O corecție vorbită nu anulează automat sau nu rescrie munca pe care backend-ul a început-o deja. Întreruperea vorbirii asistentului și schimbarea task-ului sunt acțiuni separate. Aplicația decide ce se întâmplă cu rezultatul mai vechi.
Serverul urmărește un contor task_version și îl incrementează ori de câte ori începe o nouă delegare. Când sosește un rezultat, aplicația îi verifică versiunea înainte de a acționa; propriul handler înregistrează un rezultat vechi și nu îl execută.
Delegarea Responses are o limită aici: modelul Live primește rezultatul backend direct, astfel că verificarea versiunii nu poate controla complet următorul său răspuns vorbit. Delegarea pe client îți permite să arunci un rezultat vechi înainte să ajungă la model. Versiunea task-ului, așadar, protejează acțiunile aplicației, nu fiecare cuvânt pe care îl poate spune asistentul.
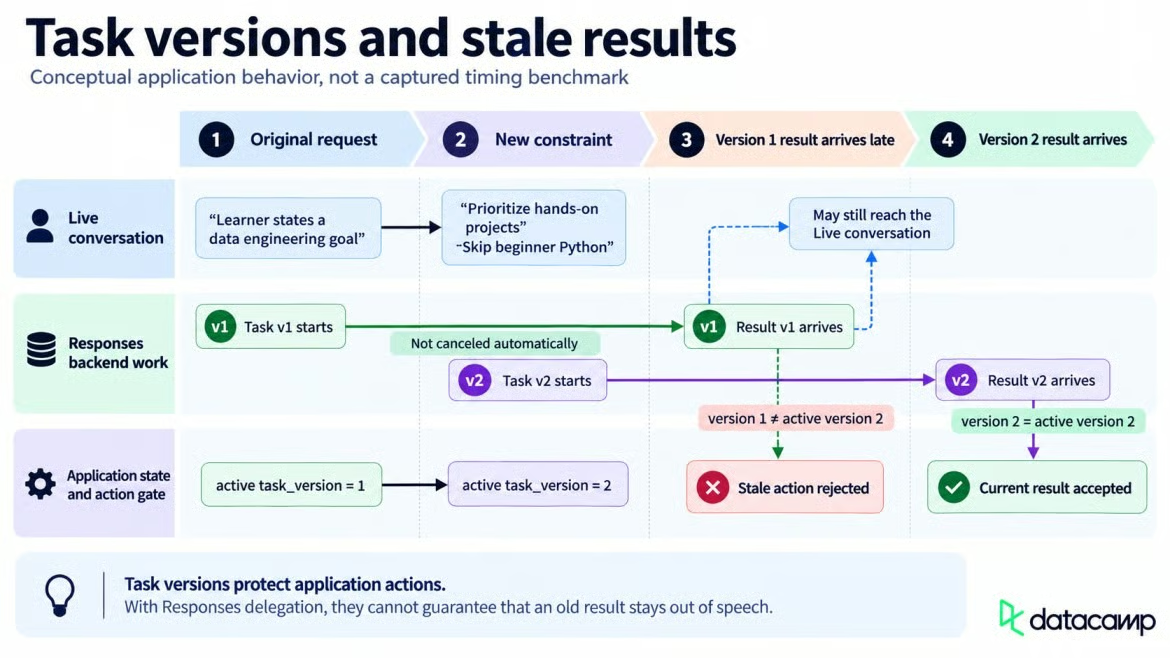
Versiunile de task mențin active noile constrângeri. Imagine de Autor.
După ce primul răspuns din backend s-a încheiat, am trimis o continuare cerând proiecte practice și fără Python pentru începători. Planul revizuit cu șapte elemente a început cu Introduction to SQL, apoi a amestecat un track, două cursuri și patru proiecte, inclusiv Exploring London's Travel Network și Building a Retail Data Pipeline. Asta arată revizuirea peste ture încheiate; nu spune nimic despre oprirea unui răspuns activ.
În timpul muncii din backend, trei evenimente de tip append pot actualiza modelul Live. session.thinking.append adaugă context care nu ar trebui rostit, session.commentary.append adaugă text pe care modelul să îl spună în propriile cuvinte, iar session.instructions.append îi schimbă instrucțiunile.
Fiecare append transportă un string simplu de maximum 500 de tokeni. Aceste evenimente actualizează contextul sau comportamentul modelului Live; nu modifică și nu anulează un task Responses din backend care rulează deja. O instrucțiune poate redirecționa comportamentul Live curent, în timp ce commentary furnizează informații pe care modelul ar trebui să le comunice cu voce tare.
Dashboard-ul înregistrează progresul backend-ului, dar nu trimite aceste evenimente append. Cu delegarea Responses, actualizările din aplicația ta pot fi în continuare trimise prin oai-events, dar folosesc delegation_id: null. ID-urile de delegare nenule sunt folosite pentru task-urile delegate pe client.
Păstrează task_id și task_version în starea aplicației, mai degrabă decât să folosești delegation_id pentru oricare dintre ele.
În această aplicație, un răspuns al modelului nu salvează nimic de unul singur. Backend-ul folosește save_learning_plan pentru a propune acțiunea în așteptare, în timp ce /api/save-plan deține scrierea efectivă.
Apelurile de funcții din backend sosesc în interiorul response.event. Handlerul așteaptă un element imbricat response.output_item.done, apoi îi citește call_id, name și arguments.
Așteptarea elementului finalizat contează deoarece evenimentele anterioare pot conține doar o parte din apel. Aplicația parsează argumentele, dar încă nu rulează funcția.
SAVE_LEARNING_PLAN_TOOL = {
    "type": "function",
    "name": "save_learning_plan",
    "description": "Propose the current learning plan for confirmation when the learner asks to save.",
    "parameters": {
        "type": "object",
        "properties": {
            "goal": {"type": "string"},
            "weekly_hours": {"type": "number"},
            "items": {
                "type": "array",
                "items": {
                    "type": "object",
                    "properties": {
                        "title": {"type": "string"},
                        "url": {"type": "string"},
                        "reason": {"type": "string"},
                        "type": {
                            "type": "string",
                            "enum": ["course", "project", "track", "article"],
                        },
                    },
                    "required": ["title", "url", "reason", "type"],
                    "additionalProperties": False,
                },
            },
        },
        "required": ["goal", "weekly_hours", "items"],
        "additionalProperties": False,
    },
    "strict": True,
}
Schema oferă aplicației un set fix de câmpuri de afișat înainte de a cere cursantului confirmarea. Câmpul type păstrează explicit în datele salvate course, project, track și article.
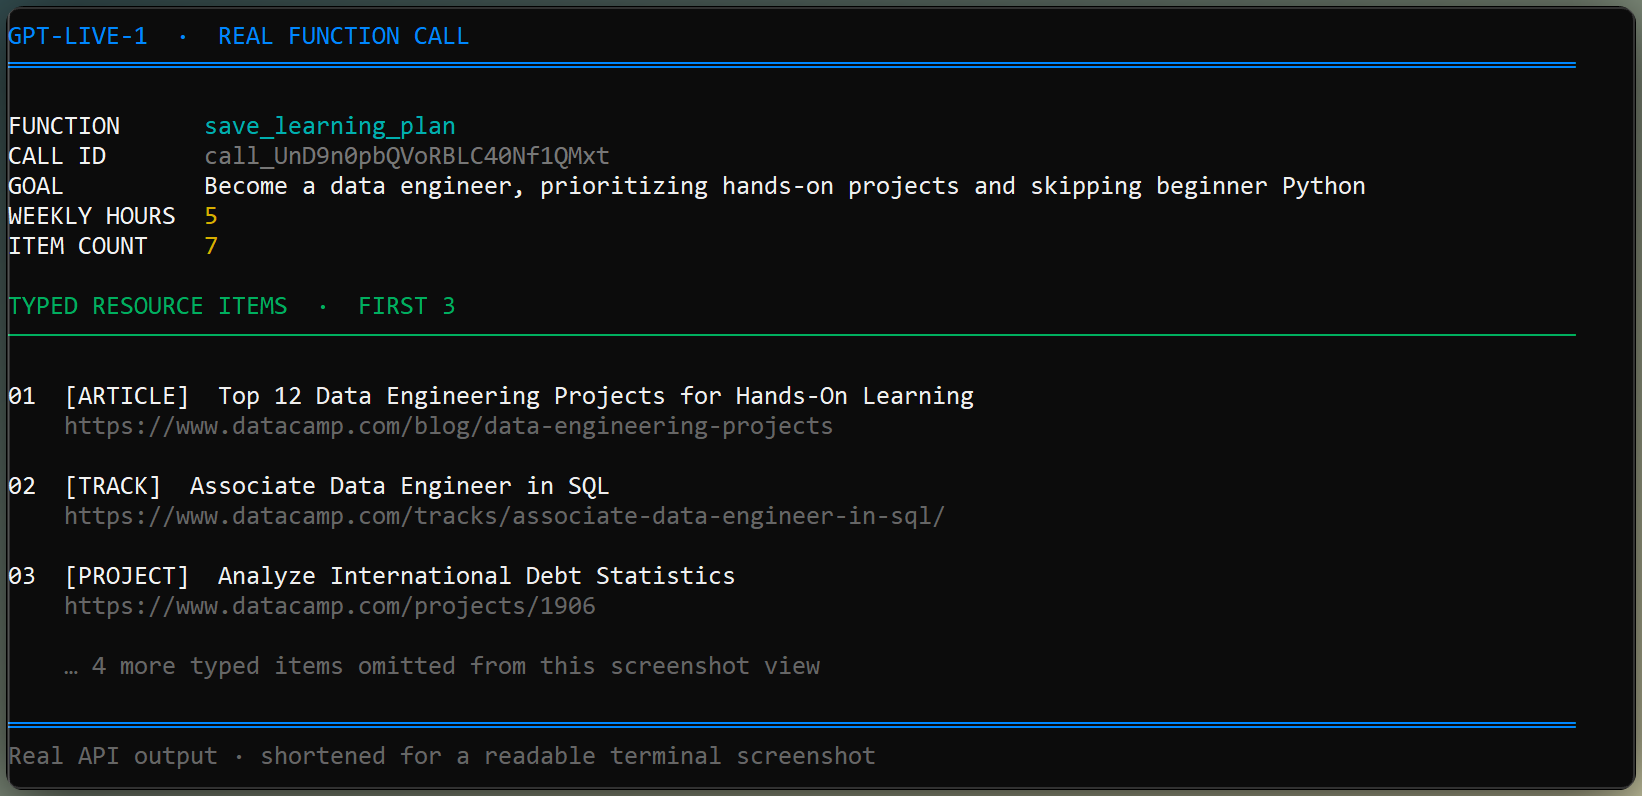
Terminalul arată argumente tipizate pentru funcția de salvare. Imagine de Autor.
Când cursantul cere să salveze, backend-ul apelează save_learning_plan cu planul complet. Widgetul stochează acele argumente și afișează caseta de confirmare, dar apelul este încă doar o propunere.
Lăsarea acelui apel de funcție fără răspuns ar bloca răspunsul delegat și turele backend ulterioare. Widgetul îl răspunde imediat cu un rezultat în așteptarea confirmării, apoi trimite response.create astfel încât conversația să poată continua.
events.send(JSON.stringify({
  type: "response.item.create",
  item: {
    type: "function_call_output",
    call_id: callId,
    output: JSON.stringify({
      status: "awaiting_user_confirmation",
      saved: false,
    }),
  },
}));
events.send(JSON.stringify({ type: "response.create" }));
Nu se scrie niciun fișier în acest punct. Asistentul îl poate ghida pe cursant către butonul Confirmă și salvează fără a bloca munca delegată ulterioară.
Endpointul /api/save-plan refuză scrierea dacă confirmed nu este true. Deoarece transcriptul poate fi greșit sau incomplet, cererea vorbită singură nu salvează planul.
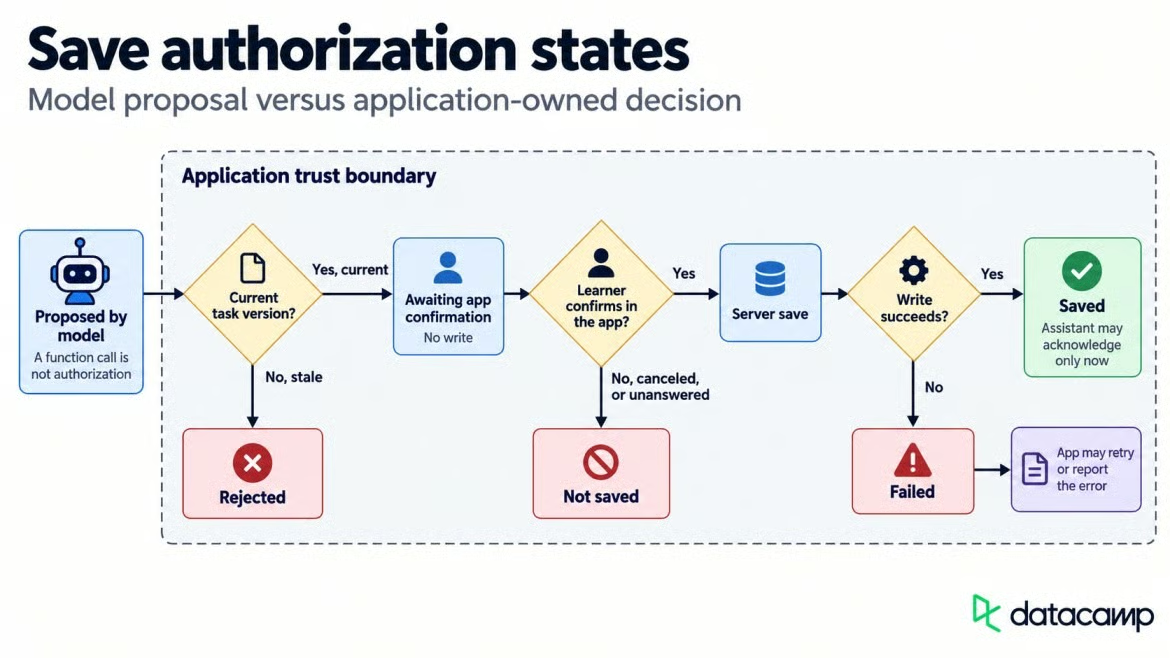
Confirmarea separă cererile de acțiunile salvate. Imagine de Autor.
Clickul pe Confirmă trimite către /api/save-plan planul în așteptare și confirmed: true. După ce serverul returnează un ID de plan, widgetul trimite session.commentary.append cu delegation_id: null deoarece apelul de funcție inițial a fost deja răspuns.
const saveResponse = await fetch(${SERVER}/api/save-plan, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    confirmed: true,
    plan: pendingFunctionCall.args,
  }),
});
const saveResult = await saveResponse.json();

events.send(JSON.stringify({
  type: "session.commentary.append",
  delegation_id: null,
  content: The plan was saved as ${saveResult.plan_id}.,
}));
Actualizarea de tip commentary îi spune modelului Live despre scrierea încheiată și îl lasă să confirme salvarea cu voce tare. Apelul de funcție anterior rămâne închis, iar sesiunea vocală rămâne disponibilă pentru următoarea cerere a cursantului.
Repository-ul GitHub menționat mai devreme conține serverul FastAPI, interfața Streamlit și widgetul WebRTC în app/. După clonare, deschide două terminale în acel folder. Rulează uvicorn server:app --host 127.0.0.1 --port 8000 în unul și streamlit run streamlit_app.py în celălalt.
Interfața Streamlit învelește același server și widget folosite pe tot parcursul build-ului. Așază conversația live lângă planul de învățare și activitatea backend, în timp ce dashboard-ul se actualizează fără a reseta apelul.
Videoul de mai jos urmărește obiectivul rostit, căutarea backend, planul revizuit și salvarea confirmată. Apelul rămâne deschis după salvare pentru ca cursantul să poată continua.
Învăță cu DataCamp
course
course
course