course
Prompt Engineering को समझना
1 घंटा
230.3K
जब मैंने पहली बार GPT-Live-1 ब्राउज़र सत्र खोला, तो मुझे सामान्य वॉइस लूप की उम्मीद थी: बोलना, इंतज़ार करना, फिर जवाब सुनना। इसके बजाय, सहायक के जवाब देते समय माइक्रोफ़ोन खुला रहा। बातचीत कम कठोर लगी, लेकिन ऐप को अब भी पृष्ठभूमि में हो रहे काम का प्रबंधन करना था।
OpenAI ने पहले जुलाई में ChatGPT में GPT-Live पेश किया, फिर इसी हफ्ते API में GPT-Live-1 लाया, ठीक उसी समय जब मैंने यह बिल्ड शुरू किया। हमारा GPT-Realtime-2.1 ट्यूटोरियल वन-मॉडल अप्रोच को कवर करता है, जबकि हमारा GPT Live Transcribe गाइड लाइव कैप्शंस पर केंद्रित है। यहां, आप एक वॉइस लर्निंग असिस्टेंट बनाएंगे जो वास्तविक DataCamp संसाधनों की खोज करता है और केवल पुष्टि के बाद ही योजना सहेजता है।
मैं इसे DataCamp Voice Learning Assistant कहता/कहती हूं। यह एक ट्यूटोरियल प्रोटोटाइप है, प्रोडक्शन वाला DataCamp AI Assistant नहीं। यह प्रोजेक्ट एक सीखने वाले को बोले गए लक्ष्य से सहेजी गई योजना तक ले जाता है।
GPT-Live-1 बोले गए आदान-प्रदान को बैकएंड कार्य से अलग करता है। चार निष्कर्ष लर्निंग असिस्टेंट को आकार देते हैं।
ये निष्कर्ष इस लर्निंग-प्लान फ़्लो पर लागू होते हैं। अलग प्रॉम्प्ट या नेटवर्क व्यवहार बदल सकता है, और क्लाइंट डेलिगेशन नियंत्रण सीमा बदल देता है।
GPT-Live-1 OpenAI का फुल-डुप्लेक्स वॉइस मॉडल है। यह बोले गए टर्न और व्यवधानों को संभालता है, उनके बीच के विरामों सहित, और फिर खोज या टूल कॉल जैसे लंबे काम को बैकएंड को भेजता है।
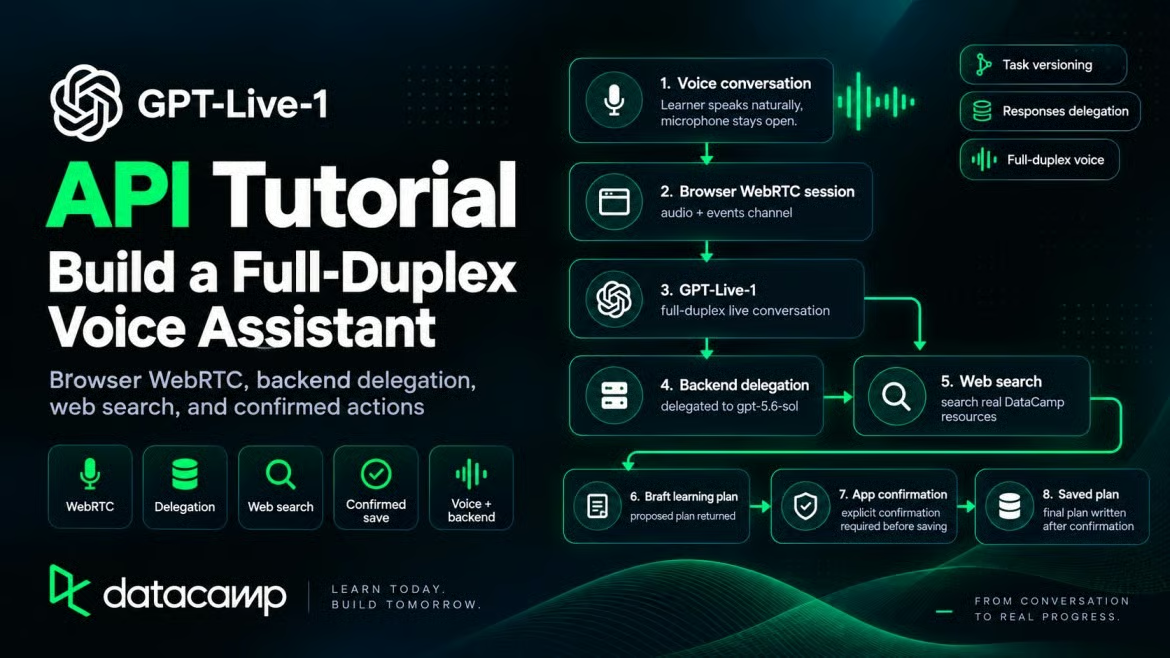
सीखने वाले के लिए, पहला दिखाई देने वाला फर्क इन्हीं विरामों में है।
फुल डुप्लेक्स टर्न-टेकिंग बदल देता है। आप सोचने के लिए रुक सकते हैं या सहायक के ऊपर बोल सकते हैं, और वह सुधार सुनने के लिए रुक सकता है। OpenAI की प्रॉम्प्टिंग गाइड छोटे अनुमोदनों और व्यवधानों के लिए प्रॉम्प्ट सेक्शन दिखाती है।
लर्निंग असिस्टेंट में यह मायने रखता है। करियर लक्ष्य बताने वाला व्यक्ति रुक सकता है, दोबारा शुरू कर सकता है, या बीच में कोई सीमा जोड़ सकता है। जो मॉडल "ठीक है, मेरा ख्याल है, शायद हफ्ते में पांच घंटे" जैसे वाक्यों के दौरान इंतज़ार करता है, वह सीखने वाले को जोर से सोचने देता है।
डेलिगेशन किसी कार्य को बैकएंड पर ले जाता है, लेकिन यह एप्लिकेशन का नियंत्रण नहीं सौंपता। ऐप अब भी तय करता है कि कौन कार्रवाई कर सकता है और सहेजना अनुमत है या नहीं। संग्रहीत टास्क स्टेट भी ऐप का ही होता है।
यदि आपने GPT-Realtime-2.1 का उपयोग किया है, तो आप सोच सकते हैं कि क्या GPT-Live-1 उसे बदल देता है। ऐसा नहीं है।
GPT-Realtime-2.1 सुनना, तर्क करना और टूल चयन एक ही मॉडल में v1/realtime पर संभालता है, जिसका बिल ऑडियो और टेक्स्ट टोकन्स से होता है। GPT-Live-1 v1/live/sessions का उपयोग करता है, वॉइस लेयर का बिल प्रति सेकंड लेता है, और तर्क को अलग बैकएंड पर भेजता है।
Realtime-2.1 पुराना या कमतर विकल्प नहीं है। उसका डिज़ाइन अलग है।
ऐप एक बोले गए लक्ष्य को लेता है और उसे वास्तविक DataCamp संसाधनों की क्रमबद्ध सूची में बदल देता है। बैकएंड कार्य के दौरान वॉइस सत्र खुला रहता है। जब अनुरोध बदलता है, ऐप बैकएंड कार्रवाई निष्पादित करने से पहले अपना टास्क वर्ज़न अपडेट करता है।
जब तक सीखने वाला ऐप में फिर से पुष्टि नहीं करता, तब तक कुछ भी लिखा नहीं जाता।
ब्राउज़र पेज WebRTC कनेक्शन और माइक्रोफ़ोन रखता है, जबकि सर्वर GPT-Live-1 सत्र बनाता है और API कुंजी अपने पास रखता है। एक Responses बैकएंड (gpt-5.6-sol) वेब सर्च और save_learning_plan फ़ंक्शन का उपयोग करता है। मौजूदा टास्क वर्ज़न और पुष्टि की गई योजना ऐप स्टेट में रहती हैं।
टास्क वर्ज़न तय करता है कि खोज के दौरान अनुरोध बदलने पर ऐप कौन-सी बैकएंड कार्रवाई स्वीकार करेगा। पूर्ण रन योग्य ऐप के लिए GitHub रिपॉज़िटरी का उपयोग करें; अगला भाग इसके GPT-Live पथ पर केंद्रित है।
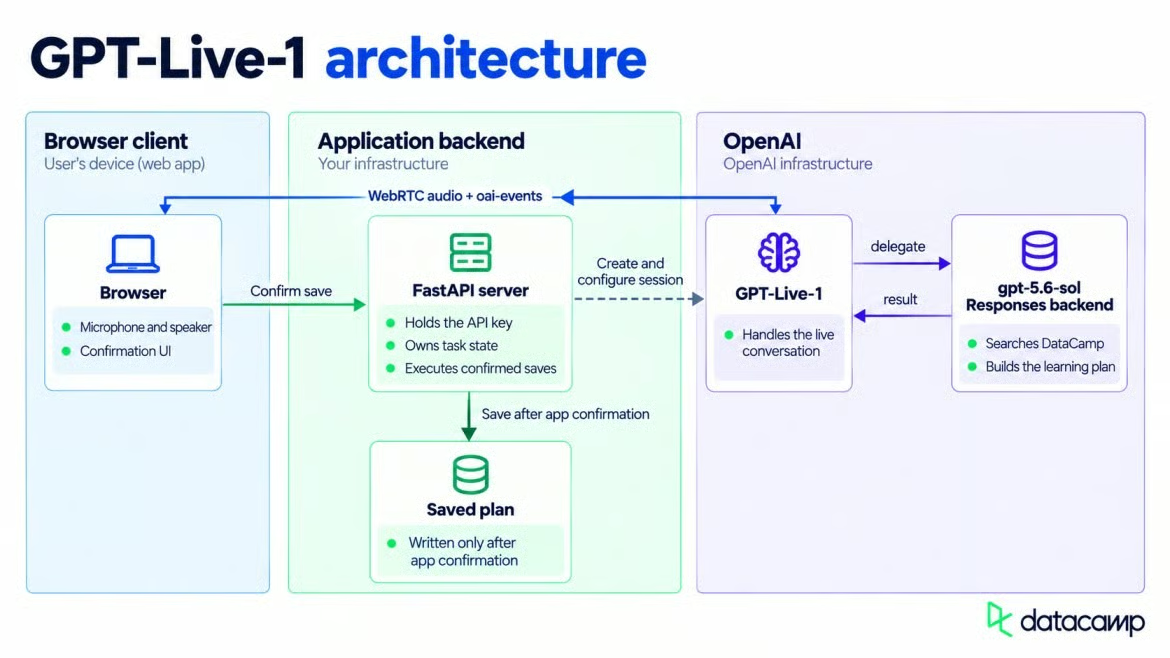
ब्राउज़र, GPT-Live-1 और बैकएंड मॉडल जुड़ते हैं। चित्र: लेखक।
आपको GPT-Live-1 एक्सेस वाला OpenAI प्रोजेक्ट (फ्री टियर इसे सपोर्ट नहीं करता), Python, और HTTPS या localhost पर चल रहा ब्राउज़र चाहिए ताकि माइक्रोफ़ोन प्रॉम्प्ट दिखाई दे सके। मैंने Python 3.11 और openai 3.13.0 का उपयोग किया। Live API के लिए कम से कम openai 3.12.0 चाहिए; पुराने संस्करणों में क्लाइंट पर .live एट्रिब्यूट नहीं होता।
समवर्ती सत्र कैप आपके उपयोग टियर पर निर्भर करते हैं। कई ब्राउज़र टैब खोलने से पहले प्रोजेक्ट लिमिट जांचें।
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install openai fastapi uvicorn python-dotenv streamlit requests
macOS या Linux पर, वातावरण को source .venv/bin/activate से सक्रिय करें। प्रोजेक्ट रूट पर एक .env फ़ाइल बनाएँ और यह मान जोड़ें।
OPENAI_API_KEY=sk-...python-dotenv वह फ़ाइल अपने-आप लोड कर लेता है जैसे ही सर्वर उसे इम्पोर्ट करता है, इसलिए कुंजी कोड में कभी दिखाने की ज़रूरत नहीं पड़ती।
OpenAI() क्लाइंट भी उसी एनवायरनमेंट वेरिएबल को पढ़ता है जब आप कुंजी पास नहीं करते।
ब्राउज़र कभी आपकी प्रोजेक्ट कुंजी नहीं देखता। वह आपका WebRTC ऑफ़र सर्वर को पोस्ट करता है, जो उसी कुंजी से सत्र बनाता है। SDP एक्सचेंज के बाद, ब्राउज़र WebRTC के ज़रिए OpenAI को ऑडियो भेजता है, बिना वह कुंजी पाए।
/api/session के अंदर GPT-Live कॉल SDP ऑफ़र से सत्र बनाती है। यह एक ही अनुरोध में वॉइस निर्देश, बैकएंड मॉडल, वेब सर्च और सेव फ़ंक्शन पास करता है।
result = client.live.create(
    session={
        "model": "gpt-live-1",
        "instructions": LIVE_INSTRUCTIONS,
        "delegation": {
            "type": "responses",
            "responses": {
                "model": "gpt-5.6-sol",
                "instructions": BACKEND_INSTRUCTIONS,
                "tools": [
                    {
                        "type": "web_search",
                        "filters": {
                            "allowed_domains": ["datacamp.com", "www.datacamp.com"]
                        },
                    },
                    SAVE_LEARNING_PLAN_TOOL,
                ],
                "tool_choice": "auto",
            },
        },
    },
    transport={"type": "webrtc", "sdp": sdp},
)
यह कॉल POST /v1/live/sessions पर एक अनुरोध भेजती है और एक सत्र ID के साथ SDP उत्तर लौटाती है। HTTP अनुरोध सत्र शुरू करता है, इसलिए बाद में अलग से session.start इवेंट न भेजें।
सैंपल सर्वर केवल localhost:8501 और 127.0.0.1:8501 से ब्राउज़र अनुरोध स्वीकार करता है। यह नियम लोकल उपयोग के लिए है।
यदि आप ऐप को डिप्लॉय करते हैं, तो उन ओरिजिन्स को बदलें और /api/session और /api/save-plan दोनों को ऑथेंटिकेट करें। सत्र निर्माण पर रेट-लिमिट लगाएँ क्योंकि हर अनुरोध पैसे खर्च कर सकता है और समवर्तीता खा सकता है। क्लाइंट खुद confirmed: true भेज सकता है, इसलिए कोई पब्लिक सर्वर उस फ़ील्ड को अनुरोधकर्ता की पहचान का सबूत नहीं मान सकता।
OpenAI की WebRTC गाइड का पालन करते हुए, ब्राउज़र माइक्रोफ़ोन एक्सेस मांगता है और एक RTCPeerConnection खोलता है। दस्तावेज़ित oai-events डेटा-चैनल लेबल का उपयोग करें और SDP ऑफ़र जनरेट करने से पहले उसे बनाएं। सत्र शुरू होने पर यह चैनल दोनों दिशाओं में JSON इवेंट्स ले जाता है।
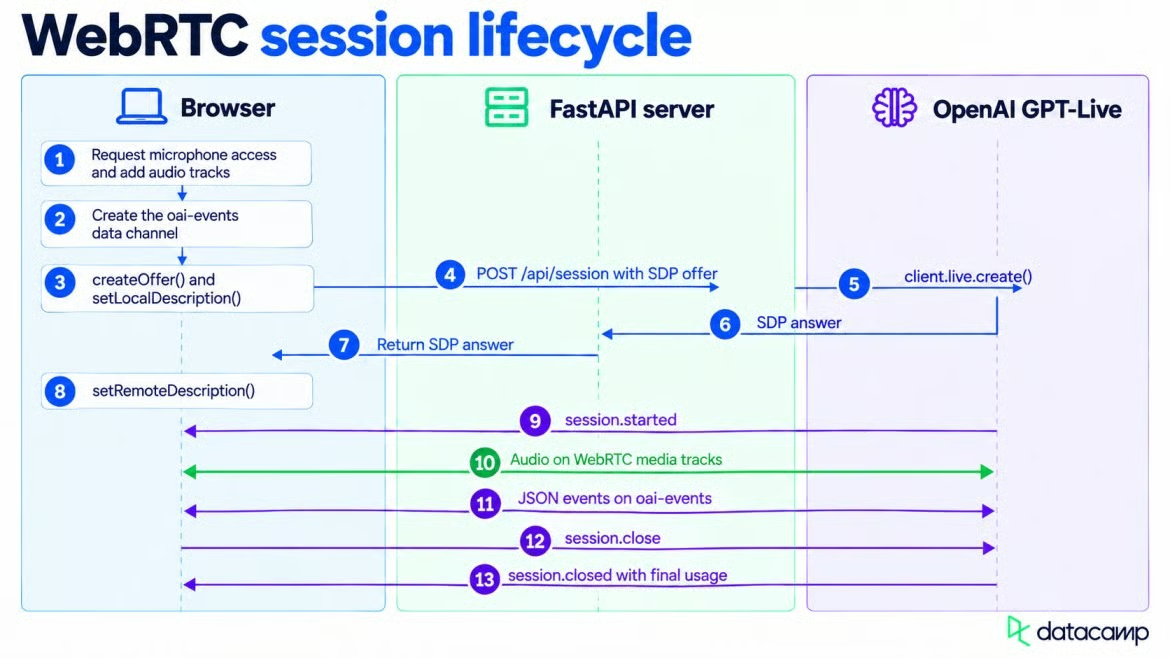
WebRTC शुरू होता है, ऑडियो स्ट्रीम करता है, फिर बंद होता है। चित्र: लेखक।
मीडिया सेटअप स्वयं सामान्य WebRTC है। GPT-Live इवेंट्स पिछले लाइन में बनाए गए डेटा चैनल का उपयोग करते हैं।
const connection = new RTCPeerConnection();
connection.addEventListener("track", (event) => {
  audio.srcObject = new MediaStream([event.track]);
  audio.play();
});
const microphone = await navigator.mediaDevices.getUserMedia({ audio: true });
for (const track of microphone.getAudioTracks()) {
  connection.addTrack(track, microphone);
}
const events = connection.createDataChannel("oai-events");
ऑफ़र बनाने के बाद, ब्राउज़र setLocalDescription() कॉल करता है और ICE गैदरिंग के पूरा होने का इंतज़ार करता है। यह लोकल SDP को /api/session पर भेजता है, फिर OpenAI के उत्तर को setRemoteDescription() के साथ लागू करता है। माइक्रोफ़ोन ऑडियो और सहायक की वाणी मीडिया ट्रैक्स पर जाती है, इसलिए अलग speech-to-text और text-to-speech अनुरोधों की ज़रूरत नहीं।
ऑडियो oai-events पर नहीं होना चाहिए। WebRTC डेटा चैनल पर session.input_audio.append न भेजें और न ही session.output_audio.delta का इंतज़ार करें।
डेटा चैनल अलग टाइमिंग नियम का पालन करता है। session.started का इंतज़ार करें, उसके बाद ही oai-events से कोई इवेंट भेजें। पहली कोशिश में, मैंने एक इवेंट बहुत जल्दी भेज दिया और कनेक्शन ने उसे नज़रअंदाज़ कर दिया।
मुझे कोई उपयोगी त्रुटि नहीं मिली, जिससे छोटा-सा क्रम-सम्बंधी गलती ढूंढना खीझ भरा हो गया।
यदि आपको दृश्य कैप्शन की ज़रूरत नहीं है, तो आप इस उपखंड को छोड़ सकते हैं; ऑडियो कनेक्शन पहले से ही पूरा है।
session.input_transcript.delta और session.output_transcript.delta लाइव कैप्शन के लिए मिलीसेकंड ऑफ़सेट्स के साथ टेक्स्ट के टुकड़े लौटाते हैं। OpenAI के डॉक्स चेताते हैं कि ट्रांसक्रिप्ट टुकड़े पूर्ण टर्न नहीं होते। डिलिवरी असमान हो सकती है, और यूज़र व सहायक के ट्रांसक्रिप्ट इंटरवल ओवरलैप कर सकते हैं।
जैसे-जैसे ट्रांसक्रिप्ट टुकड़े आते हैं, उन्हें स्क्रीन पर जोड़ें, लेकिन उनसे बैकएंड कार्य शुरू न करें। मॉडल तय करता है कि कब डेलिगेट करना है।
Live मॉडल के निर्देश छोटे होने चाहिए। OpenAI की गाइड विस्तृत कार्य चरणों को बैकएंड प्रॉम्प्ट में रखती है। मैंने कार्य-प्रक्रिया वहीं रखी और Live प्रॉम्प्ट को वाणी पर केंद्रित रखा।
यह अंश वॉइस व्यवहार को लर्निंग-प्लान कार्य से अलग रखता है। भाषण के नियम उन शर्तों से ऊपर रहते हैं जो डेलिगेशन ट्रिगर करती हैं।
You are Sage, a warm, encouraging voice learning coach for DataCamp learners.
Speak naturally at an unhurried pace. Be clear and direct, not overly cheerful.

Backchannel policy: Use moderate backchannels without competing with the response.
Interruption policy: Stop speaking when the learner interrupts, and listen.

Delegation policy:
Backend tools:
- learning_plan_research: search DataCamp resources and assemble a personalized learning plan.
- save_learning_plan: propose the current plan for app confirmation when the learner asks to save.

Delegate to the backend when:
- The learner states or changes a goal, skill level, or weekly time.
- A correction changes the plan already requested.
- The learner asks to save the plan.

Do not delegate for greetings, small clarifications, or a result already given.

Saving: a proposed save only asks the app to confirm. Do not say the plan is saved until the app reports a saved result.
After a save, keep the conversation open and ask what the learner wants next.
ये नियम अभिवादन को Live लेयर में रखते हैं और रिसर्च या सेव अनुरोधों को बैकएंड पर भेजते हैं। पुष्टि अब भी ऐप की है।
बैकचैनल और व्यवधान वाली पंक्तियाँ सहायक को बताती हैं कि विरामों के आस-पास कैसे प्रतिक्रिया देनी है। "मध्यम बैकचैनल" का अर्थ है कभी-कभार "हम्म-हम्म" जैसे अनुमोदन, बिना हर सन्नाटे को भरने के। मैंने यह स्तर इसलिए चुना कि सीखने वाले को सोचने की गुंजाइश मिले; लंबे विराम वाले पाठ में कम अनुमोदन की आवश्यकता हो सकती है।
यदि आपके ऐप को अलग व्यवहार चाहिए, तो वह पंक्ति बदलें; "जब उपयोगकर्ता बोल रहा हो तो कभी न बोलें" जोड़ने से बैकचैनल भी हट जाते हैं।
दोनों प्रॉम्प्ट का काम अलग है। Live प्रॉम्प्ट वाणी और हैंडऑफ़ नियंत्रित करता है, जबकि बैकएंड प्रॉम्प्ट रिसर्च और उत्तर प्रारूप नियंत्रित करता है। OpenAI की गाइड वॉइस निर्देशों में विस्तृत सर्च चरण रखने के विरुद्ध सलाह देती है।
पहले वर्णित विभाजन सत्र के delegation फ़ील्ड में दिखाई देता है। जब सीखने वाला कोई लक्ष्य बताता है, GPT-Live कार्य को ऐसे मॉडल को भेजता है जो हमारे कोर्स कैटलॉग में खोज कर सके और योजना बना सके।
GPT-Live-1 Responses डेलिगेशन और क्लाइंट डेलिगेशन प्रदान करता है। Responses डेलिगेशन OpenAI को बैकएंड कॉल प्रबंधित करने देता है, जबकि क्लाइंट डेलिगेशन इसे आपके कोड को सौंप देता है। मैंने Responses डेलिगेशन चुना क्योंकि यह इस ऐप में एक और बैकएंड लूप से बचाता है।
मैंने gpt-5.6-sol का उपयोग किया। OpenAI की डेलिगेशन गाइड शुरुआती उदाहरण के रूप में gpt-5.6-terra का उपयोग करती है और कम-लागत कार्यों के लिए gpt-5.6-luna सूचीबद्ध करती है। Sol के साथ, बैकएंड ने अनुरोधित योजना संरचना लौटाई।
tool_choice को auto पर रखें ताकि बैकएंड वेब सर्च या सेव फ़ंक्शन चुन सके। डेलिगेशन मोड स्टार्टअप पर फिक्स होता है; क्लाइंट डेलिगेशन पर स्विच करने के लिए मौजूदा सत्र बंद करें और दूसरा बनाएं।
Live प्रॉम्प्ट में नियम सरल है: अभिवादन और छोटे प्रश्न Live मॉडल के पास रहते हैं, जबकि लर्निंग प्लान या उसमें बदलाव बैकएंड को जाता है। API में कुछ भी उस सीमा को लागू नहीं करता। अपने ऐप को मिलने वाले अनुरोधों के प्रकार के साथ इसे टेस्ट करें क्योंकि मॉडल खुद चुनाव करता है।
एक बार डेलिगेट होने के बाद, बैकएंड का एक ही कार्य है: सीखने वाले के लक्ष्य को DataCamp संसाधनों की लिंक सहित छोटी सूची में बदलना। मैंने इसे web_search टूल दिया, जिसके filters.allowed_domains को datacamp.com और www.datacamp.com पर सेट किया। उस फ़िल्टर को सर्च निर्देश मानेँ, यह प्रमाण नहीं कि हर लिंक सही है।
नमूना लक्ष्य 5 घंटे प्रति सप्ताह के साथ डेटा इंजीनियरिंग पाथ, कुछ Python ज्ञान और SQL अनुभव नहीं मांगता है। उत्तर की शुरुआत How to Learn Data Engineering From Scratch in 2026 और Associate Data Engineer in SQL ट्रैक से होती है।
बाकी आइटम्स में एक प्रोजेक्ट, एक Python डेटाबेस कोर्स, एक और ट्रैक और अंतिम पाइपलाइन प्रोजेक्ट का मिश्रण है। सूचीबद्ध हर URL किसी मौजूदा DataCamp पेज को खोलता है।
बैकएंड प्रॉम्प्ट चार से सात क्रमबद्ध आइटम मांगता है। प्रत्येक आइटम में शीर्षक, URL, छोटा कारण और course, project, track, या article में से एक प्रकार होता है। मिश्रण सीखने वाले की बताई गई फ़ॉर्मेट वरीयता और साप्ताहिक समय का अनुसरण करता है।
जहाँ पेज अवधि नहीं बताता, मैंने मॉडल से कोर्स की अवधि का अनुमान लगाने को नहीं कहा। ऐसी स्थिति में सटीक संख्या स्रोत से अधिक का दावा करती।
GPT-Live, Responses बैकएंड के काम करते हुए वॉइस सत्र को सक्रिय रख सकता है। यदि सीखने वाला पहला प्लान लौटने से पहले हैंड्स-ऑन बाधा जोड़ देता है, तो मूल बैकएंड कार्य अपने-आप रद्द नहीं होता।
बोला गया सुधार अपने-आप उस काम को रद्द या फिर से नहीं लिखता जो बैकएंड पहले ही शुरू कर चुका है। सहायक की वाणी को रोकना और कार्य बदलना अलग क्रियाएँ हैं। पुराना परिणाम क्या होगा, यह एप्लिकेशन तय करता है।
सर्वर एक task_version काउंटर ट्रैक करता है और हर नई डेलिगेशन शुरू होने पर उसे बढ़ाता है। जब परिणाम आता है, ऐप कार्रवाई करने से पहले उसका वर्ज़न चेक करता है; उसका अपना हैंडलर पुराने परिणाम को लॉग करता है और उसे निष्पादित नहीं करता।
यहाँ Responses डेलिगेशन की एक सीमा है: Live मॉडल बैकएंड परिणाम सीधे प्राप्त करता है, इसलिए वर्ज़न चेक उसके अगले बोले गए उत्तर को पूरी तरह नियंत्रित नहीं कर सकता। क्लाइंट डेलिगेशन आपके कोड को पुराने परिणाम को मॉडल तक पहुँचने से पहले त्यागने देता है। इसलिए टास्क वर्ज़न ऐप कार्रवाइयों की रक्षा करता है, सहायक द्वारा बोले जाने वाले हर शब्द की नहीं।
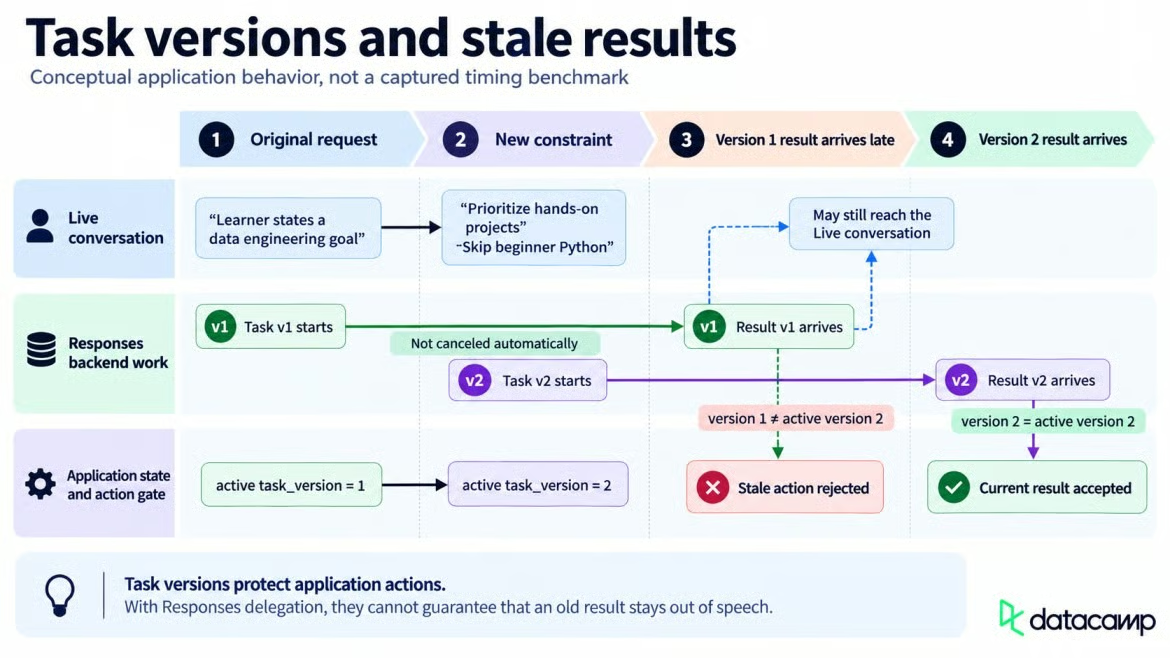
टास्क वर्ज़न नए बाधाओं को सक्रिय रखते हैं। चित्र: लेखक।
पहले बैकएंड उत्तर के पूरा होने के बाद, मैंने हैंड्स-ऑन प्रोजेक्ट्स और कोई शुरुआती Python नहीं की मांग के साथ फॉलो-अप भेजा। संशोधित सात-आइटम योजना की शुरुआत Introduction to SQL से हुई, फिर एक ट्रैक, दो कोर्स और चार प्रोजेक्ट्स मिले-जुले, जिनमें Exploring London's Travel Network और Building a Retail Data Pipeline शामिल थे। यह पूर्ण टर्नों के पार संशोधन दिखाता है; यह किसी सक्रिय उत्तर को रोकने के बारे में कुछ नहीं कहता।
बैकएंड कार्य के दौरान, तीन append इवेंट्स Live मॉडल को अपडेट कर सकते हैं। session.thinking.append ऐसा सन्दर्भ जोड़ता है जिसे बोला नहीं जाना चाहिए, session.commentary.append वह टेक्स्ट जोड़ता है जिसे मॉडल अपने शब्दों में कहे, और session.instructions.append उसके निर्देश बदलता है।
हर append अधिकतम 500 टोकन का सादा स्ट्रिंग ले जाता है। ये इवेंट्स Live मॉडल के संदर्भ या व्यवहार को अपडेट करते हैं; वे पहले से चल रहे बैकएंड Responses कार्य को संशोधित या रद्द नहीं करते। कोई निर्देश वर्तमान Live व्यवहार को दिशा दे सकता है, जबकि कमेंटरी ऐसा सूचना देती है जो मॉडल को ज़ोर से संप्रेषित करनी चाहिए।
डैशबोर्ड बैकएंड प्रगति रिकॉर्ड करता है लेकिन ये append इवेंट्स नहीं भेजता। Responses डेलिगेशन के साथ, आपके ऐप से अपडेट अब भी oai-events के माध्यम से भेजे जा सकते हैं, पर वे delegation_id: null का उपयोग करते हैं। नॉन-नल डेलिगेशन IDs क्लाइंट-डेलिगेटेड कार्यों के लिए उपयोग होते हैं।
task_id और task_version को एप्लिकेशन स्टेट में रखें, delegation_id का उपयोग इन दोनों में से किसी के लिए न करें।
इस ऐप में, केवल मॉडल का उत्तर कुछ भी अपने आप सहेजता नहीं है। बैकएंड save_learning_plan का उपयोग लंबित कार्रवाई प्रस्तावित करने के लिए करता है, जबकि /api/save-plan वास्तविक लिखाई का स्वामी है।
बैकएंड फ़ंक्शन कॉल्स response.event के अंदर आती हैं। हैंडलर नेस्टेड response.output_item.done आइटम का इंतज़ार करता है, फिर उसका call_id, name, और arguments पढ़ता है।
पूर्ण आइटम का इंतज़ार करना इसलिए ज़रूरी है क्योंकि पहले के इवेंट्स में कॉल का केवल कुछ हिस्सा हो सकता है। ऐप आर्ग्युमेंट्स पार्स करता है पर अभी फ़ंक्शन नहीं चलाता।
SAVE_LEARNING_PLAN_TOOL = {
    "type": "function",
    "name": "save_learning_plan",
    "description": "Propose the current learning plan for confirmation when the learner asks to save.",
    "parameters": {
        "type": "object",
        "properties": {
            "goal": {"type": "string"},
            "weekly_hours": {"type": "number"},
            "items": {
                "type": "array",
                "items": {
                    "type": "object",
                    "properties": {
                        "title": {"type": "string"},
                        "url": {"type": "string"},
                        "reason": {"type": "string"},
                        "type": {
                            "type": "string",
                            "enum": ["course", "project", "track", "article"],
                        },
                    },
                    "required": ["title", "url", "reason", "type"],
                    "additionalProperties": False,
                },
            },
        },
        "required": ["goal", "weekly_hours", "items"],
        "additionalProperties": False,
    },
    "strict": True,
}
स्कीमा ऐप को फ़िक्स्ड फ़ील्ड्स का सेट देता है जिसे वह पुष्टि मांगने से पहले दिखा सके। type फ़ील्ड सहेजे गए डेटा में कोर्स, प्रोजेक्ट्स, ट्रैक्स और आर्टिकल्स को स्पष्ट रखता है।
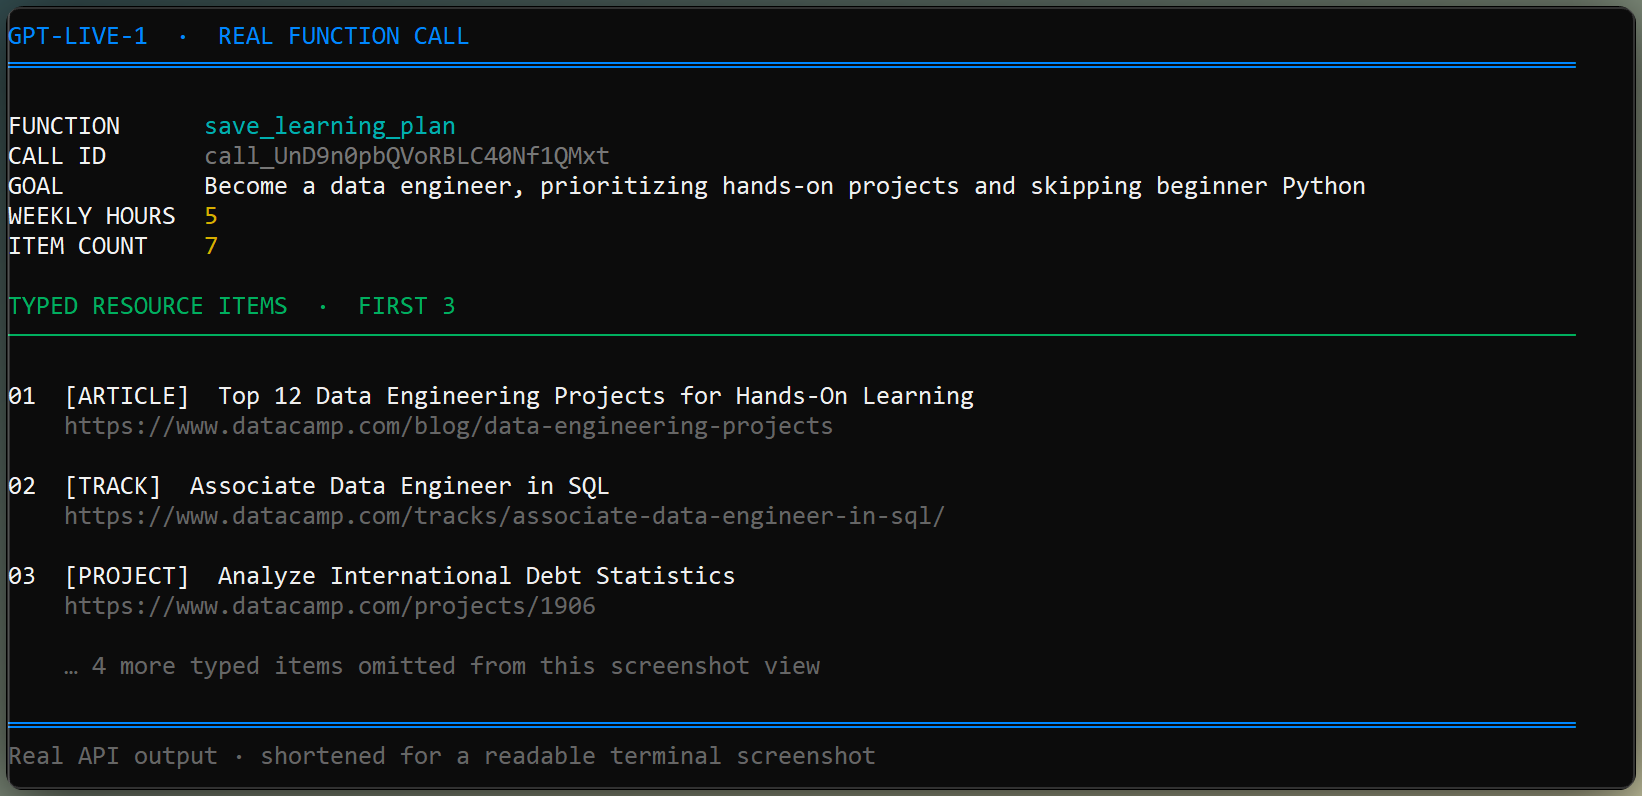
टर्मिनल टाइप्ड सेव फ़ंक्शन आर्ग्युमेंट्स दिखाता है। चित्र: लेखक।
जब सीखने वाला सहेजने के लिए कहता है, बैकएंड पूरा प्लान के साथ save_learning_plan कॉल करता है। विजेट वे आर्ग्युमेंट्स स्टोर करता है और पुष्टि बॉक्स दिखाता है, पर कॉल अभी भी केवल एक प्रस्ताव है।
उस फ़ंक्शन कॉल को अनुत्तरित छोड़ना डेलिगेटेड उत्तर और बाद के बैकएंड टर्न्स को ब्लॉक कर देगा। विजेट तुरंत उसे awaiting-confirmation परिणाम के साथ उत्तर देता है, फिर response.create भेजता है ताकि बातचीत जारी रह सके।
events.send(JSON.stringify({
  type: "response.item.create",
  item: {
    type: "function_call_output",
    call_id: callId,
    output: JSON.stringify({
      status: "awaiting_user_confirmation",
      saved: false,
    }),
  },
}));
events.send(JSON.stringify({ type: "response.create" }));
इस बिंदु पर कोई फ़ाइल नहीं लिखी जाती। सहायक सीखने वाले को Confirm and save बटन की ओर निर्देशित कर सकता है, बिना बाद के डेलिगेटेड कार्य को ब्लॉक किए।
/api/save-plan एन्डपॉइंट तब तक लिखने से इनकार करता है जब तक confirmed true न हो। चूँकि ट्रांसक्रिप्ट गलत या अधूरा हो सकता है, केवल बोला गया अनुरोध योजना को सहेजता नहीं।
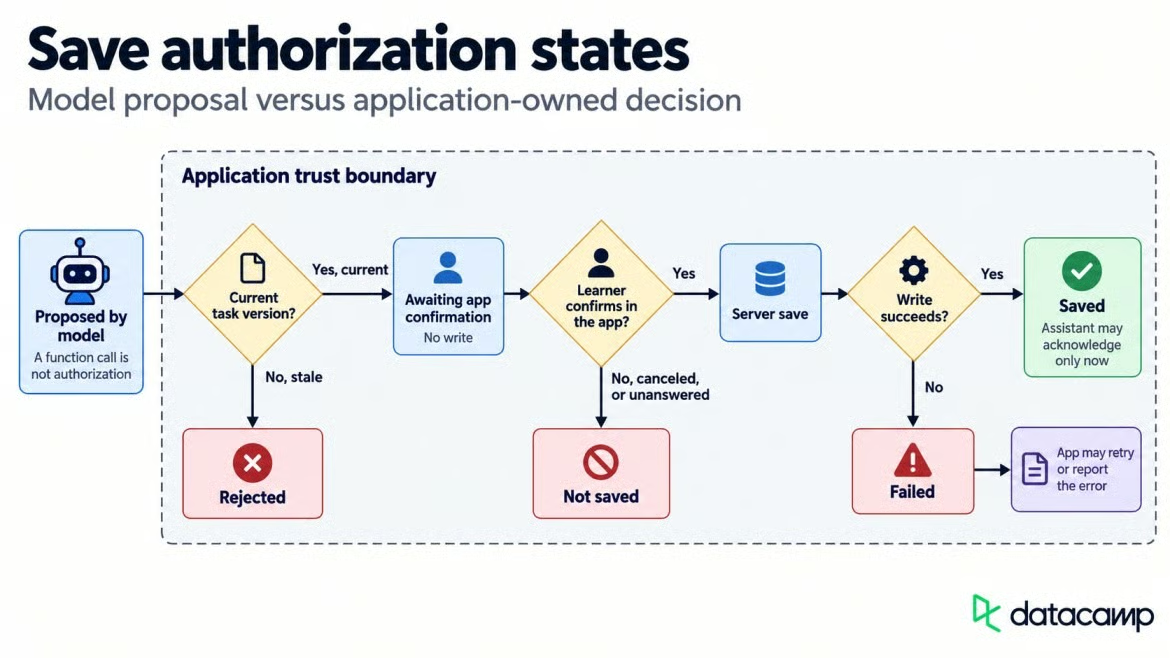
पुष्टि अनुरोधों को सहेजी गई कार्रवाइयों से अलग करती है। चित्र: लेखक।
Confirm क्लिक /api/save-plan को लंबित योजना और confirmed: true भेजता है। सर्वर से प्लान ID आने के बाद, विजेट session.commentary.append delegation_id: null के साथ भेजता है क्योंकि मूल फ़ंक्शन कॉल का पहले ही उत्तर दिया जा चुका था।
const saveResponse = await fetch(${SERVER}/api/save-plan, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    confirmed: true,
    plan: pendingFunctionCall.args,
  }),
});
const saveResult = await saveResponse.json();

events.send(JSON.stringify({
  type: "session.commentary.append",
  delegation_id: null,
  content: The plan was saved as ${saveResult.plan_id}.,
}));
कमेंटरी अपडेट Live मॉडल को पूर्ण लिखाई के बारे में बताता है और उसे सेव को ज़ोर से स्वीकार करने देता है। पहले की फ़ंक्शन कॉल बंद ही रहती है, और वॉइस सत्र सीखने वाले के अगले अनुरोध के लिए उपलब्ध रहता है।
पहले लिंक की गई GitHub रिपॉज़िटरी में FastAPI सर्वर, Streamlit इंटरफ़ेस, और app/ के अंदर WebRTC विजेट शामिल है। इसे क्लोन करने के बाद, उसी फ़ोल्डर में दो टर्मिनल खोलें। एक में uvicorn server:app --host 127.0.0.1 --port 8000 चलाएँ और दूसरे में streamlit run streamlit_app.py ।
Streamlit इंटरफ़ेस उसी सर्वर और विजेट को रैप करता है जिसका उपयोग पूरे बिल्ड में किया गया। यह लाइव बातचीत को लर्निंग प्लान और बैकएंड गतिविधि के साथ रखता है, जबकि डैशबोर्ड कॉल को रीसेट किए बिना अपडेट होता रहता है।
नीचे दिया गया वीडियो बोले गए लक्ष्य, बैकएंड सर्च, संशोधित योजना, और पुष्ट सेव का अनुसरण करता है। सहेजने के बाद कॉल खुला रहता है ताकि सीखने वाला जारी रख सके।
DataCamp के साथ सीखें
course
course
course