Curso
Comprender la ingeniería de prompts
1 h
230.3K
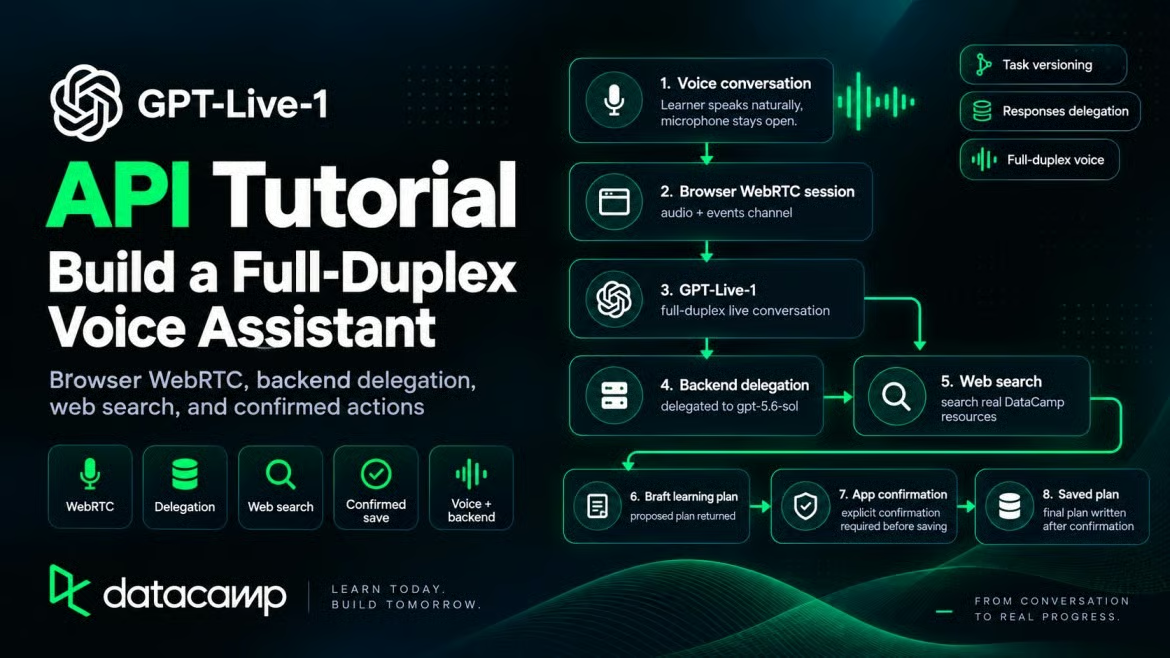
La primera vez que abrí una sesión de navegador con GPT-Live-1, esperaba el típico bucle de voz: hablas, esperas y luego escuchas la respuesta. En su lugar, el micrófono siguió abierto mientras el asistente respondía. La conversación se sentía menos rígida, pero la app seguía teniendo que orquestar el trabajo que ocurría por detrás.
OpenAI presentó GPT-Live en ChatGPT en julio y llevó GPT-Live-1 a la API a principios de esta semana, justo antes de empezar este proyecto. Nuestro tutorial de GPT-Realtime-2.1 cubre el enfoque de un solo modelo, mientras que nuestra guía de GPT Live Transcribe se centra en subtítulos en vivo. Aquí, vas a crear un asistente de aprendizaje por voz que busca recursos reales de DataCamp y guarda un plan solo tras tu confirmación.
Lo llamo DataCamp Voice Learning Assistant. Es un prototipo de tutorial, no el DataCamp AI Assistant de producción. El proyecto sigue a una persona desde un objetivo hablado hasta un plan guardado.
GPT-Live-1 separa el intercambio hablado del trabajo en el backend. Cuatro hallazgos dan forma al asistente de aprendizaje.
Estos hallazgos aplican a este flujo de creación de plan. Un prompt o red distintos pueden cambiar el comportamiento, y la delegación en cliente mueve el límite de control.
GPT-Live-1 es el modelo de voz full‑dúplex de OpenAI. Gestiona turnos hablados e interrupciones, incluidas las pausas, y deriva trabajos más largos como búsquedas o llamadas a herramientas a un backend.
Para quien aprende, la primera diferencia visible está en esas pausas.
El full‑dúplex cambia la toma de turnos. Puedes parar a pensar o hablar por encima del asistente, y este puede detenerse para oír la corrección. La guía de prompts de OpenAI muestra secciones para acuses breves y para interrupciones.
Esto importa en un asistente de aprendizaje. Al describir un objetivo profesional, alguien puede pausar, reiniciar o añadir un límite a mitad de frase. Un modelo que espera durante "pues, a ver, quizá cinco horas a la semana" permite pensar en voz alta.
Delegar mueve una tarea al backend, pero no cede el control de la aplicación. La app sigue decidiendo quién puede actuar y si se permite guardar. También es dueña del estado de la tarea almacenada.
Si has usado GPT-Realtime-2.1, quizá te preguntes si GPT-Live-1 lo sustituye. No es así.
GPT-Realtime-2.1 gestiona escucha, razonamiento y selección de herramientas en un único modelo sobre v1/realtime, con facturación por tokens de audio y texto. GPT-Live-1 usa v1/live/sessions, factura la capa de voz por segundo y envía el razonamiento a un backend separado.
Realtime-2.1 no es una opción más antigua ni inferior. Es un diseño distinto.
La app toma un objetivo hablado y lo convierte en una lista ordenada de recursos reales de DataCamp. La sesión de voz sigue abierta mientras trabaja el backend. Si cambia la solicitud, la app actualiza su versión de tarea antes de ejecutar una acción en backend.
No se escribe nada hasta que el estudiante confirma de nuevo en la app.
La página del navegador mantiene la conexión WebRTC y el micrófono, mientras el servidor crea la sesión de GPT-Live-1 y guarda la clave de la API. Un backend de Responses (gpt-5.6-sol) usa búsqueda web y la función save_learning_plan . La versión de tarea actual y el plan confirmado permanecen en el estado de la app.
La versión de tarea decide qué acción de backend acepta la app cuando una solicitud cambia durante una búsqueda. Usa el repositorio de GitHub para la app ejecutable completa; las siguientes secciones se centran en su ruta con GPT-Live.
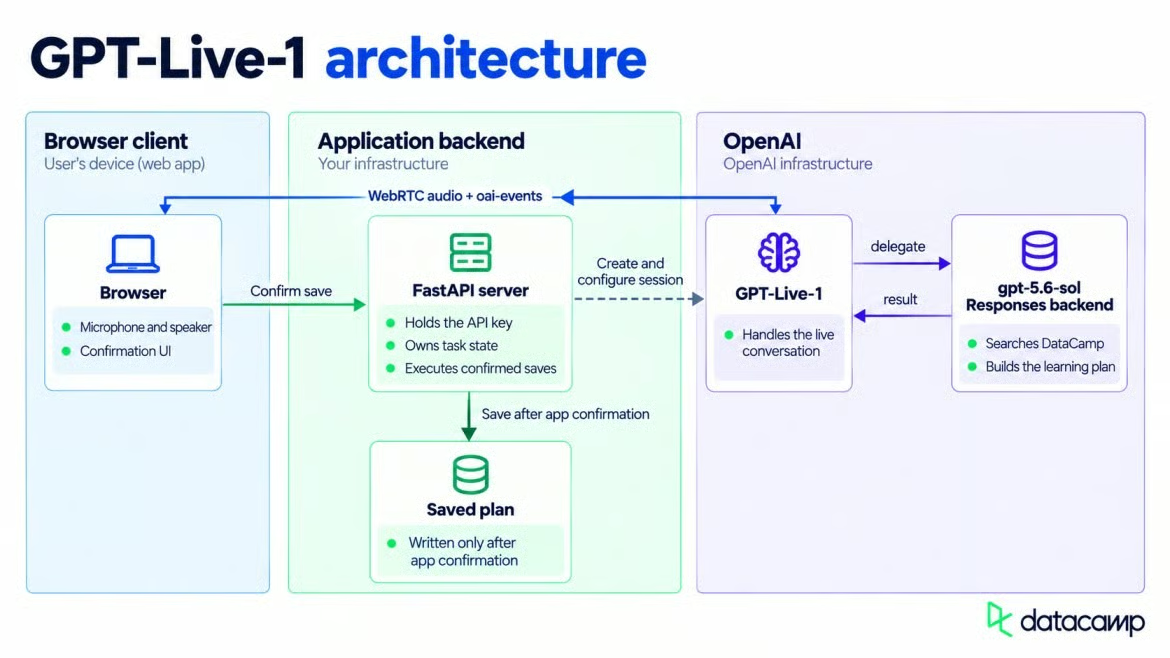
Navegador, GPT-Live-1 y modelo de backend conectados. Imagen del autor.
Necesitas un proyecto de OpenAI con acceso a GPT-Live-1 (el plan gratuito no lo incluye), Python y un navegador que ejecute sobre HTTPS o localhost para que aparezca el aviso del micrófono. Usé Python 3.11 y openai 3.13.0. La Live API requiere al menos openai 3.12.0; las versiones anteriores no tienen el atributo .live en el cliente.
El límite de sesiones concurrentes depende de tu plan. Comprueba el tope del proyecto antes de abrir muchas pestañas.
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install openai fastapi uvicorn python-dotenv streamlit requests
En macOS o Linux, activa el entorno con source .venv/bin/activate en su lugar. Crea un archivo .env en la raíz del proyecto y añade este valor.
OPENAI_API_KEY=sk-...python-dotenv carga ese archivo automáticamente cuando el servidor lo importa, así que la clave no tiene por qué aparecer en el código.
El cliente OpenAI() lee la misma variable de entorno si no le pasas una clave.
El navegador nunca ve la clave de tu proyecto. Envía una oferta WebRTC a tu servidor, que usa la clave para crear la sesión. Tras el intercambio SDP, el navegador envía audio a OpenAI por WebRTC sin recibir esa clave.
La llamada a GPT-Live dentro de /api/session crea la sesión a partir de la oferta SDP. En la misma solicitud pasa las instrucciones de voz, el modelo de backend, la búsqueda web y la función de guardado.
result = client.live.create(
    session={
        "model": "gpt-live-1",
        "instructions": LIVE_INSTRUCTIONS,
        "delegation": {
            "type": "responses",
            "responses": {
                "model": "gpt-5.6-sol",
                "instructions": BACKEND_INSTRUCTIONS,
                "tools": [
                    {
                        "type": "web_search",
                        "filters": {
                            "allowed_domains": ["datacamp.com", "www.datacamp.com"]
                        },
                    },
                    SAVE_LEARNING_PLAN_TOOL,
                ],
                "tool_choice": "auto",
            },
        },
    },
    transport={"type": "webrtc", "sdp": sdp},
)
Esa llamada envía una petición a POST /v1/live/sessions y devuelve un ID de sesión con una respuesta SDP. La solicitud HTTP inicia la sesión, así que no envíes un evento session.start aparte después.
El servidor de ejemplo solo acepta peticiones del navegador desde localhost:8501 y 127.0.0.1:8501. Esa regla es para uso local.
Si despliegas la app, cambia esos orígenes y autentica tanto /api/session como /api/save-plan. Limita la tasa de creación de sesiones, porque cada solicitud puede costar dinero y consumir concurrencia. Un cliente puede enviar confirmed: true por su cuenta, así que un servidor público no puede tratar ese campo como prueba de autoría.
Siguiendo la guía de WebRTC de OpenAI, el navegador pide acceso al micrófono y abre una RTCPeerConnection. Usa la etiqueta de canal de datos documentada oai-events y créala antes de generar la oferta SDP. Ese canal transporta eventos JSON en ambas direcciones una vez que la sesión empieza.
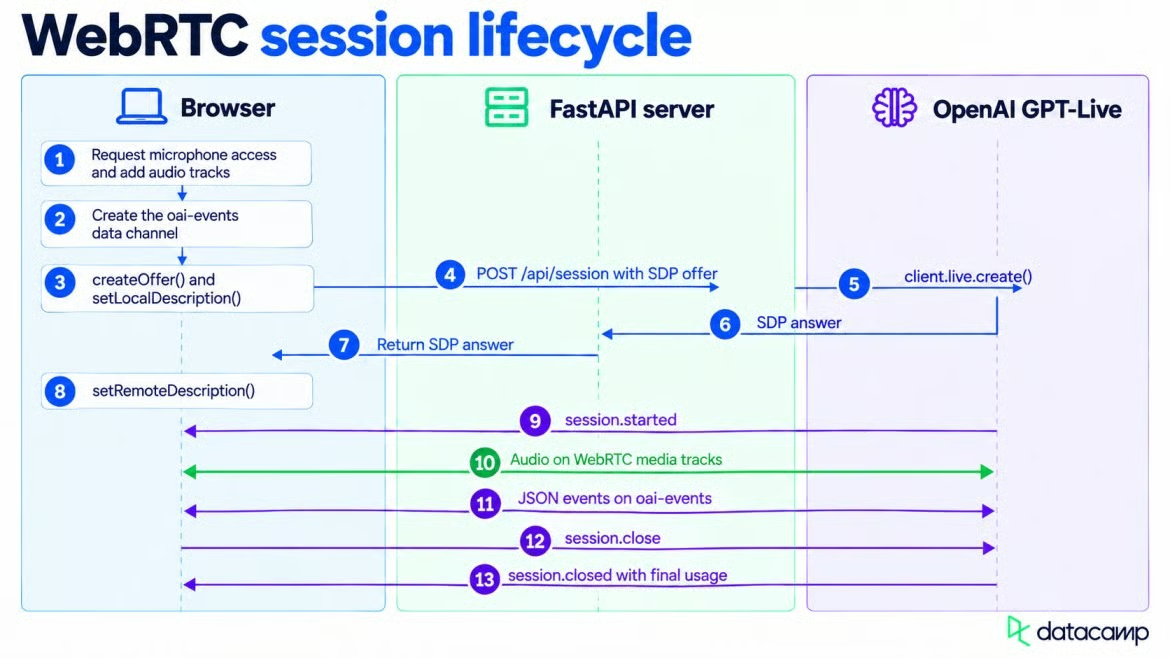
WebRTC arranca, transmite audio y luego cierra. Imagen del autor.
La configuración de medios es WebRTC estándar. Los eventos de GPT-Live usan el canal de datos creado en la última línea.
const connection = new RTCPeerConnection();
connection.addEventListener("track", (event) => {
  audio.srcObject = new MediaStream([event.track]);
  audio.play();
});
const microphone = await navigator.mediaDevices.getUserMedia({ audio: true });
for (const track of microphone.getAudioTracks()) {
  connection.addTrack(track, microphone);
}
const events = connection.createDataChannel("oai-events");
Tras crear la oferta, el navegador llama a setLocalDescription() y espera a que termine la recopilación ICE. Envía el SDP local a /api/session y luego aplica la respuesta de OpenAI con setRemoteDescription(). El audio del micrófono y la voz del asistente viajan por las pistas de medios, así que no hacen falta solicitudes separadas de voz a texto y texto a voz.
El audio no va en oai-events. No envíes session.input_audio.append ni esperes session.output_audio.delta en un canal de datos WebRTC.
El canal de datos sigue otra regla temporal. Espera a session.started antes de enviar un evento por oai-events. En mi primer intento, envié uno demasiado pronto y la conexión lo ignoró.
No obtuve ningún error útil, lo que hizo que un pequeño fallo de orden fuese molesto de rastrear.
Si no necesitas subtítulos visibles, puedes saltarte este apartado; la conexión de audio ya está lista.
session.input_transcript.delta y session.output_transcript.delta devuelven fragmentos de texto con offsets en milisegundos para subtítulos en vivo. La documentación de OpenAI avisa de que los fragmentos no equivalen a turnos cerrados. La entrega puede ser irregular y los intervalos del usuario y del asistente pueden solaparse.
Ves añadiendo fragmentos de transcripción a pantalla a medida que llegan, pero no inicies trabajo de backend desde ellos. El modelo decide cuándo delegar.
Las instrucciones del modelo Live deben ser breves. La guía de OpenAI sitúa los pasos detallados de la tarea en el prompt del backend. Mantengo el procedimiento allí y dejo el prompt de Live centrado en la voz.
Este extracto mantiene el comportamiento de voz separado de la tarea del plan de aprendizaje. Las reglas de habla quedan por encima de las condiciones que disparan la delegación.
You are Sage, a warm, encouraging voice learning coach for DataCamp learners.
Speak naturally at an unhurried pace. Be clear and direct, not overly cheerful.

Backchannel policy: Use moderate backchannels without competing with the response.
Interruption policy: Stop speaking when the learner interrupts, and listen.

Delegation policy:
Backend tools:
- learning_plan_research: search DataCamp resources and assemble a personalized learning plan.
- save_learning_plan: propose the current plan for app confirmation when the learner asks to save.

Delegate to the backend when:
- The learner states or changes a goal, skill level, or weekly time.
- A correction changes the plan already requested.
- The learner asks to save the plan.

Do not delegate for greetings, small clarifications, or a result already given.

Saving: a proposed save only asks the app to confirm. Do not say the plan is saved until the app reports a saved result.
After a save, keep the conversation open and ask what the learner wants next.
Estas reglas dejan los saludos en la capa Live y envían investigaciones o solicitudes de guardado al backend. La confirmación sigue siendo cosa de la app.
Las líneas de backchannel e interrupción indican al asistente cómo responder alrededor de las pausas. "Backchannels moderados" pide asentimientos ocasionales como "ajá" sin llenar cada silencio. Elegí ese nivel para dejar espacio al estudiante; una sesión con pausas más largas quizá necesite aún menos acuses.
Ajusta esa línea si tu app requiere otro comportamiento; añadir "nunca hables mientras el usuario esté hablando" también elimina los backchannels.
Los dos prompts tienen cometidos distintos. El de Live controla el habla y la cesión, mientras que el de backend controla la investigación y el formato de la respuesta. La guía de OpenAI desaconseja poner pasos de búsqueda detallados en las instrucciones de voz.
La separación descrita antes aparece en el campo delegation de la sesión. Cuando el estudiante establece un objetivo, GPT-Live envía la tarea a un modelo que puede buscar en nuestro catálogo y montar el plan.
GPT-Live-1 ofrece delegación con Responses y delegación en cliente. Responses permite que OpenAI gestione la llamada al backend, mientras que la delegación en cliente la entrega a tu código. Usé Responses porque evita otro bucle de backend en esta app.
Usé gpt-5.6-sol. La guía de delegación de OpenAI usa gpt-5.6-terra como ejemplo inicial y menciona gpt-5.6-luna para tareas de menor coste. Con Sol, el backend devolvió la estructura de plan solicitada.
Mantén tool_choice en auto para que el backend pueda elegir entre búsqueda web o la función de guardado. El modo de delegación se fija al arrancar; cambia a delegación en cliente cerrando la sesión actual y creando otra.
La regla del prompt de Live es simple: saludos y preguntas cortas se quedan en el modelo Live, mientras que un plan de aprendizaje o un cambio en ese plan van al backend. Nada en la API hace cumplir esa frontera. Pruébalo con los tipos de solicitudes que recibirá tu app, porque el modelo decide por sí mismo.
Una vez delegada, la tarea del backend es convertir el objetivo del estudiante en una lista breve de recursos de DataCamp con enlaces. Le di la herramienta web_search con filters.allowed_domains ajustado a datacamp.com y www.datacamp.com. Trata ese filtro como una instrucción de búsqueda, no como garantía de que cada enlace es correcto.
El objetivo de ejemplo pide una ruta de data engineering con 5 horas semanales, algo de Python y sin experiencia en SQL. La respuesta empieza con How to Learn Data Engineering From Scratch in 2026 y el itinerario Associate Data Engineer in SQL.
Los demás elementos combinan un proyecto, un curso de bases de datos en Python, otro itinerario y un proyecto final de pipelines. Todas las URL abren páginas existentes de DataCamp.
El prompt de backend pide entre cuatro y siete elementos ordenados. Cada elemento tiene un título, URL, motivo breve y un tipo course, project, track o article. La mezcla sigue la preferencia de formato y el tiempo semanal indicado por el estudiante.
No pedí al modelo que estimara la duración de un curso cuando la página no la indicaba. Dar un número exacto en ese caso afirmaría más de lo que respalda la fuente.
GPT-Live puede mantener activa la sesión de voz mientras trabaja el backend de Responses. Si el estudiante añade la condición de "más práctico" antes de que llegue el primer plan, el trabajo original en backend no se cancela automáticamente.
Una corrección hablada no cancela ni reescribe automáticamente el trabajo que el backend ya empezó. Interrumpir el habla del asistente y cambiar la tarea son acciones separadas. La aplicación decide qué hacer con el resultado anterior.
El servidor lleva un contador task_version y lo incrementa cada vez que empieza una nueva delegación. Cuando llega un resultado, la app comprueba su versión antes de actuar; su propio manejador registra un resultado antiguo y no lo ejecuta.
La delegación con Responses tiene un límite aquí: el modelo Live recibe el resultado del backend directamente, así que la comprobación de versión no puede controlar del todo su siguiente réplica hablada. La delegación en cliente te permite descartar un resultado antiguo antes de que llegue al modelo. Por tanto, la versión de tarea protege las acciones de la app, no cada palabra que el asistente pueda decir.
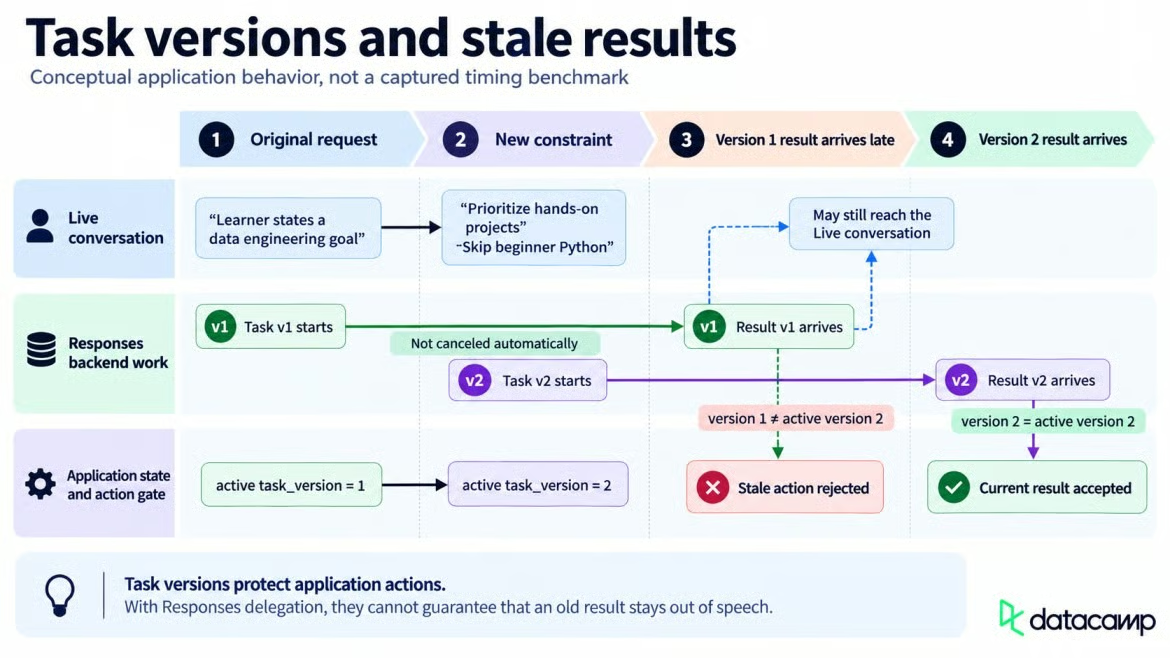
Las versiones de tarea mantienen activas las restricciones más recientes. Imagen del autor.
Tras completarse la primera respuesta del backend, envié un seguimiento pidiendo proyectos prácticos y nada de Python para principiantes. El plan revisado de siete elementos empezaba con Introduction to SQL y combinaba un itinerario, dos cursos y cuatro proyectos, como Exploring London's Travel Network y Building a Retail Data Pipeline. Eso muestra revisión entre turnos completados; no implica detener una respuesta en curso.
Mientras el backend trabaja, tres eventos de anexado pueden actualizar el modelo Live. session.thinking.append añade contexto que no debe hablarse, session.commentary.append añade texto para que el modelo lo diga con sus palabras, y session.instructions.append cambia sus instrucciones.
Cada anexado lleva una cadena simple de hasta 500 tokens. Estos eventos actualizan el contexto o el comportamiento del modelo Live; no modifican ni cancelan una tarea de Responses ya en marcha. Una instrucción puede redirigir el comportamiento actual de Live, mientras que commentary aporta información que el modelo debe comunicar en voz alta.
El panel registra el progreso del backend, pero no envía estos anexados. Con delegación de Responses, las actualizaciones desde tu app pueden seguir enviándose por oai-events, pero usan delegation_id: null. Los IDs de delegación no nulos se usan en tareas delegadas al cliente.
Mantén task_id y task_version en el estado de la aplicación, en lugar de usar delegation_id para alguno de ellos.
En esta app, una respuesta del modelo no guarda nada por sí misma. El backend usa save_learning_plan para proponer la acción pendiente, mientras que /api/save-plan realiza realmente la escritura.
Las llamadas a funciones del backend llegan dentro de response.event. El manejador espera un elemento anidado response.output_item.done, y entonces lee su call_id, name y arguments.
Esperar al elemento completado importa porque eventos anteriores pueden contener solo parte de la llamada. La app analiza los argumentos, pero aún no ejecuta la función.
SAVE_LEARNING_PLAN_TOOL = {
    "type": "function",
    "name": "save_learning_plan",
    "description": "Propose the current learning plan for confirmation when the learner asks to save.",
    "parameters": {
        "type": "object",
        "properties": {
            "goal": {"type": "string"},
            "weekly_hours": {"type": "number"},
            "items": {
                "type": "array",
                "items": {
                    "type": "object",
                    "properties": {
                        "title": {"type": "string"},
                        "url": {"type": "string"},
                        "reason": {"type": "string"},
                        "type": {
                            "type": "string",
                            "enum": ["course", "project", "track", "article"],
                        },
                    },
                    "required": ["title", "url", "reason", "type"],
                    "additionalProperties": False,
                },
            },
        },
        "required": ["goal", "weekly_hours", "items"],
        "additionalProperties": False,
    },
    "strict": True,
}
El esquema da a la app un conjunto fijo de campos que mostrar antes de pedir confirmación al estudiante. El campo type mantiene explícitos cursos, proyectos, itinerarios y artículos en los datos guardados.
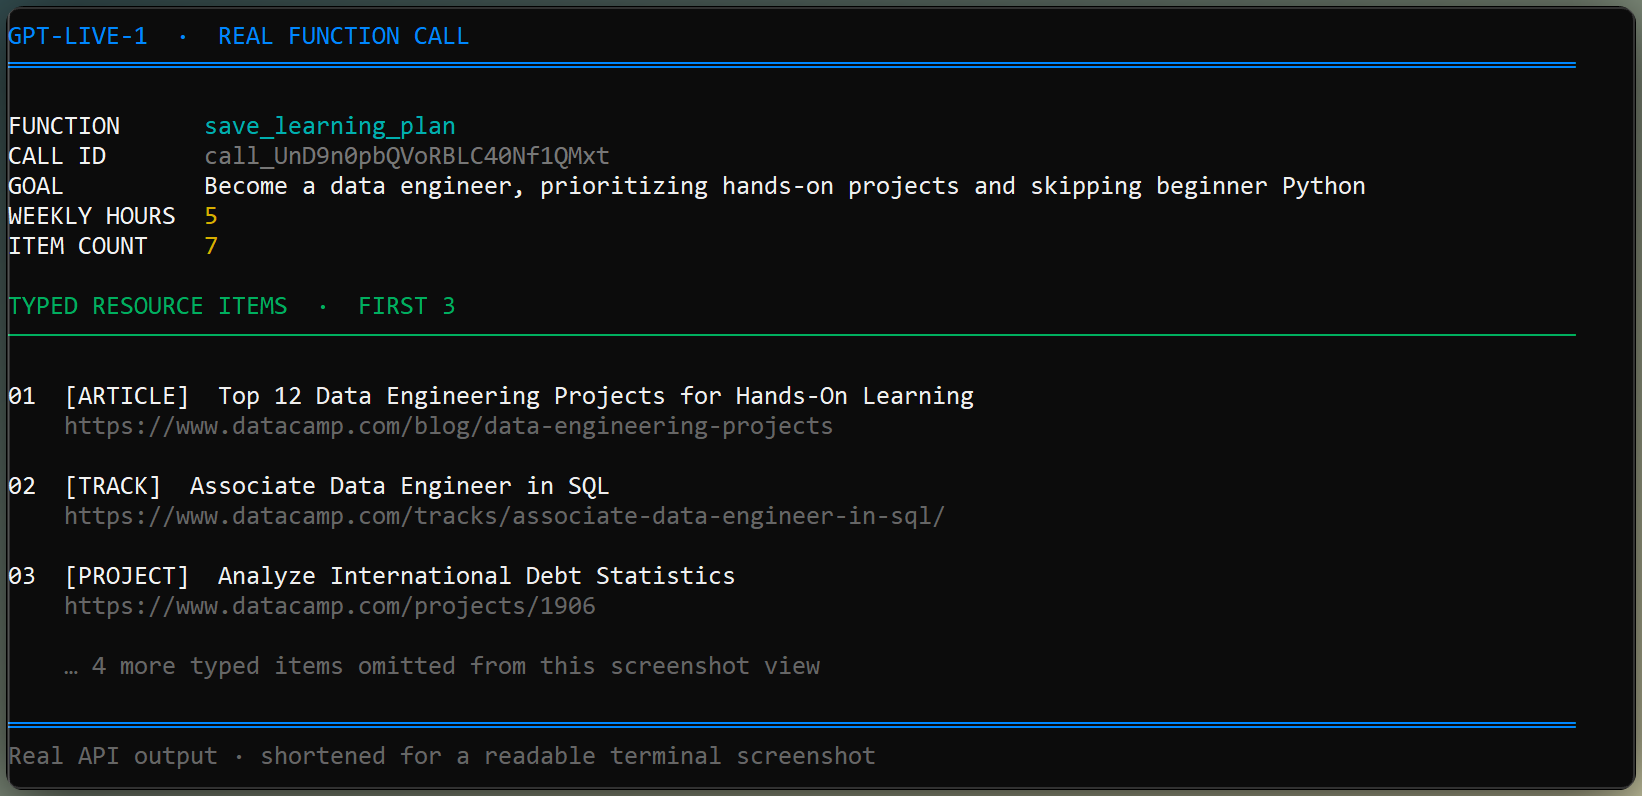
La terminal muestra argumentos tipados de la función de guardado. Imagen del autor.
Cuando el estudiante pide guardar, el backend llama a save_learning_plan con el plan completo. El widget guarda esos argumentos y muestra la caja de confirmación, pero la llamada sigue siendo solo una propuesta.
Dejar esa llamada sin respuesta bloquearía la respuesta delegada y turnos posteriores del backend. El widget la responde al instante con un resultado de "en espera de confirmación" y luego envía response.create para que la conversación continúe.
events.send(JSON.stringify({
  type: "response.item.create",
  item: {
    type: "function_call_output",
    call_id: callId,
    output: JSON.stringify({
      status: "awaiting_user_confirmation",
      saved: false,
    }),
  },
}));
events.send(JSON.stringify({ type: "response.create" }));
En este punto no se escribe ningún archivo. El asistente puede dirigir al estudiante al botón Confirmar y guardar sin bloquear trabajos delegados posteriores.
El endpoint /api/save-plan se niega a escribir si confirmed es true. Como una transcripción puede ser errónea o incompleta, la petición hablada por sí sola no guarda el plan.
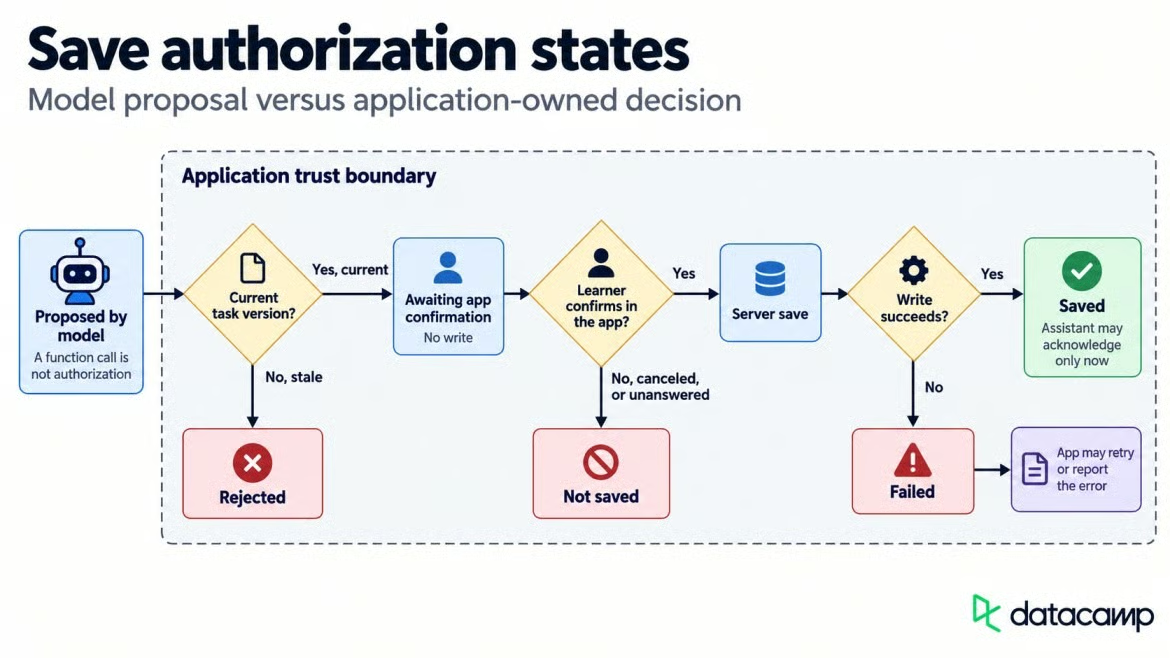
La confirmación separa las solicitudes de las acciones guardadas. Imagen del autor.
Al pulsar Confirmar se envía a /api/save-plan el plan pendiente y confirmed: true. Tras devolver el servidor un ID de plan, el widget envía session.commentary.append con delegation_id: null porque la llamada a función original ya estaba respondida.
const saveResponse = await fetch(${SERVER}/api/save-plan, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    confirmed: true,
    plan: pendingFunctionCall.args,
  }),
});
const saveResult = await saveResponse.json();

events.send(JSON.stringify({
  type: "session.commentary.append",
  delegation_id: null,
  content: The plan was saved as ${saveResult.plan_id}.,
}));
La actualización por commentary informa al modelo Live del guardado completado y le permite reconocerlo en voz alta. La llamada a función previa queda cerrada y la sesión de voz sigue disponible para la siguiente petición del estudiante.
El repositorio de GitHub enlazado antes contiene el servidor FastAPI, la interfaz de Streamlit y el widget WebRTC en app/. Tras clonarlo, abre dos terminales en esa carpeta. Ejecuta uvicorn server:app --host 127.0.0.1 --port 8000 en una y streamlit run streamlit_app.py en la otra.
La interfaz de Streamlit envuelve el mismo servidor y widget usados en todo el desarrollo. Coloca la conversación en vivo junto al plan de aprendizaje y la actividad del backend, mientras el panel se actualiza sin reiniciar la llamada.
El vídeo de abajo sigue el objetivo hablado, la búsqueda en backend, el plan revisado y el guardado confirmado. La llamada permanece abierta tras guardar para que el estudiante continúe.
Aprende con DataCamp
Curso
Curso
Curso
Tutorial
Moez Ali
11 min
Tutorial
Zoumana Keita
14 min
Tutorial
Arunn Thevapalan
12 min
Tutorial
Matt Crabtree
6 min
Tutorial
Kurtis Pykes
12 min
Tutorial
Moez Ali
7 min