Courses
プロンプトエンジニアリングを理解する
1時間
230.3K
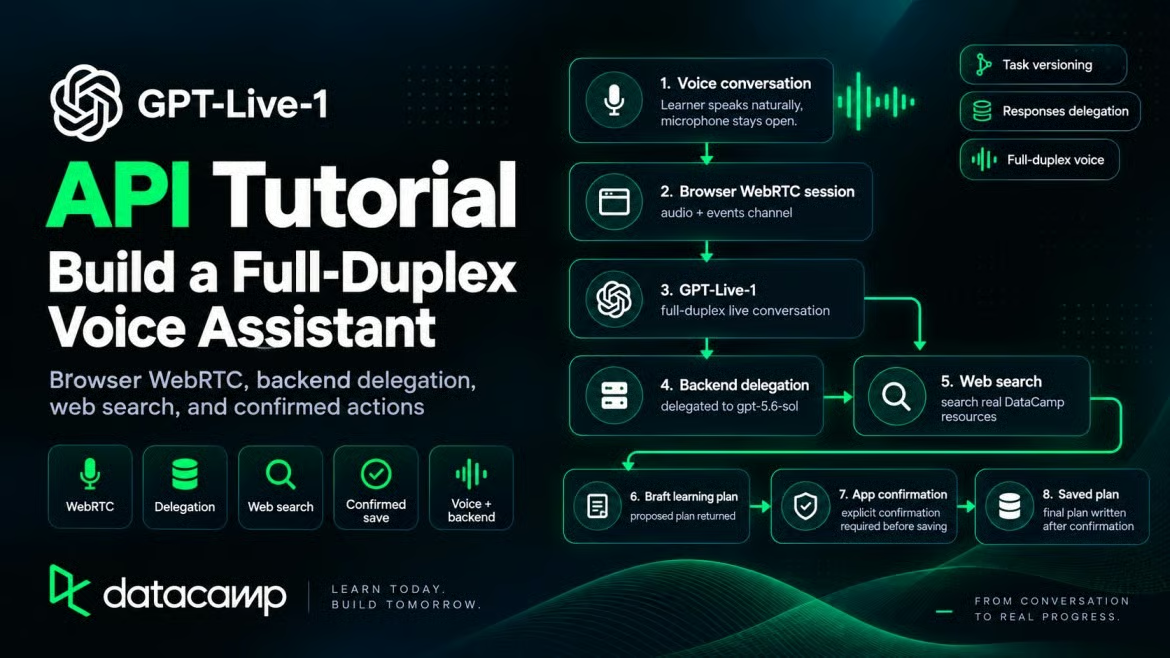
はじめてGPT-Live-1のブラウザセッションを開いたとき、従来の音声ループ——話す、待つ、返答を聞く——を想像していました。ところが実際には、アシスタントが返答している間もマイクは開いたまま。会話は堅苦しさが和らいだ一方で、アプリは裏側の処理を引き続き管理する必要がありました。
OpenAIはまず7月にChatGPTでGPT-Liveを紹介し、その後今週初めにGPT-Live-1をAPIへ提供しました。これはちょうど本記事の制作直前でした。弊社のGPT-Realtime-2.1チュートリアルは単一モデルのアプローチを扱い、GPT Live Transcribeガイドはライブ字幕に焦点を当てています。本稿では、実際のDataCampリソースを検索し、確認後にのみプランを保存する音声学習アシスタントを構築します。
私はこれをDataCamp Voice Learning Assistantと呼んでいます。これはチュートリアル用のプロトタイプであり、製品版のDataCamp AI Assistantではありません。本プロジェクトは、学習者が音声で目標を述べてからプランを保存するまでの流れを追います。
GPT-Live-1は、音声でのやり取りとバックエンド作業を切り離します。以下の4点が学習アシスタントの設計に影響しました。
これらは本稿の学習プランフローに当てはまる知見です。プロンプトやネットワークが異なれば挙動も変わり、クライアントデリゲーションでは制御境界も変わります。
GPT-Live-1は、OpenAIの全二重音声モデルです。発話のターンや割り込み(その間のポーズを含む)を扱い、検索やツール呼び出しのような長い処理はバックエンドに送ります。
学習者にとって最初に目に見える違いは、まさにそのポーズにあります。
全二重はターンテイキングを変えます。考えるために沈黙したり、アシスタントにかぶせて話したりでき、アシスタント側も話すのを止めて訂正を聞けます。OpenAIのプロンプトガイドには、短い相槌や割り込み用のセクションがあります。
学習アシスタントではこれは重要です。キャリア目標を説明する人は、途中で間を置いたり、言い直したり、制約を追加したりします。「そうですね、週5時間くらいで」といった逡巡を待てるモデルなら、学習者は考えながら話せます。
デリゲーションはタスクをバックエンドへ渡しますが、アプリケーション制御そのものは譲りません。誰が実行できるか、保存を許可するかはアプリが決め、保存するタスク状態の所有権もアプリにあります。
すでにGPT-Realtime-2.1を使っているなら、GPT-Live-1で置き換わるのかと思うかもしれません。答えはノーです。
GPT-Realtime-2.1はv1/realtimeで、リッスン・推論・ツール選択を単一モデルで担い、音声とテキストのトークンで課金されます。GPT-Live-1はv1/live/sessionsを使用し、音声レイヤーは秒単位課金、推論は別のバックエンドに送られます。
Realtime-2.1は古い・劣る選択肢ではありません。設計が異なるのです。
アプリは話された目標を受け取り、実在するDataCampリソースの優先度付きリストに変換します。バックエンドの処理中も音声セッションは開いたままです。リクエストが変わったら、バックエンドの動作を実行する前にタスクバージョンを更新します。
学習者がアプリ内で再確認するまでは、何も書き込みません。
ブラウザページはWebRTC接続とマイクを保持し、サーバーがGPT-Live-1セッションを作成しAPIキーを保持します。Responsesのバックエンド(gpt-5.6-sol)はウェブ検索と save_learning_plan 関数を使います。現在のタスクバージョンと確定済みプランはアプリ状態に保持されます。
検索中にリクエストが変化した際、どのバックエンドアクションを受け付けるかはタスクバージョンが決めます。完全な実行可能アプリはGitHubリポジトリを参照してください。以降のセクションではGPT-Liveの経路に絞って解説します。
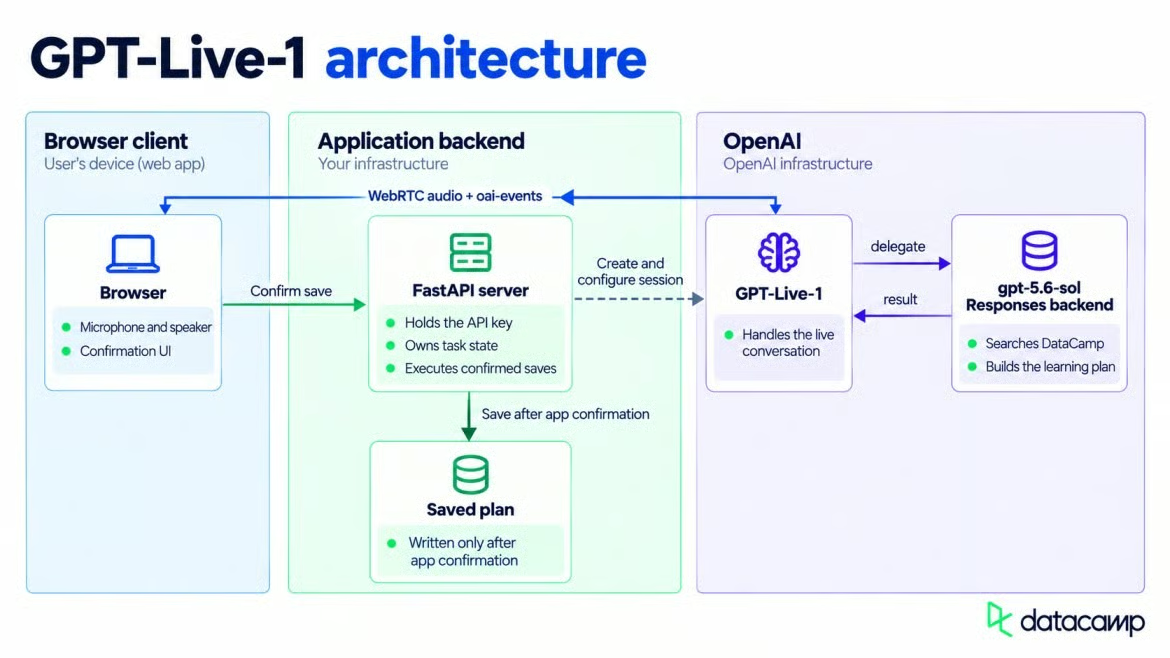
ブラウザ、GPT-Live-1、バックエンドモデルが連携。画像:筆者作成。
GPT-Live-1にアクセスできるOpenAIプロジェクト(無料枠は非対応)、Python、そしてマイク許可ダイアログのためHTTPSまたはlocalhostで動くブラウザが必要です。私はPython 3.11とopenai 3.13.0を使用しました。Live APIには少なくともopenai 3.12.0が必要で、それ以前にはクライアントに.live属性がありません。
同時セッション上限は利用プランに依存します。多数のタブを開く前にプロジェクトの制限を確認してください。
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install openai fastapi uvicorn python-dotenv streamlit requestsmacOSやLinuxでは、source .venv/bin/activate で環境を有効化してください。プロジェクトルートに.envファイルを作成し、次の値を追加します。
OPENAI_API_KEY=sk-...python-dotenvはサーバーがインポートされると自動的にそのファイルを読み込むため、キーをコード内に記載する必要はありません。
OpenAI()クライアントは、キーを渡さない場合に同じ環境変数を参照します。
ブラウザはプロジェクトキーを参照しません。WebRTCのオファーをサーバーへPOSTし、サーバーがキーを用いてセッションを作成します。SDP交換後、ブラウザはキーを受け取ることなくWebRTC経由でOpenAIに音声を送ります。
内部の/api/session のGPT-Live呼び出しは、SDPオファーからセッションを作成します。音声向けの指示、バックエンドモデル、ウェブ検索、保存関数を同一リクエストで渡します。
result = client.live.create(
    session={
        "model": "gpt-live-1",
        "instructions": LIVE_INSTRUCTIONS,
        "delegation": {
            "type": "responses",
            "responses": {
                "model": "gpt-5.6-sol",
                "instructions": BACKEND_INSTRUCTIONS,
                "tools": [
                    {
                        "type": "web_search",
                        "filters": {
                            "allowed_domains": ["datacamp.com", "www.datacamp.com"]
                        },
                    },
                    SAVE_LEARNING_PLAN_TOOL,
                ],
                "tool_choice": "auto",
            },
        },
    },
    transport={"type": "webrtc", "sdp": sdp},
)この呼び出しはPOST /v1/live/sessions へのリクエストを送り、セッションIDとSDPアンサーを返します。HTTPリクエストがセッションを開始するため、その後に別途session.start イベントを送らないでください。
サンプルサーバーは、ブラウザからのリクエストをlocalhost:8501と127.0.0.1:8501のみ受け付けます。このルールはローカル用です。
デプロイ時は、これらのオリジンを置き換え、/api/sessionと/api/save-planの双方を認証してください。各リクエストはコストと同時実行枠を消費し得るため、セッション作成はレート制限をかけてください。クライアントは自らconfirmed: trueを送れるので、公開サーバーはその値を本人確認の証拠として扱えません。
OpenAIのWebRTCガイドに従い、ブラウザはマイクアクセスを要求し、RTCPeerConnectionを開きます。ドキュメントどおりのoai-events というデータチャネルのラベルを使い、SDPオファー生成前に作成します。セッション開始後は、そのチャネルで双方向にJSONイベントが流れます。
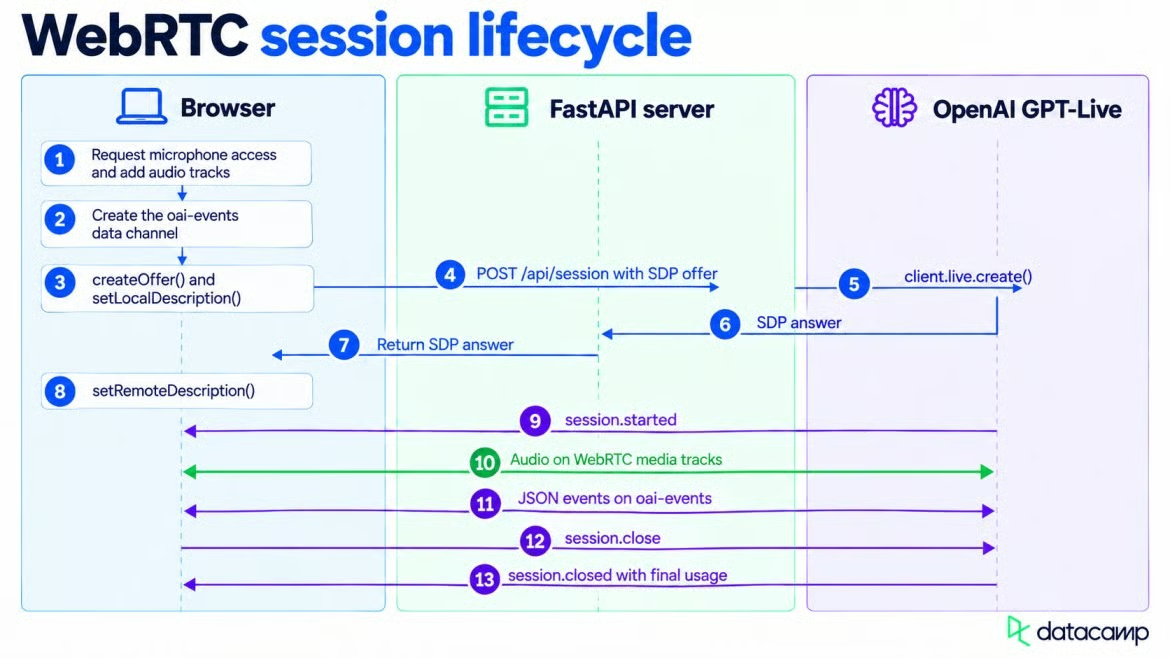
WebRTCは開始し、音声をストリームし、正常終了します。画像:筆者作成。
メディアのセットアップ自体は通常のWebRTCです。GPT-Liveのイベントは最後の行で作成したデータチャネルを使います。
const connection = new RTCPeerConnection();
connection.addEventListener("track", (event) => {
  audio.srcObject = new MediaStream([event.track]);
  audio.play();
});
const microphone = await navigator.mediaDevices.getUserMedia({ audio: true });
for (const track of microphone.getAudioTracks()) {
  connection.addTrack(track, microphone);
}
const events = connection.createDataChannel("oai-events");オファーを作成したら、ブラウザはsetLocalDescription() を呼び、ICE収集の完了を待ちます。ローカルSDPを/api/session に送り、OpenAIのアンサーをsetRemoteDescription() で適用します。マイクの音声とアシスタントの音声はメディアトラックで運ばれるため、別途音声認識と音声合成のリクエストは不要です。
音声はoai-events に載せるものではありません。WebRTCのデータチャネルでsession.input_audio.append を送ったり、session.output_audio.delta を待ったりしないでください。
データチャネルは別のタイミング規則に従います。session.started を待ってからoai-events経由でイベントを送ってください。最初の試行では早すぎるタイミングで送ってしまい、接続に無視されました。
有用なエラーは出ず、小さな順序ミスの追跡に手こずりました。
字幕表示が不要であれば、このサブセクションは飛ばして構いません。音声接続はすでに完成しています。
session.input_transcript.delta と session.output_transcript.delta は、ライブ字幕用にミリ秒オフセット付きのテキスト断片を返します。OpenAIのドキュメントでは、これらの断片が会話ターンの完了を意味しないことに注意喚起があります。配信は不均一で、ユーザーとアシスタントの区間が重なることがあります。
トランスクリプト断片は届き次第画面に追加しますが、そこからバックエンド作業を開始しないでください。どのタイミングでデリゲートするかはモデルが決めます。
Liveモデルの指示は短く保ちます。OpenAIのガイドでは、詳細な手順はバックエンドのプロンプトに置くとしています。私は手順をバックエンド側に収め、Liveのプロンプトは音声に集中させました。
以下の抜粋は、音声のふるまいを学習プランのタスクから切り離しています。発話ルールはデリゲーションを引き起こす条件より上に置いています。
You are Sage, a warm, encouraging voice learning coach for DataCamp learners.
Speak naturally at an unhurried pace. Be clear and direct, not overly cheerful.

Backchannel policy: Use moderate backchannels without competing with the response.
Interruption policy: Stop speaking when the learner interrupts, and listen.

Delegation policy:
Backend tools:
- learning_plan_research: search DataCamp resources and assemble a personalized learning plan.
- save_learning_plan: propose the current plan for app confirmation when the learner asks to save.

Delegate to the backend when:
- The learner states or changes a goal, skill level, or weekly time.
- A correction changes the plan already requested.
- The learner asks to save the plan.

Do not delegate for greetings, small clarifications, or a result already given.

Saving: a proposed save only asks the app to confirm. Do not say the plan is saved until the app reports a saved result.
After a save, keep the conversation open and ask what the learner wants next.
これらのルールにより、挨拶はLive層に残し、調査や保存リクエストはバックエンドに送られます。最終的な確認は依然としてアプリ側の責務です。
相槌と割り込みの指示は、ポーズ周りの応答方法を定めます。「ほどよい相槌」は、「うんうん」のような控えめな合図をときどき入れつつ、相手の発話を妨げないことを意味します。学習者が考える余白を残すため、その程度に設定しました。ポーズが長いレッスンでは、さらに相槌を減らす選択もあります。
アプリに別のふるまいが必要であれば、その一文を変更してください。「ユーザーが話している間は決して話さない」を加えると、相槌もなくなります。
2つのプロンプトは役割が異なります。Liveのプロンプトは発話と引き継ぎを制御し、バックエンドのプロンプトは調査と回答形式を制御します。OpenAIのガイドは、詳細な検索手順を音声の指示に入れないよう助言しています。
前述の分離は、セッションのdelegation フィールドに現れます。学習者が目標を述べると、GPT-Liveはコースカタログを検索してプランを作成できるモデルにタスクを送ります。
GPT-Live-1はResponsesのデリゲーションとクライアントデリゲーションを提供します。ResponsesのデリゲーションではOpenAIがバックエンド呼び出しを管理し、クライアントデリゲーションではそれを自前コードに委ねます。本アプリでは追加のバックエンドループを避けるため、Responsesのデリゲーションを採用しました。
使用したのはgpt-5.6-solです。OpenAIのデリゲーションガイドは例としてgpt-5.6-terra を起点に挙げ、低コスト用途にはgpt-5.6-lunaを記載しています。Solでは、バックエンドは要求したプラン構造を返しました。
バックエンドがウェブ検索や保存関数を選べるよう、tool_choice はauto に設定します。デリゲーションの方式は起動時に固定されるため、クライアントデリゲーションへ切り替えるには、現在のセッションを閉じて新たに作成してください。
Liveプロンプトのルールは単純です:挨拶や短い質問はLiveモデルに留め、学習プランやその変更はバックエンドへ送ります。APIがその境界を強制するわけではありません。アプリで想定されるリクエストでテストしてください。判断はモデルが行います。
デリゲート後、バックエンドのタスクは一つ:学習者の目標を、リンク付きの簡潔なDataCampリソースリストに変換します。そのためにweb_search ツールを与え、filters.allowed_domains をdatacamp.comとwww.datacamp.comに設定しました。これは検索の指示であって、各リンクの正しさを保証するものではないと考えてください。
サンプルの目標は、週5時間、Pythonは少し知っていて、SQLは未経験のデータエンジニアリング学習パスです。応答はまずHow to Learn Data Engineering From Scratch in 2026と、Associate Data Engineer in SQLトラックから始まります。
残りの項目は、プロジェクト、Pythonのデータベースコース、別のトラック、最後にパイプラインプロジェクトを組み合わせています。掲載されたURLはすべて既存のDataCampページを開きます。
バックエンドのプロンプトでは、4~7件の順序付き項目を要求します。各項目には、タイトル、URL、簡潔な理由、course、project、track、article のいずれかのタイプがあります。構成は、学習者の希望する形式や週の学習時間に合わせます。
ページに記載がない場合にコースの所要時間を推測するようには求めていません。その場合に正確な数値を出すのは、出典以上の主張になってしまうためです。
GPT-Liveは、Responsesのバックエンドが処理している間も音声セッションを維持できます。最初のプランが返る前に学習者がハンズオン必須という制約を追加しても、元のバックエンド処理は自動ではキャンセルされません。
話し言葉での訂正は、すでにバックエンドで始まっている作業を自動でキャンセル・書き換えしません。アシスタントの発話を中断することと、タスクを変更することは別の行為です。過去の結果をどう扱うかはアプリケーションが決めます。
サーバーはtask_version カウンタを保持し、新たなデリゲーションが始まるたびにインクリメントします。結果が届いたとき、アプリはバージョンを確認してから処理します。自前のハンドラは古い結果をログに残し、実行しません。
Responsesのデリゲーションには限界があります:Liveモデルはバックエンド結果を直接受け取るため、バージョンチェックで次の発話内容を完全には制御できません。クライアントデリゲーションなら、モデルに届く前に古い結果を破棄できます。したがってタスクバージョンは、アプリのアクションを保護するものであり、アシスタントの発話のすべてを保護するわけではありません。
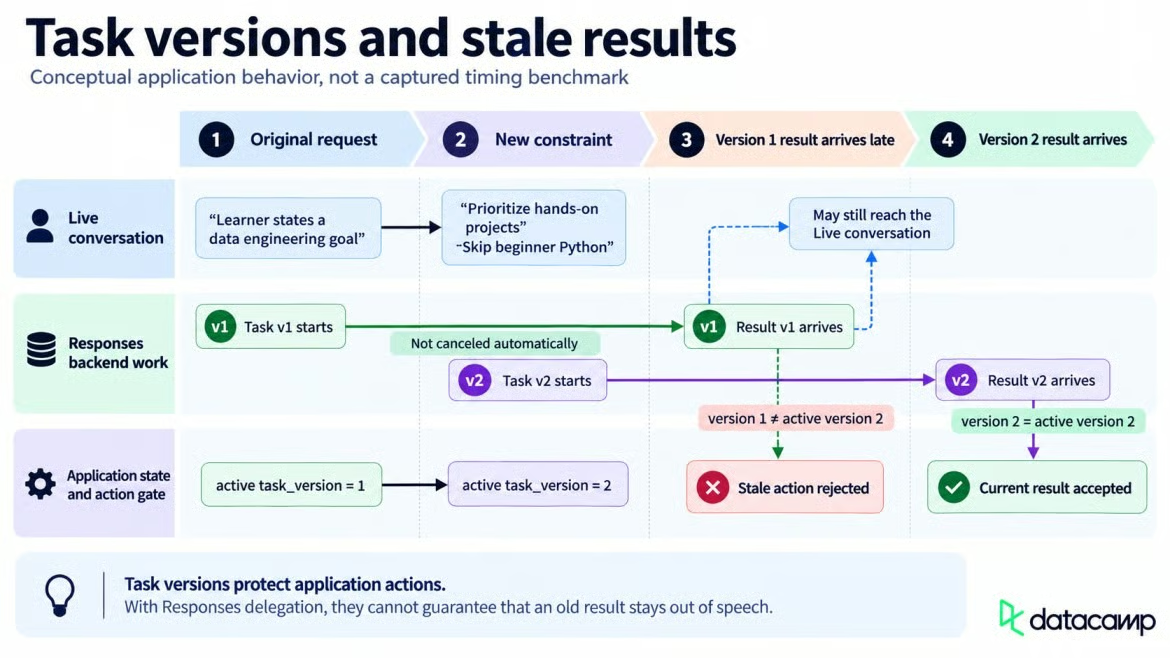
タスクバージョンにより新しい制約が有効に。画像:筆者作成。
最初のバックエンド応答が完了した後、私は「ハンズオンのプロジェクト中心で、初級Pythonは除外」という追記をしました。改訂された7件のプランはIntroduction to SQLから始まり、1件のトラック、2件のコース、4件のプロジェクト(Exploring London's Travel NetworkやBuilding a Retail Data Pipelineを含む)を組み合わせていました。これは完了済みターン間の改訂を示すもので、進行中の応答停止については何も示しません。
バックエンド作業中、3種類のappendイベントでLiveモデルを更新できます。session.thinking.append は発話しない文脈を追加し、session.commentary.append はモデルが自分の言葉で話すべきテキストを追加し、session.instructions.appendは指示を変更します。
各appendは最大500トークンのプレーン文字列を運びます。これらはLiveモデルの文脈やふるまいを更新しますが、進行中のResponsesタスクを変更・キャンセルするものではありません。instructionsは現在のLiveのふるまいを方向付け、commentaryはモデルが音声で伝えるべき情報を与えます。
ダッシュボードはバックエンドの進行を記録しますが、これらのappendイベントは送信しません。Responsesのデリゲーションでも、アプリからの更新をoai-events経由で送れますが、その際はdelegation_id: nullを使います。非nullのdelegation IDはクライアントデリゲートされたタスクに使われます。
アプリケーション状態にはtask_id とtask_version を保持し、どちらにもdelegation_id を使わないでください。
本アプリでは、モデルの返答だけでは何も保存されません。バックエンドはsave_learning_plan で保留中のアクションを提案し、実際の書き込みは/api/save-planが担います。
バックエンドの関数呼び出しはresponse.event 内に届きます。ハンドラは入れ子のresponse.output_item.done 項目を待ち、そこからcall_id、name、argumentsを読み取ります。
完了項目を待つことが重要です。より前のイベントは呼び出しの一部しか含まないことがあるためです。アプリは引数を解析しますが、まだ関数は実行しません。
SAVE_LEARNING_PLAN_TOOL = {
    "type": "function",
    "name": "save_learning_plan",
    "description": "Propose the current learning plan for confirmation when the learner asks to save.",
    "parameters": {
        "type": "object",
        "properties": {
            "goal": {"type": "string"},
            "weekly_hours": {"type": "number"},
            "items": {
                "type": "array",
                "items": {
                    "type": "object",
                    "properties": {
                        "title": {"type": "string"},
                        "url": {"type": "string"},
                        "reason": {"type": "string"},
                        "type": {
                            "type": "string",
                            "enum": ["course", "project", "track", "article"],
                        },
                    },
                    "required": ["title", "url", "reason", "type"],
                    "additionalProperties": False,
                },
            },
        },
        "required": ["goal", "weekly_hours", "items"],
        "additionalProperties": False,
    },
    "strict": True,
}このスキーマにより、アプリは確認前に表示する項目を固定のフィールドセットで扱えます。type フィールドで、コース・プロジェクト・トラック・記事の別を保存データ上も明確にします。
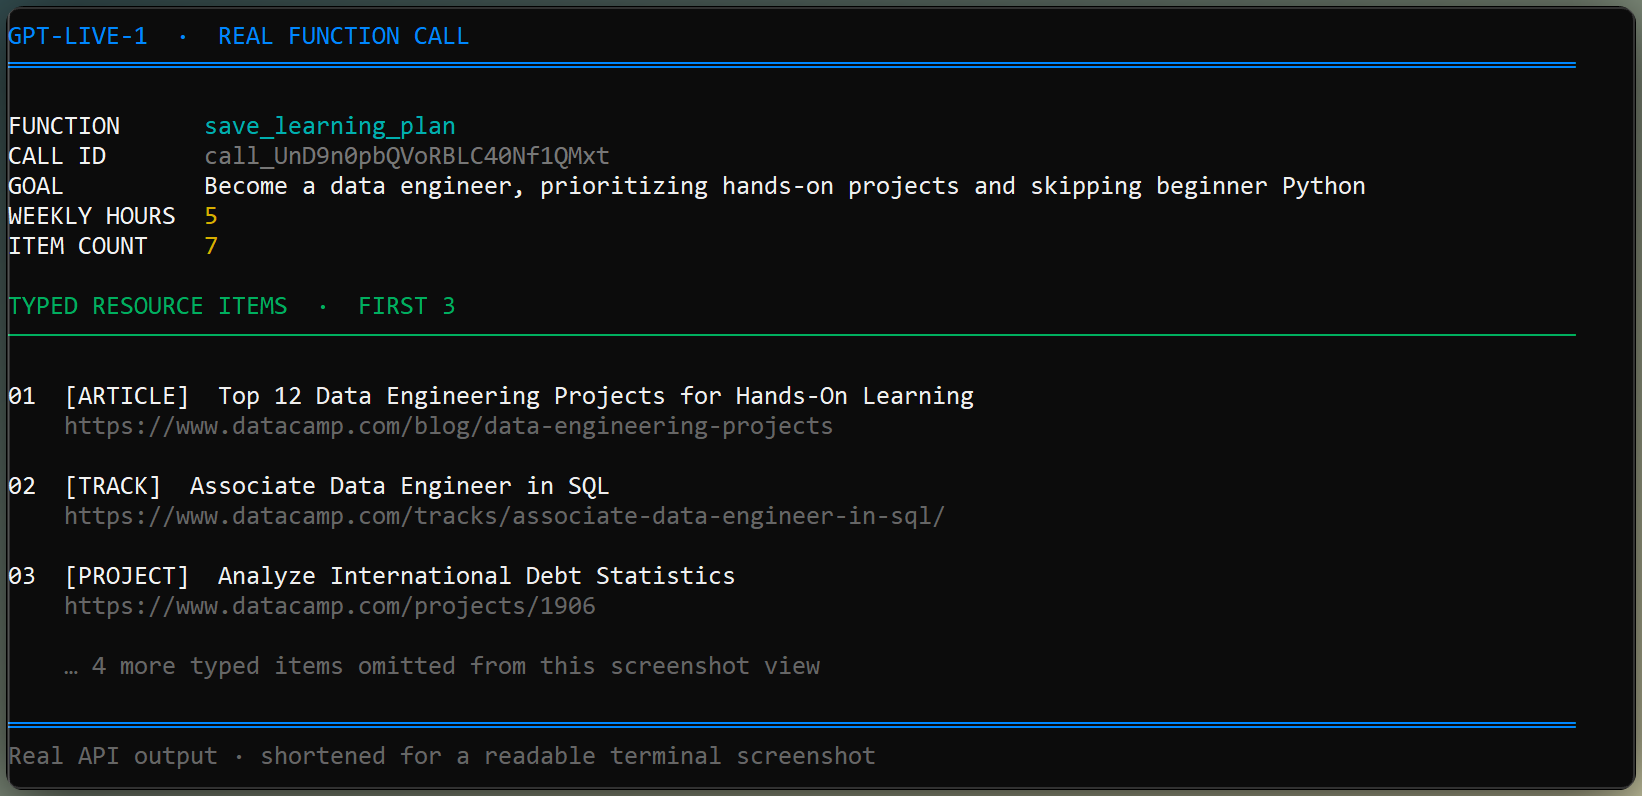
ターミナルに型付きの保存関数引数が表示。画像:筆者作成。
学習者が保存を求めると、バックエンドはsave_learning_plan をプラン全体で呼びます。ウィジェットはその引数を保持し、確認ダイアログを表示しますが、呼び出しはあくまで提案のままです。
その関数呼び出しを未応答のままにすると、委譲した応答や後続のバックエンドターンがブロックされます。ウィジェットは直ちに「確認待ち」の結果で応答し、その後response.create を送って会話を継続させます。
events.send(JSON.stringify({
  type: "response.item.create",
  item: {
    type: "function_call_output",
    call_id: callId,
    output: JSON.stringify({
      status: "awaiting_user_confirmation",
      saved: false,
    }),
  },
}));
events.send(JSON.stringify({ type: "response.create" }));
この時点では何も書き込まれません。アシスタントは「確認して保存」ボタンへ学習者を誘導しつつ、以降の委譲処理を妨げません。
/api/save-plan エンドポイントは、confirmed がtrueでなければ書き込みを拒否します。トランスクリプトは誤りや不完全さを含み得るため、音声での依頼だけでは保存しません。
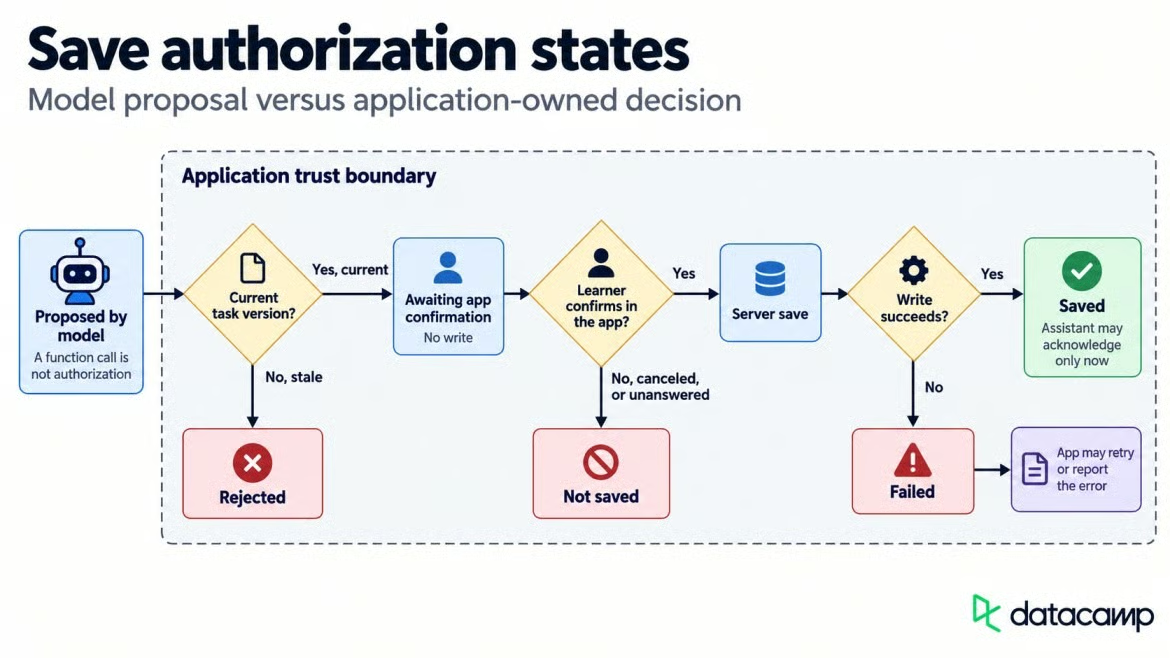
確認が、リクエストと保存済みアクションを分けます。画像:筆者作成。
Confirmのクリックで/api/save-plan へ保留中のプランとconfirmed: trueを送ります。サーバーからプランIDが返ったら、ウィジェットはsession.commentary.append をdelegation_id: null で送ります。元の関数呼び出しにはすでに応答済みだからです。
const saveResponse = await fetch(${SERVER}/api/save-plan, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    confirmed: true,
    plan: pendingFunctionCall.args,
  }),
});
const saveResult = await saveResponse.json();

events.send(JSON.stringify({
  type: "session.commentary.append",
  delegation_id: null,
  content: The plan was saved as ${saveResult.plan_id}.,
}));
commentaryの更新は、書き込み完了をLiveモデルへ伝え、保存を音声で確認させます。先の関数呼び出しはクローズされたままで、音声セッションは学習者の次のリクエストに引き続き利用できます。
前述のGitHubリポジトリには、FastAPIサーバー、Streamlitインターフェース、そしてapp/ 配下のWebRTCウィジェットが含まれています。クローン後、そのフォルダで2つのターミナルを開き、一方でuvicorn server:app --host 127.0.0.1 --port 8000、もう一方でstreamlit run streamlit_app.py を実行します。
Streamlitインターフェースは、本稿全体で用いたサーバーとウィジェットを同梱しています。ライブの会話を、学習プランやバックエンドの活動状況の隣に配置し、ダッシュボードは通話をリセットせずに更新します。
以下のビデオは、音声での目標、バックエンド検索、改訂プラン、確定保存までを追っています。保存後も通話は開いたままで、学習者は続けられます。
DataCampで学ぶ
Courses
Courses
Courses