
Kurs
So funktioniert Prompt Engineering
1 Std.
230.3K
Als ich zum ersten Mal eine GPT-Live-1-Browsersitzung geöffnet habe, erwartete ich den üblichen Sprach-Loop: sprechen, warten, Antwort hören. Stattdessen blieb das Mikrofon offen, während der Assistent antwortete. Das Gespräch fühlte sich weniger starr an, aber die App musste die dahinterliegende Arbeit weiterhin steuern.
OpenAI hat GPT-Live in ChatGPT im Juli vorgestellt und GPT-Live-1 kurz darauf in die API gebracht – genau rechtzeitig für dieses Projekt. Unser GPT-Realtime-2.1-Tutorial erklärt den Ein-Modell-Ansatz, während unser GPT Live Transcribe Guide sich auf Live-Untertitel konzentriert. Hier baust du einen Sprachlernassistenten, der echte DataCamp-Ressourcen durchsucht und einen Plan erst nach Bestätigung speichert.
Ich nenne ihn den DataCamp Voice Learning Assistant. Es ist ein Tutorial-Prototyp, nicht der produktive DataCamp AI Assistant. Das Projekt begleitet einen Lernenden vom gesprochenen Ziel bis zum gespeicherten Plan.
GPT-Live-1 trennt den gesprochenen Austausch von der Backend-Arbeit. Vier Punkte prägen den Lernassistenten.
Diese Punkte gelten für diesen Lernplan-Flow. Ein anderer Prompt oder ein anderes Netzwerk kann das Verhalten ändern, und Client-Delegation verschiebt die Kontrollgrenze.
GPT-Live-1 ist OpenAIs Full-Duplex-Sprachmodell. Es beherrscht gesprochene Turns und Unterbrechungen – inklusive der Pausen dazwischen – und delegiert längere Arbeiten wie Suche oder Toolaufrufe an ein Backend.
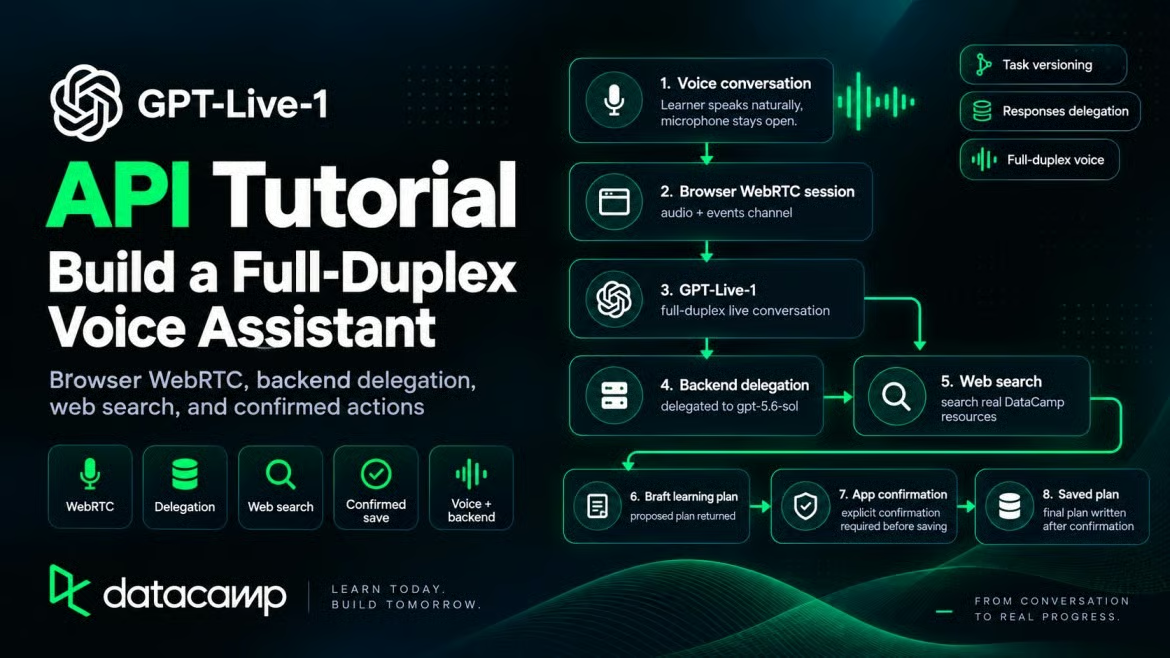
Für Lernende zeigt sich der erste Unterschied in genau diesen Pausen.
Full Duplex verändert das Wechselspiel. Du kannst eine Pause machen oder dem Assistenten ins Wort fallen, und er stoppt, um die Korrektur zu hören. OpenAIs Prompting-Guide zeigt Prompt-Abschnitte für kurze Bestätigungen und Unterbrechungen.
Das ist für einen Lernassistenten wichtig. Wer ein Karriereziel beschreibt, pausiert, setzt neu an oder ergänzt unterwegs eine Einschränkung. Ein Modell, das bei „also, ich glaube, vielleicht fünf Stunden pro Woche“ geduldig wartet, lässt Lernende laut denken.
Delegation verschiebt eine Aufgabe ins Backend, übergibt aber nicht die App-Kontrolle. Die App entscheidet weiterhin, wer handeln darf und ob gespeichert wird. Sie besitzt auch den gespeicherten Task-Status.
Wenn du GPT-Realtime-2.1 genutzt hast, fragst du dich vielleicht, ob GPT-Live-1 es ersetzt. Nein.
GPT-Realtime-2.1 übernimmt Zuhören, Reasoning und Toolwahl in einem Modell über v1/realtime und wird nach Audio- und Text-Tokens abgerechnet. GPT-Live-1 nutzt v1/live/sessions, berechnet die Voice-Schicht pro Sekunde ab und schickt das Reasoning an ein separates Backend.
Realtime-2.1 ist keine ältere oder „schlechtere“ Option. Es folgt einfach einem anderen Design.
Die App nimmt ein gesprochenes Ziel auf und wandelt es in eine geordnete Liste echter DataCamp-Ressourcen um. Die Sprachsitzung bleibt während der Backend-Arbeit offen. Ändert sich die Anfrage, aktualisiert die App ihre Task-Version, bevor eine Backend-Aktion ausgeführt wird.
Gespeichert wird erst, wenn der Lernende zusätzlich in der App bestätigt.
Die Browserseite hält die WebRTC-Verbindung und das Mikrofon, während der Server die GPT-Live-1-Sitzung erstellt und den API-Schlüssel behält. Ein Responses-Backend (gpt-5.6-sol) nutzt Websuche und die save_learning_plan Funktion. Die aktuelle Task-Version und der bestätigte Plan bleiben im App-Status.
Die Task-Version entscheidet, welche Backend-Aktion die App akzeptiert, wenn sich eine Anfrage während einer Suche ändert. Nutze das GitHub-Repository für die komplette lauffähige App; die nächsten Abschnitte fokussieren den GPT-Live-Pfad.
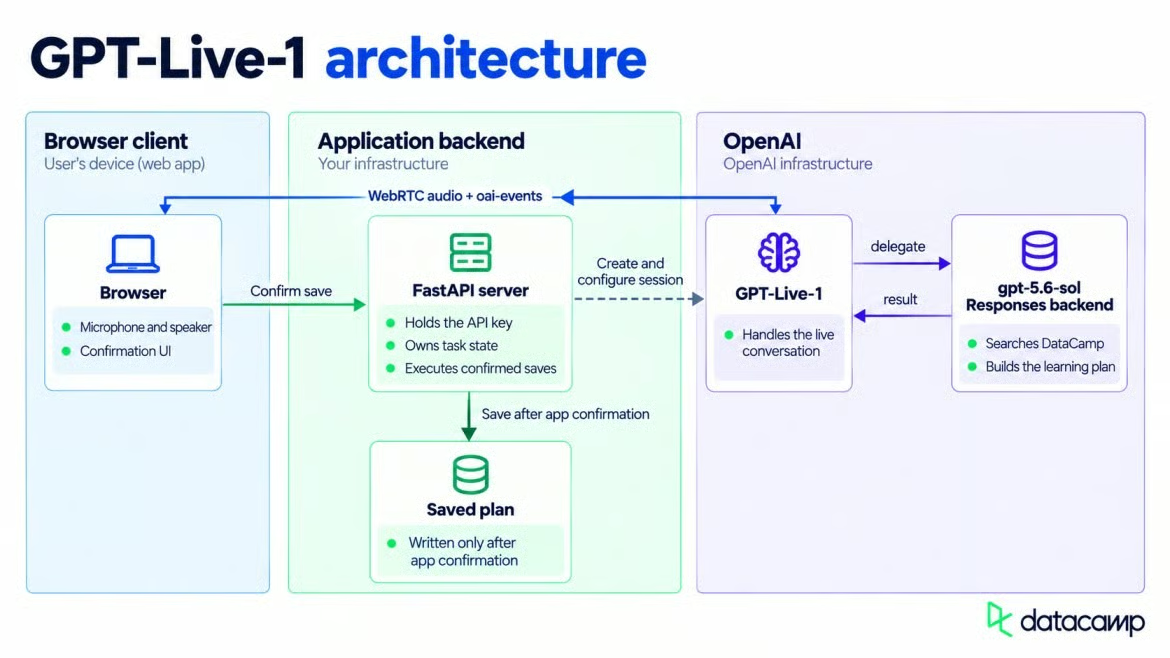
Browser, GPT-Live-1 und Backend-Modell sind verbunden. Bild: Autor.
Du brauchst ein OpenAI-Projekt mit GPT-Live-1-Zugang (der Free-Tarif unterstützt es nicht), Python und einen Browser unter HTTPS oder localhost, damit die Mikrofonabfrage erscheint. Ich habe Python 3.11 und openai 3.13.0 verwendet. Die Live-API benötigt mindestens openai 3.12.0; ältere Versionen haben kein .live Attribut am Client.
Gleichzeitige Sitzungen hängen von deinem Nutzungstarif ab. Prüfe das Projektlimit, bevor du viele Browser-Tabs öffnest.
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install openai fastapi uvicorn python-dotenv streamlit requests
Unter macOS oder Linux aktivierst du die Umgebung mit source .venv/bin/activate stattdessen. Lege im Projektstamm eine .env-Datei an und füge diesen Wert hinzu.
OPENAI_API_KEY=sk-...python-dotenv lädt die Datei automatisch, sobald der Server sie importiert – der Schlüssel muss also nie im Code auftauchen.
Der OpenAI()-Client liest dieselbe Umgebungsvariable, wenn du keinen Schlüssel übergibst.
Der Browser sieht deinen Projektschlüssel nie. Er sendet ein WebRTC-Angebot an deinen Server, der mit dem Schlüssel die Sitzung erstellt. Nach dem SDP-Austausch sendet der Browser Audio über WebRTC an OpenAI, ohne den Schlüssel zu erhalten.
Der GPT-Live-Aufruf innerhalb von /api/session erstellt die Sitzung aus dem SDP-Angebot. Er übergibt in derselben Anfrage die Sprachinstruktionen, das Backend-Modell, die Websuche und die Speicherfunktion.
result = client.live.create(
    session={
        "model": "gpt-live-1",
        "instructions": LIVE_INSTRUCTIONS,
        "delegation": {
            "type": "responses",
            "responses": {
                "model": "gpt-5.6-sol",
                "instructions": BACKEND_INSTRUCTIONS,
                "tools": [
                    {
                        "type": "web_search",
                        "filters": {
                            "allowed_domains": ["datacamp.com", "www.datacamp.com"]
                        },
                    },
                    SAVE_LEARNING_PLAN_TOOL,
                ],
                "tool_choice": "auto",
            },
        },
    },
    transport={"type": "webrtc", "sdp": sdp},
)
Dieser Aufruf sendet eine Anfrage an POST /v1/live/sessions und liefert eine Sitzungs-ID mit SDP-Antwort. Die HTTP-Anfrage startet die Sitzung – sende danach kein separates session.start-Event.
Der Beispielserver akzeptiert Browseranfragen nur von localhost:8501 und 127.0.0.1:8501. Diese Regel ist nur für den lokalen Einsatz.
Bei einem Deployment ersetzt du diese Origins und authentifizierst sowohl /api/session als auch /api/save-plan. Limitiere die Rate für Sitzungserstellung, da jede Anfrage Geld kosten und Concurrency verbrauchen kann. Ein Client kann selbst confirmed: true senden – ein öffentlicher Server darf dieses Feld nicht als Identitätsnachweis werten.
Nach OpenAIs WebRTC-Guide fragt der Browser Mikrofonzugriff an und öffnet eine RTCPeerConnection. Verwende das dokumentierte oai-events Data-Channel-Label und erstelle es vor dem SDP-Angebot. Dieser Kanal transportiert nach Start JSON-Events in beide Richtungen.
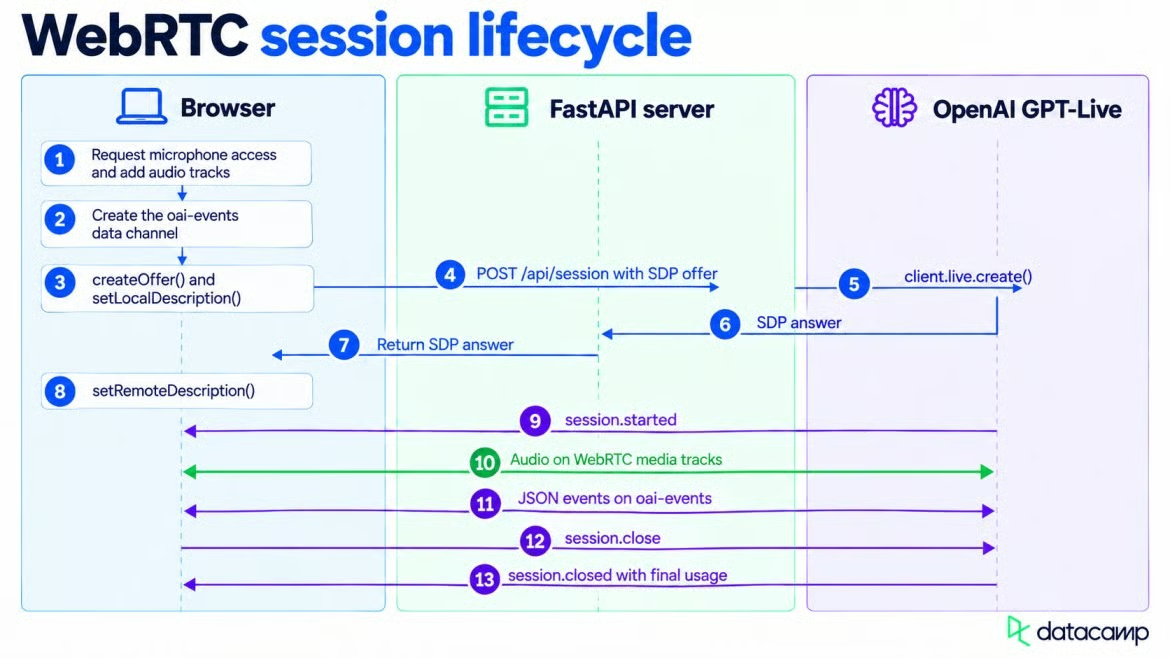
WebRTC startet, streamt Audio und schließt sauber. Bild: Autor.
Das Mediensetup ist normales WebRTC. GPT-Live-Events nutzen den im letzten Schritt erstellten Data-Channel.
const connection = new RTCPeerConnection();
connection.addEventListener("track", (event) => {
  audio.srcObject = new MediaStream([event.track]);
  audio.play();
});
const microphone = await navigator.mediaDevices.getUserMedia({ audio: true });
for (const track of microphone.getAudioTracks()) {
  connection.addTrack(track, microphone);
}
const events = connection.createDataChannel("oai-events");
Nach dem Erstellen des Angebots ruft der Browser setLocalDescription() auf und wartet, bis ICE-Gathering abgeschlossen ist. Er sendet die lokale SDP an /api/session und übernimmt OpenAIs Antwort mit setRemoteDescription(). Mikrofon-Audio und die Sprache des Assistenten laufen über die Medienspuren – separate Anfragen für Speech-to-Text und Text-to-Speech sind nicht nötig.
Audio gehört nicht auf oai-events. Sende dort kein session.input_audio.append und warte nicht auf session.output_audio.delta auf einem WebRTC-Data-Channel.
Der Data-Channel folgt einer anderen Taktung. Warte auf session.started bevor du Events über oai-events sendest. Beim ersten Versuch war ich zu früh – die Verbindung ignorierte das Event.
Es gab keinen hilfreichen Fehlerhinweis – eine kleine Reihenfolgen-Panne war dadurch zäh zu finden.
Wenn du keine sichtbaren Untertitel brauchst, kannst du diesen Abschnitt überspringen; die Audioverbindung steht bereits.
session.input_transcript.delta und session.output_transcript.delta liefern Textfragmente mit Millisekunden-Offsets für Live-Untertitel. OpenAI weist darauf hin, dass Transkript-Fragmente keine abgeschlossenen Turns sind. Die Zustellung kann ungleichmäßig sein, Zeitintervalle von Nutzer und Assistent können überlappen.
Füge Fragmente beim Eintreffen auf dem Bildschirm an, starte daraus aber keine Backend-Arbeit. Das Modell entscheidet, wann es delegiert.
Die Live-Instruktionen sollten kurz sein. OpenAIs Leitfaden verlagert detaillierte Arbeitsschritte in den Backend-Prompt. Ich habe die Vorgehensweise dort belassen und den Live-Prompt auf die Sprache fokussiert.
Dieser Auszug trennt Sprachverhalten vom Lernplan-Task. Sprachregeln stehen oberhalb der Bedingungen, die die Delegation auslösen.
You are Sage, a warm, encouraging voice learning coach for DataCamp learners.
Speak naturally at an unhurried pace. Be clear and direct, not overly cheerful.

Backchannel policy: Use moderate backchannels without competing with the response.
Interruption policy: Stop speaking when the learner interrupts, and listen.

Delegation policy:
Backend tools:
- learning_plan_research: search DataCamp resources and assemble a personalized learning plan.
- save_learning_plan: propose the current plan for app confirmation when the learner asks to save.

Delegate to the backend when:
- The learner states or changes a goal, skill level, or weekly time.
- A correction changes the plan already requested.
- The learner asks to save the plan.

Do not delegate for greetings, small clarifications, or a result already given.

Saving: a proposed save only asks the app to confirm. Do not say the plan is saved until the app reports a saved result.
After a save, keep the conversation open and ask what the learner wants next.
Diese Regeln lassen Begrüßungen in der Live-Schicht und schicken Recherche oder Speicherung ins Backend. Die Bestätigung bleibt Sache der App.
Backchannel- und Unterbrechungszeilen steuern Reaktionen rund um Pausen. „Moderate Backchannels“ bittet um gelegentliche Bestätigungen wie „mhm“, ohne jede Stille zu füllen. So bleibt Raum zum Nachdenken; Lektionen mit längeren Pausen brauchen ggf. weniger Backchannels.
Passe die Zeile an, falls deine App anderes Verhalten braucht; „sprich nie, während der User spricht“ entfernt Backchannels vollständig.
Die zwei Prompts haben unterschiedliche Aufgaben. Der Live-Prompt steuert Sprache und Handover, der Backend-Prompt Recherche und Antwortformat. OpenAI rät, detaillierte Suchschritte nicht in die Sprachinstruktionen zu legen.
Die zuvor beschriebene Trennung erscheint im Feld delegation der Sitzung. Wenn der Lernende ein Ziel nennt, schickt GPT-Live die Aufgabe an ein Modell, das unseren Kurskatalog durchsuchen und den Plan erstellen kann.
GPT-Live-1 bietet Responses-Delegation und Client-Delegation. Bei Responses-Delegation verwaltet OpenAI den Backend-Aufruf; Client-Delegation übergibt ihn an deinen Code. Ich nutze Responses-Delegation, um in dieser App eine weitere Backend-Schleife zu vermeiden.
Ich habe gpt-5.6-sol verwendet. OpenAIs Delegationsleitfaden nutzt gpt-5.6-terra als Einstieg und nennt gpt-5.6-luna für günstigere Aufgaben. Mit Sol kam der gewünschte Planaufbau zuverlässig zurück.
Lass tool_choice auf auto stehen, damit das Backend zwischen Websuche und Speicherfunktion wählen kann. Der Delegationsmodus ist beim Start festgelegt; wechsle zur Client-Delegation, indem du die aktuelle Sitzung schließt und eine neue erstellst.
Die Regel im Live-Prompt ist einfach: Begrüßungen und kurze Rückfragen bleiben beim Live-Modell, ein Lernplan oder eine Änderung daran geht ans Backend. Die API erzwingt diese Grenze nicht. Teste mit den Anfragen, die deine App erwartet – das Modell entscheidet selbst.
Nach der Delegation hat das Backend eine Aufgabe: Das Ziel des Lernenden in eine kurze Liste von DataCamp-Ressourcen mit Links zu übersetzen. Ich habe das web_search Tool mit filters.allowed_domains auf datacamp.com und www.datacamp.com begrenzt. Behandle diesen Filter als Suchanweisung, nicht als Beweis, dass jeder Link korrekt ist.
Das Beispielziel: ein Data-Engineering-Pfad mit 5 Stunden pro Woche, etwas Python-Kenntnissen und keiner SQL-Erfahrung. Die Antwort beginnt mit How to Learn Data Engineering From Scratch in 2026 und dem Associate Data Engineer in SQL Lernpfad.
Die weiteren Einträge mischen ein Projekt, einen Python-Datenbankkurs, einen weiteren Lernpfad und ein abschließendes Pipeline-Projekt. Jede aufgeführte URL führt auf eine bestehende DataCamp-Seite.
Der Backend-Prompt verlangt vier bis sieben geordnete Einträge. Jeder Eintrag enthält Titel, URL, kurze Begründung und den Typ course, project, track oder article. Die Mischung folgt dem gewünschten Format und der wöchentlichen Zeit des Lernenden.
Ich habe das Modell nicht gebeten, Kursdauern zu raten, wenn sie auf der Seite fehlen. Eine exakte Zahl würde dort mehr behaupten, als die Quelle hergibt.
GPT-Live kann die Sprachsitzung aktiv halten, während das Responses-Backend arbeitet. Fügt der Lernende die „Hands-on“-Einschränkung hinzu, bevor der erste Plan zurückkommt, wird die ursprüngliche Backend-Arbeit nicht automatisch abgebrochen.
Eine gesprochene Korrektur storniert oder überschreibt begonnene Backend-Arbeit nicht automatisch. Das Unterbrechen der Sprachausgabe des Assistenten und das Ändern der Aufgabe sind getrennte Aktionen. Die Anwendung entscheidet, was mit dem älteren Ergebnis passiert.
Der Server führt einen task_version Zähler und erhöht ihn bei jeder neuen Delegation. Wenn ein Ergebnis eintrifft, prüft die App dessen Version, bevor sie handelt; veraltete Ergebnisse werden geloggt und nicht ausgeführt.
Responses-Delegation hat hier eine Grenze: Das Live-Modell erhält das Backend-Ergebnis direkt, daher kann die Versionsprüfung nicht jede nächste gesprochene Antwort steuern. Client-Delegation erlaubt deinem Code, ein altes Ergebnis zu verwerfen, bevor es das Modell erreicht. Die Task-Version schützt somit App-Aktionen – nicht jedes Wort, das der Assistent sagen könnte.
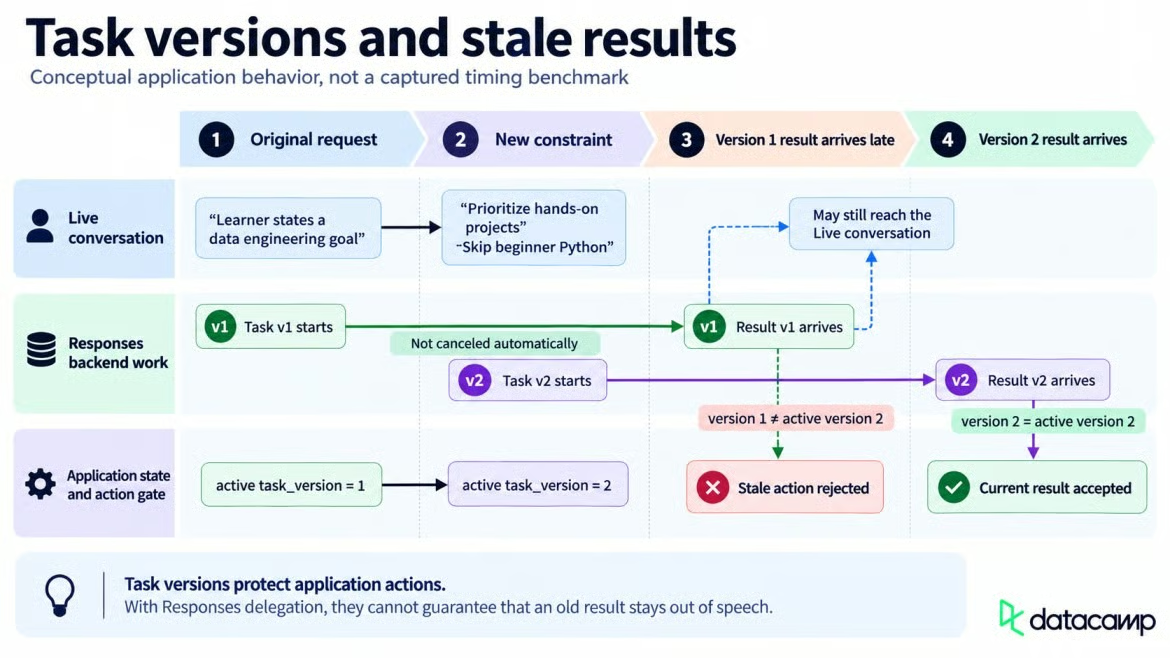
Task-Versionen halten neuere Einschränkungen aktiv. Bild: Autor.
Nachdem die erste Backend-Antwort fertig war, habe ich um Hands-on-Projekte ohne Python-Grundlagen gebeten. Der überarbeitete Sieben-Punkte-Plan startete mit Introduction to SQL und mischte einen Lernpfad, zwei Kurse und vier Projekte, darunter Exploring London's Travel Network und Building a Retail Data Pipeline. Das zeigt Überarbeitung über abgeschlossene Turns hinweg – ohne Aussage darüber, eine aktive Antwort zu stoppen.
Während das Backend arbeitet, können drei Append-Events das Live-Modell aktualisieren: session.thinking.append fügt nicht zu sprechenden Kontext hinzu, session.commentary.append fügt Text hinzu, den das Modell in eigenen Worten sagen soll, und session.instructions.append ändert seine Instruktionen.
Jedes Append trägt einen Klartext mit maximal 500 Tokens. Diese Events aktualisieren Kontext oder Verhalten des Live-Modells; sie ändern oder stoppen keine bereits laufende Backend-Responses-Aufgabe. Instruktionen lenken aktuelles Live-Verhalten um, Commentary liefert Inhalte, die das Modell aussprechen soll.
Das Dashboard zeichnet Backend-Fortschritt auf, sendet aber keine Append-Events. Bei Responses-Delegation kannst du Updates trotzdem über oai-events senden – allerdings mit delegation_id: null. Nicht-null-IDs sind für client-delegierte Tasks.
Halte task_id und task_version im App-Status statt delegation_id für einen der beiden zu verwenden.
In dieser App speichert eine Modellantwort nie allein etwas. Das Backend nutzt save_learning_plan für den Vorschlag der anstehenden Aktion, während /api/save-plan den eigentlichen Schreibvorgang besitzt.
Backend-Funktionsaufrufe kommen innerhalb von response.event. Der Handler wartet auf ein verschachteltes response.output_item.done-Item und liest dann dessen call_id, name und arguments aus.
Das Warten auf das abgeschlossene Item ist wichtig, weil frühere Events nur Teile des Aufrufs enthalten können. Die App parst die Argumente, führt die Funktion aber noch nicht aus.
SAVE_LEARNING_PLAN_TOOL = {
    "type": "function",
    "name": "save_learning_plan",
    "description": "Propose the current learning plan for confirmation when the learner asks to save.",
    "parameters": {
        "type": "object",
        "properties": {
            "goal": {"type": "string"},
            "weekly_hours": {"type": "number"},
            "items": {
                "type": "array",
                "items": {
                    "type": "object",
                    "properties": {
                        "title": {"type": "string"},
                        "url": {"type": "string"},
                        "reason": {"type": "string"},
                        "type": {
                            "type": "string",
                            "enum": ["course", "project", "track", "article"],
                        },
                    },
                    "required": ["title", "url", "reason", "type"],
                    "additionalProperties": False,
                },
            },
        },
        "required": ["goal", "weekly_hours", "items"],
        "additionalProperties": False,
    },
    "strict": True,
}
Das Schema gibt der App ein fixes Set an Feldern, die sie vor der Bestätigung anzeigen kann. Das Feld type hält Kurse, Projekte, Lernpfade und Artikel im gespeicherten Datensatz explizit.
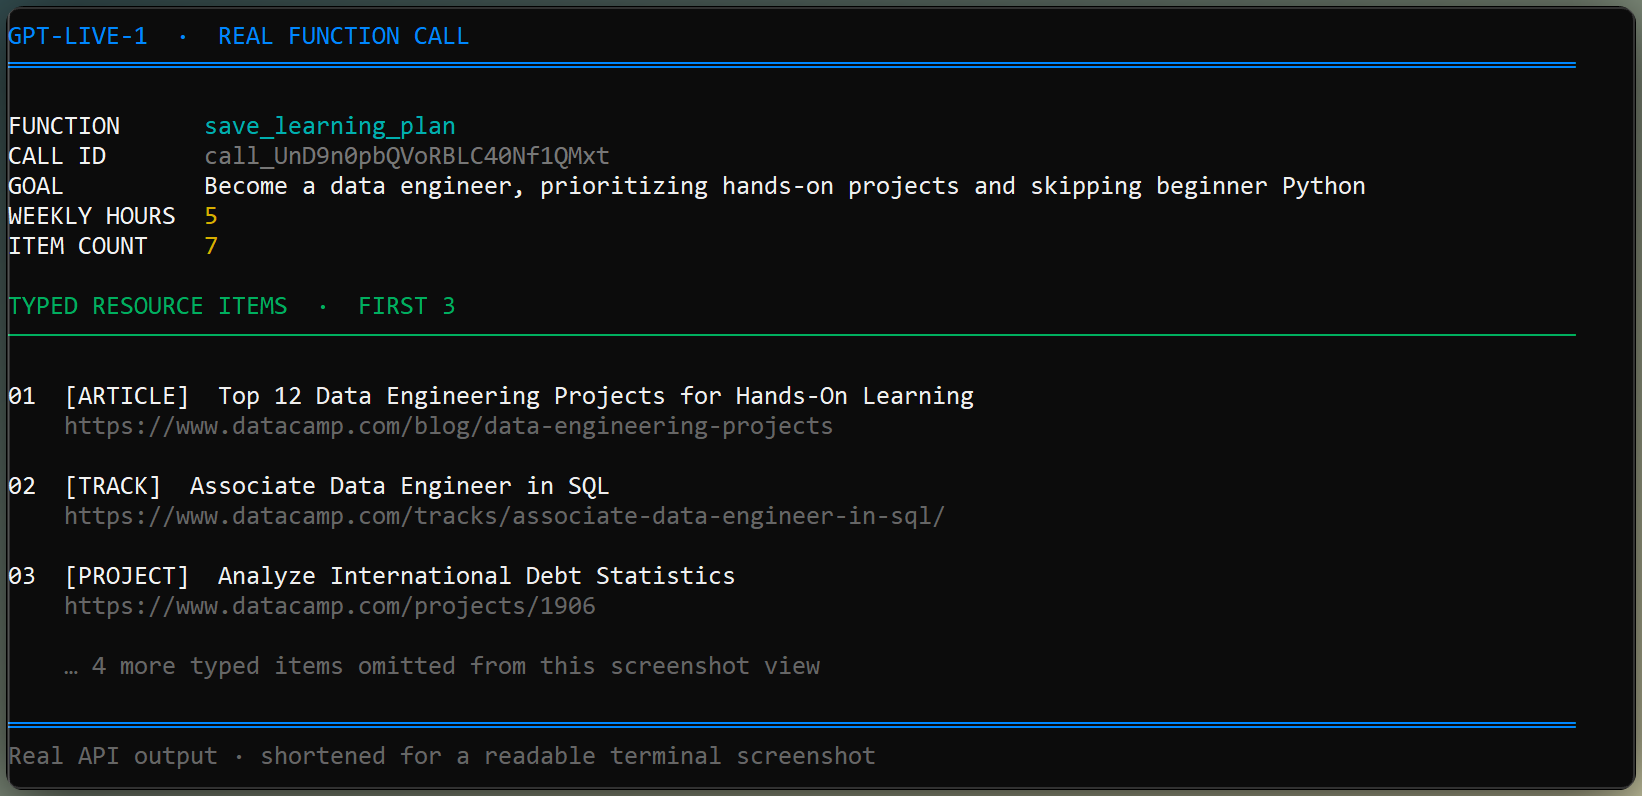
Das Terminal zeigt typisierte Argumente für die Speicherfunktion. Bild: Autor.
Wenn der Lernende speichern möchte, ruft das Backend save_learning_plan mit dem vollständigen Plan auf. Das Widget speichert diese Argumente und zeigt die Bestätigungsbox, aber der Aufruf ist weiterhin nur ein Vorschlag.
Würdest du den Funktionsaufruf offen lassen, blockierte das die delegierte Antwort und spätere Backend-Turns. Das Widget beantwortet ihn sofort mit einem Ergebnis „wartet auf Nutzerbestätigung“ und sendet anschließend response.create, damit das Gespräch weitergehen kann.
events.send(JSON.stringify({
  type: "response.item.create",
  item: {
    type: "function_call_output",
    call_id: callId,
    output: JSON.stringify({
      status: "awaiting_user_confirmation",
      saved: false,
    }),
  },
}));
events.send(JSON.stringify({ type: "response.create" }));
Zu diesem Zeitpunkt wird keine Datei geschrieben. Der Assistent kann den Lernenden auf den Button „Bestätigen und speichern“ verweisen, ohne spätere delegierte Arbeit zu blockieren.
Der Endpunkt /api/save-plan verweigert das Schreiben, sofern confirmed nicht true ist. Da Transkripte falsch oder unvollständig sein können, speichert die Sprachbitte allein den Plan nicht.
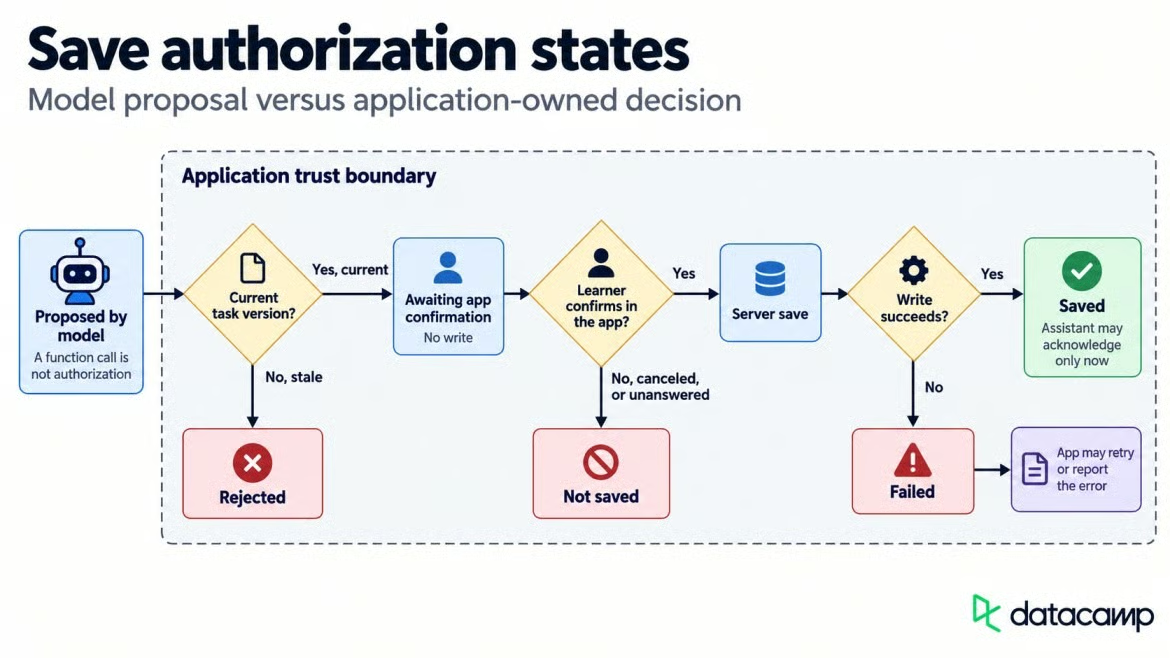
Bestätigung trennt Anfragen von gespeicherten Aktionen. Bild: Autor.
Der Klick auf „Bestätigen“ sendet /api/save-plan den anstehenden Plan und confirmed: true. Nachdem der Server eine Plan-ID zurückgibt, sendet das Widget session.commentary.append mit delegation_id: null – der ursprüngliche Funktionsaufruf wurde bereits beantwortet.
const saveResponse = await fetch(${SERVER}/api/save-plan, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    confirmed: true,
    plan: pendingFunctionCall.args,
  }),
});
const saveResult = await saveResponse.json();

events.send(JSON.stringify({
  type: "session.commentary.append",
  delegation_id: null,
  content: The plan was saved as ${saveResult.plan_id}.,
}));
Das Commentary-Update informiert das Live-Modell über den abgeschlossenen Schreibvorgang und lässt es die Speicherung aussprechen. Der frühere Funktionsaufruf bleibt geschlossen, und die Sprachsitzung steht für die nächste Anfrage bereit.
Das oben verlinkte GitHub-Repository enthält den FastAPI-Server, die Streamlit-Oberfläche und das WebRTC-Widget im Ordner app/. Nach dem Klonen öffnest du zwei Terminals in diesem Ordner. Starte in einem uvicorn server:app --host 127.0.0.1 --port 8000 und im anderen streamlit run streamlit_app.py.
Die Streamlit-Oberfläche nutzt denselben Server und dasselbe Widget wie im gesamten Build. Sie platziert das Live-Gespräch neben Lernplan und Backend-Aktivität, während das Dashboard aktualisiert, ohne den Anruf zurückzusetzen.
Das folgende Video zeigt gesprochenes Ziel, Backend-Suche, überarbeiteten Plan und bestätigtes Speichern. Der Anruf bleibt nach dem Speichern offen, damit der Lernende weitermachen kann.
Lerne mit DataCamp
Kurs
Kurs
Kurs
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Blog
Zoumana Keita
15 Min.
Tutorial
Kurtis Pykes
15 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Abid Ali Awan
7 Min.


