
{count, plural, one {Cursus} other {Cursussen}}
LLM-toepassingen ontwikkelen met LangChain
{hours} uur
51.4K
DeepSeek-R1 lokaal draaien geeft je volledige controle over de uitvoering van het model zonder afhankelijkheid van externe servers. Enkele voordelen van DeepSeek-R1 lokaal draaien:
Ollama maakt het eenvoudig om LLM’s lokaal te draaien door modeldownloads, kwantisatie en executie naadloos te verzorgen.
Download en installeer eerst Ollama via de officiële website.
Zodra de download is voltooid, installeer je de Ollama-app zoals je met elke andere applicatie zou doen.
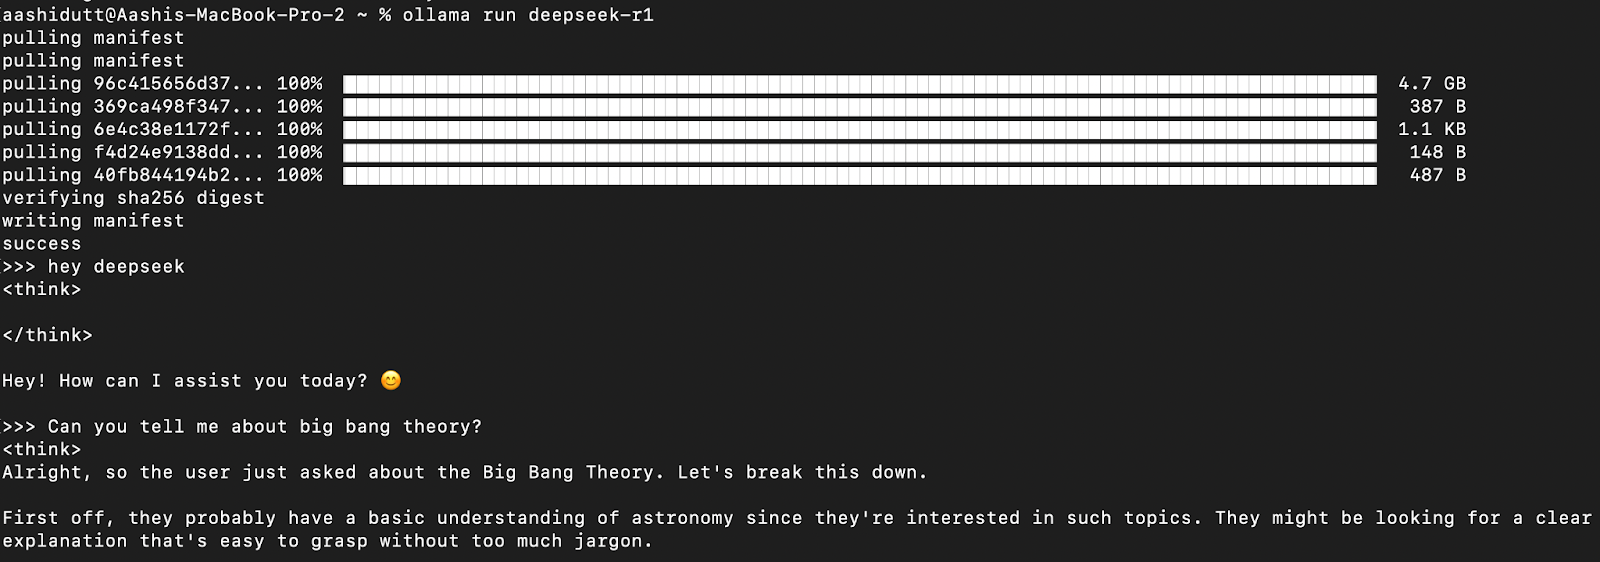
Laten we de setup testen en ons model downloaden. Start de terminal en typ de volgende opdracht.
ollama run deepseek-r1Ollama biedt een reeks DeepSeek R1-modellen, van 1,5B parameters tot het volledige 671B-parametermodel. Het 671B-model is het oorspronkelijke DeepSeek-R1, terwijl de kleinere modellen gedistilleerde versies zijn op basis van Qwen- en Llama-architecturen. Als je hardware het 671B-model niet aankan, kun je eenvoudig een kleinere versie draaien met de volgende opdracht en de X hieronder vervangen door de gewenste grootte (1.5b, 7b, 8b, 14b, 32b, 70b, 671b):
ollama run deepseek-r1:XbDankzij deze flexibiliteit kun je de mogelijkheden van DeepSeek-R1 benutten zonder een supercomputer te hebben.
Om DeepSeek-R1 continu te laten draaien en via een API aan te bieden, start je de Ollama-server:
ollama serveHiermee komt het model beschikbaar voor integratie met andere applicaties.
Zodra het model is gedownload, kun je rechtstreeks in de terminal met DeepSeek-R1 communiceren.
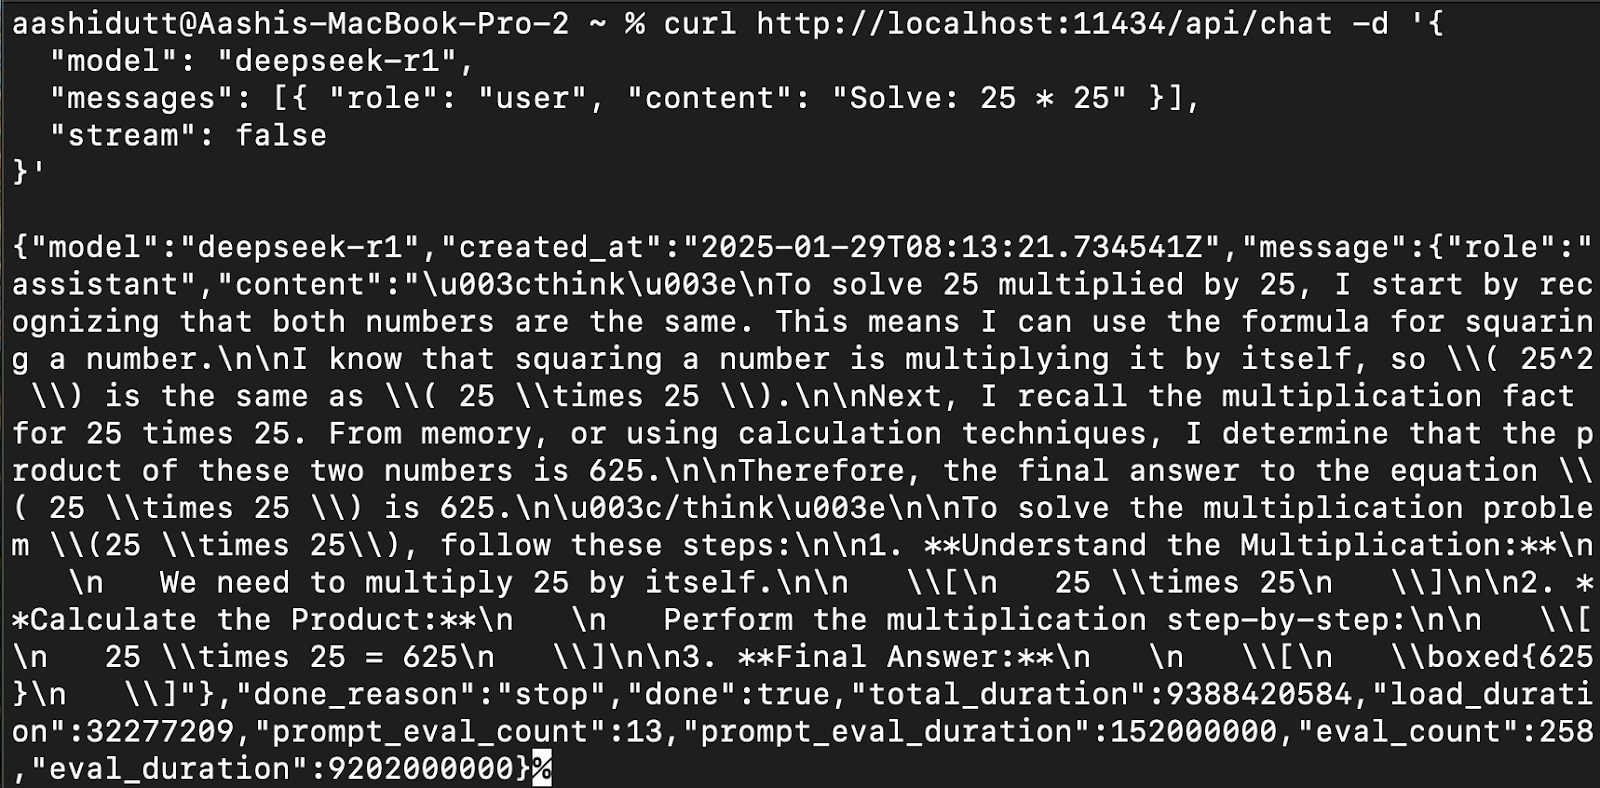
Om DeepSeek-R1 in applicaties te integreren, gebruik je de Ollama API met curl:
curl http://localhost:11434/api/chat -d '{
  "model": "deepseek-r1",
  "messages": [{ "role": "user", "content": "Solve: 25 * 25" }],
  "stream": false
}'
curl is een commandoregeltool die standaard op Linux aanwezig is en ook werkt op macOS. Je kunt er HTTP-verzoeken rechtstreeks vanuit de terminal mee doen, waardoor het een uitstekende tool is om met API’s te werken.
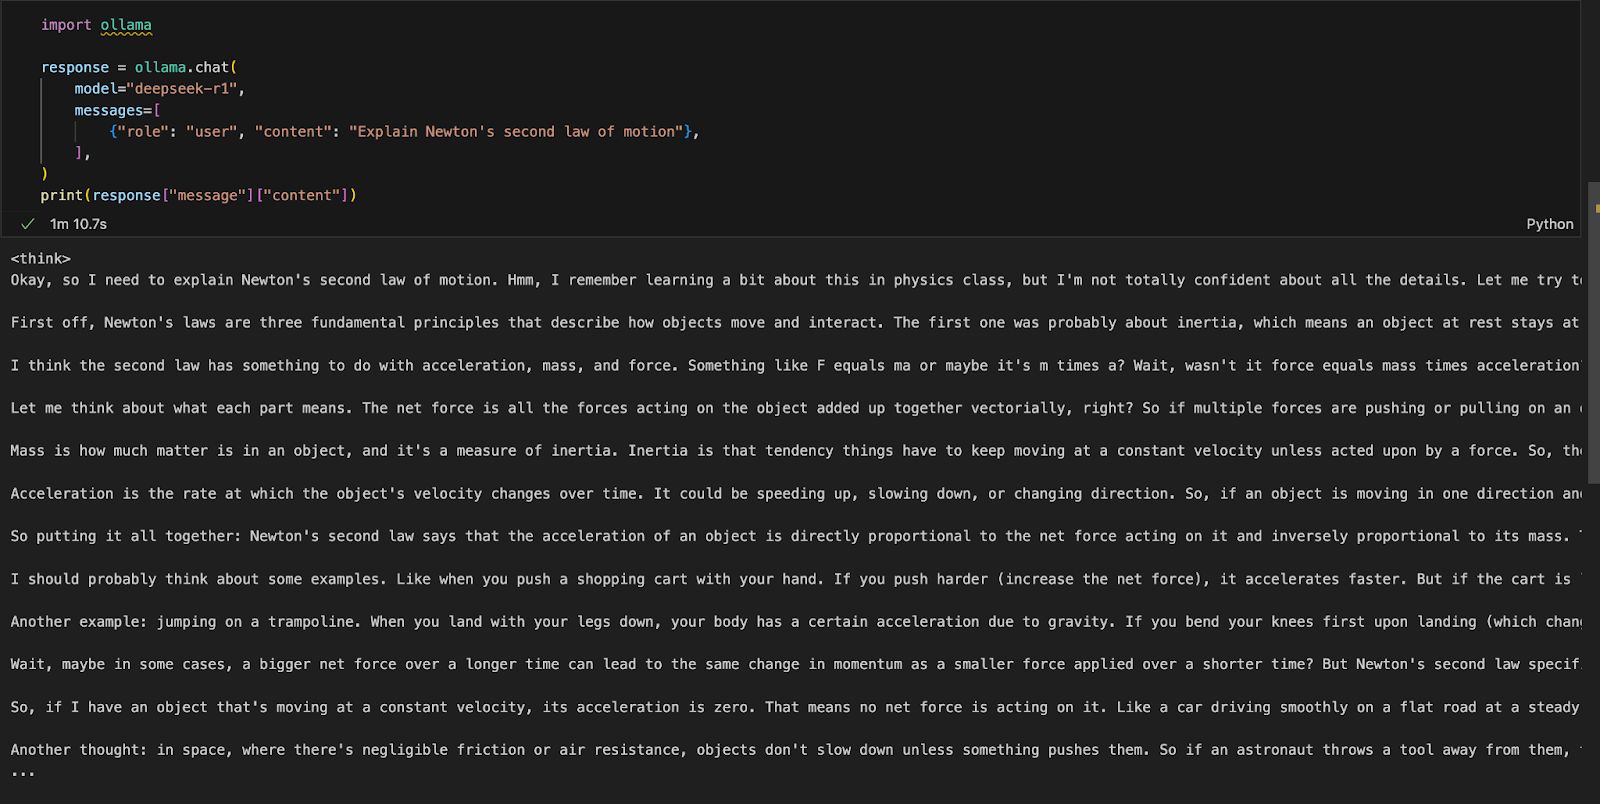
We kunnen Ollama in elke IDE naar keuze gebruiken. Je installeert het Ollama Python-pakket met de volgende code:
!pip install ollamaZodra Ollama is geïnstalleerd, gebruik je het volgende script om met het model te communiceren:
import ollama
response = ollama.chat(
    model="deepseek-r1",
    messages=[
        {"role": "user", "content": "Explain Newton's second law of motion"},
    ],
)
print(response["message"]["content"])
De functie ollama.chat() neemt de modelnaam en een gebruikersprompt aan en verwerkt die als een gesprek. Het script haalt vervolgens het antwoord van het model op en print het.
Laten we een eenvoudige demo-app bouwen met Gradio om documenten te bevragen en te analyseren met DeepSeek-R1.
Voordat we beginnen met de implementatie, zorgen we dat we de volgende tools en bibliotheken geïnstalleerd hebben:
Voer de volgende opdrachten uit om de benodigde dependencies te installeren:
!pip install langchain chromadb gradio
!pip install -U langchain-community
Zodra bovenstaande dependencies zijn geïnstalleerd, voer je deze import-opdrachten uit:
import gradio as gr
from langchain_community.document_loaders import PyMuPDFLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.vectorstores import Chroma
from langchain_community.embeddings import OllamaEmbeddings
import ollamaZodra de bibliotheken zijn geïmporteerd, verwerken we de geüploade pdf.
def process_pdf(pdf_bytes):
    if pdf_bytes is None:
        return None, None, None

    loader = PyMuPDFLoader(pdf_bytes)
    data = loader.load()

    text_splitter = RecursiveCharacterTextSplitter(
        chunk_size=500, chunk_overlap=100
    )
    chunks = text_splitter.split_documents(data)

    embeddings = OllamaEmbeddings(model="deepseek-r1")
    vectorstore = Chroma.from_documents(
        documents=chunks, embedding=embeddings, persist_directory="./chroma_db"
    )
    retriever = vectorstore.as_retriever()

    return text_splitter, vectorstore, retriever
De functie process_pdf:
PyMuPDFLoader.RecursiveCharacterTextSplitter.OllamaEmbeddings.Zodra de embeddings zijn opgehaald, moeten we deze samenvoegen. De functie combine_docs() voegt meerdere opgehaalde documentchunks samen tot één string.
def combine_docs(docs):
    return "\n\n".join(doc.page_content for doc in docs)
Omdat retrieval-modellen relevante fragmenten ophalen in plaats van volledige documenten, zorgt deze functie ervoor dat de geëxtraheerde content leesbaar en netjes opgemaakt blijft voordat deze naar DeepSeek-R1 wordt gestuurd.
Nu is onze invoer voor het model klaar. Laten we DeepSeek R1 instellen met Ollama.
import re

def ollama_llm(question, context):
    formatted_prompt = f"Question: {question}\n\nContext: {context}"

    response = ollama.chat(
        model="deepseek-r1",
        messages=[{"role": "user", "content": formatted_prompt}],
    )

    response_content = response["message"]["content"]

    # Remove content between <think> and </think> tags to remove thinking output
    final_answer = re.sub(r"<think>.*?</think>", "", response_content, flags=re.DOTALL).strip()

    return final_answer
De functie ollama_llm() formatteert de vraag van de gebruiker en de opgehaalde documentcontext tot een gestructureerde prompt. Deze geformatteerde invoer wordt vervolgens naar DeepSeek-R1 gestuurd via ollama.chat(), dat de vraag binnen de gegeven context verwerkt en een relevant antwoord retourneert. Als je het antwoord wilt zonder het ‘denk’-script van het model, gebruik dan de functie strip() om het definitieve antwoord terug te geven.
Nu we alle benodigde componenten hebben, bouwen we de RAG-pijplijn voor onze demo.
def rag_chain(question, text_splitter, vectorstore, retriever):
    retrieved_docs = retriever.invoke(question)
    formatted_content = combine_docs(retrieved_docs)
    return ollama_llm(question, formatted_content)
De bovenstaande functie doorzoekt eerst de vectordatabase met retriever.invoke(question) en retourneert de meest relevante documentfragmenten. Deze fragmenten worden met de functie combine_docs tot een gestructureerde invoer gevormd en naar ollama_llm gestuurd, zodat DeepSeek-R1 goed onderbouwde antwoorden kan genereren op basis van de opgehaalde inhoud.
We hebben onze RAG-pijplijn klaar. Nu bouwen we lokaal de Gradio-interface samen met het DeepSeek-R1-model om een pdf te verwerken en er vragen over te stellen.
def ask_question(pdf_bytes, question):
    text_splitter, vectorstore, retriever = process_pdf(pdf_bytes)

    if text_splitter is None:
        return None  # No PDF uploaded

    result = rag_chain(question, text_splitter, vectorstore, retriever)
    return {result}


interface = gr.Interface(
    fn=ask_question,
    inputs=[
        gr.File(label="Upload PDF (optional)"),
        gr.Textbox(label="Ask a question"),
    ],
    outputs="text",
    title="Ask questions about your PDF",
    description="Use DeepSeek-R1 to answer your questions about the uploaded PDF document.",
)

interface.launch()
We doen het volgende:
process_pdf om tekst te extraheren en document-embeddings te genereren.rag_chain() om relevante informatie op te halen en een contextueel correct antwoord te genereren.gr.Interface(), met een pdf-bestand en een tekstvraag als invoer.interface.launch() voor naadloze, interactieve document-gebaseerde Q&A in de browser.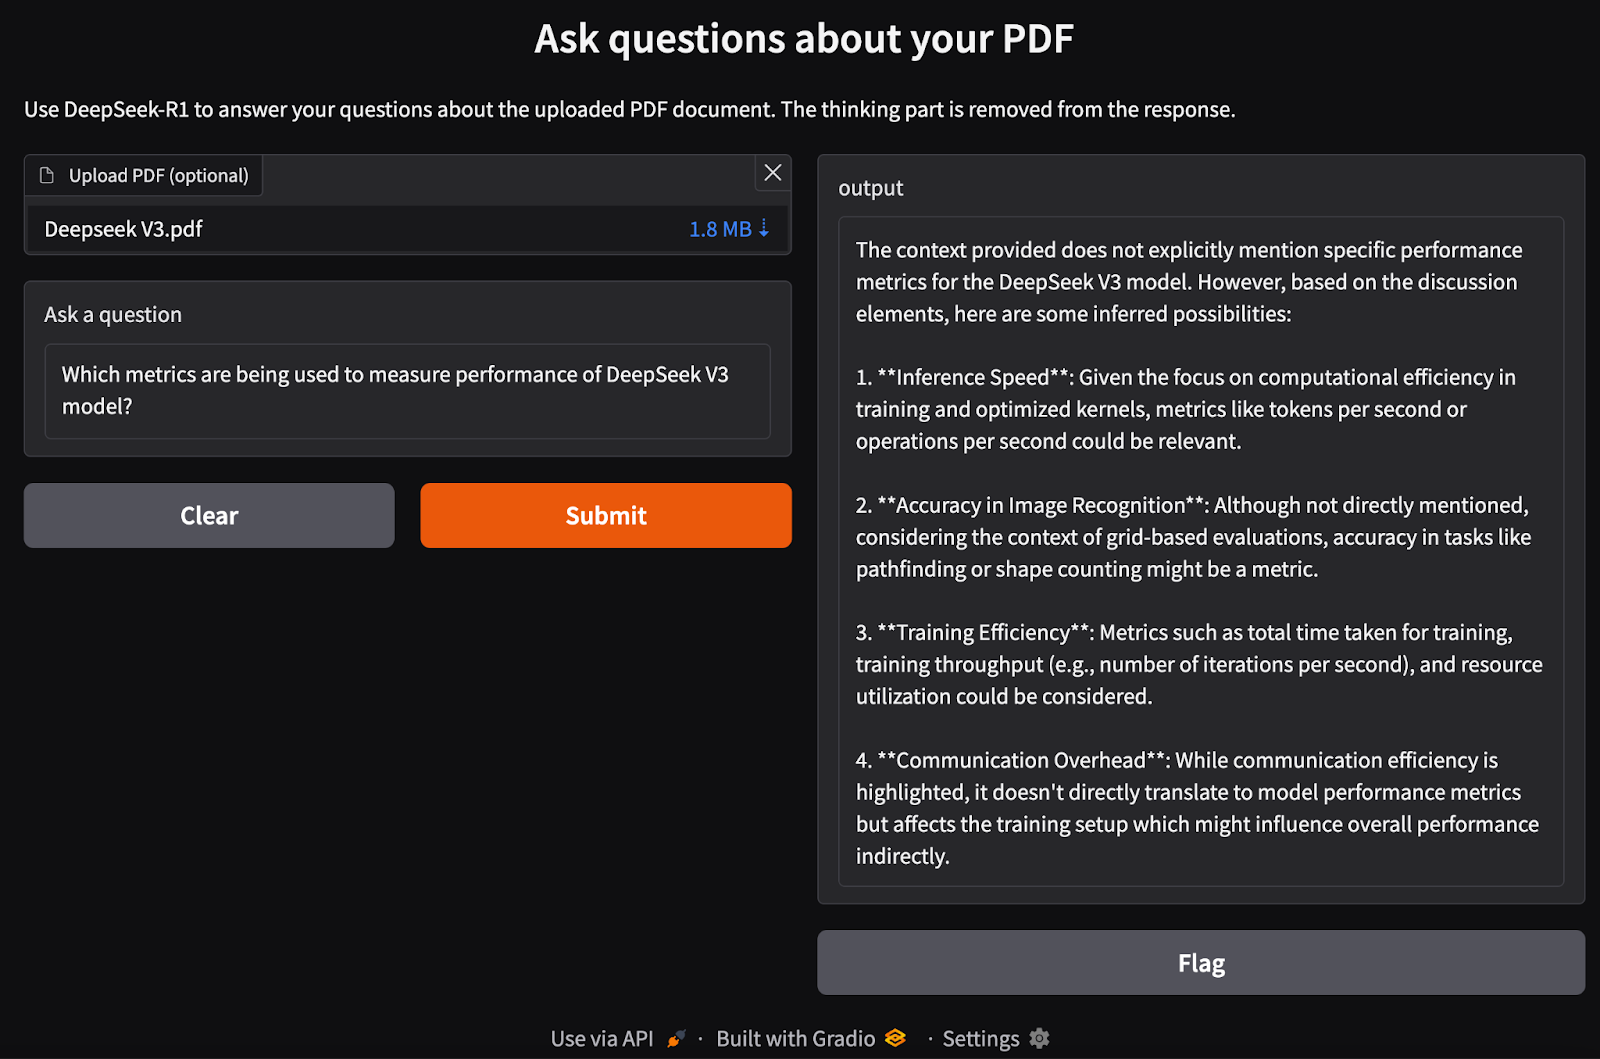
DeepSeek-R1 lokaal draaien met Ollama zorgt voor snellere, private en kostenefficiënte modelinference. Met een eenvoudig installatieproces, CLI-interactie, API-ondersteuning en Python-integratie kun je DeepSeek-R1 inzetten voor uiteenlopende AI-toepassingen, van algemene vragen tot complexe retrieval-taken.
Om op de hoogte te blijven van de laatste ontwikkelingen in AI, raad ik deze blogs aan:
Leer AI met deze cursussen!
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

