
Cursus
AI-agents bouwen met Google ADK
1 Hr
7.5K
Stem is de strijd van de maand. Op de Speech to Speech Index van Artificial Analysis stonden OpenAI's GPT-Live-1 Astra en SpaceXAI's Grok Voice Think Fast 2.0 met 0,2 punten verschil bovenaan, en OpenAI bracht begin september GPT-6 Astra uit. Op 15 september antwoordde Google met twee nieuwe speech-to-speech-modellen: Gemini 3.8 Live en Gemini 3.8 Live Extended Thinking.
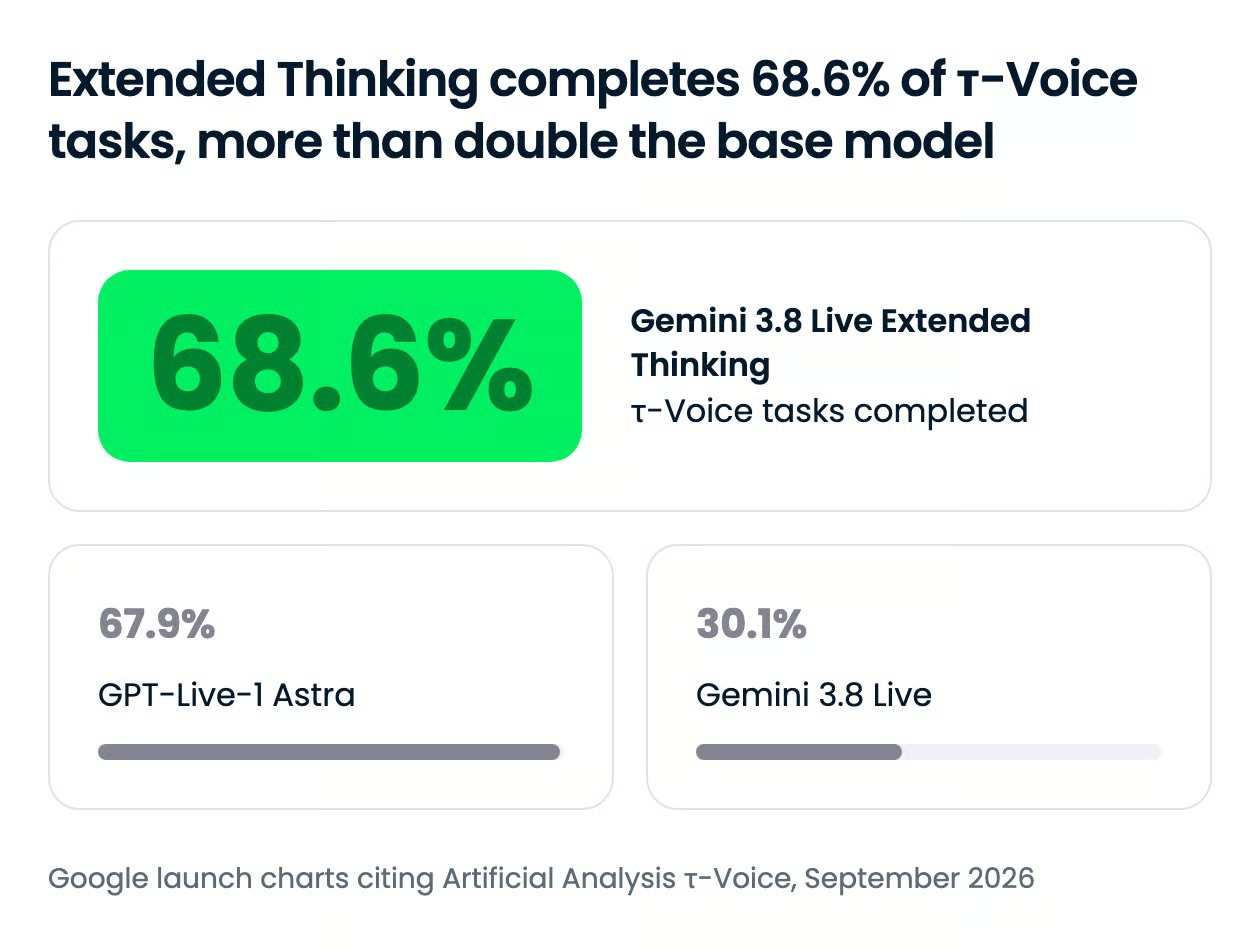
Extended Thinking pakt de eerste plek op die index met een score van 82,6 en leidt de τ-Voice agentische benchmark met 68,6%. Het basis 3.8 Live-model is de goedkope: in de kostentest van Artificial Analysis verwerkt het een uur invoeraudio voor $0,84, de laagste van alle modellen die Google in kaart bracht. Beide zijn per direct algemeen beschikbaar in de Gemini API voor dezelfde prijs als hun voorganger, Gemini 3.1 Flash Live.
In dit artikel behandel ik alles wat nieuw is in Gemini 3.8 Live: de functies, de benchmarks, het verschil tussen de twee varianten en wat het kost om te draaien. Bekijk ook onze gidsen voor aan de slag gaan met de Gemini Live API en een spraakassistent bouwen met GPT-Live-1.
Gemini 3.8 Live is Google's native speech-to-speech-model voor realtime voice-agents, uitgebracht op 15 september 2026 naast een variant met meer redeneervermogen: Gemini 3.8 Live Extended Thinking. Beide draaien via de Gemini Live API over een WebSocket-verbinding, nemen audio, video, afbeeldingen en tekst als input, en geven audio terug. Google positioneert 3.8 Live als de standaard voor gesprekken met lage latentie en Extended Thinking als de keuze voor complexe taken met meerdere stappen.
De generatieverandering ten opzichte van Gemini 3.1 Flash Live zit in hoe het model werk afhandelt dat geen praten is. Tool- en API-calls draaien nu standaard op de achtergrond terwijl het model het gesprek voortzet, en Extended Thinking voegt daar configureerbare achtergrondredenering aan toe. Google beschrijft het duo als een sprong ten opzichte van eerdere live-modellen en als vervanging voor gecascadeerde pipelines die spraak-naar-tekst, een LLM en tekst-naar-spraak aan elkaar rijgen.
Google noemt vijf mogelijkheden voor de nieuwe modellen, en de twee die het meest tellen voor iedereen die een voice-agent bouwt, zijn degene die de gesprekslus veranderen: asynchrone tool-calls en achtergrondredenering.
Beide modellen voeren functie-calls en API-verzoeken op de achtergrond uit terwijl ze audio terugstreamen naar de gebruiker. Op Gemini 3.8 Live is asynchrone uitvoering nu de standaardmodus voor functie-calls. Je kunt het oude synchrone gedrag nog steeds afdwingen door behavior: BLOCKING in te stellen bij een tool-declaratie, en het model ondersteunt het plannen van functies met de opties SILENT, WHEN_IDLE en INTERRUPTED die bepalen wanneer een resultaat wordt uitgesproken.
Extended Thinking gaat verder: het vereist niet-blokkerende tools en geeft een harde fout terug als je een blokkerende declareert. Het praktische effect is dat een beller die vraagt een boeking te wijzigen meteen een bevestiging hoort, dan een voortgangsupdate en vervolgens het resultaat, in plaats van de stilte die een gecascadeerde pipeline produceert terwijl die op een API wacht. Op Gemini 3.1 Flash Live waren functie-calls alleen sequentieel en begon het model pas te antwoorden nadat je het toolresultaat had teruggestuurd.
Gemini 3.8 Live Extended Thinking redeneert en spreekt tegelijkertijd. In Google's documentatie wordt beschreven dat het model vroege verbale signalen gebruikt zoals "Ik check dat even" om een prompt te erkennen en vervolgens de voortgang vertelt terwijl meerstaps achtergrondwerk wordt afgerond. Je stuurt de diepte met thinking_level op low, medium of high; het niveau MINIMAL dat op 3.1 Flash Live bestond, is verdwenen.
Dit verandert het protocol, en ik denk dat dit het belangrijkste migratiedetail in de release is. Omdat het model meerdere keren kan spreken tijdens één verzoek, betekent turnComplete: true niet langer dat het inactief is.
Je client moet een nieuw veld interaction_status in de gaten houden, dat IN_PROGRESS meldt terwijl redenering of tools draaien en IDLE wanneer de hele taak klaar is. Sla je dat over, dan schakelt je UI terug naar "luisteren" terwijl het model nog midden in een taak zit.
Gemini 3.8 Live baseert gesprekken op live visuele input en verwerkt videoframes vrijwel in realtime, zodat een agent kan reageren op wat een gebruiker ziet én zegt. Google's demo's omvatten een live schaakpartij en een onboarding-walkthrough voor medewerkers waarbij het model vragen beantwoordt over wat er op het scherm staat.
Video is niet gratis. Turn coverage stuurt nu standaard audio-activiteit plus alle videoframes naar het model, dus als je app geen visie nodig heeft, stuur dan alleen frames wanneer ze nuttig zijn, zowel voor de contextbudget als voor de kosten. Audio-plus-video-sessies zijn ook beperkt tot 2 minuten voordat je sessiebeheer nodig hebt om ze te verlengen, tegenover 15 minuten voor alleen-audio-sessies.
Google noemt dit "alfanumerieke precisie": het nauwkeurig parseren van strings zoals bevestigingscodes, claimnummers en technische identifiers die hardop worden uitgesproken. Iedereen die een voice-agent voor support of logistiek heeft gebouwd, weet dat dit is waar gecascadeerde stacks omvallen, omdat een spraak-naar-tekstfout vroeg in de keten stroomafwaarts niet te herstellen is. Een native spraakmodel dat de hele uiting in context hoort, heeft hier een structureel voordeel.
Gemini 3.8 Live detecteert en schakelt tussen 97 ondersteunde talen tijdens een gesprek, met wat Google accentconsistentie tussen die talen noemt. Beide modellen ondersteunen ook wat Google incrementele contentupdates noemt: je kunt op elk moment tijdens de sessie gestructureerde data sturen met een expliciete user- of model-rol, en het model voegt die samen met de live audio. Zo geef je een klantkaart of orderstatus door in een lopend gesprek zonder de flow te breken.
Twee kleinere wijzigingen raken bestaande code. Proactieve audio, waarbij het model kan besluiten niet te reageren op spraak die niet tot hem is gericht, staat nu permanent aan, en het instellen op false geeft een fout. Affective dialogue is volledig uit de API verwijderd, dus alle enable_affective_dialog-configuraties moeten eruit.
Extended Thinking leidt elke kwaliteits- en agentische lijst die Google publiceerde, maar met kleine marges boven OpenAI's GPT-Live-1 Astra, terwijl het basis 3.8 Live-model ruim wint op kosten maar verliest op agentische taken.
De index-, τ-Voice-, Big Bench Audio- en kostencijfers hieronder staan allemaal op het openbare leaderboard van Artificial Analysis, dus ze zijn onafhankelijk gemeten en niet door de leverancier gerapporteerd. De τ³-Banking-cijfers komen uit Google's lanceringsgrafiek met Sierra als bron, dus beschouw die rij als vendor-gerapporteerd totdat Sierra's board hetzelfde laat zien.
Gemini 3.8 Live Extended Thinking leidt op τ-Voice, Sierra's benchmark voor de vraag of een voice-agent meerstapstaken met tools voltooit, zoals gemeten door Artificial Analysis. GPT-Live-1 Astra volgt kort daarachter, de rest blijft achter:
Het cijfer dat me verraste is dat de score van het basismodel op τ-Voice onder die van zijn eigen voorganger ligt. Google is duidelijk dat 3.8 Live is gebouwd voor schaal en kostenefficiëntie in plaats van voor complexe workflows, maar een verschil van meer dan 38 punten tussen de twee varianten betekent dat de keuze van de tier geen nuance is. Als je agent tools aaneenrijgt, is het basismodel de verkeerde standaard.
Op Sierra's τ³-Banking-leaderboard, een zwaardere klantenservice-benchmark rond bankworkflows, scoort Extended Thinking 35,1% tegen 32,0% voor GPT-Live-1 Astra, 16,5% voor SpaceXAI's Grok Voice Think Fast 2.0, 11,3% voor Gemini 3.1 Flash Live en 10,3% voor GPT-Realtime 2. Elk model op die lijst faalt meestal, wat aangeeft hoe ver voice-agents nog verwijderd zijn van onbewaakt bankwerk, maar een verdrievoudiging ten opzichte van de vorige Gemini-generatie is een echte stap.
Op de Speech to Speech Index wint Extended Thinking ook nipt van de concurrentie:
Een voorsprong van 1,1 punt op OpenAI is een voorsprong, maar ik zou er geen aankoopbeslissing op baseren.
Voor puur redeneren over gesproken input rapporteert Google 97,7% op Big Bench Audio voor Extended Thinking. Google meldt ook dat beide modellen de Pareto-frontier opschuiven op ServiceNow's EVA-Bench voor voice-agents, balancerend tussen nauwkeurigheid en gesprekskwaliteit, al is die run gedaan op de Live API via het Gemini Enterprise Agent Platform in plaats van de publieke API.
Dit is de grafiek die Google het liefst laat zien. In de kostentest van Artificial Analysis op de Big Bench Audio-subset verwerkt Gemini 3.8 Live een uur invoeraudio voor $0,84.
Extended Thinking kost $3,50 voor hetzelfde uur, Grok Voice Think Fast 2.0 kost $4,80 en GPT-Live-1 Astra kost $5,83. Gemini 3.1 Flash Live zat op $1,50 en $1,75 afhankelijk van het denkniveau.
Lees de twee Gemini-balken samen en de productstrategie is duidelijk. Het basismodel onderbiedt alles op het bord met ruime marge, en het redeneermodel dat op kwaliteit gelijk opgaat met OpenAI kost nog steeds 40% minder per uur input. Let op: het redeneermodel verbruikt meer tokens op hogere denkniveaus, wat verklaart waarom het ongeveer 4 keer zo veel kost als zijn sibling ondanks een gedeelde prijstabel.
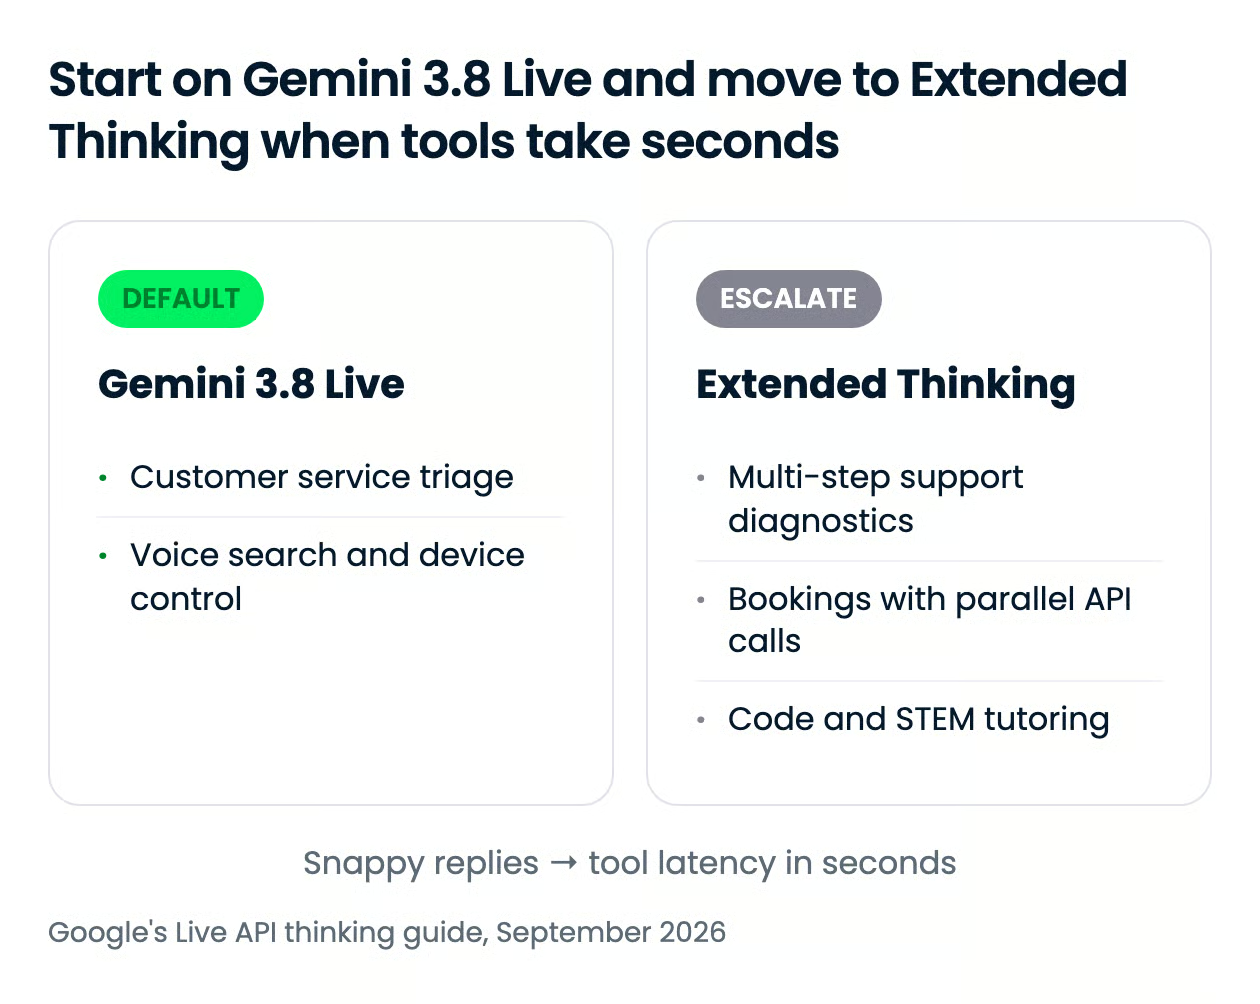
Gemini 3.8 Live is de juiste standaard voor de meeste voice-agents, en Extended Thinking is zijn hogere tokenverbruik alleen waard wanneer de agent moet plannen, vergelijken of wachten op trage tools. Google's eigen richtlijn trekt de grens bij toollatentie: als je functies in milliseconden terugkeren, blijf dan op het basismodel.
De twee varianten delen een prijstabel (die ik hieronder behandel), tokenlimieten van 131.072 input en 65.536 output, en hetzelfde WebSocket-endpoint. Wat ze scheidt, is de redeneer-architectuur.
Gemini 3.8 Live gebruikt verweven redenering met een vast latentprofiel en helemaal geen thinking_level-instelling. Extended Thinking biedt low, medium en high achtergrondredenering, streamt gesprekspauzeerders terwijl het werkt en vereist asynchrone tools. Die denkniveaus zijn de enige inspanningsregeling in de release.
| Use case | Pick | Why |
|---|---|---|
| Klantenservice-triage, spraakzoekopdrachten, taalpractice | Gemini 3.8 Live | Directe beurtwisseling is belangrijker dan diepgang en elke beurt van de gebruiker krijgt één reactie |
| Smart-apparaatbediening, sensordata uitlezen | Gemini 3.8 Live | Tools keren binnen milliseconden terug, er valt niets te maskeren |
| Technische support over logs, foutcodes en config-checks | Extended Thinking | Een diagnose in meerdere stappen heeft achtergrondredenering tussen uitingen nodig |
| Reis- en boekingsagents die vluchten en hotels parallel bevragen | Extended Thinking | Parallelle async-calls met gesproken voortgangsupdates in plaats van stilte |
| STEM- en code-tutoring | Extended Thinking | Het model verifieert formules of debugt code vóórdat het een uitleg uitspreekt |
Nog een overweging: clientcomplexiteit. Overstappen op Extended Thinking betekent je toestandsafhandeling herschrijven rond interaction_status, dus als je een werkende 3.1 Flash Live-app hebt, is het basismodel de drop-in upgrade en is het redeneermodel een kleine refactor.
Beide modellen delen de prijstabel van Gemini 3.1 Flash Live Preview, dus de upgrade is gratis. Op de betaalde laag kost audio-input $3,00 per 1 miljoen tokens, wat Google inschat op $0,005 per minuut, en audio-output kost $12,00 per 1 miljoen tokens, of ongeveer $0,018 per minuut. Thinking tokens worden afgerekend tegen het outputtarief, wat de hogere gebruikskosten van Extended Thinking verklaart.
| Modality | Paid tier, per 1M tokens | Per-minute estimate |
|---|---|---|
| Text input | $0.75 | n/a |
| Audio input | $3.00 | $0.005/min |
| Image and video input | $1.00 | $0.002/min |
| Text output | $4.50 | n/a |
| Audio output (including thinking tokens) | $12.00 | $0.018/min |
De gratis laag dekt beide modellen zonder kosten voor input en output, met de gebruikelijke kanttekening dat Google data uit de gratis laag gebruikt om zijn producten te verbeteren; data uit de betaalde laag worden daar niet voor gebruikt.
Grounding met Google Search wordt op beide lagen ondersteund, met 5.000 gratis zoekverzoeken per maand gedeeld over alle Gemini 3.x-modellen en $14 per 1.000 verzoeken daarna. Google heeft geen rate-limits gepubliceerd die specifiek zijn voor deze modellen, dus check de pagina met Gemini API rate-limits voor jouw laag voordat je een lancering plant.
Beschikbaarheid is op drie manieren opgesplitst:
Elke audio-output van beide modellen draagt een SynthID-watermerk, en Google's modelkaart is eerlijk over de beperkingen: de modellen kunnen nog steeds hallucineren, jailbreak-bestendigheid wordt nog verbeterd en er kan af en toe traagheid of time-outs optreden. Die kanttekeningen zijn het lezen waard voordat je een van beide modellen voor klanten zet.
De model-ID's zijn gemini-3.8-live en gemini-3.8-live-extended-thinking, beide stabiele strings zonder preview-suffix.
Je kunt ze benaderen via de Gemini Live API met de google-genai SDK voor Python of JavaScript, via ruwe WebSockets, of interactief in de Stream-weergave van Google AI Studio. Google noemt ook Agora, Fishjam, LiveKit, LangChain, Pipecat, Vercel en Vision Agents als integratiepartners die de mediastreaming-laag afhandelen, en er is een Agent Development Kit-streamingpad als je al op ADK bouwt.
De minimale Python-sessie hieronder opent een verbinding, stuurt een tekstbeurt en zet een outputtranscript aan zodat je kunt lezen wat het model zei:
import asyncio
from google import genai

client = genai.Client()
config = {"response_modalities": ["AUDIO"], "output_audio_transcription": {}}

async def main():
    async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
        await session.send_client_content(
            turns={"role": "user", "parts": [{"text": "Read back the claim number 7Q-4418-B."}]},
            turn_complete=True,
        )
        async for response in session.receive():
            if response.server_content and response.server_content.output_transcription:
                print(response.server_content.output_transcription.text)

asyncio.run(main())
Als je migreert vanaf gemini-3.1-flash-live-preview, wijzig dan de modelstring en verwijder eventuele thinking_level of thinking_config uit je setup; de turn-lifecycle is verder identiek. De Live API is standaard server-to-server, dus browser- en mobiele clients hebben tijdelijke tokens nodig.
Voor een volledige walkthrough van audiocapture, -afspelen en sessiebeheer, bekijk onze Gemini Live API-tutorial, en voor de tekstzijde van dezelfde familie behandelt onze Gemini 3.8 Flash API-tutorial denkniveaus en functie-calls in Python.
Google maakt vooral een statement met prijs, niet met pure kwaliteit. De voorsprong van Extended Thinking op GPT-Live-1 Astra is een punt of twee op elke lijst, maar Gemini 3.8 Live voor $0,84 per uur invoeraudio is bijna 7 keer goedkoper dan OpenAI's model, en dat is het getal dat bepaalt waar productie-stemverkeer naartoe gaat.
Mijn kijk: als je iets draait op Gemini 3.1 Flash Live, upgrade dan deze week, want de prijs is hetzelfde en de asynchrone tool-calls zijn het alleen al waard. Als je op de realtime stack van OpenAI zit, is het basismodel het proberen waard voor triage- en zoekflows, en is Extended Thinking het waard waar je tools seconden nodig hebben. De 30,1% van het basismodel op τ-Voice is de reden om het niet voor agentische taken te gebruiken.
Als je de tool-calling-kant van een voice-agent goed wilt bouwen, raad ik onze cursus Building AI Agents with Google ADK aan, die Gemini inbedt in een klantenservice-agent met tools, guardrails en delegatie.
Leer Agentic AI met DataCamp!
Cursus
Cursus
Cursus