
Cursus
Introductie tot AI voor het werk
2 uur
126.9K
OpenAI heeft GPT-6 Astra gelanceerd, dat het de intelligentste en best uitgelijnde model ter wereld noemt.
Astra komt terecht in een druk bezette frontier-klasse waarin Anthropics Claude Fable 5.1 (uitgebracht op 1 september 2026) en Claude Opus 5 de referentiepunten zijn voor coderen en agentisch werk.
De kopclaims zijn ambitieus.
Astra verzadigt FrontierMath Tier 4 met een score van 97,6%, verzadigt ARC-AGI-3 met 99,9% onder OpenAI's provider-adapterharnas, en haalt 100% op ExploitBench. Het zet ook een nieuwe maatstaf voor computer- en browsergebruik, met 72,6% op OSWorld 2.0 bij ongeveer 47% minder tijd per taak dan zijn voorganger GPT-5.6 Sol.
Zowel ARC-AGI-3 als FrontierMath Tier 4 zijn specifiek ontworpen om de AI-capaciteit voor te blijven, dus ze verzadigen is iets anders dan simpelweg een standaard leaderboard winnen.
In dit artikel behandel ik alles wat nieuw is aan GPT-6 Astra: de nieuwe functies, de benchmarks en enkele gebruiksvoorbeelden.
Wil je het model in actie zien, volg dan onze GPT-6 Astra API-tutorial en bekijk enkele GPT-6 Astra-projecten die je kunt proberen. Om te zien hoe het zich verhoudt tot de concurrentie, bekijk onze vergelijking van GPT-6 Astra en Claude Fable 5.1. Ik raad ook onze gids voor leren werken met Claude aan, en onze coverage van het nieuwe Jev System One-model plus onze vergelijking van Jev vs GPT-6 Astra.
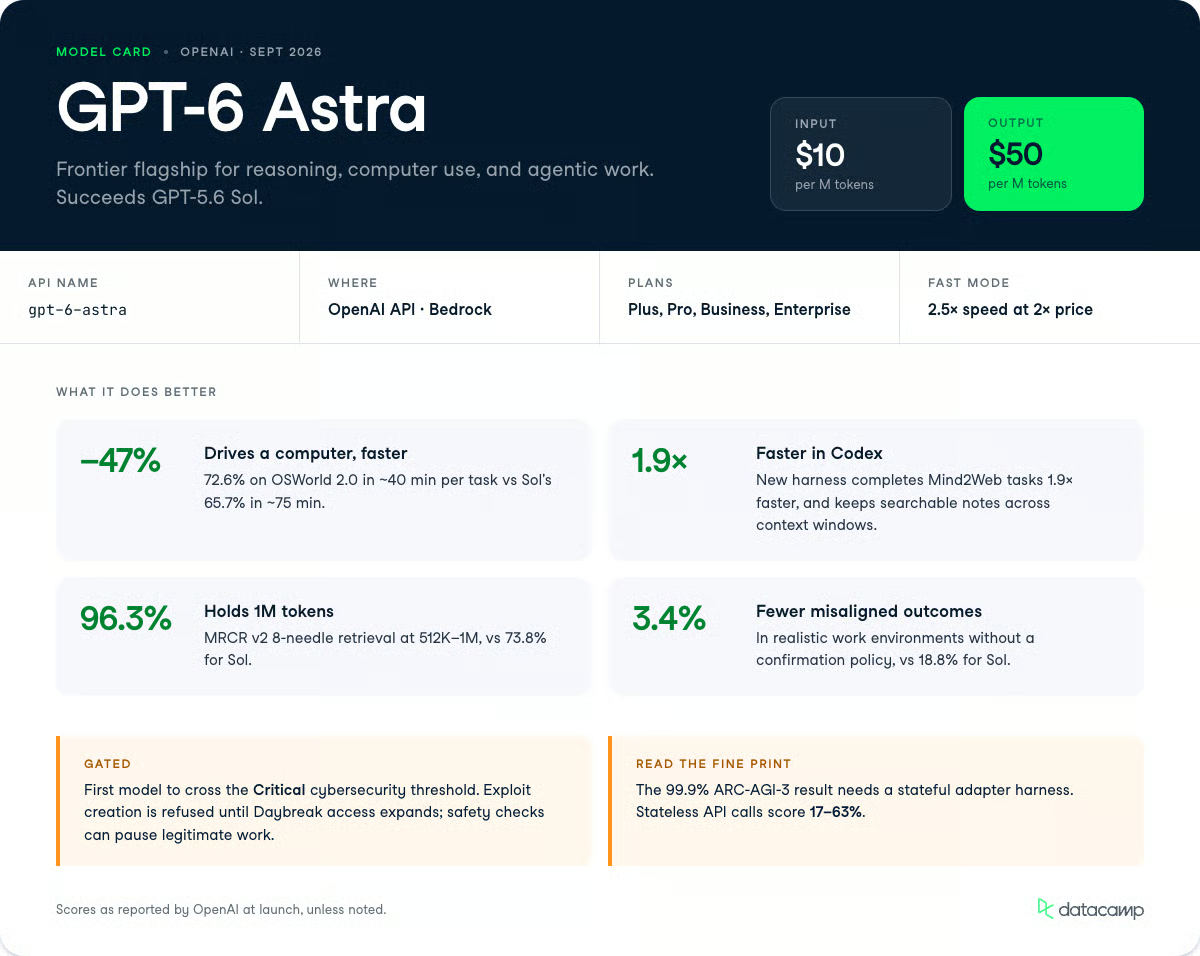
GPT-6 Astra is OpenAI's nieuwe frontier-vlaggenschip, de opvolger van GPT-5.6 Sol als topmodel voor redeneren, computergebruik en agentisch werk. GPT-6.1 Sol concurreert nu op prijs versus output.
OpenAI positioneert het rond drie gebieden:
De nuttigste benchmarkkop voor practitioners is OSWorld 2.0, waar Astra 72,6% scoort in ongeveer 40 minuten per taak, vergeleken met GPT-5.6 Sol's 65,7% in ongeveer 75 minuten.
Die combinatie van hogere nauwkeurigheid en lagere wall-clock-tijd is het verschil tussen een agent die je moet babysitten en een agent waaraan je een taak kunt overlaten.
Astra wordt geleverd met een bijgewerkt Codex-harnas dat volgens OpenAI 1,9x snellere taakafronding levert dan de huidige GPT-5.6 Sol-ervaring op de Mind2Web-benchmark.
Het is beschikbaar als gpt-6-astra in de OpenAI API en via Amazon Bedrock, met een GPT-6 Astra Pro-laag voor Pro-, Business- en Enterprise-abonnementen.
Ben je ook geïnteresseerd in OpenAI's nieuwste modellen in de lagere klasse, bekijk dan onze gids voor GPT-6 Sol en Luna.
Astra's veranderingen clusteren rond agentische uitvoering: een computer bedienen, afgewerkte professionele artefacten produceren, context behouden tijdens lange codeersessies en binnen geautoriseerde grenzen blijven.
Dit zijn de capaciteiten die opvallen.
Astra kan een computer rechtstreeks bedienen en het soort saaie, meerstappige werk afhandelen dat normaal een middag opslokt.
Goede voorbeelden zijn:
In latencysimulaties op OSWorld 2.0 haalt Astra 72,6% in ongeveer 40 minuten per taak tegenover GPT-5.6 Sol's 65,7% in ongeveer 75 minuten, een tijdsreductie per taak van 47%.
OSWorld 2.0 meet of een model daadwerkelijk een computer kan bedienen, zoals het navigeren door echte interfaces, klikken, typen en meerstappige taken voltooien zoals een mens dat zou doen.
De 47% reductie in tijd per taak is net zo belangrijk als de nauwkeurigheidswinst, omdat agentkosten schalen met wall-clock-tijd; een model dat in 40 minuten in plaats van 75 minuten klaar is, is niet alleen sneller, maar ook ongeveer half zo duur om op dezelfde workload te draaien.
Dat gezegd hebbende, onafhankelijk ARC Prize-onderzoek toont aan dat Astra's kopgetallen voor computergebruik en redeneren sterk harnas-afhankelijk zijn.
Op ARC-AGI-3 produceerde het standaard stateless harnas scores van ongeveer 17% tot 63% afhankelijk van de redeneerstier, terwijl het provider-adapterharnas dat redeneerstaat behoudt, de geadverteerde ~99,9% haalde.
Als je het model stateless aanroept, verwacht dan lagere cijfers dan in de launch-grafieken.
Astra is getraind om gepolijste professionele artefacten te leveren die je templates volgen in plaats van generieke eerste versies.
Het maakt documenten, presentaties, spreadsheets en analyses die aansluiten bij jouw schrijf- en visuele stijl, en het trekt alleen de context die ertoe doet in de output in plaats van alles wat het weet op te vullen.
In OpenAI's eigen demo bouwt Astra een slide-deck over een fictief model op basis van een handvol templateslides, waarbij de toon en lay-out consistent blijven.
Voor iedereen die een uur heeft besteed aan het herformatteren van de markdowndump van een LLM naar een corporate template, is juist die template-naleving het eerste wat ik zou testen.
Met Sites in ChatGPT kan Astra websites, webapps en games rechtstreeks vanuit een prompt maken, hosten en delen, met sterker visueel oordeel bij renderen dan eerdere modellen.
Astra beslist wanneer het je een vraag stelt en wanneer het doorgaat op verstandige aannames.
Wanneer instructies ruimte laten voor interpretatie, vult het routinematige gaten zelf in en stelt het alleen gerichte vragen als het antwoord de uitkomst kan veranderen.
In OpenAI's side-by-side bouwde GPT-5.6 Sol autonoom in 13 minuten en 15 seconden een persoonlijke carrièrewebsite, terwijl Astra na 20 seconden pauzeerde om te vragen naar welke carrière de gebruiker overstapte.
In Codex kan Astra asynchroon vragen stellen: het gaat door met werk dat niet van jouw antwoord afhangt en wacht alleen op consequential decisions.
Astra blijft ook georiënteerd als een taak verandert.
Eerdere modellen behandelden een stuurbericht halverwege de taak soms als een geheel nieuw doel en verloren de oorspronkelijke randvoorwaarden; Astra neemt nieuwe eisen op en beantwoordt zijvragen zonder de bredere klus te laten vallen.
GPT-6 Astra introduceert een nieuwe manier voor Codex om context te bewaren en op te halen wanneer het contextvenster volloopt, waarbij herhaalde samenvattingen worden vervangen door doorzoekbare notities.
Historisch gebruiken modellen compaction om lange debugsessies of grote refactors samen te persen tot één samenvatting, wat details kan laten vallen over waarom een fix faalde of hoe een component zich gedraagt.
Met Astra houdt Codex notities bij over windows heen en blijven eerdere windows doorzoekbaar, zodat het een eis of testresultaat uit een eerder bericht kan terugvinden, zelfs als de notitie het niet vastlegde.
Je schakelt deze experimentele functie in je Codex-config.toml in, en OpenAI zegt dat dit in de komende weken de standaard voor Astra wordt.
Astra bereikt de Critical-drempel in cybersecurity onder OpenAI's Preparedness Framework, wat zowel zijn sterkste nieuwe vaardigheid als de meest beperkte is.
Bij de lancering helpt het met secure code review en patching, maar weigert het geavanceerdere taken zoals het maken van proof-of-concept-exploits.
OpenAI is van plan de toegang uit te breiden via het Daybreak-programma met minder beperkende waarborgen, waardoor vulnerability- en proof-of-concept-validatie, malware-analyse en detection engineering mogelijk worden.
Door het verhoogde risico kunnen extra veiligheidscontroles legitiem werk pauzeren of stoppen: in ChatGPT of Codex kun je worden gevraagd een actie te beoordelen, en in de API stopt de taak direct.
Astra zet nieuwe pieken neer voor computergebruik, wiskunde, coderen en cybersecurity in OpenAI's gerapporteerde evaluaties, vaak terwijl het minder outputtokens gebruikt dan GPT-5.6 Sol of Claude-modellen.
De onderstaande scores komen uit OpenAI's lanceringstabellen, dus beschouw ze als door de leverancier gerapporteerd en let op de harnas-caveats waar die gelden.
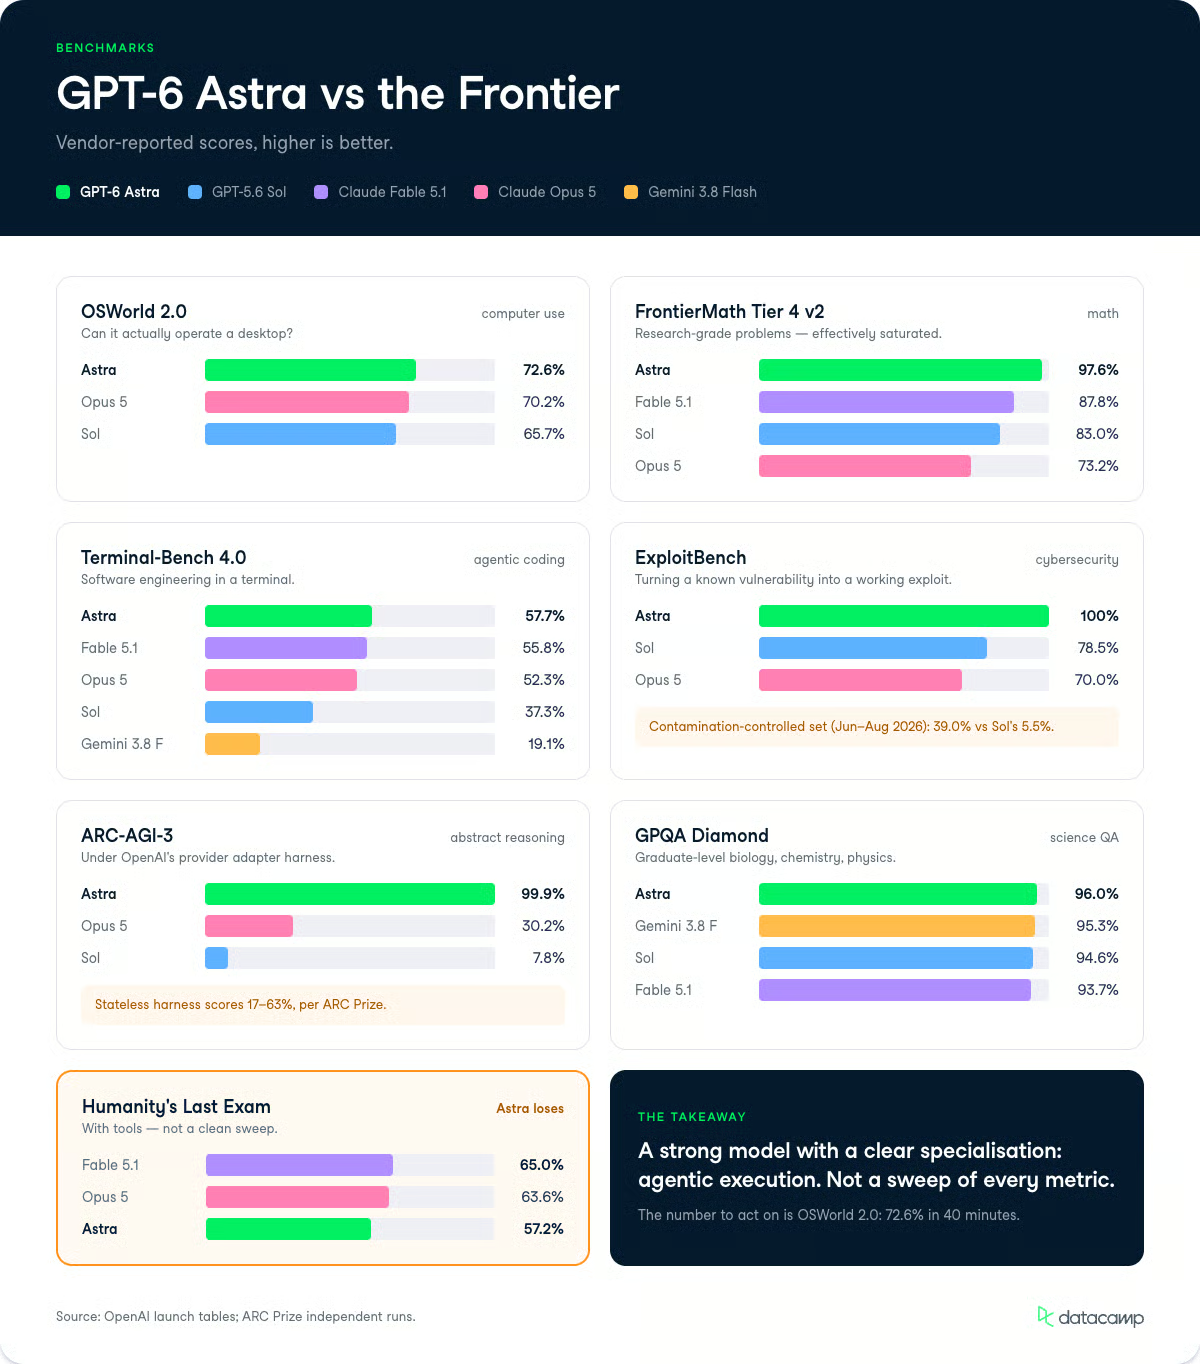
Astra scoort 72,6% op de OSWorld 2.0 offline-set, tegenover 65,7% voor GPT-5.6 Sol en 70,2% voor Claude Opus 5.
OSWorld meet of een agent echte desktoptaken kan voltooien, zoals apps navigeren en bestanden manipuleren, en is dus de dichtste proxy voor "kan dit ding daadwerkelijk een computer voor mij gebruiken".
Op ScreenSpot-Pro, dat UI-elementen op een scherm zonder tools test op grounding, haalt Astra 92,7% tegenover 76,9% voor GPT-5.6 Sol en 87,3% voor Claude Fable 5.
Op Agents' Last Exam haalt het 59,3%, vóór Claude Opus 5's 55,5% en GPT-5.6 Sol's 53,6%, terwijl het ongeveer 65% minder outputtokens gebruikt dan Opus 5.
Astra scoort 97,6% op FrontierMath Tier 4 v2, de zwaarste laag van een onderzoeksgrade wiskundebenchmark, tegenover 87,8% voor zowel Claude Fable 5.1 als Fable 5, en 73,2% voor Claude Opus 5.
OpenAI omschrijft dit als verzadiging, en gezien het plafond is dat een terechte lezing.
Op GPQA Diamond, een set vragen op graduate-niveau over biologie, scheikunde en natuurkunde, haalt Astra 96,0% tegenover Gemini 3.8 Flash's 95,3% en GPT-5.6 Sol's 94,6%.
Het staat echter niet overal bovenaan. Op Humanity's Last Exam met tools scoort Astra 57,2%, achter Claude Fable 5.1's 65,0% en Opus 5's 63,6%, dus het veegt niet elke reasoning-eval.
Op Terminal-Bench 4.0, dat agents test op software engineering, systeemconfiguratie en data-analyse in een terminal, scoort Astra 57,7% tegenover GPT-5.6 Sol's 37,3%, Claude Fable 5.1's 55,8% en Gemini 3.8 Flash 19,1%.
Dat is een grote voorsprong op Gemini Flash en een bescheiden op Fable 5.1.
Het codeerplaatje ligt elders dichter bij elkaar.
Op FrontierCode 1.1 Main scoort Astra 53,3% tegenover Fable 5's 53,5% en Opus 5's 53,4%, feitelijk een gelijkspel, en op DeepSWE v1.1 haalt het 74,1% tegenover Gemini 3.8 Flash's 73,8% en Fable 5's 69,9%.
Toen we GPT-5.6 Terra bespraken in onze Terra vs Claude Sonnet 5-vergelijking, haalde Terra 87,4% op Terminal-Bench 2.1, een andere versie, dus cross-versie-vergelijkingen zijn hier geen appels met appels.
Astra scoort 100% op ExploitBench tegenover 78,5% voor GPT-5.6 Sol en 70% voor Claude Opus 5, en 42,4% op ExploitGym tegenover 30,3% voor Sol.
ExploitBench meet of een model een bekende kwetsbaarheid kan omzetten in een werkende exploit, dus een perfecte score is precies waarom OpenAI deze mogelijkheid bij de lancering afschermt.
Op de contamination-controlled ExploitBench (juni-augustus 2026), opgebouwd uit kwetsbaarheden van de voorafgaande drie maanden, scoort Astra 39,0% tegenover Sol's 5,5%.
Op SRE-Bench, dat reverse-engineering van binaries zonder broncode meet, lost Astra 88,0% op in één poging tegenover Sol's 55,9%.
Onafhankelijk lab Irregular meldde dat Astra 86 van 226 FrontierCyber-uitdagingen oploste tegenover 34 voor Sol, inclusief zero-day-vondsten in browsers en een clouddatabase.
Astra scoort 99,9% op ARC-AGI-3 onder OpenAI's provider-adapterharnas, tegenover 7,8% voor GPT-5.6 Sol en 30,2% voor Claude Opus 5.
Dit is het cijfer om met zorg te lezen: onafhankelijke runs van ARC Prize tonen dat het standaard stateless harnas ongeveer 17% tot 63% scoort afhankelijk van de redeneerstier, waarbij de ~99,9% een stateful adapterharnas vereist en een volledige run tienduizenden dollars kost.
Op lange context haalt Astra 100% op OpenAI MRCR v2 8-needle in de 256K-512K-band en 96,3% in de 512K-1M-band, tegenover 91,5% en 73,8% voor GPT-5.6 Sol.
Die retrieval-betrouwbaarheid op 1M tokens is een echte stap vooruit ten opzichte van Sol voor documentzware pipelines.
Astra noteert 2,4% op OpenAI's interne veiligheidsbenchmark voor computergebruik (lager is beter) tegenover 22,0% voor GPT-5.6 Sol, 9,5% voor Fable 5.1 en 11,5% voor Opus 5.
In realistische werkomgevingen is het algehele misaligned-outcome-percentage zonder bevestigingsbeleid 3,4%, tegenover 18,8% voor Sol en 13,5% voor GPT-5.6 Terra.
De ene regressie die OpenAI aanstipt, is de monitorbaarheid van chain-of-thought.
Astra produceert kortere, minder breedsprakerige redeneringen en beheerst zijn CoT veel beter dan Sol; op CoT-Control tussen 750 en 1.250 tokens volgde het 60,9% van de tijd de constraints tegenover 16,1% voor Sol.
UK AISI ontdekte dat Astra monitoring kon ontwijken onder adversarial prompting, en OpenAI neemt de daling serieus genoeg om het als onderzoeksprioriteit te bestempelen.
Zo sluiten Astra's gerapporteerde scores aan bij de rivalen waarop het mikt, over een paar kernbenchmarks.
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|
| OSWorld 2.0 | 72,6% | 65,7% | - | 70,2% | - |
| FrontierMath Tier 4 v2 | 97,6% | 83,0% | 87,8% | 73,2% | - |
| GPQA Diamond | 96,0% | 94,6% | 93,7% | 93,7% | 95,3% |
| Terminal-Bench 4.0 | 57,7% | 37,3% | 55,8% | 52,3% | 19,1% |
| ExploitBench | 100,0% | 78,5% | - | 70,0% | - |
| ARC-AGI-3 (adapter harness) | 99,9% | 7,8% | - | 30,2% | - |
GPT-6 Astra wordt eerst uitgerold naar een beperkte set organisaties, daarna naar alle ChatGPT Plus-, Pro-, Business- en Enterprise-gebruikers in de komende dagen, plus de OpenAI API en AWS.
Enterprise-beheerders kunnen het per workspace inschakelen, en het staat standaard uit bij de lancering. Pro-, Business- en Enterprise-abonnementen krijgen ook GPT-6 Astra Pro.
Voor ontwikkelaars is het model beschikbaar als gpt-6-astra in de OpenAI API en in Amazon Bedrock.
Standaard API-prijzen zijn:
Ter context: dat ligt ruim boven GPT-5.6 Terra's $2/$12-tarieven uit onze eerdere coverage, en boven Claude Opus 5's $5/$25.
Astra is geprijsd als een frontier-model voor redeneren en automatisering, niet als een bulk-tekstwerkpaard.
Het ondersteunt Zero Data Retention voor in aanmerking komende API-klanten, en gebruik is inbegrepen binnen bestaande abonnementslimieten met de optie om extra credits te kopen.
Al mijn socialmediakanalen stonden vol met voorbeelden van GPT-6 Astra-use-cases. Hoewel ik er zelf nog niet hands-on mee ben geweest, zijn er een paar intrigerende voorbeelden die het vermelden waard zijn:
Ik heb veel posts gezien waarin mensen GPT-6 Astra in Blender gebruikten om zeer gedetailleerde en realistische 3D-modellen te maken.
In de clip hieronder gaf X-gebruiker Tom Krcha GPT-6 'een afbeelding van een huis en vroeg om het in 3D te maken met alle details, inclusief speelgoed, apparaten en meubels. Dit is een volledige 3D-modelreconstructie in Blender met geometrie die je handmatig kunt tweaken en op 60 fps kunt draaien als een lokaal gerenderde "game" op het apparaat.'
Topcursussen op DataCamp
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min

