
Last chance! 50% off DataCamp Premium
Sale ends in
Dit artikel is een gewaardeerde bijdrage uit onze community en is door DataCamp bewerkt voor duidelijkheid en nauwkeurigheid.
Wil je jouw eigen expertise delen? We horen graag van je! Dien je artikelen of ideeën in via ons Community Contribution Formulier.
Veel organisaties zijn tegenwoordig afhankelijk van data om beslissingen te nemen. Die data wordt vaak vastgelegd en verzameld uit diverse bronnen, in allerlei vormen en formaten. Meestal wordt deze data in een eigen silo opgeslagen en getransformeerd en gebruikt om specifieke vragen over die data te beantwoorden. Naarmate organisaties overstappen op een data-gedreven aanpak, komt er bij datateams een ogenschijnlijk eenvoudige vraag op: Kunnen we de prestaties van alle klanten van het bedrijf op één centrale plek beoordelen? (of kunnen we alle datapunten op één plek zien?)
In deze tutorial leer je hoe je technieken die je mogelijk al kent, kunt combineren om een oplossing te bouwen die helpt deze vraag te beantwoorden.
Hier hebben we enkele kernconcepten uiteengezet die we in de rest van dit artikel zullen verkennen.
Een groot, gecentraliseerd archief waarin gestructureerde, semi-gestructureerde en ongestructureerde data op elke schaal wordt opgeslagen. Het biedt een flexibele en kosteneffectieve oplossing voor het opslaan van grote hoeveelheden diverse datatypes uit verschillende bronnen.
In tegenstelling tot traditionele datasystemen vereist een datalake geen voorafgaande datamodellering of strikte schemahandhaving, waardoor data as-is kan worden opgeslagen. Deze ruwe en onbewerkte data kan naar behoefte worden verwerkt, geanalyseerd en getransformeerd, waardoor het een waardevolle bron is voor data-gedreven besluitvorming en geavanceerde analytics.
Je kunt een datalake vergelijken met een datawarehouse in een apart artikel.
Een datawarehouse is een groot, gecentraliseerd archief waarin gestructureerde data wordt opgeslagen en beheerd. Het is ontworpen om business intelligence, rapportage en data-analyse te ondersteunen. Datawarehouses consolideren data uit meerdere databases, applicaties en systemen en transformeren die naar een uniforme, consistente indeling voor efficiënt raadplegen en analyseren.
Microservices zijn een architecturale en organisatorische aanpak voor softwareontwikkeling waarbij software bestaat uit kleine, onafhankelijke services die communiceren via goed gedefinieerde API’s. Deze services zijn in eigendom van kleine, zelfstandige teams. Microservice-architecturen maken applicaties makkelijker schaalbaar en sneller te ontwikkelen, wat innovatie stimuleert en de time-to-market voor nieuwe features versnelt.
Deze aanpak omvat stappen van dataverzameling, opslag, verwerking, het bouwen van stagingviews en het op schaal genereren van analytics.
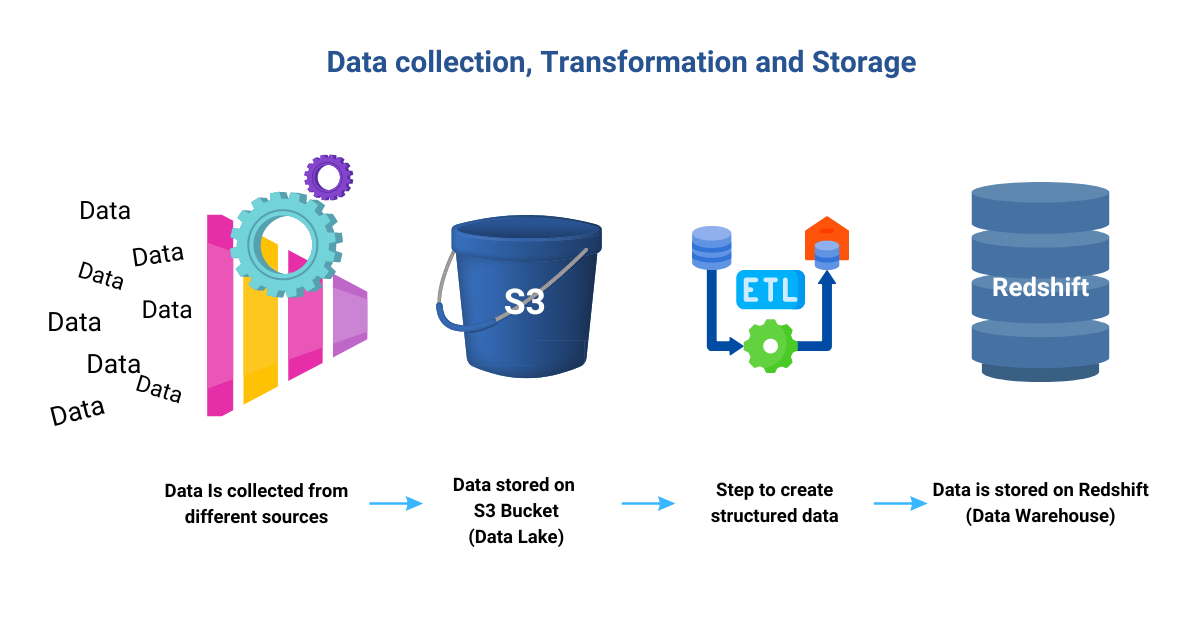 Afbeelding door de auteur
In deze eerste fase is het cruciaal om belangrijke randvoorwaarden te adresseren voordat je in de taak duikt. Onderzoek de herkomst en opslag van de data grondig om een volledig beeld te krijgen van de bronnen.
Bedenk effectieve strategieën om de verzamelde data bruikbaar te maken en klaar voor analyse. Data wrangling speelt een cruciale rol om te zorgen dat de data schoon en bruikbaar is en klaar voor verdere verwerking. Daarnaast ligt de prioriteit bij het vinden van een oplossing die naadloos datapunten van verschillende klanten integreert, met behoud van de integriteit en veiligheid van de data.
DataCamp’s gids What is Data Analysis gaat dieper in op dit proces.
Data wordt verzameld van verschillende klanten en geconsolideerd in S3-buckets (een opslaglocatie in Amazon Simple Storage Service (Amazon S3)), waarmee een datalake ontstaat om de diverse informatie in ruwe vorm te bewaren. De volgende stap omvat het gebruik van Extract, Transform, Load (ETL)-processen om de verzamelde data om te zetten in een gestructureerde dataset die naadloos in het datawarehouse past. Het datawarehouse wordt zo een opslagplaats waar schema’s en gestructureerde data zorgvuldig zijn georganiseerd. De data voor elke klant blijft echter gescheiden en bevindt zich in hun eigen silo’s binnen het datawarehouse.
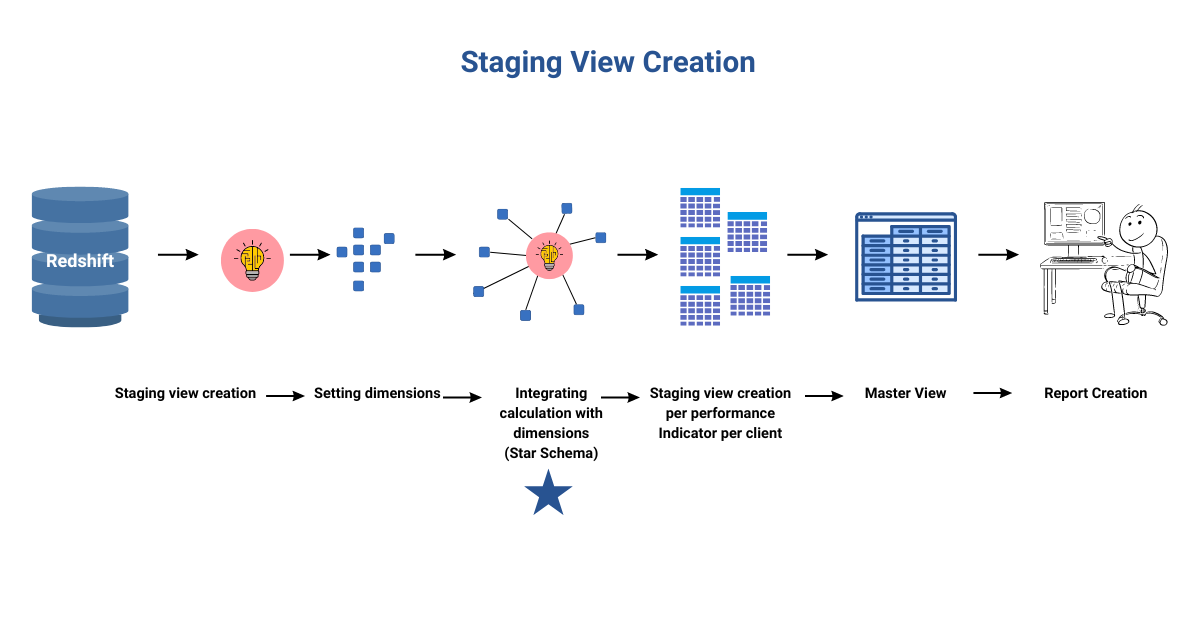 Afbeelding door de auteur
De stagingviews worden opgebouwd door gebruik te maken van de relaties tussen schema, tabellen en kolommen in een datawarehouse. Dit resulteert in een vereenvoudigde businessview die complexiteit verbergt en zorgt voor een consistente interpretatie van dimensies en feiten voor analyse. Alle gebruikers binnen de organisatie hebben toegang tot nauwkeurige, centraal beheerde data, wat waardevolle inzichten mogelijk maakt in prestaties over verschillende dimensies.
De kern van deze aanpak is het technische proces van het creëren van stagingviews. Deze views bevatten de berekeningen en attributen die nodig zijn voor rapportage en analytics, waardoor het hele ecosysteem schaalbaar wordt. Nieuwe logica of wijzigingen worden in deze stagingviews doorgevoerd.
Om effectief te kunnen troubleshooten, worden stagingviews per klant en per prestatie-indicator gemaakt, zodat problemen gericht en efficiënt kunnen worden opgespoord en opgelost. Deze aanpak staat in contrast met één enkele, enorme stored procedure, die het identificeren van problemen tijdrovend en lastig kan maken.
Met segmentatie- en aggregatietechnieken worden hoog-niveau/geaggregeerde prestatie-indicatoren gegenereerd door transactionele data te analyseren en die op slimme wijze te combineren. Elke stagingview omvat de rekenlogica en dimensies om de gewenste outputwaarde te leveren. Dit proces wordt voor elke klant herhaald, wat resulteert in een aparte stagingview voor elke prestatie-indicator per klant, terwijl de beveiliging van gevoelige informatie behouden blijft.
In stap 3 van ons proces hebben we alle data samengebracht in één masterview. Deze masterview vormt de basis voor het maken van klantspecifieke views door filters toe te passen op basis van specifieke klantgerelateerde attributen. Doordat alle klantdimensionale attributen op één plek staan, wordt het maken van views gestroomlijnd.
Bovendien kan de masterview data voor meerdere jaren opslaan, maar hij kan eenvoudig worden beperkt tot slechts een paar maanden aan data, afgestemd op de specifieke behoeften van elke klant. Deze flexibiliteit stelt ons in staat om klanten precies de data te bieden die ze nodig hebben, wat de relevantie en efficiëntie van onze analyses vergroot.
Het star-schema (een multidimensionaal datamodel om data te organiseren) dient als het gebruikte datamodel. Dit model splitst de data effectief op in twee kernelementen: de facttabel en de dimensionstabellen.
De numerieke data in de facttabel is naadloos gekoppeld aan de dimensionstabellen via primaire sleutels, waardoor relaties ontstaan die gemakkelijk te begrijpen zijn. Deze opzet helpt gebruikers om snel en eenvoudig queries uit te voeren door data te filteren en te aggregeren op basis van verschillende dimensies. Data-analyse wordt kinderspel, omdat gebruikers specifieke datapunten kunnen verkennen zonder ingewikkelde joins over meerdere tabellen.
De briljante, gedenormaliseerde structuur van het star-schema zorgt ervoor dat dimensionstabellen onafhankelijk zijn, wat leidt tot razendsnelle queryprestaties. De database-engine kan data moeiteloos ophalen zonder uitgebreide verwerking, waardoor betere responstijden worden geleverd, zelfs voor de meest complexe analytische queries.
Kortom, het star-schema is een krachtige bondgenoot die data-analyse eenvoudig en efficiënt maakt. Door data te organiseren in fact- en dimensionstabellen worden queries versneld, wordt verkennen eenvoudiger en gaat er een wereld aan inzichten open voor onderbouwde besluitvorming.
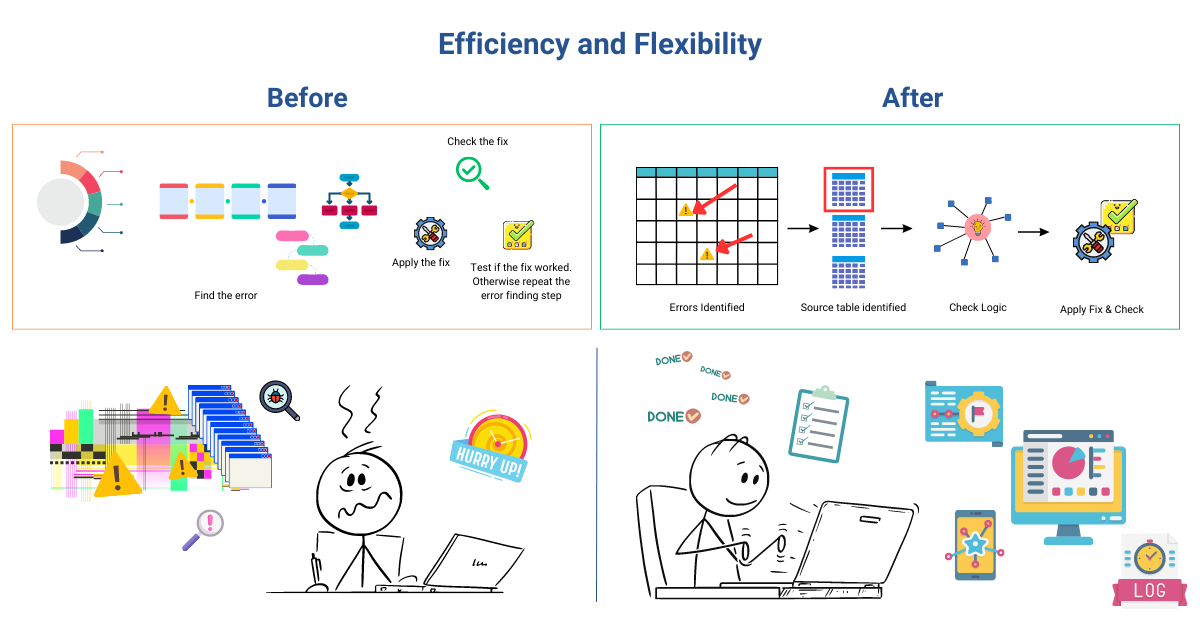
Afbeelding door de auteur
De echte kracht van deze aanpak zit in de opmerkelijke efficiëntie en ongeëvenaarde flexibiliteit. Dit is waar het concept van microservices wordt benut.
Wanneer er wijzigingen nodig zijn, of het nu gaat om herberekeningen of het aanpakken van dataproblemen, updaten we eenvoudig de logica van de prestatie-indicator binnen het stagingscript. Bovendien maakt dit proces van troubleshooten en aanpassingen naadloze en razendsnelle taken, wat mogelijke downtime drastisch terugdringt.
Om de kracht van deze aanpak echt te begrijpen, stel je een scenario voor waarin de prestatie-indicator van een specifieke klant een afwijkend datapunt laat zien. In de traditionele manier van troubleshooten zouden we een langdurig proces moeten doorlopen om de hoofdoorzaak te achterhalen, met meerdere stappen zoals herberekeningen, code-runs en datavalidatie.
Met de huidige aanpak bereiken we een ongekend niveau van efficiëntie en stroomlijnen we het troubleshootingproces.
We kunnen nu razendsnel de exacte prestatie-indicator aanwijzen die verantwoordelijk is voor een afwijking, de logica grondig inspecteren en direct de bijbehorende tabel voor berekeningen valideren. Daardoor wordt het identificeren van de oorsprong van fouten moeiteloos en het doorvoeren van noodzakelijke fixes gaat uitzonderlijk snel. Dankzij deze aanpak wordt de tijd voor troubleshooting drastisch verkort, omdat we ons kunnen richten op het snel oplossen van problemen in plaats van vast te lopen in lange en omslachtige stappen.
Om prestatieniveaus te beoordelen—of ze nu goed, slecht of voor verbetering vatbaar zijn—vertrouwen we op doelen. Daarvoor kan een applicatie-interface worden ontwikkeld en gekoppeld aan de mastertabel. Deze gebruiksvriendelijke interface legt doelinvoer op attribuutniveau vast van gebruikers, die wordt opgeslagen in een aparte tabel. Door de mastertabel te integreren met een applicatie die rechtstreeks input accepteert uit de data die beschikbaar is in de datawarehousetabel, tonen we het fundament van deze aanpak voor het bouwen van oplossingen.
De dojeltabel wordt vervolgens gecombineerd met de Performance Master-tabel, waardoor een holistisch beeld ontstaat van prestatie-indicatoren naast hun respectieve doelen. Deze integratie stelt ons in staat een volledig begrip te krijgen van hoe goed de doelstellingen worden gehaald.
Rapporten bouwen op basis van deze data maakt de oplossing compleet en levert krachtige inzichten op die besluitvorming sturen.
De aanpak die we hebben uiteengezet, heeft alle data samengebracht en de weg vrijgemaakt om de grote vraag te beantwoorden: Kunnen we de prestaties van alle klanten van het bedrijf op één centrale plek beoordelen?
Maar er is meer! Deze oplossing is geen vluchtig project; het is een robuuste, tijdloze oplossing die eindeloze mogelijkheden opent. Stel je voor: meerdere rapporten bouwen die allemaal op deze oplossing als stevige basis leunen.
Nu komt het spannende deel—deze onschatbare kennis doorgeven om een groep vaardige mensen te vormen die het potentieel kunnen benutten. Een oplossing bouwen is niet genoeg; om het echt schaalbaar en duurzaam te maken, moeten we teams in staat stellen en de expertise in datawijsheid opbouwen om deze goed geoliede machine vlekkeloos te laten draaien.
Net als de Six Sigma-methodologie, die helpt bedrijfsprocessen te verbeteren, verbeteren we processen continu, stroomlijnen we workflows en nemen we maatregelen om deze uitzonderlijke aanpak te behouden.
In essentie bouwen we niet alleen een oplossing; we ontketenen een transformatie die de komende jaren vooruitgang en excellentie zal stimuleren.
In veel gevallen vereisen de eenvoudigste vragen een geavanceerde datainfrastructuur. Data science draait er in de kern om data te benutten om een significante impact op je organisatie te maken. Met deze krachtige oplossing in handen kun je het ware potentieel van je data ontsluiten en een transformatieve impact creëren.
Klaar om dieper in data-engineering en analytics te duiken? Schrijf je in voor DataCamp’s Streamlined Data Ingestion with pandas-cursus om praktische vaardigheden op te doen in het optimaliseren van dataverzameling, -inname en -transformatie. Of bekijk het Data Engineer in Python-carrièrepad om de veelgevraagde skills te leren waar bedrijven naar op zoek zijn en neem, zodra je er klaar voor bent, de Data Engineer Certification.
blog
Adel Nehme
15 min

