यह लेख हमारे समुदाय का एक मूल्यवान योगदान है और स्पष्टता व सटीकता के लिए DataCamp द्वारा संपादित किया गया है।
क्या आप अपना विशेषज्ञता साझा करना चाहते हैं? हमें आपसे सुनकर खुशी होगी! कृपया अपने लेख या विचार हमारे Community Contribution Form के माध्यम से भेजें।
आज कई संगठन निर्णय लेने के लिए डेटा पर निर्भर करते हैं। डेटा अक्सर विभिन्न स्रोतों से अलग-अलग रूपों में रिकॉर्ड और एकत्र किया जाता है। ज्यादातर मामलों में, यह डेटा अपने-अपने साइलो में संग्रहीत और रूपांतरित होता है और उसी डेटा से जुड़े विशिष्ट प्रश्नों के उत्तर देने में काम आता है। जैसे-जैसे संगठन डेटा-प्रेरित दृष्टिकोण अपनाते हैं, डेटा टीमों के सामने एक सरल-सा प्रश्न आता है: क्या हम कंपनी के सभी क्लाइंट्स के प्रदर्शन का आकलन एक केंद्रीकृत स्थान पर कर सकते हैं? (या क्या हम सभी डेटा पॉइंट्स एक ही जगह देख सकते हैं?)
इस ट्यूटोरियल में, आप सीखेंगे कि पहले से जानी-पहचानी तकनीकों का लाभ उठाकर और उन्हें परत-दर-परत जोड़कर ऐसा समाधान कैसे बनाया जाए जो इस प्रश्न का उत्तर देने में मदद करे।
मुख्य विचार
यहाँ हमने कुछ प्रमुख अवधारणाएँ रेखांकित की हैं जिनका अन्वेषण हम आगे के लेख में करेंगे।
डेटा लेक
एक विशाल, केंद्रीकृत रिपॉजिटरी जो किसी भी पैमाने पर संरचित, अर्ध-संरचित और असंरचित डेटा को संग्रहित करती है। यह विभिन्न स्रोतों से आने वाले विविध डेटा प्रकारों के बड़े वॉल्यूम को संग्रहीत करने के लिए लचीला और किफायती समाधान प्रदान करती है।
पारंपरिक डेटा स्टोरेज सिस्टम्स के विपरीत, डेटा लेक में पहले से डेटा मॉडलिंग या कड़े स्कीमा लागू करने की आवश्यकता नहीं होती, जिससे डेटा को जैसा है वैसा ही संग्रहीत किया जा सकता है। यह कच्चा और अप्रसंस्कृत डेटा आवश्यकता अनुसार प्रोसेस, विश्लेषित और रूपांतरित किया जा सकता है, जो डेटा-आधारित निर्णय लेने और उन्नत एनालिटिक्स के लिए इसे मूल्यवान संसाधन बनाता है।
आप डेटा लेक बनाम डेटा वेयरहाउस की तुलना एक अलग लेख में देख सकते हैं।
डेटा वेयरहाउस
डेटा वेयरहाउस एक बड़ा, केंद्रीकृत रिपॉजिटरी है जो संरचित डेटा को संग्रहीत और प्रबंधित करता है। यह बिज़नेस इंटेलिजेंस, रिपोर्टिंग और डेटा विश्लेषण गतिविधियों का समर्थन करने के लिए बनाया गया है। डेटा वेयरहाउस कई डेटाबेस, अनुप्रयोगों और सिस्टमों से डेटा को समेकित करते हैं और इसे कुशल क्वेरीइंग व विश्लेषण के लिए एकीकृत, सुसंगत प्रारूप में रूपांतरित करते हैं।
माइक्रोसर्विसेज
माइक्रोसर्विसेज सॉफ्टवेयर विकास का एक आर्किटेक्चरल और संगठनात्मक दृष्टिकोण है जिसमें सॉफ्टवेयर छोटे-छोटे स्वतंत्र सर्विसेज से मिलकर बना होता है जो सुव्यवस्थित API के माध्यम से संचार करते हैं। ये सर्विसेज छोटी, स्वायत्त टीमों के स्वामित्व में होती हैं। माइक्रोसर्विसेज आर्किटेक्चर अनुप्रयोगों को स्केल करना आसान बनाते हैं और विकास को तेज करते हैं, जिससे नवाचार और नई सुविधाओं के लिए टाइम-टू-मार्केट तेज होता है।
अनुकूलनशील डेटा पाइपलाइन बनाना
यह दृष्टिकोण डेटा संग्रह, भंडारण, प्रोसेसिंग, स्टेजिंग व्यूज़ बनाने और बड़े पैमाने पर एनालिटिक्स जनरेट करने के चरणों से मिलकर बना है।
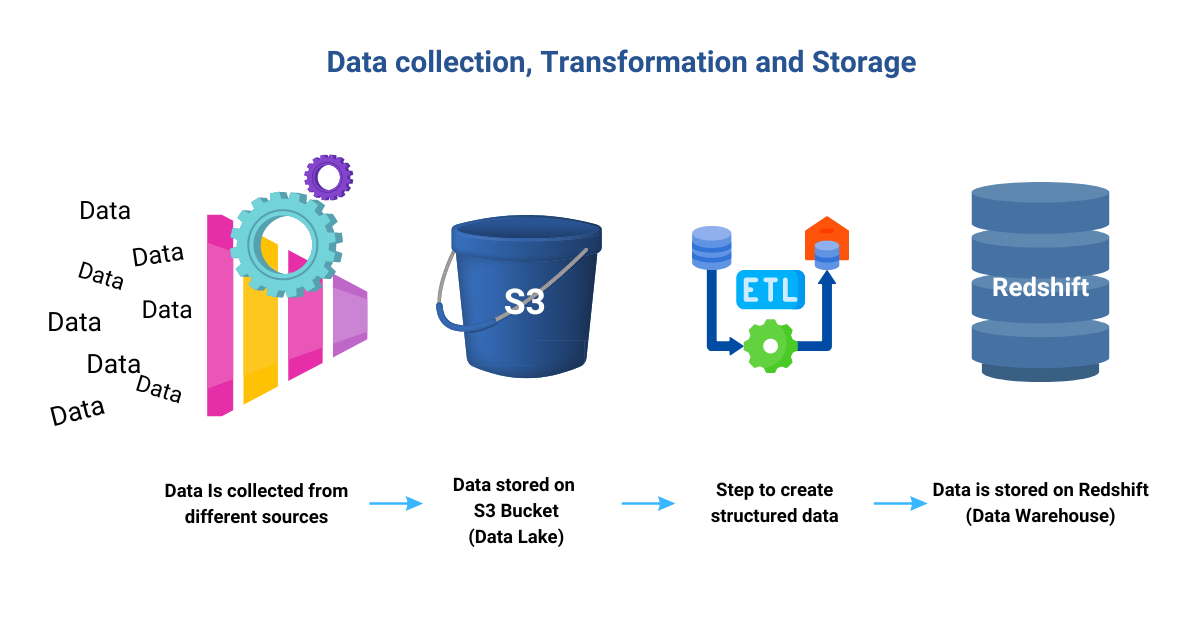 Image by Author
चरण 1: डेटा संग्रह और पूर्वापेक्षाएँ
प्रारंभिक चरण में, हाथ में मौजूद कार्य में गोता लगाने से पहले महत्वपूर्ण पूर्वापेक्षाओं को संबोधित करना आवश्यक है। डेटा के स्रोतों और भंडारण को अच्छी तरह परखें ताकि उसके स्रोतों की समग्र समझ बन सके।
एकत्रित डेटा को उपयोगी और विश्लेषण के लिए तैयार बनाने की प्रभावी रणनीतियाँ विकसित करें। डेटा रैंगलिंग यह सुनिश्चित करने में महत्वपूर्ण भूमिका निभाती है कि डेटा स्वच्छ और उपयोगी प्रारूप में हो, जिससे उसे आगे की प्रोसेसिंग के लिए तैयार किया जा सके। इसके अलावा, प्राथमिकता ऐसे समाधान को खोजने की है जो अलग-अलग क्लाइंट्स के डेटा पॉइंट्स को निर्बाध रूप से एकीकृत करे, साथ ही डेटा की अखंडता और सुरक्षा को बनाए रखे।
DataCamp की गाइड, What is Data Analysis, इस प्रक्रिया को और विस्तार से समझाती है।
चरण 2: डेटा लेक और डेटा वेयरहाउस
डेटा विभिन्न क्लाइंट्स से एकत्र कर S3 Buckets (Amazon Simple Storage Service (Amazon S3) में एक स्टोरेज लोकेशन) में समेकित किया जाता है, जो कच्चे रूप में विविध जानकारी रखने के लिए एक डेटा लेक बनता है। अगला कदम Extract, Transform, Load (ETL) प्रक्रियाओं का उपयोग कर एकत्रित डेटा को एक संरचित डेटासेट में रूपांतरित करना है जो डेटा वेयरहाउस में सहजता से फिट हो। नतीजतन, डेटा वेयरहाउस एक ऐसा रिपॉजिटरी बन जाता है जहाँ स्कीमा और संरचित डेटा सुव्यवस्थित ढंग से संगठित होते हैं। हालाँकि, प्रत्येक क्लाइंट का डेटा अलग रहता है और डेटा वेयरहाउस के भीतर उनके-अपने साइलो में रहता है।
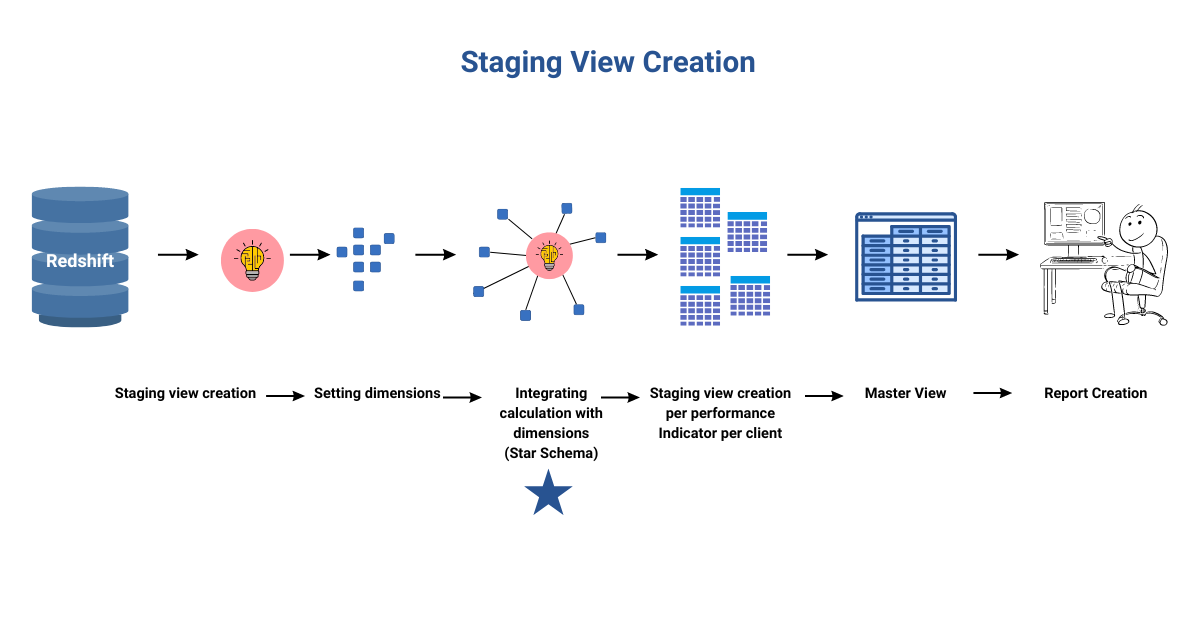 Image by Author
चरण 3: स्टेजिंग व्यू (इस ऑपरेशन का हृदय)
स्टेजिंग व्यूज़ डेटा वेयरहाउस में स्कीमा, टेबल और कॉलम के बीच संबंधों का लाभ उठाकर बनाए जाते हैं। इसका परिणाम एक सरलीकृत व्यावसायिक व्यू के रूप में मिलता है जो जटिलता को छुपाता है और विश्लेषण के लिए डाइमेंशन्स और फैक्ट्स की सुसंगत समझ सुनिश्चित करता है। सभी एंटरप्राइज़ उपयोगकर्ता केंद्रीकृत रूप से प्रबंधित, सटीक डेटा तक पहुँच सकते हैं, जिससे विभिन्न डाइमेंशन्स में प्रदर्शन पर मूल्यवान अंतर्दृष्टि मिलती है।
इस दृष्टिकोण के केंद्र में स्टेजिंग व्यूज़ बनाना एक तकनीकी प्रक्रिया है। इन व्यूज़ में रिपोर्टिंग और एनालिटिक्स के लिए आवश्यक गणनाएँ और एट्रिब्यूट्स होते हैं, जिससे पूरा इकोसिस्टम स्केलेबल बनता है। कोई भी नया लॉजिक या बदलाव इन्हीं स्टेजिंग व्यूज़ पर लागू किए जाते हैं।
प्रभावी ट्रबलशूटिंग को संभव बनाने के लिए, स्टेजिंग व्यूज़ प्रति क्लाइंट और प्रति प्रदर्शन संकेतक बनाए जाते हैं, जिससे समस्याओं की सटीक पहचान और समाधान कुशलता से हो सके। यह दृष्टिकोण एकल, विशाल स्टोर्ड प्रोसीजर के उपयोग के विपरीत है, जो समस्या पहचान को समय-साध्य और चुनौतीपूर्ण बना सकता है।
सेगमेंटेशन और एग्रीगेशन तकनीकों के माध्यम से, लेनदेन डेटा का विश्लेषण कर और उन्हें कुशलतापूर्वक मिलाकर उच्च-स्तरीय/संयुक्त प्रदर्शन संकेतक उत्पन्न किए जाते हैं। प्रत्येक स्टेजिंग व्यू वांछित आउटपुट वैल्यू देने के लिए गणना लॉजिक और डाइमेंशन्स को समाहित करता है। यह प्रक्रिया प्रत्येक क्लाइंट के लिए दोहराई जाती है, जिसके परिणामस्वरूप प्रत्येक क्लाइंट के प्रति प्रदर्शन संकेतक हेतु अलग स्टेजिंग व्यू बनते हैं, जबकि संवेदनशील जानकारी की सुरक्षा बनी रहती है।
चरण 4: डेटा मॉडलिंग
प्रक्रिया के चरण 3 में, हमने सारा डेटा एक एकल मास्टर व्यू में समेकित कर लिया है। यह मास्टर व्यू, क्लाइंट-विशिष्ट एट्रिब्यूट्स के आधार पर फ़िल्टर लागू कर, क्लाइंट-विशिष्ट व्यूज़ बनाने की नींव का काम करता है। सभी क्लाइंट्स के डाइमेंशनल एट्रिब्यूट्स एक ही जगह होने से व्यू निर्माण की प्रक्रिया सरल हो जाती है।
आगे, मास्टर व्यू में कई वर्षों का डेटा संग्रहीत किया जा सकता है, लेकिन इसे आसानी से सीमित कर केवल कुछ महीनों का डेटा शामिल किया जा सकता है, जो प्रत्येक क्लाइंट की विशिष्ट आवश्यकताओं के अनुरूप हो। यह लचीलापन हमें क्लाइंट्स को वही डेटा प्रदान करने देता है जिसकी उन्हें आवश्यकता है, जिससे हमारे एनालिटिक्स की प्रासंगिकता और दक्षता बढ़ती है।
स्टार स्कीमा मॉडल (डेटा को व्यवस्थित करने के लिए प्रयुक्त एक बहु-आयामी डेटा मॉडल) बतौर डेटा मॉडल उपयोग किया जाता है। यह मॉडल डेटा को दो प्रमुख घटकों में प्रभावी ढंग से विभाजित करता है: फैक्ट टेबल और डाइमेंशन टेबल्स।
फैक्ट टेबल के संख्यात्मक डेटा डाइमेंशन टेबल्स से प्राइमरी कीज़ के माध्यम से सहजता से जुड़ते हैं, जिससे आसानी से समझ आने वाले संबंध स्थापित होते हैं। यह सेटअप उपयोगकर्ताओं को विभिन्न डाइमेंशन्स के आधार पर डेटा को फ़िल्टर और एग्रीगेट कर तेज़ और सरल क्वेरियाँ चलाने में मदद करता है। डेटा विश्लेषण सरल हो जाता है क्योंकि उपयोगकर्ता कई टेबल्स में जटिल जोइन्स से जूझे बिना विशिष्ट डेटा पॉइंट्स का अन्वेषण कर सकते हैं।
स्टार स्कीमा की उत्कृष्ट डीनॉर्मलाइज़्ड संरचना डाइमेंशन टेबल्स को स्वतंत्र बनाती है, जिससे क्वेरी प्रदर्शन बिजली-सी तेज़ हो जाता है। डेटाबेस इंजन व्यापक प्रोसेसिंग के बिना ही आसानी से डेटा प्राप्त कर सकता है, और जटिल विश्लेषणात्मक क्वेरियों के लिए भी बेहतर प्रतिक्रिया समय देता है।
संक्षेप में, स्टार स्कीमा एक शक्तिशाली सहयोगी है, जो डेटा विश्लेषण को सरल और कुशल बनाता है। डेटा को फैक्ट और डाइमेंशन टेबल्स में व्यवस्थित करना क्वेरीइंग को तेज़ करता है, अन्वेषण को सरल बनाता है, और सूचित निर्णय लेने के लिए अंतर्दृष्टियों की दुनिया खोलता है।
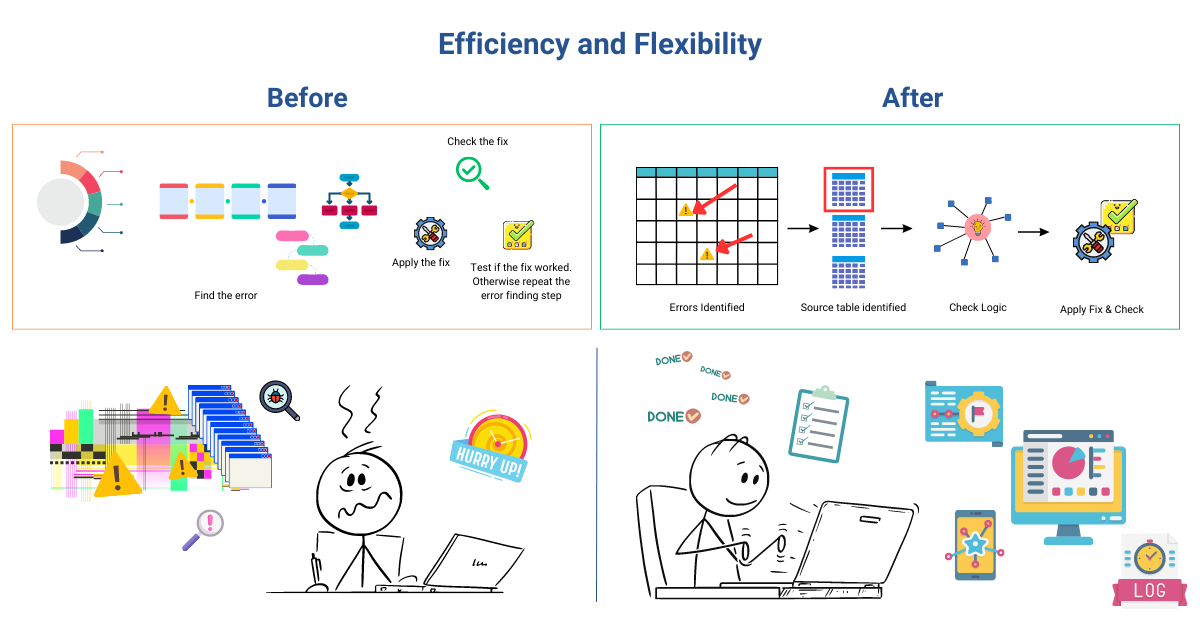
Image by Author
दक्षता और लचीलापन
इस दृष्टिकोण की असली उत्कृष्टता इसकी उल्लेखनीय दक्षता और बेजोड़ लचीलेपन में निहित है। यहीं माइक्रोसर्विसेज की अवधारणा का लाभ उठाया जाता है।
जब बदलाव आवश्यक हों—चाहे दोबारा गणना करनी हो या डेटा समस्याओं का समाधान—तो हम बस स्टेजिंग स्क्रिप्ट के भीतर प्रदर्शन संकेतक के लॉजिक को अपडेट कर देते हैं। साथ ही, यह प्रक्रिया ट्रबलशूटिंग और संशोधनों को भी निर्बाध और बेहद तेज़ कार्यों में बदल देती है, जिससे संभावित डाउनटाइम में भारी कमी आती है।
इस दृष्टिकोण की शक्ति को सच में समझने के लिए, एक ऐसा परिदृश्य देखें जहाँ किसी विशिष्ट क्लाइंट का प्रदर्शन संकेतक असंगत डेटा पॉइंट दिखाता है। पारंपरिक ट्रबलशूटिंग पद्धति में हमें जड़ कारण तक पहुँचने के लिए लंबी प्रक्रिया से गुजरना पड़ता—जिसमें दोबारा गणनाएँ, कोड रन और डेटा वैलिडेशन जैसे कई चरण शामिल होते।
वर्तमान दृष्टिकोण के साथ, हम अद्वितीय स्तर की दक्षता प्राप्त करते हैं और ट्रबलशूटिंग प्रक्रिया को सुव्यवस्थित करते हैं।
अब हम किसी भी विसंगति के लिए ज़िम्मेदार सटीक प्रदर्शन संकेतक को तुरंत चिन्हित कर सकते हैं, उसके लॉजिक की पूरी तरह जाँच कर सकते हैं और गणनाओं के लिए संबंधित टेबल को तुरंत वैलिडेट कर सकते हैं। परिणामस्वरूप, त्रुटियों के स्रोत की पहचान करना आसान हो जाता है और आवश्यक सुधार असाधारण गति से लागू होते हैं। इस दृष्टिकोण की बदौलत, ट्रबलशूटिंग समय में नाटकीय कमी आती है, क्योंकि हम लंबी और थकाऊ चरणों में उलझने के बजाय समय पर मुद्दों के समाधान पर अधिक ध्यान दे पाते हैं।
एप्लिकेशन और रिपोर्टिंग
प्रदर्शन स्तरों—चाहे वे अच्छे हों, खराब हों, या सुधार की आवश्यकता हो—का आकलन करने के लिए हम लक्ष्यों पर निर्भर करते हैं। इसे पूरा करने के लिए, एक एप्लिकेशन इंटरफ़ेस विकसित किया जा सकता है और मास्टर टेबल से जोड़ा जा सकता है। यह उपयोगकर्ता-अनुकूल इंटरफ़ेस उपयोगकर्ताओं से एट्रिब्यूट-स्तरीय लक्ष्य इनपुट लेता है, जिन्हें एक समर्पित टेबल में संग्रहीत किया जाता है। मास्टर टेबल को ऐसे एप्लिकेशन से जोड़कर जो डेटा वेयरहाउस टेबल में उपलब्ध डेटा से सीधे इनपुट स्वीकार करता है, हम इस दृष्टिकोण की समाधान-निर्माण की बुनियादी क्षमता का प्रदर्शन करते हैं।
इसके बाद लक्ष्यों की टेबल को परफॉर्मेंस मास्टर टेबल के साथ संयोजित किया जाता है, जिससे प्रदर्शन संकेतकों का उनके संबंधित लक्ष्यों के साथ एक समग्र व्यू बनता है। यह एकीकरण हमें यह व्यापक समझ देता है कि उद्देश्यों को किस हद तक हासिल किया जा रहा है।
इसी डेटा के आधार पर रिपोर्ट बनाना समाधान को पूर्ण करता है और निर्णय लेने के लिए शक्तिशाली अंतर्दृष्टियाँ प्रदान करता है।
निष्कर्ष
हमारे द्वारा रेखांकित दृष्टिकोण ने सारा डेटा एक साथ ला दिया है, और उस बड़े प्रश्न का उत्तर देने का मार्ग प्रशस्त किया है: क्या हम कंपनी के सभी क्लाइंट्स के प्रदर्शन का आकलन एक केंद्रीकृत स्थान पर कर सकते हैं?
लेकिन ठहरिए, यह सब नहीं है! यह समाधान कोई क्षणिक प्रोजेक्ट नहीं; यह एक मजबूत, कालजयी समाधान है जो असीमित संभावनाएँ खोलने के लिए बना है। कल्पना कीजिए कि कई रिपोर्टें बनाई जा रही हों, जो सभी इस समाधान को अपनी मजबूत नींव के रूप में उपयोग कर रही हों।
अब आता है रोमांचक भाग—इस अनमोल ज्ञान को आगे बढ़ाकर ऐसे दक्ष व्यक्तियों की शक्ति तैयार करना जो इसकी क्षमता का उपयोग कर सकें। समाधान बनाना पर्याप्त नहीं है; इसे सच में स्केलेबल और टिकाऊ बनाने के लिए, हमें टीमों को सशक्त करना होगा और डेटा साक्षरता की विशेषज्ञता विकसित करनी होगी, ताकि यह सधे हुए इंजन की तरह बेदाग चलता रहे।
जैसे Six Sigma पद्धति व्यवसाय प्रक्रियाओं को बेहतर बनाने में मदद करती है, वैसे ही हम लगातार प्रक्रियाओं को उन्नत करते हैं, वर्कफ़्लोज़ को सुव्यवस्थित करते हैं और इस उत्कृष्ट दृष्टिकोण को बनाए रखने के उपाय अपनाते हैं।
मूल रूप में, हम केवल एक समाधान नहीं बना रहे हैं; हम एक ऐसा परिवर्तन जगा रहे हैं जो आने वाले वर्षों तक प्रगति और उत्कृष्टता को आगे बढ़ाएगा।
कई बार, सबसे सरल प्रश्न भी परिष्कृत डेटा इन्फ्रास्ट्रक्चर की माँग करते हैं। डेटा साइंस, अपने मूल में, आपके संगठन पर सार्थक प्रभाव डालने के लिए डेटा का उपयोग करना है। इस शक्तिशाली समाधान के साथ, आप अपने डेटा की वास्तविक क्षमता को खोल सकेंगे और रूपांतरकारी प्रभाव पैदा कर सकेंगे।
डेटा इंजीनियरिंग और एनालिटिक्स की दुनिया में गहराई से डूबने के लिए तैयार हैं? DataCamp के Streamlined Data Ingestion with pandas कोर्स में नामांकन करें और डेटा संग्रह, इनजेशन और ट्रांसफॉर्मेशन को अनुकूलित करने के व्यावहारिक कौशल पाएँ। वैकल्पिक रूप से, Data Engineer in Python करियर ट्रैक देखें ताकि आप वे इन-डिमांड स्किल्स हासिल कर सकें जिनकी व्यवसायों को तलाश है और जब आप तैयार हों, Data Engineer Certification लें।