Bài viết này là đóng góp quý giá từ cộng đồng của chúng tôi và đã được DataCamp biên tập để rõ ràng và chính xác hơn.
Bạn muốn chia sẻ chuyên môn của mình? Chúng tôi rất mong được lắng nghe! Hãy gửi bài viết hoặc ý tưởng của bạn qua Biểu mẫu Đóng góp Cộng đồng.
Ngày nay, nhiều tổ chức phụ thuộc vào dữ liệu để ra quyết định. Dữ liệu thường được ghi nhận và thu thập từ nhiều nguồn với đủ dạng thức khác nhau. Thông thường, dữ liệu này được lưu trữ và chuyển đổi trong những “ô chứa” riêng và được dùng để trả lời các câu hỏi cụ thể. Khi các tổ chức chuyển sang cách tiếp cận dựa trên dữ liệu, các nhóm dữ liệu sẽ gặp một câu hỏi tưởng chừng đơn giản: Chúng ta có thể đánh giá hiệu suất của tất cả khách hàng của công ty ở một nơi tập trung không? (hoặc chúng ta có thể xem tất cả điểm dữ liệu ở một nơi không?)
Trong hướng dẫn này, bạn sẽ học cách tận dụng các kỹ thuật mình có thể đã biết và xếp lớp chúng để xây dựng một giải pháp giúp trả lời câu hỏi này.
Những cân nhắc chính
Dưới đây là một số khái niệm cốt lõi mà chúng ta sẽ tìm hiểu trong phần còn lại của bài viết.
Data lake
Một kho lưu trữ tập trung, dung lượng lớn, có thể lưu dữ liệu có cấu trúc, bán cấu trúc và phi cấu trúc ở mọi quy mô. Đây là giải pháp linh hoạt và tiết kiệm chi phí để lưu trữ lượng lớn dữ liệu đa dạng từ nhiều nguồn.
Không giống các hệ thống lưu trữ dữ liệu truyền thống, data lake không yêu cầu mô hình dữ liệu từ trước hoặc áp đặt lược đồ nghiêm ngặt, cho phép lưu dữ liệu nguyên bản như vốn có. Dữ liệu thô, chưa xử lý này có thể được xử lý, phân tích và chuyển đổi khi cần, trở thành nguồn lực giá trị cho việc ra quyết định dựa trên dữ liệu và phân tích nâng cao.
Bạn có thể so sánh data lake và data warehouse trong một bài riêng.
Data warehouse
Data warehouse là một kho lưu trữ tập trung, quy mô lớn để lưu và quản lý dữ liệu có cấu trúc. Nó được thiết kế để hỗ trợ business intelligence, báo cáo và hoạt động phân tích dữ liệu. Data warehouse hợp nhất dữ liệu từ nhiều cơ sở dữ liệu, ứng dụng và hệ thống, chuyển đổi chúng thành định dạng thống nhất và nhất quán để truy vấn và phân tích hiệu quả.
Microservices
Microservices là cách tiếp cận kiến trúc và tổ chức cho phát triển phần mềm, trong đó phần mềm được tạo thành từ các dịch vụ nhỏ, độc lập giao tiếp qua các API được định nghĩa rõ. Những dịch vụ này do các đội nhóm nhỏ, tự chủ sở hữu. Kiến trúc microservices giúp ứng dụng dễ mở rộng và phát triển nhanh hơn, thúc đẩy đổi mới và rút ngắn thời gian đưa tính năng ra thị trường.
Xây dựng pipeline dữ liệu thích ứng
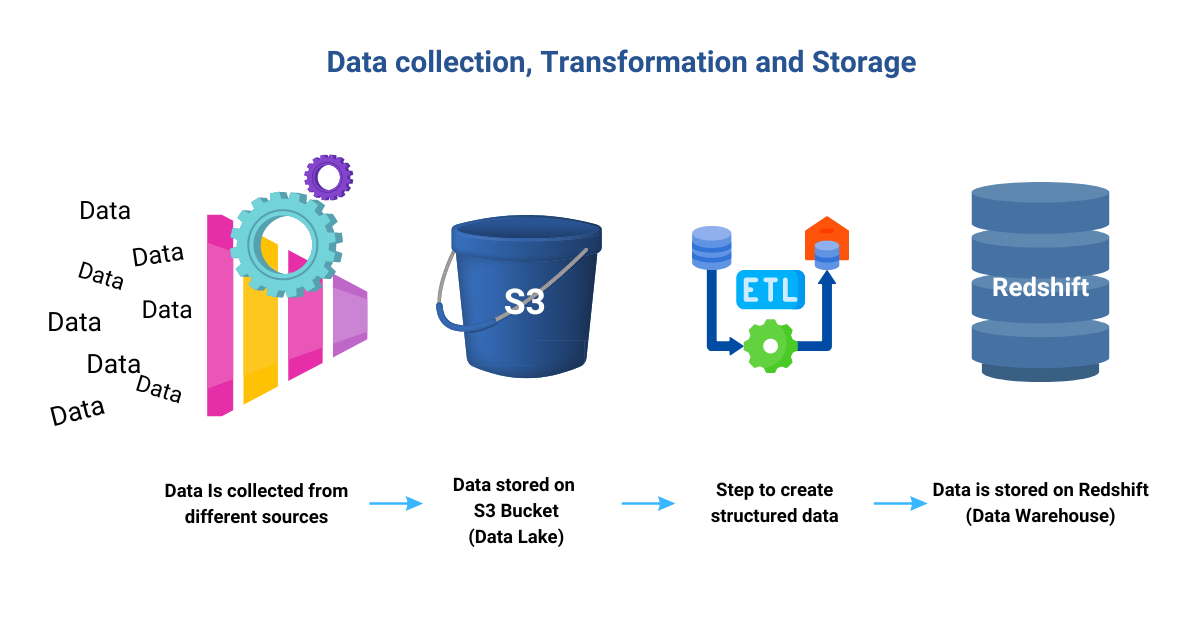
Cách tiếp cận này gồm các bước từ thu thập dữ liệu, lưu trữ, xử lý, xây dựng các view tạm (staging) và tạo phân tích ở quy mô lớn.
 Hình ảnh do Tác giả cung cấp
Bước 1: Thu thập dữ liệu và điều kiện tiên quyết
Ở giai đoạn đầu tiên này, điều quan trọng là giải quyết các điều kiện tiên quyết trước khi bắt tay vào công việc. Hãy xem xét kỹ nguồn gốc và nơi lưu trữ dữ liệu để hiểu toàn diện về nguồn của chúng.
Xây dựng các chiến lược hiệu quả để khiến dữ liệu thu thập được trở nên hữu ích và sẵn sàng cho phân tích. Làm sạch và xử lý dữ liệu (data wrangling) đóng vai trò then chốt để đảm bảo dữ liệu ở định dạng sạch, có thể sử dụng, chuẩn bị cho các bước xử lý tiếp theo. Bên cạnh đó, ưu tiên là tìm giải pháp tích hợp liền mạch các điểm dữ liệu từ nhiều khách hàng khác nhau đồng thời duy trì tính toàn vẹn và bảo mật dữ liệu.
Hướng dẫn của DataCamp, Data Analysis là gì, trình bày chi tiết hơn về quy trình này.
Bước 2: Data lake và data warehouse
Dữ liệu được thu thập từ nhiều khách hàng và hợp nhất vào các S3 Bucket (vị trí lưu trữ trong Amazon Simple Storage Service (Amazon S3)), hình thành một data lake để giữ thông tin đa dạng ở dạng thô. Bước tiếp theo là sử dụng quy trình Trích xuất, Chuyển đổi, Tải (ETL) để chuyển đổi dữ liệu đã thu thập thành tập dữ liệu có cấu trúc phù hợp đưa vào data warehouse. Kết quả là data warehouse trở thành kho lưu trữ nơi các lược đồ và dữ liệu có cấu trúc được tổ chức cẩn thận. Tuy nhiên, dữ liệu của từng khách hàng vẫn tách biệt, nằm trong các “ô chứa” riêng của họ trong data warehouse.
 Hình ảnh do Tác giả cung cấp
Bước 3: View staging (Trái tim của quy trình)
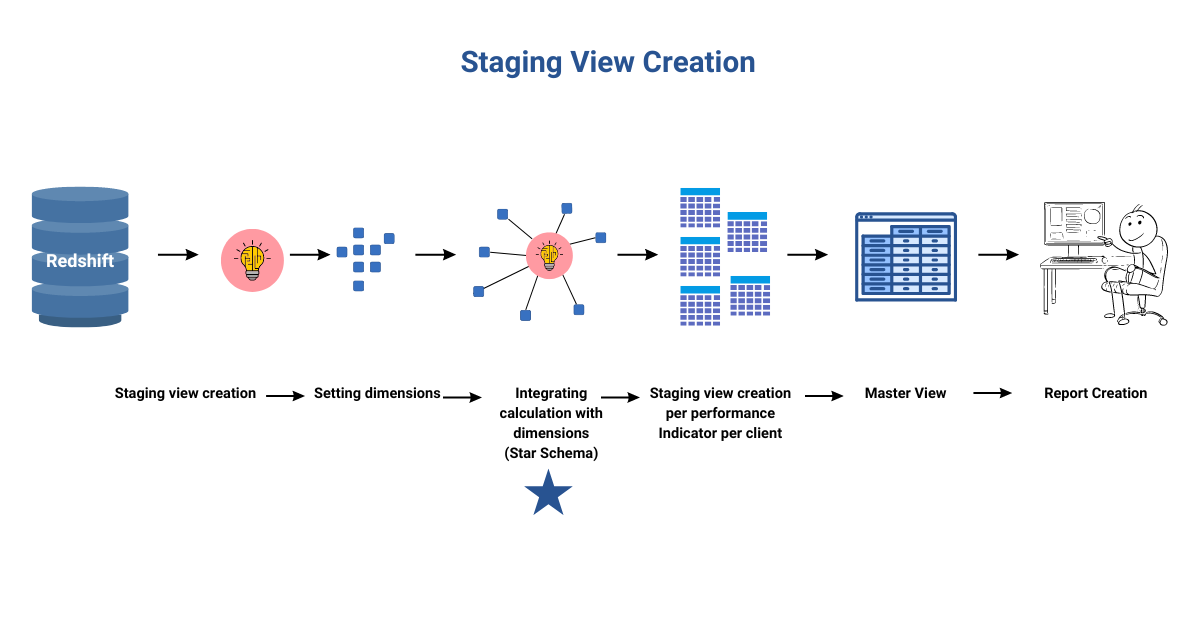
Các view staging được xây dựng bằng cách tận dụng mối quan hệ giữa lược đồ, bảng và cột trong data warehouse. Điều này tạo ra một view nghiệp vụ đơn giản hóa, che giấu sự phức tạp và đảm bảo cách hiểu nhất quán về các chiều (dimension) và sự kiện (fact) cho phân tích. Tất cả người dùng trong doanh nghiệp có thể truy cập dữ liệu chính xác được quản lý tập trung, từ đó có được những insight giá trị về hiệu suất trên nhiều chiều.
Cốt lõi của cách tiếp cận này là quy trình kỹ thuật tạo các view staging. Các view này chứa các phép tính và thuộc tính cần cho báo cáo và phân tích, giúp toàn bộ hệ sinh thái có thể mở rộng. Mọi logic mới hoặc thay đổi đều được triển khai trên các view staging này.
Để hỗ trợ khắc phục sự cố hiệu quả, các view staging được tạo theo từng khách hàng và từng chỉ số hiệu suất, cho phép xác định và xử lý vấn đề nhanh chóng. Cách này trái ngược với việc dùng một thủ tục lưu trữ khổng lồ duy nhất, vốn khiến việc xác định vấn đề tốn thời gian và khó khăn.
Thông qua các kỹ thuật phân đoạn và tổng hợp, các chỉ số hiệu suất cấp cao/tổng hợp được tạo ra bằng cách phân tích dữ liệu giao dịch và kết hợp khéo léo chúng. Mỗi view staging nhúng logic tính toán và các chiều để trả về giá trị đầu ra mong muốn. Quy trình này được lặp lại cho từng khách hàng, tạo ra một view staging riêng cho mỗi chỉ số hiệu suất trên mỗi khách hàng, đồng thời vẫn đảm bảo an toàn cho thông tin nhạy cảm.
Bước 4: Mô hình dữ liệu
Ở Bước 3, chúng ta đã hợp nhất toàn bộ dữ liệu vào một master view duy nhất. Master view này là nền tảng để tạo các view theo từng khách hàng bằng cách áp dụng bộ lọc dựa trên các thuộc tính liên quan đến khách hàng cụ thể. Việc có đầy đủ thuộc tính chiều của khách hàng ở một nơi giúp đơn giản hóa quy trình tạo view.
Hơn nữa, master view có thể lưu dữ liệu nhiều năm, nhưng cũng có thể giới hạn dễ dàng chỉ còn vài tháng dữ liệu phù hợp với yêu cầu cụ thể của từng khách hàng. Tính linh hoạt này giúp chúng ta cung cấp chính xác dữ liệu mà khách hàng cần, nâng cao mức độ phù hợp và hiệu quả của phân tích.
Mô hình star schema (một mô hình dữ liệu đa chiều dùng để tổ chức dữ liệu) được sử dụng làm mô hình dữ liệu. Mô hình này phân tách dữ liệu thành hai thành phần chính: bảng fact và các bảng dimension.
Dữ liệu số trong bảng fact liên kết mượt mà với các bảng dimension thông qua khóa chính, tạo ra mối quan hệ dễ hiểu. Thiết lập này giúp người dùng thực hiện truy vấn nhanh chóng và đơn giản bằng cách lọc và tổng hợp dữ liệu theo nhiều chiều khác nhau. Phân tích dữ liệu trở nên nhẹ nhàng khi người dùng có thể khám phá các điểm dữ liệu cụ thể mà không phải xử lý các phép nối phức tạp qua nhiều bảng.
Cấu trúc phi chuẩn hóa “tuyệt vời” của star schema đảm bảo các bảng dimension độc lập, dẫn đến hiệu năng truy vấn cực nhanh. Bộ máy cơ sở dữ liệu có thể truy xuất dữ liệu dễ dàng mà không cần xử lý nhiều, mang lại thời gian phản hồi cải thiện ngay cả với các truy vấn phân tích phức tạp.
Tóm lại, Star Schema là đồng minh mạnh mẽ, giúp phân tích dữ liệu trở nên đơn giản và hiệu quả. Tổ chức dữ liệu thành bảng Fact và Dimension tăng tốc truy vấn, tối ưu khám phá và mở ra kho insight phục vụ quyết định sáng suốt.
Hình ảnh do Tác giả cung cấp
Hiệu quả và linh hoạt
Điểm sáng của cách tiếp cận này nằm ở hiệu quả vượt trội và tính linh hoạt khó sánh. Đây là lúc khái niệm microservices được tận dụng.
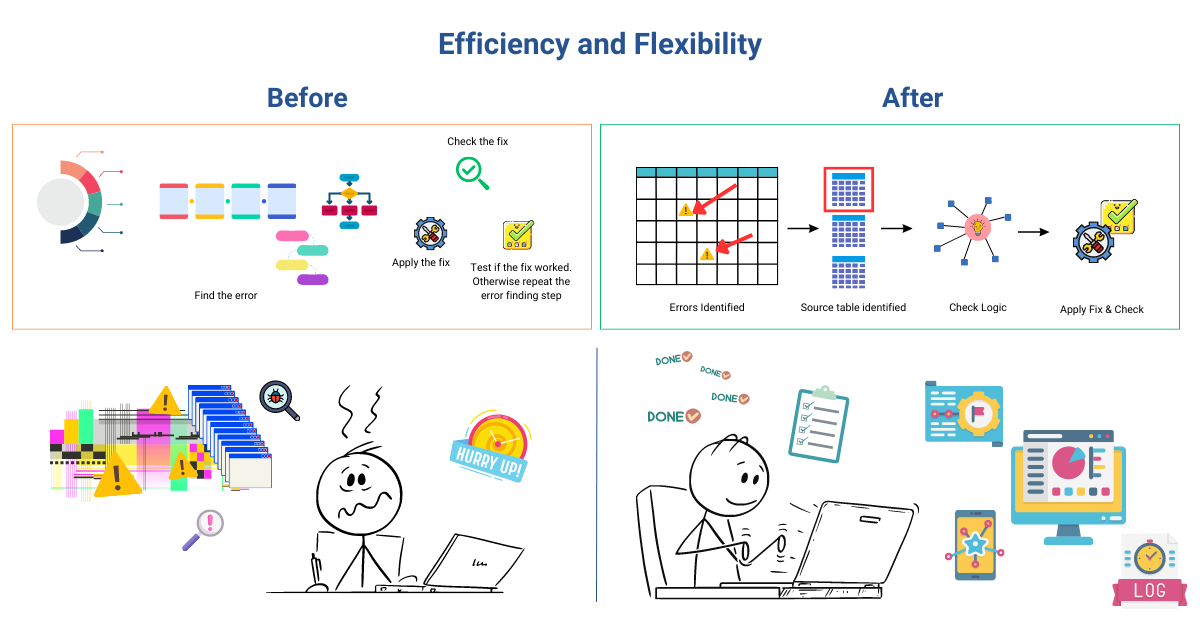
Khi cần thay đổi, dù là tính toán lại hay xử lý vấn đề dữ liệu, chúng ta chỉ cần cập nhật logic của chỉ số hiệu suất trong script staging. Ngoài ra, quy trình này cũng biến việc khắc phục sự cố và chỉnh sửa trở thành những tác vụ trơn tru, cực nhanh, giảm mạnh thời gian gián đoạn tiềm ẩn.
Để hình dung rõ sức mạnh của cách tiếp cận này, hãy tưởng tượng một tình huống khi chỉ số hiệu suất của một khách hàng cụ thể cho thấy điểm dữ liệu không khớp. Với phương pháp xử lý sự cố truyền thống, chúng ta phải trải qua quy trình dài để truy tìm nguyên nhân gốc rễ, gồm nhiều bước như tính toán lại, chạy code và kiểm định dữ liệu.
Với cách tiếp cận hiện tại, chúng ta đạt được mức hiệu quả vượt trội và tinh gọn hóa quy trình xử lý sự cố.
Giờ đây, chúng ta có thể nhanh chóng xác định chính xác chỉ số hiệu suất gây ra sai lệch, kiểm tra kỹ logic của nó và lập tức xác minh bảng liên quan cho các phép tính. Nhờ đó, việc xác định nguồn gốc lỗi trở nên dễ dàng và áp dụng bản vá cần thiết diễn ra với tốc độ cao. Cảm ơn cách tiếp cận này, thời gian xử lý sự cố được rút ngắn đáng kể, vì chúng ta tập trung vào giải quyết vấn đề kịp thời thay vì sa lầy vào các bước dài dòng, tẻ nhạt.
Ứng dụng và báo cáo
Để đánh giá mức độ hiệu suất — tốt, kém hay cần cải thiện — chúng ta dựa vào mục tiêu. Để làm được điều này, có thể phát triển một giao diện ứng dụng và liên kết với bảng master. Giao diện thân thiện này ghi nhận các mục tiêu ở cấp thuộc tính từ người dùng và lưu vào một bảng riêng. Bằng cách tích hợp bảng master với một ứng dụng nhận đầu vào trực tiếp từ dữ liệu có trong bảng của data warehouse, chúng ta cho thấy tiềm năng nền tảng của cách tiếp cận này để xây dựng giải pháp.
Sau đó, bảng mục tiêu được kết hợp với bảng Performance Master, tạo nên cái nhìn tổng thể về các chỉ số hiệu suất cùng với mục tiêu tương ứng. Sự tích hợp này giúp chúng ta hiểu toàn diện mức độ hoàn thành mục tiêu.
Xây dựng báo cáo dựa trên dữ liệu này sẽ hoàn thiện giải pháp, mang đến insight mạnh mẽ để định hướng quyết định.
Kết luận
Cách tiếp cận mà chúng tôi trình bày đã tập hợp toàn bộ dữ liệu lại với nhau, mở đường để trả lời câu hỏi lớn: Chúng ta có thể đánh giá hiệu suất của tất cả khách hàng của công ty ở một nơi tập trung không?
Nhưng chưa dừng ở đó! Giải pháp này không phải dự án nhất thời; nó là một giải pháp vững chắc, bền bỉ, mở ra vô vàn khả năng. Hãy hình dung xây dựng nhiều báo cáo, tất cả đều tận dụng giải pháp này như nền tảng vững chắc.
Giờ đến phần thú vị — truyền lại kiến thức quý báu này để xây dựng một lực lượng những người có kỹ năng khai thác tiềm năng của nó. Xây dựng giải pháp thôi là chưa đủ; để thực sự mở rộng và bền vững, chúng ta phải trao quyền cho các đội nhóm và xây dựng năng lực văn hóa dữ liệu để cỗ máy vận hành trơn tru.
Tương tự phương pháp Six Sigma, vốn giúp cải thiện quy trình kinh doanh, chúng ta liên tục nâng cấp quy trình, tối ưu luồng công việc và áp dụng các biện pháp để duy trì cách tiếp cận xuất sắc này.
Tựu trung, chúng ta không chỉ xây dựng một giải pháp; chúng ta đang thắp lên một cuộc chuyển đổi sẽ thúc đẩy tiến bộ và xuất sắc trong nhiều năm tới.
Trong nhiều trường hợp, những câu hỏi đơn giản nhất lại đòi hỏi hạ tầng dữ liệu tinh vi. Cốt lõi của khoa học dữ liệu là khai thác dữ liệu để tạo tác động đáng kể cho tổ chức của bạn. Với giải pháp mạnh mẽ này trong tay, bạn sẽ mở khóa trọn vẹn tiềm năng dữ liệu và tạo ra tác động chuyển đổi.
Sẵn sàng đào sâu hơn vào thế giới kỹ thuật dữ liệu và phân tích? Hãy đăng ký khóa Streamlined Data Ingestion with pandas của DataCamp để rèn kỹ năng thực hành tối ưu thu thập, nạp và chuyển đổi dữ liệu. Hoặc, xem lộ trình nghề nghiệp Data Engineer bằng Python để trang bị các kỹ năng được doanh nghiệp săn đón và khi sẵn sàng, hãy thi Chứng chỉ Data Engineer.
