Questo articolo è un prezioso contributo della nostra community ed è stato revisionato da DataCamp per chiarezza e accuratezza.
Ti piacerebbe condividere la tua esperienza? Ci farebbe piacere sentirti! Invia i tuoi articoli o le tue idee tramite il nostro modulo per i contributi della community.
Oggi molte organizzazioni si affidano ai dati per prendere decisioni. I dati vengono spesso registrati e raccolti da fonti diverse, in vari formati. Molto spesso, questi dati vengono archiviati e trasformati nel loro silo e utilizzati per rispondere a domande specifiche partendo da quei dati. Man mano che le organizzazioni si spostano verso un approccio data-driven, i team dati si imbattono in una domanda apparentemente semplice: possiamo valutare le performance di tutti i clienti dell'azienda in un unico luogo centralizzato? (o possiamo vedere tutti i punti dati in un unico posto?)
In questo tutorial imparerai come sfruttare tecniche che potresti già conoscere e combinarle per costruire una soluzione che aiuti a rispondere a questa domanda.
Considerazioni chiave
Qui abbiamo delineato alcuni dei concetti principali che esploreremo nel resto dell'articolo.
Data lake
Un ampio repository centralizzato che memorizza dati strutturati, semi-strutturati e non strutturati a qualsiasi scala. Offre una soluzione flessibile ed economica per archiviare grandi volumi di tipologie di dati diversi provenienti da varie fonti.
A differenza dei sistemi di archiviazione tradizionali, un data lake non richiede modellazione dei dati preventiva o un rigido rispetto dello schema, consentendo di archiviare i dati così come sono. Questi dati grezzi e non elaborati possono essere processati, analizzati e trasformati secondo necessità, rendendoli una risorsa preziosa per decisioni data-driven e analytics avanzati.
Puoi confrontare un data lake e un data warehouse in un articolo a parte.
Data warehouse
Un data warehouse è un grande repository centralizzato che memorizza e gestisce dati strutturati. È progettato per supportare business intelligence, reportistica e attività di analisi dei dati. I data warehouse consolidano dati da più database, applicazioni e sistemi, trasformandoli in un formato unificato e coerente per interrogazioni e analisi efficienti.
Microservizi
I microservizi sono un approccio architetturale e organizzativo allo sviluppo software in cui il software è composto da piccoli servizi indipendenti che comunicano tramite API ben definite. Questi servizi sono di proprietà di team piccoli e autonomi. Le architetture a microservizi rendono le applicazioni più facili da scalare e più rapide da sviluppare, abilitando l'innovazione e accelerando il time-to-market per le nuove funzionalità.
Costruire una pipeline di dati adattiva
Questo approccio comprende passaggi che vanno dalla raccolta, archiviazione e processamento dei dati, alla creazione di viste di staging e alla generazione di analytics su larga scala.
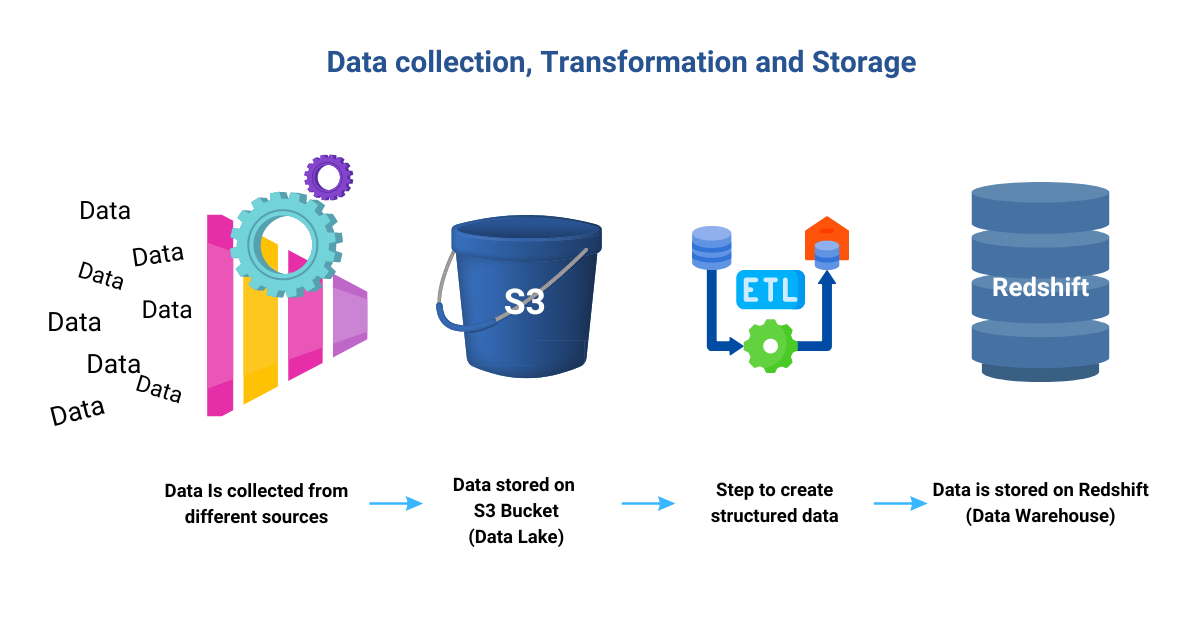 Immagine dell'autore
Passo 1: Raccolta dati e prerequisiti
In questa fase iniziale è fondamentale affrontare importanti prerequisiti prima di entrare nel vivo dell'attività. Esamina a fondo l'origine e l'archiviazione dei dati per ottenere una comprensione completa delle loro fonti.
Elabora strategie efficaci per rendere i dati raccolti utili e pronti per l'analisi. Il data wrangling svolge un ruolo cruciale per assicurare che i dati siano in un formato pulito e utilizzabile, preparandoli all'elaborazione successiva. Inoltre, la priorità è trovare una soluzione che integri senza soluzione di continuità i punti dati di clienti diversi, salvaguardando al contempo l'integrità e la sicurezza dei dati.
La guida di DataCamp, Cos'è l'analisi dei dati, approfondisce questo processo.
Passo 2: Data lake e data warehouse
I dati vengono raccolti da vari clienti e consolidati in bucket S3 (una posizione di archiviazione in Amazon Simple Storage Service, Amazon S3), formando un data lake per contenere le informazioni eterogenee in forma grezza. Il passo successivo prevede l'uso di processi di Extract, Transform, Load (ETL) per convertire i dati raccolti in un dataset strutturato che si inserisca perfettamente nel data warehouse. Di conseguenza, il data warehouse diventa un repository in cui schemi e dati strutturati sono organizzati meticolosamente. Tuttavia, i dati di ciascun cliente restano separati, all'interno dei rispettivi silo all'interno del data warehouse.
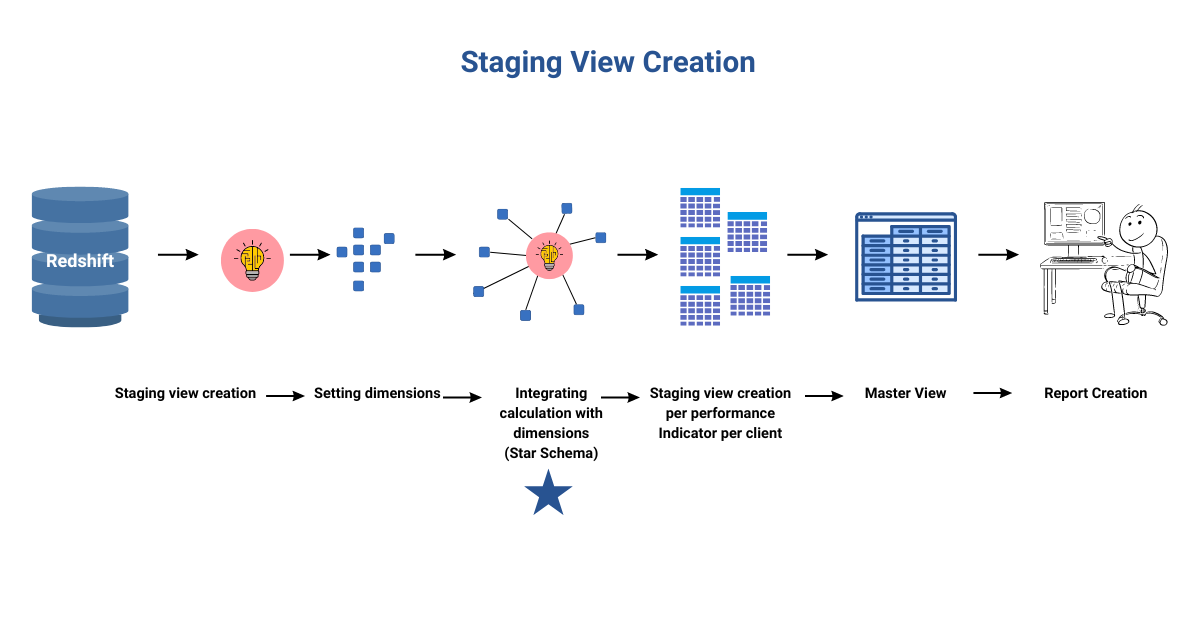 Immagine dell'autore
Passo 3: Vista di staging (Il cuore dell'operazione)
Le viste di staging sono costruite sfruttando le relazioni tra schema, tabelle e colonne in un data warehouse. Il risultato è una vista di business semplificata che nasconde la complessità e garantisce una comprensione coerente di dimensioni e fatti per l'analisi. Tutti gli utenti aziendali possono accedere a dati accurati gestiti centralmente, ottenendo insight preziosi sulle performance lungo varie dimensioni.
Al centro di questo approccio c'è il processo tecnico di creazione delle viste di staging. Queste viste contengono i calcoli e gli attributi necessari per reporting e analytics, rendendo l'intero ecosistema scalabile. Qualsiasi nuova logica o modifica viene implementata su queste viste di staging.
Per facilitare un troubleshooting efficace, le viste di staging vengono create per cliente e per indicatore di performance, consentendo di individuare e risolvere i problemi con efficienza. Questo approccio si contrappone all'uso di un'unica, enorme stored procedure, che può rendere l'identificazione dei problemi lunga e complessa.
Attraverso tecniche di segmentazione e aggregazione, gli indicatori di performance di alto livello/aggregati vengono generati analizzando i dati transazionali e combinandoli con perizia. Ogni vista di staging incorpora la logica di calcolo e le dimensioni per fornire il valore di output desiderato. Questo processo si ripete per ciascun cliente, producendo una vista di staging distinta per ogni indicatore di performance per cliente, mantenendo al contempo la sicurezza delle informazioni sensibili.
Passo 4: Data modeling
Nel Passo 3 del nostro processo abbiamo consolidato tutti i dati in un'unica vista master. Questa vista master funge da base per creare viste specifiche per cliente applicando filtri basati su attributi legati a quello specifico cliente. Avere tutti gli attributi dimensionali dei clienti in un unico posto semplifica la creazione delle viste.
Inoltre, la vista master può memorizzare dati di più anni, ma può essere facilmente limitata a includere solo alcuni mesi di dati, su misura per soddisfare le esigenze specifiche di ciascun cliente. Questa flessibilità ci consente di fornire ai clienti esattamente i dati di cui hanno bisogno, aumentando la pertinenza e l'efficienza delle nostre analisi.
Il modello a stella (un modello di dati multidimensionale utilizzato per organizzare i dati) è il modello dati impiegato. Questo modello scompone efficacemente i dati in due componenti chiave: la tabella dei fatti e le tabelle delle dimensioni.
I dati numerici della tabella dei fatti si collegano senza soluzione di continuità alle tabelle delle dimensioni tramite chiavi primarie, stabilendo relazioni di facile comprensione. Questa configurazione consente agli utenti di eseguire interrogazioni rapide e semplici filtrando e aggregando i dati in base a varie dimensioni. L'analisi dei dati diventa agevole, poiché gli utenti possono esplorare punti dati specifici senza dover gestire join complessi tra più tabelle.
La brillante struttura denormalizzata dello schema a stella garantisce l'indipendenza delle tabelle delle dimensioni, con prestazioni di query fulminee. Il motore del database può recuperare i dati senza un'elaborazione estesa, offrendo tempi di risposta migliori anche per le query analitiche più complesse.
In poche parole, lo schema a stella è un alleato potente che rende l'analisi dei dati semplice ed efficiente. Organizzare i dati in tabelle dei fatti e delle dimensioni accelera le interrogazioni, semplifica l'esplorazione e apre un mondo di insight per decisioni informate.
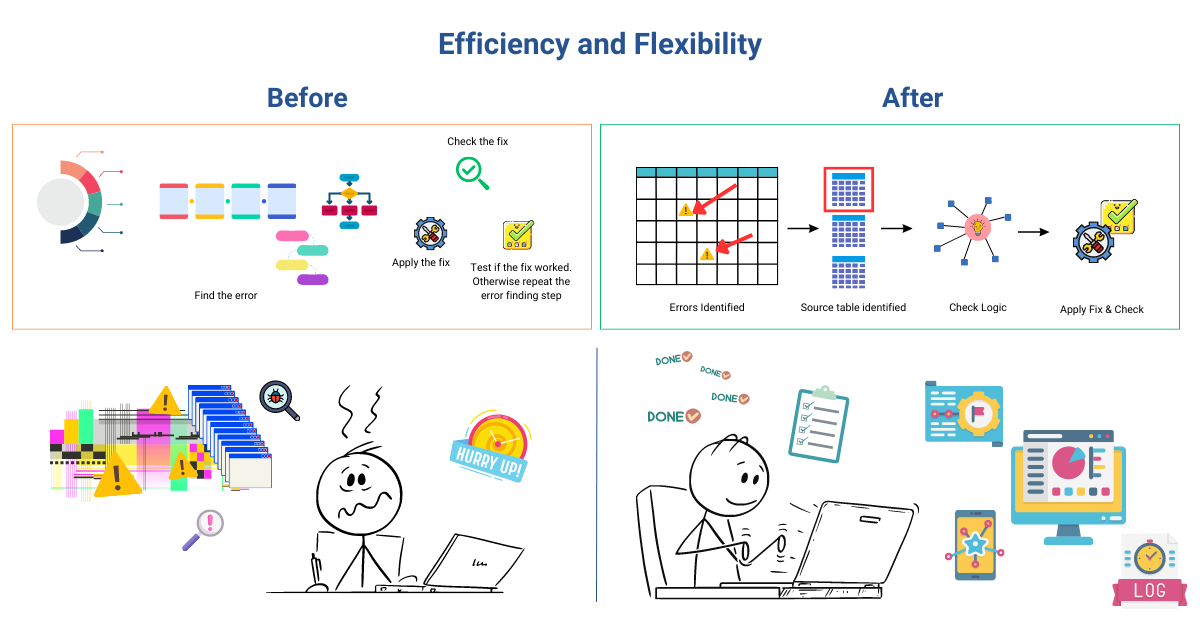
Immagine dell'autore
Efficienza e flessibilità
La vera forza di questo approccio risiede nella sua notevole efficienza e nell'ineguagliabile flessibilità. Qui entra in gioco il concetto di microservizi.
Quando sono necessarie modifiche, che si tratti di ricalcoli o di affrontare problemi sui dati, aggiorniamo semplicemente la logica dell'indicatore di performance all'interno dello script di staging. Inoltre, questo processo trasforma il troubleshooting e le modifiche in attività fluide e rapidissime, riducendo drasticamente eventuali tempi di inattività.
Per comprendere davvero la potenza di questo approccio, immagina uno scenario in cui l'indicatore di performance di un cliente specifico mostri un punto dati non corrispondente. Nel metodo di troubleshooting tradizionale, dovremmo intraprendere un lungo processo per risalire alla causa principale, passando per più passaggi come ricalcoli, esecuzione del codice e validazione dei dati.
Con l'approccio attuale, si ottiene un livello di efficienza senza pari e si snellisce il processo di troubleshooting.
Ora possiamo individuare rapidamente l'esatto indicatore di performance responsabile di qualsiasi discrepanza, esaminarne a fondo la logica e validare prontamente la tabella associata ai calcoli. Di conseguenza, identificare l'origine degli errori diventa semplice e applicare le correzioni necessarie avviene con velocità eccezionale. Grazie a questo approccio, i tempi di troubleshooting si riducono drasticamente, perché ci concentriamo di più sulla risoluzione tempestiva dei problemi anziché restare impantanati in passaggi lunghi e tediosi.
Applicazione e reportistica
Per valutare i livelli di performance — che siano buoni, scarsi o da migliorare — ci basiamo su obiettivi. Per farlo, si può sviluppare un'interfaccia applicativa collegata alla tabella master. Questa interfaccia intuitiva raccoglie dagli utenti gli input degli obiettivi a livello di attributo, che vengono memorizzati in una tabella dedicata. Integrando la tabella master con un'applicazione che accetta input direttamente dai dati disponibili nella tabella del data warehouse, dimostriamo il potenziale di base di questo approccio per costruire soluzioni.
La tabella degli obiettivi viene quindi combinata con la tabella Performance Master, creando una visione olistica degli indicatori di performance insieme ai rispettivi obiettivi. Questa integrazione ci consente di comprendere in modo completo quanto bene vengano raggiunti gli obiettivi.
Creare report basati su questi dati completa la soluzione, fornendo insight potenti per guidare le decisioni.
Conclusione
L'approccio che abbiamo descritto ha riunito tutti i dati, spianando la strada per rispondere alla grande domanda: possiamo valutare le performance di tutti i clienti dell'azienda in un unico luogo centralizzato?
Ma non finisce qui! Questa soluzione non è un progetto effimero; è una soluzione robusta e duratura, pensata per aprire possibilità infinite. Immagina di costruire più report, tutti basati su questa soluzione come solida fondamenta.
Ora arriva la parte entusiasmante: trasferire questa conoscenza preziosa per creare una squadra di persone competenti in grado di sfruttarne il potenziale. Costruire una soluzione non basta; per renderla davvero scalabile e sostenibile, dobbiamo dare potere ai team e sviluppare la data literacy necessaria per mantenere questo motore ben oliato che gira alla perfezione.
Proprio come la metodologia Six Sigma, che aiuta a migliorare i processi aziendali, miglioriamo continuamente i processi, snelliamo i flussi di lavoro e adottiamo misure per mantenere questo approccio eccezionale.
In sostanza, non stiamo solo costruendo una soluzione; stiamo innescando una trasformazione che guiderà progresso ed eccellenza per gli anni a venire.
In molti casi, le domande più semplici richiedono un'infrastruttura dati sofisticata. La data science, alla base, consiste nello sfruttare i dati per avere un impatto significativo sulla tua organizzazione. Con questa potente soluzione a disposizione, potrai sbloccare il vero potenziale dei tuoi dati e generare un impatto trasformativo.
Pronto ad approfondire il mondo del data engineering e dell'analytics? Iscriviti al corso di DataCamp Streamlined Data Ingestion with pandas per acquisire competenze pratiche nell'ottimizzazione della raccolta, ingestione e trasformazione dei dati. In alternativa, dai un'occhiata al percorso di carriera Data Engineer in Python per ottenere le competenze richieste dalle aziende e, quando ti senti pronto, sostieni la certificazione Data Engineer.



