
Last chance! 50% off DataCamp Premium
Sale ends in
Artikel ini merupakan kontribusi berharga dari komunitas kami dan telah disunting oleh DataCamp untuk kejelasan dan ketepatan.
Tertarik berbagi keahlian Anda? Kami ingin mendengarnya! Silakan kirimkan artikel atau ide Anda melalui Formulir Kontribusi Komunitas kami.
Banyak organisasi saat ini bergantung pada data untuk mengambil keputusan. Data sering kali dicatat dan dikumpulkan dari berbagai sumber dalam beragam bentuk. Seringnya, data ini disimpan dan ditransformasikan dalam sillonya sendiri dan dimanfaatkan untuk menjawab pertanyaan spesifik dari data tersebut. Saat organisasi bergerak menuju pendekatan berbasis data, tim data akan menemui pertanyaan yang tampak sederhana: Bisakah kita menilai kinerja semua klien perusahaan di satu tempat terpusat? (atau bisakah kita melihat semua titik data di satu tempat?)
Dalam tutorial ini, Anda akan mempelajari cara memanfaatkan teknik yang mungkin sudah Anda kuasai dan menyusunnya untuk membangun solusi yang membantu menjawab pertanyaan ini.
Di sini, kami menguraikan beberapa konsep kunci yang akan kita bahas di sisa artikel ini.
Repositori besar dan terpusat yang menyimpan data terstruktur, semi-terstruktur, dan tidak terstruktur dalam skala apa pun. Ini menawarkan solusi yang fleksibel dan hemat biaya untuk menyimpan volume besar berbagai tipe data dari berbagai sumber.
Tidak seperti sistem penyimpanan data tradisional, data lake tidak memerlukan pemodelan data di awal atau penegakan skema yang ketat, sehingga data dapat disimpan apa adanya. Data mentah dan belum diproses ini dapat diproses, dianalisis, dan ditransformasikan sesuai kebutuhan, menjadikannya sumber daya berharga untuk pengambilan keputusan berbasis data dan analitik lanjutan.
Anda dapat membandingkan data lake vs. data warehouse dalam artikel terpisah.
Data warehouse adalah repositori besar dan terpusat yang menyimpan dan mengelola data terstruktur. Ini dirancang untuk mendukung business intelligence, pelaporan, dan aktivitas analisis data. Data warehouse mengonsolidasikan data dari banyak basis data, aplikasi, dan sistem, lalu mentransformasikannya ke dalam format yang terpadu dan konsisten untuk kueri dan analisis yang efisien.
Microservices adalah pendekatan arsitektural dan organisasional dalam pengembangan perangkat lunak di mana perangkat lunak tersusun dari layanan-layanan kecil yang independen dan berkomunikasi melalui API yang terdefinisi dengan baik. Layanan-layanan ini dimiliki oleh tim kecil yang berdikari. Arsitektur microservices membuat aplikasi lebih mudah diskalakan dan lebih cepat dikembangkan, sehingga mendorong inovasi dan mempercepat waktu peluncuran fitur baru ke pasar.
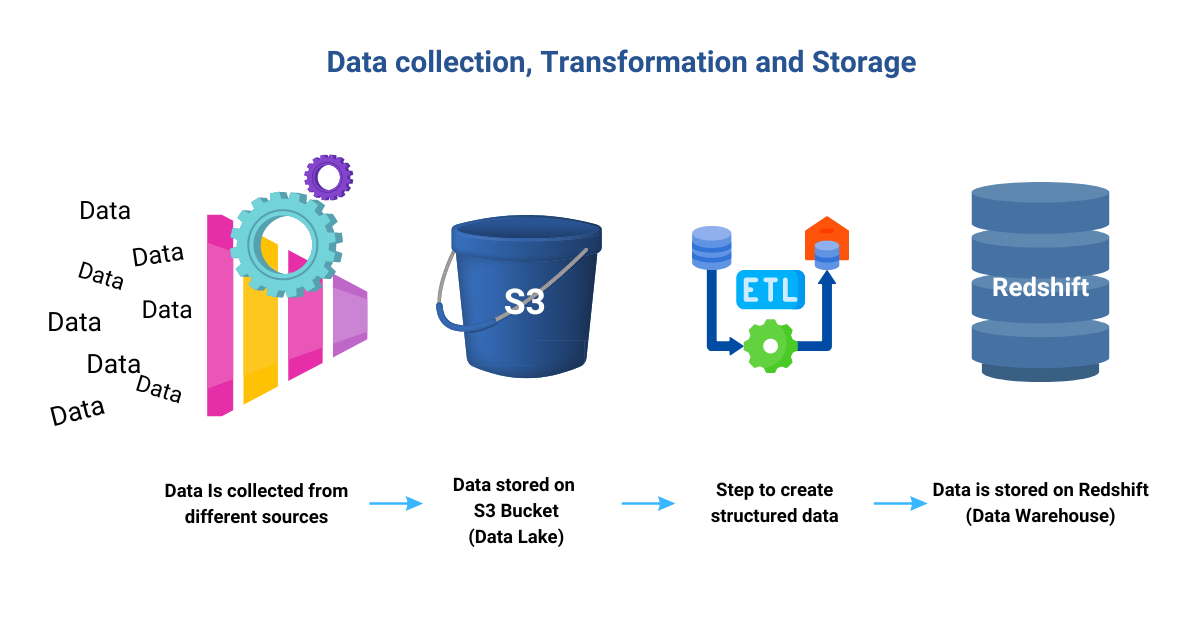
Pendekatan ini terdiri dari langkah-langkah mulai dari pengumpulan, penyimpanan, pemrosesan data, membangun staging view, hingga menghasilkan analitik dalam skala besar.
 Gambar oleh Penulis
Pada fase awal ini, penting untuk menangani prasyarat sebelum masuk ke tugas inti. Tinjau secara menyeluruh asal-usul dan penyimpanan data untuk memahami sumbernya secara komprehensif.
Rancang strategi efektif agar data yang terkumpul bermanfaat dan siap dianalisis. Data wrangling berperan penting untuk memastikan data berada dalam format yang bersih dan dapat digunakan, sehingga siap untuk pemrosesan lebih lanjut. Selain itu, prioritasnya adalah menemukan solusi yang dapat mengintegrasikan titik data dari berbagai klien secara mulus sambil menjaga integritas dan keamanan data.
Panduan DataCamp, What is Data Analysis, membahas proses ini lebih detail.
Data dikumpulkan dari berbagai klien dan dikonsolidasikan dalam S3 Bucket (lokasi penyimpanan di Amazon Simple Storage Service (Amazon S3)), membentuk data lake untuk menampung beragam informasi dalam bentuk mentah. Langkah berikutnya melibatkan penggunaan proses Extract, Transform, Load (ETL) untuk mengonversi data yang terkumpul menjadi set data terstruktur yang cocok dengan mulus ke dalam data warehouse. Hasilnya, data warehouse menjadi repositori tempat skema dan data terstruktur diatur secara saksama. Namun, data setiap klien tetap terpisah, berada di dalam silo masing-masing di dalam data warehouse.
 Gambar oleh Penulis
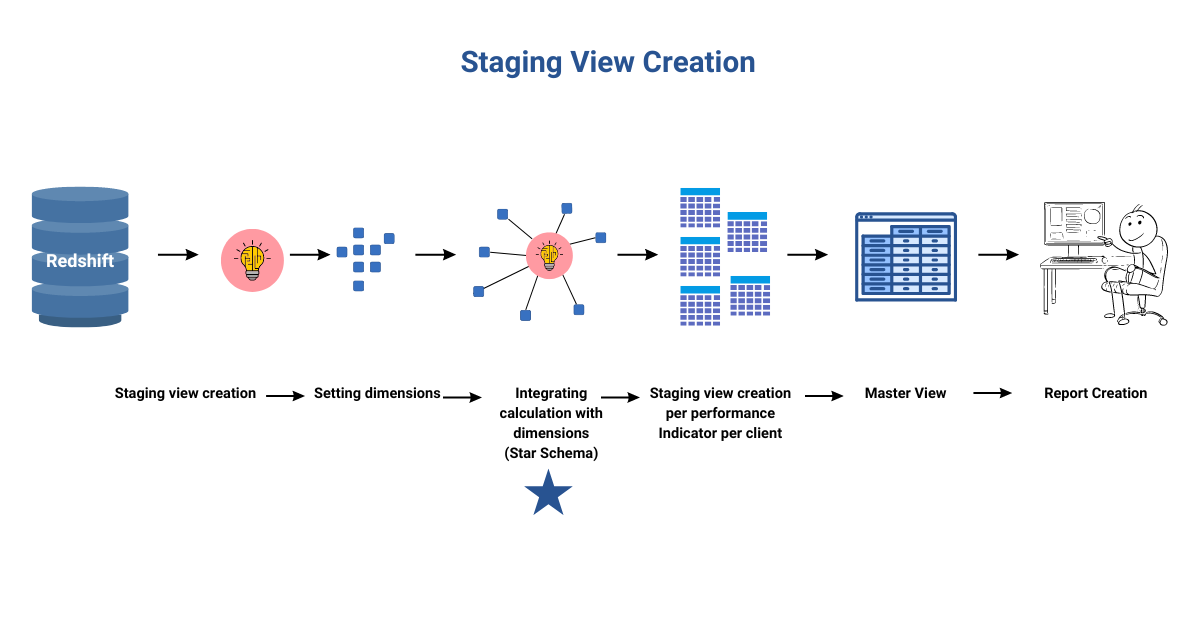
Staging view dibangun dengan memanfaatkan hubungan antara skema, tabel, dan kolom di dalam data warehouse. Ini menghasilkan tampilan bisnis yang disederhanakan, menyembunyikan kompleksitas dan memastikan pemahaman yang konsisten tentang dimensi dan fakta untuk analisis. Semua pengguna perusahaan dapat mengakses data akurat yang dikelola secara terpusat, sehingga memungkinkan wawasan berharga tentang kinerja di berbagai dimensi.
Inti dari pendekatan ini adalah proses teknis pembuatan staging view. Tampilan ini memuat perhitungan dan atribut yang diperlukan untuk pelaporan dan analitik, menjadikan seluruh ekosistem skalabel. Setiap logika baru atau perubahan diterapkan pada staging view ini.
Untuk mempermudah penelusuran masalah, staging view dibuat per klien dan per indikator kinerja, sehingga memungkinkan identifikasi dan penanganan masalah secara efisien. Pendekatan ini berbeda dengan penggunaan satu prosedur tersimpan raksasa, yang dapat membuat identifikasi masalah memakan waktu dan menantang.
Melalui teknik segmentasi dan agregasi, indikator kinerja tingkat tinggi/teragregasi dihasilkan dengan menganalisis data transaksional dan mengombinasikannya secara cermat. Setiap staging view menanamkan logika perhitungan dan dimensi untuk menghasilkan nilai keluaran yang diinginkan. Proses ini diulang untuk setiap klien, menghasilkan staging view terpisah untuk setiap indikator kinerja per klien sekaligus menjaga keamanan informasi sensitif.
Pada Langkah 3, kami telah mengonsolidasikan seluruh data ke dalam satu master view. Master view ini menjadi landasan untuk membuat tampilan khusus klien dengan menerapkan filter berdasarkan atribut terkait klien tertentu. Memiliki semua atribut dimensi klien di satu tempat menyederhanakan proses pembuatan tampilan.
Lebih lanjut, master view dapat menyimpan data untuk beberapa tahun, namun dapat dengan mudah dibatasi hanya mencakup beberapa bulan data yang disesuaikan dengan kebutuhan spesifik masing-masing klien. Fleksibilitas ini memungkinkan kami menyediakan data yang tepat bagi klien, sehingga meningkatkan relevansi dan efisiensi analitik kami.
Model star schema (model data multi-dimensi yang digunakan untuk mengatur data) digunakan sebagai model data. Model ini secara efektif memecah data menjadi dua komponen kunci: tabel fakta dan tabel dimensi.
Data numerik pada tabel fakta terhubung mulus ke tabel dimensi melalui primary key, membentuk relasi yang mudah dipahami. Pengaturan ini membantu pengguna melakukan kueri dengan cepat dan sederhana dengan memfilter dan mengagregasi data berdasarkan berbagai dimensi. Analisis data menjadi mudah karena pengguna dapat menelusuri titik data spesifik tanpa harus berurusan dengan join kompleks di banyak tabel.
Struktur terdenormalisasi yang cemerlang pada star schema memastikan tabel dimensi bersifat independen, sehingga kinerja kueri menjadi sangat cepat. Mesin basis data dapat mengambil data dengan mudah tanpa pemrosesan ekstensif, memberikan waktu respons yang lebih baik bahkan untuk kueri analitis yang paling kompleks.
Singkatnya, Star Schema adalah sekutu yang tangguh, membuat analisis data menjadi sederhana dan efisien. Mengorganisasi data ke dalam Tabel Fakta dan Dimensi mempercepat kueri, menyederhanakan eksplorasi, dan membuka dunia wawasan untuk pengambilan keputusan yang berinformasi.
Gambar oleh Penulis
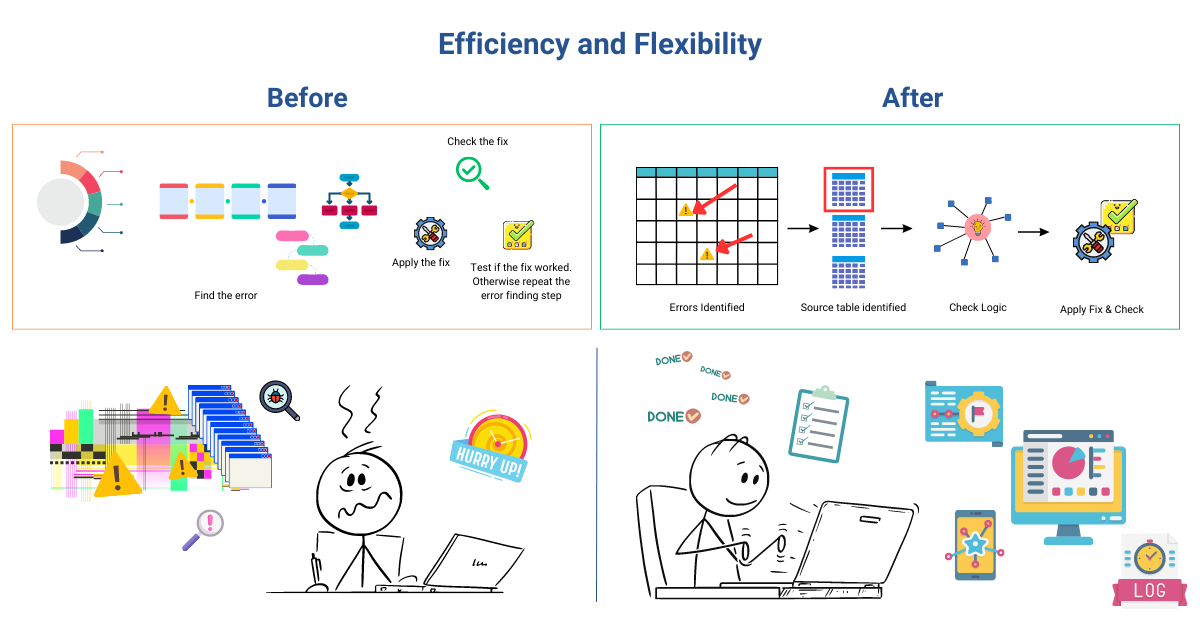
Keunggulan sejati dari pendekatan ini terletak pada efisiensinya yang luar biasa dan fleksibilitasnya yang tak tertandingi. Di sinilah konsep microservices dimanfaatkan.
Ketika perubahan diperlukan, baik itu perhitungan ulang atau penanganan masalah data, kami cukup memperbarui logika indikator kinerja di dalam skrip staging. Selain itu, proses ini juga mengubah penelusuran masalah dan modifikasi menjadi tugas yang mulus dan sangat cepat, sehingga secara drastis mengurangi potensi downtime.
Untuk benar-benar memahami kekuatan pendekatan ini, bayangkan skenario ketika indikator kinerja klien tertentu menunjukkan titik data yang tidak cocok. Dalam metode penelusuran tradisional, kita harus menjalani proses panjang mencari akar masalah, melibatkan banyak langkah seperti perhitungan ulang, menjalankan kode, dan validasi data.
Dengan pendekatan saat ini, efisiensi yang tak tertandingi tercapai dan proses penelusuran masalah menjadi lebih ramping.
Kini, kita dapat dengan cepat mengidentifikasi indikator kinerja spesifik yang bertanggung jawab atas ketidaksesuaian, meninjau logikanya secara menyeluruh, dan segera memvalidasi tabel terkait untuk perhitungan. Alhasil, mengidentifikasi asal kesalahan menjadi mudah, dan penerapan perbaikan yang diperlukan berlangsung sangat cepat. Berkat pendekatan ini, waktu penelusuran masalah berkurang drastis, karena kita lebih fokus menangani isu dengan segera daripada terjebak langkah-langkah panjang dan melelahkan.
Untuk menilai tingkat kinerja—apakah baik, buruk, atau perlu ditingkatkan—kita mengandalkan target. Untuk mencapainya, antarmuka aplikasi dapat dikembangkan dan ditautkan ke master table. Antarmuka yang ramah pengguna ini menangkap masukan target pada tingkat atribut dari pengguna, yang disimpan di tabel khusus. Dengan mengintegrasikan master table dengan aplikasi yang menerima masukan langsung dari data yang tersedia di tabel data warehouse, kami menunjukkan potensi dasar pendekatan ini untuk membangun solusi.
Tabel target kemudian digabungkan dengan Performance Master table, menciptakan tampilan holistik atas indikator kinerja beserta targetnya masing-masing. Integrasi ini memungkinkan kami memperoleh pemahaman menyeluruh tentang seberapa baik tujuan tercapai.
Membangun laporan berdasarkan data ini menyempurnakan solusi, memberikan wawasan kuat untuk memandu pengambilan keputusan.
Pendekatan yang kami jelaskan telah menyatukan semua data, membuka jalan untuk menjawab pertanyaan besar: Bisakah kita menilai kinerja semua klien perusahaan di satu tempat terpusat?
Namun, tidak berhenti di situ! Solusi ini bukan proyek sesaat; ini adalah solusi yang tangguh dan tahan lama yang dimaksudkan untuk membuka kemungkinan tanpa batas. Bayangkan membangun banyak laporan, semuanya memanfaatkan solusi ini sebagai fondasi yang kuat.
Kini tibalah bagian yang menarik—mewariskan pengetahuan berharga ini untuk menciptakan barisan individu terampil yang dapat memanfaatkan potensinya. Membangun solusi saja tidak cukup; agar benar-benar skalabel dan berkelanjutan, kita harus memberdayakan tim dan membangun keahlian kemelekan data guna menjaga mesin yang terpelihara ini berjalan mulus.
Sama seperti metodologi Six Sigma, yang membantu meningkatkan proses bisnis, kami terus menyempurnakan proses, merampingkan alur kerja, dan mengambil langkah-langkah untuk mempertahankan pendekatan luar biasa ini.
Intinya, kita tidak sekadar membangun solusi; kita menyalakan transformasi yang akan mendorong kemajuan dan keunggulan selama bertahun-tahun ke depan.
Dalam banyak kasus, pertanyaan paling sederhana menuntut infrastruktur data yang canggih. Sains data, pada intinya, adalah tentang memanfaatkan data untuk memberikan dampak signifikan pada organisasi Anda. Dengan solusi yang kuat ini di tangan Anda, Anda akan mampu membuka potensi sejati data Anda dan menciptakan dampak transformasional.
Siap menyelami lebih dalam dunia rekayasa data dan analitik? Daftarlah ke kursus Streamlined Data Ingestion with pandas dari DataCamp untuk memperoleh keterampilan praktis dalam mengoptimalkan pengumpulan, pemasukan, dan transformasi data. Atau, lihat jalur karier Data Engineer in Python untuk memperoleh keterampilan yang banyak dicari bisnis dan ketika Anda siap, ambil Sertifikasi Data Engineer.
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt



