Dieser Artikel ist ein geschätzter Beitrag aus unserer Community und wurde von DataCamp redaktionell überarbeitet.
Du möchtest dein Fachwissen teilen? Wir freuen uns darauf! Reiche deine Artikel oder Ideen über unser Community Contribution Form ein.
Viele Unternehmen treffen Entscheidungen auf Basis von Daten. Diese Daten stammen häufig aus unterschiedlichen Quellen und liegen in verschiedenen Formaten vor. Meist werden sie in eigenen Silos gespeichert und transformiert, um sehr spezifische Fragen zu beantworten. Wenn Unternehmen eine datengetriebene Arbeitsweise etablieren, stößen Datenteams auf eine scheinbar einfache Frage: Können wir die Performance aller Kundinnen und Kunden an einem zentralen Ort auswerten? (Oder können wir alle Datenpunkte gebündelt sehen?)
In diesem Tutorial lernst du, wie du dir bekannte Techniken kombinierst und übereinanderlegst, um eine Lösung zu bauen, die genau diese Frage beantwortet.
Wichtige Grundlagen
Hier fassen wir zentrale Konzepte zusammen, die wir im weiteren Verlauf des Artikels vertiefen.
Data Lake
Ein großer, zentraler Speicherort für strukturierte, semi-strukturierte und unstrukturierte Daten in beliebiger Menge. Er bietet eine flexible und kosteneffiziente Lösung, um große Datenvolumina aus verschiedensten Quellen abzulegen.
Anders als klassische Datenspeicher erfordert ein Data Lake kein upfrontes Datenmodell oder strenge Schemas. Daten können im Rohzustand gespeichert werden und lassen sich bei Bedarf verarbeiten, analysieren und transformieren — ideal für datenbasierte Entscheidungen und Advanced Analytics.
Einen Vergleich von Data Lake vs. Data Warehouse findest du in einem separaten Artikel.
Data Warehouse
Ein Data Warehouse ist ein großer, zentraler Speicher für strukturierte Daten. Es unterstützt Business Intelligence, Reporting und Datenanalysen. Daten aus mehreren Datenbanken, Anwendungen und Systemen werden vereinheitlicht, konsistent aufbereitet und so für effiziente Abfragen und Analysen bereitgestellt.
Microservices
Microservices sind ein architektonischer und organisatorischer Ansatz, bei dem Software aus kleinen, unabhängigen Services besteht, die über klar definierte APIs kommunizieren. Diese Services gehören eigenverantwortlichen, kleinen Teams. Microservice-Architekturen erleichtern das Skalieren und beschleunigen die Entwicklung — Innovationen kommen schneller in die Anwendung.
Eine adaptive Datenpipeline aufbauen
Der Ansatz umfasst die Schritte Datenerfassung, Speicherung, Verarbeitung, Staging-Views und die skalierte Generierung von Analysen.
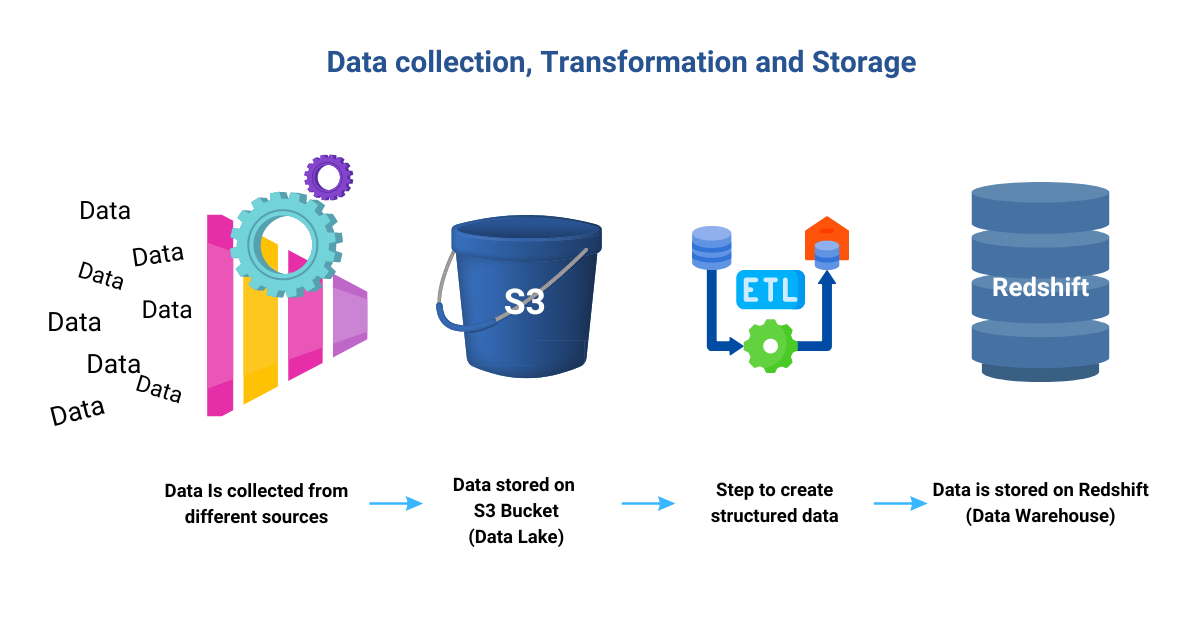 Bild: Autorin/Autor
Schritt 1: Datenerfassung und Voraussetzungen
In der Startphase solltest du zentrale Voraussetzungen klären, bevor du loslegst. Analysiere sorgfältig, woher die Daten kommen und wo sie liegen, um die Quellen vollständig zu verstehen.
Entwickle Strategien, um die gesammelten Daten nutzbar und analysierbar zu machen. Data Wrangling spielt eine Schlüsselrolle, damit die Daten sauber und verwendbar vorliegen. Priorität hat zudem eine Lösung, die Datenpunkte verschiedener Kundinnen und Kunden nahtlos zusammenführt — bei voller Datenintegrität und Sicherheit.
DataCamps Guide What is Data Analysis beschreibt diesen Prozess im Detail.
Schritt 2: Data Lake und Data Warehouse
Daten werden aus verschiedenen Kundensystemen gesammelt und in S3 Buckets (ein Speicherort in Amazon Simple Storage Service (Amazon S3)) konsolidiert — der Data Lake für Rohdaten. Anschließend werden Extract, Transform, Load-(ETL)-Prozesse genutzt, um die Rohdaten in strukturierte Datensätze für das Data Warehouse zu überführen. So entsteht im Warehouse ein sauber organisiertes Repository mit Schemas und strukturierten Daten. Die Daten je Kundin/Kunde bleiben jedoch getrennt und liegen in eigenen Silos innerhalb des Warehouses.
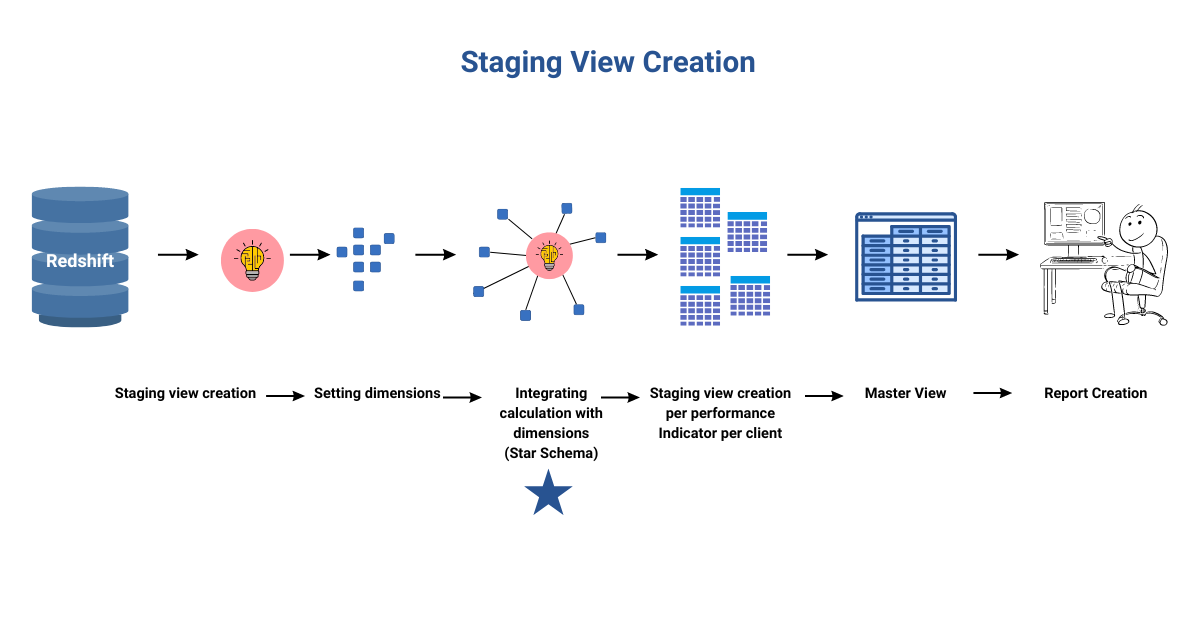 Bild: Autorin/Autor
Schritt 3: Staging-View (Das Herzstück)
Die Staging-Views nutzen die Beziehungen zwischen Schema, Tabellen und Spalten im Data Warehouse. Ergebnis ist eine vereinfachte Business-Sicht, die Komplexität verbirgt und ein konsistentes Verständnis von Dimensionen und Fakten für Analysen sicherstellt. Alle Stakeholder erhalten zentral verwaltete, korrekte Daten und können Performance entlang verschiedener Dimensionen auswerten.
Kern des Ansatzes ist der technische Aufbau dieser Staging-Views. Sie enthalten die fürs Reporting und für Analytics benötigten Berechnungen und Attribute — und machen das gesamte Ökosystem skalierbar. Neue Logik oder Änderungen werden in diesen Staging-Views umgesetzt.
Für gezieltes Troubleshooting werden Staging-Views pro Kundin/Kunde und pro Leistungskennzahl angelegt. So lassen sich Probleme schnell isolieren und beheben. Das steht im Kontrast zu einer einzigen, sehr großen Stored Procedure, bei der die Fehlersuche deutlich länger dauert.
Durch Segmentierung und Aggregation entstehen aus Transaktionsdaten aussagekräftige, aggregierte Leistungskennzahlen. Jede Staging-View enthält die Berechnungslogik und Dimensionen für den gewünschten Output. Dieser Prozess wird für jede Kundin/jeden Kunden wiederholt, sodass pro Kennzahl und Kunde eine eigene Staging-View entsteht — bei gewahrter Sicherheit sensibler Informationen.
Schritt 4: Datenmodellierung
In Schritt 3 haben wir alle Daten in einer zentralen Master-View gebündelt. Diese dient als Grundlage für kundenspezifische Views, indem wir nach kundenbezogenen Attributen filtern. Dass alle Kundenattribute an einem Ort liegen, beschleunigt die Erstellung neuer Views.
Die Master-View kann Daten über mehrere Jahre enthalten, lässt sich aber problemlos auf wenige Monate beschränken — exakt passend zu den Anforderungen der jeweiligen Kundin/des jeweiligen Kunden. So liefern wir präzise die benötigten Daten und steigern Relevanz und Effizienz der Analysen.
Als Datenmodell dient das Star-Schema (ein multidimensionales Modell zur Organisation von Daten). Es gliedert die Daten in zwei Komponenten: Fact Table und Dimensionstabellen.
Die numerischen Daten der Fact Table sind über Primärschlüssel mit den Dimensionstabellen verknüpft — die Beziehungen sind leicht nachvollziehbar. So lassen sich Daten schnell filtern und aggregieren. Nutzerinnen und Nutzer können gezielt explorieren, ohne komplexe Joins über viele Tabellen zu benötigen.
Dank der denormalisierten Struktur sind Dimensionstabellen unabhängig — das beschleunigt Abfragen deutlich. Die Datenbank kann effizient lesen, ohne umfangreiche Verarbeitung, und liefert selbst bei komplexen Analysen kurze Antwortzeiten.
Kurz gesagt: Das Star-Schema ist ein starker Hebel für einfache, effiziente Analysen. Die Organisation in Fact- und Dimensionstabellen beschleunigt Abfragen, vereinfacht die Exploration und erschließt wertvolle Insights für fundierte Entscheidungen.
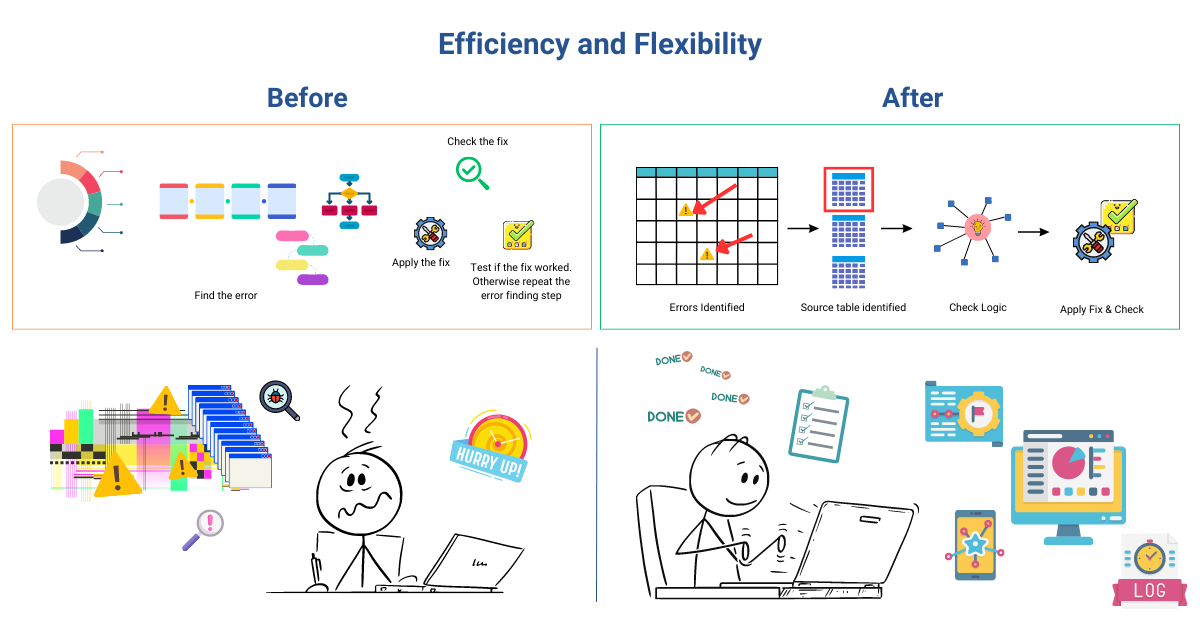
Bild: Autorin/Autor
Effizienz und Flexibilität
Die eigentliche Stärke dieses Ansatzes liegt in seiner hohen Effizienz und großen Flexibilität. Hier kommt das Microservices-Prinzip zum Tragen.
Müssen wir etwas ändern — etwa Neuberechnungen vornehmen oder Datenfehler beheben —, passen wir einfach die Logik der jeweiligen Kennzahl im Staging-Skript an. So werden Fehlersuche und Änderungen zu schnellen, reibungslosen Tasks — Ausfallzeiten sinken drastisch.
Stell dir vor, bei einer bestimmten Kundin/einem bestimmten Kunden zeigt eine Kennzahl einen unplausiblen Wert. Klassisch würde die Fehlersuche länger dauern: Ursache finden, neu berechnen, Code laufen lassen, Daten validieren.
Mit unserem Ansatz erreichen wir eine beispiellose Effizienz und verschlanken die Fehlersuche deutlich.
Wir können nun schnell die betroffene Kennzahl identifizieren, ihre Logik prüfen und die zugrunde liegende Berechnungstabelle validieren. Fehlerursachen werden damit leicht sichtbar, und Fixes sind zügig umgesetzt. Die Troubleshooting-Zeit sinkt massiv — wir konzentrieren uns auf die Lösung statt auf langwierige Prozesse.
Anwendung und Reporting
Um Performance einzuordnen — ob gut, schlecht oder mit Verbesserungsbedarf —, arbeiten wir mit Zielen. Dafür kann eine Anwendungsoberfläche entwickelt und mit der Master-Tabelle verbunden werden. Die nutzerfreundliche UI erfasst zielbezogene Eingaben auf Attributebene und speichert sie in einer separaten Tabelle. Indem wir die Master-Tabelle mit einer Anwendung verknüpfen, die Eingaben direkt aus den im Data-Warehouse verfügbaren Daten zulässt, zeigen wir das Potenzial dieses Ansatzes für produktionsreife Lösungen.
Die Zieltabelle wird mit der Performance-Master-Tabelle verknüpft. So entsteht ein ganzheitlicher Blick auf Kennzahlen und ihre Zielwerte — ideal, um Zielerreichung umfassend zu beurteilen.
Reports zu bauen rundet die Lösung ab und liefert starke Insights für bessere Entscheidungen.
Fazit
Mit diesem Ansatz führen wir alle Daten zusammen und können die zentrale Frage beantworten: Lässt sich die Performance aller Kundinnen und Kunden an einem Ort auswerten?
Mehr noch: Die Lösung ist kein Strohfeuer, sondern ein robustes, langfristiges Fundament mit vielen Möglichkeiten. Du kannst zahlreiche Reports darauf aufbauen.
Jetzt kommt der nächste Schritt: Wissen weitergeben, Teams befähigen und Datenkompetenz aufbauen — damit dieser Motor dauerhaft rundläuft.
Wie bei der Six-Sigma-Methodik verbessern wir Prozesse kontinuierlich, verschlanken Workflows und sichern die Qualität dieses Ansatzes.
Kurzum: Wir bauen nicht nur eine Lösung, wir stoßen eine Transformation an, die Fortschritt und Exzellenz über Jahre hinweg treibt.
Oft verlangen einfache Fragen eine ausgeklügelte Dateninfrastruktur. Data Science bedeutet, Daten so zu nutzen, dass sie in deinem Unternehmen wirklich etwas bewegen. Mit dieser Lösung kannst du das volle Potenzial deiner Daten heben und messbare Wirkung erzielen.
Du willst tiefer in Data Engineering und Analytics einsteigen? Starte mit DataCamps Kurs Streamlined Data Ingestion with pandas und lerne, Datenerfassung, -ingestion und -transformation zu optimieren. Oder folge dem Data Engineer in Python Career Track, um gefragte Kompetenzen aufzubauen — und wenn du soweit bist, hol dir die Data Engineer Certification.