Este artigo é uma valiosa contribuição da nossa comunidade e foi editado pela DataCamp para maior clareza e precisão.
Quer compartilhar sua experiência? A gente quer te ouvir! Envie seus artigos ou ideias pelo nosso formulário de contribuição da comunidade.
Hoje, muitas organizações dependem de dados para tomar decisões. Esses dados costumam ser registrados e coletados de fontes diversas, em diferentes formatos. Na maior parte das vezes, eles são armazenados e transformados em silos próprios, sendo usados para responder perguntas específicas daquele conjunto. Conforme as empresas avançam para uma abordagem orientada por dados, os times de dados se deparam com uma pergunta aparentemente simples: dá para avaliar o desempenho de todos os clientes da empresa em um único lugar centralizado? (ou seja, ver todos os pontos de dados em um só lugar?)
Neste tutorial, você vai aprender a aproveitar técnicas que talvez já conheça e combiná-las para construir uma solução que ajuda a responder essa pergunta.
Pontos-chave
Aqui, destacamos alguns dos conceitos que vamos explorar ao longo do artigo.
Data lake
Um repositório vasto e centralizado que armazena dados estruturados, semiestruturados e não estruturados, em qualquer escala. É uma solução flexível e econômica para guardar grandes volumes de dados de diferentes tipos e fontes.
Diferentemente de sistemas tradicionais de armazenamento, um data lake não exige modelagem prévia nem imposição rígida de esquemas, permitindo guardar os dados como eles são. Esses dados brutos podem ser processados, analisados e transformados conforme necessário, tornando-se um recurso valioso para decisões orientadas por dados e análises avançadas.
Você pode comparar data lake vs. data warehouse em um artigo separado.
Data warehouse
Um data warehouse é um repositório grande e centralizado que armazena e gerencia dados estruturados. Ele é projetado para dar suporte a business intelligence, relatórios e atividades de análise. Data warehouses consolidam dados de múltiplos bancos, aplicativos e sistemas, transformando tudo em um formato unificado e consistente para consultas e análises eficientes.
Microsserviços
Microsserviços são uma abordagem arquitetural e organizacional de desenvolvimento em que o software é composto por serviços pequenos e independentes que se comunicam por APIs bem definidas. Esses serviços são de responsabilidade de times pequenos e autônomos. Arquiteturas de microsserviços facilitam a escalabilidade e aceleram o desenvolvimento, favorecendo a inovação e reduzindo o time-to-market de novas funcionalidades.
Construindo um pipeline de dados adaptável
Essa abordagem inclui etapas de coleta, armazenamento, processamento, criação de views de staging e geração de análises em escala.
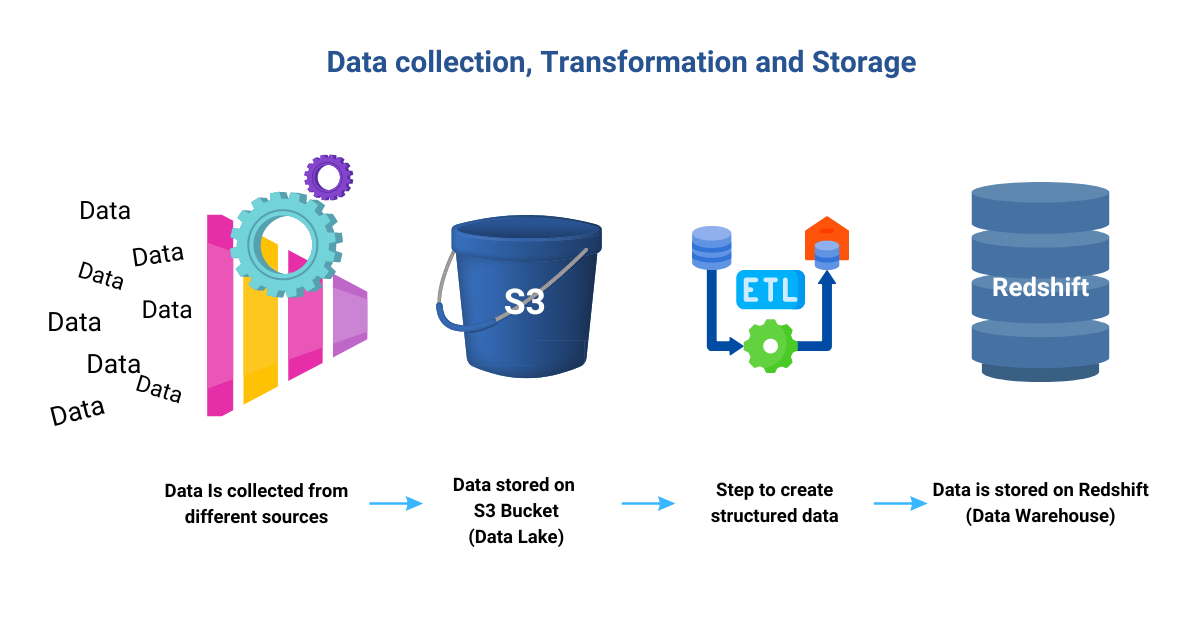 Imagem do autor
Passo 1: coleta de dados e pré-requisitos
Na fase inicial, é fundamental tratar dos pré-requisitos antes de começar a execução. Analise a fundo a origem e o armazenamento dos dados para entender bem as fontes.
Defina estratégias eficazes para tornar os dados coletados úteis e prontos para análise. A preparação e limpeza de dados (data wrangling) é essencial para garantir um formato limpo e utilizável, preparando tudo para as próximas etapas. Além disso, a prioridade é encontrar uma solução que integre, sem atritos, pontos de dados de diferentes clientes, preservando a integridade e a segurança.
O guia da DataCamp, What is Data Analysis, aprofunda esse processo.
Passo 2: data lake e data warehouse
Os dados são coletados de vários clientes e consolidados em S3 Buckets (um local de armazenamento no Amazon Simple Storage Service, o Amazon S3), formando um data lake que guarda informações diversas em sua forma bruta. Em seguida, usamos processos de Extract, Transform, Load (ETL) para converter os dados coletados em um conjunto estruturado que se encaixa no data warehouse. Assim, o data warehouse se torna um repositório em que esquemas e dados estruturados são organizados com rigor. Porém, os dados de cada cliente continuam separados, em seus próprios silos dentro do data warehouse.
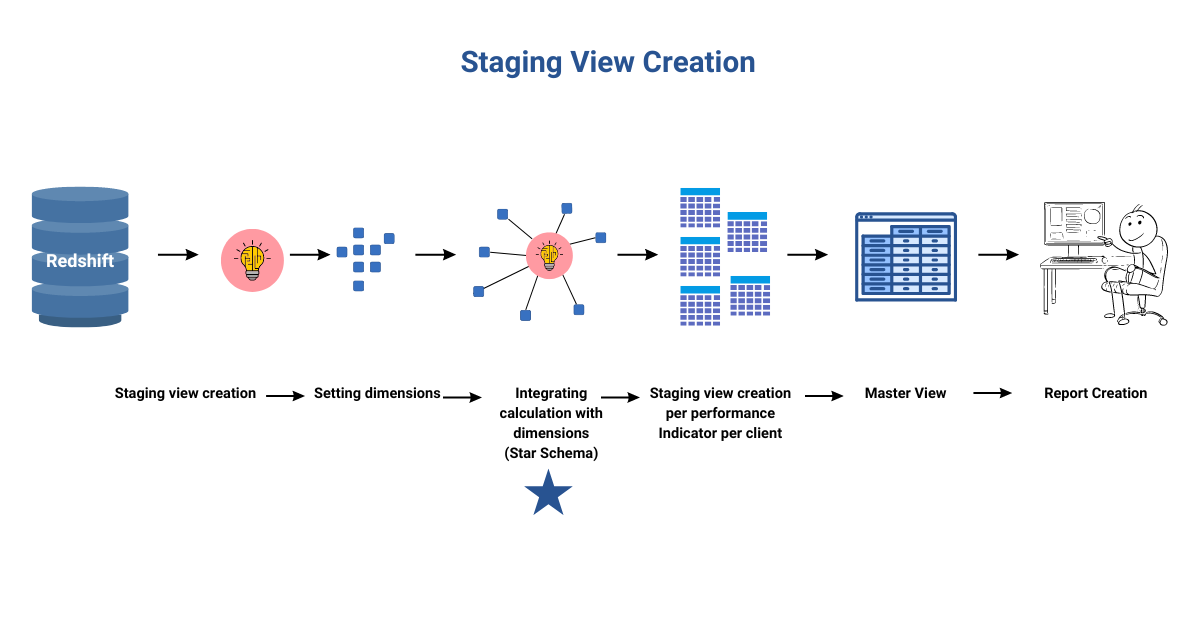 Imagem do autor
Passo 3: view de staging (o coração da operação)
As views de staging são construídas aproveitando os relacionamentos entre esquemas, tabelas e colunas no data warehouse. O resultado é uma visão de negócios simplificada que esconde a complexidade e garante entendimento consistente de dimensões e fatos para análise. Todos os usuários corporativos acessam dados precisos, gerenciados de forma centralizada, permitindo insights valiosos sobre desempenho em diferentes dimensões.
No centro dessa abordagem está o processo técnico de criação das views de staging. Elas concentram os cálculos e atributos necessários para relatórios e análises, tornando todo o ecossistema escalável. Qualquer lógica nova ou ajustes são implementados nessas views.
Para facilitar a identificação de problemas, as views de staging são criadas por cliente e por indicador de desempenho, permitindo localizar e resolver questões com eficiência. Essa abordagem contrasta com o uso de um único procedimento armazenado gigantesco, que dificulta e torna demorada a identificação de problemas.
Com técnicas de segmentação e agregação, indicadores de desempenho de alto nível são gerados a partir da análise de dados transacionais e da combinação criteriosa desses dados. Cada view de staging incorpora a lógica de cálculo e as dimensões para entregar o valor esperado. O processo se repete para cada cliente, resultando em uma view de staging por indicador e por cliente, mantendo a segurança de informações sensíveis.
Passo 4: modelagem de dados
No passo 3, consolidamos todos os dados em uma única master view. Essa master view serve de base para criar views específicas por cliente ao aplicar filtros com atributos relacionados a cada cliente. Ter todos os atributos dimensionais dos clientes em um só lugar agiliza a criação dessas views.
Além disso, a master view pode armazenar dados de vários anos, mas é fácil restringir para incluir apenas alguns meses, conforme as necessidades de cada cliente. Essa flexibilidade permite entregar exatamente o que cada um precisa, aumentando a relevância e a eficiência das análises.
O modelo estrela (star schema) é o modelo de dados usado. Ele separa os dados em dois componentes-chave: a tabela fato e as tabelas dimensão.
Os dados numéricos da tabela fato se conectam às dimensões por meio de chaves primárias, criando relações fáceis de entender. Isso ajuda os usuários a fazer consultas rápidas e simples, filtrando e agregando dados por diversas dimensões. A análise fica mais ágil, pois é possível explorar pontos específicos sem joins complexos entre várias tabelas.
A estrutura desnormalizada do star schema garante independência entre as tabelas dimensão, proporcionando desempenho de consulta muito rápido. O mecanismo do banco consegue recuperar dados sem processamento pesado, entregando tempos de resposta melhores até para consultas analíticas mais complexas.
Em resumo, o star schema é um grande aliado, deixando a análise de dados simples e eficiente. Organizar em tabelas fato e dimensão acelera consultas, simplifica a exploração e abre um mundo de insights para decisões mais embasadas.
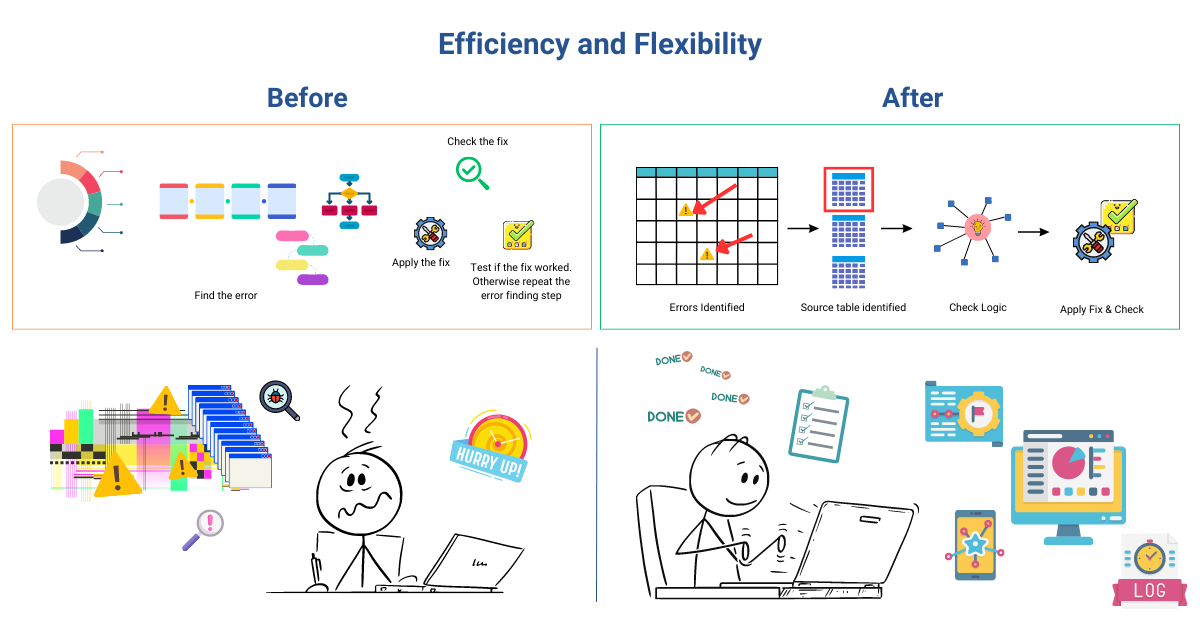
Imagem do autor
Eficiência e flexibilidade
O grande diferencial dessa abordagem está na eficiência e na flexibilidade. É aqui que o conceito de microsserviços entra em cena.
Quando mudanças são necessárias — seja para recalcular ou corrigir dados — basta atualizar a lógica do indicador de desempenho dentro do script de staging. Além disso, esse processo torna a identificação de problemas e as modificações muito mais simples e rápidas, reduzindo drasticamente qualquer possível indisponibilidade.
Para entender o poder dessa abordagem, imagine um cenário em que o indicador de desempenho de um cliente específico mostra um ponto de dados inconsistente. No método tradicional, seria preciso um processo demorado para rastrear a causa raiz, com várias etapas de recálculos, execuções de código e validações.
Com a abordagem atual, alcançamos um nível ímpar de eficiência e simplificamos o troubleshooting.
Agora, conseguimos identificar rapidamente o indicador exato responsável pela discrepância, inspecionar a lógica e validar a tabela associada aos cálculos. Assim, localizar a origem do erro fica fácil, e aplicar os ajustes necessários acontece com velocidade. Graças a esse método, o tempo de troubleshooting cai drasticamente: focamos em resolver o problema, não em etapas longas e cansativas.
Aplicação e relatórios
Para avaliar níveis de desempenho — se estão bons, ruins ou precisam melhorar — usamos metas. Para isso, é possível desenvolver uma interface de aplicação conectada à tabela master. Essa interface intuitiva captura as metas em nível de atributo inseridas pelos usuários, que são armazenadas em uma tabela dedicada. Ao integrar a tabela master com um aplicativo que recebe entradas diretamente dos dados disponíveis no data warehouse, mostramos o potencial dessa abordagem como base para a construção de soluções.
A tabela de metas é então combinada com a tabela Performance Master, criando uma visão completa dos indicadores de desempenho ao lado de suas respectivas metas. Essa integração permite entender, de forma abrangente, o quanto os objetivos estão sendo alcançados.
Criar relatórios com base nesses dados fecha a solução, oferecendo insights poderosos para orientar a tomada de decisão.
Conclusão
A abordagem que apresentamos reuniu todos os dados, abrindo caminho para responder à grande pergunta: dá para avaliar o desempenho de todos os clientes da empresa em um único lugar centralizado?
E tem mais! Essa solução não é um projeto passageiro; é uma base robusta e duradoura que abre um leque de possibilidades. Imagine criar vários relatórios, todos aproveitando essa solução como alicerce.
Agora vem a parte empolgante — compartilhar esse conhecimento para formar profissionais capazes de explorar todo o potencial. Construir uma solução não basta; para escalar e garantir sustentabilidade, é preciso capacitar os times e desenvolver o letramento em dados que mantém essa máquina azeitada funcionando sem falhas.
Assim como a metodologia Six Sigma, que ajuda a aprimorar processos de negócios, buscamos continuamente melhorar processos, simplificar fluxos de trabalho e manter esse padrão de excelência.
Em essência, não estamos apenas construindo uma solução; estamos acendendo uma transformação que vai impulsionar progresso e excelência por muitos anos.
Em muitos casos, as perguntas mais simples exigem uma infraestrutura de dados sofisticada. Ciência de dados, no fundo, é usar dados para gerar impacto real na sua organização. Com essa solução poderosa em mãos, você vai liberar todo o potencial dos seus dados e gerar transformação.
Quer se aprofundar em engenharia e análise de dados? Matricule-se no curso Streamlined Data Ingestion with pandas da DataCamp para desenvolver habilidades práticas em otimização de coleta, ingestão e transformação de dados. Ou confira a trilha de carreira Data Engineer in Python para adquirir as competências mais procuradas pelas empresas e, quando estiver pronto, faça a Data Engineer Certification.