Als je van plan bent een nieuwe digitale applicatie te starten, zul je waarschijnlijk gegevens moeten verzamelen en opslaan. Waar en hoe je die data opslaat, is een van de belangrijkste beslissingen die je moet nemen, want de hele software zal op die data steunen om te werken.
Traditioneel werden gegevens opgeslagen in tabellen met rijen en kolommen die via bepaalde relaties (d.w.z. gemeenschappelijke kolommen) met elkaar verbonden zijn. Databases die relationele data opslaan, heten relationele databases, of SQL-databases, omdat de meeste, zo niet allemaal, op SQL vertrouwen voor allerlei bewerkingen.
In de afgelopen decennia zijn er echter nieuwe databasemanagementsystemen ontwikkeld om de snelle toename in volume en verscheidenheid aan data die elke seconde wordt gecreëerd, het hoofd te bieden. De zogeheten NoSQL-databases (Not only SQL) stellen nieuwe schema’s en strategieën voor om data effectief te verzamelen op basis van specifieke use-cases, terwijl ze tot op zekere hoogte nog steeds op SQL steunen.
In dit artikel analyseren we twee populaire databasemanagementsystemen: PostgreSQL vs MongoDB. De eerste is een van de populairste SQL-databases, terwijl de tweede de bekendste NoSQL-database is.
We behandelen de belangrijkste functies en sterke punten van beide databases, hun meest aansprekende use-cases en zaken om te onthouden als je overweegt je data naar een van deze databases te migreren.
Wil je meteen praktisch aan de slag en elke methode uitproberen? Bekijk dan zeker onze cursussen Creating PostgreSQL Databases en Introduction to MongoDB in Python.
TL;DR: PostgreSQL vs MongoDB
De juiste database kiezen is cruciaal voor elke digitale applicatie. PostgreSQL, een krachtige relationele database op basis van SQL, blinkt uit bij gestructureerde data die consistentie, complexe joins en ACID-transacties vereist. MongoDB, een flexibele NoSQL documentdatabase die BSON gebruikt, is ideaal voor dynamische, ongestructureerde data en biedt grotere schaalbaarheid via horizontale sharding. De keuze tussen PostgreSQL en MongoDB hangt uiteindelijk af van de datastructuur van je project, je schaalbaarheidsbehoeften en je consistentie-eisen.
PostgreSQL vs MongoDB: datamodelarchitecturen
Laten we de belangrijkste verschillen tussen PostgreSQL en MongoDB analyseren qua datamodelarchitectuur.
Relationele vs documentgebaseerde structuren
Relationele databasemanagementsystemen, zoals PostgreSQL, organiseren data in tabellen, waarbij elke tabel uit rijen en kolommen bestaat. Deze tabellen kunnen via sleutels worden gekoppeld, waardoor complexe gegevensrelaties mogelijk zijn via SQL-joins en efficiënte query’s.
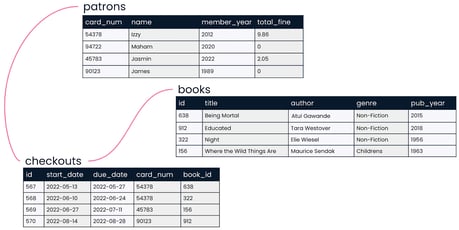
Relationele database. Bron: DataCamp
Dankzij hun eenvoud, unieke efficiëntie en sterke consistentie zijn relationele databases de afgelopen decennia enorm succesvol en breed omarmd.
Toch zijn ze mogelijk niet de beste optie wanneer je werkt met ongestructureerde data die niet netjes in een tabelvorm past (bijv. socialmediaberichten, sensordata) of wanneer schaalbaarheid een must is; dus wanneer je applicatie horizontaal over meerdere servers moet schalen.
Hier komen NoSQL-databases in beeld. In tegenstelling tot hun relationele tegenhangers kunnen NoSQL-databases ongestructureerde of semi-gestructureerde data verwerken zonder de beperkingen van een vast schema.
Specifiek is MongoDB een zogeheten documentdatabase, een type NoSQL-database die data opslaat in collecties van JSON-achtige documenten met een formaat genaamd BSON (Binary JSON). Simpel gezegd lijken documenten op JSON key-value-objecten, met extra mogelijkheden voor opslag en bewerking dankzij BSON.
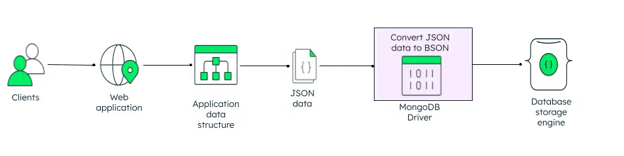
Hoe MongoDB data als BSON opslaat. Bron: DataCamp
De flexibele aard van BSON maakt het mogelijk om dynamische documentschema’s te creëren waarvan de structuur en data on the fly kunnen variëren. In de volgende subsectie gaan we hier dieper op in.
Schema-evolutiepatronen
Relationele databases zoals PostgreSQL bieden robuuste schema’s die lastig te wijzigen zijn zodra je je tabellen hebt aangemaakt. Dat is een groot voordeel als de data waarmee je werkt een tabelvorm heeft en altijd in hetzelfde formaat in je applicatie binnenkomt. Maar als je te maken hebt met semi-gestructureerde of ongestructureerde data waarvan de inhoud per datapunt kan verschillen, zoals socialmediaberichten of sensordata, heb je een zekere flexibiliteit nodig om je data te verwerken.
In tegenstelling tot PostgreSQL werkt MongoDB met zogeheten schemaloze ontwerpen, die uitzonderlijke flexibiliteit bieden voor het verwerken van diverse en evoluerende data. Het schemaloze ontwerp van MongoDB organiseert data in documenten en collecties:
- Documenten zijn de basiseenheid van data en bestaan uit BSON key-value-paren. Documenten kunnen strings, nummers, datums, arrays en zelfs andere ingesloten documenten bevatten. Dit maakt verfijnde datamodellen mogelijk die complexe relaties binnen één document weergeven, wat aansluit bij hoe objecten in de meeste programmeertalen zijn opgebouwd.
- Collecties groeperen gerelateerde documenten, vergelijkbaar met een tabel, maar op een flexibelere manier. Collecties dwingen geen schema af, waardoor documenten verschillende structuren en velden kunnen hebben. Collecties bestaan binnen MongoDB-databases, en elke database kan meerdere collecties bevatten.
In tegenstelling tot traditionele relationele databases, waar het toevoegen van een nieuw veld vereist dat je de hele tabelstructuur wijzigt, laat MongoDB toe dat documenten binnen dezelfde collectie volledig verschillende velden en structuren hebben. Dit maakt rigide schema’s overbodig en vereenvoudigt het opslaan van uiteenlopende data zonder uniformiteit te forceren.
PostgreSQL vs MongoDB: querytalen
Welke database je ook gebruikt, PostgreSQL of MongoDB, je moet de taal leren om met je databases te communiceren en ze te beheren. In PostgreSQL is dat SQL, een enorm populaire, gestandaardiseerde en gebruiksvriendelijke programmeertaal. Je kunt aan de slag met SQL in onze cursus Introduction to SQL.
Daarentegen vertrouwt MongoDB primair op de eigen MongoDB Query Language (MQL) voor interactie met de database. Het is echter ook mogelijk om andere populaire programmeertalen, zoals Python, C en Java, te gebruiken om verbinding te maken met en te communiceren met MongoDB-databases.
Laten we de belangrijkste verschillen tussen SQL en MQL bekijken.
SQL- vs MQL-mogelijkheden
Een van de grootste voordelen van PostgreSQL ten opzichte van MongoDB is het gebruik van SQL. SQL (staat voor “Structured Query Language”) is een essentiële taal voor het bouwen en onderhouden van relationele databases.
Het is een eenvoudige, domeinspecifieke programmeertaal die door bijna alle relationele databasesystemen wordt gebruikt, zoals MySQL, SQL Server, SQLite en natuurlijk PostgreSQL.
SQL is extreem krachtig en laat je allerlei databewerkingen uitvoeren, van dataopvraging en -aggregatie tot opschonen en join-operaties. In PostgreSQL zijn de mogelijkheden zelfs nog groter, omdat PostgreSQL beschikt over een reeks geavanceerde functies voor complexe analyses, waaronder:
- Functies en procedures: PostgreSQL ondersteunt het aanmaken van functies en stored procedures, die in verschillende programmeertalen kunnen worden geschreven, wat het vermogen van de database vergroot om complexe bewerkingen aan te kunnen.
- Volledige-tekstzoeking: PostgreSQL biedt robuuste full-text search-mogelijkheden, waardoor efficiënte zoekacties op tekstuele data mogelijk zijn.
- JSON-ondersteuning: Uitgebreide ondersteuning voor JSON-datatypen stelt PostgreSQL in staat om semi-gestructureerde data effectief te verwerken, waardoor het gat tussen relationele en documentgeoriënteerde databases gedeeltelijk wordt overbrugd.
Daartegenover staat dat, hoewel MongoDB niet op SQL steunt, het krachtige query-, indexerings- en aggregatiemogelijkheden heeft, evenals andere functies om informatie in documentdatabases in te voegen, bij te werken of te verwijderen. Als je bekend bent met JSON of Python-dictionaries, zal het niet lang duren voor je de MQL-syntaxis onder de knie hebt.
MQL is speciaal ontworpen om het dynamische karakter van documenten te verwerken. Daardoor is het een veel flexibelere taal dan SQL. En omdat documenten andere documenten kunnen insluiten, is er in MongoDB geen noodzaak voor complexe en inefficiënte join-operaties, wat in relationele databases vaak wel het geval is.
Indexeringsstrategieën
Indexen zijn databaseobjecten die de snelheid van data-opvragingen verbeteren. Ze fungeren als verwijzingen om rijen in een tabel snel te lokaliseren en verhogen zo de prestaties van query’s.
PostgreSQL heeft sterke indexeringsmogelijkheden en ondersteunt meerdere indextypen, waaronder:
- B-tree-index: Het standaard en meest gebruikte indextype
- Hash-index: Voor snelle gelijkheidszoekacties
- GIN-index: Voor het indexeren van JSON, arrays en full-text search
- GiST-index: Voor complexe datatypen zoals geometrische of fuzzy search
- BRIN-index: Voor grote, natuurlijk geordende data (zoals tijdreekslogs)
- Expressie-index: Index op basis van een functie of expressie
- Partiële index: Indexeer slechts een subset van rijen (handig voor filtering)
MongoDB ondersteunt ook indexering om documenten in collecties te vinden zonder alle documenten te hoeven scannen. De mogelijkheden zijn echter beperkter en missen de variëteit en verfijning die beschikbaar is in relationele databases zoals PostgreSQL. Dit omvat:
- Single-field-index: Single-field-indexen verzamelen en sorteren data uit één veld in elk document van een collectie.
- Samengestelde index: Samengestelde indexen verzamelen en sorteren data uit twee of meer velden in elk document van een collectie.
- Multikey-index: Multikey-indexen verzamelen en sorteren data die in arrays is opgeslagen.
- Tekstindex: Tekstindexen ondersteunen tekstzoekopdrachten op velden met tekenreeksinhoud.
- Gehashede index: Gehashede indexen ondersteunen gehashte sharding. Ze indexeren de hash van de waarde van een veld.
Indexen gebruiken in je SQL- en NoSQL-databases is essentieel om de prestaties te verhogen en querytijden te verkorten, vooral bij grote datasets.
Onthoud echter dat het toevoegen van een index ook een negatief prestatie-effect kan hebben voor schrijfbewerkingen. Voor tabellen of collecties met een hoge write-to-read-verhouding zijn indexen kostbaar, omdat bij elke insert ook alle relevante indexen moeten worden bijgewerkt.
Prestaties en schaalbaarheid in MongoDB vs PostgreSQL
MongoDB en PostgreSQL zijn geweldige databasetools, maar het heeft weinig zin om de een boven de ander te kiezen op basis van hun eigenschappen alleen. Je keuze moet je altijd maken met de bijzonderheden van je use-case in gedachten. Laten we, met dit in het achterhoofd, de verschillen in prestaties en schaalbaarheid van MongoDB en PostgreSQL analyseren.
Transactieverwerking
Zoals andere populaire relationele databasesystemen waarborgt PostgreSQL een hoge mate van dataintegriteit en -kwaliteit via het robuuste typesysteem en de ondersteuning voor ACID-transacties (Atomicity, Consistency, Isolation, Durability).
ACID-transacties zijn een set eigenschappen die de betrouwbare verwerking van databasetransacties garanderen. Ze zorgen ervoor dat data nauwkeurig en veilig blijft, zelfs bij fouten, crashes of gelijktijdige toegang. Deze eigenschappen zijn cruciaal voor het handhaven van datakwaliteit in elk project.
Hoewel ACID-transacties lange tijd de gouden standaard zijn geweest voor het waarborgen van dataintegriteit in relationele databases, geven NoSQL-databases zoals MongoDB vaak voorrang aan flexibiliteit en schaalbaarheid boven strikte transactionele consistentie. Dit leidt tot het versoepelen van sommige ACID-eigenschappen die in relationele databases te vinden zijn.
Zo geven sommige MongoDB-implementaties prioriteit aan uiteindelijke consistentie boven onmiddellijke consistentie, wat betekent dat wijzigingen niet meteen op alle nodes zichtbaar zijn. De afwegingen op het vlak van consistentie, beschikbaarheid en prestaties zorgen voor betere performance en schaalbaarheid, maar vereisen zorgvuldige overweging bij het ontwerpen van applicaties die op strikte dataconsistentie steunen.
Schaalbaarheidspatronen
Schalen omvat het gebruik van verschillende technieken om toenames in datavolume en verkeer op te vangen. Simpel gesteld kan dat via verticale en horizontale schaalvergroting. De eerste houdt in dat je dezelfde server verbetert en meer resources toevoegt om de hogere belasting aan te kunnen. De tweede bereik je door extra servers of nodes toe te voegen aan een gedistribueerd systeem, wat de capaciteit vergroot.
PostgreSQL vertrouwt primair op verticale schaalvergroting om capaciteit te verhogen. In tegenstelling tot andere populaire SQL-databases laat PostgreSQL echter ook horizontale schaalvergroting via partitionering toe, al vereist dat complexe configuraties. Je kunt alle technische details van partitionering in PostgreSQL leren in onze cursus Improving Query Performance in PostgreSQL.
Daarentegen is in NoSQL-systemen zoals MongoDB horizontale schaalvergroting de standaardstrategie om groeiend dataverkeer en -volume aan te kunnen. MongoDB is ontworpen om sharding te benutten, een techniek waarbij een database wordt opgesplitst in kleinere, beter beheersbare stukken, “shards”, die over meerdere servers worden verdeeld, waardoor het systeem grote datasets en hoge verkeersvolumes kan verwerken.
Lees ons artikel Sharding vs Partitioning om alles te weten over deze populaire schaaltechnieken.
MongoDB vs PostgreSQL: use-caseanalyse
Nu we de belangrijkste functies en sterke punten van PostgreSQL en MongoDB kennen, is het tijd om de scenario’s te bekijken waarin ze het nuttigst zijn.
Ideale PostgreSQL-scenario’s
PostgreSQL is een goede keuze wanneer je project het volgende vereist:
- Sterke consistentie: Zorgen dat alle gebruikers gelijktijdig dezelfde data zien.
- Complexe query’s: Data uit meerdere tabellen joinen om inzichten te verkrijgen.
- Geavanceerde analyses: Als je complexe berekeningen of datatransformaties binnen de database moet uitvoeren, is de uitbreidbaarheid van PostgreSQL van onschatbare waarde.
- Schaalbaarheid: Voor projecten die aanzienlijk zullen groeien, is het vermogen van PostgreSQL om grote datasets aan te kunnen via verticale schaalvergroting of partitionering een groot voordeel.
- ACID-naleving: Betrouwbare transactieverwerking garanderen voor kritieke applicaties.
Enkele overtuigende voorbeelden waarbij PostgreSQL een goed idee is:
- Financiële transacties: Nauwkeurigheid en consistentie zijn cruciaal bij geld overmaken of betalingen verwerken.
- Voorraadbeheersystemen: Voorraadniveaus correct bijwerken is essentieel om overselling of verschillen te voorkomen.
- Orderverwerking: In e-commerce moeten bestellingen correct en consistent worden verwerkt om klanten tevreden te stellen.
Optimale MongoDB-implementaties
MongoDB werkt het best wanneer flexibele datastructuren nuttig zijn die zich dynamisch kunnen aanpassen aan nieuwe informatie en schema’s, wanneer schaalbaarheid en prestaties belangrijk zijn, en bij ongestructureerde data. Het schemaloze ontwerp van MongoDB, in combinatie met horizontale schaalvergroting, maakt het een uitstekende keuze voor use-cases zoals:
- Socialmediafeeds: Omdat veel binnenkomende data ongestructureerd en onvoorspelbaar is, is dataconsistentie minder kritiek en zijn tijdelijke inconsistenties in posts of likes acceptabel zolang het systeem responsief blijft.
- Content Delivery Networks: Content met minimale latency aan gebruikers leveren heeft prioriteit boven consistentie.
Hybride architecturen
Er kunnen use-cases zijn waarin je de sterke punten van MongoDB en PostgreSQL moet combineren om tot een allesomvattende oplossing voor diverse databehoeften te komen. Hybride architecturen die SQL- en NoSQL-databases combineren zijn mogelijk en een goed idee als je sterke consistentie in je transacties wilt combineren met een zekere flexibiliteit.
Zo kun je MongoDB gebruiken voor snelle writes in realtime-analytics, terwijl je PostgreSQL inzet voor complexe relationele bewerkingen en het opslaan van gestructureerde data. Er is echter momenteel geen manier om de functionaliteiten van beide databases te “fuseren”. Je gebruikt gewoon twee verschillende databases tegelijk, wat de complexiteit van je systeem verhoogt en een zorgvuldige analyse vereist voordat je dit implementeert.
Migratie-overwegingen
Als je van plan bent data van MongoDB naar PostgreSQL te migreren of andersom, moet je met verschillende elementen rekening houden:
Databaseschema’s
Als je migreert van MongoDB naar PostgreSQL, moet je voordat je de data migreert een tabel of meerdere tabellen met een vooraf gedefinieerd schema aanmaken, dat wil zeggen een lijst met kolommen met hun toegewezen datatypen en eventuele constraints. Als je je data naar Mongo wilt verplaatsen, moet je bepalen hoe de data in de documenten wordt opgenomen. Ondanks de flexibele aard van documenten zal enig datamodelleren essentieel zijn om de bestaande data een plek te geven.
De data die je wilt exporteren, heeft mogelijk niet het gewenste formaat. In dat geval moet je vóór de migratie een soort datapijplijn opzetten om de data naar het juiste formaat te transformeren voordat je deze in de PostgreSQL- of MongoDB-database invoegt.
Hoe je de data migreert
Er zijn verschillende manieren om een migratieproces uit te voeren. Je kunt het handmatig doen voor basisstappen van export/import, maar dat kan tijdrovend, complex en foutgevoelig zijn, zeker als de database die je wilt migreren veel data bevat. Daarom kan het kiezen van een ELT-oplossing om het werk te doen een betere optie zijn. Er zijn veel oplossingen beschikbaar, zowel voor migreren van PostgreSQL naar Mongo als andersom.
Prestatie-optimalisatie
Het overwegen van technieken om de prestaties tijdens migratie te verhogen is cruciaal, vooral bij complexe migraties. Afhankelijk van de bron en de bestemming bieden PostgreSQL en MongoDB specifieke technieken en strategieën om het proces te versnellen, waaronder connection pooling, partitionering, shard key-selectie en covered queries.
Beveiliging en compliance
Het beschermen van je database-implementatie is cruciaal om dataintegriteit, beschikbaarheid en compliance te waarborgen. Zowel MongoDB als PostgreSQL bieden diverse methoden om je databases te beveiligen. In deze sectie behandelen we enkele van de meest gebruikelijke technieken.
Authenticatiemechanismen
PostgreSQL heeft een reeks authenticatiemethoden die effectief via rollen kunnen worden beheerd. Rollen zijn entiteiten die databaseobjecten kunnen bezitten en databaseprivileges hebben. Rollen kunnen worden gebruikt voor authenticatie, toestemmingsbeheer en het definiëren van gebruikersniveaus. In PostgreSQL kan een rol functioneren als gebruiker of als een groep gebruikers.
Je kunt ook rollen aanmaken in MongoDB om ongeautoriseerde toegang te voorkomen. De rolgebaseerde controle volgt het principe van minimale privileges om beveiligingsrisico’s te beperken. MongoDB biedt verschillende authenticatiemechanismen, waarbij Salted Challenge Response Authentication Mechanism (SCRAM) de standaard is voor veilige, wachtwoordgebaseerde authenticatie.
Encryptiepraktijken
MongoDB biedt een flink aantal encryptiepraktijken om je data te beveiligen, waaronder:
- TLS/SSL-encryptie: Gebruik TLS/SSL om data tijdens transport te versleutelen en zo veilige communicatie tussen clients en de database te waarborgen.
- IP-whitelisting en VPN’s: Beperk toegang tot je MongoDB-instanties door alleen vertrouwde IP-adressen toe te staan. Gebruik voor extra beveiliging VPN’s om veilige tunnels te creëren voor toegang tot productieomgevingen.
- Encryptie at rest: Je kunt encryptie at rest inschakelen met de native ondersteuning van MongoDB in de WiredTiger-opslagengine. Dit beschermt gevoelige data die op schijf is opgeslagen.
- Client-side veldniveau-encryptie: Gebruik voor hoge beveiliging client-side veldniveau-encryptie om specifieke velden te versleutelen voordat ze naar de database worden verzonden. Dit zorgt ervoor dat zelfs databasebeheerders geen toegang hebben tot gevoelige informatie.
Ook PostgreSQL biedt encryptie op verschillende niveaus en flexibiliteit om data te beschermen tegen openbaarmaking door diefstal van de databaseserver, onbetrouwbare beheerders en onveilige netwerken. Enkele opties zijn:
- Wachtwoordencryptie: Wachtwoorden van databasegebruikers kunnen als hashes worden opgeslagen, zodat de beheerder het werkelijke wachtwoord van de gebruiker niet kan achterhalen.
- Data versleutelen over een netwerk: SSL-verbindingen versleutelen alle data die over het netwerk wordt verzonden: het wachtwoord, de query’s en de geretourneerde data.
- Encryptie van datapartities: Opslagencryptie kan worden uitgevoerd op bestandsysteemniveau of partitie-niveau.
- SSL-hostauthenticatie: Zowel de client als de server kunnen SSL-certificaten aan elkaar verstrekken.
Zowel MongoDB als PostgreSQL zijn zeer populaire tools met groeiende gebruikersgemeenschappen en bloeiende ecosystemen. Laten we ernaar kijken.
Uitbreidingsmogelijkheden
PostgreSQL-extensies in PostgreSQL zijn add-onmodules die de mogelijkheden van de database uitbreiden. Ze zijn vergelijkbaar met packages in Python of R. De afgelopen jaren is er een rijk ecosysteem van extensies ontstaan om het potentieel van PostgreSQL te vergroten in allerlei scenario’s, disciplines en use-cases. De meeste zijn te vinden op het PostgreSQL Extension Network.
Daarentegen beschikt MongoDB over een beperkter aantal extensies en richt het zich vooral op het mogelijk maken van het gebruik van MongoDB met andere technologieën en frameworks, zoals IDE’s als Visual Studio Code en clouds zoals Google Cloud. Wel kunnen er andere pakketten van derden beschikbaar zijn voor de verschillende programmeertalen die je doorgaans gebruikt om MongoDB te beheren.
Adoptietrends
Zowel PostgreSQL als MongoDB beleven gouden tijden, zoals te zien is in de volgende afbeelding met trends van database-engines, gebaseerd op gegevens van DB-Engines.
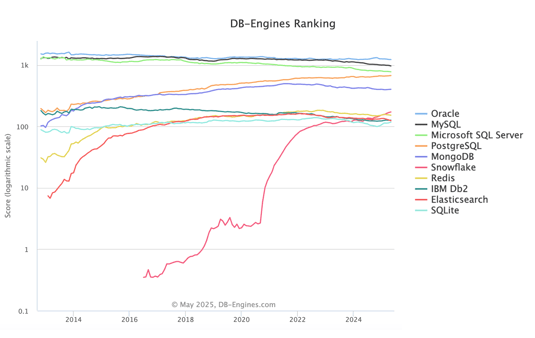
Bron: db-engines
Hoewel relationele databasemanagementsystemen nog steeds dominant zijn (waaronder PostgreSQL, dat 4e staat), laat de grafiek ook een opvallende verschuiving in recente jaren zien: NoSQL-databases zoals MongoDB en Redis kennen een sterke groei. Deze opwaartse trend weerspiegelt de toenemende adoptie van deze flexibele en schaalbare oplossingen voor het beheren van ongestructureerde data en het ondersteunen van applicaties met veel verkeer.
PostgreSQL vs MongoDB: vergelijkingstabel
Hier is een handige tabel die de verschillen tussen MongoDB- en PostgreSQL-databases samenvat:
|
Functie
|
MongoDB
|
PostgreSQL
|
|
Datastructuur
|
Slaat data op als documenten (bijv. JSON, BSON), wat flexibele, hiërarchische structuren mogelijk maakt.
|
Slaat data op in tabellen met rijen en kolommen, volgens een vooraf gedefinieerd schema.
|
|
Schemaflexibiliteit
|
Schemaloos: documenten kunnen verschillende structuren hebben, met uiteenlopende velden en datatypen.
|
Vast schema: vereist een vooraf gedefinieerd schema met specifieke kolommen en datatypen.
|
|
Querytaal
|
Gebruikt MongoDB Query Language (MQL) of vergelijkbaar, objectgebaseerd en flexibeler.
|
Gebruikt SQL (Structured Query Language) voor het bevragen van gestructureerde data.
|
|
Joins
|
Vermijdt joins door gerelateerde data in documenten in te bedden (denormalisatie).
|
Ondersteunt complexe joins tussen tabellen (normalisatie).
|
|
Prestaties
|
Snellere reads en writes voor on- of semigestructureerde data. Vermijdt overhead van joins.
|
Sterke prestaties voor gestructureerde data, maar joins kunnen query’s vertragen.
|
|
Schaalbaarheid
|
Horizontaal schaalbaar: kan data over meerdere servers verdelen via sharding.
|
Meestal verticaal schaalbaar: vertrouwt op krachtigere hardware, al is horizontaal schalen soms mogelijk (bijv. met partities).
|
|
Transactieondersteuning
|
Ondersteunt multi-document ACID-transacties (vanaf MongoDB 4.0 en hoger), maar is oorspronkelijk ontworpen voor niet-transactionele operaties.
|
Volledige ondersteuning voor ACID-conforme transacties, met sterke consistentie en betrouwbaarheid.
|
|
Use-cases
|
Best voor on- of semigestructureerde data zoals gebruikersprofielen, logs, catalogi en flexibele datastructuren.
|
Ideaal voor gestructureerde data met duidelijke relaties, zoals financiële gegevens of ERP.
|
|
Datarelaties
|
Ondersteunt ingesloten data (denormalisatie), waardoor gerelateerde informatie met één query is op te halen.
|
Relationele databases vertrouwen op foreign keys om relaties tussen tabellen te leggen (normalisatie).
|
|
Indexering
|
Ondersteunt indexering maar mist de variatie en verfijning van indexering in relationele databases.
|
Sterke indexeringsmogelijkheden met meerdere indextypen (bijv. B-tree, hash) voor betere prestatie-optimalisatie.
|
|
Consistentie
|
Biedt uiteindelijke consistentie in gedistribueerde opstellingen, maar ook sterke consistentie wanneer nodig (via ACID-transacties).
|
Waarborgt in de meeste gevallen sterke consistentie dankzij ACID-transacties en relationele integriteit.
|
|
Schalen van datavolume
|
Schaalt eenvoudig door meer servers toe te voegen (sharding) om grote hoeveelheden data te verwerken.
|
Kan verticaal schalen, maar horizontaal schalen vereist complexere configuratie (bijv. partitionering).
|
|
Dataintegriteit
|
Dataintegriteit wordt per document beheerd, maar relaties tussen documenten beheren is uitdagender.
|
Sterke ingebouwde ondersteuning voor dataintegriteit via primary en foreign keys en constraints zoals UNIQUE en NOT NULL.
|
|
Ontwikkelaarsvriendelijkheid
|
Ontwikkelaarsvriendelijk: flexibel datamodel, werkt goed met moderne applicaties (bijv. JSON, REST API’s).
|
Rigide datamodel maar goed begrepen door ontwikkelaars die bekend zijn met SQL en gestructureerde data.
|
Conclusie
MongoDB en PostgreSQL behoren tot de populairste databases. Het zijn sterke voorbeelden van respectievelijk NoSQL- en SQL-databases, en door ze te vergelijken kunnen we de verschillen, sterke punten en uiteenlopende use-cases waarin deze databases nuttig zijn, verduidelijken.
Er valt veel te leren over SQL- en NoSQL-databases. Bij DataCamp willen we je helpen met de meest volledige en up-to-date cursussen en tutorials. Bekijk hier een selectie van ons materiaal over databases:




Als je van plan bent een nieuwe digitale applicatie te starten, zul je waarschijnlijk gegevens moeten verzamelen en opslaan. Waar en hoe je die data opslaat, is een van de belangrijkste beslissingen die je moet nemen, want de hele software zal op die data steunen om te werken.
Traditioneel werden gegevens opgeslagen in tabellen met rijen en kolommen die via bepaalde relaties (d.w.z. gemeenschappelijke kolommen) met elkaar verbonden zijn. Databases die relationele data opslaan, heten relationele databases, of SQL-databases, omdat de meeste, zo niet allemaal, op SQL vertrouwen voor allerlei bewerkingen.
In de afgelopen decennia zijn er echter nieuwe databasemanagementsystemen ontwikkeld om de snelle toename in volume en verscheidenheid aan data die elke seconde wordt gecreëerd, het hoofd te bieden. De zogeheten NoSQL-databases (Not only SQL) stellen nieuwe schema’s en strategieën voor om data effectief te verzamelen op basis van specifieke use-cases, terwijl ze tot op zekere hoogte nog steeds op SQL steunen.
In dit artikel analyseren we twee populaire databasemanagementsystemen: PostgreSQL vs MongoDB. De eerste is een van de populairste SQL-databases, terwijl de tweede de bekendste NoSQL-database is.
We behandelen de belangrijkste functies en sterke punten van beide databases, hun meest aansprekende use-cases en zaken om te onthouden als je overweegt je data naar een van deze databases te migreren.
Wil je meteen praktisch aan de slag en elke methode uitproberen? Bekijk dan zeker onze cursussen Creating PostgreSQL Databases en Introduction to MongoDB in Python.
TL;DR: PostgreSQL vs MongoDB
De juiste database kiezen is cruciaal voor elke digitale applicatie. PostgreSQL, een krachtige relationele database op basis van SQL, blinkt uit bij gestructureerde data die consistentie, complexe joins en ACID-transacties vereist. MongoDB, een flexibele NoSQL documentdatabase die BSON gebruikt, is ideaal voor dynamische, ongestructureerde data en biedt grotere schaalbaarheid via horizontale sharding. De keuze tussen PostgreSQL en MongoDB hangt uiteindelijk af van de datastructuur van je project, je schaalbaarheidsbehoeften en je consistentie-eisen.
PostgreSQL vs MongoDB: datamodelarchitecturen
Laten we de belangrijkste verschillen tussen PostgreSQL en MongoDB analyseren qua datamodelarchitectuur.
Relationele vs documentgebaseerde structuren
Relationele databasemanagementsystemen, zoals PostgreSQL, organiseren data in tabellen, waarbij elke tabel uit rijen en kolommen bestaat. Deze tabellen kunnen via sleutels worden gekoppeld, waardoor complexe gegevensrelaties mogelijk zijn via SQL-joins en efficiënte query’s.
Relationele database. Bron: DataCamp
Dankzij hun eenvoud, unieke efficiëntie en sterke consistentie zijn relationele databases de afgelopen decennia enorm succesvol en breed omarmd.
Toch zijn ze mogelijk niet de beste optie wanneer je werkt met ongestructureerde data die niet netjes in een tabelvorm past (bijv. socialmediaberichten, sensordata) of wanneer schaalbaarheid een must is; dus wanneer je applicatie horizontaal over meerdere servers moet schalen.
Hier komen NoSQL-databases in beeld. In tegenstelling tot hun relationele tegenhangers kunnen NoSQL-databases ongestructureerde of semi-gestructureerde data verwerken zonder de beperkingen van een vast schema.
Specifiek is MongoDB een zogeheten documentdatabase, een type NoSQL-database die data opslaat in collecties van JSON-achtige documenten met een formaat genaamd BSON (Binary JSON). Simpel gezegd lijken documenten op JSON key-value-objecten, met extra mogelijkheden voor opslag en bewerking dankzij BSON.
Hoe MongoDB data als BSON opslaat. Bron: DataCamp
De flexibele aard van BSON maakt het mogelijk om dynamische documentschema’s te creëren waarvan de structuur en data on the fly kunnen variëren. In de volgende subsectie gaan we hier dieper op in.
Schema-evolutiepatronen
Relationele databases zoals PostgreSQL bieden robuuste schema’s die lastig te wijzigen zijn zodra je je tabellen hebt aangemaakt. Dat is een groot voordeel als de data waarmee je werkt een tabelvorm heeft en altijd in hetzelfde formaat in je applicatie binnenkomt. Maar als je te maken hebt met semi-gestructureerde of ongestructureerde data waarvan de inhoud per datapunt kan verschillen, zoals socialmediaberichten of sensordata, heb je een zekere flexibiliteit nodig om je data te verwerken.
In tegenstelling tot PostgreSQL werkt MongoDB met zogeheten schemaloze ontwerpen, die uitzonderlijke flexibiliteit bieden voor het verwerken van diverse en evoluerende data. Het schemaloze ontwerp van MongoDB organiseert data in documenten en collecties:
In tegenstelling tot traditionele relationele databases, waar het toevoegen van een nieuw veld vereist dat je de hele tabelstructuur wijzigt, laat MongoDB toe dat documenten binnen dezelfde collectie volledig verschillende velden en structuren hebben. Dit maakt rigide schema’s overbodig en vereenvoudigt het opslaan van uiteenlopende data zonder uniformiteit te forceren.
PostgreSQL vs MongoDB: querytalen
Welke database je ook gebruikt, PostgreSQL of MongoDB, je moet de taal leren om met je databases te communiceren en ze te beheren. In PostgreSQL is dat SQL, een enorm populaire, gestandaardiseerde en gebruiksvriendelijke programmeertaal. Je kunt aan de slag met SQL in onze cursus Introduction to SQL.
Daarentegen vertrouwt MongoDB primair op de eigen MongoDB Query Language (MQL) voor interactie met de database. Het is echter ook mogelijk om andere populaire programmeertalen, zoals Python, C en Java, te gebruiken om verbinding te maken met en te communiceren met MongoDB-databases.
Laten we de belangrijkste verschillen tussen SQL en MQL bekijken.
SQL- vs MQL-mogelijkheden
Een van de grootste voordelen van PostgreSQL ten opzichte van MongoDB is het gebruik van SQL. SQL (staat voor “Structured Query Language”) is een essentiële taal voor het bouwen en onderhouden van relationele databases.
Het is een eenvoudige, domeinspecifieke programmeertaal die door bijna alle relationele databasesystemen wordt gebruikt, zoals MySQL, SQL Server, SQLite en natuurlijk PostgreSQL.
SQL is extreem krachtig en laat je allerlei databewerkingen uitvoeren, van dataopvraging en -aggregatie tot opschonen en join-operaties. In PostgreSQL zijn de mogelijkheden zelfs nog groter, omdat PostgreSQL beschikt over een reeks geavanceerde functies voor complexe analyses, waaronder:
Daartegenover staat dat, hoewel MongoDB niet op SQL steunt, het krachtige query-, indexerings- en aggregatiemogelijkheden heeft, evenals andere functies om informatie in documentdatabases in te voegen, bij te werken of te verwijderen. Als je bekend bent met JSON of Python-dictionaries, zal het niet lang duren voor je de MQL-syntaxis onder de knie hebt.
MQL is speciaal ontworpen om het dynamische karakter van documenten te verwerken. Daardoor is het een veel flexibelere taal dan SQL. En omdat documenten andere documenten kunnen insluiten, is er in MongoDB geen noodzaak voor complexe en inefficiënte join-operaties, wat in relationele databases vaak wel het geval is.
Indexeringsstrategieën
Indexen zijn databaseobjecten die de snelheid van data-opvragingen verbeteren. Ze fungeren als verwijzingen om rijen in een tabel snel te lokaliseren en verhogen zo de prestaties van query’s.
PostgreSQL heeft sterke indexeringsmogelijkheden en ondersteunt meerdere indextypen, waaronder:
MongoDB ondersteunt ook indexering om documenten in collecties te vinden zonder alle documenten te hoeven scannen. De mogelijkheden zijn echter beperkter en missen de variëteit en verfijning die beschikbaar is in relationele databases zoals PostgreSQL. Dit omvat:
Indexen gebruiken in je SQL- en NoSQL-databases is essentieel om de prestaties te verhogen en querytijden te verkorten, vooral bij grote datasets.
Onthoud echter dat het toevoegen van een index ook een negatief prestatie-effect kan hebben voor schrijfbewerkingen. Voor tabellen of collecties met een hoge write-to-read-verhouding zijn indexen kostbaar, omdat bij elke insert ook alle relevante indexen moeten worden bijgewerkt.
Prestaties en schaalbaarheid in MongoDB vs PostgreSQL
MongoDB en PostgreSQL zijn geweldige databasetools, maar het heeft weinig zin om de een boven de ander te kiezen op basis van hun eigenschappen alleen. Je keuze moet je altijd maken met de bijzonderheden van je use-case in gedachten. Laten we, met dit in het achterhoofd, de verschillen in prestaties en schaalbaarheid van MongoDB en PostgreSQL analyseren.
Transactieverwerking
Zoals andere populaire relationele databasesystemen waarborgt PostgreSQL een hoge mate van dataintegriteit en -kwaliteit via het robuuste typesysteem en de ondersteuning voor ACID-transacties (Atomicity, Consistency, Isolation, Durability).
ACID-transacties zijn een set eigenschappen die de betrouwbare verwerking van databasetransacties garanderen. Ze zorgen ervoor dat data nauwkeurig en veilig blijft, zelfs bij fouten, crashes of gelijktijdige toegang. Deze eigenschappen zijn cruciaal voor het handhaven van datakwaliteit in elk project.
Hoewel ACID-transacties lange tijd de gouden standaard zijn geweest voor het waarborgen van dataintegriteit in relationele databases, geven NoSQL-databases zoals MongoDB vaak voorrang aan flexibiliteit en schaalbaarheid boven strikte transactionele consistentie. Dit leidt tot het versoepelen van sommige ACID-eigenschappen die in relationele databases te vinden zijn.
Zo geven sommige MongoDB-implementaties prioriteit aan uiteindelijke consistentie boven onmiddellijke consistentie, wat betekent dat wijzigingen niet meteen op alle nodes zichtbaar zijn. De afwegingen op het vlak van consistentie, beschikbaarheid en prestaties zorgen voor betere performance en schaalbaarheid, maar vereisen zorgvuldige overweging bij het ontwerpen van applicaties die op strikte dataconsistentie steunen.
Schaalbaarheidspatronen
Schalen omvat het gebruik van verschillende technieken om toenames in datavolume en verkeer op te vangen. Simpel gesteld kan dat via verticale en horizontale schaalvergroting. De eerste houdt in dat je dezelfde server verbetert en meer resources toevoegt om de hogere belasting aan te kunnen. De tweede bereik je door extra servers of nodes toe te voegen aan een gedistribueerd systeem, wat de capaciteit vergroot.
PostgreSQL vertrouwt primair op verticale schaalvergroting om capaciteit te verhogen. In tegenstelling tot andere populaire SQL-databases laat PostgreSQL echter ook horizontale schaalvergroting via partitionering toe, al vereist dat complexe configuraties. Je kunt alle technische details van partitionering in PostgreSQL leren in onze cursus Improving Query Performance in PostgreSQL.
Daarentegen is in NoSQL-systemen zoals MongoDB horizontale schaalvergroting de standaardstrategie om groeiend dataverkeer en -volume aan te kunnen. MongoDB is ontworpen om sharding te benutten, een techniek waarbij een database wordt opgesplitst in kleinere, beter beheersbare stukken, “shards”, die over meerdere servers worden verdeeld, waardoor het systeem grote datasets en hoge verkeersvolumes kan verwerken.
Lees ons artikel Sharding vs Partitioning om alles te weten over deze populaire schaaltechnieken.
MongoDB vs PostgreSQL: use-caseanalyse
Nu we de belangrijkste functies en sterke punten van PostgreSQL en MongoDB kennen, is het tijd om de scenario’s te bekijken waarin ze het nuttigst zijn.
Ideale PostgreSQL-scenario’s
PostgreSQL is een goede keuze wanneer je project het volgende vereist:
Enkele overtuigende voorbeelden waarbij PostgreSQL een goed idee is:
Optimale MongoDB-implementaties
MongoDB werkt het best wanneer flexibele datastructuren nuttig zijn die zich dynamisch kunnen aanpassen aan nieuwe informatie en schema’s, wanneer schaalbaarheid en prestaties belangrijk zijn, en bij ongestructureerde data. Het schemaloze ontwerp van MongoDB, in combinatie met horizontale schaalvergroting, maakt het een uitstekende keuze voor use-cases zoals:
Hybride architecturen
Er kunnen use-cases zijn waarin je de sterke punten van MongoDB en PostgreSQL moet combineren om tot een allesomvattende oplossing voor diverse databehoeften te komen. Hybride architecturen die SQL- en NoSQL-databases combineren zijn mogelijk en een goed idee als je sterke consistentie in je transacties wilt combineren met een zekere flexibiliteit.
Zo kun je MongoDB gebruiken voor snelle writes in realtime-analytics, terwijl je PostgreSQL inzet voor complexe relationele bewerkingen en het opslaan van gestructureerde data. Er is echter momenteel geen manier om de functionaliteiten van beide databases te “fuseren”. Je gebruikt gewoon twee verschillende databases tegelijk, wat de complexiteit van je systeem verhoogt en een zorgvuldige analyse vereist voordat je dit implementeert.
Migratie-overwegingen
Als je van plan bent data van MongoDB naar PostgreSQL te migreren of andersom, moet je met verschillende elementen rekening houden:
Databaseschema’s
Als je migreert van MongoDB naar PostgreSQL, moet je voordat je de data migreert een tabel of meerdere tabellen met een vooraf gedefinieerd schema aanmaken, dat wil zeggen een lijst met kolommen met hun toegewezen datatypen en eventuele constraints. Als je je data naar Mongo wilt verplaatsen, moet je bepalen hoe de data in de documenten wordt opgenomen. Ondanks de flexibele aard van documenten zal enig datamodelleren essentieel zijn om de bestaande data een plek te geven.
Mogelijke datatransformaties
De data die je wilt exporteren, heeft mogelijk niet het gewenste formaat. In dat geval moet je vóór de migratie een soort datapijplijn opzetten om de data naar het juiste formaat te transformeren voordat je deze in de PostgreSQL- of MongoDB-database invoegt.
Hoe je de data migreert
Er zijn verschillende manieren om een migratieproces uit te voeren. Je kunt het handmatig doen voor basisstappen van export/import, maar dat kan tijdrovend, complex en foutgevoelig zijn, zeker als de database die je wilt migreren veel data bevat. Daarom kan het kiezen van een ELT-oplossing om het werk te doen een betere optie zijn. Er zijn veel oplossingen beschikbaar, zowel voor migreren van PostgreSQL naar Mongo als andersom.
Prestatie-optimalisatie
Het overwegen van technieken om de prestaties tijdens migratie te verhogen is cruciaal, vooral bij complexe migraties. Afhankelijk van de bron en de bestemming bieden PostgreSQL en MongoDB specifieke technieken en strategieën om het proces te versnellen, waaronder connection pooling, partitionering, shard key-selectie en covered queries.
Beveiliging en compliance
Het beschermen van je database-implementatie is cruciaal om dataintegriteit, beschikbaarheid en compliance te waarborgen. Zowel MongoDB als PostgreSQL bieden diverse methoden om je databases te beveiligen. In deze sectie behandelen we enkele van de meest gebruikelijke technieken.
Authenticatiemechanismen
PostgreSQL heeft een reeks authenticatiemethoden die effectief via rollen kunnen worden beheerd. Rollen zijn entiteiten die databaseobjecten kunnen bezitten en databaseprivileges hebben. Rollen kunnen worden gebruikt voor authenticatie, toestemmingsbeheer en het definiëren van gebruikersniveaus. In PostgreSQL kan een rol functioneren als gebruiker of als een groep gebruikers.
Je kunt ook rollen aanmaken in MongoDB om ongeautoriseerde toegang te voorkomen. De rolgebaseerde controle volgt het principe van minimale privileges om beveiligingsrisico’s te beperken. MongoDB biedt verschillende authenticatiemechanismen, waarbij Salted Challenge Response Authentication Mechanism (SCRAM) de standaard is voor veilige, wachtwoordgebaseerde authenticatie.
Encryptiepraktijken
MongoDB biedt een flink aantal encryptiepraktijken om je data te beveiligen, waaronder:
Ook PostgreSQL biedt encryptie op verschillende niveaus en flexibiliteit om data te beschermen tegen openbaarmaking door diefstal van de databaseserver, onbetrouwbare beheerders en onveilige netwerken. Enkele opties zijn:
Community en ecosysteem
Zowel MongoDB als PostgreSQL zijn zeer populaire tools met groeiende gebruikersgemeenschappen en bloeiende ecosystemen. Laten we ernaar kijken.
Uitbreidingsmogelijkheden
PostgreSQL-extensies in PostgreSQL zijn add-onmodules die de mogelijkheden van de database uitbreiden. Ze zijn vergelijkbaar met packages in Python of R. De afgelopen jaren is er een rijk ecosysteem van extensies ontstaan om het potentieel van PostgreSQL te vergroten in allerlei scenario’s, disciplines en use-cases. De meeste zijn te vinden op het PostgreSQL Extension Network.
Daarentegen beschikt MongoDB over een beperkter aantal extensies en richt het zich vooral op het mogelijk maken van het gebruik van MongoDB met andere technologieën en frameworks, zoals IDE’s als Visual Studio Code en clouds zoals Google Cloud. Wel kunnen er andere pakketten van derden beschikbaar zijn voor de verschillende programmeertalen die je doorgaans gebruikt om MongoDB te beheren.
Adoptietrends
Zowel PostgreSQL als MongoDB beleven gouden tijden, zoals te zien is in de volgende afbeelding met trends van database-engines, gebaseerd op gegevens van DB-Engines.
Bron: db-engines
Hoewel relationele databasemanagementsystemen nog steeds dominant zijn (waaronder PostgreSQL, dat 4e staat), laat de grafiek ook een opvallende verschuiving in recente jaren zien: NoSQL-databases zoals MongoDB en Redis kennen een sterke groei. Deze opwaartse trend weerspiegelt de toenemende adoptie van deze flexibele en schaalbare oplossingen voor het beheren van ongestructureerde data en het ondersteunen van applicaties met veel verkeer.
PostgreSQL vs MongoDB: vergelijkingstabel
Hier is een handige tabel die de verschillen tussen MongoDB- en PostgreSQL-databases samenvat:
Functie
MongoDB
PostgreSQL
Datastructuur
Slaat data op als documenten (bijv. JSON, BSON), wat flexibele, hiërarchische structuren mogelijk maakt.
Slaat data op in tabellen met rijen en kolommen, volgens een vooraf gedefinieerd schema.
Schemaflexibiliteit
Schemaloos: documenten kunnen verschillende structuren hebben, met uiteenlopende velden en datatypen.
Vast schema: vereist een vooraf gedefinieerd schema met specifieke kolommen en datatypen.
Querytaal
Gebruikt MongoDB Query Language (MQL) of vergelijkbaar, objectgebaseerd en flexibeler.
Gebruikt SQL (Structured Query Language) voor het bevragen van gestructureerde data.
Joins
Vermijdt joins door gerelateerde data in documenten in te bedden (denormalisatie).
Ondersteunt complexe joins tussen tabellen (normalisatie).
Prestaties
Snellere reads en writes voor on- of semigestructureerde data. Vermijdt overhead van joins.
Sterke prestaties voor gestructureerde data, maar joins kunnen query’s vertragen.
Schaalbaarheid
Horizontaal schaalbaar: kan data over meerdere servers verdelen via sharding.
Meestal verticaal schaalbaar: vertrouwt op krachtigere hardware, al is horizontaal schalen soms mogelijk (bijv. met partities).
Transactieondersteuning
Ondersteunt multi-document ACID-transacties (vanaf MongoDB 4.0 en hoger), maar is oorspronkelijk ontworpen voor niet-transactionele operaties.
Volledige ondersteuning voor ACID-conforme transacties, met sterke consistentie en betrouwbaarheid.
Use-cases
Best voor on- of semigestructureerde data zoals gebruikersprofielen, logs, catalogi en flexibele datastructuren.
Ideaal voor gestructureerde data met duidelijke relaties, zoals financiële gegevens of ERP.
Datarelaties
Ondersteunt ingesloten data (denormalisatie), waardoor gerelateerde informatie met één query is op te halen.
Relationele databases vertrouwen op foreign keys om relaties tussen tabellen te leggen (normalisatie).
Indexering
Ondersteunt indexering maar mist de variatie en verfijning van indexering in relationele databases.
Sterke indexeringsmogelijkheden met meerdere indextypen (bijv. B-tree, hash) voor betere prestatie-optimalisatie.
Consistentie
Biedt uiteindelijke consistentie in gedistribueerde opstellingen, maar ook sterke consistentie wanneer nodig (via ACID-transacties).
Waarborgt in de meeste gevallen sterke consistentie dankzij ACID-transacties en relationele integriteit.
Schalen van datavolume
Schaalt eenvoudig door meer servers toe te voegen (sharding) om grote hoeveelheden data te verwerken.
Kan verticaal schalen, maar horizontaal schalen vereist complexere configuratie (bijv. partitionering).
Dataintegriteit
Dataintegriteit wordt per document beheerd, maar relaties tussen documenten beheren is uitdagender.
Sterke ingebouwde ondersteuning voor dataintegriteit via primary en foreign keys en constraints zoals UNIQUE en NOT NULL.
Ontwikkelaarsvriendelijkheid
Ontwikkelaarsvriendelijk: flexibel datamodel, werkt goed met moderne applicaties (bijv. JSON, REST API’s).
Rigide datamodel maar goed begrepen door ontwikkelaars die bekend zijn met SQL en gestructureerde data.
Conclusie
MongoDB en PostgreSQL behoren tot de populairste databases. Het zijn sterke voorbeelden van respectievelijk NoSQL- en SQL-databases, en door ze te vergelijken kunnen we de verschillen, sterke punten en uiteenlopende use-cases waarin deze databases nuttig zijn, verduidelijken.
Er valt veel te leren over SQL- en NoSQL-databases. Bij DataCamp willen we je helpen met de meest volledige en up-to-date cursussen en tutorials. Bekijk hier een selectie van ons materiaal over databases: