Nếu bạn đang lên kế hoạch bắt đầu một ứng dụng số mới, rất có thể bạn sẽ cần thu thập và lưu trữ một số dữ liệu. Lưu trữ dữ liệu ở đâu và như thế nào là một trong những quyết định quan trọng nhất bạn phải đưa ra, vì toàn bộ phần mềm sẽ phụ thuộc vào dữ liệu đó để hoạt động.
Truyền thống, dữ liệu được lưu trong các bảng với các hàng và cột được liên kết thông qua một số mối quan hệ nhất định (tức là các cột chung). Các cơ sở dữ liệu lưu trữ dữ liệu quan hệ được gọi là cơ sở dữ liệu quan hệ, hay cơ sở dữ liệu SQL, vì hầu hết, nếu không muốn nói là tất cả, đều dựa vào SQL cho mọi loại thao tác.
Tuy nhiên, trong vài thập kỷ gần đây, các hệ quản trị cơ sở dữ liệu mới đã phát triển để đáp ứng sự gia tăng nhanh chóng về khối lượng và tính đa dạng của dữ liệu được tạo ra mỗi giây. Các cơ sở dữ liệu NoSQL (Not only SQL) đề xuất các lược đồ và chiến lược mới để thu thập dữ liệu hiệu quả dựa trên các trường hợp sử dụng cụ thể, đồng thời vẫn dựa một phần vào SQL.
Trong bài viết này, chúng ta sẽ phân tích hai hệ quản trị cơ sở dữ liệu phổ biến: PostgreSQL và MongoDB. Cái đầu là một trong những cơ sở dữ liệu SQL phổ biến nhất, còn cái sau là cơ sở dữ liệu NoSQL nổi tiếng nhất.
Chúng tôi sẽ đề cập đến các tính năng và điểm mạnh chính của cả hai cơ sở dữ liệu, các trường hợp sử dụng thuyết phục nhất của chúng, và những điều nên ghi nhớ nếu bạn đang cân nhắc chuyển dữ liệu sang một trong hai cơ sở dữ liệu này.
Nếu bạn muốn trực tiếp thực hành và thử từng phương pháp, hãy xem các khóa học của chúng tôi, Tạo cơ sở dữ liệu PostgreSQL và Nhập môn MongoDB với Python.
TL;DR: PostgreSQL và MongoDB
Việc chọn cơ sở dữ liệu phù hợp rất quan trọng với bất kỳ ứng dụng số nào. PostgreSQL, một cơ sở dữ liệu quan hệ mạnh mẽ dựa trên SQL, vượt trội trong các kịch bản dữ liệu có cấu trúc đòi hỏi tính nhất quán, join phức tạp và giao dịch ACID. MongoDB, một cơ sở dữ liệu tài liệu NoSQL linh hoạt sử dụng BSON, lý tưởng để xử lý dữ liệu động, phi cấu trúc, cung cấp khả năng mở rộng lớn hơn thông qua sharding theo chiều ngang. Việc chọn giữa PostgreSQL và MongoDB cuối cùng phụ thuộc vào cấu trúc dữ liệu, nhu cầu mở rộng và yêu cầu nhất quán của dự án của bạn.
Kiến trúc mô hình dữ liệu của PostgreSQL và MongoDB
Hãy phân tích những khác biệt chính giữa PostgreSQL và MongoDB về kiến trúc mô hình dữ liệu.
Cấu trúc quan hệ so với cấu trúc dựa trên tài liệu
Hệ quản trị cơ sở dữ liệu quan hệ như PostgreSQL tổ chức dữ liệu thành các bảng, trong đó mỗi bảng gồm các hàng và cột. Các bảng này có thể được liên kết thông qua khóa, cho phép các mối quan hệ dữ liệu phức tạp thông qua SQL join và truy vấn hiệu quả.
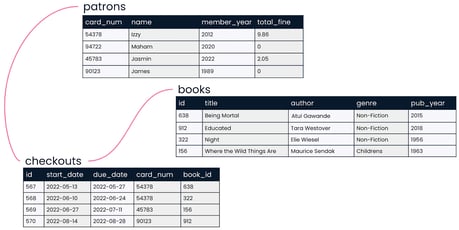
Cơ sở dữ liệu quan hệ. Nguồn: DataCamp
Nhờ sự đơn giản, hiệu quả riêng có và tính nhất quán mạnh mẽ, cơ sở dữ liệu quan hệ đã vô cùng thành công và được áp dụng rộng rãi trong nhiều thập kỷ qua.
Tuy nhiên, chúng có thể không phải là lựa chọn tốt nhất khi bạn làm việc với dữ liệu phi cấu trúc không phù hợp gọn gàng với định dạng dạng bảng (ví dụ: bài đăng mạng xã hội, dữ liệu cảm biến) hoặc khi khả năng mở rộng là điều bắt buộc; tức là khi ứng dụng của bạn cần mở rộng theo chiều ngang trên nhiều máy chủ.
Đây là lúc cơ sở dữ liệu NoSQL xuất hiện. Không giống như các đối tác quan hệ, cơ sở dữ liệu NoSQL có thể xử lý dữ liệu phi cấu trúc hoặc bán cấu trúc mà không bị ràng buộc bởi một lược đồ cố định.
Cụ thể, MongoDB là cơ sở dữ liệu tài liệu, một loại cơ sở dữ liệu NoSQL lưu trữ dữ liệu trong các bộ sưu tập (collection) các tài liệu giống JSON bằng định dạng gọi là BSON (Binary JSON). Nói đơn giản, tài liệu tương tự như các đối tượng key-value của JSON, với các khả năng bổ sung để lưu trữ và thao tác dữ liệu do BSON cung cấp.
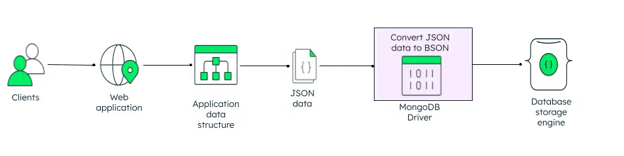
Cách MongoDB lưu dữ liệu dưới dạng BSON. Nguồn: DataCamp
Tính linh hoạt của BSON cho phép tạo ra các lược đồ tài liệu động, trong đó cấu trúc và dữ liệu có thể thay đổi tức thời. Chúng ta sẽ thấy rõ hơn ở tiểu mục tiếp theo.
Mẫu tiến hóa lược đồ
Cơ sở dữ liệu quan hệ như PostgreSQL cung cấp các lược đồ mạnh mẽ, khó thay đổi khi bạn đã tạo bảng. Đây là một tính năng tuyệt vời nếu dữ liệu bạn làm việc có bản chất dạng bảng và luôn đi vào ứng dụng của bạn với cùng một định dạng. Tuy nhiên, nếu bạn xử lý dữ liệu bán cấu trúc hoặc phi cấu trúc có nội dung có thể thay đổi giữa các phần dữ liệu, như bài đăng mạng xã hội hoặc dữ liệu cảm biến, bạn có thể cần một mức độ linh hoạt nhất định để tiếp nhận dữ liệu.
Trái ngược với PostgreSQL, MongoDB đi kèm với thiết kế không lược đồ (schema-less), mang lại sự linh hoạt đặc biệt để xử lý dữ liệu đa dạng và phát triển. Thiết kế không lược đồ của MongoDB tổ chức dữ liệu thành tài liệu (document) và bộ sưu tập (collection):
- Tài liệu (Document) là đơn vị dữ liệu cơ bản, bao gồm các cặp key-value BSON. Tài liệu có thể chứa chuỗi, số, ngày, mảng, và thậm chí các tài liệu lồng nhau khác. Điều này cho phép các mô hình dữ liệu tinh vi thể hiện các mối quan hệ phức tạp trong một tài liệu duy nhất, phù hợp với cách cấu trúc đối tượng trong hầu hết các ngôn ngữ lập trình.
- Bộ sưu tập (Collection) nhóm các tài liệu liên quan, tương tự như một bảng, nhưng linh hoạt hơn. Collection không ép buộc lược đồ, vì vậy các tài liệu có thể có cấu trúc và trường khác nhau. Collection tồn tại trong các cơ sở dữ liệu MongoDB, và mỗi cơ sở dữ liệu có thể chứa nhiều collection.
Không giống các cơ sở dữ liệu quan hệ truyền thống, nơi việc thêm trường mới yêu cầu thay đổi toàn bộ cấu trúc bảng, MongoDB cho phép các tài liệu trong cùng một collection có các trường và cấu trúc hoàn toàn khác nhau. Điều này loại bỏ nhu cầu về lược đồ cứng nhắc và giúp dễ dàng lưu trữ dữ liệu đa dạng mà không ép buộc tính đồng nhất.
Ngôn ngữ truy vấn: PostgreSQL và MongoDB
Bất kể bạn dùng cơ sở dữ liệu nào, PostgreSQL hay MongoDB, bạn sẽ cần học ngôn ngữ để giao tiếp và quản lý cơ sở dữ liệu. Trong PostgreSQL, đó là SQL, một ngôn ngữ lập trình cực kỳ phổ biến, tiêu chuẩn hóa và dễ sử dụng. Bạn có thể bắt đầu với SQL trong khóa Nhập môn SQL của chúng tôi.
Ngược lại, MongoDB chủ yếu dựa vào ngôn ngữ riêng là MongoDB Query Language (MQL) để tương tác với cơ sở dữ liệu. Tuy nhiên, cũng có thể dùng các ngôn ngữ lập trình phổ biến khác như Python, C và Java để kết nối và tương tác với cơ sở dữ liệu MongoDB.
Hãy phân tích những khác biệt chính giữa SQL và MQL.
Khả năng của SQL và MQL
Một trong những lợi thế lớn nhất của PostgreSQL so với MongoDB là việc sử dụng SQL. SQL (viết tắt của “Structured Query Language”) là một ngôn ngữ thiết yếu để xây dựng và duy trì cơ sở dữ liệu quan hệ.
Đây là một ngôn ngữ lập trình chuyên biệt, đơn giản, được hầu hết các hệ thống cơ sở dữ liệu quan hệ sử dụng, như MySQL, SQL Server, SQLite và tất nhiên là PostgreSQL.
SQL cực kỳ mạnh mẽ, cho phép bạn thực hiện mọi loại thao tác dữ liệu, từ truy xuất và tổng hợp dữ liệu đến làm sạch dữ liệu và các phép join. Tuy nhiên, khi nói đến PostgreSQL, khả năng còn lớn hơn, vì PostgreSQL đi kèm một tập các tính năng nâng cao cho phân tích phức tạp, bao gồm:
- Hàm và thủ tục: PostgreSQL hỗ trợ tạo hàm và stored procedure, có thể viết bằng nhiều ngôn ngữ lập trình, tăng cường khả năng xử lý các thao tác phức tạp của cơ sở dữ liệu.
- Tìm kiếm toàn văn (full-text search): PostgreSQL cung cấp khả năng tìm kiếm toàn văn mạnh mẽ, cho phép thao tác tìm kiếm hiệu quả trên dữ liệu văn bản.
- Hỗ trợ JSON: Hỗ trợ sâu rộng cho kiểu dữ liệu JSON cho phép PostgreSQL xử lý dữ liệu bán cấu trúc hiệu quả, phần nào thu hẹp khoảng cách giữa cơ sở dữ liệu quan hệ và định hướng tài liệu.
Ngược lại, dù MongoDB không dựa vào SQL, nó có khả năng truy vấn, lập chỉ mục và tổng hợp mạnh mẽ, cũng như các chức năng khác để chèn, cập nhật hoặc xóa thông tin trong cơ sở dữ liệu tài liệu. Do đó, nếu bạn quen với JSON hoặc dictionary trong Python, bạn sẽ không mất nhiều thời gian để làm quen với cú pháp MQL.
MQL được thiết kế đặc biệt để xử lý bản chất động của tài liệu. Vì vậy, nó linh hoạt hơn nhiều so với SQL. Ngoài ra, do tài liệu có thể lồng tài liệu khác bên trong, trong MongoDB không cần dùng các phép join phức tạp và kém hiệu quả, điều thường thấy ở cơ sở dữ liệu quan hệ.
Chiến lược lập chỉ mục
Chỉ mục là các đối tượng cơ sở dữ liệu giúp tăng tốc các thao tác truy xuất dữ liệu. Chúng đóng vai trò như con trỏ để nhanh chóng định vị hàng trong bảng, cải thiện hiệu năng truy vấn.
PostgreSQL có khả năng lập chỉ mục mạnh, hỗ trợ nhiều loại chỉ mục, bao gồm:
- Chỉ mục B-Tree: Loại chỉ mục mặc định và được dùng phổ biến nhất
- Chỉ mục Hash: Cho các tìm kiếm bằng so sánh bằng (equality) nhanh
- Chỉ mục GIN: Cho lập chỉ mục JSON, mảng và tìm kiếm toàn văn
- Chỉ mục GiST: Cho các kiểu dữ liệu phức tạp như hình học hoặc tìm kiếm mờ (fuzzy)
- Chỉ mục BRIN: Cho dữ liệu lớn, có thứ tự tự nhiên (như log chuỗi thời gian)
- Chỉ mục biểu thức: Chỉ mục dựa trên một hàm hoặc biểu thức
- Chỉ mục một phần (Partial): Chỉ lập chỉ mục một tập con hàng (hữu ích cho lọc)
MongoDB cũng hỗ trợ lập chỉ mục để tìm tài liệu trong collection mà không phải quét toàn bộ tài liệu. Tuy nhiên, khả năng của nó hạn chế hơn, thiếu sự đa dạng và tinh vi trong lập chỉ mục như ở các cơ sở dữ liệu quan hệ như PostgreSQL. Bao gồm:
- Chỉ mục một trường (Single field): Thu thập và sắp xếp dữ liệu từ một trường duy nhất trong mỗi tài liệu của collection.
- Chỉ mục tổng hợp (Compound): Thu thập và sắp xếp dữ liệu từ hai hoặc nhiều trường trong mỗi tài liệu của collection.
- Chỉ mục đa khóa (Multikey): Thu thập và sắp xếp dữ liệu lưu trong mảng.
- Chỉ mục văn bản (Text): Hỗ trợ truy vấn tìm kiếm văn bản trên các trường chứa chuỗi.
- Chỉ mục băm (Hashed): Hỗ trợ sharding theo giá trị băm. Chỉ mục băm lập chỉ mục theo giá trị băm của một trường.
Sử dụng chỉ mục trong cơ sở dữ liệu SQL và NoSQL là chìa khóa để tăng hiệu năng và giảm thời gian truy vấn, đặc biệt trên các tập dữ liệu lớn.
Tuy nhiên, hãy nhớ rằng thêm chỉ mục cũng có thể tác động tiêu cực đến hiệu năng ghi. Với các bảng hoặc collection có tỷ lệ ghi/đọc cao, chỉ mục trở nên tốn kém vì mỗi lần chèn cũng phải cập nhật các chỉ mục.
Hiệu năng và khả năng mở rộng trong MongoDB và PostgreSQL
MongoDB và PostgreSQL là những công cụ cơ sở dữ liệu tuyệt vời, nhưng không có ý nghĩa khi chọn cái này thay vì cái kia chỉ dựa trên thuộc tính của chúng. Thay vào đó, bạn luôn nên đưa ra lựa chọn dựa trên đặc thù trường hợp sử dụng. Với lưu ý này, hãy phân tích sự khác biệt về hiệu năng và khả năng mở rộng của MongoDB và PostgreSQL.
Xử lý giao dịch
Giống các hệ thống cơ sở dữ liệu quan hệ phổ biến khác, PostgreSQL đảm bảo mức độ toàn vẹn và chất lượng dữ liệu cao thông qua hệ thống kiểu mạnh mẽ và hỗ trợ các giao dịch ACID (Atomicity, Consistency, Isolation, Durability).
Giao dịch ACID là tập hợp các thuộc tính đảm bảo việc xử lý giao dịch cơ sở dữ liệu đáng tin cậy. Chúng đảm bảo dữ liệu vẫn chính xác và an toàn ngay cả khi xảy ra lỗi, sập hệ thống hoặc truy cập đồng thời. Những thuộc tính này rất quan trọng để duy trì chất lượng dữ liệu trong bất kỳ dự án nào.
Trong khi giao dịch ACID từ lâu là tiêu chuẩn vàng để đảm bảo tính toàn vẹn dữ liệu trong cơ sở dữ liệu quan hệ, các cơ sở dữ liệu NoSQL như MongoDB thường ưu tiên tính linh hoạt và khả năng mở rộng hơn là tính nhất quán giao dịch chặt chẽ. Điều này dẫn đến việc nới lỏng một số thuộc tính ACID có trong cơ sở dữ liệu quan hệ.
Ví dụ, một số cơ sở dữ liệu MongoDB ưu tiên tính nhất quán cuối cùng (eventual consistency) thay vì nhất quán tức thời, nghĩa là các thay đổi có thể không được phản ánh ngay lập tức trên tất cả các nút. Những đánh đổi về tính nhất quán, tính sẵn sàng và hiệu năng cho phép hiệu năng và khả năng mở rộng tốt hơn nhưng đòi hỏi cân nhắc kỹ khi thiết kế ứng dụng phụ thuộc vào tính nhất quán dữ liệu nghiêm ngặt.
Mẫu mở rộng
Mở rộng bao gồm việc sử dụng nhiều kỹ thuật để giải quyết sự gia tăng khối lượng dữ liệu và lưu lượng. Nói đơn giản, chúng ta có thể làm điều này thông qua mở rộng dọc và mở rộng ngang. Cái đầu là cải thiện và bổ sung tài nguyên cho cùng một máy chủ để xử lý tải tăng. Cái sau đạt được bằng cách thêm nhiều máy chủ hoặc nút vào hệ thống phân tán, từ đó giúp tăng năng lực.
PostgreSQL chủ yếu dựa vào mở rộng dọc để tăng năng lực. Tuy nhiên, khác với các cơ sở dữ liệu SQL phổ biến khác, PostgreSQL cũng cho phép mở rộng ngang thông qua phân vùng (partitioning), nhưng yêu cầu cấu hình phức tạp. Bạn có thể tìm hiểu mọi kỹ thuật về partitioning trong PostgreSQL tại khóa Cải thiện hiệu năng truy vấn trong PostgreSQL.
Ngược lại, trong các hệ NoSQL như MongoDB, chiến lược mặc định để xử lý lưu lượng và khối lượng dữ liệu tăng là mở rộng ngang. MongoDB được thiết kế để tận dụng sharding, một kỹ thuật chia cơ sở dữ liệu thành các phần nhỏ hơn, dễ quản lý hơn gọi là “shard” và phân phối chúng trên nhiều máy chủ, cho phép hệ thống xử lý tập dữ liệu lớn và lưu lượng cao.
Xem bài viết Sharding và Partitioning để biết mọi thứ về các kỹ thuật mở rộng phổ biến này.
MongoDB và PostgreSQL: Phân tích trường hợp sử dụng
Giờ khi đã biết các tính năng và điểm mạnh chính của PostgreSQL và MongoDB, đã đến lúc phân tích các kịch bản nơi chúng hữu ích hơn.
Kịch bản lý tưởng cho PostgreSQL
PostgreSQL là lựa chọn tuyệt vời khi dự án của bạn cần:
- Tính nhất quán mạnh: Đảm bảo mọi người dùng nhìn thấy cùng một dữ liệu đồng thời.
- Truy vấn phức tạp: Join dữ liệu từ nhiều bảng để rút ra insight.
- Phân tích nâng cao: Nếu bạn cần thực hiện tính toán phức tạp hoặc biến đổi dữ liệu ngay trong cơ sở dữ liệu, tính mở rộng của PostgreSQL là vô giá.
- Khả năng mở rộng: Với các dự án dự kiến tăng trưởng đáng kể, khả năng xử lý tập dữ liệu lớn thông qua mở rộng dọc hoặc phân vùng của PostgreSQL là lợi thế lớn.
- Tuân thủ ACID: Đảm bảo xử lý giao dịch đáng tin cậy cho các ứng dụng quan trọng.
Ví dụ thuyết phục, PostgreSQL là ý tưởng hợp lý trong:
- Giao dịch tài chính: Độ chính xác và nhất quán là then chốt khi chuyển tiền hoặc xử lý thanh toán.
- Hệ thống tồn kho: Đảm bảo mức tồn kho được cập nhật chính xác là rất quan trọng để tránh bán vượt hoặc sai lệch.
- Xử lý đơn hàng: Để làm hài lòng khách hàng thương mại điện tử, đơn hàng cần được xử lý đúng và nhất quán.
Triển khai tối ưu cho MongoDB
MongoDB hoạt động tốt nhất trong các trường hợp hữu ích khi có các cấu trúc dữ liệu linh hoạt có thể thích ứng động với thông tin và lược đồ mới, khi khả năng mở rộng và hiệu năng quan trọng, và với dữ liệu phi cấu trúc. Thiết kế không lược đồ của MongoDB, kết hợp với mở rộng ngang, khiến nó rất phù hợp cho các trường hợp như:
- Bảng tin mạng xã hội: Vì phần lớn dữ liệu đầu vào là phi cấu trúc và khó dự đoán, tính nhất quán dữ liệu ít quan trọng hơn, và những bất nhất tạm thời ở bài đăng hoặc lượt thích có thể chấp nhận được miễn là hệ thống vẫn phản hồi tốt.
- Mạng phân phối nội dung (CDN): Ưu tiên phục vụ nội dung cho người dùng với độ trễ tối thiểu hơn là tính nhất quán.
Kiến trúc lai
Có thể có các trường hợp bạn cần kết hợp thế mạnh của MongoDB và PostgreSQL để đưa ra giải pháp toàn diện cho các yêu cầu dữ liệu đa dạng. Việc tạo kiến trúc lai kết hợp cơ sở dữ liệu SQL và NoSQL là khả thi, và là ý tưởng hay nếu bạn cần kết hợp tính nhất quán mạnh cho giao dịch với một mức độ linh hoạt nào đó.
Ví dụ, bạn có thể dùng MongoDB cho ghi nhanh trong phân tích thời gian thực, trong khi dùng PostgreSQL cho các thao tác quan hệ phức tạp và lưu trữ dữ liệu có cấu trúc. Tuy nhiên, hiện không có cách nào để “hợp nhất” chức năng của cả hai cơ sở dữ liệu. Bạn sẽ chỉ dùng hai cơ sở dữ liệu khác nhau cùng lúc, điều này sẽ làm tăng độ phức tạp của hệ thống, đòi hỏi phân tích cẩn trọng trước khi triển khai.
Cân nhắc khi di chuyển dữ liệu
Nếu bạn dự định di chuyển dữ liệu từ MongoDB sang PostgreSQL hoặc ngược lại, bạn sẽ phải cân nhắc một số yếu tố:
Lược đồ cơ sở dữ liệu
Nếu bạn di chuyển từ MongoDB sang PostgreSQL, trước khi di chuyển dữ liệu, bạn sẽ phải tạo một hoặc nhiều bảng với lược đồ xác định trước, tức là danh sách các cột với kiểu dữ liệu được gán và các ràng buộc tiềm năng. Nếu bạn muốn chuyển dữ liệu sang Mongo, bạn sẽ cần xác định cách dữ liệu được đưa vào tài liệu. Dù tài liệu linh hoạt, một số mô hình hóa dữ liệu vẫn cần thiết để đặt dữ liệu hiện có.
Các biến đổi dữ liệu tiềm năng
Dữ liệu bạn muốn xuất có thể không có định dạng mong muốn. Nếu vậy, trước khi di chuyển, bạn sẽ phải thiết lập một dạng pipeline dữ liệu để biến đổi dữ liệu sang định dạng đúng trước khi chèn vào cơ sở dữ liệu PostgreSQL hoặc MongoDB.
Cách thức di chuyển dữ liệu
Có nhiều cách để thực hiện quá trình di chuyển. Bạn có thể làm thủ công cho các bước xuất/nhập cơ bản, nhưng đó có thể là quy trình tốn thời gian, phức tạp và dễ lỗi, đặc biệt nếu cơ sở dữ liệu bạn muốn di chuyển chứa nhiều dữ liệu. Đó là lý do chọn một công cụ ELT để thực hiện có thể là giải pháp tốt hơn. Có rất nhiều giải pháp có sẵn, cả cho di chuyển từ PostgreSQL sang Mongo và ngược lại.
Tối ưu hóa hiệu năng
Xem xét các kỹ thuật tăng hiệu năng trong quá trình di chuyển là rất quan trọng, đặc biệt trong các quy trình phức tạp. Tùy nguồn và đích, PostgreSQL và MongoDB cung cấp các kỹ thuật và chiến lược cụ thể để tăng tốc quá trình, bao gồm connection pooling, partitioning, chọn khóa shard và covered query.
Bảo mật và tuân thủ
Bảo vệ triển khai cơ sở dữ liệu là điều tối quan trọng để đảm bảo tính toàn vẹn, sẵn sàng và tuân thủ dữ liệu. Cả MongoDB và PostgreSQL đều cung cấp nhiều phương pháp để bảo mật cơ sở dữ liệu của bạn. Phần này đề cập đến một số kỹ thuật phổ biến nhất.
Cơ chế xác thực
PostgreSQL đi kèm nhiều phương thức xác thực, có thể quản lý hiệu quả thông qua role. Role là các thực thể có thể sở hữu đối tượng cơ sở dữ liệu và có đặc quyền. Role có thể dùng cho mục đích xác thực, quản lý quyền và xác định mức truy cập người dùng. Trong PostgreSQL, một role có thể hoạt động như người dùng hoặc như một nhóm người dùng.
Bạn cũng có thể tạo role trong MongoDB để ngăn truy cập trái phép. Kiểm soát dựa trên vai trò tuân theo nguyên tắc đặc quyền tối thiểu để giảm thiểu rủi ro bảo mật. MongoDB đi kèm nhiều cơ chế xác thực, trong đó Salted Challenge Response Authentication Mechanism (SCRAM) là cơ chế mặc định cho xác thực dựa trên mật khẩu an toàn.
Thực hành mã hóa
MongoDB cung cấp nhiều thực hành mã hóa để bảo vệ dữ liệu của bạn, bao gồm:
- Mã hóa TLS/SSL: Sử dụng TLS/SSL để mã hóa dữ liệu khi truyền, đảm bảo giao tiếp an toàn giữa client và cơ sở dữ liệu.
- Danh sách trắng IP và VPN: Hạn chế truy cập vào các instance MongoDB của bạn bằng cách chỉ cho phép địa chỉ IP tin cậy. Để tăng cường bảo mật, sử dụng VPN để tạo đường hầm an toàn truy cập cơ sở dữ liệu sản xuất.
- Mã hóa khi lưu trữ (at rest): Bạn có thể bật mã hóa khi lưu trữ bằng hỗ trợ gốc của MongoDB trong storage engine WiredTiger. Điều này bảo vệ dữ liệu nhạy cảm lưu trên đĩa.
- Mã hóa cấp trường phía client: Với yêu cầu bảo mật cao, sử dụng mã hóa cấp trường phía client để mã hóa các trường cụ thể trước khi gửi đến cơ sở dữ liệu. Điều này đảm bảo ngay cả quản trị viên cơ sở dữ liệu cũng không thể truy cập thông tin nhạy cảm.
Đối với PostgreSQL, nó cũng cung cấp mã hóa ở nhiều cấp độ và mang lại sự linh hoạt trong việc bảo vệ dữ liệu khỏi bị lộ do đánh cắp máy chủ cơ sở dữ liệu, quản trị viên thiếu trung thực và mạng không an toàn. Một số tùy chọn gồm:
- Mã hóa mật khẩu: Mật khẩu người dùng cơ sở dữ liệu có thể được lưu dưới dạng hash, vì vậy quản trị viên không thể xác định mật khẩu thực tế của người dùng.
- Mã hóa dữ liệu qua mạng: Kết nối SSL mã hóa toàn bộ dữ liệu gửi qua mạng: mật khẩu, truy vấn và dữ liệu trả về.
- Mã hóa phân vùng dữ liệu: Mã hóa lưu trữ có thể được thực hiện ở cấp độ hệ thống tệp hoặc cấp độ phân vùng.
- Xác thực máy chủ SSL: Cả client và server đều có thể cung cấp chứng chỉ SSL cho nhau.
Cộng đồng và hệ sinh thái
Cả MongoDB và PostgreSQL đều là các công cụ rất phổ biến, với cộng đồng người dùng ngày càng lớn và hệ sinh thái phát triển mạnh. Hãy cùng xem qua.
Khả năng mở rộng qua tiện ích
Extension trong PostgreSQL là các mô-đun bổ sung mở rộng khả năng của cơ sở dữ liệu. Chúng giống các gói (package) trong Python hoặc R. Trong những năm gần đây, một hệ sinh thái extension phong phú đã xuất hiện để tăng tiềm năng của PostgreSQL trong mọi kịch bản, lĩnh vực và trường hợp sử dụng. Hầu hết có thể được tìm thấy tại PostgreSQL Extension Network.
Ngược lại, MongoDB đi kèm bộ extension hạn chế hơn và chủ yếu giới hạn ở việc cho phép sử dụng MongoDB với các công nghệ và framework khác, như IDE Visual Studio Code và các hệ thống đám mây như Google Cloud. Tuy nhiên, có thể có các gói của bên thứ ba cho các ngôn ngữ lập trình khác nhau mà bạn thường dùng để quản lý MongoDB.
Xu hướng áp dụng
Cả PostgreSQL và MongoDB đều đang trong thời kỳ hoàng kim, như thể hiện trong hình sau với xu hướng của các engine cơ sở dữ liệu dựa trên dữ liệu từ DB-Engines.
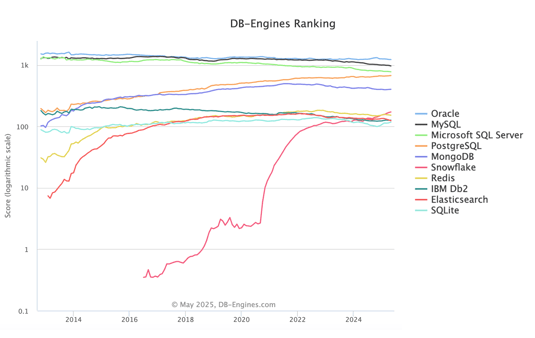
Nguồn: db-engines
Trong khi các hệ quản trị cơ sở dữ liệu quan hệ vẫn chiếm ưu thế (bao gồm PostgreSQL, xếp hạng 4), biểu đồ cũng cho thấy một sự dịch chuyển đáng chú ý trong những năm gần đây, với các cơ sở dữ liệu NoSQL như MongoDB và Redis tăng trưởng mạnh. Xu hướng đi lên này phản ánh việc ngày càng áp dụng các giải pháp linh hoạt và có khả năng mở rộng để quản lý dữ liệu phi cấu trúc và đáp ứng các ứng dụng có lưu lượng cao.
Bảng so sánh PostgreSQL và MongoDB
Dưới đây là một bảng tóm tắt sự khác biệt giữa cơ sở dữ liệu MongoDB và PostgreSQL:
|
Tính năng
|
MongoDB
|
PostgreSQL
|
|
Cấu trúc dữ liệu
|
Lưu dữ liệu dưới dạng tài liệu (ví dụ: JSON, BSON), cho phép cấu trúc linh hoạt, phân cấp.
|
Lưu dữ liệu trong các bảng với hàng và cột, theo lược đồ xác định trước.
|
|
Tính linh hoạt của lược đồ
|
Không lược đồ: Tài liệu có thể có cấu trúc khác nhau, cho phép trường và kiểu dữ liệu khác nhau.
|
Lược đồ cố định: Yêu cầu lược đồ xác định trước với các cột và kiểu dữ liệu cụ thể.
|
|
Ngôn ngữ truy vấn
|
Sử dụng MongoDB Query Language (MQL) hoặc tương tự, dựa trên đối tượng và linh hoạt hơn.
|
Sử dụng SQL (Structured Query Language) để truy vấn dữ liệu có cấu trúc.
|
|
Join
|
Tránh join bằng cách nhúng dữ liệu liên quan vào trong tài liệu (phi chuẩn hóa).
|
Hỗ trợ join phức tạp giữa các bảng (chuẩn hóa).
|
|
Hiệu năng
|
Đọc và ghi nhanh hơn cho dữ liệu phi cấu trúc hoặc bán cấu trúc. Tránh chi phí overhead từ join.
|
Hiệu năng mạnh cho dữ liệu có cấu trúc, nhưng join có thể làm chậm truy vấn.
|
|
Khả năng mở rộng
|
Mở rộng ngang: Có thể phân phối dữ liệu trên nhiều máy chủ bằng sharding.
|
Thường mở rộng dọc: Dựa vào phần cứng mạnh hơn, dù có hỗ trợ mở rộng ngang (ví dụ: bằng partition).
|
|
Hỗ trợ giao dịch
|
Hỗ trợ giao dịch ACID đa tài liệu (từ MongoDB 4.0 trở lên), nhưng ban đầu được thiết kế cho các thao tác không giao dịch.
|
Hỗ trợ đầy đủ các giao dịch tuân thủ ACID, cung cấp tính nhất quán và độ tin cậy mạnh.
|
|
Trường hợp sử dụng
|
Tốt nhất cho dữ liệu phi cấu trúc hoặc bán cấu trúc như hồ sơ người dùng, log, danh mục và các cấu trúc dữ liệu linh hoạt.
|
Lý tưởng cho dữ liệu có cấu trúc với mối quan hệ rõ ràng, như hồ sơ tài chính hoặc hoạch định nguồn lực doanh nghiệp (ERP).
|
|
Quan hệ dữ liệu
|
Hỗ trợ dữ liệu nhúng (phi chuẩn hóa), giúp dễ dàng truy xuất thông tin liên quan từ một truy vấn duy nhất.
|
Cơ sở dữ liệu quan hệ dựa vào khóa ngoại để thiết lập quan hệ giữa các bảng (chuẩn hóa).
|
|
Lập chỉ mục
|
Hỗ trợ lập chỉ mục nhưng thiếu sự đa dạng và tinh vi như trong cơ sở dữ liệu quan hệ.
|
Khả năng lập chỉ mục mạnh, hỗ trợ nhiều loại chỉ mục (ví dụ: B-tree, hash) để tối ưu hiệu năng tốt hơn.
|
|
Tính nhất quán
|
Cung cấp tính nhất quán cuối cùng trong thiết lập phân tán nhưng cũng có thể đảm bảo tính nhất quán mạnh khi cần (thông qua giao dịch ACID).
|
Đảm bảo tính nhất quán mạnh trong hầu hết trường hợp nhờ giao dịch ACID và tính toàn vẹn quan hệ.
|
|
Mở rộng khối lượng dữ liệu
|
Dễ dàng mở rộng để đáp ứng lượng dữ liệu lớn bằng cách thêm máy chủ (sharding).
|
Có thể mở rộng dọc, nhưng mở rộng ngang đòi hỏi cấu hình phức tạp hơn (ví dụ: partitioning).
|
|
Tính toàn vẹn dữ liệu
|
Tính toàn vẹn dữ liệu được quản lý trong từng tài liệu, nhưng quản lý quan hệ giữa các tài liệu có thể khó khăn hơn.
|
Hỗ trợ mạnh mẽ sẵn có cho tính toàn vẹn dữ liệu thông qua khóa chính và khóa ngoại, cũng như các ràng buộc như UNIQUE và NOT NULL.
|
|
Thân thiện với nhà phát triển
|
Thân thiện với nhà phát triển: Mô hình hóa dữ liệu linh hoạt, hoạt động tốt với ứng dụng hiện đại (ví dụ: JSON, REST API).
|
Mô hình hóa dữ liệu cứng nhắc hơn nhưng được hiểu rõ bởi các nhà phát triển quen với SQL và dữ liệu có cấu trúc.
|
Kết luận
MongoDB và PostgreSQL là hai trong số những cơ sở dữ liệu phổ biến nhất hiện nay. Chúng là ví dụ điển hình của cơ sở dữ liệu SQL và NoSQL, và bằng cách so sánh chúng, chúng ta có thể làm rõ những khác biệt, điểm mạnh và các trường hợp sử dụng đa dạng nơi các cơ sở dữ liệu này hữu ích.
Có rất nhiều điều để học về cơ sở dữ liệu SQL và NoSQL. Tại DataCamp, chúng tôi muốn hỗ trợ bạn với các khóa học và hướng dẫn toàn diện, cập nhật nhất. Xem thêm một số tài liệu chuyên sâu về cơ sở dữ liệu tại đây:


Nếu bạn đang lên kế hoạch bắt đầu một ứng dụng số mới, rất có thể bạn sẽ cần thu thập và lưu trữ một số dữ liệu. Lưu trữ dữ liệu ở đâu và như thế nào là một trong những quyết định quan trọng nhất bạn phải đưa ra, vì toàn bộ phần mềm sẽ phụ thuộc vào dữ liệu đó để hoạt động.
Truyền thống, dữ liệu được lưu trong các bảng với các hàng và cột được liên kết thông qua một số mối quan hệ nhất định (tức là các cột chung). Các cơ sở dữ liệu lưu trữ dữ liệu quan hệ được gọi là cơ sở dữ liệu quan hệ, hay cơ sở dữ liệu SQL, vì hầu hết, nếu không muốn nói là tất cả, đều dựa vào SQL cho mọi loại thao tác.
Tuy nhiên, trong vài thập kỷ gần đây, các hệ quản trị cơ sở dữ liệu mới đã phát triển để đáp ứng sự gia tăng nhanh chóng về khối lượng và tính đa dạng của dữ liệu được tạo ra mỗi giây. Các cơ sở dữ liệu NoSQL (Not only SQL) đề xuất các lược đồ và chiến lược mới để thu thập dữ liệu hiệu quả dựa trên các trường hợp sử dụng cụ thể, đồng thời vẫn dựa một phần vào SQL.
Trong bài viết này, chúng ta sẽ phân tích hai hệ quản trị cơ sở dữ liệu phổ biến: PostgreSQL và MongoDB. Cái đầu là một trong những cơ sở dữ liệu SQL phổ biến nhất, còn cái sau là cơ sở dữ liệu NoSQL nổi tiếng nhất.
Chúng tôi sẽ đề cập đến các tính năng và điểm mạnh chính của cả hai cơ sở dữ liệu, các trường hợp sử dụng thuyết phục nhất của chúng, và những điều nên ghi nhớ nếu bạn đang cân nhắc chuyển dữ liệu sang một trong hai cơ sở dữ liệu này.
Nếu bạn muốn trực tiếp thực hành và thử từng phương pháp, hãy xem các khóa học của chúng tôi, Tạo cơ sở dữ liệu PostgreSQL và Nhập môn MongoDB với Python.
TL;DR: PostgreSQL và MongoDB
Việc chọn cơ sở dữ liệu phù hợp rất quan trọng với bất kỳ ứng dụng số nào. PostgreSQL, một cơ sở dữ liệu quan hệ mạnh mẽ dựa trên SQL, vượt trội trong các kịch bản dữ liệu có cấu trúc đòi hỏi tính nhất quán, join phức tạp và giao dịch ACID. MongoDB, một cơ sở dữ liệu tài liệu NoSQL linh hoạt sử dụng BSON, lý tưởng để xử lý dữ liệu động, phi cấu trúc, cung cấp khả năng mở rộng lớn hơn thông qua sharding theo chiều ngang. Việc chọn giữa PostgreSQL và MongoDB cuối cùng phụ thuộc vào cấu trúc dữ liệu, nhu cầu mở rộng và yêu cầu nhất quán của dự án của bạn.
Kiến trúc mô hình dữ liệu của PostgreSQL và MongoDB
Hãy phân tích những khác biệt chính giữa PostgreSQL và MongoDB về kiến trúc mô hình dữ liệu.
Cấu trúc quan hệ so với cấu trúc dựa trên tài liệu
Hệ quản trị cơ sở dữ liệu quan hệ như PostgreSQL tổ chức dữ liệu thành các bảng, trong đó mỗi bảng gồm các hàng và cột. Các bảng này có thể được liên kết thông qua khóa, cho phép các mối quan hệ dữ liệu phức tạp thông qua SQL join và truy vấn hiệu quả.
Cơ sở dữ liệu quan hệ. Nguồn: DataCamp
Nhờ sự đơn giản, hiệu quả riêng có và tính nhất quán mạnh mẽ, cơ sở dữ liệu quan hệ đã vô cùng thành công và được áp dụng rộng rãi trong nhiều thập kỷ qua.
Tuy nhiên, chúng có thể không phải là lựa chọn tốt nhất khi bạn làm việc với dữ liệu phi cấu trúc không phù hợp gọn gàng với định dạng dạng bảng (ví dụ: bài đăng mạng xã hội, dữ liệu cảm biến) hoặc khi khả năng mở rộng là điều bắt buộc; tức là khi ứng dụng của bạn cần mở rộng theo chiều ngang trên nhiều máy chủ.
Đây là lúc cơ sở dữ liệu NoSQL xuất hiện. Không giống như các đối tác quan hệ, cơ sở dữ liệu NoSQL có thể xử lý dữ liệu phi cấu trúc hoặc bán cấu trúc mà không bị ràng buộc bởi một lược đồ cố định.
Cụ thể, MongoDB là cơ sở dữ liệu tài liệu, một loại cơ sở dữ liệu NoSQL lưu trữ dữ liệu trong các bộ sưu tập (collection) các tài liệu giống JSON bằng định dạng gọi là BSON (Binary JSON). Nói đơn giản, tài liệu tương tự như các đối tượng key-value của JSON, với các khả năng bổ sung để lưu trữ và thao tác dữ liệu do BSON cung cấp.
Cách MongoDB lưu dữ liệu dưới dạng BSON. Nguồn: DataCamp
Tính linh hoạt của BSON cho phép tạo ra các lược đồ tài liệu động, trong đó cấu trúc và dữ liệu có thể thay đổi tức thời. Chúng ta sẽ thấy rõ hơn ở tiểu mục tiếp theo.
Mẫu tiến hóa lược đồ
Cơ sở dữ liệu quan hệ như PostgreSQL cung cấp các lược đồ mạnh mẽ, khó thay đổi khi bạn đã tạo bảng. Đây là một tính năng tuyệt vời nếu dữ liệu bạn làm việc có bản chất dạng bảng và luôn đi vào ứng dụng của bạn với cùng một định dạng. Tuy nhiên, nếu bạn xử lý dữ liệu bán cấu trúc hoặc phi cấu trúc có nội dung có thể thay đổi giữa các phần dữ liệu, như bài đăng mạng xã hội hoặc dữ liệu cảm biến, bạn có thể cần một mức độ linh hoạt nhất định để tiếp nhận dữ liệu.
Trái ngược với PostgreSQL, MongoDB đi kèm với thiết kế không lược đồ (schema-less), mang lại sự linh hoạt đặc biệt để xử lý dữ liệu đa dạng và phát triển. Thiết kế không lược đồ của MongoDB tổ chức dữ liệu thành tài liệu (document) và bộ sưu tập (collection):
Không giống các cơ sở dữ liệu quan hệ truyền thống, nơi việc thêm trường mới yêu cầu thay đổi toàn bộ cấu trúc bảng, MongoDB cho phép các tài liệu trong cùng một collection có các trường và cấu trúc hoàn toàn khác nhau. Điều này loại bỏ nhu cầu về lược đồ cứng nhắc và giúp dễ dàng lưu trữ dữ liệu đa dạng mà không ép buộc tính đồng nhất.
Ngôn ngữ truy vấn: PostgreSQL và MongoDB
Bất kể bạn dùng cơ sở dữ liệu nào, PostgreSQL hay MongoDB, bạn sẽ cần học ngôn ngữ để giao tiếp và quản lý cơ sở dữ liệu. Trong PostgreSQL, đó là SQL, một ngôn ngữ lập trình cực kỳ phổ biến, tiêu chuẩn hóa và dễ sử dụng. Bạn có thể bắt đầu với SQL trong khóa Nhập môn SQL của chúng tôi.
Ngược lại, MongoDB chủ yếu dựa vào ngôn ngữ riêng là MongoDB Query Language (MQL) để tương tác với cơ sở dữ liệu. Tuy nhiên, cũng có thể dùng các ngôn ngữ lập trình phổ biến khác như Python, C và Java để kết nối và tương tác với cơ sở dữ liệu MongoDB.
Hãy phân tích những khác biệt chính giữa SQL và MQL.
Khả năng của SQL và MQL
Một trong những lợi thế lớn nhất của PostgreSQL so với MongoDB là việc sử dụng SQL. SQL (viết tắt của “Structured Query Language”) là một ngôn ngữ thiết yếu để xây dựng và duy trì cơ sở dữ liệu quan hệ.
Đây là một ngôn ngữ lập trình chuyên biệt, đơn giản, được hầu hết các hệ thống cơ sở dữ liệu quan hệ sử dụng, như MySQL, SQL Server, SQLite và tất nhiên là PostgreSQL.
SQL cực kỳ mạnh mẽ, cho phép bạn thực hiện mọi loại thao tác dữ liệu, từ truy xuất và tổng hợp dữ liệu đến làm sạch dữ liệu và các phép join. Tuy nhiên, khi nói đến PostgreSQL, khả năng còn lớn hơn, vì PostgreSQL đi kèm một tập các tính năng nâng cao cho phân tích phức tạp, bao gồm:
Ngược lại, dù MongoDB không dựa vào SQL, nó có khả năng truy vấn, lập chỉ mục và tổng hợp mạnh mẽ, cũng như các chức năng khác để chèn, cập nhật hoặc xóa thông tin trong cơ sở dữ liệu tài liệu. Do đó, nếu bạn quen với JSON hoặc dictionary trong Python, bạn sẽ không mất nhiều thời gian để làm quen với cú pháp MQL.
MQL được thiết kế đặc biệt để xử lý bản chất động của tài liệu. Vì vậy, nó linh hoạt hơn nhiều so với SQL. Ngoài ra, do tài liệu có thể lồng tài liệu khác bên trong, trong MongoDB không cần dùng các phép join phức tạp và kém hiệu quả, điều thường thấy ở cơ sở dữ liệu quan hệ.
Chiến lược lập chỉ mục
Chỉ mục là các đối tượng cơ sở dữ liệu giúp tăng tốc các thao tác truy xuất dữ liệu. Chúng đóng vai trò như con trỏ để nhanh chóng định vị hàng trong bảng, cải thiện hiệu năng truy vấn.
PostgreSQL có khả năng lập chỉ mục mạnh, hỗ trợ nhiều loại chỉ mục, bao gồm:
MongoDB cũng hỗ trợ lập chỉ mục để tìm tài liệu trong collection mà không phải quét toàn bộ tài liệu. Tuy nhiên, khả năng của nó hạn chế hơn, thiếu sự đa dạng và tinh vi trong lập chỉ mục như ở các cơ sở dữ liệu quan hệ như PostgreSQL. Bao gồm:
Sử dụng chỉ mục trong cơ sở dữ liệu SQL và NoSQL là chìa khóa để tăng hiệu năng và giảm thời gian truy vấn, đặc biệt trên các tập dữ liệu lớn.
Tuy nhiên, hãy nhớ rằng thêm chỉ mục cũng có thể tác động tiêu cực đến hiệu năng ghi. Với các bảng hoặc collection có tỷ lệ ghi/đọc cao, chỉ mục trở nên tốn kém vì mỗi lần chèn cũng phải cập nhật các chỉ mục.
Hiệu năng và khả năng mở rộng trong MongoDB và PostgreSQL
MongoDB và PostgreSQL là những công cụ cơ sở dữ liệu tuyệt vời, nhưng không có ý nghĩa khi chọn cái này thay vì cái kia chỉ dựa trên thuộc tính của chúng. Thay vào đó, bạn luôn nên đưa ra lựa chọn dựa trên đặc thù trường hợp sử dụng. Với lưu ý này, hãy phân tích sự khác biệt về hiệu năng và khả năng mở rộng của MongoDB và PostgreSQL.
Xử lý giao dịch
Giống các hệ thống cơ sở dữ liệu quan hệ phổ biến khác, PostgreSQL đảm bảo mức độ toàn vẹn và chất lượng dữ liệu cao thông qua hệ thống kiểu mạnh mẽ và hỗ trợ các giao dịch ACID (Atomicity, Consistency, Isolation, Durability).
Giao dịch ACID là tập hợp các thuộc tính đảm bảo việc xử lý giao dịch cơ sở dữ liệu đáng tin cậy. Chúng đảm bảo dữ liệu vẫn chính xác và an toàn ngay cả khi xảy ra lỗi, sập hệ thống hoặc truy cập đồng thời. Những thuộc tính này rất quan trọng để duy trì chất lượng dữ liệu trong bất kỳ dự án nào.
Trong khi giao dịch ACID từ lâu là tiêu chuẩn vàng để đảm bảo tính toàn vẹn dữ liệu trong cơ sở dữ liệu quan hệ, các cơ sở dữ liệu NoSQL như MongoDB thường ưu tiên tính linh hoạt và khả năng mở rộng hơn là tính nhất quán giao dịch chặt chẽ. Điều này dẫn đến việc nới lỏng một số thuộc tính ACID có trong cơ sở dữ liệu quan hệ.
Ví dụ, một số cơ sở dữ liệu MongoDB ưu tiên tính nhất quán cuối cùng (eventual consistency) thay vì nhất quán tức thời, nghĩa là các thay đổi có thể không được phản ánh ngay lập tức trên tất cả các nút. Những đánh đổi về tính nhất quán, tính sẵn sàng và hiệu năng cho phép hiệu năng và khả năng mở rộng tốt hơn nhưng đòi hỏi cân nhắc kỹ khi thiết kế ứng dụng phụ thuộc vào tính nhất quán dữ liệu nghiêm ngặt.
Mẫu mở rộng
Mở rộng bao gồm việc sử dụng nhiều kỹ thuật để giải quyết sự gia tăng khối lượng dữ liệu và lưu lượng. Nói đơn giản, chúng ta có thể làm điều này thông qua mở rộng dọc và mở rộng ngang. Cái đầu là cải thiện và bổ sung tài nguyên cho cùng một máy chủ để xử lý tải tăng. Cái sau đạt được bằng cách thêm nhiều máy chủ hoặc nút vào hệ thống phân tán, từ đó giúp tăng năng lực.
PostgreSQL chủ yếu dựa vào mở rộng dọc để tăng năng lực. Tuy nhiên, khác với các cơ sở dữ liệu SQL phổ biến khác, PostgreSQL cũng cho phép mở rộng ngang thông qua phân vùng (partitioning), nhưng yêu cầu cấu hình phức tạp. Bạn có thể tìm hiểu mọi kỹ thuật về partitioning trong PostgreSQL tại khóa Cải thiện hiệu năng truy vấn trong PostgreSQL.
Ngược lại, trong các hệ NoSQL như MongoDB, chiến lược mặc định để xử lý lưu lượng và khối lượng dữ liệu tăng là mở rộng ngang. MongoDB được thiết kế để tận dụng sharding, một kỹ thuật chia cơ sở dữ liệu thành các phần nhỏ hơn, dễ quản lý hơn gọi là “shard” và phân phối chúng trên nhiều máy chủ, cho phép hệ thống xử lý tập dữ liệu lớn và lưu lượng cao.
Xem bài viết Sharding và Partitioning để biết mọi thứ về các kỹ thuật mở rộng phổ biến này.
MongoDB và PostgreSQL: Phân tích trường hợp sử dụng
Giờ khi đã biết các tính năng và điểm mạnh chính của PostgreSQL và MongoDB, đã đến lúc phân tích các kịch bản nơi chúng hữu ích hơn.
Kịch bản lý tưởng cho PostgreSQL
PostgreSQL là lựa chọn tuyệt vời khi dự án của bạn cần:
Ví dụ thuyết phục, PostgreSQL là ý tưởng hợp lý trong:
Triển khai tối ưu cho MongoDB
MongoDB hoạt động tốt nhất trong các trường hợp hữu ích khi có các cấu trúc dữ liệu linh hoạt có thể thích ứng động với thông tin và lược đồ mới, khi khả năng mở rộng và hiệu năng quan trọng, và với dữ liệu phi cấu trúc. Thiết kế không lược đồ của MongoDB, kết hợp với mở rộng ngang, khiến nó rất phù hợp cho các trường hợp như:
Kiến trúc lai
Có thể có các trường hợp bạn cần kết hợp thế mạnh của MongoDB và PostgreSQL để đưa ra giải pháp toàn diện cho các yêu cầu dữ liệu đa dạng. Việc tạo kiến trúc lai kết hợp cơ sở dữ liệu SQL và NoSQL là khả thi, và là ý tưởng hay nếu bạn cần kết hợp tính nhất quán mạnh cho giao dịch với một mức độ linh hoạt nào đó.
Ví dụ, bạn có thể dùng MongoDB cho ghi nhanh trong phân tích thời gian thực, trong khi dùng PostgreSQL cho các thao tác quan hệ phức tạp và lưu trữ dữ liệu có cấu trúc. Tuy nhiên, hiện không có cách nào để “hợp nhất” chức năng của cả hai cơ sở dữ liệu. Bạn sẽ chỉ dùng hai cơ sở dữ liệu khác nhau cùng lúc, điều này sẽ làm tăng độ phức tạp của hệ thống, đòi hỏi phân tích cẩn trọng trước khi triển khai.
Cân nhắc khi di chuyển dữ liệu
Nếu bạn dự định di chuyển dữ liệu từ MongoDB sang PostgreSQL hoặc ngược lại, bạn sẽ phải cân nhắc một số yếu tố:
Lược đồ cơ sở dữ liệu
Nếu bạn di chuyển từ MongoDB sang PostgreSQL, trước khi di chuyển dữ liệu, bạn sẽ phải tạo một hoặc nhiều bảng với lược đồ xác định trước, tức là danh sách các cột với kiểu dữ liệu được gán và các ràng buộc tiềm năng. Nếu bạn muốn chuyển dữ liệu sang Mongo, bạn sẽ cần xác định cách dữ liệu được đưa vào tài liệu. Dù tài liệu linh hoạt, một số mô hình hóa dữ liệu vẫn cần thiết để đặt dữ liệu hiện có.
Các biến đổi dữ liệu tiềm năng
Dữ liệu bạn muốn xuất có thể không có định dạng mong muốn. Nếu vậy, trước khi di chuyển, bạn sẽ phải thiết lập một dạng pipeline dữ liệu để biến đổi dữ liệu sang định dạng đúng trước khi chèn vào cơ sở dữ liệu PostgreSQL hoặc MongoDB.
Cách thức di chuyển dữ liệu
Có nhiều cách để thực hiện quá trình di chuyển. Bạn có thể làm thủ công cho các bước xuất/nhập cơ bản, nhưng đó có thể là quy trình tốn thời gian, phức tạp và dễ lỗi, đặc biệt nếu cơ sở dữ liệu bạn muốn di chuyển chứa nhiều dữ liệu. Đó là lý do chọn một công cụ ELT để thực hiện có thể là giải pháp tốt hơn. Có rất nhiều giải pháp có sẵn, cả cho di chuyển từ PostgreSQL sang Mongo và ngược lại.
Tối ưu hóa hiệu năng
Xem xét các kỹ thuật tăng hiệu năng trong quá trình di chuyển là rất quan trọng, đặc biệt trong các quy trình phức tạp. Tùy nguồn và đích, PostgreSQL và MongoDB cung cấp các kỹ thuật và chiến lược cụ thể để tăng tốc quá trình, bao gồm connection pooling, partitioning, chọn khóa shard và covered query.
Bảo mật và tuân thủ
Bảo vệ triển khai cơ sở dữ liệu là điều tối quan trọng để đảm bảo tính toàn vẹn, sẵn sàng và tuân thủ dữ liệu. Cả MongoDB và PostgreSQL đều cung cấp nhiều phương pháp để bảo mật cơ sở dữ liệu của bạn. Phần này đề cập đến một số kỹ thuật phổ biến nhất.
Cơ chế xác thực
PostgreSQL đi kèm nhiều phương thức xác thực, có thể quản lý hiệu quả thông qua role. Role là các thực thể có thể sở hữu đối tượng cơ sở dữ liệu và có đặc quyền. Role có thể dùng cho mục đích xác thực, quản lý quyền và xác định mức truy cập người dùng. Trong PostgreSQL, một role có thể hoạt động như người dùng hoặc như một nhóm người dùng.
Bạn cũng có thể tạo role trong MongoDB để ngăn truy cập trái phép. Kiểm soát dựa trên vai trò tuân theo nguyên tắc đặc quyền tối thiểu để giảm thiểu rủi ro bảo mật. MongoDB đi kèm nhiều cơ chế xác thực, trong đó Salted Challenge Response Authentication Mechanism (SCRAM) là cơ chế mặc định cho xác thực dựa trên mật khẩu an toàn.
Thực hành mã hóa
MongoDB cung cấp nhiều thực hành mã hóa để bảo vệ dữ liệu của bạn, bao gồm:
Đối với PostgreSQL, nó cũng cung cấp mã hóa ở nhiều cấp độ và mang lại sự linh hoạt trong việc bảo vệ dữ liệu khỏi bị lộ do đánh cắp máy chủ cơ sở dữ liệu, quản trị viên thiếu trung thực và mạng không an toàn. Một số tùy chọn gồm:
Cộng đồng và hệ sinh thái
Cả MongoDB và PostgreSQL đều là các công cụ rất phổ biến, với cộng đồng người dùng ngày càng lớn và hệ sinh thái phát triển mạnh. Hãy cùng xem qua.
Khả năng mở rộng qua tiện ích
Extension trong PostgreSQL là các mô-đun bổ sung mở rộng khả năng của cơ sở dữ liệu. Chúng giống các gói (package) trong Python hoặc R. Trong những năm gần đây, một hệ sinh thái extension phong phú đã xuất hiện để tăng tiềm năng của PostgreSQL trong mọi kịch bản, lĩnh vực và trường hợp sử dụng. Hầu hết có thể được tìm thấy tại PostgreSQL Extension Network.
Ngược lại, MongoDB đi kèm bộ extension hạn chế hơn và chủ yếu giới hạn ở việc cho phép sử dụng MongoDB với các công nghệ và framework khác, như IDE Visual Studio Code và các hệ thống đám mây như Google Cloud. Tuy nhiên, có thể có các gói của bên thứ ba cho các ngôn ngữ lập trình khác nhau mà bạn thường dùng để quản lý MongoDB.
Xu hướng áp dụng
Cả PostgreSQL và MongoDB đều đang trong thời kỳ hoàng kim, như thể hiện trong hình sau với xu hướng của các engine cơ sở dữ liệu dựa trên dữ liệu từ DB-Engines.
Nguồn: db-engines
Trong khi các hệ quản trị cơ sở dữ liệu quan hệ vẫn chiếm ưu thế (bao gồm PostgreSQL, xếp hạng 4), biểu đồ cũng cho thấy một sự dịch chuyển đáng chú ý trong những năm gần đây, với các cơ sở dữ liệu NoSQL như MongoDB và Redis tăng trưởng mạnh. Xu hướng đi lên này phản ánh việc ngày càng áp dụng các giải pháp linh hoạt và có khả năng mở rộng để quản lý dữ liệu phi cấu trúc và đáp ứng các ứng dụng có lưu lượng cao.
Bảng so sánh PostgreSQL và MongoDB
Dưới đây là một bảng tóm tắt sự khác biệt giữa cơ sở dữ liệu MongoDB và PostgreSQL:
Tính năng
MongoDB
PostgreSQL
Cấu trúc dữ liệu
Lưu dữ liệu dưới dạng tài liệu (ví dụ: JSON, BSON), cho phép cấu trúc linh hoạt, phân cấp.
Lưu dữ liệu trong các bảng với hàng và cột, theo lược đồ xác định trước.
Tính linh hoạt của lược đồ
Không lược đồ: Tài liệu có thể có cấu trúc khác nhau, cho phép trường và kiểu dữ liệu khác nhau.
Lược đồ cố định: Yêu cầu lược đồ xác định trước với các cột và kiểu dữ liệu cụ thể.
Ngôn ngữ truy vấn
Sử dụng MongoDB Query Language (MQL) hoặc tương tự, dựa trên đối tượng và linh hoạt hơn.
Sử dụng SQL (Structured Query Language) để truy vấn dữ liệu có cấu trúc.
Join
Tránh join bằng cách nhúng dữ liệu liên quan vào trong tài liệu (phi chuẩn hóa).
Hỗ trợ join phức tạp giữa các bảng (chuẩn hóa).
Hiệu năng
Đọc và ghi nhanh hơn cho dữ liệu phi cấu trúc hoặc bán cấu trúc. Tránh chi phí overhead từ join.
Hiệu năng mạnh cho dữ liệu có cấu trúc, nhưng join có thể làm chậm truy vấn.
Khả năng mở rộng
Mở rộng ngang: Có thể phân phối dữ liệu trên nhiều máy chủ bằng sharding.
Thường mở rộng dọc: Dựa vào phần cứng mạnh hơn, dù có hỗ trợ mở rộng ngang (ví dụ: bằng partition).
Hỗ trợ giao dịch
Hỗ trợ giao dịch ACID đa tài liệu (từ MongoDB 4.0 trở lên), nhưng ban đầu được thiết kế cho các thao tác không giao dịch.
Hỗ trợ đầy đủ các giao dịch tuân thủ ACID, cung cấp tính nhất quán và độ tin cậy mạnh.
Trường hợp sử dụng
Tốt nhất cho dữ liệu phi cấu trúc hoặc bán cấu trúc như hồ sơ người dùng, log, danh mục và các cấu trúc dữ liệu linh hoạt.
Lý tưởng cho dữ liệu có cấu trúc với mối quan hệ rõ ràng, như hồ sơ tài chính hoặc hoạch định nguồn lực doanh nghiệp (ERP).
Quan hệ dữ liệu
Hỗ trợ dữ liệu nhúng (phi chuẩn hóa), giúp dễ dàng truy xuất thông tin liên quan từ một truy vấn duy nhất.
Cơ sở dữ liệu quan hệ dựa vào khóa ngoại để thiết lập quan hệ giữa các bảng (chuẩn hóa).
Lập chỉ mục
Hỗ trợ lập chỉ mục nhưng thiếu sự đa dạng và tinh vi như trong cơ sở dữ liệu quan hệ.
Khả năng lập chỉ mục mạnh, hỗ trợ nhiều loại chỉ mục (ví dụ: B-tree, hash) để tối ưu hiệu năng tốt hơn.
Tính nhất quán
Cung cấp tính nhất quán cuối cùng trong thiết lập phân tán nhưng cũng có thể đảm bảo tính nhất quán mạnh khi cần (thông qua giao dịch ACID).
Đảm bảo tính nhất quán mạnh trong hầu hết trường hợp nhờ giao dịch ACID và tính toàn vẹn quan hệ.
Mở rộng khối lượng dữ liệu
Dễ dàng mở rộng để đáp ứng lượng dữ liệu lớn bằng cách thêm máy chủ (sharding).
Có thể mở rộng dọc, nhưng mở rộng ngang đòi hỏi cấu hình phức tạp hơn (ví dụ: partitioning).
Tính toàn vẹn dữ liệu
Tính toàn vẹn dữ liệu được quản lý trong từng tài liệu, nhưng quản lý quan hệ giữa các tài liệu có thể khó khăn hơn.
Hỗ trợ mạnh mẽ sẵn có cho tính toàn vẹn dữ liệu thông qua khóa chính và khóa ngoại, cũng như các ràng buộc như UNIQUE và NOT NULL.
Thân thiện với nhà phát triển
Thân thiện với nhà phát triển: Mô hình hóa dữ liệu linh hoạt, hoạt động tốt với ứng dụng hiện đại (ví dụ: JSON, REST API).
Mô hình hóa dữ liệu cứng nhắc hơn nhưng được hiểu rõ bởi các nhà phát triển quen với SQL và dữ liệu có cấu trúc.
Kết luận
MongoDB và PostgreSQL là hai trong số những cơ sở dữ liệu phổ biến nhất hiện nay. Chúng là ví dụ điển hình của cơ sở dữ liệu SQL và NoSQL, và bằng cách so sánh chúng, chúng ta có thể làm rõ những khác biệt, điểm mạnh và các trường hợp sử dụng đa dạng nơi các cơ sở dữ liệu này hữu ích.
Có rất nhiều điều để học về cơ sở dữ liệu SQL và NoSQL. Tại DataCamp, chúng tôi muốn hỗ trợ bạn với các khóa học và hướng dẫn toàn diện, cập nhật nhất. Xem thêm một số tài liệu chuyên sâu về cơ sở dữ liệu tại đây: