Wenn du eine neue digitale Anwendung planst, wirst du sehr wahrscheinlich Daten erfassen und speichern müssen. Wo und wie du diese Daten speicherst, ist eine der wichtigsten Entscheidungen – schließlich hängt die gesamte Software davon ab.
Traditionell werden Daten in Tabellen mit Zeilen und Spalten gespeichert, die über Relationen (z. B. gemeinsame Spalten) verknüpft sind. Datenbanken, die solche relationalen Daten speichern, heißen relationale Datenbanken oder SQL-Datenbanken, da sie sich für nahezu alle Operationen auf SQL stützen.
In den letzten Jahrzehnten sind jedoch neue Datenbankmanagementsysteme entstanden, um dem rasanten Wachstum von Datenmenge und -vielfalt gerecht zu werden. Die sogenannten NoSQL-Datenbanken („Not only SQL“) schlagen neue Schemata und Strategien vor, um Daten je nach Use Case effizient zu erfassen – teils weiterhin mit SQL-Bezug.
In diesem Artikel vergleichen wir zwei beliebte Datenbankmanagementsysteme: PostgreSQL vs. MongoDB. Ersteres ist eine der populärsten SQL-Datenbanken, letzteres die bekannteste NoSQL-Datenbank.
Wir beleuchten die wichtigsten Funktionen und Stärken beider Datenbanken, die überzeugendsten Einsatzszenarien und was du bei einer möglichen Migration beachten solltest.
Wenn du praktisch einsteigen und beide Ansätze ausprobieren willst, schau dir unsere Kurse Creating PostgreSQL Databases und Introduction to MongoDB in Python an.
Kurzfassung: PostgreSQL vs. MongoDB
Die Wahl der richtigen Datenbank ist entscheidend für jede digitale Anwendung. PostgreSQL, eine leistungsstarke relationale SQL-Datenbank, überzeugt bei strukturierten Daten mit Bedarf an Konsistenz, komplexen Joins und ACID-Transaktionen. MongoDB, eine flexible NoSQL-Dokumentendatenbank mit BSON, ist ideal für dynamische, unstrukturierte Daten und bietet durch horizontales Sharding hohe Skalierbarkeit. Die Entscheidung zwischen PostgreSQL und MongoDB hängt letztlich von Datenstruktur, Skalierungsbedarf und Konsistenzanforderungen deines Projekts ab.
Datenmodell-Architekturen: PostgreSQL vs. MongoDB
Schauen wir uns die wichtigsten Unterschiede der Datenmodell-Architektur von PostgreSQL und MongoDB an.
Relationale vs. dokumentenbasierte Strukturen
Relationale Datenbankmanagementsysteme wie PostgreSQL organisieren Daten in Tabellen aus Zeilen und Spalten. Tabellen lassen sich über Schlüssel verknüpfen, wodurch komplexe Datenbeziehungen via SQL-Joins und effiziente Abfragen abgebildet werden.
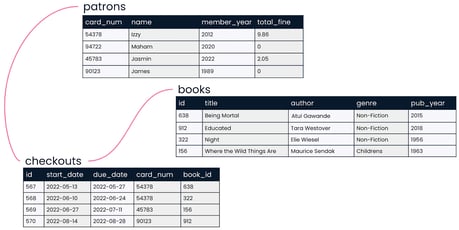
Relationale Datenbank. Quelle: DataCamp
Dank ihrer Einfachheit, hohen Effizienz und starken Konsistenz sind relationale Datenbanken seit Jahrzehnten äußerst erfolgreich und weit verbreitet.
Bei unstrukturierten Daten, die nicht in ein Tabellenformat passen (z. B. Social-Media-Posts, Sensordaten), oder wenn horizontale Skalierung über viele Server zwingend ist, sind sie jedoch nicht immer die beste Wahl.
Hier kommen NoSQL-Datenbanken ins Spiel. Anders als relationale Gegenstücke können sie unstrukturierte oder semistrukturierte Daten ohne festes Schema verarbeiten.
Konkret ist MongoDB eine sogenannte Dokumentendatenbank, also ein Typ NoSQL-Datenbank, die Daten in Sammlungen JSON-ähnlicher Dokumente im BSON-Format (Binary JSON) speichert. Einfach gesagt: Dokumente sind JSON-Schlüssel-Wert-Objekten ähnlich, mit zusätzlichen Fähigkeiten von BSON für Speicherung und Verarbeitung.
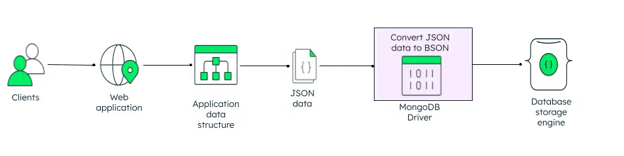
So speichert MongoDB Daten als BSON. Quelle: DataCamp
Die Flexibilität von BSON ermöglicht dynamische Dokumentschemata, deren Struktur und Inhalt sich im laufenden Betrieb ändern können. Mehr dazu im nächsten Abschnitt.
Schema-Evolution
Relationale Datenbanken wie PostgreSQL bieten robuste Schemata, die sich nach dem Anlegen von Tabellen nur schwer ändern lassen. Das ist ideal, wenn deine Daten tabellarisch sind und in gleichbleibendem Format in der Anwendung ankommen. Arbeitest du jedoch mit semi- oder unstrukturierten Daten, deren Inhalt variieren kann (z. B. Social-Media-Posts, Sensordaten), brauchst du mehr Flexibilität, um die Daten zu verarbeiten.
Im Gegensatz zu PostgreSQL setzt MongoDB auf schemalose Designs und bietet damit außergewöhnliche Flexibilität für diverse, sich entwickelnde Daten. MongoDB organisiert Daten in Dokumenten und Kollektionen:
- Dokumente sind die kleinste Dateneinheit und bestehen aus BSON-Schlüssel-Wert-Paaren. Sie können Strings, Zahlen, Datumswerte, Arrays und auch eingebettete Dokumente enthalten. So lassen sich komplexe Beziehungen innerhalb eines Dokuments modellieren – ähnlich wie Objekte in vielen Programmiersprachen.
- Kollektionen gruppieren zusammengehörige Dokumente ähnlich einer Tabelle, jedoch deutlich flexibler. Sie erzwingen kein Schema, sodass Dokumente unterschiedliche Strukturen und Felder aufweisen dürfen. Kollektionen existieren innerhalb von MongoDB-Datenbanken, und jede Datenbank kann mehrere Kollektionen enthalten.
Während man in relationalen Datenbanken für ein neues Feld die gesamte Tabellenstruktur ändern muss, können in MongoDB Dokumente derselben Kollektion vollkommen unterschiedliche Felder und Strukturen haben. Das macht starre Schemata überflüssig und erleichtert die Speicherung heterogener Daten, ohne sie in ein Korsett zu zwängen.
Abfragesprachen: PostgreSQL vs. MongoDB
Unabhängig von der Datenbank – PostgreSQL oder MongoDB – musst du ihre Sprache beherrschen, um sie zu verwalten. In PostgreSQL ist das SQL, eine äußerst verbreitete, standardisierte und einfach zu erlernende Programmiersprache. Starte mit SQL in unserem Kurs Introduction to SQL.
MongoDB hingegen nutzt primär die eigene MongoDB Query Language (MQL) zur Interaktion mit der Datenbank. Es ist aber auch möglich, über gängige Programmiersprachen wie Python, C oder Java auf MongoDB zuzugreifen.
Werfen wir einen Blick auf die Hauptunterschiede zwischen SQL und MQL.
Fähigkeiten von SQL vs. MQL
Einer der größten Vorteile von PostgreSQL gegenüber MongoDB ist der Einsatz von SQL. SQL („Structured Query Language“) ist essenziell für Aufbau und Betrieb relationaler Datenbanken.
Es ist eine einfache domänenspezifische Sprache, die nahezu alle relationalen Systeme nutzen, darunter MySQL, SQL Server, SQLite und natürlich PostgreSQL.
SQL ist extrem mächtig – von Abfragen und Aggregationen über Datenbereinigung bis hin zu Joins. In PostgreSQL geht sogar noch mehr: Die Datenbank bietet erweiterte Fähigkeiten für komplexe Analysen, darunter:
- Funktionen und Prozeduren: PostgreSQL unterstützt die Erstellung von Funktionen und Stored Procedures in verschiedenen Sprachen und kann so komplexe Operationen direkt in der Datenbank ausführen.
- Volltextsuche: PostgreSQL bietet eine robuste Volltextsuche für performante Textabfragen.
- JSON-Unterstützung: Umfangreiche JSON-Typen erlauben die effektive Verarbeitung semistrukturierter Daten und schlagen damit eine Brücke zwischen relationalen und dokumentenorientierten Modellen.
MongoDB setzt zwar nicht auf SQL, verfügt aber über leistungsfähige Funktionen für Abfragen, Indexierung und Aggregation sowie zum Einfügen, Aktualisieren oder Löschen von Informationen in Dokumentendatenbanken. Wenn du JSON oder Python-Dictionaries kennst, wirst du dich schnell in die MQL-Syntax einfinden.
MQL ist speziell für die Dynamik von Dokumenten ausgelegt und daher flexibler als SQL. Da Dokumente wiederum andere Dokumente einbetten können, sind in MongoDB keine komplexen, oft teuren Joins nötig, wie es in relationalen Systemen häufig der Fall ist.
Indexierungsstrategien
Indizes beschleunigen Datenzugriffe, indem sie als Zeiger dienen, um Zeilen in Tabellen schneller zu finden und Abfragen zu beschleunigen.
PostgreSQL bietet starke Indexierungsoptionen und unterstützt u. a.:
- B-Tree-Index: Standard und am häufigsten genutzt
- Hash-Index: Für schnelle Gleichheitsabfragen
- GIN-Index: Für JSON, Arrays und Volltextsuche
- GiST-Index: Für komplexe Datentypen wie Geometrie oder fuzzych Suche
- BRIN-Index: Für große, natürlich geordnete Daten (z. B. Zeitreihen-Logs)
- Expressionsindex: Index basierend auf einer Funktion oder einem Ausdruck
- Partieller Index: Indiziert nur einen Teil der Zeilen (nützlich für Filter)
Auch MongoDB unterstützt Indizes, um Dokumente in Kollektionen zu finden, ohne alle scannen zu müssen. Der Umfang ist jedoch geringer und weniger vielseitig als in relationalen Systemen wie PostgreSQL. Dazu zählen:
- Einfeld-Index: Aggregiert und sortiert Daten eines einzelnen Felds pro Dokument.
- Zusammengesetzter Index: Aggregiert und sortiert Daten aus zwei oder mehr Feldern.
- Multikey-Index: Für in Arrays gespeicherte Daten.
- Text-Index: Unterstützt Textsuche in Feldern mit String-Inhalten.
- Gehashter Index: Für gehashte Shards; indiziert den Hash eines Feldwerts.
Indizes sind in SQL- und NoSQL-Datenbanken entscheidend, um Performance zu steigern und Abfragezeiten – gerade auf großen Datensätzen – zu senken.
Beachte aber: Zusätzliche Indizes können Schreiboperationen verlangsamen. Bei Tabellen oder Kollektionen mit hohem Write-zu-Read-Verhältnis sind Indizes teuer, da jeder Insert auch die Indizes aktualisieren muss.
Performance und Skalierbarkeit: MongoDB vs. PostgreSQL
MongoDB und PostgreSQL sind starke Werkzeuge, doch die Wahl sollte immer vom konkreten Use Case abhängen. Vor diesem Hintergrund betrachten wir Unterschiede bei Performance und Skalierung.
Transaktionsverarbeitung
Wie andere verbreitete relationale Systeme gewährleistet PostgreSQL durch sein starkes Typsystem und die Unterstützung von ACID-Transaktionen (Atomicity, Consistency, Isolation, Durability) hohe Datenintegrität und -qualität.
ACID-Transaktionen sind Eigenschaften, die eine zuverlässige Transaktionsverarbeitung sicherstellen. Sie sorgen für korrekte und sichere Daten – selbst bei Fehlern, Abstürzen oder parallelem Zugriff. Unverzichtbar, um Datenqualität zu wahren.
Während ACID lange der Goldstandard für relationale Datenbanken ist, priorisieren NoSQL-Systeme wie MongoDB oft Flexibilität und Skalierbarkeit vor strenger Transaktionskonsistenz – einige ACID-Eigenschaften werden gelockert.
Beispielsweise setzen manche MongoDB-Setups auf Eventual Consistency statt sofortiger Konsistenz, d. h. Änderungen sind nicht auf allen Knoten unmittelbar sichtbar. Dieser Trade-off zwischen Konsistenz, Verfügbarkeit und Performance verbessert Skalierbarkeit, erfordert aber sorgfältiges Design, wenn strikte Konsistenz geschäftskritisch ist.
Skalierungsmuster
Skalierung begegnet steigendem Datenvolumen und Traffic über zwei Grundstrategien: vertikal und horizontal. Vertikal bedeutet, denselben Server mit mehr Ressourcen auszustatten. Horizontal erweitert man ein verteiltes System um zusätzliche Server oder Knoten.
PostgreSQL setzt primär auf vertikale Skalierung. Anders als viele SQL-Systeme erlaubt PostgreSQL aber auch horizontale Skalierung via Partitionierung – allerdings mit komplexer Konfiguration. Die Details lernst du im Kurs Improving Query Performance in PostgreSQL.
NoSQL-Systeme wie MongoDB setzen hingegen auf horizontale Skalierung. MongoDB ist für Sharding ausgelegt: Die Datenbank wird in kleinere „Shards“ aufgeteilt und über mehrere Server verteilt, um große Datensätze und hohen Traffic zu bewältigen.
Alles zu diesen Techniken findest du in unserem Artikel Sharding vs. Partitioning.
MongoDB vs. PostgreSQL: Use-Case-Analyse
Nun, da die Kernfeatures und Stärken beider Systeme klar sind, betrachten wir typische Einsatzszenarien.
Wann PostgreSQL ideal ist
PostgreSQL ist eine gute Wahl, wenn dein Projekt Folgendes erfordert:
- Starke Konsistenz: Alle Nutzer sehen gleichzeitig identische Daten.
- Komplexe Abfragen: Daten aus mehreren Tabellen verknüpfen und auswerten.
- Erweiterte Analysen: Wenn komplexe Berechnungen oder Transformationen in der Datenbank stattfinden sollen, ist PostgreSQLs Erweiterbarkeit ein großer Pluspunkt.
- Skalierbarkeit: Erwartest du starkes Wachstum, punktet PostgreSQL mit vertikaler Skalierung und Partitionierung.
- ACID-Compliance: Zuverlässige Transaktionsverarbeitung für geschäftskritische Anwendungen.
Konkrete Beispiele, bei denen PostgreSQL sinnvoll ist:
- Finanztransaktionen: Genauigkeit und Konsistenz sind beim Geldtransfer oder der Zahlungsabwicklung entscheidend.
- Lagersysteme: Bestände müssen korrekt aktualisiert werden, um Überverkäufe und Abweichungen zu vermeiden.
- Auftragsabwicklung: Gerade im E-Commerce müssen Bestellungen korrekt und konsistent verarbeitet werden.
Wann MongoDB am besten passt
MongoDB spielt seine Stärken aus, wenn flexible Strukturen benötigt werden, die sich dynamisch an neue Informationen und Schemata anpassen, wenn Skalierung und Performance zählen und bei unstrukturierten Daten. Das schemalose Design in Kombination mit Horizontal-Skalierung eignet sich z. B. für:
- Social-Media-Feeds: Viele eingehende Daten sind unstrukturiert und unvorhersehbar. Temporäre Inkonsistenzen bei Posts oder Likes sind akzeptabel, solange das System reaktionsschnell bleibt.
- Content-Delivery-Netzwerke: Minimale Latenz bei der Auslieferung hat Vorrang vor strikter Konsistenz.
Hybride Architekturen
Mitunter ist eine Kombination aus MongoDB und PostgreSQL sinnvoll, um unterschiedliche Anforderungen abzudecken. Hybride Architekturen aus SQL- und NoSQL-Datenbanken sind machbar und empfehlenswert, wenn du starke Konsistenz für Transaktionen mit Flexibilität verbinden willst.
Beispielsweise kannst du MongoDB für schnelle Writes in Echtzeitanalysen nutzen und PostgreSQL für komplexe relationale Operationen und strukturierte Daten. Eine echte „Verschmelzung“ der Funktionen gibt es nicht – du betreibst zwei Systeme parallel. Das erhöht die Komplexität und sollte gut abgewogen werden.
Wichtige Punkte bei Migrationen
Wenn du Daten zwischen MongoDB und PostgreSQL migrieren willst, beachte Folgendes:
Datenbankschemata
Bei der Migration von MongoDB zu PostgreSQL musst du vorab Tabellen mit einem definierten Schema anlegen, also Spalten, Datentypen und ggf. Constraints. Umgekehrt solltest du bei der Migration nach MongoDB festlegen, wie die Daten in Dokumente überführt werden. Trotz Flexibilität ist ein gewisses Datenmodell für die saubere Ablage erforderlich.
Exportierte Daten liegen möglicherweise nicht im Wunschformat vor. Dann brauchst du vor der Migration eine Datenpipeline, die das Format passend für PostgreSQL oder MongoDB transformiert.
Vorgehen bei der Migration
Für Migrationen gibt es mehrere Wege. Manuell ist bei einfachen Export/Import-Schritten möglich, aber zeitaufwändig, komplex und fehleranfällig – vor allem bei großen Datenmengen. Daher kann ein ELT-Tool die bessere Wahl sein. Es gibt zahlreiche Lösungen, sowohl für PostgreSQL-→MongoDB als auch umgekehrt.
Gerade bei komplexen Migrationen ist Performance zentral. Je nach Quelle und Ziel stellen PostgreSQL und MongoDB Techniken bereit, um den Prozess zu beschleunigen, darunter Connection Pooling, Partitionierung, Wahl geeigneter Shard Keys und Covered Queries.
Sicherheit und Compliance
Die Absicherung deiner Datenbank ist entscheidend für Integrität, Verfügbarkeit und Compliance. Sowohl MongoDB als auch PostgreSQL bieten verschiedene Schutzmaßnahmen. Hier die häufigsten Ansätze.
Authentifizierungsmechanismen
PostgreSQL bietet diverse Authentifizierungsverfahren, die über Rollen effizient verwaltet werden. Rollen können Objekte besitzen und Rechte halten, dienen der Authentifizierung, Rechtevergabe und Zugriffsteuerung. Eine Rolle kann als Nutzer oder Nutzergruppe fungieren.
Auch in MongoDB lassen sich Rollen anlegen, um unbefugten Zugriff zu verhindern. Die rollenbasierte Kontrolle folgt dem Least-Privilege-Prinzip. Als Standard für passwortbasierte Authentifizierung verwendet MongoDB SCRAM (Salted Challenge Response Authentication Mechanism).
Verschlüsselungspraktiken
MongoDB bietet verschiedene Optionen zur Verschlüsselung deiner Daten, darunter:
- TLS/SSL-Verschlüsselung: Verschlüsselt Daten während der Übertragung und sichert so die Kommunikation zwischen Clients und Datenbank.
- IP-Whitelisting und VPNs: Beschränkt den Zugriff auf vertrauenswürdige IPs; zusätzlich sorgen VPNs für sichere Tunnel zu Produktivdatenbanken.
- Verschlüsselung at Rest: Aktivierbar über die native Unterstützung der WiredTiger-Storage-Engine; schützt sensible Daten auf dem Datenträger.
- Clientseitige Feldverschlüsselung: Für höchste Anforderungen einzelne Felder schon vor dem Senden an die Datenbank verschlüsseln – selbst Administratoren sehen dann keine Klartexte.
Auch PostgreSQL bietet Verschlüsselung auf mehreren Ebenen und schützt Daten vor Offenlegung – etwa bei Serverdiebstahl, unredlichen Administratoren oder unsicheren Netzen. Optionen sind u. a.:
- Passwort-Hashing: Nutzerpasswörter werden als Hash gespeichert; Admins können den Klartext nicht einsehen.
- Verschlüsselung über das Netzwerk: SSL-Verbindungen verschlüsseln alle übertragenen Daten: Passwort, Abfragen und Rückgaben.
- Verschlüsselung auf Partitionsebene: Storage-Verschlüsselung kann auf Dateisystem- oder Partitionsebene erfolgen.
- SSL-Host-Authentifizierung: Client und Server können sich gegenseitig per SSL-Zertifikat ausweisen.
MongoDB und PostgreSQL sind sehr beliebt, mit wachsenden Communities und lebendigen Ökosystemen. Ein kurzer Blick darauf.
Erweiterungen
PostgreSQL-Erweiterungen sind Add-ons, die den Funktionsumfang erweitern – vergleichbar mit Paketen in Python oder R. In den letzten Jahren ist ein reiches Ökosystem entstanden, das PostgreSQL für unterschiedlichste Szenarien aufrüstet. Viele findest du im PostgreSQL Extension Network.
MongoDB bietet im Vergleich weniger Erweiterungen; diese zielen vor allem auf die Einbindung in andere Technologien und Frameworks ab, etwa IDEs wie Visual Studio Code oder Cloud-Plattformen wie Google Cloud. Zusätzlich gibt es Third-Party-Pakete für verschiedene Programmiersprachen, mit denen du MongoDB verwaltest.
Adoption-Trends
Beide Systeme erleben derzeit Hochkonjunktur – die folgende Grafik zu Datenbanktrends (DB-Engines) zeigt es.
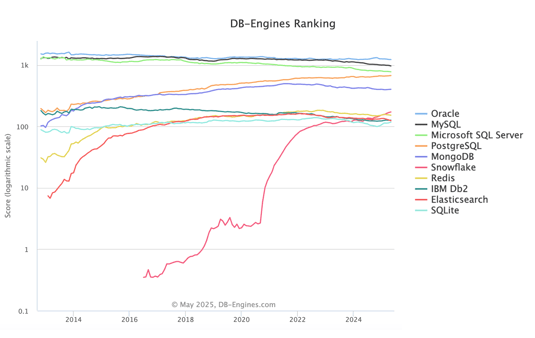
Quelle: db-engines
Relationale Systeme dominieren weiterhin (PostgreSQL auf Rang 4). Gleichzeitig zeigt sich ein deutlicher Aufschwung von NoSQL-Datenbanken wie MongoDB und Redis. Der Trend spiegelt die wachsende Verbreitung flexibler, skalierbarer Lösungen für unstrukturierte Daten und Anwendungen mit hohem Traffic wider.
Vergleichstabelle: PostgreSQL vs. MongoDB
Diese Tabelle fasst die Unterschiede zwischen MongoDB und PostgreSQL zusammen:
|
Feature
|
MongoDB
|
PostgreSQL
|
|
Datenstruktur
|
Speichert Daten als Dokumente (z. B. JSON, BSON) und erlaubt flexible, hierarchische Strukturen.
|
Speichert Daten in Tabellen mit Zeilen und Spalten auf Basis eines vordefinierten Schemas.
|
|
Schema-Flexibilität
|
Schemalos: Dokumente können unterschiedliche Strukturen, Felder und Datentypen haben.
|
Festes Schema: Benötigt ein vordefiniertes Schema mit konkreten Spalten und Datentypen.
|
|
Abfragesprache
|
Verwendet die MongoDB Query Language (MQL) o.ä., objektbasiert und flexibler.
|
Verwendet SQL (Structured Query Language) für strukturierte Abfragen.
|
|
Joins
|
Vermeidet Joins durch Einbettung verwandter Daten in Dokumente (Denormalisierung).
|
Unterstützt komplexe Joins über Tabellen (Normalisierung).
|
|
Performance
|
Schnelle Reads/Writes bei un- oder semistrukturierten Daten; kein Join-Overhead.
|
Stark bei strukturierten Daten; Joins können Abfragen verlangsamen.
|
|
Skalierbarkeit
|
Horizontal skalierbar: Verteilung über mehrere Server via Sharding.
|
Typisch vertikal: Setzt auf leistungsfähere Hardware; horizontale Skalierung teils via Partitionierung.
|
|
Transaktionen
|
Unterstützt Multi-Dokument-ACID-Transaktionen (ab MongoDB 4.0), war ursprünglich aber nicht darauf ausgelegt.
|
Vollständige ACID-Unterstützung für hohe Konsistenz und Zuverlässigkeit.
|
|
Use Cases
|
Optimal für un- oder semistrukturierte Daten wie Profile, Logs, Kataloge und flexible Strukturen.
|
Ideal für strukturierte Daten mit klaren Beziehungen, z. B. Finanzdaten oder ERP.
|
|
Datenbeziehungen
|
Setzt auf eingebettete Daten (Denormalisierung), sodass zusammengehörige Infos per Einzelabfrage abrufbar sind.
|
Relationale Datenbanken arbeiten mit Fremdschlüsseln zur Beziehung über Tabellen (Normalisierung).
|
|
Indexierung
|
Unterstützt Indizes, jedoch weniger Varianten und Tiefe als relationale Systeme.
|
Umfangreiche Indexierung (z. B. B-Tree, Hash) zur Performanceoptimierung.
|
|
Konsistenz
|
Bietet in verteilten Setups Eventual Consistency, kann bei Bedarf über ACID auch starke Konsistenz liefern.
|
Sichert in der Regel starke Konsistenz dank ACID und relationaler Integrität.
|
|
Skalierung des Datenvolumens
|
Lässt sich durch Hinzufügen von Servern (Sharding) leicht erweitern.
|
Kann vertikal wachsen; horizontale Skalierung erfordert komplexere Konfiguration (z. B. Partitionierung).
|
|
Datenintegrität
|
Integrität wird innerhalb von Dokumenten gewahrt; Beziehungen zwischen Dokumenten sind aufwendiger.
|
Starke Integrität über Primär-/Fremdschlüssel und Constraints wie UNIQUE oder NOT NULL.
|
|
Entwicklerfreundlichkeit
|
Entwicklerfreundlich: Flexibles Datenmodell, gut für moderne Apps (z. B. JSON, REST-APIs).
|
Strengeres Datenmodell, aber vertraut für Entwickler mit SQL- und Struktur-Datenkenntnissen.
|
Fazit
MongoDB und PostgreSQL gehören zu den beliebtesten Datenbanken. Sie stehen exemplarisch für NoSQL bzw. SQL. Der Vergleich zeigt Unterschiede, Stärken und Einsatzfälle, in denen die jeweilige Datenbank punktet.
Zu SQL und NoSQL gibt es viel zu lernen. DataCamp unterstützt dich mit aktuellen, umfassenden Kursen und Tutorials. Hier findest du passendes Material:



Wenn du eine neue digitale Anwendung planst, wirst du sehr wahrscheinlich Daten erfassen und speichern müssen. Wo und wie du diese Daten speicherst, ist eine der wichtigsten Entscheidungen – schließlich hängt die gesamte Software davon ab.
Traditionell werden Daten in Tabellen mit Zeilen und Spalten gespeichert, die über Relationen (z. B. gemeinsame Spalten) verknüpft sind. Datenbanken, die solche relationalen Daten speichern, heißen relationale Datenbanken oder SQL-Datenbanken, da sie sich für nahezu alle Operationen auf SQL stützen.
In den letzten Jahrzehnten sind jedoch neue Datenbankmanagementsysteme entstanden, um dem rasanten Wachstum von Datenmenge und -vielfalt gerecht zu werden. Die sogenannten NoSQL-Datenbanken („Not only SQL“) schlagen neue Schemata und Strategien vor, um Daten je nach Use Case effizient zu erfassen – teils weiterhin mit SQL-Bezug.
In diesem Artikel vergleichen wir zwei beliebte Datenbankmanagementsysteme: PostgreSQL vs. MongoDB. Ersteres ist eine der populärsten SQL-Datenbanken, letzteres die bekannteste NoSQL-Datenbank.
Wir beleuchten die wichtigsten Funktionen und Stärken beider Datenbanken, die überzeugendsten Einsatzszenarien und was du bei einer möglichen Migration beachten solltest.
Wenn du praktisch einsteigen und beide Ansätze ausprobieren willst, schau dir unsere Kurse Creating PostgreSQL Databases und Introduction to MongoDB in Python an.
Kurzfassung: PostgreSQL vs. MongoDB
Die Wahl der richtigen Datenbank ist entscheidend für jede digitale Anwendung. PostgreSQL, eine leistungsstarke relationale SQL-Datenbank, überzeugt bei strukturierten Daten mit Bedarf an Konsistenz, komplexen Joins und ACID-Transaktionen. MongoDB, eine flexible NoSQL-Dokumentendatenbank mit BSON, ist ideal für dynamische, unstrukturierte Daten und bietet durch horizontales Sharding hohe Skalierbarkeit. Die Entscheidung zwischen PostgreSQL und MongoDB hängt letztlich von Datenstruktur, Skalierungsbedarf und Konsistenzanforderungen deines Projekts ab.
Datenmodell-Architekturen: PostgreSQL vs. MongoDB
Schauen wir uns die wichtigsten Unterschiede der Datenmodell-Architektur von PostgreSQL und MongoDB an.
Relationale vs. dokumentenbasierte Strukturen
Relationale Datenbankmanagementsysteme wie PostgreSQL organisieren Daten in Tabellen aus Zeilen und Spalten. Tabellen lassen sich über Schlüssel verknüpfen, wodurch komplexe Datenbeziehungen via SQL-Joins und effiziente Abfragen abgebildet werden.
Relationale Datenbank. Quelle: DataCamp
Dank ihrer Einfachheit, hohen Effizienz und starken Konsistenz sind relationale Datenbanken seit Jahrzehnten äußerst erfolgreich und weit verbreitet.
Bei unstrukturierten Daten, die nicht in ein Tabellenformat passen (z. B. Social-Media-Posts, Sensordaten), oder wenn horizontale Skalierung über viele Server zwingend ist, sind sie jedoch nicht immer die beste Wahl.
Hier kommen NoSQL-Datenbanken ins Spiel. Anders als relationale Gegenstücke können sie unstrukturierte oder semistrukturierte Daten ohne festes Schema verarbeiten.
Konkret ist MongoDB eine sogenannte Dokumentendatenbank, also ein Typ NoSQL-Datenbank, die Daten in Sammlungen JSON-ähnlicher Dokumente im BSON-Format (Binary JSON) speichert. Einfach gesagt: Dokumente sind JSON-Schlüssel-Wert-Objekten ähnlich, mit zusätzlichen Fähigkeiten von BSON für Speicherung und Verarbeitung.
So speichert MongoDB Daten als BSON. Quelle: DataCamp
Die Flexibilität von BSON ermöglicht dynamische Dokumentschemata, deren Struktur und Inhalt sich im laufenden Betrieb ändern können. Mehr dazu im nächsten Abschnitt.
Schema-Evolution
Relationale Datenbanken wie PostgreSQL bieten robuste Schemata, die sich nach dem Anlegen von Tabellen nur schwer ändern lassen. Das ist ideal, wenn deine Daten tabellarisch sind und in gleichbleibendem Format in der Anwendung ankommen. Arbeitest du jedoch mit semi- oder unstrukturierten Daten, deren Inhalt variieren kann (z. B. Social-Media-Posts, Sensordaten), brauchst du mehr Flexibilität, um die Daten zu verarbeiten.
Im Gegensatz zu PostgreSQL setzt MongoDB auf schemalose Designs und bietet damit außergewöhnliche Flexibilität für diverse, sich entwickelnde Daten. MongoDB organisiert Daten in Dokumenten und Kollektionen:
Während man in relationalen Datenbanken für ein neues Feld die gesamte Tabellenstruktur ändern muss, können in MongoDB Dokumente derselben Kollektion vollkommen unterschiedliche Felder und Strukturen haben. Das macht starre Schemata überflüssig und erleichtert die Speicherung heterogener Daten, ohne sie in ein Korsett zu zwängen.
Abfragesprachen: PostgreSQL vs. MongoDB
Unabhängig von der Datenbank – PostgreSQL oder MongoDB – musst du ihre Sprache beherrschen, um sie zu verwalten. In PostgreSQL ist das SQL, eine äußerst verbreitete, standardisierte und einfach zu erlernende Programmiersprache. Starte mit SQL in unserem Kurs Introduction to SQL.
MongoDB hingegen nutzt primär die eigene MongoDB Query Language (MQL) zur Interaktion mit der Datenbank. Es ist aber auch möglich, über gängige Programmiersprachen wie Python, C oder Java auf MongoDB zuzugreifen.
Werfen wir einen Blick auf die Hauptunterschiede zwischen SQL und MQL.
Fähigkeiten von SQL vs. MQL
Einer der größten Vorteile von PostgreSQL gegenüber MongoDB ist der Einsatz von SQL. SQL („Structured Query Language“) ist essenziell für Aufbau und Betrieb relationaler Datenbanken.
Es ist eine einfache domänenspezifische Sprache, die nahezu alle relationalen Systeme nutzen, darunter MySQL, SQL Server, SQLite und natürlich PostgreSQL.
SQL ist extrem mächtig – von Abfragen und Aggregationen über Datenbereinigung bis hin zu Joins. In PostgreSQL geht sogar noch mehr: Die Datenbank bietet erweiterte Fähigkeiten für komplexe Analysen, darunter:
MongoDB setzt zwar nicht auf SQL, verfügt aber über leistungsfähige Funktionen für Abfragen, Indexierung und Aggregation sowie zum Einfügen, Aktualisieren oder Löschen von Informationen in Dokumentendatenbanken. Wenn du JSON oder Python-Dictionaries kennst, wirst du dich schnell in die MQL-Syntax einfinden.
MQL ist speziell für die Dynamik von Dokumenten ausgelegt und daher flexibler als SQL. Da Dokumente wiederum andere Dokumente einbetten können, sind in MongoDB keine komplexen, oft teuren Joins nötig, wie es in relationalen Systemen häufig der Fall ist.
Indexierungsstrategien
Indizes beschleunigen Datenzugriffe, indem sie als Zeiger dienen, um Zeilen in Tabellen schneller zu finden und Abfragen zu beschleunigen.
PostgreSQL bietet starke Indexierungsoptionen und unterstützt u. a.:
Auch MongoDB unterstützt Indizes, um Dokumente in Kollektionen zu finden, ohne alle scannen zu müssen. Der Umfang ist jedoch geringer und weniger vielseitig als in relationalen Systemen wie PostgreSQL. Dazu zählen:
Indizes sind in SQL- und NoSQL-Datenbanken entscheidend, um Performance zu steigern und Abfragezeiten – gerade auf großen Datensätzen – zu senken.
Beachte aber: Zusätzliche Indizes können Schreiboperationen verlangsamen. Bei Tabellen oder Kollektionen mit hohem Write-zu-Read-Verhältnis sind Indizes teuer, da jeder Insert auch die Indizes aktualisieren muss.
Performance und Skalierbarkeit: MongoDB vs. PostgreSQL
MongoDB und PostgreSQL sind starke Werkzeuge, doch die Wahl sollte immer vom konkreten Use Case abhängen. Vor diesem Hintergrund betrachten wir Unterschiede bei Performance und Skalierung.
Transaktionsverarbeitung
Wie andere verbreitete relationale Systeme gewährleistet PostgreSQL durch sein starkes Typsystem und die Unterstützung von ACID-Transaktionen (Atomicity, Consistency, Isolation, Durability) hohe Datenintegrität und -qualität.
ACID-Transaktionen sind Eigenschaften, die eine zuverlässige Transaktionsverarbeitung sicherstellen. Sie sorgen für korrekte und sichere Daten – selbst bei Fehlern, Abstürzen oder parallelem Zugriff. Unverzichtbar, um Datenqualität zu wahren.
Während ACID lange der Goldstandard für relationale Datenbanken ist, priorisieren NoSQL-Systeme wie MongoDB oft Flexibilität und Skalierbarkeit vor strenger Transaktionskonsistenz – einige ACID-Eigenschaften werden gelockert.
Beispielsweise setzen manche MongoDB-Setups auf Eventual Consistency statt sofortiger Konsistenz, d. h. Änderungen sind nicht auf allen Knoten unmittelbar sichtbar. Dieser Trade-off zwischen Konsistenz, Verfügbarkeit und Performance verbessert Skalierbarkeit, erfordert aber sorgfältiges Design, wenn strikte Konsistenz geschäftskritisch ist.
Skalierungsmuster
Skalierung begegnet steigendem Datenvolumen und Traffic über zwei Grundstrategien: vertikal und horizontal. Vertikal bedeutet, denselben Server mit mehr Ressourcen auszustatten. Horizontal erweitert man ein verteiltes System um zusätzliche Server oder Knoten.
PostgreSQL setzt primär auf vertikale Skalierung. Anders als viele SQL-Systeme erlaubt PostgreSQL aber auch horizontale Skalierung via Partitionierung – allerdings mit komplexer Konfiguration. Die Details lernst du im Kurs Improving Query Performance in PostgreSQL.
NoSQL-Systeme wie MongoDB setzen hingegen auf horizontale Skalierung. MongoDB ist für Sharding ausgelegt: Die Datenbank wird in kleinere „Shards“ aufgeteilt und über mehrere Server verteilt, um große Datensätze und hohen Traffic zu bewältigen.
Alles zu diesen Techniken findest du in unserem Artikel Sharding vs. Partitioning.
MongoDB vs. PostgreSQL: Use-Case-Analyse
Nun, da die Kernfeatures und Stärken beider Systeme klar sind, betrachten wir typische Einsatzszenarien.
Wann PostgreSQL ideal ist
PostgreSQL ist eine gute Wahl, wenn dein Projekt Folgendes erfordert:
Konkrete Beispiele, bei denen PostgreSQL sinnvoll ist:
Wann MongoDB am besten passt
MongoDB spielt seine Stärken aus, wenn flexible Strukturen benötigt werden, die sich dynamisch an neue Informationen und Schemata anpassen, wenn Skalierung und Performance zählen und bei unstrukturierten Daten. Das schemalose Design in Kombination mit Horizontal-Skalierung eignet sich z. B. für:
Hybride Architekturen
Mitunter ist eine Kombination aus MongoDB und PostgreSQL sinnvoll, um unterschiedliche Anforderungen abzudecken. Hybride Architekturen aus SQL- und NoSQL-Datenbanken sind machbar und empfehlenswert, wenn du starke Konsistenz für Transaktionen mit Flexibilität verbinden willst.
Beispielsweise kannst du MongoDB für schnelle Writes in Echtzeitanalysen nutzen und PostgreSQL für komplexe relationale Operationen und strukturierte Daten. Eine echte „Verschmelzung“ der Funktionen gibt es nicht – du betreibst zwei Systeme parallel. Das erhöht die Komplexität und sollte gut abgewogen werden.
Wichtige Punkte bei Migrationen
Wenn du Daten zwischen MongoDB und PostgreSQL migrieren willst, beachte Folgendes:
Datenbankschemata
Bei der Migration von MongoDB zu PostgreSQL musst du vorab Tabellen mit einem definierten Schema anlegen, also Spalten, Datentypen und ggf. Constraints. Umgekehrt solltest du bei der Migration nach MongoDB festlegen, wie die Daten in Dokumente überführt werden. Trotz Flexibilität ist ein gewisses Datenmodell für die saubere Ablage erforderlich.
Mögliche Datentransformationen
Exportierte Daten liegen möglicherweise nicht im Wunschformat vor. Dann brauchst du vor der Migration eine Datenpipeline, die das Format passend für PostgreSQL oder MongoDB transformiert.
Vorgehen bei der Migration
Für Migrationen gibt es mehrere Wege. Manuell ist bei einfachen Export/Import-Schritten möglich, aber zeitaufwändig, komplex und fehleranfällig – vor allem bei großen Datenmengen. Daher kann ein ELT-Tool die bessere Wahl sein. Es gibt zahlreiche Lösungen, sowohl für PostgreSQL-→MongoDB als auch umgekehrt.
Performanceoptimierung
Gerade bei komplexen Migrationen ist Performance zentral. Je nach Quelle und Ziel stellen PostgreSQL und MongoDB Techniken bereit, um den Prozess zu beschleunigen, darunter Connection Pooling, Partitionierung, Wahl geeigneter Shard Keys und Covered Queries.
Sicherheit und Compliance
Die Absicherung deiner Datenbank ist entscheidend für Integrität, Verfügbarkeit und Compliance. Sowohl MongoDB als auch PostgreSQL bieten verschiedene Schutzmaßnahmen. Hier die häufigsten Ansätze.
Authentifizierungsmechanismen
PostgreSQL bietet diverse Authentifizierungsverfahren, die über Rollen effizient verwaltet werden. Rollen können Objekte besitzen und Rechte halten, dienen der Authentifizierung, Rechtevergabe und Zugriffsteuerung. Eine Rolle kann als Nutzer oder Nutzergruppe fungieren.
Auch in MongoDB lassen sich Rollen anlegen, um unbefugten Zugriff zu verhindern. Die rollenbasierte Kontrolle folgt dem Least-Privilege-Prinzip. Als Standard für passwortbasierte Authentifizierung verwendet MongoDB SCRAM (Salted Challenge Response Authentication Mechanism).
Verschlüsselungspraktiken
MongoDB bietet verschiedene Optionen zur Verschlüsselung deiner Daten, darunter:
Auch PostgreSQL bietet Verschlüsselung auf mehreren Ebenen und schützt Daten vor Offenlegung – etwa bei Serverdiebstahl, unredlichen Administratoren oder unsicheren Netzen. Optionen sind u. a.:
Community und Ökosystem
MongoDB und PostgreSQL sind sehr beliebt, mit wachsenden Communities und lebendigen Ökosystemen. Ein kurzer Blick darauf.
Erweiterungen
PostgreSQL-Erweiterungen sind Add-ons, die den Funktionsumfang erweitern – vergleichbar mit Paketen in Python oder R. In den letzten Jahren ist ein reiches Ökosystem entstanden, das PostgreSQL für unterschiedlichste Szenarien aufrüstet. Viele findest du im PostgreSQL Extension Network.
MongoDB bietet im Vergleich weniger Erweiterungen; diese zielen vor allem auf die Einbindung in andere Technologien und Frameworks ab, etwa IDEs wie Visual Studio Code oder Cloud-Plattformen wie Google Cloud. Zusätzlich gibt es Third-Party-Pakete für verschiedene Programmiersprachen, mit denen du MongoDB verwaltest.
Adoption-Trends
Beide Systeme erleben derzeit Hochkonjunktur – die folgende Grafik zu Datenbanktrends (DB-Engines) zeigt es.
Quelle: db-engines
Relationale Systeme dominieren weiterhin (PostgreSQL auf Rang 4). Gleichzeitig zeigt sich ein deutlicher Aufschwung von NoSQL-Datenbanken wie MongoDB und Redis. Der Trend spiegelt die wachsende Verbreitung flexibler, skalierbarer Lösungen für unstrukturierte Daten und Anwendungen mit hohem Traffic wider.
Vergleichstabelle: PostgreSQL vs. MongoDB
Diese Tabelle fasst die Unterschiede zwischen MongoDB und PostgreSQL zusammen:
Feature
MongoDB
PostgreSQL
Datenstruktur
Speichert Daten als Dokumente (z. B. JSON, BSON) und erlaubt flexible, hierarchische Strukturen.
Speichert Daten in Tabellen mit Zeilen und Spalten auf Basis eines vordefinierten Schemas.
Schema-Flexibilität
Schemalos: Dokumente können unterschiedliche Strukturen, Felder und Datentypen haben.
Festes Schema: Benötigt ein vordefiniertes Schema mit konkreten Spalten und Datentypen.
Abfragesprache
Verwendet die MongoDB Query Language (MQL) o.ä., objektbasiert und flexibler.
Verwendet SQL (Structured Query Language) für strukturierte Abfragen.
Joins
Vermeidet Joins durch Einbettung verwandter Daten in Dokumente (Denormalisierung).
Unterstützt komplexe Joins über Tabellen (Normalisierung).
Performance
Schnelle Reads/Writes bei un- oder semistrukturierten Daten; kein Join-Overhead.
Stark bei strukturierten Daten; Joins können Abfragen verlangsamen.
Skalierbarkeit
Horizontal skalierbar: Verteilung über mehrere Server via Sharding.
Typisch vertikal: Setzt auf leistungsfähere Hardware; horizontale Skalierung teils via Partitionierung.
Transaktionen
Unterstützt Multi-Dokument-ACID-Transaktionen (ab MongoDB 4.0), war ursprünglich aber nicht darauf ausgelegt.
Vollständige ACID-Unterstützung für hohe Konsistenz und Zuverlässigkeit.
Use Cases
Optimal für un- oder semistrukturierte Daten wie Profile, Logs, Kataloge und flexible Strukturen.
Ideal für strukturierte Daten mit klaren Beziehungen, z. B. Finanzdaten oder ERP.
Datenbeziehungen
Setzt auf eingebettete Daten (Denormalisierung), sodass zusammengehörige Infos per Einzelabfrage abrufbar sind.
Relationale Datenbanken arbeiten mit Fremdschlüsseln zur Beziehung über Tabellen (Normalisierung).
Indexierung
Unterstützt Indizes, jedoch weniger Varianten und Tiefe als relationale Systeme.
Umfangreiche Indexierung (z. B. B-Tree, Hash) zur Performanceoptimierung.
Konsistenz
Bietet in verteilten Setups Eventual Consistency, kann bei Bedarf über ACID auch starke Konsistenz liefern.
Sichert in der Regel starke Konsistenz dank ACID und relationaler Integrität.
Skalierung des Datenvolumens
Lässt sich durch Hinzufügen von Servern (Sharding) leicht erweitern.
Kann vertikal wachsen; horizontale Skalierung erfordert komplexere Konfiguration (z. B. Partitionierung).
Datenintegrität
Integrität wird innerhalb von Dokumenten gewahrt; Beziehungen zwischen Dokumenten sind aufwendiger.
Starke Integrität über Primär-/Fremdschlüssel und Constraints wie UNIQUE oder NOT NULL.
Entwicklerfreundlichkeit
Entwicklerfreundlich: Flexibles Datenmodell, gut für moderne Apps (z. B. JSON, REST-APIs).
Strengeres Datenmodell, aber vertraut für Entwickler mit SQL- und Struktur-Datenkenntnissen.
Fazit
MongoDB und PostgreSQL gehören zu den beliebtesten Datenbanken. Sie stehen exemplarisch für NoSQL bzw. SQL. Der Vergleich zeigt Unterschiede, Stärken und Einsatzfälle, in denen die jeweilige Datenbank punktet.
Zu SQL und NoSQL gibt es viel zu lernen. DataCamp unterstützt dich mit aktuellen, umfassenden Kursen und Tutorials. Hier findest du passendes Material: