Curso
Creación de bases de datos en PostgreSQL
4 h
22.5K
Si vas a poner en marcha una nueva aplicación digital, casi seguro que necesitarás recopilar y almacenar datos. Dónde y cómo guardarlos es una de las decisiones más importantes que tendrás que tomar: todo el software dependerá de esos datos para funcionar.
Tradicionalmente, los datos se han almacenado en tablas con filas y columnas conectadas por ciertas relaciones (por ejemplo, columnas en común). Las bases de datos que almacenan datos relacionales se llaman bases de datos relacionales, o bases de datos SQL, porque la mayoría, si no todas, se basan en SQL para todo tipo de operaciones.
Sin embargo, en las últimas décadas han surgido nuevos sistemas de gestión de bases de datos para responder al rápido aumento del volumen y la variedad de datos que se crean cada segundo. Las llamadas bases de datos NoSQL (Not only SQL) proponen nuevos esquemas y estrategias para recopilar datos de forma eficaz según casos de uso específicos, aunque en cierta medida sigan apoyándose en SQL.
En este artículo, analizaremos dos sistemas de gestión de bases de datos muy populares: PostgreSQL vs MongoDB. El primero es una de las bases de datos SQL más extendidas, mientras que el segundo es la base de datos NoSQL más conocida.
Veremos las características clave y los puntos fuertes de ambas, sus casos de uso más convincentes y aspectos a tener en cuenta si estás pensando en migrar tus datos a una de estas bases de datos.
Si quieres ensuciarte las manos y probar cada enfoque, echa un vistazo a nuestros cursos Creating PostgreSQL Databases e Introduction to MongoDB in Python.
Elegir bien la base de datos es crucial para cualquier aplicación digital. PostgreSQL, una potente base de datos relacional basada en SQL, destaca con datos estructurados que requieren consistencia, joins complejos y transacciones ACID. MongoDB, una base de datos de documentos NoSQL que usa BSON, es ideal para datos dinámicos y no estructurados, y ofrece mayor escalabilidad mediante sharding horizontal. La elección entre PostgreSQL y MongoDB depende, en última instancia, de la estructura de datos de tu proyecto, sus necesidades de escalado y los requisitos de consistencia.
Analicemos las principales diferencias entre PostgreSQL y MongoDB en términos de arquitectura del modelo de datos.
Los sistemas de gestión de bases de datos relacionales, como PostgreSQL, organizan los datos en tablas, donde cada tabla consta de filas y columnas. Estas tablas pueden vincularse mediante claves, lo que permite relaciones de datos complejas a través de joins en SQL y consultas eficientes.
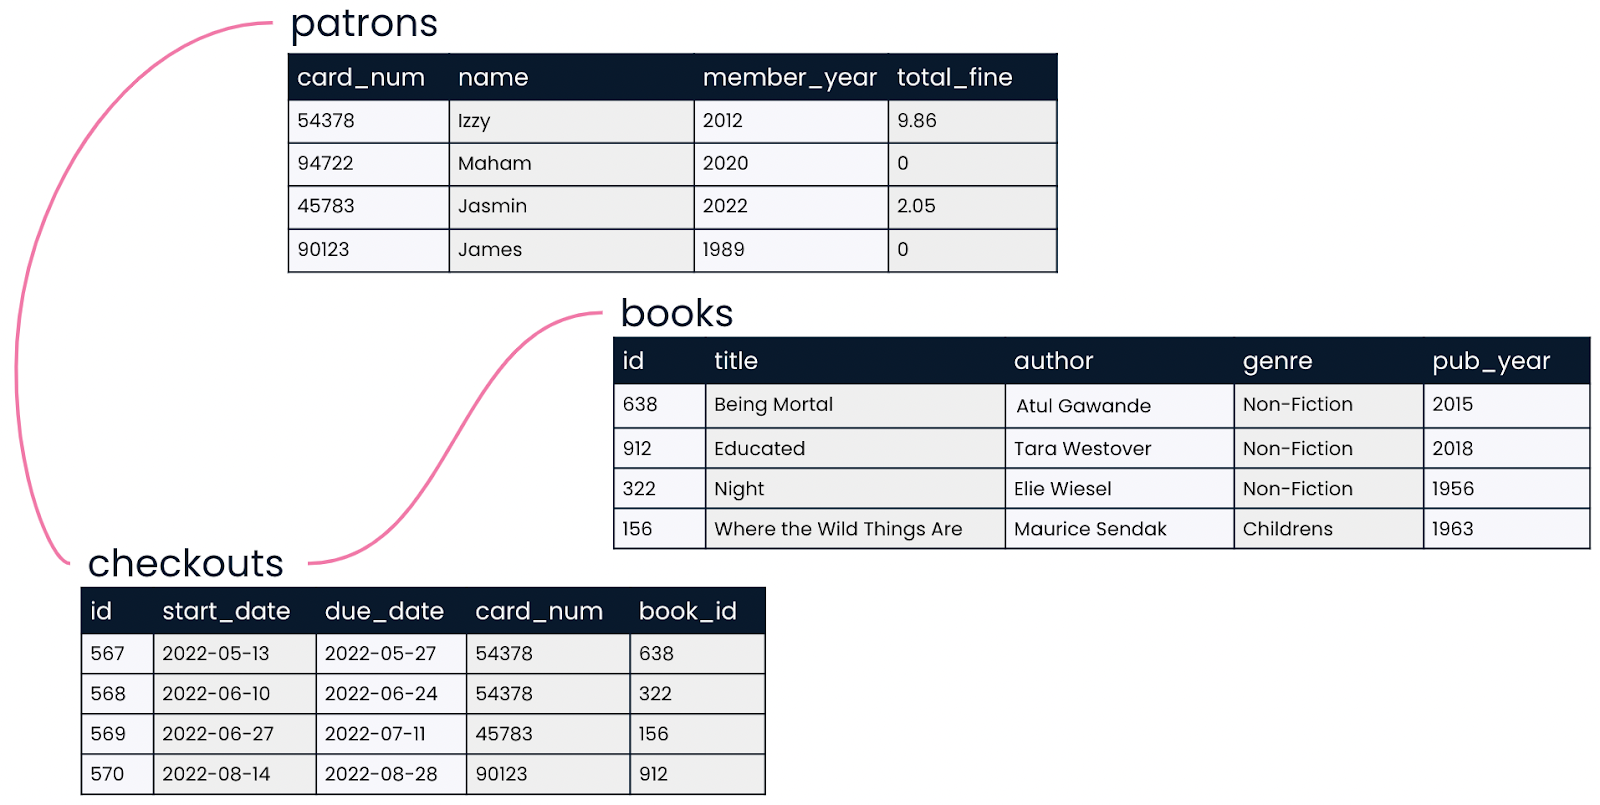
Base de datos relacional. Fuente: DataCamp
Gracias a su simplicidad, eficiencia y consistencia, las bases de datos relacionales han sido extremadamente exitosas y se han adoptado masivamente en las últimas décadas.
No obstante, pueden no ser la mejor opción cuando trabajas con datos no estructurados que no encajan bien en un formato tabular (por ejemplo, publicaciones en redes sociales, datos de sensores) o cuando la escalabilidad es imprescindible; es decir, cuando tu aplicación necesita escalar horizontalmente en numerosos servidores.
Aquí es donde entran en juego las bases de datos NoSQL. A diferencia de sus homólogas relacionales, las bases de datos NoSQL pueden manejar datos no estructurados o semiestructurados sin las limitaciones de un esquema fijo.
En particular, MongoDB es una base de datos de documentos, un tipo de base de datos NoSQL que almacena datos en colecciones de documentos similares a JSON usando un formato llamado BSON (Binary JSON). En pocas palabras, los documentos son parecidos a objetos clave-valor en JSON, con capacidades adicionales para almacenar y manipular datos gracias a BSON.
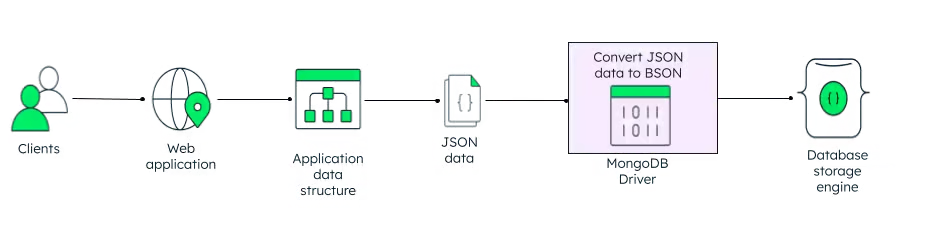
Cómo almacena MongoDB los datos como BSON. Fuente: DataCamp
La naturaleza flexible de BSON permite crear esquemas de documentos dinámicos cuyo contenido y estructura pueden variar sobre la marcha. Veremos más en el siguiente apartado.
Las bases de datos relacionales como PostgreSQL proporcionan esquemas robustos que son difíciles de modificar una vez que creas tus tablas. Es una gran ventaja si los datos con los que trabajas tienen naturaleza tabular y siempre llegan a tu aplicación con el mismo formato. Sin embargo, si tratas con datos semiestructurados o no estructurados cuyo contenido puede variar de un elemento a otro, como publicaciones en redes sociales o datos de sensores, necesitarás cierto nivel de flexibilidad para digerirlos.
A diferencia de PostgreSQL, MongoDB ofrece diseños sin esquema, que brindan una flexibilidad excepcional para manejar datos diversos y en evolución. El diseño sin esquema de MongoDB organiza los datos en documentos y colecciones:
A diferencia de las bases de datos relacionales tradicionales, donde añadir un nuevo campo exige alterar toda la estructura de la tabla, MongoDB permite que los documentos de una misma colección tengan campos y estructuras completamente diferentes. Esto elimina la necesidad de esquemas rígidos y facilita almacenar datos variados sin forzar la uniformidad.
Independientemente de la base de datos que uses, ya sea PostgreSQL o MongoDB, tendrás que aprender el lenguaje para comunicarte y gestionarla. En PostgreSQL, es SQL, un lenguaje de programación extremadamente popular, estandarizado y sencillo de usar. Puedes iniciarte con SQL en nuestro curso Introduction to SQL.
Por el contrario, MongoDB se apoya principalmente en su propio lenguaje, MongoDB Query Language (MQL), para interactuar con la base de datos. No obstante, también es posible usar otros lenguajes populares, como Python, C y Java, para conectar e interactuar con bases de datos MongoDB.
Veamos las principales diferencias entre SQL y MQL.
Una de las grandes ventajas de PostgreSQL frente a MongoDB es el uso de SQL. SQL (del inglés "Structured Query Language") es un lenguaje esencial para crear y mantener bases de datos relacionales.
Es un lenguaje sencillo y específico del dominio que utilizan casi todos los sistemas de bases de datos relacionales, como MySQL, SQL Server, SQLite y, por supuesto, PostgreSQL.
SQL es extremadamente potente y te permite realizar todo tipo de operaciones con datos, desde recuperación y agregación hasta limpieza y joins. Sin embargo, en PostgreSQL las posibilidades son aún mayores, ya que incorpora un conjunto de capacidades avanzadas para análisis complejos, entre ellas:
Por su parte, aunque MongoDB no usa SQL, dispone de potentes capacidades de consulta, indexación y agregación, además de funciones para insertar, actualizar o eliminar información en bases de datos de documentos. Por tanto, si ya estás familiarizado con JSON o con los diccionarios de Python, te resultará sencillo habituarte a la sintaxis de MQL.
MQL está diseñado específicamente para manejar la naturaleza dinámica de los documentos. Como resultado, es un lenguaje mucho más flexible que SQL. Además, como los documentos pueden anidar otros documentos, en MongoDB no es necesario recurrir a joins complejos e ineficientes, algo habitual en bases de datos relacionales.
Los índices son objetos de base de datos que mejoran la velocidad de las operaciones de recuperación de datos. Actúan como punteros para localizar rápidamente filas en una tabla y mejorar el rendimiento de las consultas.
PostgreSQL incorpora sólidas capacidades de indexación y admite varios tipos de índices, entre ellos:
MongoDB también admite indexación para encontrar documentos en colecciones sin tener que escanearlos todos. Sin embargo, sus capacidades son más limitadas y carece de la variedad y sofisticación de índices disponible en bases de datos relacionales como PostgreSQL. Entre ellas:
Usar índices en tus bases de datos SQL y NoSQL es clave para aumentar el rendimiento y reducir los tiempos de consulta, especialmente en conjuntos de datos grandes.
Eso sí, recuerda que añadir un índice también puede afectar negativamente al rendimiento de las escrituras. En tablas o colecciones con una alta proporción de escrituras frente a lecturas, los índices son costosos porque cada inserción debe actualizar los índices.
MongoDB y PostgreSQL son excelentes herramientas, pero no tiene sentido elegir una u otra solo por sus propiedades. Deberías decidir siempre en función de las particularidades de tu caso de uso. Con esto en mente, analicemos las diferencias de rendimiento y escalabilidad entre MongoDB y PostgreSQL.
Como otros sistemas relacionales populares, PostgreSQL garantiza altos niveles de integridad y calidad de datos gracias a su sólido sistema de tipado y a su compatibilidad con transacciones ACID (Atomicidad, Consistencia, Aislamiento y Durabilidad).
Las transacciones ACID son un conjunto de propiedades que garantizan el procesamiento fiable de transacciones en bases de datos. Aseguran que los datos se mantengan exactos y seguros incluso ante errores, caídas o accesos concurrentes. Estas propiedades son vitales para preservar la calidad de los datos en cualquier proyecto.
Aunque las transacciones ACID han sido el estándar de oro para garantizar la integridad en bases de datos relacionales, las bases NoSQL como MongoDB a menudo priorizan la flexibilidad y la escalabilidad frente a una consistencia transaccional estricta. Esto conlleva relajar algunas de las propiedades ACID presentes en las bases relacionales.
Por ejemplo, algunas implementaciones de MongoDB priorizan la consistencia eventual frente a la consistencia inmediata, lo que significa que los cambios pueden no reflejarse en todos los nodos de forma instantánea. Este equilibrio entre consistencia, disponibilidad y rendimiento permite mejorar rendimiento y escalabilidad, pero exige diseñar con cuidado las aplicaciones que dependen de una consistencia estricta.
Escalar implica varias técnicas para afrontar incrementos de volumen de datos y tráfico. En términos sencillos, podemos hacerlo mediante escalado vertical y horizontal. El primero consiste en mejorar y añadir recursos al mismo servidor para gestionar más carga. El segundo se logra añadiendo más servidores o nodos a un sistema distribuido, aumentando así su capacidad.
PostgreSQL se apoya principalmente en el escalado vertical para aumentar la capacidad. No obstante, a diferencia de otras bases SQL populares, PostgreSQL también permite el escalado horizontal mediante particionado, aunque requiere configuraciones complejas. Puedes aprender los detalles técnicos del particionado en PostgreSQL en nuestro curso Improving Query Performance in PostgreSQL.
Por el contrario, en sistemas NoSQL como MongoDB, la estrategia de referencia para manejar el crecimiento del tráfico y el volumen de datos es el escalado horizontal. MongoDB está diseñado para aprovechar el sharding, una técnica que divide una base de datos en piezas más pequeñas y manejables llamadas "shards" y las distribuye en varios servidores, lo que permite gestionar grandes volúmenes de datos y altos niveles de tráfico.
Consulta nuestro artículo Sharding vs Partitioning para conocer a fondo estas técnicas de escalado.
Ahora que conocemos las características clave y los puntos fuertes de PostgreSQL y MongoDB, toca analizar en qué escenarios resultan más útiles.
PostgreSQL es una gran elección cuando tu proyecto requiere:
A modo de ejemplo, PostgreSQL es una apuesta segura en:
MongoDB brilla cuando conviene contar con estructuras de datos flexibles que se adapten dinámicamente a nueva información y esquemas, cuando importan la escalabilidad y el rendimiento, y con datos no estructurados. Su diseño sin esquema, junto con el escalado horizontal, lo hace ideal para casos como:
Puede haber casos en los que te interese combinar las fortalezas de MongoDB y PostgreSQL para cubrir requisitos de datos diversos. Crear arquitecturas híbridas que combinen bases de datos SQL y NoSQL es posible, y una gran idea si necesitas unir consistencia fuerte en transacciones con cierto grado de flexibilidad.
Por ejemplo, puedes usar MongoDB para escrituras rápidas en analítica en tiempo real y PostgreSQL para operaciones relacionales complejas y almacenamiento de datos estructurados. Eso sí, hoy no existe una forma de "fusionar" las funcionalidades de ambas: estarás usando dos bases distintas a la vez, lo que incrementa la complejidad del sistema y requiere un análisis cuidadoso antes de implementarlo.
Si estás planeando migrar datos de MongoDB a PostgreSQL o a la inversa, tendrás que valorar varios elementos:
Si migras de MongoDB a PostgreSQL, antes de mover los datos tendrás que crear una tabla o varias con un esquema predefinido; es decir, una lista de columnas con sus tipos y posibles restricciones. Si quieres mover tus datos a Mongo, deberás definir cómo se incorporarán a los documentos. A pesar de la flexibilidad de los documentos, será esencial cierto modelado de datos para ubicar la información existente.
Es posible que los datos que quieras exportar no tengan el formato deseado. Si es así, antes de migrar tendrás que establecer algún tipo de pipeline para transformarlos al formato correcto antes de insertarlos en la base de datos de PostgreSQL o MongoDB.
Hay varias formas de realizar una migración. Puedes hacerlo manualmente para exportaciones/importaciones básicas, pero puede ser un proceso largo, complejo y propenso a errores, especialmente si la base que quieres migrar contiene muchos datos. Por eso, optar por una herramienta ELT puede ser mejor solución. Hay muchas opciones disponibles, tanto para migrar de PostgreSQL a Mongo como a la inversa.
Valorar técnicas para aumentar el rendimiento durante la migración es crucial, sobre todo en procesos complejos. De nuevo, según el origen y el destino, PostgreSQL y MongoDB ofrecen técnicas y estrategias específicas para acelerar el proceso, como pools de conexiones, particionado, selección de shard key y consultas cubiertas.
Proteger el despliegue de tu base de datos es fundamental para garantizar la integridad, disponibilidad y cumplimiento. Tanto MongoDB como PostgreSQL ofrecen diversos métodos para asegurar tus bases. En esta sección cubrimos algunas de las técnicas más comunes.
PostgreSQL incluye varios métodos de autenticación, que pueden gestionarse eficazmente a través de roles. Los roles son entidades que pueden poseer objetos de base de datos y tener privilegios. Pueden usarse para autenticación, gestión de permisos y definición de niveles de acceso. En PostgreSQL, un rol puede funcionar como usuario o como grupo de usuarios.
En MongoDB también puedes crear roles para evitar accesos no autorizados. El control basado en roles sigue el principio de mínimo privilegio para minimizar riesgos. MongoDB incorpora varios mecanismos de autenticación, siendo SCRAM (Salted Challenge Response Authentication Mechanism) el mecanismo por defecto para autenticación segura basada en contraseña.
MongoDB ofrece numerosas prácticas de cifrado para proteger tus datos, entre ellas:
En cuanto a PostgreSQL, también ofrece cifrado en varios niveles y aporta flexibilidad para proteger los datos frente a robos del servidor, administradores deshonestos y redes inseguras. Algunas opciones incluyen:
Tanto MongoDB como PostgreSQL son herramientas muy populares, con comunidades en crecimiento y ecosistemas muy vivos. Veámoslos.
Las extensiones de PostgreSQL son módulos adicionales que amplían las capacidades de la base de datos. Son como los paquetes en Python o R. En los últimos años, ha surgido un rico ecosistema de extensiones para potenciar PostgreSQL en todo tipo de escenarios, disciplinas y casos de uso. La mayoría pueden encontrarse en la PostgreSQL Extension Network.
En cambio, MongoDB cuenta con un conjunto más limitado de extensiones y se centra sobre todo en habilitar su uso con otras tecnologías y frameworks, como IDEs tipo Visual Studio Code, y sistemas cloud como Google Cloud. Aun así, puede haber paquetes de terceros disponibles para los distintos lenguajes que uses para gestionar MongoDB.
Tanto PostgreSQL como MongoDB viven un gran momento, como muestra la siguiente imagen con las tendencias de motores de bases de datos basada en datos de DB-Engines.
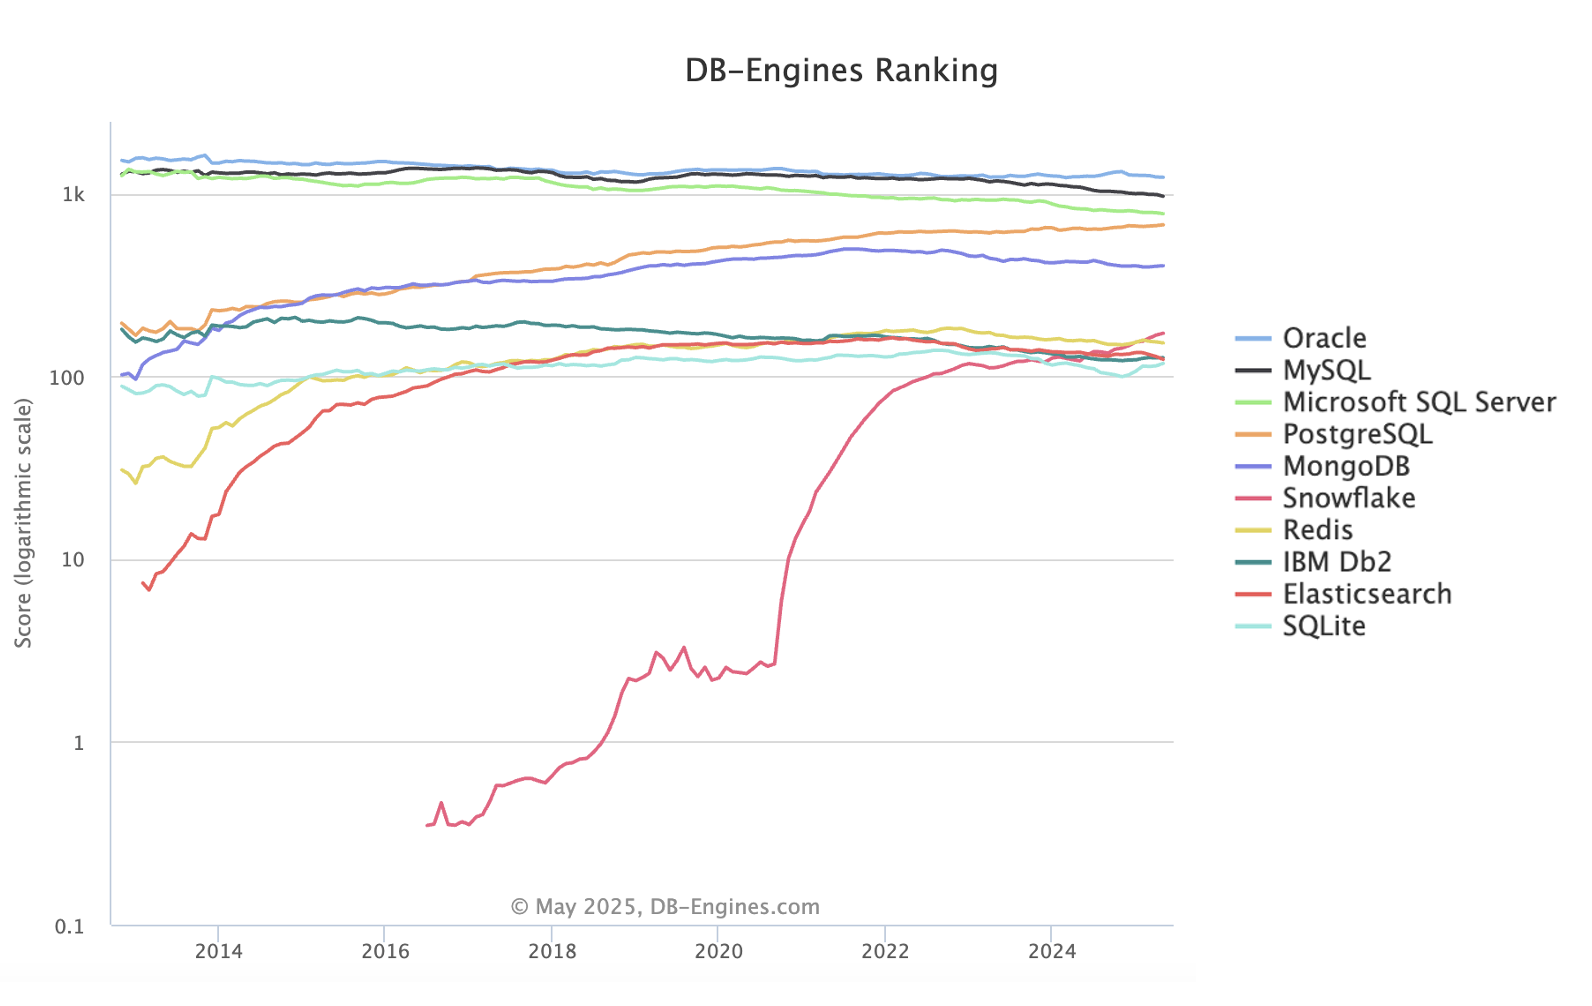
Fuente: db-engines
Aunque los sistemas de bases de datos relacionales siguen siendo dominantes (incluido PostgreSQL, que ocupa el 4.º puesto), el gráfico también revela un cambio notable en los últimos años, con bases NoSQL como MongoDB y Redis creciendo con fuerza. Esta tendencia al alza refleja la adopción creciente de soluciones flexibles y escalables para gestionar datos no estructurados y soportar aplicaciones de alto tráfico.
Aquí tienes una tabla que resume las diferencias entre MongoDB y PostgreSQL:
|
Función |
MongoDB |
PostgreSQL |
|
Estructura de datos |
Almacena datos como documentos (p. ej., JSON, BSON), permitiendo estructuras flexibles y jerárquicas. |
Almacena datos en tablas con filas y columnas, siguiendo un esquema predefinido. |
|
Flexibilidad del esquema |
Sin esquema: los documentos pueden tener estructuras variables, con distintos campos y tipos de datos. |
Esquema fijo: requiere un esquema predefinido con columnas y tipos específicos. |
|
Lenguaje de consulta |
Usa MongoDB Query Language (MQL) u otro similar, basado en objetos y más flexible. |
Usa SQL (Structured Query Language) para consultar datos estructurados. |
|
Joins |
Evita joins incrustando datos relacionados dentro de los documentos (desnormalización). |
Admite joins complejos entre tablas (normalización). |
|
Rendimiento |
Lecturas y escrituras más rápidas con datos no estructurados o semiestructurados. Evita la sobrecarga de los joins. |
Gran rendimiento con datos estructurados, aunque los joins pueden ralentizar las consultas. |
|
Escalabilidad |
Escala horizontalmente: puede distribuir datos entre varios servidores mediante sharding. |
Normalmente escala verticalmente: depende de hardware más potente, aunque admite cierto escalado horizontal (p. ej., con particiones). |
|
Soporte de transacciones |
Admite transacciones ACID multidocumento (desde MongoDB 4.0), pero se diseñó inicialmente para operaciones no transaccionales. |
Soporte completo de transacciones ACID, con consistencia y fiabilidad sólidas. |
|
Casos de uso |
Ideal para datos no estructurados o semiestructurados como perfiles de usuario, logs, catálogos y estructuras flexibles. |
Idóneo para datos estructurados con relaciones claras, como registros financieros o ERP. |
|
Relaciones de datos |
Soporta datos incrustados (desnormalización), facilitando recuperar información relacionada con una sola consulta. |
Las bases relacionales usan claves externas para establecer relaciones entre tablas (normalización). |
|
Indexación |
Admite indexación, pero sin la variedad y sofisticación de los sistemas relacionales. |
Capacidades de indexación sólidas, con múltiples tipos (p. ej., B-tree, hash) para optimizar el rendimiento. |
|
Consistencia |
Proporciona consistencia eventual en entornos distribuidos, pero también ofrece consistencia fuerte cuando se necesita (vía transacciones ACID). |
Garantiza consistencia fuerte en la mayoría de los casos gracias a ACID y la integridad relacional. |
|
Escalado de volumen |
Escala fácilmente añadiendo servidores (sharding) para manejar grandes volúmenes. |
Puede escalar verticalmente, pero el escalado horizontal requiere configuraciones más complejas (p. ej., particionado). |
|
Integridad de datos |
La integridad se gestiona dentro de cada documento, pero las relaciones entre documentos son más complejas de mantener. |
Sólido soporte integrado mediante claves primarias y externas, y restricciones como UNIQUE y NOT NULL. |
|
Facilidad para desarrolladores |
Amigable: modelado flexible, encaja bien con apps modernas (JSON, REST APIs). |
Modelado más rígido, pero muy conocido por desarrolladores familiarizados con SQL y datos estructurados. |
MongoDB y PostgreSQL son dos de las bases de datos más populares. Son grandes ejemplos de bases SQL y NoSQL y, al compararlas, podemos aclarar diferencias, fortalezas y casos de uso en los que cada una aporta más valor.
Hay mucho que aprender sobre bases de datos SQL y NoSQL. En DataCamp, queremos ayudarte con los cursos y tutoriales más completos y actualizados. Echa un vistazo a nuestro material específico sobre bases de datos:
Top DataCamp Courses
Curso
Curso
Curso
blog
Mona Khalil
5 min
blog
Kurtis Pykes
11 min
blog
Gus Frazer
14 min
Tutorial
Javier Canales Luna
14 min
Tutorial
Nic Raboy
Tutorial
Moez Ali
10 min