
Last chance! 50% off DataCamp Premium
Sale ends in
यदि आप कोई नया डिजिटल एप्लिकेशन शुरू करने की योजना बना रहे हैं, तो संभवतः आपको कुछ डेटा एकत्र और संग्रहीत करने की आवश्यकता होगी। उस डेटा को कहाँ और कैसे संग्रहीत करना है, यह सबसे महत्वपूर्ण निर्णयों में से एक है, क्योंकि पूरा सॉफ़्टवेयर उसके सही ढंग से काम करने के लिए उसी डेटा पर निर्भर करेगा।
परंपरागत रूप से, डेटा को तालिकाओं में पंक्तियों और स्तंभों के रूप में संग्रहीत किया जाता रहा है, जो कुछ संबंधों (जैसे, सामान्य कॉलम) के माध्यम से जुड़े होते हैं। जो डेटाबेस रिलेशनल डेटा संग्रहीत करते हैं, उन्हें रिलेशनल डेटाबेस या SQL डेटाबेस कहा जाता है, क्योंकि अधिकांश, अगर सभी नहीं, तो हर तरह के ऑपरेशन के लिए SQL पर निर्भर होते हैं।
हालांकि, हाल के दशकों में, हर सेकंड बनने वाले डेटा की मात्रा और विविधता में तेजी से वृद्धि को संबोधित करने के लिए नए डेटाबेस मैनेजमेंट सिस्टम विकसित हुए हैं। तथाकथित NoSQL डेटाबेस (Not only SQL) विशिष्ट उपयोग मामलों के आधार पर डेटा को प्रभावी ढंग से एकत्र करने के लिए नए स्कीमा और रणनीतियाँ पेश करते हैं, जबकि कुछ हद तक SQL पर भी निर्भर रहते हैं।
इस लेख में, हम दो लोकप्रिय डेटाबेस मैनेजमेंट सिस्टम का विश्लेषण करेंगे: PostgreSQL बनाम MongoDB। पहला सबसे लोकप्रिय SQL डेटाबेस में से एक है, जबकि दूसरा सबसे प्रसिद्ध NoSQL डेटाबेस है।
हम दोनों डेटाबेस की प्रमुख विशेषताओं और मजबूती, उनके सबसे प्रभावी उपयोग मामलों, और वे बातें कवर करेंगे जिन्हें आपको याद रखना चाहिए यदि आप अपना डेटा इनमें से किसी एक डेटाबेस में माइग्रेट करने पर विचार कर रहे हैं।
यदि आप व्यावहारिक रूप से हर विधि आज़माना चाहते हैं, तो हमारे कोर्स Creating PostgreSQL Databases और Introduction to MongoDB in Python ज़रूर देखें।
किसी भी डिजिटल एप्लिकेशन के लिए सही डेटाबेस चुनना अत्यंत महत्वपूर्ण है। PostgreSQL, एक शक्तिशाली SQL-आधारित रिलेशनल डेटाबेस, संरचित डेटा परिदृश्यों में उत्कृष्ट है जहाँ संगति, जटिल जोइन, और ACID ट्रांज़ैक्शन आवश्यक होते हैं। MongoDB, एक लचीला NoSQL डॉक्यूमेंट डेटाबेस जो BSON का उपयोग करता है, गतिशील, असंरचित डेटा को संभालने के लिए आदर्श है और क्षैतिज शार्डिंग के माध्यम से अधिक स्केलेबिलिटी प्रदान करता है। अंततः, PostgreSQL और MongoDB के बीच चयन आपके प्रोजेक्ट की डेटा संरचना, स्केलेबिलिटी की ज़रूरतों और संगति आवश्यकताओं पर निर्भर करता है।
आइए डेटा मॉडल आर्किटेक्चर के संदर्भ में PostgreSQL और MongoDB के मुख्य अंतरों का विश्लेषण करें।
PostgreSQL जैसे रिलेशनल डेटाबेस मैनेजमेंट सिस्टम डेटा को तालिकाओं में व्यवस्थित करते हैं, जहाँ प्रत्येक तालिका पंक्तियों और स्तंभों से बनी होती है। ये तालिकाएँ कीज़ के माध्यम से जोड़ी जा सकती हैं, जिससे SQL जोइन्स और दक्ष क्वेरीइंग के माध्यम से जटिल डेटा संबंध संभव होते हैं।
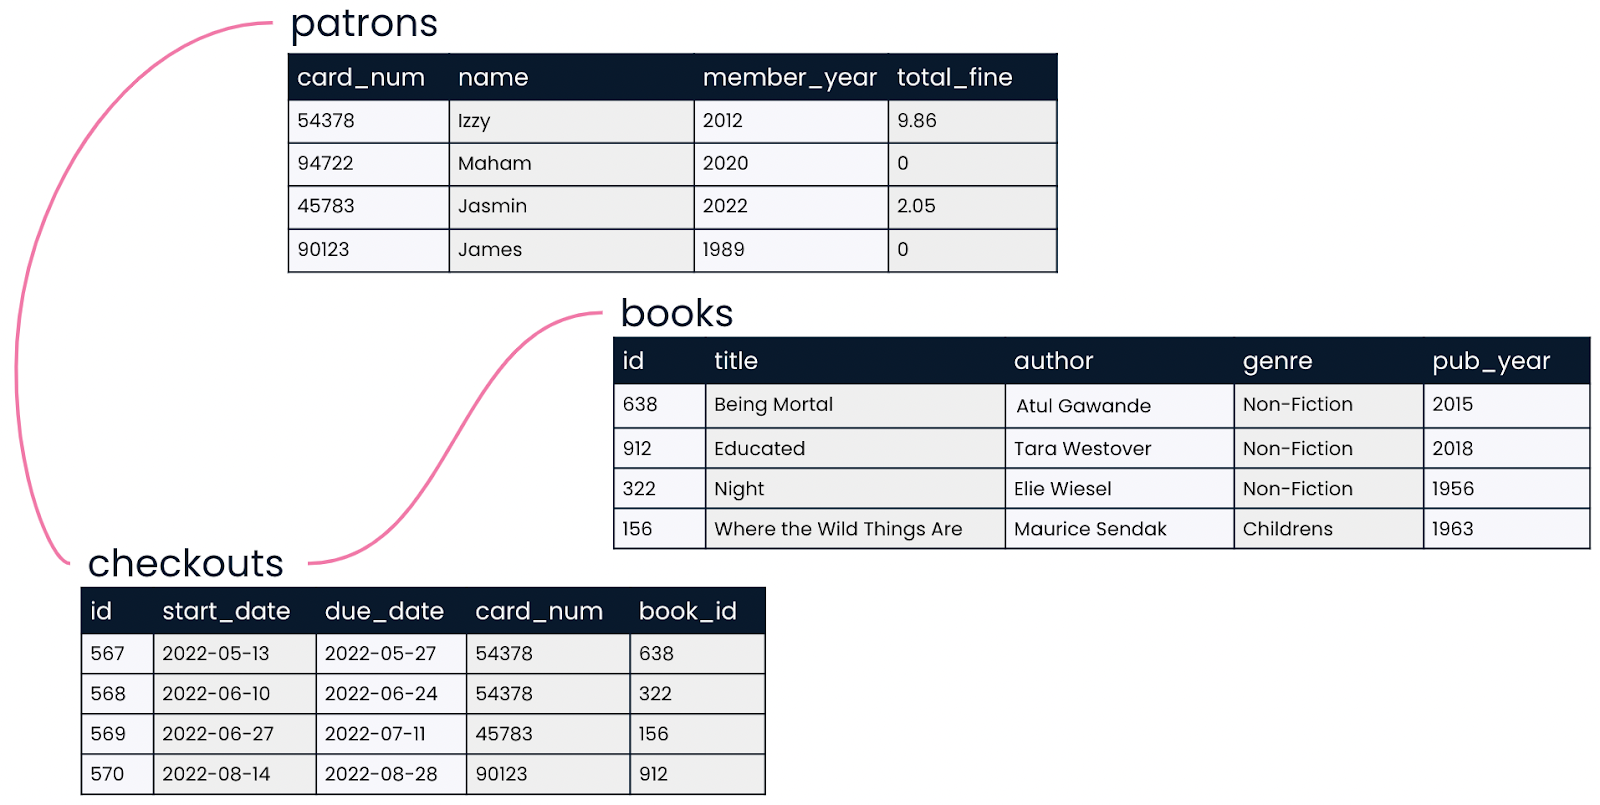
रिलेशनल डेटाबेस। स्रोत: DataCamp
अपनी सरलता, विशिष्ट दक्षता और मजबूत संगति के कारण, रिलेशनल डेटाबेस पिछले दशकों में अत्यंत सफल और व्यापक रूप से अपनाए गए हैं।
हालाँकि, जब आप असंरचित डेटा के साथ काम करते हैं जो सुव्यवस्थित टैबुलर प्रारूप में नहीं बैठता (जैसे, सोशल मीडिया पोस्ट, सेंसर डेटा) या जब स्केलेबिलिटी अनिवार्य होती है; अर्थात, जब आपके एप्लिकेशन को कई सर्वरों में क्षैतिज रूप से स्केल करना हो, तब वे सबसे अच्छा विकल्प नहीं हो सकते।
यहीं पर NoSQL डेटाबेस दृश्य में आते हैं। रिलेशनल समकक्षों के विपरीत, NoSQL डेटाबेस फिक्स्ड स्कीमा की बाधाओं के बिना असंरचित या अर्ध-संरचित डेटा को संभाल सकते हैं।
विशेष रूप से, MongoDB एक तथाकथित डॉक्यूमेंट डेटाबेस है, जो एक प्रकार का NoSQL डेटाबेस है जो BSON (बाइनरी JSON) नामक फ़ॉर्मेट का उपयोग करके JSON-जैसे दस्तावेज़ों के संग्रह में डेटा संग्रहीत करता है। सरल शब्दों में, दस्तावेज़ JSON की-वैल्यू ऑब्जेक्ट्स के समान होते हैं, जिनमें BSON द्वारा प्रदान की गई अतिरिक्त क्षमताएँ डेटा संग्रहीत करने और उसमें हेरफेर करने के लिए होती हैं।
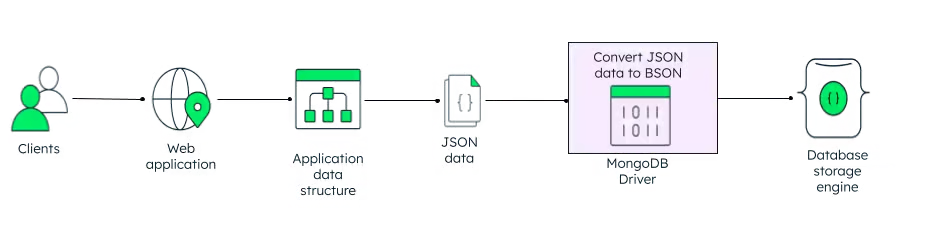
MongoDB कैसे BSON के रूप में डेटा संग्रहीत करता है। स्रोत: DataCamp
BSON की लचीली प्रकृति डायनेमिक डॉक्यूमेंट स्कीमा के निर्माण को सक्षम करती है, जिनकी संरचना और डेटा ऑन-द-फ्लाई बदल सकते हैं। हम अगले उपखंड में इस पर और देखेंगे।
PostgreSQL जैसे रिलेशनल डेटाबेस मजबूत स्कीमा प्रदान करते हैं जिन्हें एक बार तालिकाएँ बनाने के बाद बदलना कठिन होता है। यदि आप जिस डेटा पर काम कर रहे हैं उसका स्वभाव टैबुलर है और वह हमेशा एक ही प्रारूप में आपके एप्लिकेशन में आता है, तो यह एक बेहतरीन सुविधा है। लेकिन यदि आप ऐसे अर्ध-संरचित या असंरचित डेटा से निपटते हैं जिसकी सामग्री एक आइटम से दूसरे में भिन्न हो सकती है, जैसे सोशल मीडिया पोस्ट या सेंसर डेटा, तो डेटा को पचाने के लिए आपको कुछ हद तक लचीलापन चाहिए हो सकता है।
PostgreSQL के विपरीत, MongoDB तथाकथित स्कीमा-रहित डिज़ाइन के साथ आता है, जो विविध और विकसित होते डेटा को संभालने के लिए असाधारण लचीलापन प्रदान करता है। MongoDB का स्कीमा-रहित डिज़ाइन डेटा को दस्तावेज़ और कलेक्शनों में व्यवस्थित करता है:
पारंपरिक रिलेशनल डेटाबेस के विपरीत, जहाँ नया फ़ील्ड जोड़ने के लिए पूरी तालिका संरचना को बदलना पड़ता है, MongoDB एक ही कलेक्शन के भीतर दस्तावेज़ों को पूरी तरह अलग फ़ील्ड और संरचनाएँ रखने की अनुमति देता है। यह कठोर स्कीमा की आवश्यकता को समाप्त करता है और विविध डेटा को बिना एकरूपता थोपे संग्रहीत करना आसान बनाता है।
आप चाहे जो भी डेटाबेस उपयोग कर रहे हों, PostgreSQL या MongoDB, आपको अपने डेटाबेस से संवाद और प्रबंधन करने के लिए भाषा सीखनी होगी। PostgreSQL में यह SQL है, जो अत्यंत लोकप्रिय, मानकीकृत और उपयोग में आसान प्रोग्रामिंग भाषा है। आप हमारे Introduction to SQL कोर्स से SQL शुरू कर सकते हैं।
इसके विपरीत, MongoDB मुख्य रूप से डेटाबेस के साथ इंटरैक्ट करने के लिए अपनी खुद की MongoDB क्वेरी लैंग्वेज (MQL) पर निर्भर करता है। फिर भी, Python, C, और Java जैसी अन्य लोकप्रिय प्रोग्रामिंग भाषाओं का उपयोग करके MongoDB डेटाबेस से कनेक्ट और इंटरैक्ट करना भी संभव है।
आइए SQL और MQL के मुख्य अंतरों का विश्लेषण करें।
PostgreSQL की MongoDB की तुलना में सबसे बड़ी खूबियों में से एक SQL का उपयोग है। SQL (“Structured Query Language”) रिलेशनल डेटाबेस बनाने और बनाए रखने के लिए एक अनिवार्य भाषा है।
यह एक सरल, डोमेन-विशिष्ट प्रोग्रामिंग भाषा है जिसका उपयोग लगभग सभी रिलेशनल डेटाबेस सिस्टम द्वारा किया जाता है, जैसे MySQL, SQL Server, SQLite और, बेशक, PostgreSQL।
SQL अत्यंत शक्तिशाली है, जो आपको डेटा पुनर्प्राप्ति और एग्रीगेशन से लेकर डेटा क्लीनिंग और जोइन ऑपरेशन्स तक हर तरह के डेटा ऑपरेशन करने की अनुमति देता है। हालाँकि, PostgreSQL के मामले में संभावनाएँ और भी अधिक हैं, क्योंकि PostgreSQL जटिल विश्लेषण के लिए उन्नत क्षमताओं के सेट के साथ आता है, जिनमें शामिल हैं:
इसके विपरीत, भले ही MongoDB SQL पर निर्भर नहीं करता, इसमें शक्तिशाली क्वेरीइंग, इंडेक्सिंग और एग्रीगेशन क्षमताएँ हैं, साथ ही डॉक्यूमेंट डेटाबेस में जानकारी इनसर्ट, अपडेट या डिलीट करने के अन्य फ़ंक्शन भी हैं। इसलिए, यदि आप JSON या Python डिक्शनरी से परिचित हैं, तो आपको MQL सिंटैक्स से परिचित होने में अधिक समय नहीं लगेगा।
MQL विशेष रूप से दस्तावेज़ों की गतिशील प्रकृति को संभालने के लिए डिज़ाइन किया गया है। परिणामस्वरूप, यह SQL की तुलना में कहीं अधिक लचीली भाषा है। साथ ही, क्योंकि दस्तावेज़ों के भीतर अन्य दस्तावेज़ एम्बेड किए जा सकते हैं, MongoDB में अक्सर रिलेशनल डेटाबेस में आवश्यक जटिल और कम-दक्ष जोइन ऑपरेशन्स की ज़रूरत नहीं पड़ती।
इंडेक्स ऐसे डेटाबेस ऑब्जेक्ट होते हैं जो डेटा पुनर्प्राप्ति ऑपरेशन्स की गति में सुधार करते हैं। वे टेबल में पंक्तियों को जल्दी खोजने के लिए पॉइंटर्स की तरह काम करते हैं, जिससे क्वेरी के प्रदर्शन में सुधार होता है।
PostgreSQL मजबूत इंडेक्सिंग क्षमताओं के साथ आता है, जो कई इंडेक्स प्रकारों का समर्थन करता है, जिनमें शामिल हैं:
MongoDB भी कलेक्शनों में सभी दस्तावेज़ स्कैन किए बिना दस्तावेज़ खोजने के लिए इंडेक्सिंग का समर्थन करता है। हालाँकि, इसकी क्षमताएँ सीमित हैं और PostgreSQL जैसे रिलेशनल डेटाबेस में उपलब्ध इंडेक्सिंग की विविधता और परिष्कार की कमी है। इसमें शामिल हैं:
अपने SQL और NoSQL डेटाबेस में इंडेक्स का उपयोग करना परफ़ॉर्मेंस बढ़ाने और क्वेरी समय घटाने की कुंजी है, विशेष रूप से बड़े डेटासेट्स पर।
हालाँकि, याद रखें कि इंडेक्स जोड़ना राइट ऑपरेशन्स के लिए नकारात्मक प्रदर्शन प्रभाव भी डाल सकता है। जिन तालिकाओं या कलेक्शनों में लिखने-से-पढ़ने का अनुपात अधिक है, उनमें इंडेक्स महंगे होते हैं क्योंकि प्रत्येक इनसर्ट को किसी भी इंडेक्स को भी अपडेट करना होता है।
MongoDB और PostgreSQL बेहतरीन डेटाबेस टूल हैं, लेकिन उनकी विशेषताओं के आधार पर किसी एक को चुनने का कोई सार्वभौमिक कारण नहीं है। इसके बजाय, आपको हमेशा अपने उपयोग मामले की विशिष्टताओं को ध्यान में रखते हुए चुनाव करना चाहिए। इसे ध्यान में रखते हुए, आइए MongoDB और PostgreSQL के प्रदर्शन और स्केलेबिलिटी में अंतर का विश्लेषण करें।
अन्य लोकप्रिय रिलेशनल डेटाबेस सिस्टम की तरह, PostgreSQL अपने मज़बूत टाइपिंग सिस्टम और ACID (Atomicity, Consistency, Isolation, Durability) ट्रांज़ैक्शन्स के समर्थन के माध्यम से उच्च स्तर की डेटा अखंडता और गुणवत्ता सुनिश्चित करता है।
ACID ट्रांज़ैक्शन्स ऐसी विशेषताओं का समूह है जो डेटाबेस ट्रांज़ैक्शन्स की विश्वसनीय प्रोसेसिंग की गारंटी देता है। वे सुनिश्चित करते हैं कि त्रुटियों, क्रैश या समवर्ती एक्सेस के बावजूद डेटा सटीक और सुरक्षित बना रहे। किसी भी प्रोजेक्ट में डेटा गुणवत्ता बनाए रखने के लिए ये गुण महत्वपूर्ण हैं।
जहाँ रिलेशनल डेटाबेस में डेटा अखंडता सुनिश्चित करने के लिए ACID ट्रांज़ैक्शन्स लंबे समय से स्वर्ण मानक रहे हैं, वहीं MongoDB जैसे NoSQL डेटाबेस अक्सर सख्त ट्रांज़ैक्शनल संगति की तुलना में लचीलापन और स्केलेबिलिटी को प्राथमिकता देते हैं। इसका परिणाम रिलेशनल डेटाबेस में पाई जाने वाली कुछ ACID विशेषताओं में ढील देना होता है।
उदाहरण के लिए, कुछ MongoDB डिप्लॉयमेंट तात्कालिक संगति के बजाय इवेंचुअल संगति को प्राथमिकता देते हैं, अर्थात परिवर्तन तुरंत सभी नोड्स पर परिलक्षित नहीं हो सकते। संगति, उपलब्धता और प्रदर्शन के बीच यह संतुलन बेहतर प्रदर्शन और स्केलेबिलिटी की अनुमति देता है, लेकिन उन एप्लिकेशनों को डिज़ाइन करते समय सावधानीपूर्वक विचार की आवश्यकता होती है जो सख्त डेटा संगति पर निर्भर हैं।
स्केलिंग में डेटा वॉल्यूम और ट्रैफ़िक में वृद्धि को संबोधित करने के लिए कई तकनीकों का उपयोग शामिल होता है। सरल शब्दों में, हम इसे वर्टिकल स्केलिंग और हॉरिज़ॉन्टल स्केलिंग के माध्यम से कर सकते हैं। पहला बढ़े हुए लोड को संभालने के लिए उसी सर्वर में संसाधनों को बेहतर बनाने और जोड़ने से जुड़ा है। दूसरा वितरित सिस्टम में अधिक सर्वर या नोड्स जोड़कर हासिल किया जाता है, जो क्षमता बढ़ाने में मदद करता है।
PostgreSQL मुख्य रूप से क्षमता बढ़ाने के लिए वर्टिकल स्केलिंग पर निर्भर करता है। हालाँकि, अन्य लोकप्रिय SQL डेटाबेस के विपरीत, PostgreSQL पार्टिशनिंग के माध्यम से हॉरिज़ॉन्टल स्केलिंग की भी अनुमति देता है, लेकिन इसके लिए जटिल कॉन्फ़िगरेशन की आवश्यकता होती है। आप हमारे Improving Query Performance in PostgreSQL Course में PostgreSQL में पार्टिशनिंग की तकनीकी बातें सीख सकते हैं।
इसके विपरीत, MongoDB जैसे NoSQL सिस्टम में बढ़ते डेटा ट्रैफ़िक और वॉल्यूम को संभालने की मानक रणनीति हॉरिज़ॉन्टल स्केलिंग है। MongoDB को शार्डिंग का लाभ उठाने के लिए डिज़ाइन किया गया है, जो एक तकनीक है जिसमें किसी डेटाबेस को छोटे, अधिक प्रबंधनीय हिस्सों में विभाजित किया जाता है जिन्हें "शार्ड्स" कहा जाता है और उन्हें कई सर्वरों में वितरित किया जाता है, जिससे सिस्टम बड़े डेटासेट्स और उच्च ट्रैफ़िक वॉल्यूम को संभाल सके।
हमारा Sharding vs Partitioning लेख देखें ताकि इन लोकप्रिय स्केलिंग तकनीकों के बारे में सब कुछ जान सकें।
अब जब हमें PostgreSQL और MongoDB की प्रमुख विशेषताएँ और मजबूती पता हैं, तो यह विश्लेषण करने का समय है कि किन परिदृश्यों में वे अधिक उपयोगी हैं।
जब आपके प्रोजेक्ट को निम्नलिखित की आवश्यकता हो, तो PostgreSQL एक बढ़िया विकल्प है:
कुछ ठोस उदाहरण देने के लिए, PostgreSQL इन स्थितियों में उचित विचार है:
MongoDB उन मामलों में सबसे अच्छा काम करता है जब लचीली डेटा संरचनाएँ उपयोगी होती हैं जो नई जानकारी और स्कीमा के अनुरूप गतिशील रूप से अनुकूलित हो सकें, जब स्केलेबिलिटी और परफ़ॉर्मेंस महत्वपूर्ण हों, और जब डेटा असंरचित हो। MongoDB का स्कीमा-रहित डिज़ाइन, हॉरिज़ॉन्टल स्केलिंग के साथ मिलकर, इसे इन उपयोग मामलों के लिए उपयुक्त बनाता है:
ऐसे उपयोग मामले हो सकते हैं जहाँ आपको विविध डेटा आवश्यकताओं के लिए एक व्यापक समाधान बनाने हेतु MongoDB और PostgreSQL की ताकतों को संयोजित करने की आवश्यकता हो। SQL और NoSQL डेटाबेस को मिलाकर हाइब्रिड आर्किटेक्चर बनाना संभव है, और यदि आपको अपनी ट्रांज़ैक्शन्स में मजबूत संगति के साथ कुछ हद तक लचीलापन भी चाहिए, तो यह एक बढ़िया विचार है।
उदाहरण के लिए, आप रियल-टाइम एनालिटिक्स में तेज़ राइट्स के लिए MongoDB का उपयोग कर सकते हैं, जबकि जटिल रिलेशनल ऑपरेशन्स और संरचित डेटा संग्रहीत करने के लिए PostgreSQL का उपयोग कर सकते हैं। हालाँकि, वर्तमान में दोनों डेटाबेस की कार्यक्षमताओं को “मर्ज” करने का कोई तरीका नहीं है। आप बस एक ही समय में दो अलग-अलग डेटाबेस का उपयोग करेंगे, जिससे आपके सिस्टम की जटिलता बढ़ेगी, और इसे लागू करने से पहले सावधानीपूर्वक विश्लेषण की आवश्यकता होगी।
यदि आप डेटा को MongoDB से PostgreSQL या इसके विपरीत माइग्रेट करने की योजना बना रहे हैं, तो आपको कई तत्वों पर विचार करना होगा:
यदि आप MongoDB से PostgreSQL में माइग्रेट कर रहे हैं, तो डेटा माइग्रेट करने से पहले आपको एक तालिका या एक से अधिक तालिकाएँ पूर्व-परिभाषित स्कीमा के साथ बनानी होंगी, अर्थात् कॉलमों की सूची उनके निर्धारित डेटा प्रकारों और संभावित बाधाओं सहित। यदि आप अपना डेटा Mongo में स्थानांतरित करना चाहते हैं, तो आपको परिभाषित करना होगा कि डेटा दस्तावेज़ों में कैसे शामिल किया जाएगा। दस्तावेज़ों की लचीली प्रकृति के बावजूद, मौजूदा डेटा को रखने के लिए कुछ डेटा मॉडलिंग आवश्यक होगी।
जिस डेटा को आप एक्सपोर्ट करना चाहते हैं, वह संभवतः वांछित प्रारूप में न हो। यदि ऐसा है, तो माइग्रेशन से पहले, आपको डेटा को सही प्रारूप में बदलने के लिए किसी प्रकार की डेटा पाइपलाइन स्थापित करनी होगी और फिर उसे PostgreSQL या MongoDB डेटाबेस में इनसर्ट करना होगा।
माइग्रेशन प्रक्रिया करने के कई तरीके हैं। आप बुनियादी एक्सपोर्ट/इम्पोर्ट चरणों के लिए इसे मैन्युअल रूप से कर सकते हैं, लेकिन यह समय लेने वाली, जटिल और त्रुटि-प्रवण प्रक्रिया हो सकती है, खासकर यदि जिस डेटाबेस को आप माइग्रेट करना चाहते हैं उसमें बहुत सारा डेटा है। इसलिए काम पूरा करने के लिए किसी ELT का चयन करना बेहतर समाधान हो सकता है। वहाँ कई उपलब्ध समाधान मौजूद हैं, चाहे PostgreSQL से Mongo की ओर माइग्रेट करना हो या इसके विपरीत।
माइग्रेशन के दौरान परफ़ॉर्मेंस बढ़ाने की तकनीकों पर विचार करना महत्वपूर्ण है, विशेष रूप से जटिल माइग्रेशन प्रक्रियाओं में। फिर से, स्रोत और गंतव्य के आधार पर, PostgreSQL और MongoDB प्रक्रिया को तेज़ करने के लिए विशिष्ट तकनीकें और रणनीतियाँ प्रदान करते हैं, जिनमें कनेक्शन पूलिंग, पार्टिशनिंग, शार्ड की चयन, और कवरड क्वेरीज़ शामिल हैं।
अपने डेटाबेस डिप्लॉयमेंट की सुरक्षा सुनिश्चित करना डेटा अखंडता, उपलब्धता और अनुपालन के लिए महत्वपूर्ण है। MongoDB और PostgreSQL दोनों आपके डेटाबेस को सुरक्षित करने के लिए विविध तरीके प्रदान करते हैं। इस खंड में, हम कुछ सबसे सामान्य तकनीकों को कवर करते हैं।
PostgreSQL कई प्रमाणीकरण तरीकों के साथ आता है, जिन्हें भूमिकाओं (roles) के माध्यम से प्रभावी ढंग से प्रबंधित किया जा सकता है। रोल ऐसे एंटिटी हैं जो डेटाबेस ऑब्जेक्ट्स के मालिक हो सकते हैं और जिनके पास डेटाबेस प्रिविलेज होते हैं। रोल का उपयोग प्रमाणीकरण उद्देश्यों, अनुमति प्रबंधन और उपयोगकर्ता एक्सेस स्तरों को परिभाषित करने के लिए किया जा सकता है। PostgreSQL में, कोई रोल एक उपयोगकर्ता के रूप में या उपयोगकर्ताओं के समूह के रूप में कार्य कर सकता है।
अनधिकृत एक्सेस को रोकने के लिए आप MongoDB में भी रोल बना सकते हैं। रोल-आधारित नियंत्रण कम-से-कम विशेषाधिकार के सिद्धांत का पालन करता है ताकि सुरक्षा जोखिमों को कम किया जा सके। MongoDB कई प्रमाणीकरण तंत्रों के साथ आता है, जिनमें Salted Challenge Response Authentication Mechanism (SCRAM) सुरक्षित पासवर्ड-आधारित प्रमाणीकरण के लिए डिफ़ॉल्ट तंत्र है।
MongoDB आपका डेटा सुरक्षित करने के लिए कई एन्क्रिप्शन प्रथाएँ प्रदान करता है, जिनमें शामिल हैं:
जहाँ तक PostgreSQL का संबंध है, यह भी कई स्तरों पर एन्क्रिप्शन प्रदान करता है और डेटा को डेटाबेस सर्वर की चोरी, अविश्वसनीय प्रशासकों और असुरक्षित नेटवर्कों के कारण प्रकटीकरण से बचाने में लचीलापन देता है। कुछ विकल्पों में शामिल हैं:
MongoDB और PostgreSQL दोनों ही अत्यंत लोकप्रिय टूल हैं, जिनके उपयोगकर्ताओं के बढ़ते समुदाय और समृद्ध इकोसिस्टम हैं। आइए उन पर नज़र डालें।
PostgreSQL में एक्स्टेंशन ऐसे ऐड-ऑन मॉड्यूल हैं जो डेटाबेस की क्षमताओं का विस्तार करते हैं। ये Python या R के पैकेजों जैसे होते हैं। पिछले वर्षों में, एक्स्टेंशनों का एक समृद्ध इकोसिस्टम उभरा है जो PostgreSQL की संभावनाओं को हर तरह के परिदृश्यों, अनुशासनों और उपयोग मामलों में बढ़ाता है। इनमें से अधिकांश PostgreSQL Extension Network पर मिल सकते हैं।
इसके विपरीत, MongoDB सीमित एक्स्टेंशनों के सेट के साथ आता है और मुख्यतः MongoDB को अन्य तकनीकों और फ़्रेमवर्क्स के साथ उपयोग करने को सक्षम करने तक सीमित है, जैसे Visual Studio Code जैसे IDEs, और Google Cloud जैसे क्लाउड सिस्टम। हालाँकि, उन विभिन्न प्रोग्रामिंग भाषाओं के लिए अन्य थर्ड-पार्टी पैकेज उपलब्ध हो सकते हैं जिनका आप सामान्यतः MongoDB को प्रबंधित करने के लिए उपयोग करते हैं।
PostgreSQL और MongoDB दोनों स्वर्णिम समय जी रहे हैं, जैसा कि DB-Engines के डेटा पर आधारित निम्न छवि में डेटाबेस इंजनों की प्रवृत्तियों से स्पष्ट है।
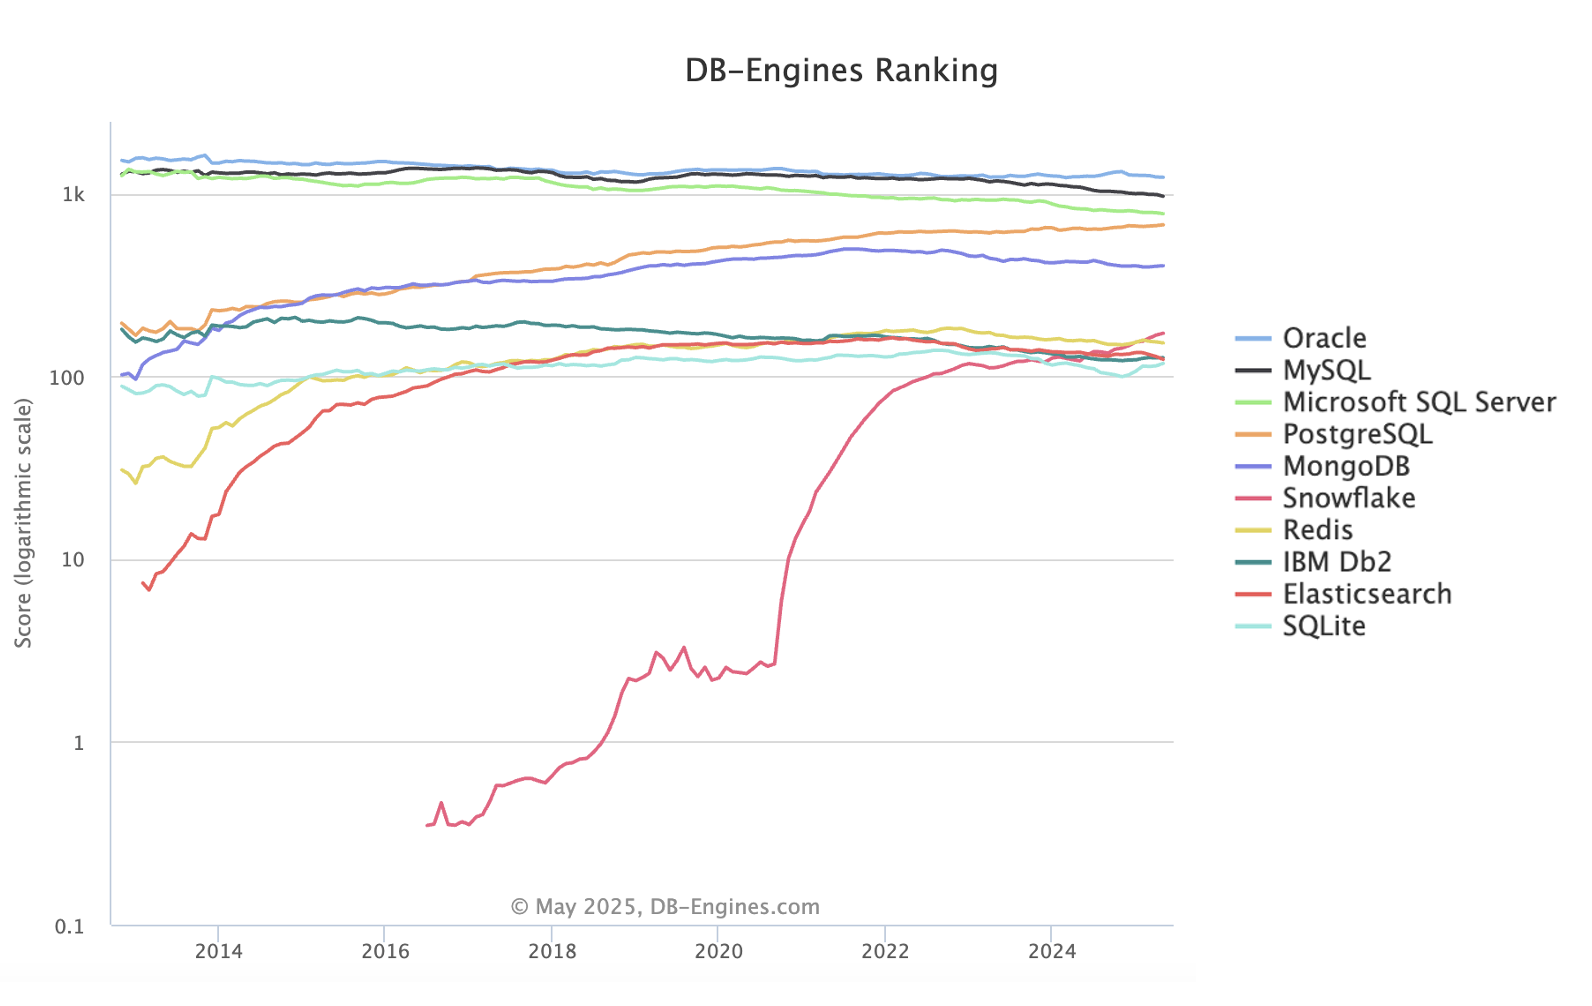
स्रोत: db-engines
जहाँ रिलेशनल डेटाबेस मैनेजमेंट सिस्टम अभी भी प्रमुख हैं (जिसमें PostgreSQL भी शामिल है, जो 4थे स्थान पर है), वहीं ग्राफ़ हाल के वर्षों में एक उल्लेखनीय बदलाव भी दर्शाता है, जहाँ MongoDB और Redis जैसे NoSQL डेटाबेस ने महत्वपूर्ण वृद्धि का अनुभव किया है। यह बढ़ती रफ़्तार असंरचित डेटा को प्रबंधित करने और उच्च-ट्रैफ़िक एप्लिकेशनों को समायोजित करने के लिए इन लचीले और स्केलेबल समाधानों को बढ़ती स्वीकृति को दर्शाती है।
यहाँ MongoDB डेटाबेस और PostgreSQL के बीच के अंतरों को संक्षेप में प्रस्तुत करने वाली एक उत्तम तालिका दी गई है:
|
फ़ीचर |
MongoDB |
PostgreSQL |
|
डेटा संरचना |
डेटा को दस्तावेज़ों (जैसे, JSON, BSON) के रूप में संग्रहीत करता है, जो लचीली, अनुक्रमिक संरचनाओं की अनुमति देता है। |
पूर्व-परिभाषित स्कीमा का पालन करते हुए पंक्तियों और स्तंभों वाली तालिकाओं में डेटा संग्रहीत करता है। |
|
स्कीमा लचीलापन |
स्कीमा-रहित: दस्तावेज़ों की संरचनाएँ भिन्न हो सकती हैं, जिससे अलग-अलग फ़ील्ड्स और डेटा प्रकार संभव हैं। |
फिक्स्ड स्कीमा: विशिष्ट कॉलम और डेटा प्रकारों के साथ पूर्व-परिभाषित स्कीमा आवश्यक। |
|
क्वेरी भाषा |
MongoDB Query Language (MQL) या समान का उपयोग करता है, जो ऑब्जेक्ट-आधारित और अधिक लचीला है। |
संरचित डेटा को क्वेरी करने के लिए SQL (Structured Query Language) का उपयोग करता है। |
|
जॉइन्स |
संबंधित डेटा को दस्तावेज़ों के भीतर एम्बेड करके (डीनॉर्मलाइज़ेशन) जॉइन्स से बचता है। |
तालिकाओं के बीच जटिल जॉइन्स का समर्थन करता है (नॉर्मलाइज़ेशन)। |
|
प्रदर्शन |
असंरचित या अर्ध-संरचित डेटा के लिए तेज़ रीड और राइट। जॉइन्स से होने वाले ओवरहेड से बचता है। |
संरचित डेटा के लिए मजबूत प्रदर्शन, लेकिन जॉइन्स क्वेरीज़ को धीमा कर सकते हैं। |
|
स्केलेबिलिटी |
हॉरिज़ॉन्टली स्केलेबल: शार्डिंग का उपयोग करके डेटा को कई सर्वरों में वितरित कर सकता है। |
आम तौर पर वर्टिकली स्केलेबल: अधिक शक्तिशाली हार्डवेयर पर निर्भर, हालांकि कुछ हॉरिज़ॉन्टल स्केलिंग का समर्थन (जैसे, पार्टिशन के साथ) मौजूद है। |
|
ट्रांज़ैक्शन समर्थन |
मल्टी-डॉक्यूमेंट ACID ट्रांज़ैक्शन्स का समर्थन करता है (MongoDB 4.0 और उससे ऊपर से), लेकिन मूल रूप से नॉन-ट्रांज़ैक्शनल ऑपरेशन्स के लिए डिज़ाइन किया गया था। |
ACID-अनुपालक ट्रांज़ैक्शन्स के लिए पूर्ण समर्थन, जो मजबूत संगति और विश्वसनीयता प्रदान करता है। |
|
उपयोग केस |
असंरचित या अर्ध-संरचित डेटा जैसे उपयोगकर्ता प्रोफ़ाइल, लॉग, कैटलॉग और लचीली डेटा संरचनाओं के लिए सर्वोत्तम। |
स्पष्ट संबंधों वाले संरचित डेटा के लिए आदर्श, जैसे वित्तीय रिकॉर्ड या एंटरप्राइज़ रिसोर्स प्लानिंग (ERP)। |
|
डेटा संबंध |
एम्बेडेड डेटा (डीनॉर्मलाइज़ेशन) का समर्थन करता है, जिससे एकल क्वेरी से संबंधित जानकारी प्राप्त करना आसान होता है। |
रिलेशनल डेटाबेस तालिकाओं के बीच संबंध स्थापित करने के लिए फॉरेन कीज़ पर निर्भर करते हैं (नॉर्मलाइज़ेशन)। |
|
इंडेक्सिंग |
इंडेक्सिंग का समर्थन करता है लेकिन रिलेशनल डेटाबेस में उपलब्ध इंडेक्सिंग की विविधता और परिष्कार की कमी है। |
मज़बूत इंडेक्सिंग क्षमताएँ, बेहतर प्रदर्शन अनुकूलन के लिए कई इंडेक्स प्रकारों (जैसे, B-tree, हैश) का समर्थन। |
|
संगति |
वितरित सेटअप में इवेंचुअल कंसिस्टेंसी प्रदान करता है, लेकिन आवश्यकता होने पर मजबूत संगति भी (ACID ट्रांज़ैक्शन्स के माध्यम से) प्रदान करता है। |
ACID ट्रांज़ैक्शन्स और रिलेशनल इंटेग्रिटी के कारण अधिकांश मामलों में मजबूत संगति सुनिश्चित करता है। |
|
डेटा वॉल्यूम स्केलिंग |
सर्वर जोड़कर (शार्डिंग) बड़ी मात्रा में डेटा को आसानी से स्केल करता है। |
वर्टिकली स्केल कर सकता है, लेकिन हॉरिज़ॉन्टल स्केलिंग के लिए अधिक जटिल कॉन्फ़िगरेशन (जैसे, पार्टिशनिंग) आवश्यक है। |
|
डेटा अखंडता |
डेटा अखंडता प्रत्येक दस्तावेज़ के भीतर प्रबंधित होती है, लेकिन दस्तावेज़ों के बीच संबंध प्रबंधित करना अधिक चुनौतीपूर्ण हो सकता है। |
प्राइमरी और फॉरेन कीज़ के माध्यम से, साथ ही UNIQUE और NOT NULL जैसी बाधाओं के साथ डेटा अखंडता के लिए मज़बूत अंतर्निहित समर्थन। |
|
डेवलपर-फ्रेंडली |
डेवलपर-फ्रेंडली: लचीली डेटा मॉडलिंग, आधुनिक एप्लिकेशनों (जैसे, JSON, REST APIs) के साथ अच्छा काम करता है। |
कठोर डेटा मॉडलिंग, लेकिन SQL और संरचित डेटा से परिचित डेवलपर्स के लिए अच्छी तरह समझा हुआ। |
MongoDB और PostgreSQL सबसे लोकप्रिय डेटाबेस में से दो हैं। वे क्रमशः SQL और NoSQL डेटाबेस के बेहतरीन उदाहरण हैं, और उनकी तुलना करके, हम उन अंतरों, ताकतों और विभिन्न उपयोग मामलों पर रोशनी डाल सकते हैं जहाँ ये डेटाबेस उपयोगी हो सकते हैं।
SQL और NoSQL डेटाबेस के बारे में सीखने के लिए बहुत कुछ है। DataCamp में, हम आपको सबसे व्यापक और अपडेटेड कोर्स और ट्यूटोरियल से मदद करना चाहते हैं। यहाँ हमारे कुछ समर्पित डेटाबेस मटेरियल देखें:
शीर्ष DataCamp कोर्स
कोर्स
कोर्स
कोर्स
