Cours
Créer des bases de données PostgreSQL
4 h
22.5K
Si vous lancez une nouvelle application numérique, vous aurez probablement besoin de collecter et de stocker des données. Le choix du lieu et de la manière de stocker ces données est l’une des décisions les plus importantes, car l’ensemble du logiciel reposera sur ces données pour fonctionner.
Historiquement, les données sont stockées dans des tables avec des lignes et des colonnes reliées par des relations (c’est-à-dire des colonnes communes). Les bases de données qui stockent des données relationnelles sont appelées bases de données relationnelles, ou bases de données SQL, puisqu’elles s’appuient, pour la plupart, sur SQL pour tous types d’opérations.
Cependant, ces dernières décennies, de nouveaux systèmes de gestion de bases de données ont émergé pour répondre à l’augmentation rapide du volume et de la variété des données créées chaque seconde. Les bases de données dites NoSQL (Not only SQL) proposent de nouveaux schémas et stratégies pour collecter efficacement des données selon des cas d’usage spécifiques, tout en s’appuyant encore partiellement sur SQL.
Dans cet article, nous allons analyser deux systèmes de gestion de bases de données populaires : PostgreSQL et MongoDB. Le premier est l’une des bases SQL les plus répandues, tandis que le second est la base NoSQL la plus connue.
Nous couvrirons les fonctionnalités clés et les atouts de chaque base, leurs cas d’usage les plus convaincants, ainsi que les points d’attention si vous envisagez de migrer vos données vers l’une d’entre elles.
Si vous souhaitez pratiquer et tester chaque approche, découvrez nos cours Creating PostgreSQL Databases et Introduction to MongoDB in Python.
Choisir la bonne base de données est crucial pour toute application numérique. PostgreSQL, une base relationnelle puissante fondée sur SQL, excelle avec des données structurées nécessitant cohérence, jointures complexes et transactions ACID. MongoDB, base NoSQL flexible orientée documents en BSON, est idéale pour des données dynamiques et non structurées, offrant une meilleure scalabilité via le sharding horizontal. Le choix entre PostgreSQL et MongoDB dépend en fin de compte de la structure de vos données, de vos besoins de montée en charge et de vos exigences de cohérence.
Analysons les principales différences entre PostgreSQL et MongoDB en termes d’architecture des modèles de données.
Les systèmes de gestion de bases relationnelles, comme PostgreSQL, organisent les données en tables composées de lignes et de colonnes. Ces tables peuvent être liées par des clés, permettant des relations complexes via les jointures SQL et des requêtes performantes.
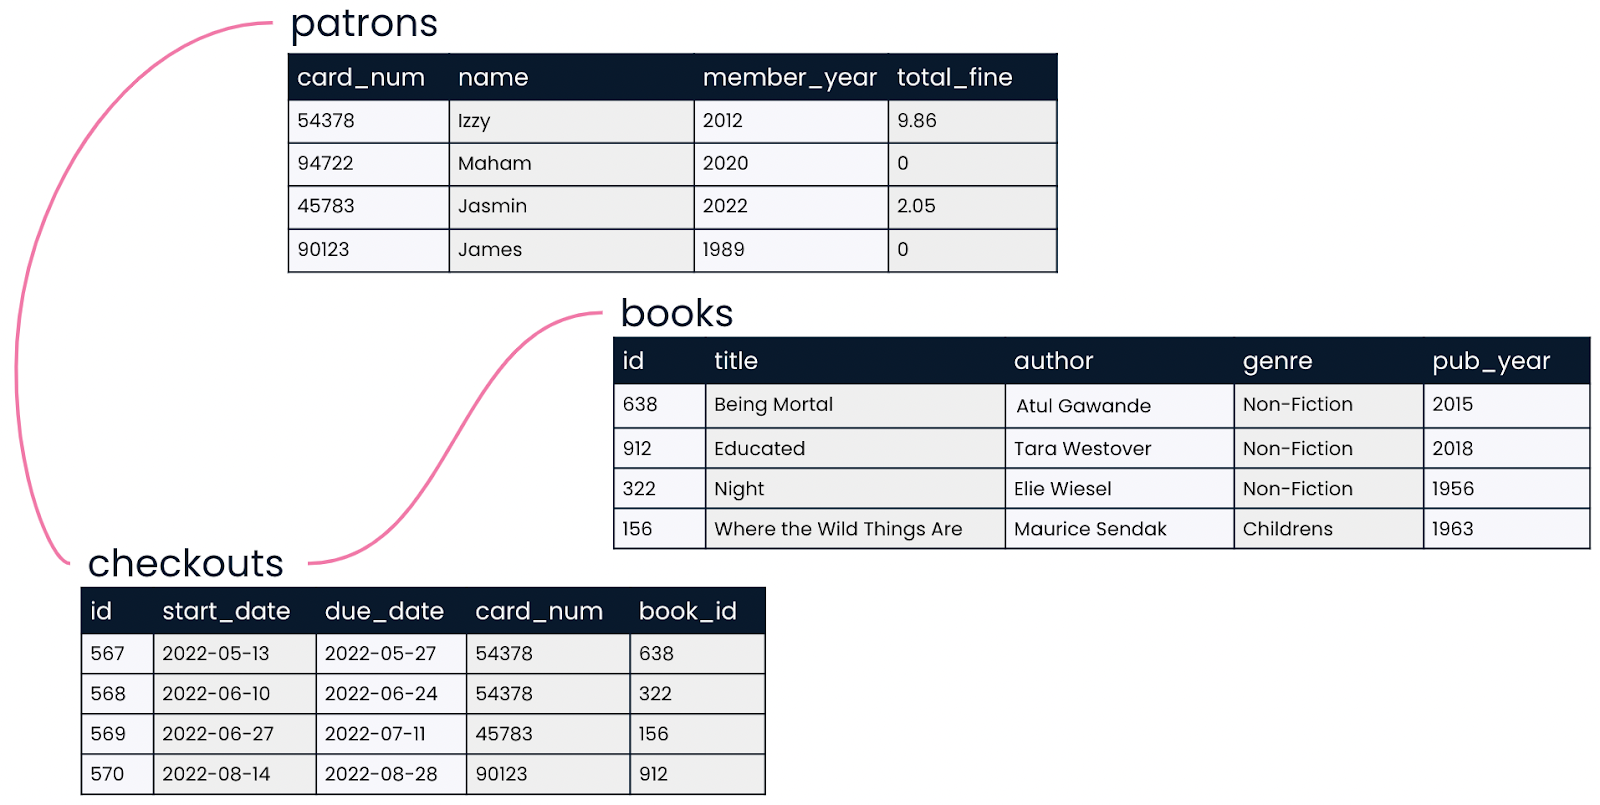
Base de données relationnelle. Source : DataCamp
Grâce à leur simplicité, leur efficacité et leur forte cohérence, les bases relationnelles ont connu un succès massif et une large adoption au cours des dernières décennies.
Elles ne sont toutefois pas toujours le meilleur choix lorsque vous travaillez avec des données non structurées qui ne s’intègrent pas bien à un format tabulaire (par exemple, des posts sur les réseaux sociaux, des données de capteurs) ou lorsque la scalabilité est indispensable, c’est-à-dire quand votre application doit s’étendre horizontalement sur de nombreux serveurs.
C’est là que les bases NoSQL entrent en scène. Contrairement aux bases relationnelles, les bases NoSQL gèrent des données non structurées ou semi-structurées sans les contraintes d’un schéma figé.
En particulier, MongoDB est une base dite orientée documents, un type de base NoSQL qui stocke les données sous forme de collections de documents de type JSON via un format appelé BSON (Binary JSON). En termes simples, les documents ressemblent à des objets clé-valeur JSON, avec des capacités supplémentaires de stockage et de manipulation offertes par BSON.
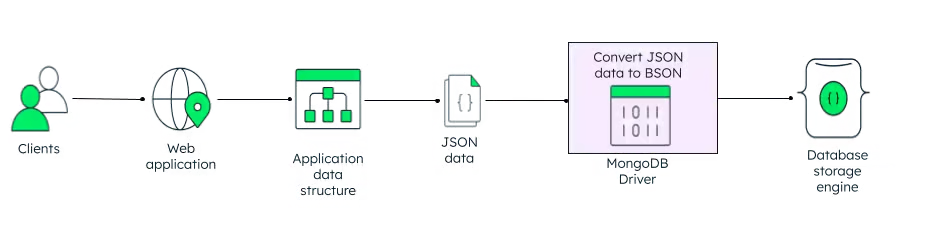
Comment MongoDB stocke les données en BSON. Source : DataCamp
La nature flexible de BSON permet de créer des schémas de documents dynamiques dont la structure et le contenu peuvent évoluer à la volée. Nous y revenons dans la sous-section suivante.
Les bases relationnelles comme PostgreSQL proposent des schémas robustes, difficiles à modifier une fois les tables créées. C’est idéal si vos données sont de nature tabulaire et arrivent toujours au même format. En revanche, si vous traitez des données semi-structurées ou non structurées dont le contenu varie d’un enregistrement à l’autre, comme des posts sociaux ou des données de capteurs, il vous faut davantage de flexibilité pour les ingérer.
À l’inverse de PostgreSQL, MongoDB adopte des conceptions sans schéma, offrant une flexibilité exceptionnelle pour gérer des données diverses et évolutives. Le modèle sans schéma de MongoDB organise les données en documents et collections :
Contrairement aux bases relationnelles traditionnelles où l’ajout d’un champ requiert de modifier toute la structure de la table, MongoDB permet à des documents d’une même collection d’avoir des champs et structures entièrement différents. Cela supprime la nécessité de schémas rigides et facilite le stockage de données variées sans imposer l’uniformité.
Quelle que soit la base utilisée, PostgreSQL ou MongoDB, vous devrez maîtriser le langage pour communiquer avec elle. Dans PostgreSQL, il s’agit de SQL, un langage standardisé, très populaire et simple à utiliser. Vous pouvez démarrer avec notre cours Introduction to SQL.
À l’inverse, MongoDB s’appuie principalement sur son propre langage, le MongoDB Query Language (MQL), pour interagir avec la base. Il est toutefois possible d’utiliser d’autres langages populaires, comme Python, C ou Java, pour se connecter et interagir avec des bases MongoDB.
Analysons les différences majeures entre SQL et MQL.
L’un des grands atouts de PostgreSQL par rapport à MongoDB est l’usage de SQL. SQL (pour « Structured Query Language ») est un langage essentiel pour construire et maintenir des bases relationnelles.
C’est un langage simple et spécifique au domaine, utilisé par quasiment tous les systèmes relationnels, comme MySQL, SQL Server, SQLite et, bien sûr, PostgreSQL.
SQL est extrêmement puissant et permet toutes sortes d’opérations : extraction et agrégation de données, nettoyage, jointures, etc. Avec PostgreSQL, les possibilités sont encore plus vastes grâce à des fonctionnalités avancées pour l’analyse complexe, notamment :
À l’inverse, même si MongoDB ne repose pas sur SQL, il propose des capacités puissantes de requêtage, d’indexation et d’agrégation, ainsi que des fonctions d’insertion, de mise à jour ou de suppression pour les bases orientées documents. Si vous êtes familier avec JSON ou les dictionnaires Python, vous prendrez rapidement en main la syntaxe MQL.
MQL est conçu pour gérer la nature dynamique des documents. Il est donc bien plus flexible que SQL. De plus, comme les documents peuvent en imbriquer d’autres, MongoDB évite souvent les jointures complexes et coûteuses qui sont fréquentes en bases relationnelles.
Les index sont des objets de base de données qui accélèrent la récupération de données. Ils servent de pointeurs pour localiser rapidement les lignes d’une table et améliorer les performances des requêtes.
PostgreSQL offre des capacités d’indexation étendues, avec plusieurs types d’index, notamment :
MongoDB prend également en charge l’indexation pour retrouver des documents dans les collections sans devoir les parcourir intégralement. Néanmoins, ses capacités sont plus limitées et n’offrent ni la variété ni la sophistication des index des bases relationnelles comme PostgreSQL. Parmi celles-ci :
L’usage d’index dans vos bases SQL et NoSQL est essentiel pour améliorer les performances et réduire les temps de requête, surtout sur de grands volumes.
Gardez toutefois à l’esprit que l’ajout d’un index peut dégrader les performances en écriture. Pour des tables ou collections avec un fort ratio écriture/lecture, les index sont coûteux car chaque insertion doit aussi mettre à jour les index.
MongoDB et PostgreSQL sont d’excellents outils, mais il n’y a pas de choix universel. Vous devez décider en fonction des spécificités de votre cas d’usage. Dans cet esprit, analysons leurs différences en matière de performances et de scalabilité.
Comme d’autres systèmes relationnels populaires, PostgreSQL garantit un haut niveau d’intégrité et de qualité des données grâce à son typage robuste et à la prise en charge des transactions ACID (Atomicité, Cohérence, Isolation, Durabilité).
Les transactions ACID sont un ensemble de propriétés qui garantissent le traitement fiable des transactions. Elles assurent l’exactitude et la sécurité des données, même en cas d’erreurs, de pannes ou d’accès concurrents. Ces propriétés sont vitales pour préserver la qualité des données dans tout projet.
Alors que les transactions ACID sont la référence pour l’intégrité des données dans les bases relationnelles, les bases NoSQL comme MongoDB privilégient souvent la flexibilité et la scalabilité à une cohérence transactionnelle stricte, assouplissant certaines propriétés ACID.
Par exemple, certains déploiements MongoDB privilégient la cohérence éventuelle plutôt que la cohérence immédiate, ce qui signifie que les changements ne sont pas reflétés instantanément sur tous les nœuds. Ce compromis entre cohérence, disponibilité et performance améliore la scalabilité, mais exige une conception prudente lorsqu’une cohérence stricte est requise.
La montée en charge recourt à différentes techniques pour absorber la hausse du volume et du trafic. En simplifiant, on distingue la scalabilité verticale et horizontale. La première consiste à renforcer les ressources d’un même serveur. La seconde ajoute des serveurs ou nœuds à un système distribué pour augmenter la capacité.
PostgreSQL s’appuie principalement sur la scalabilité verticale. Toutefois, contrairement à d’autres bases SQL, PostgreSQL autorise aussi une scalabilité horizontale via la partition, au prix de configurations plus complexes. Vous pouvez approfondir la partition dans notre cours Improving Query Performance in PostgreSQL.
À l’inverse, dans les systèmes NoSQL comme MongoDB, la stratégie privilégiée pour gérer la croissance des données et du trafic est la scalabilité horizontale. MongoDB est conçu pour tirer parti du sharding, une technique qui divise la base en fragments (« shards ») distribués sur plusieurs serveurs, afin de gérer de grands jeux de données et des volumes de trafic élevés.
Consultez notre article Sharding vs Partitioning pour tout savoir sur ces techniques.
Maintenant que nous connaissons les forces de PostgreSQL et MongoDB, voyons dans quels scénarios chacun s’illustre le mieux.
PostgreSQL est un excellent choix lorsque votre projet exige :
Quelques exemples parlants où PostgreSQL s’impose :
MongoDB est particulièrement adapté lorsque des structures de données flexibles doivent s’adapter à de nouvelles informations et schémas, lorsque la scalabilité et la performance sont clés, et pour des données non structurées. Son modèle sans schéma, combiné à la scalabilité horizontale, le rend idéal pour des cas d’usage tels que :
Il peut exister des cas où combiner les forces de MongoDB et PostgreSQL répond le mieux à des besoins hétérogènes. Créer des architectures hybrides mêlant bases SQL et NoSQL est possible et pertinent si vous devez associer forte cohérence transactionnelle et flexibilité.
Par exemple, vous pouvez utiliser MongoDB pour des écritures rapides en analytics temps réel, et PostgreSQL pour des opérations relationnelles complexes et le stockage structuré. Il n’existe toutefois pas de moyen de « fusionner » leurs fonctionnalités : vous utiliserez deux bases distinctes en parallèle, ce qui accroît la complexité du système et exige une étude approfondie avant mise en œuvre.
Si vous envisagez de migrer des données de MongoDB vers PostgreSQL ou inversement, plusieurs éléments sont à considérer :
Si vous migrez de MongoDB vers PostgreSQL, vous devrez, avant la migration, créer une ou plusieurs tables avec un schéma prédéfini, c’est-à-dire une liste de colonnes avec leurs types et contraintes. Si vous migrez vers Mongo, vous devrez définir comment intégrer les données dans les documents. Malgré la flexibilité des documents, un minimum de modélisation sera indispensable pour loger les données existantes.
Les données à exporter n’ont pas toujours le format souhaité. Dans ce cas, avant la migration, il faudra mettre en place un pipeline pour transformer les données au bon format avant insertion dans PostgreSQL ou MongoDB.
Plusieurs approches existent. Vous pouvez procéder manuellement pour des exports/imports basiques, mais cela peut être long, complexe et source d’erreurs, surtout avec de gros volumes. C’est pourquoi le choix d’un outil ELT peut s’avérer plus judicieux. Il existe de nombreuses solutions pour migrer de PostgreSQL vers Mongo et inversement.
Prendre en compte des techniques d’optimisation pendant la migration est crucial, surtout pour les processus complexes. Selon la source et la destination, PostgreSQL et MongoDB offrent des leviers spécifiques pour accélérer la migration, notamment le pooling de connexions, la partition, le choix de la clé de shard et les requêtes couvertes.
Protéger votre déploiement est essentiel pour assurer l’intégrité, la disponibilité et la conformité des données. MongoDB comme PostgreSQL offrent diverses méthodes pour sécuriser vos bases. Voici quelques techniques courantes.
PostgreSQL propose une large gamme de méthodes d’authentification, gérées efficacement via des rôles. Les rôles sont des entités pouvant posséder des objets et détenir des privilèges. Ils servent à l’authentification, à la gestion des permissions et à la définition des niveaux d’accès. Dans PostgreSQL, un rôle peut agir comme un utilisateur ou comme un groupe d’utilisateurs.
Vous pouvez également créer des rôles dans MongoDB pour empêcher les accès non autorisés. Le contrôle d’accès fondé sur les rôles suit le principe du moindre privilège afin de réduire les risques. MongoDB propose plusieurs mécanismes d’authentification, dont le mécanisme par défaut est le SCRAM (Salted Challenge Response Authentication Mechanism) pour une authentification par mot de passe sécurisée.
MongoDB offre un large éventail de pratiques de chiffrement pour sécuriser vos données, notamment :
PostgreSQL propose également du chiffrement à plusieurs niveaux et offre une grande flexibilité pour protéger les données contre les fuites dues au vol de serveur, à des administrateurs indélicats ou à des réseaux non sécurisés. Parmi les options :
MongoDB et PostgreSQL sont tous deux très populaires, avec des communautés en croissance et des écosystèmes dynamiques. Jetons-y un œil.
Les extensions PostgreSQL sont des modules additionnels qui élargissent les capacités de la base, à l’image des packages en Python ou R. Ces dernières années, un riche écosystème d’extensions a émergé pour décupler le potentiel de PostgreSQL dans de nombreux contextes. La plupart sont disponibles sur le PostgreSQL Extension Network.
À l’inverse, MongoDB offre un éventail d’extensions plus limité, principalement destiné à l’intégrer à d’autres technologies et frameworks, tels que des IDE comme Visual Studio Code ou des plateformes cloud comme Google Cloud. D’autres packages tiers existent toutefois pour les langages que vous utilisez pour piloter MongoDB.
PostgreSQL et MongoDB vivent tous deux une période faste, comme l’illustre l’image suivante des tendances des moteurs de bases de données d’après DB-Engines.
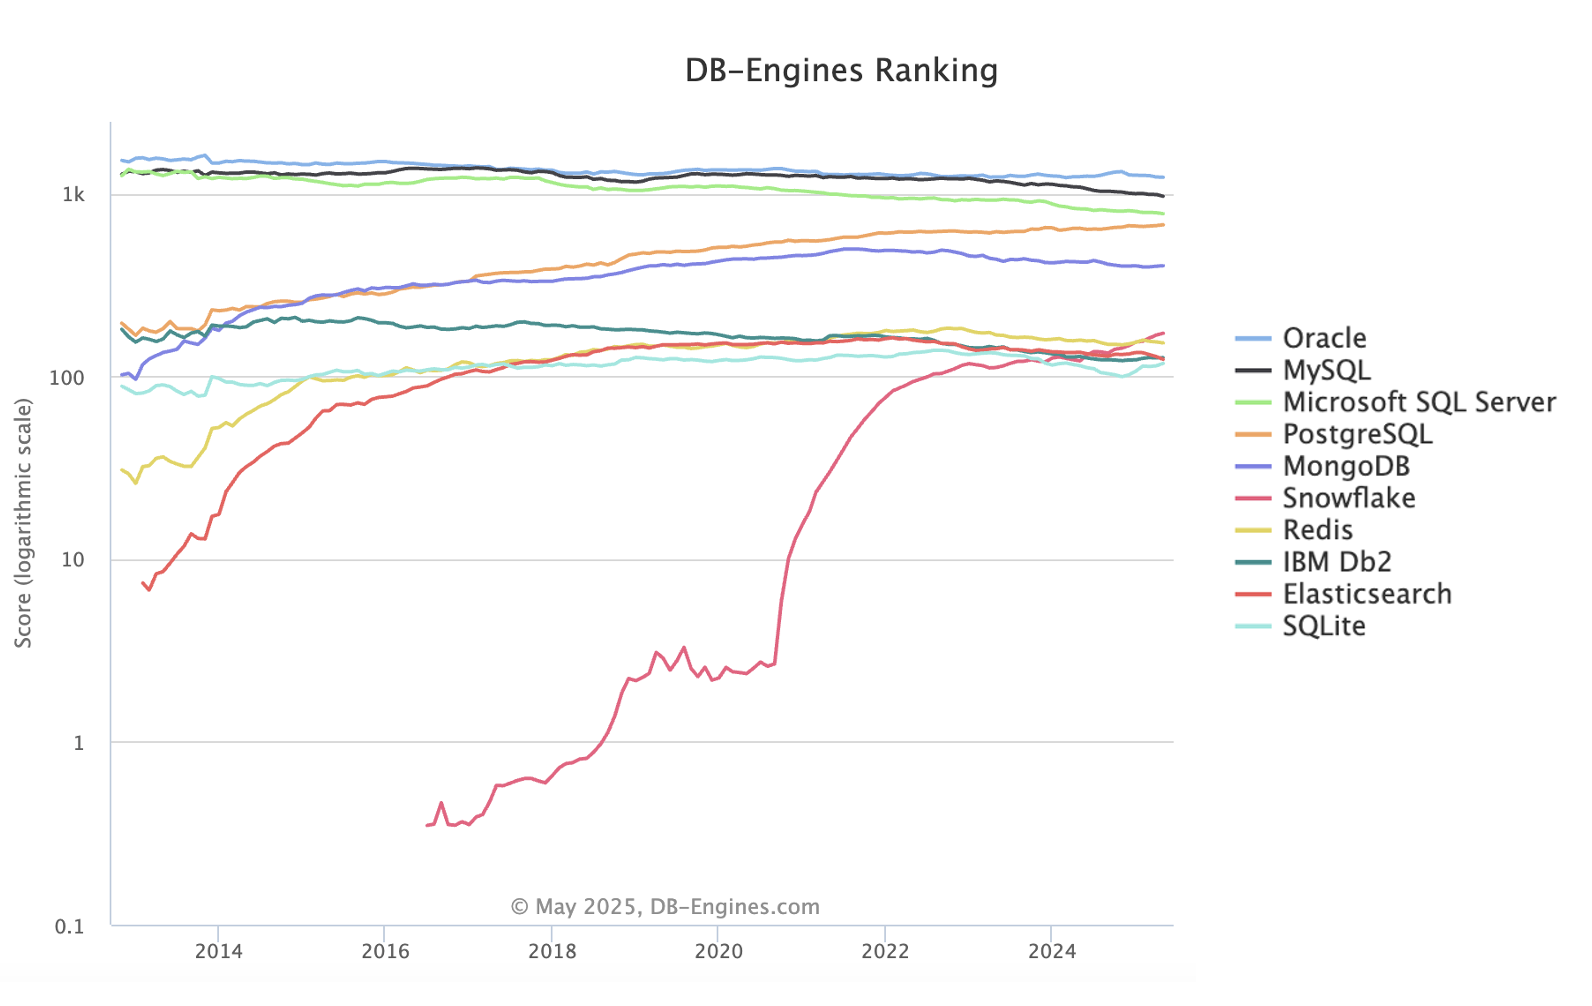
Source : db-engines
Bien que les SGBDR restent dominants (dont PostgreSQL, 4e du classement), le graphique révèle aussi un tournant récent, avec une forte croissance des bases NoSQL comme MongoDB et Redis. Cette trajectoire traduit l’adoption croissante de solutions flexibles et scalables pour gérer des données non structurées et des applications à fort trafic.
Voici un tableau récapitulatif des différences entre MongoDB et PostgreSQL :
|
Caractéristique |
MongoDB |
PostgreSQL |
|
Structure des données |
Stocke les données sous forme de documents (JSON, BSON), permettant des structures flexibles et hiérarchiques. |
Stocke les données en tables (lignes/colonnes) selon un schéma prédéfini. |
|
Flexibilité du schéma |
Sans schéma : les documents peuvent avoir des structures variées, avec des champs et types différents. |
Schéma fixe : nécessite un schéma prédéfini avec colonnes et types spécifiques. |
|
Langage de requête |
Utilise MQL (MongoDB Query Language) ou équivalent, orienté objets et plus flexible. |
Utilise SQL (Structured Query Language) pour interroger des données structurées. |
|
Jointures |
Évite les jointures en imbriquant les données liées dans les documents (dénormalisation). |
Prend en charge des jointures complexes entre tables (normalisation). |
|
Performance |
Lectures/écritures plus rapides pour des données non ou semi-structurées. Évite le surcoût des jointures. |
Très performant pour des données structurées, mais les jointures peuvent ralentir les requêtes. |
|
Scalabilité |
Scalabilité horizontale : répartition sur plusieurs serveurs via sharding. |
Généralement verticale : nécessite un matériel plus puissant, même si une scalabilité horizontale est possible (partitions). |
|
Support des transactions |
Prend en charge les transactions ACID multi-documents (depuis MongoDB 4.0+), mais n’a pas été conçu initialement pour cela. |
Support complet des transactions ACID, offrant cohérence et fiabilité. |
|
Cas d’usage |
Idéal pour des données non/semi-structurées comme profils utilisateurs, logs, catalogues et structures flexibles. |
Parfait pour des données structurées avec relations claires, ex. écritures comptables ou ERP. |
|
Relations de données |
Privilégie les données imbriquées (dénormalisation) pour récupérer des informations liées en une seule requête. |
S’appuie sur des clés étrangères pour lier les tables (normalisation). |
|
Indexation |
Prend en charge l’indexation mais avec moins de variété et de sophistication que les bases relationnelles. |
Capacités d’indexation étendues (ex. B-tree, hash) pour une meilleure optimisation des performances. |
|
Cohérence |
Assure une cohérence éventuelle en environnement distribué et peut fournir une forte cohérence si nécessaire (via transactions ACID). |
Assure généralement une forte cohérence grâce aux transactions ACID et à l’intégrité relationnelle. |
|
Montée en volume |
S’adapte facilement à de très gros volumes en ajoutant des serveurs (sharding). |
Peut monter verticalement ; l’horizontal nécessite des configurations plus complexes (ex. partition). |
|
Intégrité des données |
Gérée au niveau de chaque document ; gérer les relations entre documents est plus complexe. |
Support natif fort via clés primaires/étrangères et contraintes (UNIQUE, NOT NULL). |
|
Expérience développeur |
Agréable pour les développeurs : modélisation flexible, très adapté aux applis modernes (JSON, REST APIs). |
Modélisation plus rigide mais bien maîtrisée par les développeurs familiers de SQL et des données structurées. |
MongoDB et PostgreSQL comptent parmi les bases de données les plus populaires. Elles incarnent respectivement les approches NoSQL et SQL. En les comparant, on met en lumière leurs différences, leurs forces et les cas d’usage où chacune brille.
Il y a beaucoup à apprendre sur les bases SQL et NoSQL. Chez DataCamp, nous vous accompagnons avec des cours et tutoriels complets et à jour. Découvrez notre sélection dédiée :
Meilleurs cours DataCamp
Cours
Cours
Cours